索引膨胀与重建:PostgreSQL REINDEX 生产实践
标签:#PostgreSQL #索引 #性能优化 #REINDEX
一、前言
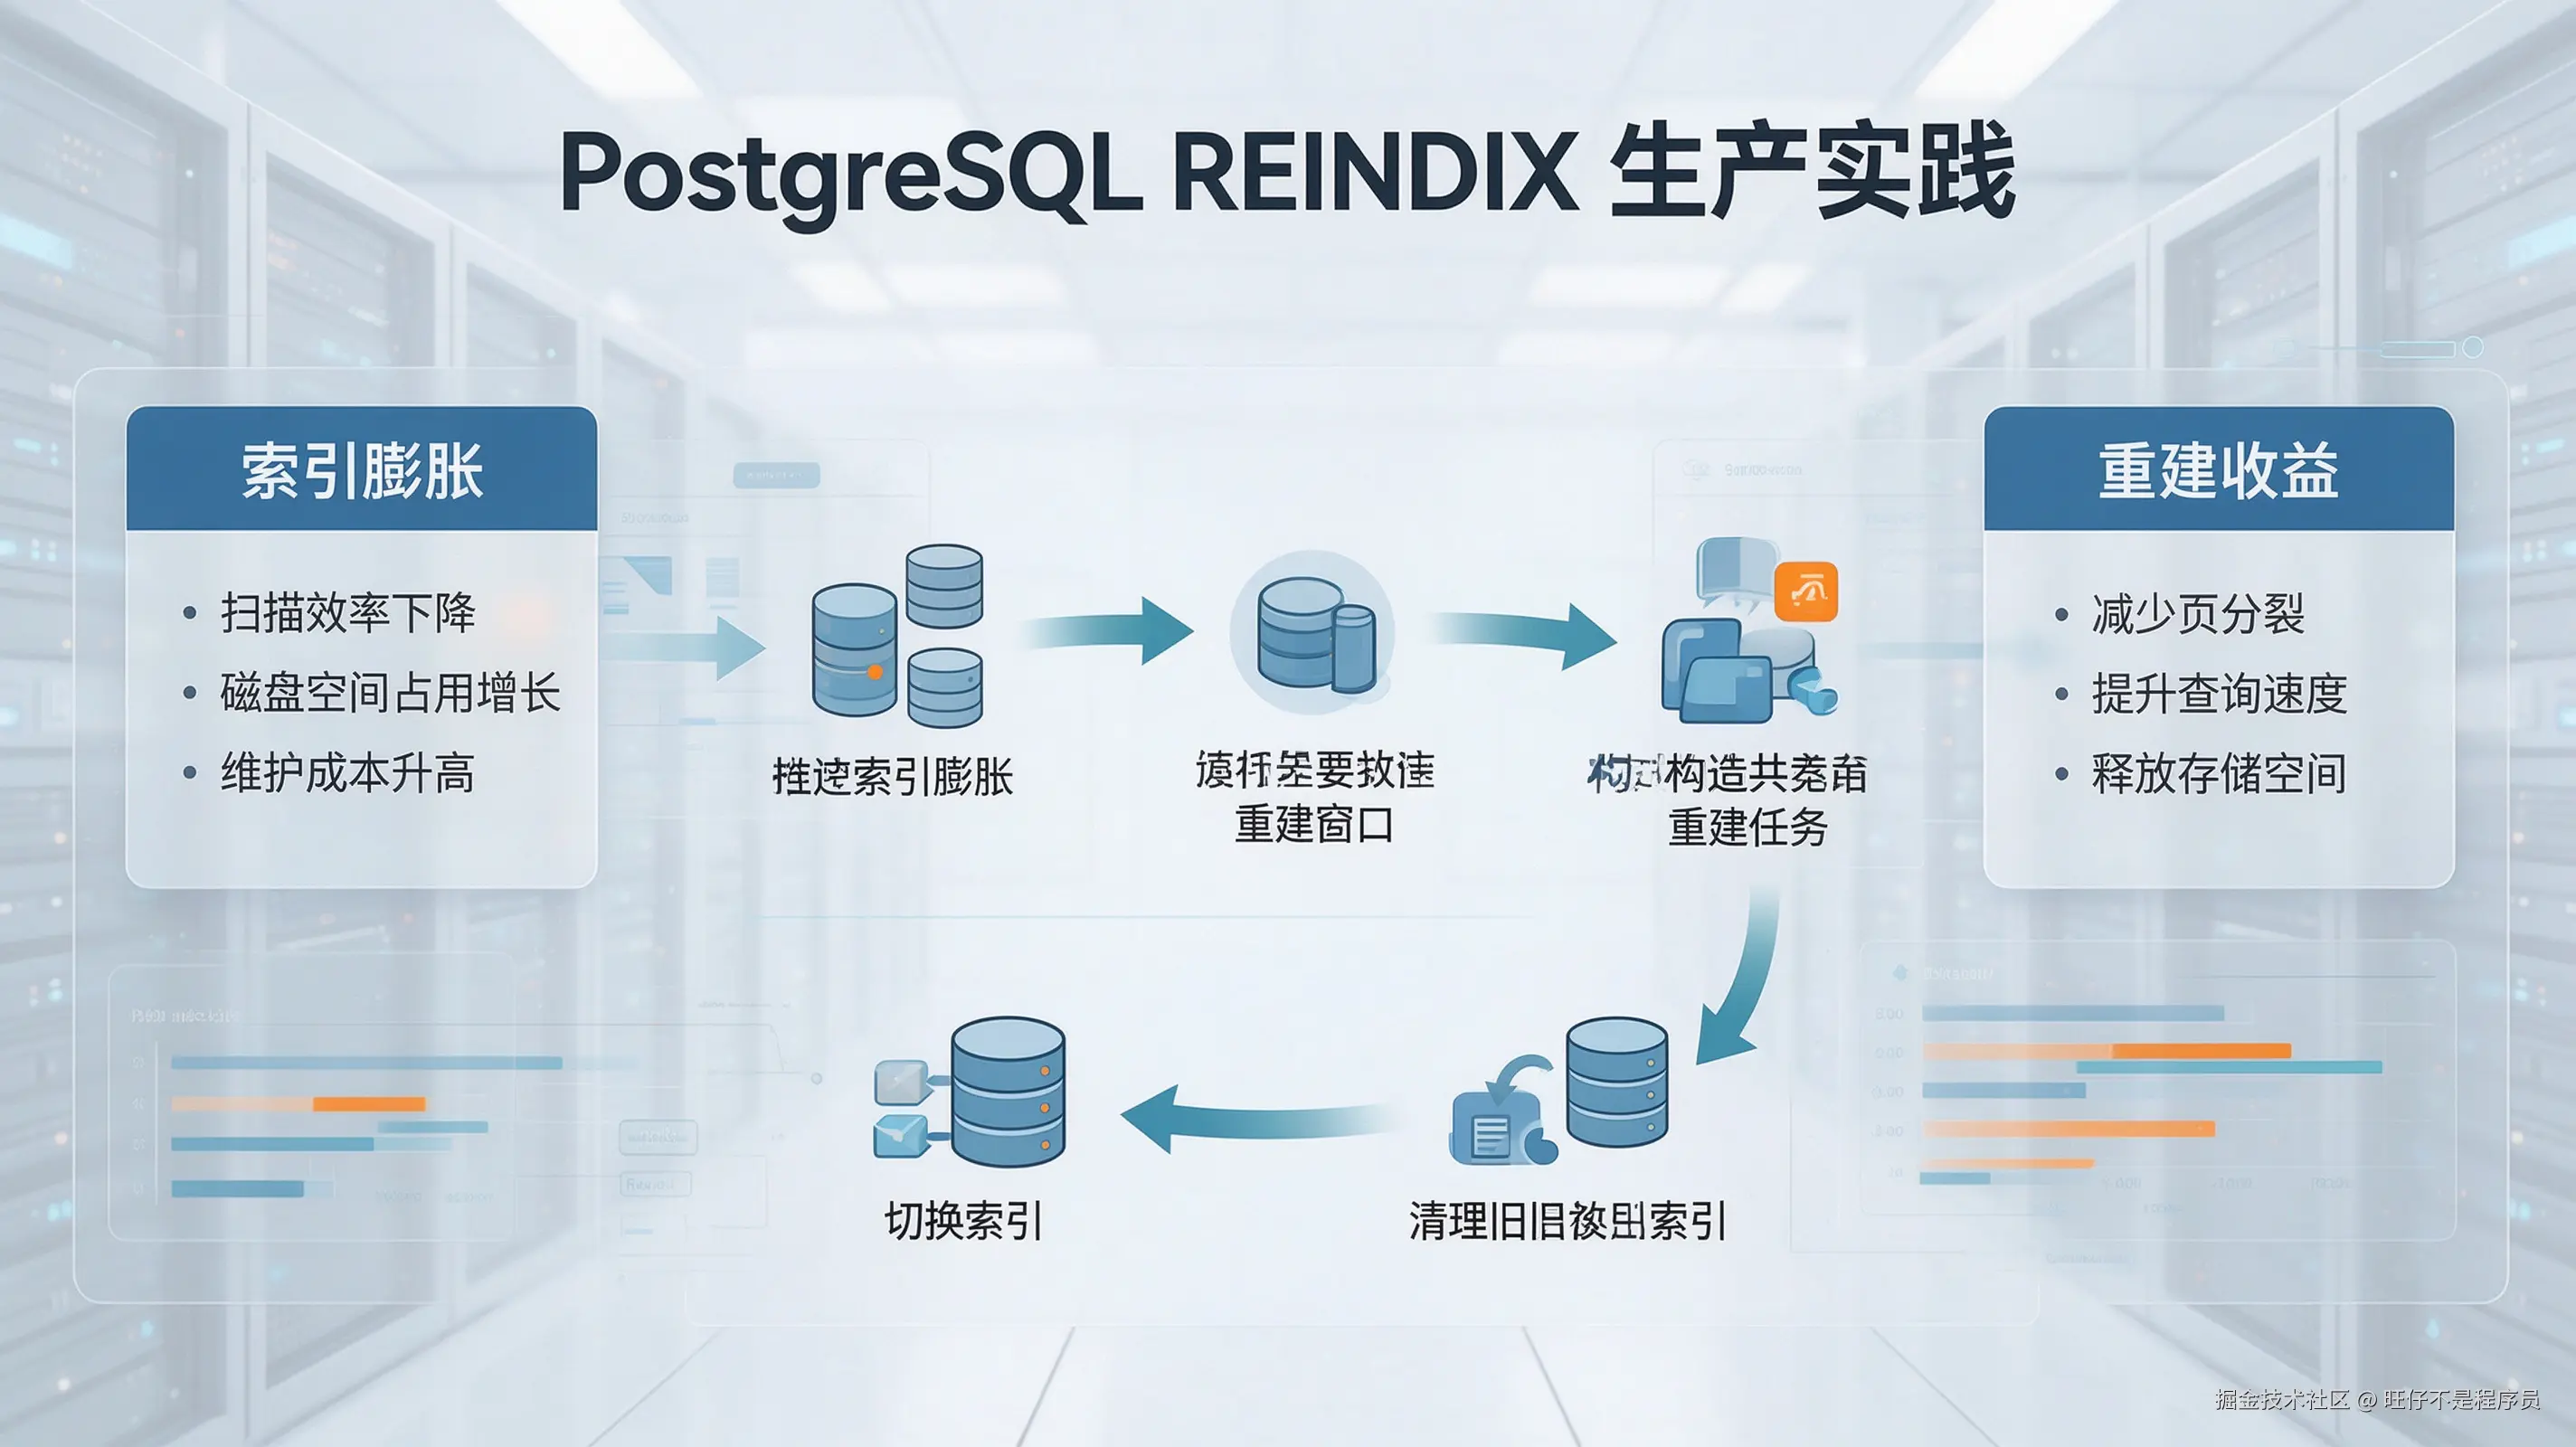
表的 UPDATE / DELETE 越频繁,索引越容易"膨胀":被更新的旧版本残留、被删除的行留下死条目、B-tree 里堆满空页或接近空的页------索引体积虚胖、扫描性能肉眼可见地下降。
重建索引是解决膨胀的标准手段 ,PostgreSQL 提供 REINDEX 命令:用表里当前的数据重建一份全新的索引,替换旧索引------不需要停止数据库 ,但普通 REINDEX 期间会锁表(官方口径:阻塞写入、不阻塞读取),生产环境执行需谨慎。
sql
REINDEX INDEX idx_orders_status;   -- 重建单个索引
REINDEX TABLE orders; -- 重建表上所有索引数据大量更新或删除后,记得重建索引;膨胀严重的表,可以考虑定期重建。
二、核心开发规范
- 大量更新 / 删除后 → 重建索引 :
REINDEX INDEX 索引名;(或REINDEX TABLE 表名;一次重建全部)------清理索引碎片与膨胀,恢复扫描性能; - 生产环境优先
REINDEX INDEX CONCURRENTLY 索引名;(PG 12+ 引入):不阻塞并发插入 / 更新 / 删除;普通 REINDEX 会阻塞写入(不阻塞读取),业务高峰执行有风险; - 定期重建 :高频 UPDATE / DELETE 的表,把重建纳入维护窗口(如业务低峰每日 / 每周),并结合膨胀检测决定是否值得重建。
三、底层原理通俗讲解
- 膨胀怎么来的 :PostgreSQL 的 UPDATE 本质是"删旧行 + 插新行",DELETE 只做标记;B-tree 索引不会立即回收死条目和空页------高频更新 / 删除的表,索引里会积累大量空页或接近空的页(官方 REINDEX 文档原话:索引"膨胀",包含很多空页或接近空的页);
- 为什么 VACUUM 不够 :VACUUM 能回收表里的死元组空间,但 B-tree 索引的膨胀(结构性空页)不一定被 VACUUM 充分回收------索引体量依旧虚胖,扫描性能持续受损,需要 REINDEX 这种"重建"手段;
- REINDEX 原理 :用索引所在表的当前数据重新构建一份全新索引,再替换旧副本------死条目、空页、碎片一次性清零,索引恢复紧凑;
- 锁行为(官方口径) :标准 REINDEX 会阻塞表上的写入 (但不阻塞读取),直到完成;
CONCURRENTLY模式(PG 12+)不获取任何阻止并发插入 / 更新 / 删除的锁,但代价是要扫描表两次、等所有可能使用该索引的事务结束------总工作量更大、耗时更长; - invalid 索引(呼应第 3 篇) :
CREATE INDEX CONCURRENTLY/REINDEX CONCURRENTLY失败会留下 invalid(无效)索引------官方明确:这类索引无用,但可以方便地用 REINDEX 重建; - 定时重建的依据 :官方没有强制"必须定期",但社区生产实践一致------膨胀严重、扫描明显变慢的高频写表,定期重建收益显著。
四、实战错误案例&优化方案
场景1:高频 UPDATE / DELETE 后索引膨胀,性能下降
表设计:orders 表 5000 万行,status 字段频繁更新(订单状态流转),idx_orders_status 索引明显膨胀
❌ 错误做法(发现变慢但放任不管 / 只 VACUUM)
sql
-- 只 VACUUM:回收表的死元组,但 B-tree 索引的空页不一定被回收
VACUUM orders;
-- 索引依旧虚胖,扫描还是慢
✅ 正确做法(先看体积,再 REINDEX 重建)
sql
-- ① 看索引体积(对比正常时期,明显偏大 = 膨胀)
SELECT pg_size_pretty(pg_relation_size('idx_orders_status')) AS idx_size;
-- 例如:正常 200 MB,膨胀后 1.2 GB

-- ② 重建索引(低峰期执行;标准模式阻塞写入、不阻塞读取)
REINDEX INDEX idx_orders_status;

-- ③ 重建后再看体积,恢复紧凑
SELECT pg_size_pretty(pg_relation_size('idx_orders_status')) AS idx_size;
关键结论 :膨胀的索引要 REINDEX 而不是只 VACUUM ------REINDEX 用当前数据重建全新索引,空页、死条目、碎片一次清零;建索引前后对比 pg_relation_size 是验证重建收益最直接的方式。
场景2:生产环境直接 REINDEX,写入被阻塞(核心坑)
表设计:orders 表,业务 7x24,status 高频更新,需要重建膨胀索引
❌ 错误写法(业务高峰直接 REINDEX)
sql
-- 标准 REINDEX 会阻塞表上的写入(不阻塞读取)
REINDEX INDEX idx_orders_status;
-- 订单更新、插入全部排队等待,直到重建完成 → 生产事故
✅ 正确写法(PG 12+ 用 CONCURRENTLY,不锁写)
sql
-- 不获取任何阻止并发插入 / 更新 / 删除的锁
REINDEX INDEX CONCURRENTLY idx_orders_status;

-- 执行期间业务读写照常,代价是两次扫描 + 等待旧事务结束,耗时更长
关键结论 :生产环境重建索引用 CONCURRENTLY(PG 12 起官方支持)------标准 REINDEX 阻塞写入,高峰期是事故隐患;CONCURRENTLY 牺牲一点耗时,换来业务无感。
场景3:PG 12 以下没有 REINDEX CONCURRENTLY 的变通
表设计:老版本(PG 11 及以下),idx_orders_status 膨胀
❌ 错误写法(无脑标准 REINDEX,业务阻塞)
sql
REINDEX INDEX idx_orders_status; -- 阻塞写入,业务高峰危险✅ 正确写法(CONCURRENTLY 建新 + 删旧,等效不锁写)
sql
-- ① 并发建一个新索引
CREATE INDEX CONCURRENTLY idx_orders_status_new ON orders (status);
-- ② 并发删掉旧索引
DROP INDEX CONCURRENTLY idx_orders_status;
-- ③ 改名接替
ALTER INDEX idx_orders_status_new RENAME TO idx_orders_status;
关键结论 :老版本(无 REINDEX CONCURRENTLY)用"并发建新 + 并发删旧"变通------效果等效,且每步都不阻塞读写;注意任何一步失败都可能留下 invalid 索引,需检查清理。
场景4:定期重建策略 + 膨胀检测
表设计:orders 表,每天几十万行 UPDATE / DELETE,希望建立维护机制
✅ 正确做法(定期 + 检测双保险)
sql
-- ① 定期重建(纳入维护窗口,业务低峰执行)
-- 每日/每周 cron:REINDEX INDEX CONCURRENTLY idx_orders_status;

-- ② 用 pgstattuple 精确检测膨胀(比裸看体积更可靠)
CREATE EXTENSION IF NOT EXISTS pgstattuple;
SELECT * FROM pgstatindex('idx_orders_status');
-- avg_leaf_density 过低、leaf_fragmentation 过高 → 该重建了

-- ③ 结合索引使用率决定去留(从来没人用的索引直接 DROP)
SELECT indexrelname, idx_scan, idx_tup_read
FROM pg_stat_user_indexes WHERE relname = 'orders';
-- idx_scan 长期为 0 的索引:膨胀了也没有重建价值,删除
关键结论 :定期重建 + 量化检测 + 使用率评估 三位一体------pgstatindex 看叶密度 / 碎片率决定何时重建,pg_stat_user_indexes 看扫描次数决定索引去留(死索引重建毫无意义,直接 DROP)。
五、绝对禁止的写法汇总
- 数据大量更新 / 删除后放任索引膨胀(只靠 VACUUM,B-tree 空页回收不了,性能持续恶化);
- 业务高峰执行标准 REINDEX(阻塞写入,订单更新全部排队);
- 生产环境能用 CONCURRENTLY 却图快用普通 REINDEX(省的那点时间可能引发事故);
- 不检测就无脑定期重建所有索引(膨胀不严重的索引重建纯属浪费资源;从不使用的索引该 DROP 不是 REINDEX);
REINDEX ... CONCURRENTLY失败后不检查 invalid 索引(官方明确:失败留 invalid 索引,需 REINDEX 重建或 DROP 清理);- 重建完不看体积 / 不 EXPLAIN 验证(膨胀是否真正解决要用数据说话)。
六、最终评审口诀(记住不踩坑)
索引膨胀性能掉,REINDEX来重建好;
生产执行防锁表,CONCURRENTLY要记牢。
七、总结
- 何时重建 :数据被大量更新 / 删除后、索引明显膨胀 / 扫描变慢时;膨胀严重的表可纳入定期重建维护窗口;
- 为什么 REINDEX:VACUUM 回收表死元组但回收不了 B-tree 索引空页;REINDEX 用当前数据重建全新索引,碎片一次清零;
- 怎么重建 :低峰
REINDEX INDEX 索引名;(阻塞写入、不阻塞读取);生产环境用REINDEX INDEX CONCURRENTLY 索引名;(PG 12+,不锁写但耗时更长);PG 12 以下用"并发建新 + 并发删旧"变通; - 配套 :
pgstatindex检测膨胀(叶密度 / 碎片率),pg_stat_user_indexes看使用率(死索引直接 DROP); - 红线 :REINDEX 不需要停库,但标准模式会锁表(阻塞写入),生产执行必须谨慎 + 优先 CONCURRENTLY。
标签:PostgreSQL 数据库 性能优化
参考来源
- PostgreSQL 官方文档 REINDEX(重建场景:损坏 / 膨胀 / 存储参数 / invalid 索引;标准重建锁写不锁读;CONCURRENTLY 需两次扫描并等待旧事务结束)------ www.postgresql.org/docs/curren...
- PostgreSQL 官方文档 12.0 Release Notes(引入 REINDEX CONCURRENTLY,重建索引不阻塞表写入)------ www.postgresql.org/docs/releas...
- PostgreSQL 官方文档 reindexdb(REINDEX 的命令行封装工具)------ www.postgresql.org/docs/curren...