一、问题背景
最近在梳理 Rust 推理库与输入法的集成方案时,发现一个容易被忽略的问题:推理库编译失败,影响的不只是模型功能,还可能导致整个输入法的智能补全、语义纠错等功能无法启动。
例如,输入法原本计划在用户输入文字时,调用本地推理库完成候选词排序或文本纠错。结果在部署环境中,Cargo 编译报错,或者编译虽然通过,加载动态库时却出现符号缺失。
这类问题不能简单归结为"Rust 编译器有问题"。Rust 推理库通常还会依赖 C/C++ 库、模型运行时、系统链接器和特定硬件指令集,问题可能出现在多个环节。
本文结合一个简化的输入法接入场景,整理一套便于复现和逐步定位的处理方法。
二、先判断编译失败发生在哪个阶段
Rust 工程一般通过 Cargo 管理依赖和构建流程。接入推理库后,可以将问题大致分成三个阶段:
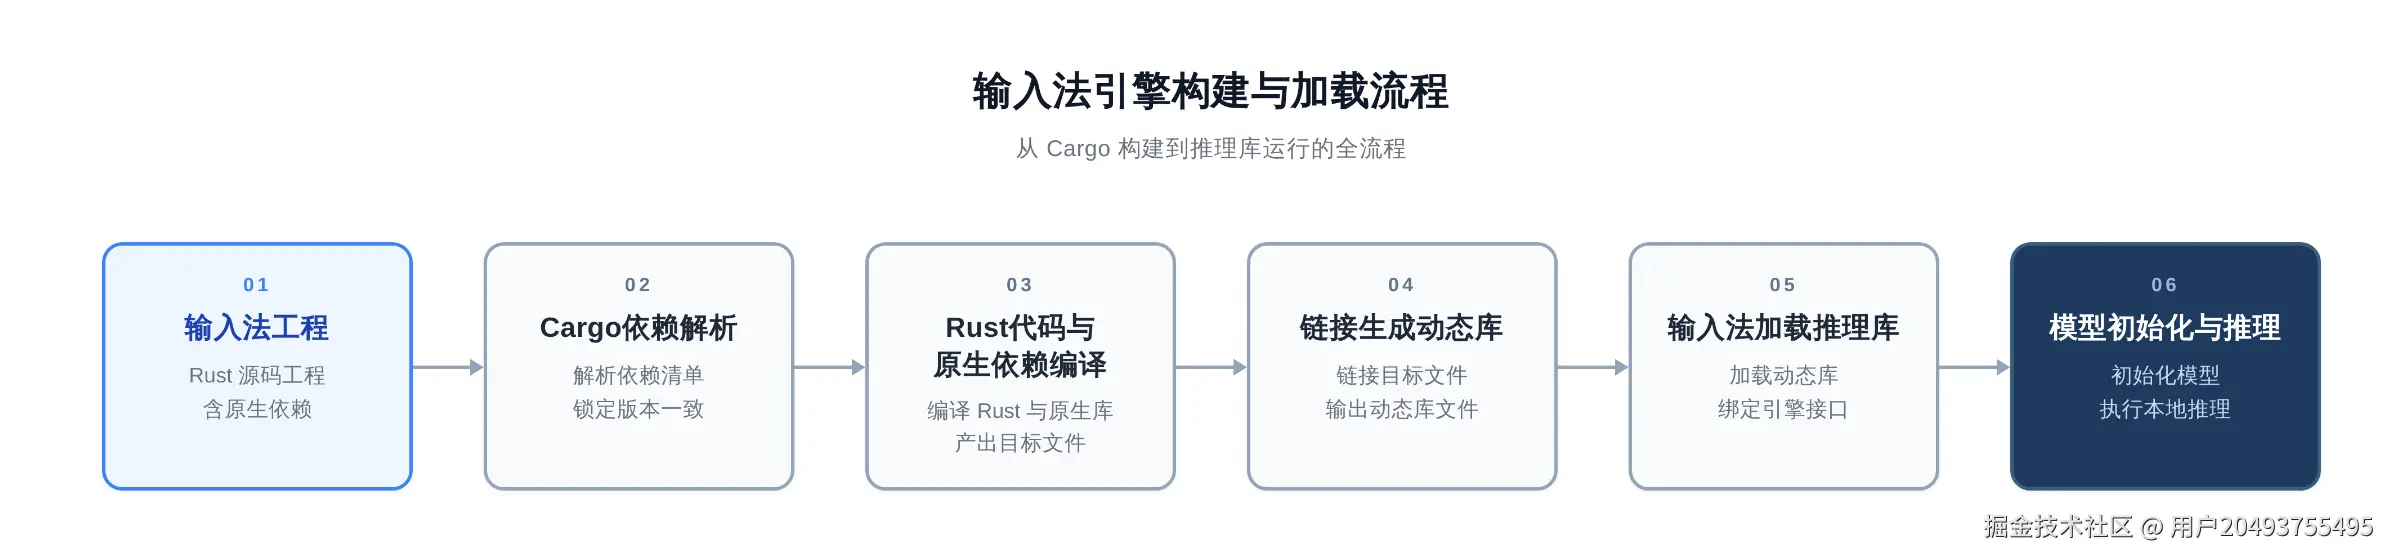 不同阶段的错误,需要使用不同的排查方法。
例如:
failed to select a version:优先检查依赖版本约束。could not compile:查看前面的具体编译错误,不要只看最后一行。cannot find -lxxx:检查链接器搜索路径和目标库。undefined reference:检查符号是否存在、链接顺序及 ABI 是否一致。library not found:检查运行时动态库路径。
尤其要注意,编译错误和运行时加载错误不是一回事。前者发生在构建阶段,后者可能发生在部署之后。
三、检查Rust工具链与Cargo依赖
首先记录当前环境,避免开发机和部署机使用不同版本却没有留下记录。
sql
rustc -V
cargo -V
rustup show
cargo tree
如果项目指定了工具链,可以在工程根目录创建 rust-toolchain.toml:
ini
[toolchain]
channel = "1.81.0"
profile = "minimal"
这里的版本仅为示例,应根据项目依赖和实际验证结果确定。
接着检查 Cargo.toml 中的依赖配置。推理库可能通过特性开关启用不同的计算后端,如果同时打开多个互不兼容的特性,就可能引入额外的原生依赖。
可以先关闭非必要特性,尝试最小化构建:
css
cargo check
cargo tree -i 某个依赖名称
cargo build -vv
cargo check 主要用于检查 Rust 代码,不等同于完整链接验证。最终仍然需要执行实际构建。
-vv 可以帮助观察构建脚本执行情况。Cargo 构建脚本能够通过输出指令向编译流程传递链接库和搜索路径等信息,因此遇到原生依赖问题时,查看详细构建日志很有价值。
参考:Cargo构建脚本文档
四、解决链接器和原生依赖问题
这是 Rust 推理库接入过程中比较容易耗费时间的环节。
假设报错内容为:
go
error: linking with `cc` failed
cannot find -lonnxruntime
这通常意味着链接器没有找到指定的库文件,但也需要结合完整日志确认目标架构和库名称是否正确。
可以按以下顺序检查:
- 推理运行时是否已经安装。
- 库文件是否与当前 CPU 架构一致。
- 当前编译目标是 GNU 还是 musl 等环境。
- 静态库、动态库的选择是否与部署方式一致。
- 链接器搜索路径是否正确。
Linux 下可以查看:
bash
which gcc
which ld
uname -m
Rust 交叉编译时,还要确认目标平台:
css
rustup target list --installed
rustc --print target-list
例如,编译到 ARM64 Linux 时,不能仅因为本机 x86_64 环境可以编译,就认定生成的库能够直接用于 ARM 设备。
Cargo 支持针对不同 target 配置链接器,因此可以根据实际工具链配置,而不是简单地修改全局环境变量。
参考:Cargo目标平台配置
五、使用build.rs管理推理库依赖
如果推理库依赖固定目录中的原生动态库,可以通过构建脚本配置链接路径。
项目目录:
css
rust-ime/
├── Cargo.toml
├── build.rs
└── src/
    └── lib.rs
示例 build.rs:
rust
fn main() {
    let lib_dir = std::env::var("INFER_LIB_DIR")
        .expect("请设置 INFER_LIB_DIR");

    println!("cargo:rustc-link-search=native={}", lib_dir);
    println!("cargo:rustc-link-lib=dylib=onnxruntime");

    println!("cargo:rerun-if-env-changed=INFER_LIB_DIR");
}
在 Cargo.toml 中:
ini
[package]
name = "rust-ime"
version = "0.1.0"
edition = "2021"
build = "build.rs"
这里的 onnxruntime 只是示例库名,实际名称需要与安装的运行时对应。
需要注意,build.rs 负责构建阶段的配置,并不意味着程序运行时一定能找到动态库。部署时仍要处理系统动态库搜索路径、依赖文件分发及版本匹配。
另外,交叉编译场景中,构建脚本运行在宿主机,而生成的目标程序运行在目标平台。不要直接使用宿主机信息推断目标系统,应检查 Cargo 提供的目标环境变量。
六、通过FFI隔离Rust与推理运行时
如果推理库通过 C 接口暴露能力,可以在 Rust 与原生运行时之间增加一层稳定的接口。
例如,C 接口定义:
arduino
int infer_text(
    const char *input,
    char *output,
    unsigned long output_size
);
Rust 侧声明:
rust
use std::ffi::{CStr, CString};
use std::os::raw::{c_char, c_int};

unsafe extern "C" {
    fn infer_text(
        input: *const c_char,
        output: *mut c_char,
        output_size: usize,
    ) -> c_int;
}
上面的代码用于说明接口形式。实际工程中,C 侧的 unsigned long 与 Rust 的 usize 并非在所有平台都具有相同宽度,必须根据真实头文件进行匹配。
FFI 调用还要注意:
- 字符串编码和结尾的
\0。 - 指针有效期及缓冲区大小。
- C 与 Rust 的结构体内存布局。
- 返回值和错误码的定义。
- 不允许异常或 panic 无控制地跨越 ABI 边界。
建议将不安全调用集中在一个模块中,对外只暴露安全的 Rust 方法,避免输入法业务代码到处直接操作裸指针。
七、输入法主线程不要直接执行耗时推理
即使推理库已经成功编译,也不代表输入法集成完成。
如果每次按键都同步执行模型推理,模型初始化、内存分配或计算耗时都可能造成界面卡顿。
比较稳妥的方式是将输入事件与推理任务分开:
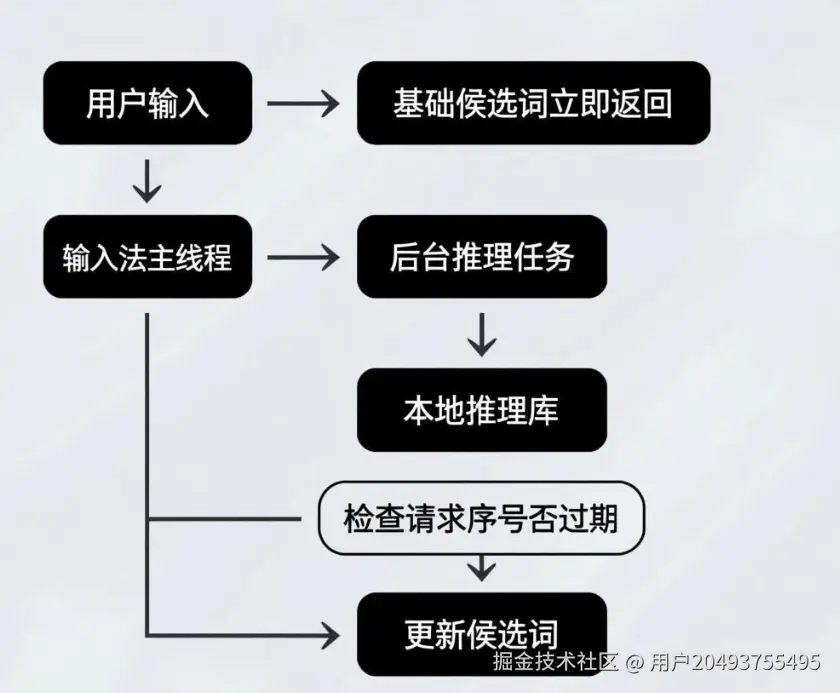
可以给请求增加序号,防止较早的推理结果覆盖较新的输入状态。
rust
use std::sync::atomic::{AtomicU64, Ordering};

static REQUEST_ID: AtomicU64 = AtomicU64::new(0);

fn next_request_id() -> u64 {
    REQUEST_ID.fetch_add(1, Ordering::Relaxed) + 1
}

fn is_latest(id: u64) -> bool {
    REQUEST_ID.load(Ordering::Relaxed) == id
}
这段代码只展示请求版本控制的基本思路。实际项目还需要根据线程模型处理结果回调、取消任务和输入法状态切换。
八、建立可执行的回归测试
修复编译问题后,不建议只验证一次 cargo build。
至少应该覆盖以下测试:
| 测试项 | 验证内容 |
|---|---|
| 干净构建 | 清理构建产物后能否重新编译 |
| 目标平台构建 | 对应系统和架构是否能够生成目标库 |
| 动态库加载 | 输入法能否正常加载推理库 |
| 模型初始化 | 模型文件和运行时能否匹配 |
| 连续输入 | 高频输入时是否出现阻塞或旧结果覆盖 |
| 异常恢复 | 模型加载失败后是否还能使用基础输入功能 |
对于持续集成环境,可以固定 Rust 工具链、依赖锁文件和目标平台,并在每次修改推理库接口后运行最小化回归测试。
九、总结
Rust 推理库编译失败,表面上可能只是一条 Cargo 报错,背后却涉及工具链、原生依赖、链接器、ABI 和运行时部署等多个环节。
实际排查时,建议先定位失败阶段,再逐步验证依赖和链接配置,最后才进入输入法调用链的调试。
在本地智能语音、文本纠错等场景中,包括熙瑾会悟涉及的端侧智能应用,推理能力能否稳定接入,不仅取决于模型效果,也取决于底层工程的可构建性、可部署性和异常恢复能力。
工程上的目标不是让一次编译通过,而是让同一套代码在约定的环境中可以重复构建、可靠加载,并且在推理失败时不影响输入法的基本使用。