装了个 AI Skill 却查不了数据?一篇讲透 Skill 调用接口的三种方式(scripts / CLI / MCP)
最近在研究 AI Skill(技能)开发,遇到一个很典型的问题:技能装好了,却查不了数据。顺着这个问题挖下去,把 Skill 获取数据的架构彻底理了一遍。这篇文章把整个思考过程沉淀下来,适合正在做或准备做 Skill 开发的同学。
一、从一个"翻车"说起
我给一个 AI 助手装了一个数据查询技能,技能文件完整、文档规范,装完一运行------查询失败。
原因很简单:这个技能只有"说明书",没有"数据通道"。
这引出一个很多人容易忽略的认知:
markdown
技能(Skill)= 规程文档(怎么查、怎么展示) + 数据通道(从哪取数)
                ↑ 我们通常只关注这个              ↑ 但它才是能不能跑起来的关键
技能本体可以只是一份 Markdown 说明书,数据通道则有多种实现方式。两者拆开看,很多架构问题就清楚了。
二、三种主流取数架构
方式一:技能自带 scripts/,直连 OpenAPI
技能包里直接放脚本,调用对方的 HTTP 接口:
perl
my-skill/
├── SKILL.md          # 规程:怎么调、怎么校验、怎么展示
└── scripts/
    ├── call.mjs      # CLI 入口(零 npm 依赖,Node ≥ 18 原生 fetch)
    ├── apis/         # 端点注册表
    └── lib/          # HTTP client、参数校验
实测一次调用,输出协议长这样:
json
{
  "ok": true,
  "message": "POST https://api.example.com/v2/product/detail 成功 (200, 126ms)",
  "request": { "method": "POST", "status": 200, "durationMs": 126 },
  "data": {
    "code": "000000",
    "msg": "成功",
    "data": { "productName": "示例商品名称", "...": "..." }
  }
}
特点:装完即用、零外部依赖、分发最简单。 适合接口公开无鉴权的场景。
方式二:本地 CLI 负责鉴权,数据走任意通道
厂商提供官方 CLI,首次使用时在对话里完成登录(典型如短信验证码),凭证落地本机:
bash
xxx-cli init status                  # 检查是否已初始化
xxx-cli init setup --phone 138xxxx   # 发验证码
xxx-cli init setup --verify-code 123456  # 完成初始化,apiKey 自动写入本机
之后数据查询可以走 MCP,也可以继续走 CLI。首次配置在对话里闭环完成,不用去网页开通再回来配凭证,转化路径短得多。
方式三:纯 MCP 挂载,技能只是说明书
技能一个脚本都不带,全部数据能力依赖宿主挂载的 MCP 工具:
bash
技能文档里声明:本技能依赖以下 6 个 MCP 工具
├── xxx_search            # 按名称搜索
├── xxx_query_profile     # 详情
├── xxx_query_orders      # 订单列表
└── ...
工具不在场,技能就是空转。这是数据厂商最常见的开放方式。
三种方式横向对比
| 维度 | 方式一:scripts 直连 | 方式二:本地 CLI 鉴权 | 方式三:纯 MCP 挂载 |
|---|---|---|---|
| 技能包内容 | 说明书 + 脚本 | 说明书(CLI 单独安装) | 只有说明书 |
| 数据通道 | 脚本直连 OpenAPI | CLI / MCP 均可 | 宿主挂载的 MCP 工具 |
| 鉴权能力 | 无(适合公开接口) | 有(对话里闭环初始化) | 取决于 MCP 服务端 |
| 装完即用 | ✅ 零外部依赖 | ❌ 需先初始化 CLI | ❌ 依赖宿主已挂载工具 |
| 首次配置成本 | 无 | 中(验证码登录) | 高(需在宿主侧配置) |
| 可移植性 | 最强,拷走就能跑 | 中,依赖本机 CLI | 弱,换宿主要重配 MCP |
| 适用场景 | 公开无鉴权接口 | 需要登录态的数据源 | 厂商只开放 MCP 的场景 |
三、MCP 的两种形态:本地 stdio vs 远程托管
配过 MCP 的都知道,配置文件里有两种长得很不一样的写法:
jsonc
{
  "mcpServers": {
    // 本地 stdio 型:要在本机起进程
    "local-one": {
      "command": "npx",
      "args": ["-y", "some-mcp"],
      "env": { "TOKEN": "xxx" }
    }
    // 远程型:只配服务地址 + 凭证
    // "remote-one": { "url": "https://mcp.vendor.com/sse", "headers": { ... } }
  }
}
架构差异
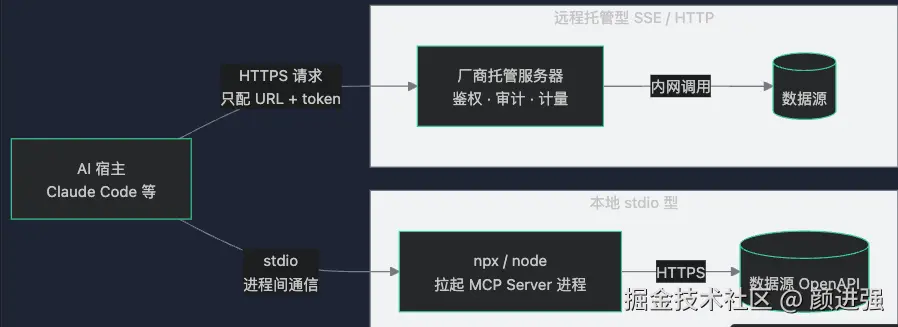 对照着看更直观:
| 环节 | 本地 stdio | 远程托管 |
|---|---|---|
| 进程位置 | MCP Server 跑在本机 | 跑在厂商服务器,本机无进程 |
| 通信方式 | stdin/stdout(进程间,最低延迟) | HTTPS(多一跳网络) |
| 凭证存放 | 本地明文(env 配置文件) | 托管在服务端,可吊销可轮换 |
| 谁执行第三方代码 | 你的电脑(供应链风险自担) | 厂商侧 |
优缺点对照
| 维度 | 本地 stdio | 远程托管 |
|---|---|---|
| 网络依赖 | 可离线、可内网(连 127.0.0.1 都行) | 断网即失效 |
| 本地环境 | 依赖运行时版本,有安装/路径坑 | 零依赖 |
| 延迟 | 进程间通信,最低 | 多一跳 HTTPS |
| 凭证 | 本地明文(env) | 托管在服务端,可吊销可轮换 |
| 版本 | 本地锁定,可能碎片化 | 服务端统一,更新无感 |
| 安全边界 | 本机执行第三方代码(供应链风险) | 本机不跑第三方代码 |
| 审计 | 无 | 每次调用可计量可追溯 |
| 供应商风险 | 包在本地,跑多久自己说了算 | 服务下线即失能 |
一句话:本地型的本质是"主权在你",远程型的本质是"主权和责任都在厂商"。
选型口诀
操作本机资源(文件/浏览器/本地服务)→ 本地 stdio
云端数据 + 需要账号鉴权             → 远程 SSE/HTTP
两者都要                            → 混合架构(最优解)
四、实战:两个真实技能的"镜像设计"
我对比了两个同领域、不同架构的技能,发现它们像一面镜子:
| scripts 直连方案 | MCP 挂载方案(厂商授权向) | |
|---|---|---|
| 设计哲学 | 工程优先:自包含、装完即用 | 授权优先:统一通道、口径统一 |
| 防错方式 | 协议层(代码保证) | 指令层(规则约束) |
| 强项 | 可移植、扩展、传输健壮 | 防错规则密度、合规完整度 |
| 短板 | 数据源灰色、无鉴权预留 | 硬依赖 MCP、开通路径重 |
防错的两种实现,值得细品
协议层防错(scripts 方案)------用代码让错误不可能被当数据读:
一次调用有两层成功标识,必须都通过:
text
① CLI 层:stdout 信封 ok === true   (false = 网络/参数问题)
② 业务层:data.code === "000000"    (其他值 = 业务失败)
为什么必须有第二层?实测见过这种返回:
json
{
  "ok": true,           // ← HTTP 层面成功了
  "data": {
    "code": "000999",   // ← 但业务层失败了!
    "msg": "网络不好,请稍后重试",
    "data": null
  }
}
如果只看 HTTP 状态码,AI 会把"网络不好请稍后重试"当成业务数据读进报告。双层信封在协议层面堵死了这个坑。
指令层防错(MCP 方案)------用规则约束 AI 的行为边界:
这份技能规约里的每一条,背后都是一个真实的 AI 翻车场景:
| 规则 | 防住的翻车场景 |
|---|---|
| "纯 6 位数字搜了 0 条也还是编号" | AI 拿编号硬搜名称,0 条后改口"没有这个条目" |
| "连不上不等于没开通" | 把网络超时误报成"您未开通服务" |
| "当前页只有一条,不能自动选" | AI 偷懒跳过用户确认环节 |
| "空列表要先有成功的概况,才能说暂无数据" | 把接口失败说成"没有记录" |
| "不要向用户要密钥、验证码或密码" | 凭证泄露 |
我的结论:协议层更硬(代码保证),指令层覆盖面更广(语义级错误代码防不了)。成熟技能应该两层都要。
写在最后
这轮研究最大的收获是一个认知转变:
"技能装完不能用"不是 bug,是架构设计的信息------它告诉你这个技能的数据主权在谁手里。
本地 scripts、本地 CLI、远程 MCP,三种方式没有绝对优劣,只有场景匹配。理解了"规程 + 通道"的分离,再看任何一个 Skill,你都能在五分钟内判断出它的架构、依赖和接入成本。