13张图讲透RAG:从"向量是什么"到评测体系的Spring AI实战
本文是一次完整的 RAG 学习与实战记录:从"embedding 到底是什么"一路走到"评测体系量化检索质量",配 13 张手绘概念图和四个渐进式任务的真实代码。 技术栈:Spring Boot 3.4 + Spring AI 1.0.0-M6 + PostgreSQL(pgvector) + 阿里百炼(text-embedding-v3 / qwen3-rerank / qwen 生成模型)。 完整代码见仓库(文末有结构说明),分块(chunking)策略留到下一篇。
〇、先看全景:RAG 到底在干什么
一句话:大模型是开卷考试的考生,RAG 就是考前把参考资料塞给它。
大模型有两个天生缺陷:知识有截止日期、不知道你公司内部的私有数据。RAG(Retrieval-Augmented Generation,检索增强生成)的解法很朴素------用户提问时,先从你的私有知识库里检索 出相关内容,拼进 Prompt,再让大模型生成回答。
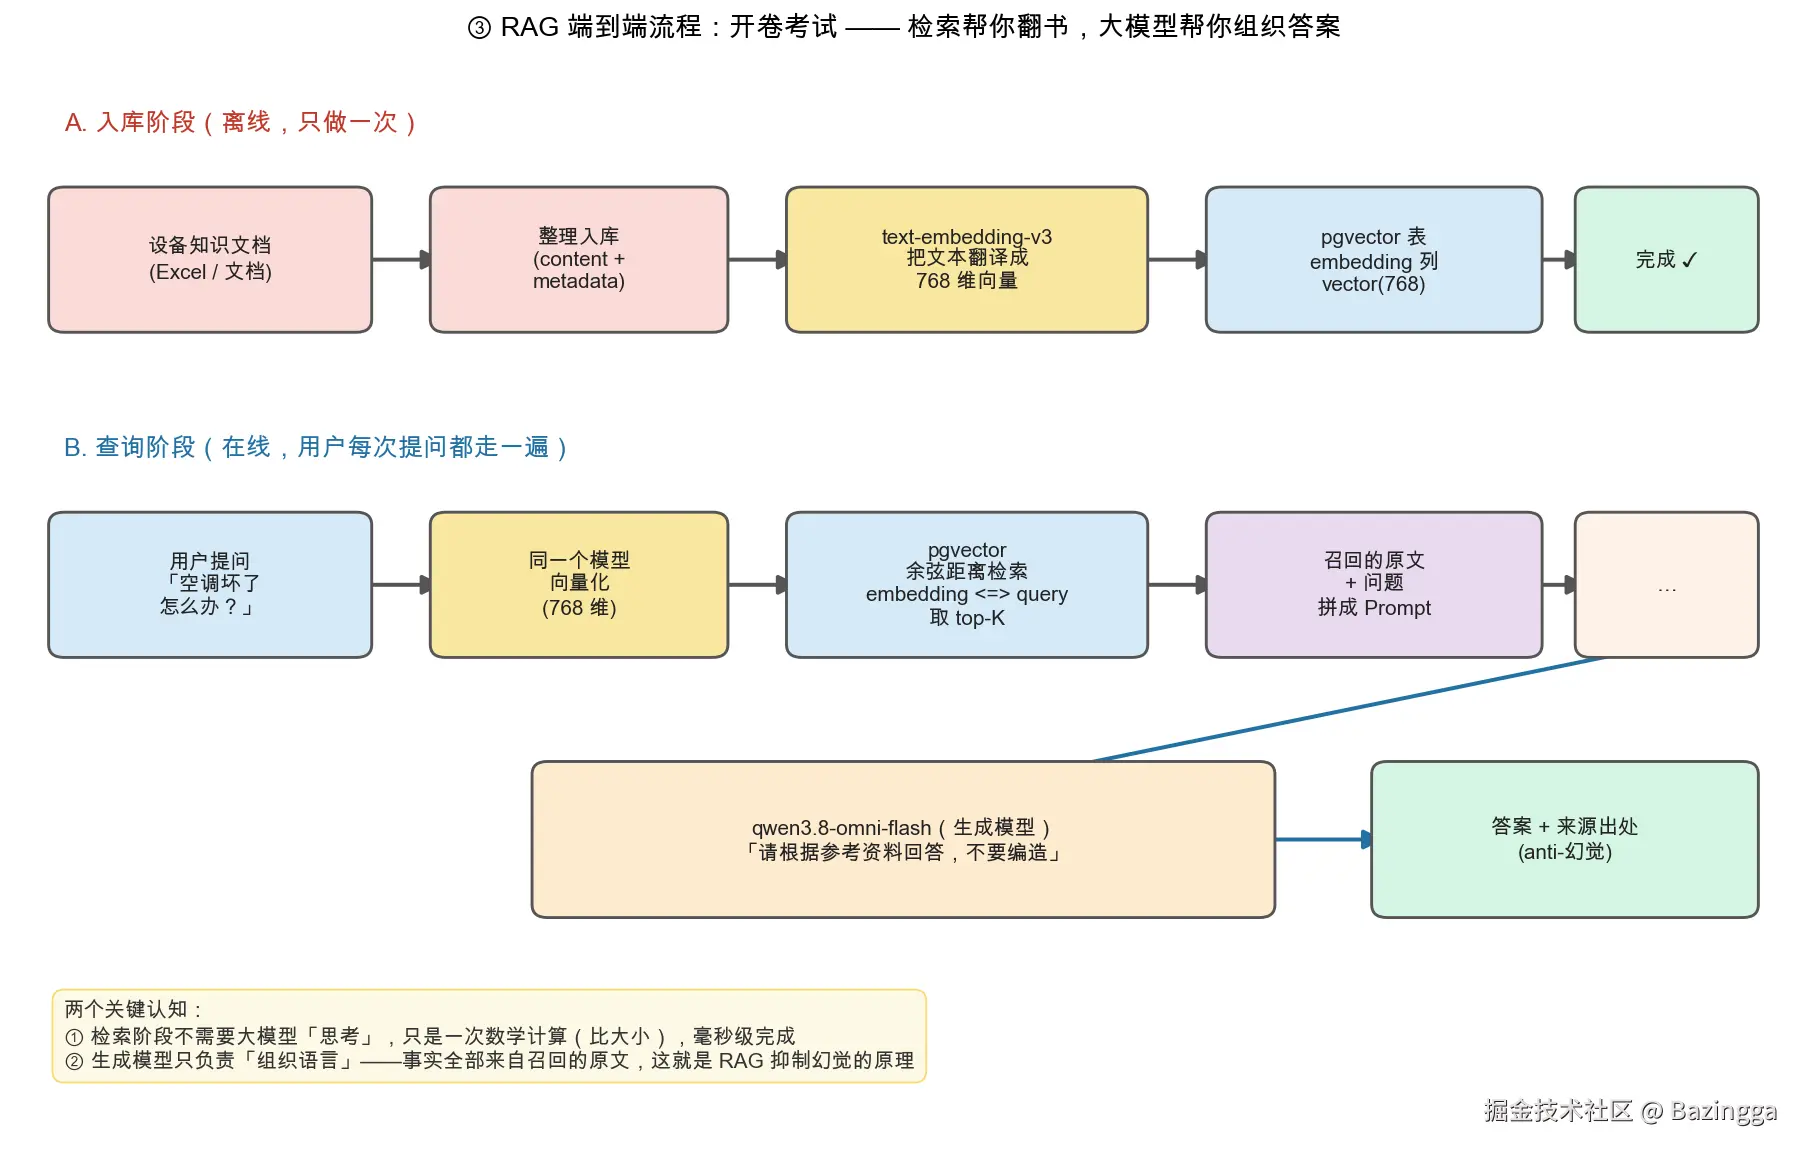 一次完整的 RAG 链路分两个阶段:
- 离线阶段(入库):文档 → 解析 → 分块 → 向量化(embedding)→ 存入向量数据库
- 在线阶段(问答):用户问题 → 向量化 → 相似度检索(召回)→ (可选)重排序 → 拼 Prompt → 大模型生成
我这次的实战数据是一份真实业务数据:XXX AGV 故障清单(约 260 条故障处理知识),目标是做一个"设备运维问答助手"。
下面按"概念 → 实战 → 生产 → 总结"的顺序展开。
一、核心概念:五个必须想透的问题
1.1 向量化的本质:把文字变成"语义坐标"
"向量"这个词听着抽象,拆开其实很朴素:一组用来标记事物的数字。从最熟悉的场景说起:
- 在地图上标记杭州,两个数字就够了:东经 120.15°、北纬 30.27°------用 2 个数字标记一个地点,这就是 2 维;
- 要标记"一个人",两个数字不够用了,得三个:身高 175、体重 70、年龄 30------用 3 个数字标记一个人,这就是 3 维。(175, 70, 30) 这串数字,就是一个最朴素的向量。
顺着这个思路问下去:要标记一段话的含义,得用几个数字?------768 个。
这就是 embedding 的全部含义:把一段文本翻译成 768 个数字(术语叫"768 维向量"),语义相近的文本,这串数字就相近。就像"AGV 充不进电"和"电量无增加"这两句话字面上几乎不沾边,但它们在 768 个数字上的读数高度接近------好比两个身高、体重、年龄全都接近的人,在"人海"里就是紧挨着的。
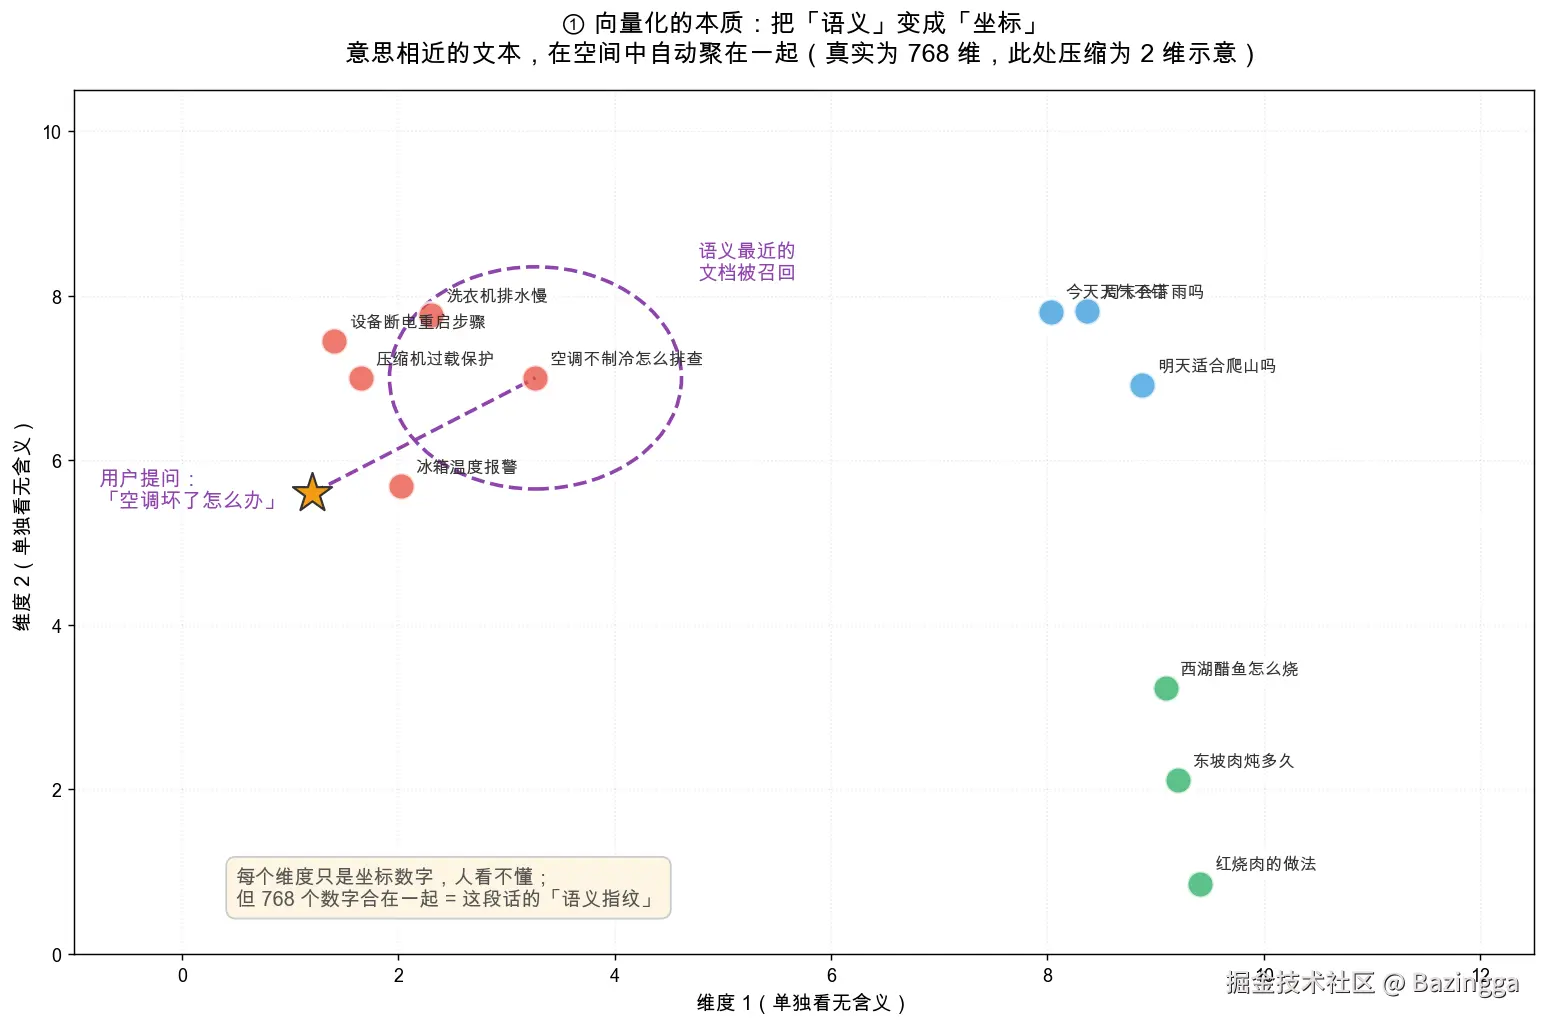
上图是把 768 维强行压缩成 2 维画在纸面上------和你平时看地图是同一个道理。效果一目了然:意思相近的文本自动聚成一团,"AGV 充不进电"和"电量无增加"落在同一片街区,"红烧肉怎么做"在几公里外。向量化模型干的就是"给每段文字分配坐标"的测绘活。
那这 768 个数字分别是什么含义?没有人类可读的答案------不像"身高"那样每个维度都有名字。只能粗略理解为 768 个语义刻度 :第 1 维可能在衡量"是否跟设备相关"、第 2 维在衡量"是否跟故障相关"......每个维度度量语义的一个侧面,768 个侧面合在一起,就是这段话的"语义指纹"。我用的 text-embedding-v3 输出 768 维(默认 1024 维,可选 1024/768/512/256/128/64)。
两个工程约束必须记住:
- 维度必须前后一致 :向量一旦算出,维度就不能再变------后面任务 1 建表用的列类型是
vector(768),所以代码调 embedding 接口时要显式传dimensions=768,两边必须对齐; - 问题向量和文档向量必须是同一个模型算的------同一张地图上的坐标才有可比性。
1.2 检索怎么算"像不像":余弦相似度与余弦距离
向量有了(问题是一串数字,每份文档也各是一串数字),怎么判断两串数字"近"?答案是余弦相似度 :把每串数字看作从原点出发的一支箭头,只比较两支箭头的夹角,不管箭头画多长。
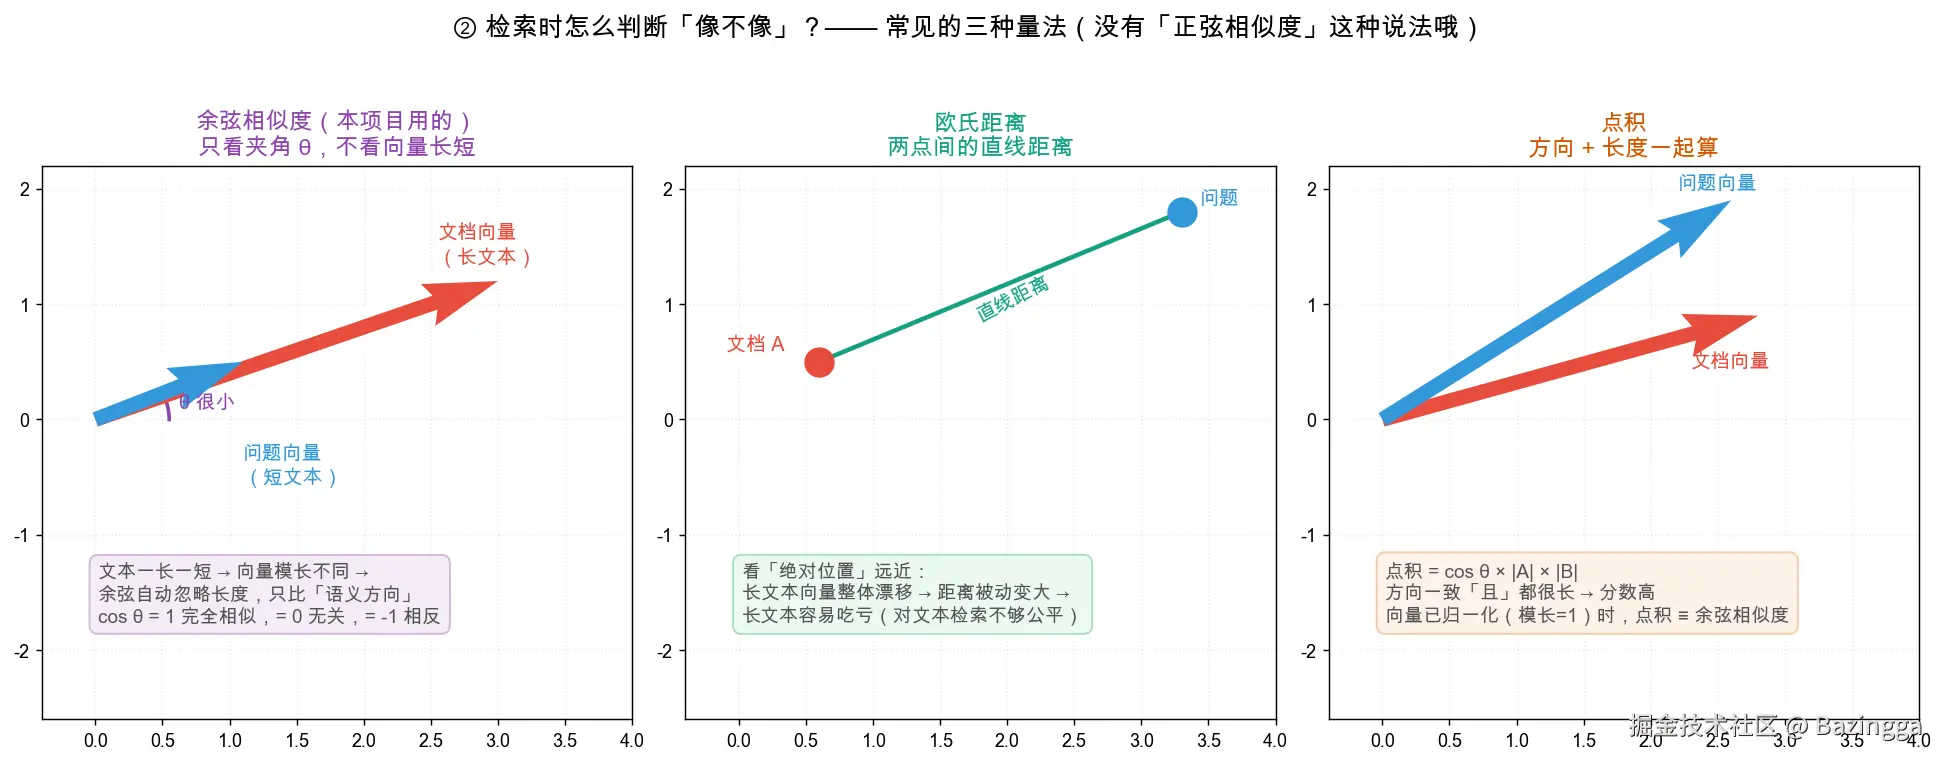
\\text{余弦相似度} = \\cos\\theta \\quad\\quad \\text{余弦距离} = 1 - \\cos\\theta
| 余弦相似度 | 余弦距离(pgvector 返回的) | |
|---|---|---|
| 完全相关 | 1 | 0 |
| 无关 | 0 | 1 |
| 使用习惯 | 越大越像 | 越小越像 |
一个我亲身踩过的认知坑 :接口里返回的 distance 字段,我一开始以为是余弦相似度------实际是余弦距离 ,方向完全相反!看到 distance: 0.28 要读成"相似度 0.72,挺相关"。
pgvector 提供三种距离算子,全部"越小越像":
sql
<=>  余弦距离(本工程使用,适合长短文本比较)
<->  欧氏距离(直线距离)
<#>  负内积
检索 SQL 的核心就一行:
sql
SELECT id, content, metadata,
       (embedding <=> '[0.1,0.2,...]'::vector) AS distance
FROM device_docs
ORDER BY embedding <=> '[0.1,0.2,...]'::vector
LIMIT 3;
1.3 模型分工:嵌入、重排、生成是三个工种
到这里先盘点一下:〇章的链路图里其实出现了三种不同的模型调用------打坐标的(向量化环节)、重排的(可选精排环节)、写答案的(生成环节)。它们不是一个模型干三件事,而是三种工种不同的模型。百炼平台上的模型按"输出什么"分三班:
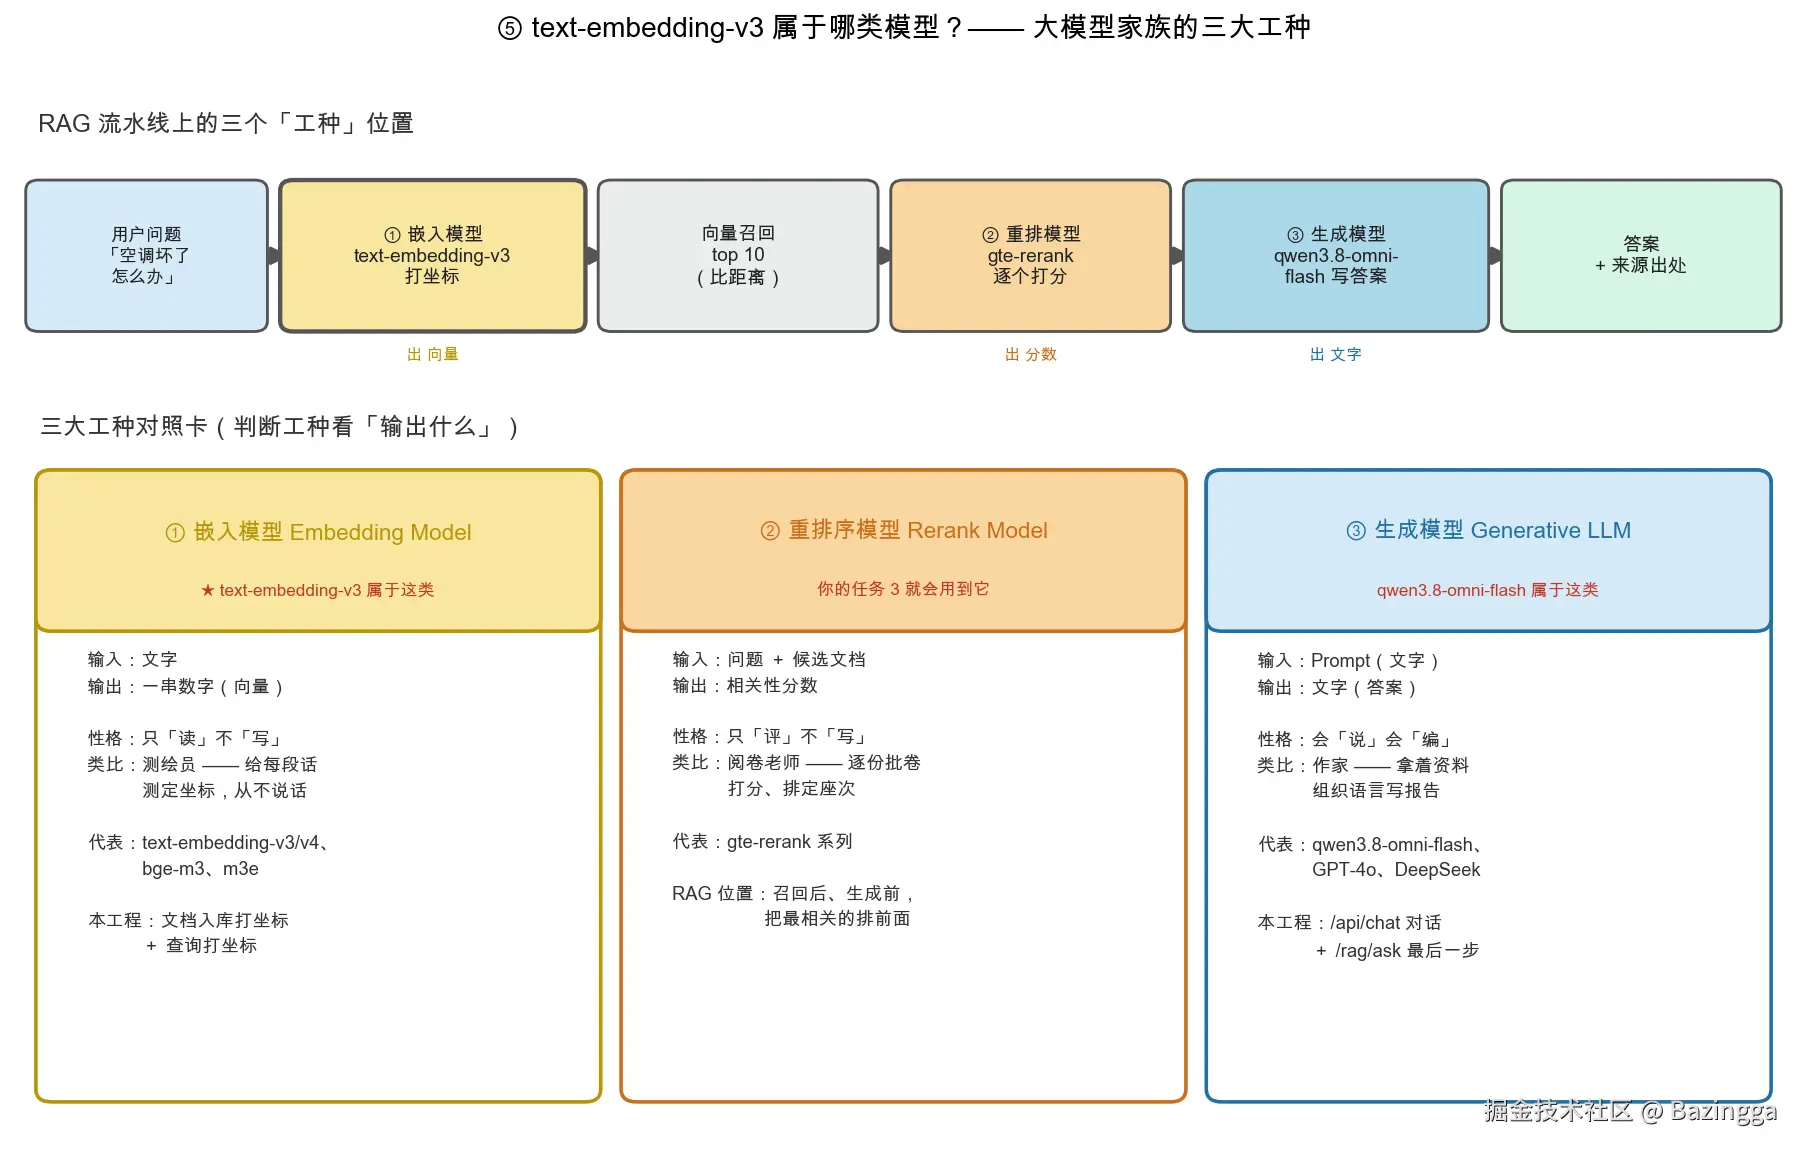
| 工种 | 输出 | 代表 | 用在哪 |
|---|---|---|---|
| 嵌入模型 | 向量(坐标) | text-embedding-v3 | 入库打标、查询打标 |
| 重排模型 | 分数(0~1) | qwen3-rerank | 精排候选文档 |
| 生成模型 | 文字 | qwen 系列 | 最终回答 |
当然,这只是文本处理这条线上的三个工种。把视野放宽,按"输入什么、输出什么"还能数出一串别的工种(都在百炼平台上能找到):
| 工种 | 输出 | 代表 | 用在哪 |
|---|---|---|---|
| 视觉理解 | 文字(对图片的回答) | qwen-vl | 拍照识物、图纸问答、截图排障 |
| 图像生成 | 图片 | 通义万相(wanx) | 海报、插画配图 |
| 语音识别(ASR) | 文字(听写稿) | Paraformer | 会议转写、语音输入 |
| 语音合成(TTS) | 语音 | CosyVoice | 智能客服配音、有声书 |
| 多模态 | 图文音混合 | qwen-omni 系列 | 边看图边对话、视频理解 |
(顺带一提:我项目里生成模型 qwen3.8-omni-flash 名字里的 "omni" 就是"全能"的意思------它本身就出身多模态家族。)
这些工种同样能接进 RAG 链路:比如"语音提问 → ASR 转文字 → 文本 RAG 检索生成 → TTS 把答案念出来",就是一套语音版运维助手。本文聚焦最经典的文本 RAG,其他工种按下不表。
顺带厘清一个常见叫法:text-embedding-v3 常被叫作"向量模型",正式归类是嵌入模型 ------同一个东西,一个俗称、一个工种名。它的规格(以官方文档为准):单条最长 8192 token,批量一次最多 10 条(这个限制直接决定了后面批量向量化的代码写法)。
1.4 双塔模式:检索为什么快而粗
1.2 说检索就是"比两个向量的夹角"。这里有个容易被忽略、却决定了整条 RAG 链路形态的细节:问题向量和文档向量是各自单独算出来的------用户提问时,问题单独过一遍嵌入模型;每份文档入库时,文档也单独过一遍同一个模型。两边从头到尾没见过面,算完各拿一个向量,事后只比夹角。
这个工作方式有个名字:双塔(Bi-Encoder)------两座塔各自独立编码。它不是某个模型的可选特性,而是所有嵌入模型的通用架构。
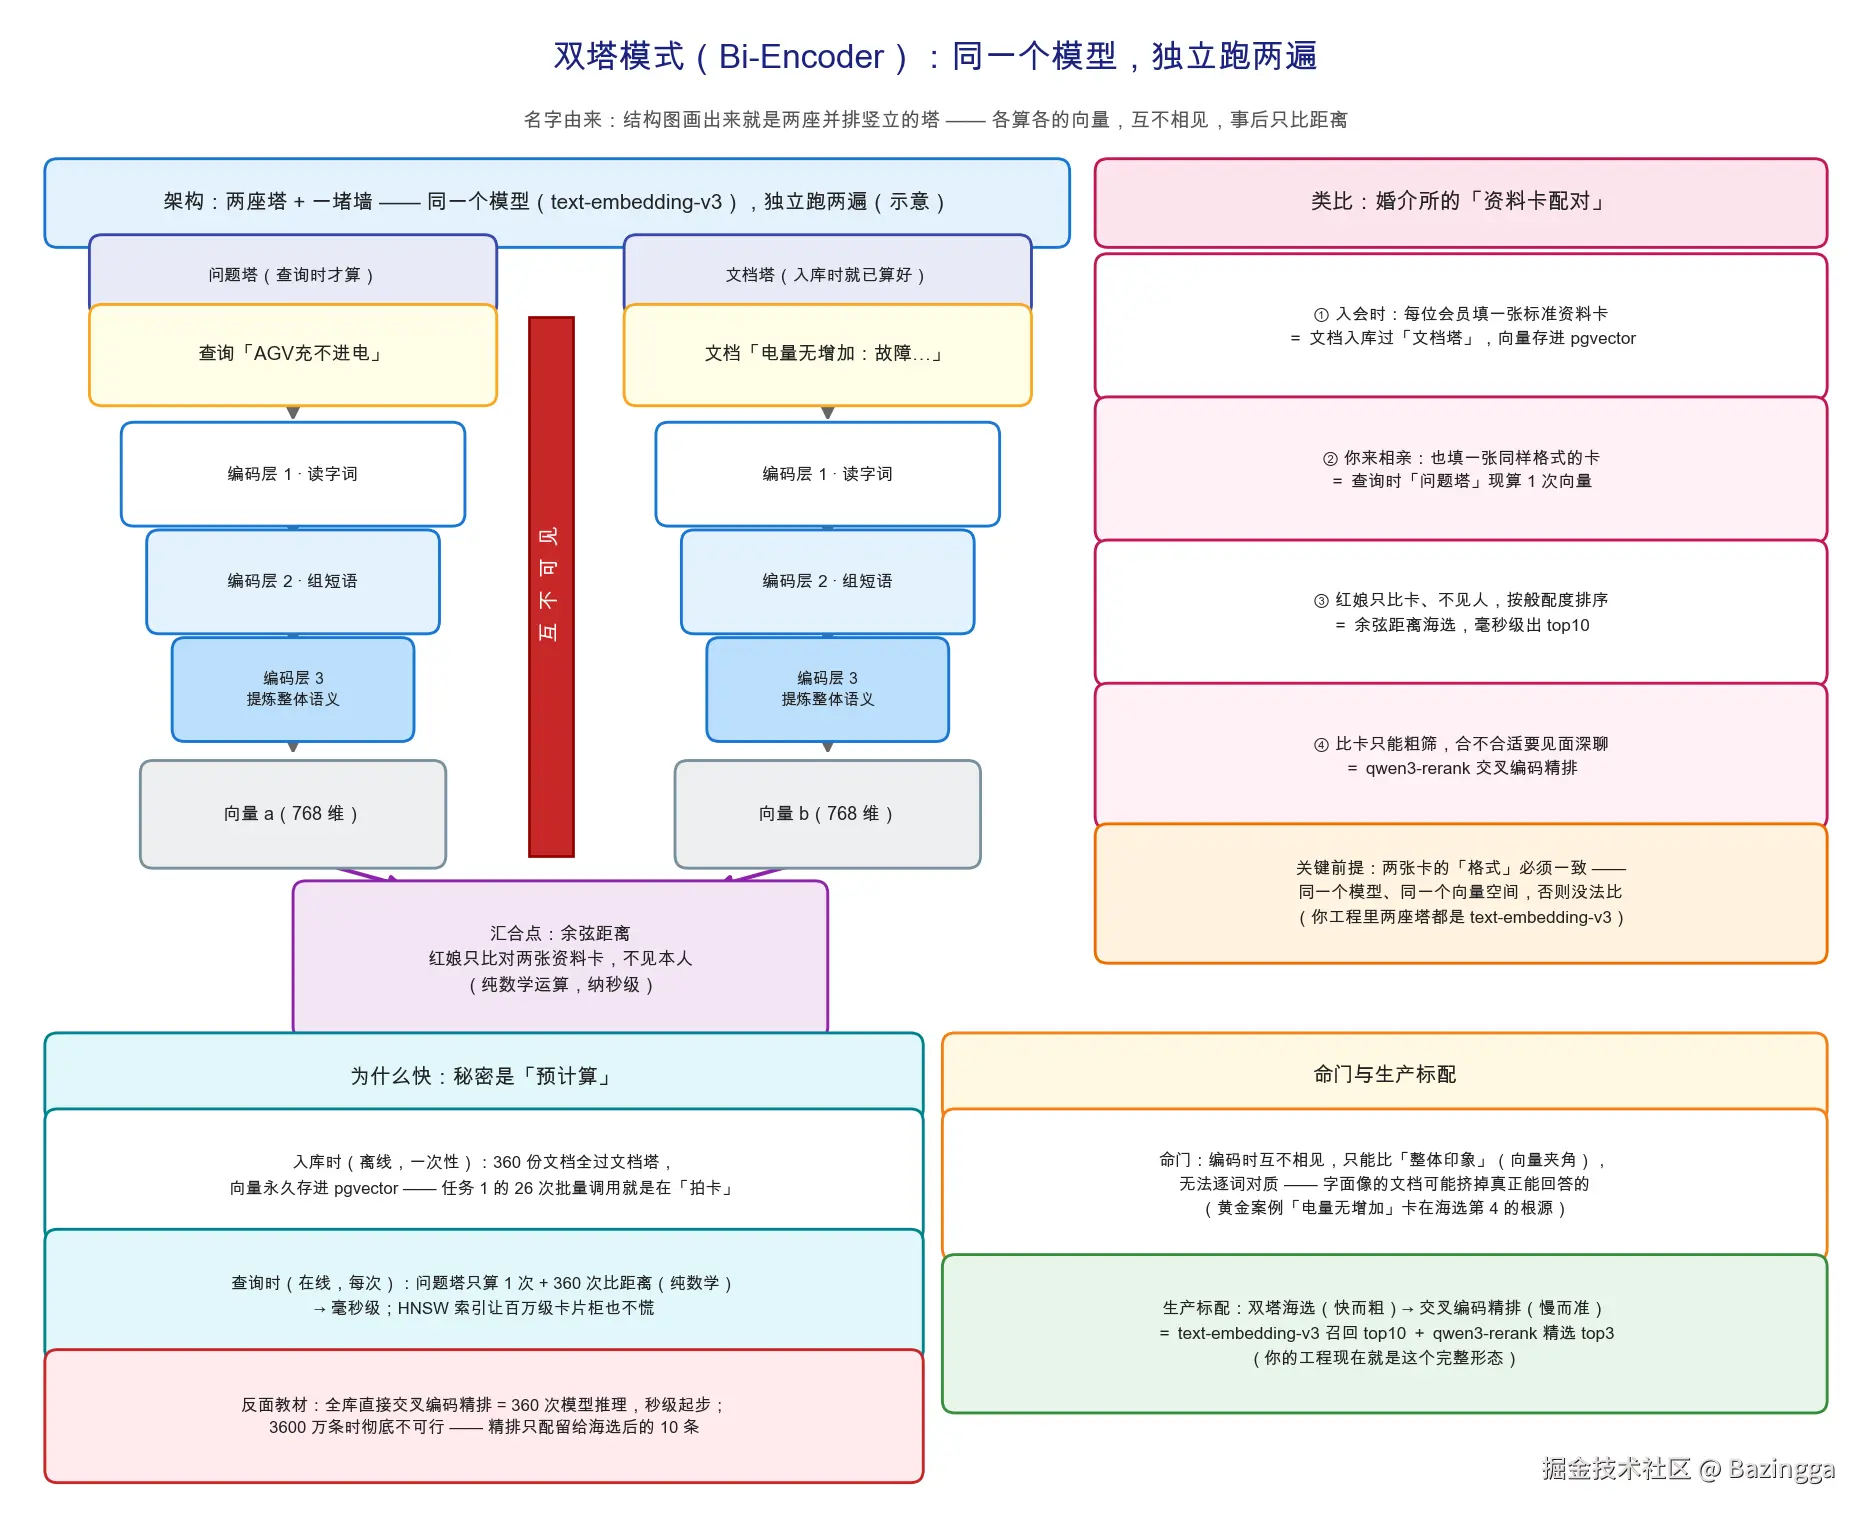
婚介所类比:会员入会时填一张标准资料卡(文档入库时预计算向量存库),你来相亲也填一张同格式的卡(查询时现算一次向量),红娘只比卡不见人(余弦距离纯数学运算,毫秒级),合不合适要见面深聊(rerank 精排)。
快的原因是预计算:260 份文档入库时就算好向量存进 pgvector,查询时只需现场算 1 次问题向量 + 260 次比距离(纯数学运算,毫秒级)。反过来,如果每次查询都要"问题×全部文档"送进模型逐对精算,260 份就是 260 次模型推理,秒级起步,百万文档时彻底不可行------双塔用"不见面"换来了检索的可行性。
粗的代价也在这里:两塔互不相见,只能比"整体印象"。字面全是"充""电"的文档,整体印象和"AGV 充不进电"很像------哪怕它其实答非所问。这个"粗"不是缺陷而是权衡,它也正是任务 3 引入 rerank 精排的全部理由------这里先欠着,到时候还。
1.5 metadata:贴在内容上的快递面单
回收一个 1.2 埋下的细节:那条检索 SQL 的 SELECT 里,除了 content 还带出一列 metadata,当时没有展开------它正是向量之外的第二根检索支柱。向量数据库里每条记录由两部分组成:
- content(正文) :故障描述、处理方法全文------收件人是大模型,只有它"拆包裹"逐字阅读
- metadata(标签) :设备类型、故障编号、来源文件......------看面单的是分拣员(SQL),从不拆包裹却能精准分流
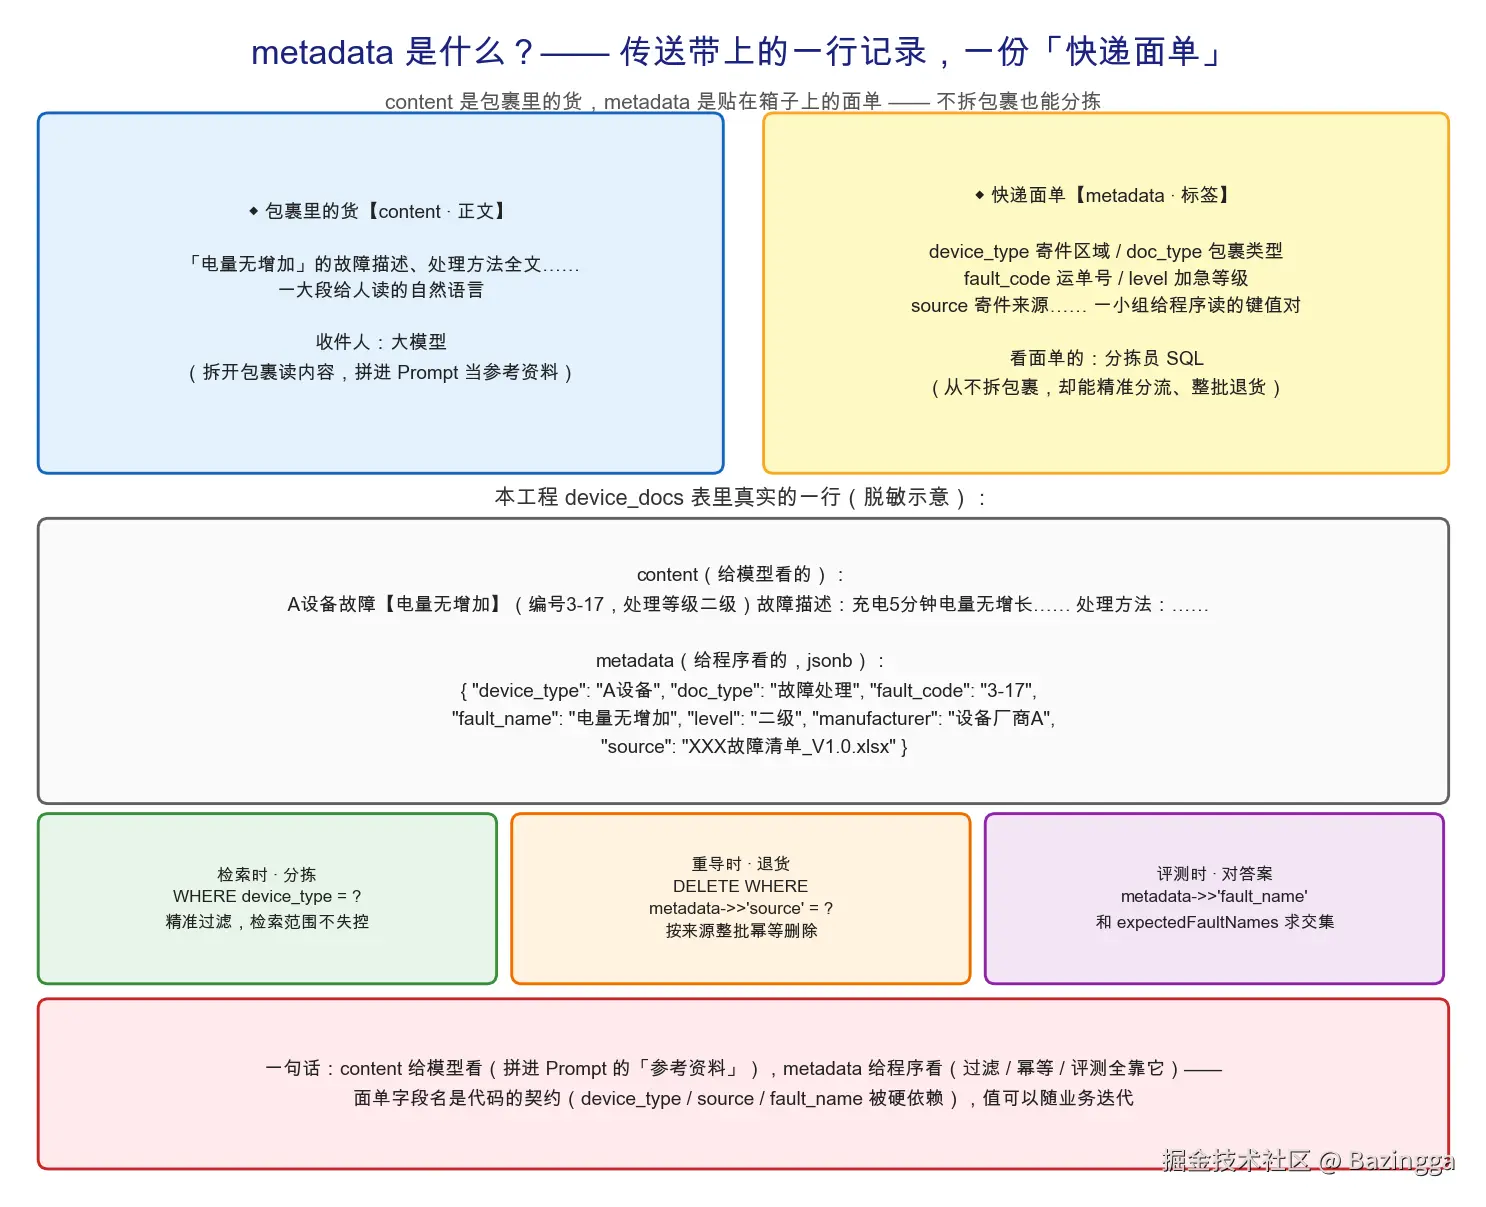
我的工程里每条故障的 metadata 长这样(存 PostgreSQL 的 jsonb 列):
json
{
  "device_type": "A设备",
  "doc_type": "故障处理",
  "fault_code": "3-17",
  "fault_name": "电量无增加",
  "level": "二级",
  "manufacturer": "设备厂商A",
  "source": "XXX故障清单_V1.0.xlsx"
}注意区分两层:metadata 是概念(结构化标签),JSON 只是存储格式 。就算拆成 device_type、fault_code 独立列,它依然叫 metadata。选 jsonb 的好处是标签结构可以随业务演化不用改表,代价是查询要用 ->> 操作符。
metadata 是后面"检索增强"和"合规过滤"的地基------面单在手,分拣自由。
二、实战任务 1:文档摄入管道(Excel → 向量库)
2.1 设计决策
我的数据源是 data/ 目录下的一份 xlsx(260 条故障)。三个关键设计:
- 文件放工程目录,代码自动读 ------不做手动导数据库的界面,
POST /rag/ingest触发扫描; - 一行 = 一条知识------Excel 每行就是一个独立故障,天然分好块(真正的长文档分块策略是另一个话题,下篇讲);
- 幂等重导------手册更新后重新调用摄入接口,不能产生重复数据。
2.2 表结构
sql
CREATE TABLE device_docs (
    id        SERIAL PRIMARY KEY,
    content   TEXT,                    -- 知识正文
    metadata  JSONB,                   -- 结构化标签
    embedding VECTOR(768)              -- 向量(与 dimensions=768 对齐)
);
CREATE INDEX ON device_docs USING hnsw (embedding vector_cosine_ops);  -- HNSW 索引加速相似度检索
2.3 摄入核心代码
解析与入库 (DocumentIngestService,有删节):
java
public Map<String, Object> ingestAll() throws IOException {
    // 扫描 data/ 下的 xlsx,跳过 Excel 打开时的 ~$ 锁文件
    List<Path> files;
    try (var stream = Files.list(Path.of(ingestDir))) {
        files = stream
                .filter(f -> f.getFileName().toString().toLowerCase().endsWith(".xlsx"))
                .filter(f -> !f.getFileName().toString().startsWith("~$"))
                .sorted().toList();
    }
    int deleted = 0, inserted = 0;
    for (Path file : files) {
        int[] result = ingestFile(file);   // 每个文件:先删同源旧数据再插入
        deleted += result[0];
        inserted += result[1];
    }
    int vectorized = ragService.initEmbeddings();  // 入库后统一批量向量化
    return Map.of("files", files.size(), "deleted", deleted,
                  "inserted", inserted, "vectorized", vectorized);
}

private int[] ingestFile(Path file) throws IOException {
    String source = file.getFileName().toString();
    int deleted = deviceDocMapper.deleteBySource(source);  // 幂等关键:按 source 先删后插
    int inserted = 0;
    try (InputStream in = Files.newInputStream(file);
         Workbook workbook = WorkbookFactory.create(in)) {   // Apache POI 解析
        Sheet sheet = workbook.getSheet("故障清单");
        DataFormatter formatter = new DataFormatter();
        for (int r = 1; r <= sheet.getLastRowNum(); r++) {   // 跳过表头
            Row row = sheet.getRow(r);
            if (row == null) continue;
            String faultName = cell(row, formatter, 3);
            String desc = cell(row, formatter, 5);
            String method = cell(row, formatter, 6);
            // 跳过无故障名、或描述与处理方法均为空的占位行
            if (faultName.isBlank() || (desc.isBlank() && method.isBlank())) continue;

            String content = buildContent(...);    // 拼"自包含"知识文本
            String metadata = buildMetadata(...);  // 拼标签 JSON
            deviceDocMapper.insertDoc(content, metadata);
            inserted++;
        }
    }
    return new int[]{deleted, inserted};
}两个容易被忽视的设计细节:
- 幂等靠 metadata 的 source 字段 :
DELETE FROM device_docs WHERE metadata ->> 'source' = #{source},同源文件重导 N 次都不会重复(实测 260 条:删 260 → 插 260 → 向量化 260); - 正文要拼成"自包含"文本 :不能只存"处理方法"几行字,而是拼成
A设备故障【电量无增加】(编号3-17,处理等级二级)\n故障描述:...\n处理方法:...------向量是对整段文本算的,上下文越完整,坐标越准。
批量向量化 (RagService):text-embedding-v3 单次请求最多 10 条,所以按批调用,260 条只需 26 次请求(比逐条调用省 234 次):
java
private static final int EMBED_BATCH_SIZE = 10;

public int initEmbeddings() {
    List<DeviceDoc> docs = deviceDocMapper.selectUnembedded(1000);  // 幂等:只捞 embedding IS NULL 的
    int count = 0;
    for (int i = 0; i < docs.size(); i += EMBED_BATCH_SIZE) {
        List<DeviceDoc> batch = docs.subList(i, Math.min(i + EMBED_BATCH_SIZE, docs.size()));
        try {
            List<float[]> vectors = embedTexts(batch.stream().map(DeviceDoc::getContent).toList());
            for (int j = 0; j < batch.size(); j++) {
                deviceDocMapper.updateEmbedding(batch.get(j).getId(), toVectorString(vectors.get(j)));
                count++;
            }
        } catch (Exception e) {
            // 按批容错:某批失败不影响其他批
            System.err.printf("[RAG] 批量向量化失败(id 从 %d 起): %s%n", batch.get(0).getId(), e.getMessage());
        }
    }
    return count;
}
调用 embedding API 用 RestTemplate 直连 DashScope(显式传 dimensions=768),还有一个防坑细节------返回的 data 要按 index 重排序,防止服务端乱序返回导致向量和文档错配:
java
List<Map<String, Object>> data = (List<Map<String, Object>>) response.getBody().get("data");
// 按 index 还原输入顺序,防止服务端乱序返回
data.sort(Comparator.comparingInt(d -> ((Number) d.get("index")).intValue()));配置(application.yml):
yaml
spring:
  ai:
    openai:
      api-key: ${DASHSCOPE_API_KEY}        # 生产环境用环境变量,不要明文入库!
      base-url: https://dashscope.aliyuncs.com/compatible-mode
rag:
  ingest-dir: data                          # 故障清单 Excel 目录
2.4 附:为什么应用一启动就能自动向量化?
工程里有个 RagInitConfig,暴露一个 CommandLineRunner Bean------Spring Boot 启动就绪后自动回调它,再调 ragService.initEmbeddings()。幂等条件是 WHERE embedding IS NULL:只捞没向量的文档,所以重复启动不会重复烧 API。
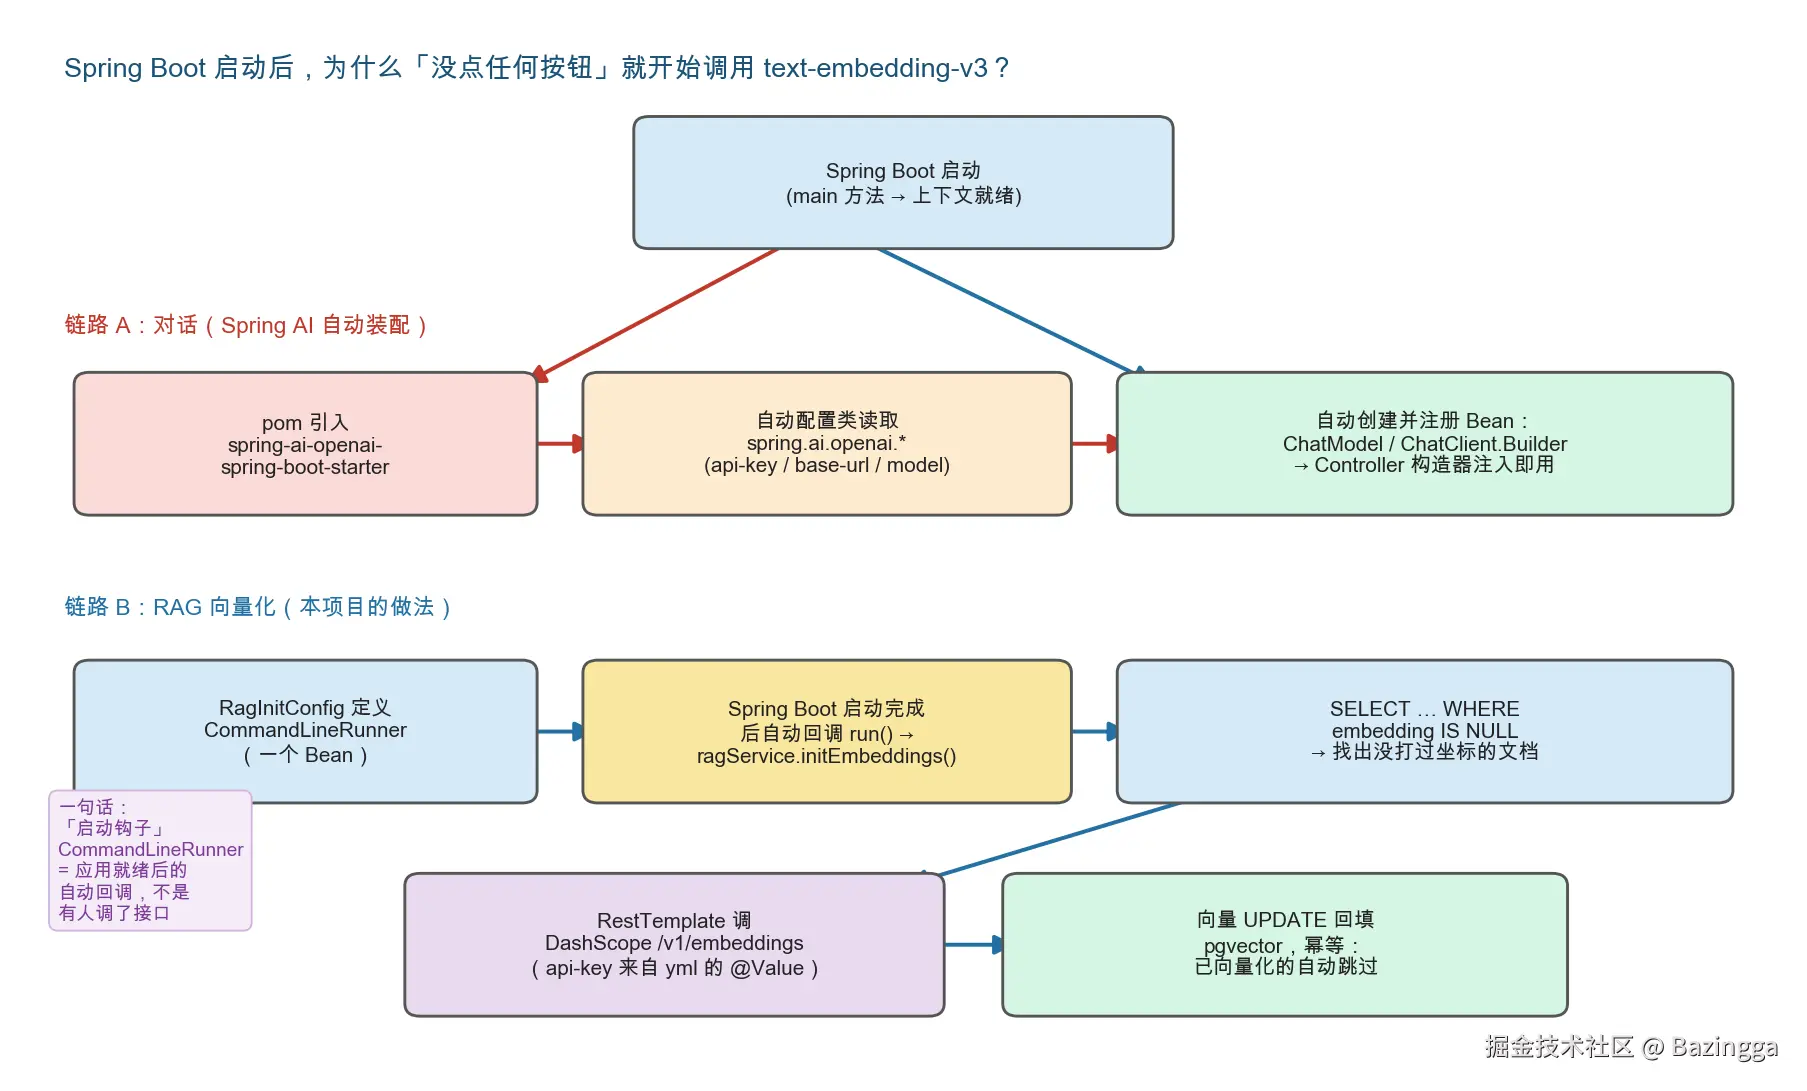
另外要区分本工程的两条模型调用链路(容易混):对话/生成链路 走 Spring AI Starter 自动装配(注入 ChatModel 即用);向量化链路 是 RagService 用 RestTemplate 直连 DashScope embedding 接口(显式 dimensions=768),绕过了 Spring AI 抽象层。两条链路各自独立,改配置时不要张冠李戴。
实测结果:260 条故障知识全部入库并向量化,重复调用摄入接口无重复数据。
三、实战任务 2:检索策略增强(过滤下推 + 阈值截断)
纯 topK 检索有两个典型问题:
- 范围失控:库里混着 A 设备和 B 设备的文档,问 A 设备的问题可能召回 B 设备的答案;
- 强行凑数:问"红烧肉怎么做",topK=3 照样硬塞 3 条最不相关的故障文档进 Prompt(反正总会选出"相对最近"的)。
解法一明一暗:metadata 过滤下推 (明面,用面单分拣)+ 距离阈值截断(暗中,宁缺毋滥)。
3.1 metadata 过滤下推:把条件推进 SQL
MyBatis 动态 SQL 版的检索(注意 <=> 在注解 SQL 里必须写成 <=>------注解 SQL 会被当成 XML 片段解析,< 是特殊字符):
java
@Select("""
<script>
SELECT id, content, metadata,
(embedding <=> #{queryEmbedding}::vector) AS distance
FROM device_docs
<if test="deviceType != null and deviceType != ''">
WHERE metadata ->> 'device_type' = #{deviceType}
</if>
ORDER BY embedding <=> #{queryEmbedding}::vector
LIMIT #{topK}
</script>
""")
List<DeviceDoc> similaritySearch(@Param("queryEmbedding") String queryEmbedding,
@Param("deviceType") String deviceType,
@Param("topK") int topK);为什么叫"下推":过滤条件写在 SQL 的 WHERE 里(数据库层),而不是查出 topK 再在 Java 里过滤。区别巨大------先过滤再检索,是在"分拣后的包裹堆"里找最近邻;先检索再过滤,可能 topK 全被别的设备占了名额,过滤完剩 0 条。
接口加可选参数:
ini
GET /rag/search?query=AGV充不进电&topK=3&deviceType=A设备3.2 距离阈值截断:给"不相关"设一条死线
思路:余弦距离超过阈值的文档直接丢弃,哪怕 topK 凑不满也不硬塞。
java
/** 默认距离阈值:余弦距离大于该值的文档视为不相关(可在 yml 覆盖) */
@Value("${rag.max-distance:0.5}")
private double maxDistance;

public List<Map<String, Object>> searchByVector(String query, float[] vector,
                                                String deviceType, int topK, boolean rerank) {
    // 1. 海选:向量检索(rerank 开启时扩大召回池,见任务3)
    List<DeviceDoc> results = deviceDocMapper.similaritySearch(vectorStr, deviceType, recallSize);
    // 2. 阈值截断:明显不相关的先淘汰
    List<Map<String, Object>> docs = results.stream()
            .filter(doc -> doc.getDistance() == null || doc.getDistance() <= maxDistance)
            .map(this::toResultMap)   // 顺手把 distance 带出去,作为排查证据
            .toList();
    // 3. 可选:rerank 精排(任务3)
    ...
}
配置:
yaml
rag:
max-distance: 0.5 # 余弦距离阈值:越小越严格,0 表示不截断实测效果:
- 问"红烧肉怎么做"→ 返回
[](全部文档距离超 0.5,正确拒绝回答) - 问"AGV 充不进电"→ 正常返回,且每条结果带
distance字段,"为什么召回它"从此有量化证据
阈值怎么定:0.5 对余弦距离是偏严的起点(相似度 0.5 以下才截断)。实测如果正常查询也被清空,就上调到 0.6~0.7。这是个需要拿真实数据调的参数------也是为什么评测体系(任务 4)那么重要:调参后跑一遍评测就知道是变好还是变坏。
3.3 一个高价值副产物:distance 透传
SQL 本来就算了距离,以前算完就扔。现在带出来给上层,排查问题时直接看数字说话:
json
{
  "id": 449,
  "content": "A 设备故障【充电站输出电流不匹配】...",
  "metadata": { "fault_name": "充电站输出电流不匹配", ... },
  "distance": 0.227
}
四、实战任务 3:Rerank 精排(海选之后的"面试")
4.1 为什么需要重排:海选的先天缺陷
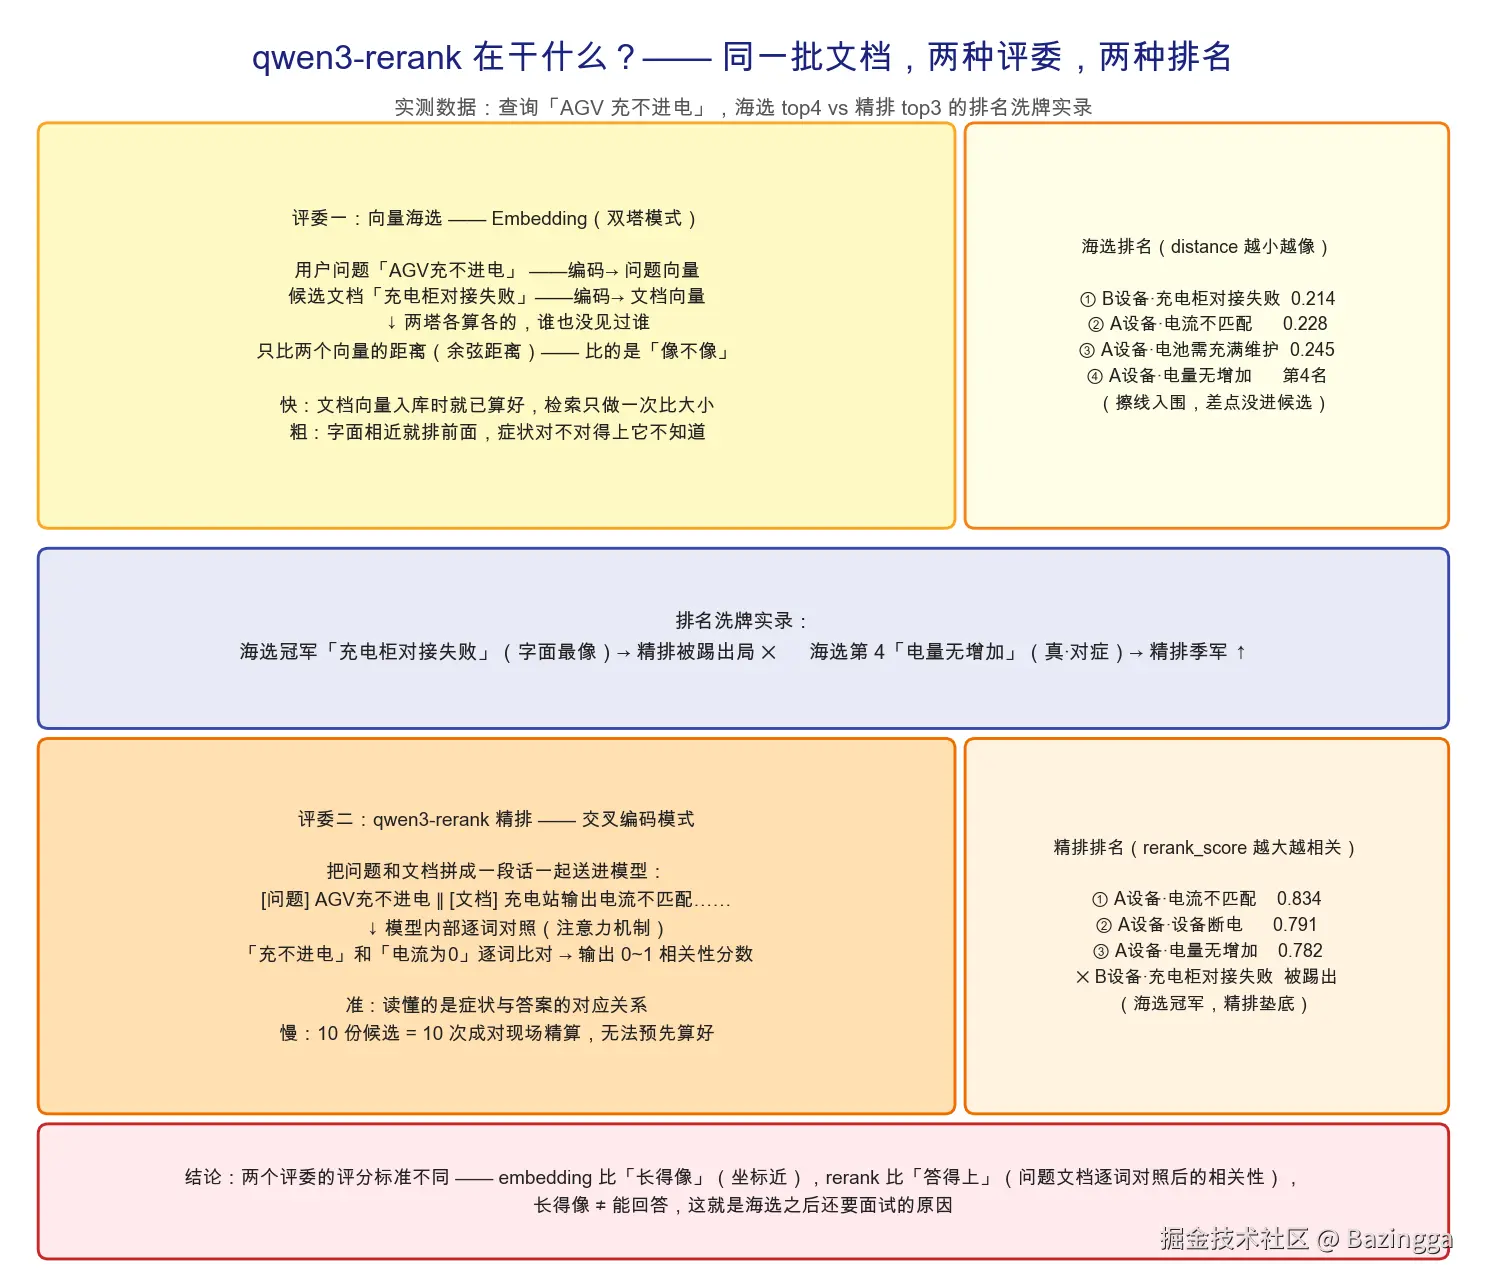
任务 1 实测时发现一个黄金案例:问"AGV 充不进电",最应该命中的"电量无增加"只排海选第 4,前三被"充电站输出电流不匹配"等字面相近的文档占据。字面像 ≠ 能回答------这正是双塔"只比整体印象"的代价。
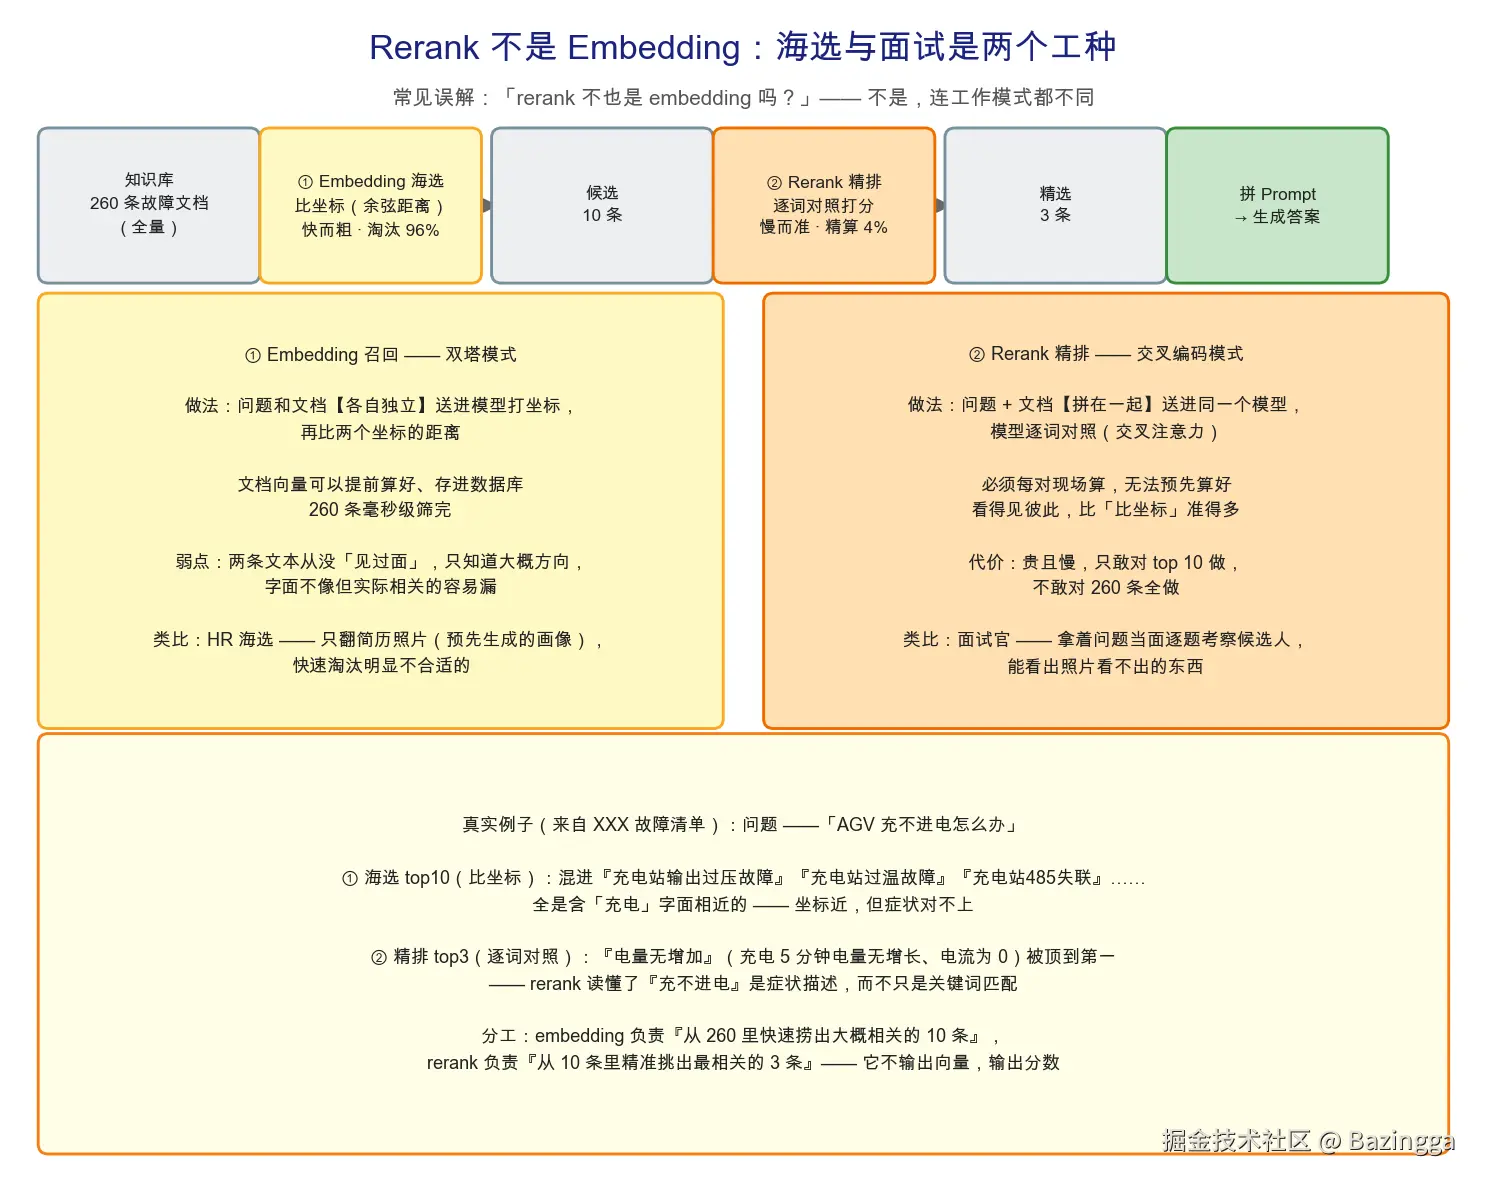
两阶段检索是业界标配:
- 海选(双塔):快而粗,从全库捞出 top10 候选
- 精排(交叉编码 Cross-Encoder):慢而准,把"问题 × 每份候选"拼成一对送进 rerank 模型逐词对照,输出 0~1 的相关性分数,重新排序取 top3
交叉编码和双塔的本质区别 :双塔两座塔互不相见、可以预计算、只比夹角;交叉编码把问题和文档拼成一段话送进模型,问题的每个词都能"看见"文档的每个词(注意力机制),输出的是"这份文档能回答这个问题的把握"。
4.2 RerankService 核心代码
模型选型有个插曲:原计划用 gte-rerank,查官方文档发现已于 2026-05 下线 ,官方指定替代是 qwen3-rerank (单请求最多 500 文档、单条 4000 token)。教训:云模型 API 的存活状态必须实时查文档,不能信旧教程。
java
@Service
public class RerankService {

    @Value("${rag.rerank.url:https://dashscope.aliyuncs.com/api/v1/services/rerank/text-rerank/text-rerank}")
    private String rerankUrl;
    @Value("${rag.rerank.model:qwen3-rerank}")
    private String rerankModel;

    public List<Map<String, Object>> rerank(String query, List<Map<String, Object>> docs, int topN) {
        if (docs.size() <= 1) return docs;
        try {
            List<String> documents = docs.stream().map(d -> (String) d.get("content")).toList();

            // DashScope 原生端点要求嵌套结构:input.query / input.documents / parameters.top_n
            Map<String, Object> input = new LinkedHashMap<>();
            input.put("query", query);
            input.put("documents", documents);
            Map<String, Object> parameters = new LinkedHashMap<>();
            parameters.put("top_n", Math.min(topN, docs.size()));
            parameters.put("return_documents", false);
            Map<String, Object> body = new LinkedHashMap<>();
            body.put("model", rerankModel);
            body.put("input", input);
            body.put("parameters", parameters);

            HttpHeaders headers = new HttpHeaders();
            headers.setContentType(MediaType.APPLICATION_JSON);
            headers.setBearerAuth(apiKey);
            ResponseEntity<Map> response = restTemplate.postForEntity(
                    rerankUrl, new HttpEntity<>(body, headers), Map.class);

            // results 在 output.results 下,按返回的 index 映射回原文档并附上 rerank_score
            List<Map<String, Object>> results = extractResults(response.getBody());
            List<Map<String, Object>> ranked = new ArrayList<>();
            for (Map<String, Object> r : results) {
                int index = ((Number) r.get("index")).intValue();
                double score = ((Number) r.get("relevance_score")).doubleValue();
                Map<String, Object> doc = new LinkedHashMap<>(docs.get(index));
                doc.put("rerank_score", score);
                ranked.add(doc);
            }
            return ranked;
        } catch (Exception e) {
            // 降级:rerank 失败不阻断检索链路,返回原序前 topN
            System.err.printf("[RAG][Rerank] 调用失败,降级返回原序前 %d 条: %s%n", topN, e.getMessage());
            return docs.subList(0, Math.min(topN, docs.size()));
        }
    }
}两个设计决策值得展开:
- 降级策略:rerank 是"锦上添花"环节,接口挂了不能拖垮整个问答------catch 后返回海选原序。上线第一天我就靠这个降级躲过一次 400 错误,检索链路全程无感;
- URL/模型名全部 yml 可配:云服务商端点说变就变(gte-rerank 下线就是前车之鉴),改配置不改代码。
4.3 链路串联:海选池要扩大
关键点:开 rerank 时海选池要从 topK 扩大到 10 条。海选只取 3 条的话,排第 4 的"电量无增加"连参评资格都没有,精排再强也没用。
java
public List<Map<String, Object>> searchByVector(String query, float[] vector,
                                                String deviceType, int topK, boolean rerank) {
    // 1. 海选:开启 rerank 时扩大召回池,给"海选靠后但实际相关"的文档留翻身空间
    int recallSize = rerank ? Math.max(topK, rerankCandidates) : topK;   // rerankCandidates=10
    List<DeviceDoc> results = deviceDocMapper.similaritySearch(vectorStr, deviceType, recallSize);
    // 2. 阈值截断:明显不相关的先淘汰,不浪费 rerank 精算名额
    // 3. 精排:rerank 模型对"问题×文档"逐对打分重排,取前 topK
    if (rerank && !docs.isEmpty()) {
        return rerankService.rerank(query, docs, topK);
    }
    return docs;
}配置与接口(rerank 默认 false,不传时行为与任务 2 完全一致------渐进式改造,不破坏已有调用方):
yaml
rag:
  rerank:
    candidates: 10       # 海选池大小
    url: https://dashscope.aliyuncs.com/api/v1/services/rerank/text-rerank/text-rerank
    model: qwen3-rerank
ini
GET /rag/search?query=AGV充不进电&topK=3&rerank=true
GET /rag/ask?query=AGV充不进电&topK=3&deviceType=A设备&rerank=true
4.4 黄金案例实测:精排的"洗牌"
实测结果(真实数据,比"rerank 全面变好"有意思得多):
| 变化 | 海选 | 精排后 |
|---|---|---|
| 电量无增加 | 第 4 名(distance 0.247) | 第 3 名(rerank_score 0.782) ✅ 黄金案例达成 |
| B设备·充电柜对接失败 | 第 1 名(distance 0.214,字面最像) | 被踢出前三 ✅ 答非所问的被识破 |
| 设备断电 | 第 5 名开外 | 空降第 2(0.791)------海选池扩大的功劳 |
三个变化各自印证一件事:交叉编码看懂了"电量无增加=充不进电"(语义泛化)、识破了"长得像但答非所问"(逐词对照)、海选池扩大让边缘候选有了参评资格(链路设计)。
也有值得警惕的一面:精排把"设备断电"(充不进电的可能原因而非直接答案)排到第 2------rerank 不是真理,是第二个评委的意见。它到底让整体变好还是变坏?肉眼判断到此为止,量化裁决交给任务 4。
五、生产环境视角:两个"课上不教"的问题
5.1 大规模摄入怎么做
教学工程是"一个 xlsx、同步跑完";真实公司是每天几千份多源文档(PDF/Word/Confluence/工单)、增量更新、权限隔离。
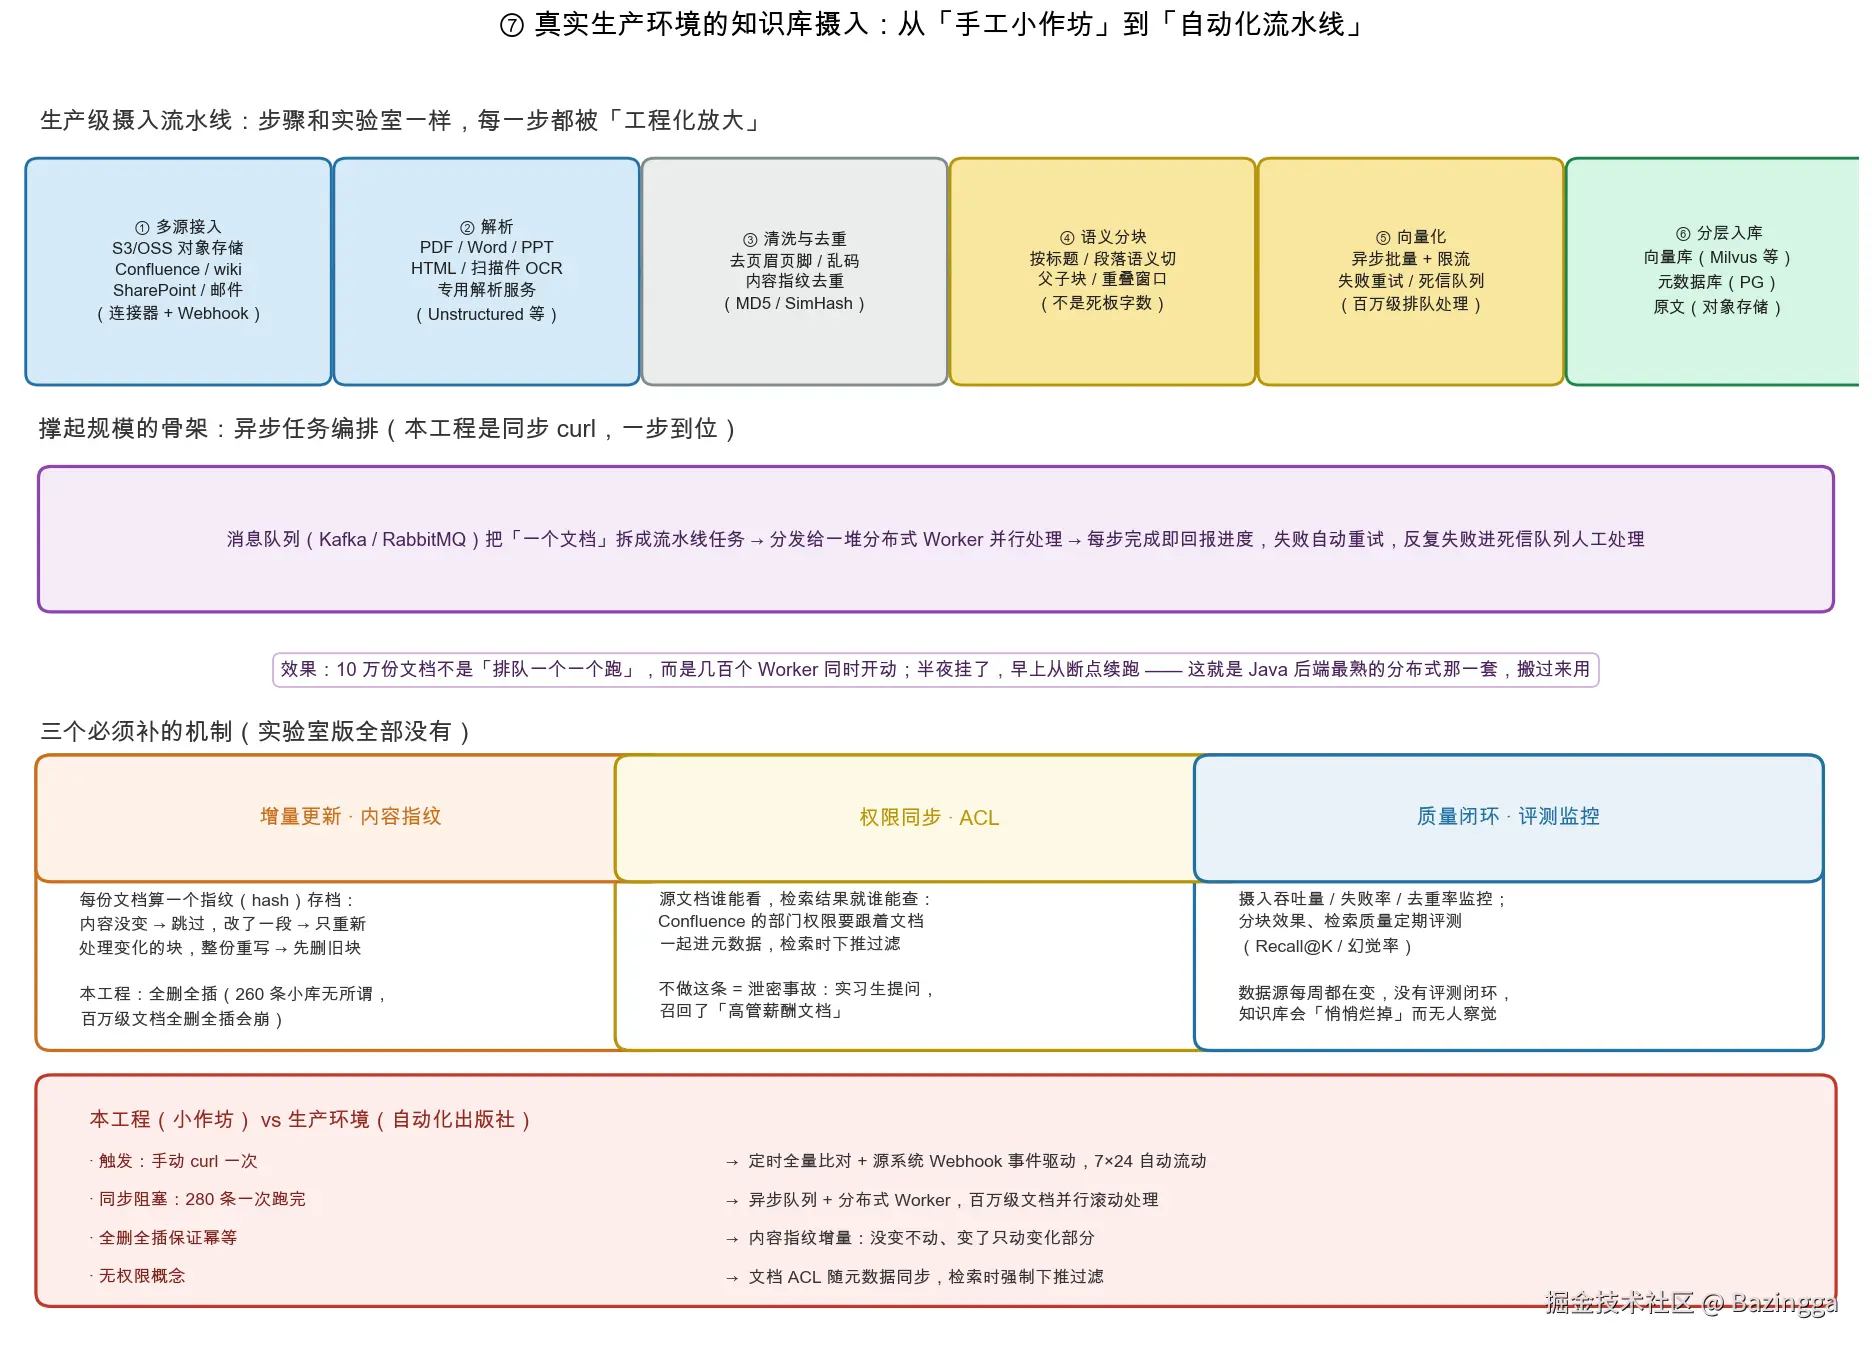
核心结论:摄入步骤本身不变(解析→分块→向量化→入库),变的是外面套的工程化外壳------异步分布式编排(消息队列 + Worker 池 + 失败重试/死信队列)、多源连接器、内容指纹增量更新(只重灌变化的文档)、ACL 权限同步(谁能看原文,谁就能被检索到)。教学工程的一把梭同步调用,在生产会死于超时和不可重试。
5.2 内容不合规怎么办
文档进了库,万一有客户手机号、密码凭证、过期文档、甚至恶意注入指令呢?
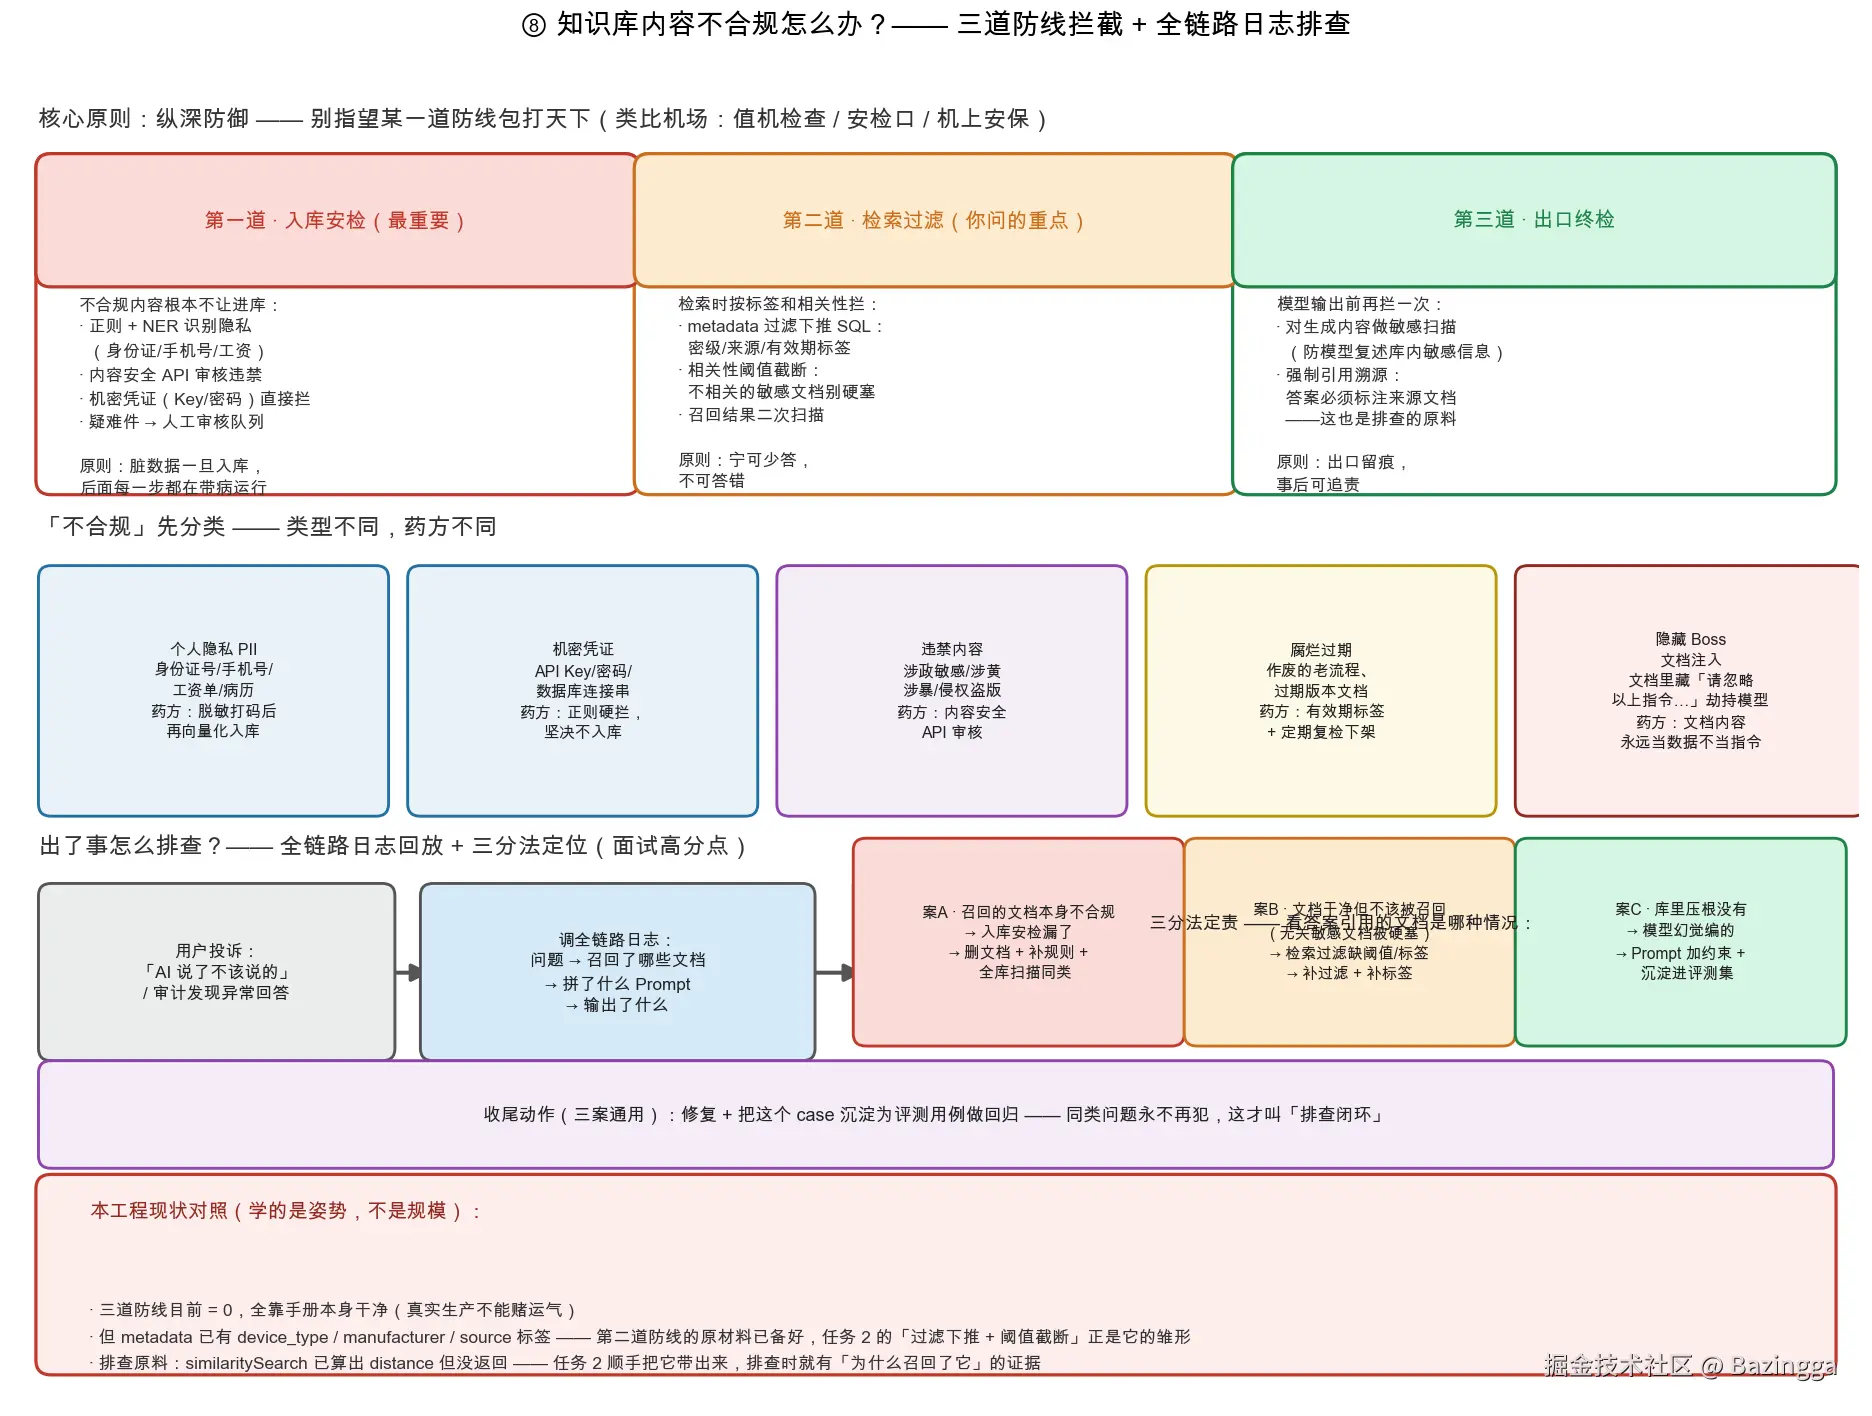
纵深防御三道防线:
- 入库安检(最重要):PII 脱敏、凭证类内容硬拦、内容安全 API 扫描------脏数据进库,后面全白搭
- 检索过滤:metadata 标签下推(密级标签)+ 距离阈值截断 + 召回二次扫描------原则是"宁可少答,不可答错"
- 出口终检:输出侧敏感词扫描 + 强制引用溯源(回答必须标注来自哪份文档)
排查"为什么答出了不该答的"用三分法定责:A 文档本身不合规 → 补入库安检;B 文档干净但不该被召回 → 补检索过滤;C 库里没有、模型自己编的 → 收紧 Prompt 约束。我工程里的 metadata 标签 + 阈值截断,正是第二道防线的雏形。
六、实战任务 4:评测体系(把"感觉"变成"指标")
6.1 为什么必须有评测
改了阈值、换了模型、加了 rerank------怎么证明变好了? 没有评测,每次改动都是赌博。评测体系的本质:一份固定考卷 + 一套算分规则,任何改动都跑同一张考卷,分数可比。
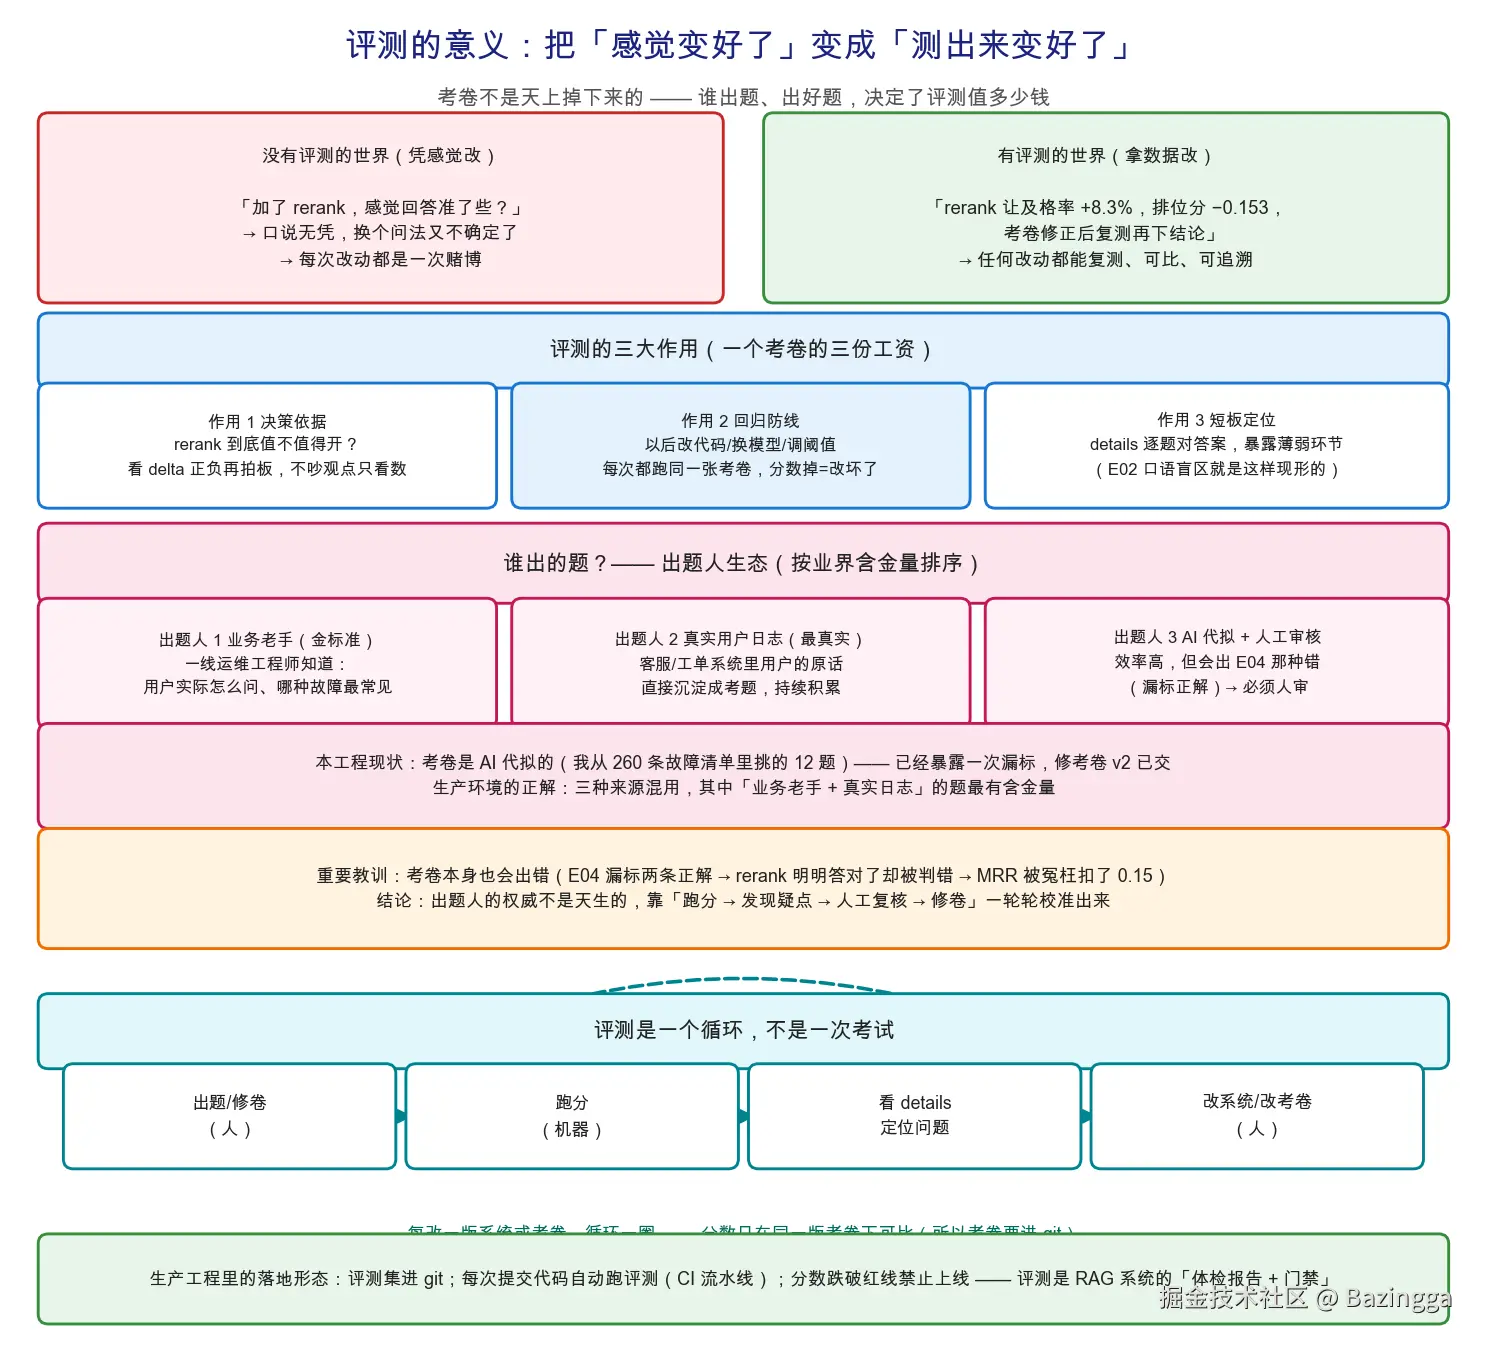
它打三份工:决策依据 (rerank 值不值得开,看 delta 正负)、回归防线 (每次改动复测,分数掉=改坏了)、短板定位(逐题对答案,暴露盲区)。
6.2 评测集:12 道题的考卷
设计原则:query 用用户口吻 ,标准答案用知识库术语------因为这正是检索最难的部分。考题类型覆盖口语转术语("开不了机"→设备断电)、多正解("撞到障碍物"→撞击告警+碰撞条族)、分级术语("电池报高温"→一级/二级)、跨界查询("充电站过温"→车端+桩端故障)。
json
[
  {
    "id": "E01",
    "query": "AGV充不进电",
    "expectedFaultNames": ["电量无增加", "充电站未连接", "充电站输出过压故障"],
    "note": "黄金案例:症状口语 vs 知识库术语,考察语义泛化能力"
  },
  {
    "id": "E09",
    "query": "屏幕不亮了",
    "expectedFaultNames": ["显示屏失联"],
    "note": "部件口语:屏幕不亮 → 显示屏失联"
  }
]字段契约:query/expectedFaultNames 被代码硬依赖(改名就崩),id 用于回显,note 纯人眼注释。骨架是契约别动,血肉(值和条数)随便迭代------考卷要进 git,因为分数只在同一版考卷下可比。
6.3 三大指标
| 指标 | 通俗含义 | 算法 |
|---|---|---|
| HitRate@K | 12 题里几题"至少蒙对一条" | 命中≥1 条正解的用例 ÷ 总用例 |
| Recall@K | 该找的答案找回来几成 | 命中正解数 ÷ 全部正解数 |
| MRR | 对的答案排得靠不靠前 | 首个正解排名倒数均值(第1名=1.0,第3名=0.33) |
核心代码(RagEvalService):
java
public Map<String, Object> evaluate(String mode, int topK) {
    for (Map<String, Object> c : evalCases) {
        String query = (String) c.get("query");
        List<String> expected = (List<String>) c.get("expectedFaultNames");
        // 同一问题只 embed 一次,baseline 与 rerank 共用向量:省配额且对比公平
        float[] vector = ragService.embedQuery(query);

        Map<String, Object> s1 = score(expected, extractFaultNames(
                ragService.searchByVector(query, vector, null, topK, false)));  // 海选
        Map<String, Object> s2 = score(expected, extractFaultNames(
                ragService.searchByVector(query, vector, null, topK, true)));   // 精排
        ...
    }
    // delta = rerank 各指标 − baseline 各指标:正数=精排有功,负数=帮了倒忙
}

private Map<String, Object> score(List<String> expected, List<String> retrieved) {
    List<String> hits = new ArrayList<>();
    Integer firstHitRank = null;
    for (int i = 0; i < retrieved.size(); i++) {
        if (expected.contains(retrieved.get(i))) {
            hits.add(retrieved.get(i));
            if (firstHitRank == null) firstHitRank = i + 1;
        }
    }
    // recall = hits.size / expected.size;rr = 1 / firstHitRank
    ...
}
评测接口故意用 POST(跑一次评测要烧 12 次 embedding + 12 次 rerank 配额,防误触发):
bash
curl -s -X POST "http://localhost:8080/rag/eval?mode=compare&topK=3" | python3 -m json.tool6.4 首跑数据解读:评测最精彩的一课
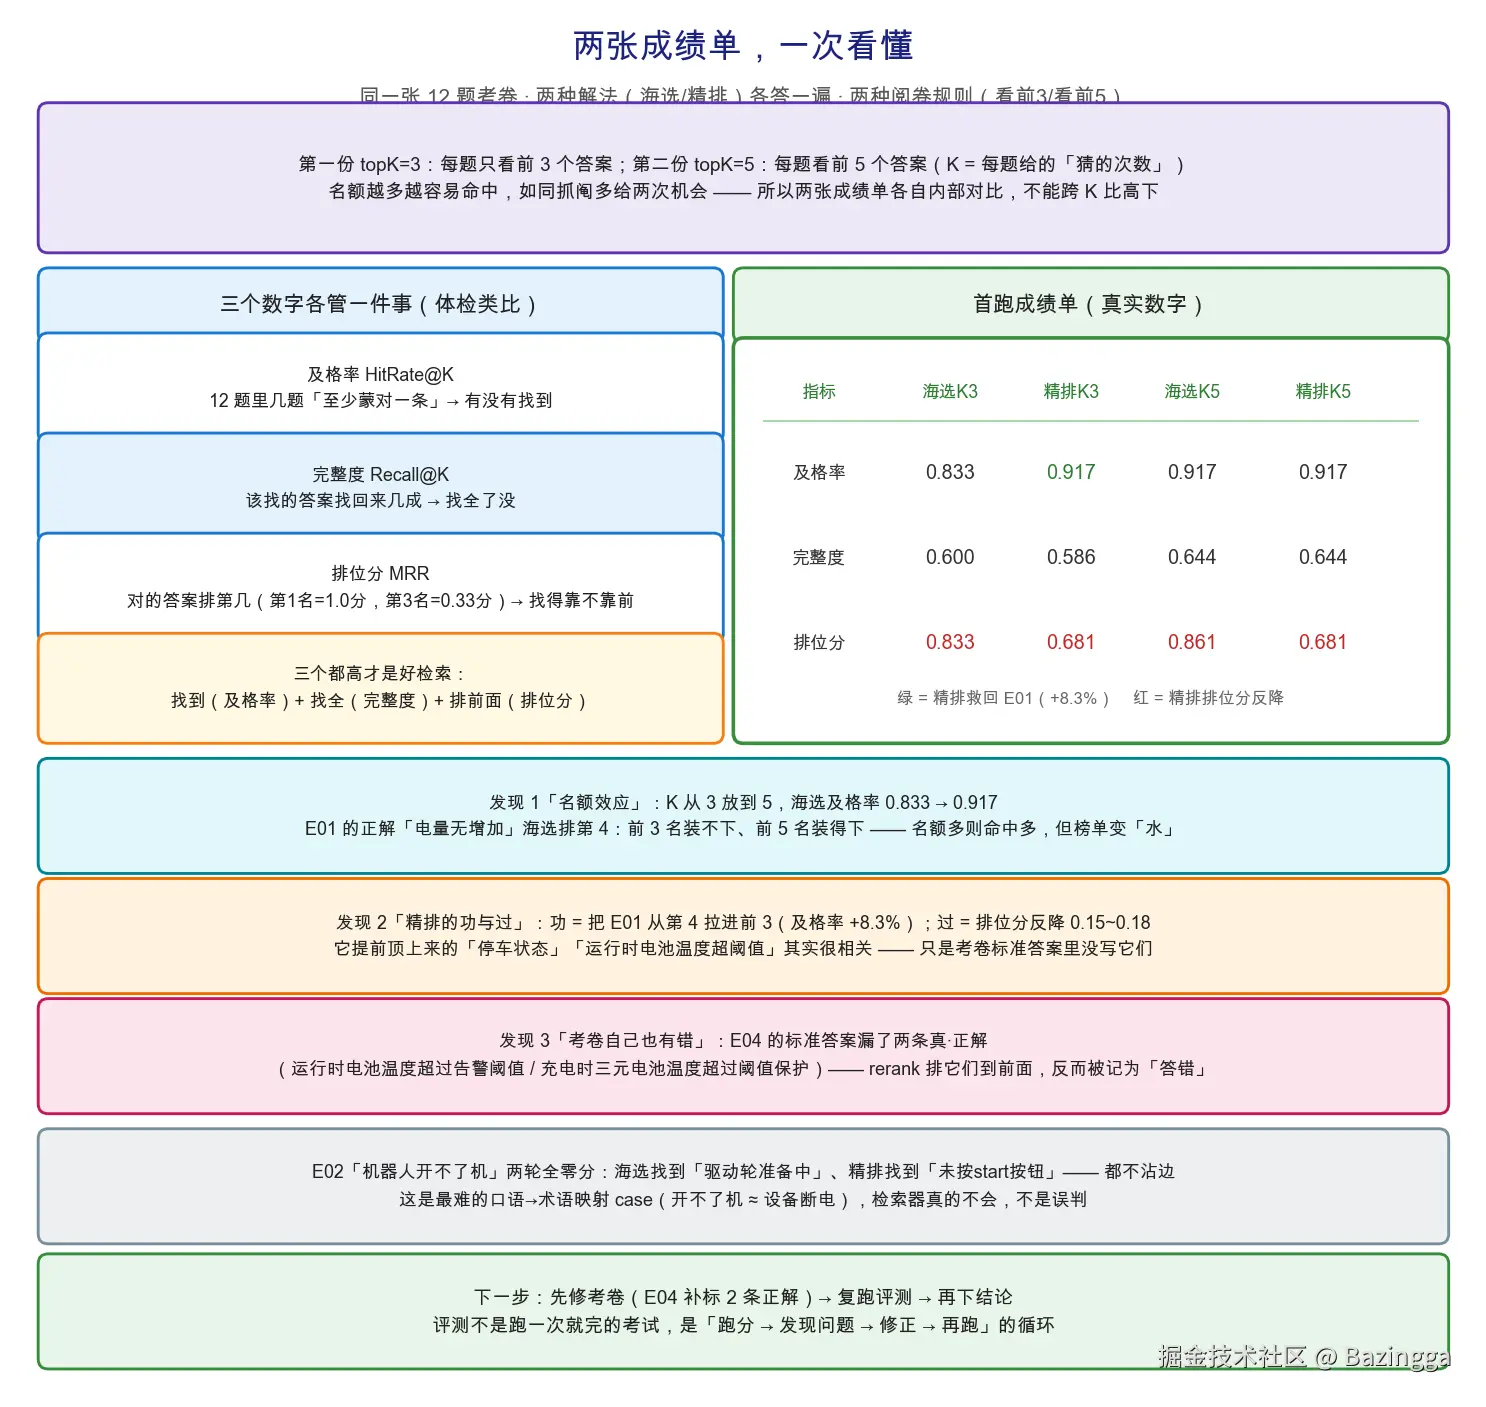
真实成绩(topK=3):
| 指标 | 海选 | 精排 | delta |
|---|---|---|---|
| HitRate@K | 0.833 | 0.917 | +0.083 |
| Recall@K | 0.600 | 0.586 | −0.014 |
| MRR | 0.833 | 0.681 | −0.153 |
三个发现,每个都有启发:
发现 1「名额效应」 :topK 从 3 放到 5,海选 HitRate 也从 0.833 升到 0.917------"电量无增加"海选排第 4,前 3 装不下、前 5 装得下。K 越大越容易命中,但榜单越"水",所以不同 K 的分数不能直接比。
发现 2「精排的功与过」:功------纯靠精排把 E01 从第 4 拉进前 3(HitRate +8.3%);过------MRR 反降 0.15。逐题看原因:精排把"运行时电池温度超过告警阈值"排到第 1,把标准答案"电池温度过高一级"挤到第 3......
发现 3「考卷自己也有错」 :上一条的"过",其实大部分是假阴性 ------"运行时电池温度超阈值"就是电池高温的同义故障,我出题时漏标了它!rerank 找到了它,反而被判"答错"。评测集会错,出题人的权威是"跑分→发现疑点→人工复核→修卷"一轮轮校准出来的。修完考卷 v2 复跑,MRR 的冤枉分就能洗掉。
另外 E02"机器人开不了机"两轮全零------海选和精排都不认识"开不了机≈设备断电"这层映射,这是纯向量检索的真·盲区(也是后面做混合检索的靶子)。
结论 :评测最大的价值不是打分,而是揪出了"标准答案本身有错"这种肉眼永远看不见的问题 。评测是循环:出题 → 跑分 → 看逐题 → 改系统或改考卷 → 再跑分。生产环境的终极形态是挂到 CI:每次提交自动跑评测,分数跌破红线禁止上线------评测从"体检报告"升级为"门禁"。
七、总结:一张图收束全文
回头看,整个 RAG 学习路径其实就四个字:召回、精排、评测------
scss
                     ┌─────────────── 离线 ───────────────┐
Excel ──POI解析──▶ 自包含知识文本 ──批量embedding(10/批)──▶ pgvector(768维, HNSW)
                     │ 幂等:metadata->>'source' 先删后插
                     └──────────────────────────────────────┘
                     ┌─────────────── 在线 ───────────────┐
用户问题 ──embedding──▶ 双塔海选 top10 ──阈值截断(<0.5)──▶ qwen3-rerank 精排 ──▶ top3 拼 Prompt ──▶ 生成
                     │        │               │                失败降级原序
                     │   metadata 过滤下推     └─ 宁缺毋滥
                     └──────────────────────────────────────┘
                                    ┌────────── 闭环 ──────────┐
                                    │ 评测集(12题) → 跑分 → 修卷/改系统 → 再跑分 │
                                    └──────────────────────────┘
概念上的几个"顿悟时刻":
- 距离 vs 相似度:pgvector 返回的是余弦距离(越小越像),不是余弦相似度------方向搞反,阈值就全错;
- 双塔 vs 交叉编码:海选快是因为文档向量可预计算(塔互不相见),精排准是因为问题能逐词对照文档(拆掉墙)------各有分工,谁也替代不了谁;
- metadata 是第二根检索支柱:向量管"语义像不像",面单管"该不该在这一堆里找";
- 评测是循环不是考试:跑分最大的收获,往往是发现考卷自己错了。
附:本文涉及的代码与资源
bash
src/main/java/com/suyou/ailab/
├── controller/RagController.java        # /rag/search /rag/ask /rag/ingest /rag/eval
├── service/
│   ├── DocumentIngestService.java       # 任务1:Excel 摄入管道(幂等)
│   ├── RagService.java                  # 向量化/检索/阈值截断/rerank 链路串联
│   ├── RerankService.java               # 任务3:qwen3-rerank 精排(含降级)
│   └── RagEvalService.java              # 任务4:三指标评测引擎
├── mapper/DeviceDocMapper.java          # pgvector <=> 检索 + jsonb 操作
└── entity/DeviceDoc.java                # content/metadata/embedding/distance
src/main/resources/
├── application.yml                      # 阈值/rerank/摄入目录配置
└── rag-eval.json                        # 评测集(12 题,v2)