第14篇 pg_trgm GIN 索引:PostgreSQL 正则、模糊与近似度查询的三合一加速器
标签:#PostgreSQL #索引 #性能优化 #pg_trgm
一、前言
业务里有三类"文本不精确匹配"的需求,最容易把查询拖成全表扫描:
sql
-- ① 前后模糊查询
SELECT * FROM tbl WHERE col LIKE '%手机%';
-- ② 规则表达式(正则)查询
SELECT * FROM tbl WHERE col ~ '^(苹果|华为).*手机';
-- ③ 文本近似度查询(容错拼写 / 错别字)
SELECT * FROM tbl WHERE col % '苹杲手机';
一个 pg_trgm 扩展 + GIN 索引,三类需求全部覆盖:
sql
CREATE EXTENSION IF NOT EXISTS pg_trgm;

CREATE INDEX idx_tab_colname ON 表名 USING gin (colname gin_trgm_ops);
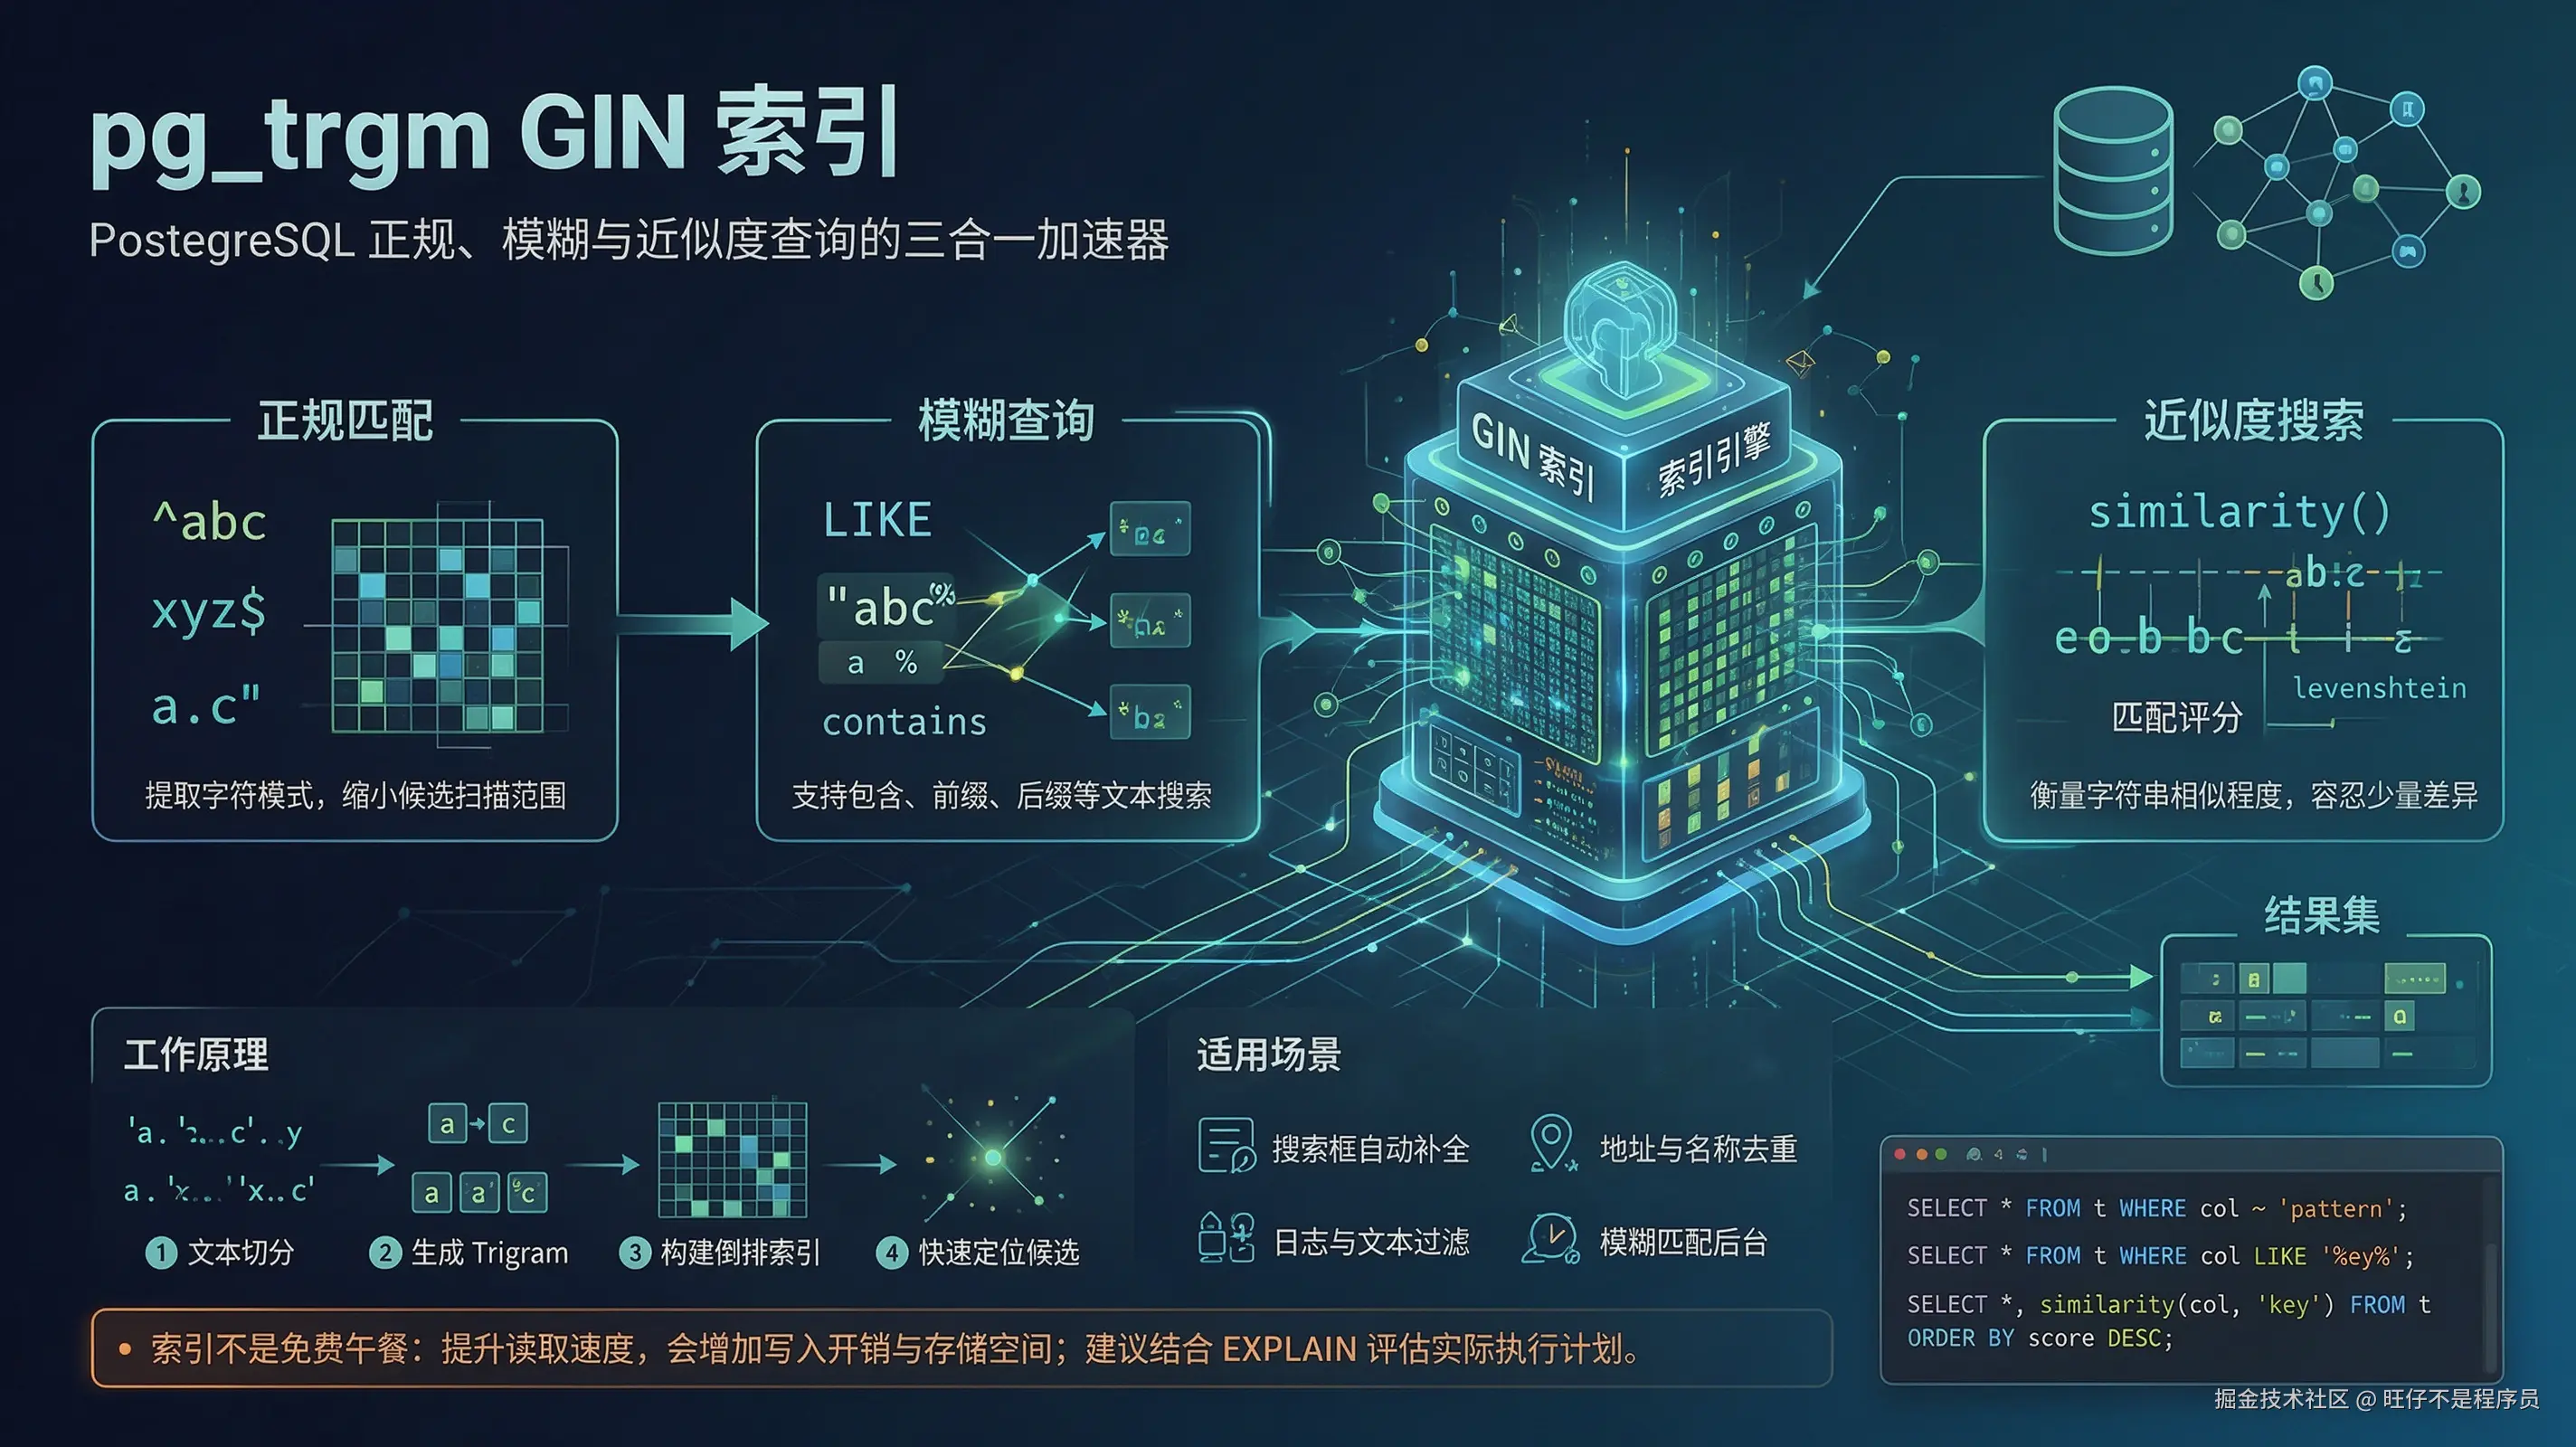
没有这个 trgm GIN 索引,就不推荐在核心路径上用 LIKE '%xxxx%' 这类前后模糊查询------B-tree 帮不上忙(第 13 篇讲过),只能全表逐行扫描。
二、核心开发规范
- 正则 / 近似度 / 前后模糊 → pg_trgm 扩展 + GIN 索引 :
CREATE INDEX idx_tab_colname ON 表名 USING gin (colname gin_trgm_ops);------官方明确该索引支持相似度运算符,以及基于三字母组的 LIKE、ILIKE、SIMILAR TO 与 POSIX 正则的索引搜索; - 近似度查询用
%+similarity():col % '关键词'表示相似度超过阈值(pg_trgm.similarity_threshold,默认 0.3);排序打分用similarity(col, '关键词'),距离用<->; - 前提:模式必须能提取三元组(至少 3 个字符) ------官方警告:模式和正则里没有可提取的三元组时会退化为全索引扫描,短模式、纯符号模式慎用。
三、底层原理通俗讲解
- 三元组(trigram)是什么 :把字符串按连续 3 个字符切开(首尾用空格补齐)------
'apple'拆成' a'、' ap'、'app'、'ppl'、'ple'、'le '、'e '; - 相似度怎么算:两个串的相似度 = 共享三元组数量 / 双方三元组总数(Jaccard 式重叠度)------字符串越长、越像,重叠越多;
- GIN 索引存什么 :把每行的所有三元组作为键存进 GIN 索引;查询时把模式/正则也拆成三元组,直接在索引里找候选行,再回表精确验证------从"逐行跑匹配"变成"索引里定位候选";
- 为什么三类查询一网打尽 :LIKE 模糊、正则匹配、相似度判断本质都是"三元组重叠"逻辑------模式是
%手机%还是~ 正则还是% '近似词',GIN 都能用三元组预筛候选,只是最后一步验证方式不同; - 阈值与排序 :
%用默认阈值 0.3(可SET pg_trgm.similarity_threshold = 0.5;调严);要按相似度排序就用similarity()打分 +ORDER BY ... DESC LIMIT n; - 官方警告(重要) :模式少于 3 个字符 / 提取不出三元组 时(如
LIKE 'ab%'只有 2 字符),索引搜索退化为全索引扫描,帮助有限; - GIN vs GiST:pg_trgm 同时提供两种操作符类------GIN 查询更快但体积更大、写入更慢(适合读多写少);GiST 更新开销小(适合写多场景);本规范主推 GIN。
四、实战错误案例&优化方案
场景1:文本近似度查询(错别字 / 模糊搜索)
表设计:products 表,name text,用户搜索"苹杲手机"(含错别字)要容错匹配"苹果手机"等相似商品名
❌ 错误写法(无索引,% 逐行算相似度)
sql
-- 没有 trgm 索引:
SELECT id, name, similarity(name, '苹杲手机') AS score
FROM products
WHERE name % '苹杲手机'
ORDER BY score DESC LIMIT 10;
-- Seq Scan ← 每行现场算三元组相似度,5000 万行算到天荒地老
✅ 正确写法(trgm GIN 索引,官方推荐)
sql
CREATE EXTENSION IF NOT EXISTS pg_trgm;

CREATE INDEX CONCURRENTLY idx_products_name_trgm
  ON products USING gin (name gin_trgm_ops);

SELECT id, name, similarity(name, '苹杲手机') AS score
FROM products
WHERE name % '苹杲手机'
ORDER BY score DESC LIMIT 10;
-- Bitmap Index Scan using idx_products_name_trgm ✓
-- 索引用三元组预筛候选,% 只对候选行精确算相似度
关键结论 :近似度查询(% / <->)配 trgm GIN ------% 负责过滤(相似度超过默认 0.3),similarity() 负责排序,索引把"全表算"变成"候选集算"。
场景2:正则表达式查询(规则匹配)
表设计:products 表,需要正则筛选 WHERE name ~ '^(苹果|华为).*手机'
❌ 错误写法(无 trgm 索引,正则逐行跑)
sql
SELECT * FROM products WHERE name ~ '^(苹果|华为).*手机';
-- Seq Scan ← 每行现场跑正则,全表扫描
✅ 正确写法(同一 trgm GIN 索引直接覆盖)
sql
-- 场景1 建的索引直接可用(不用另建)
SELECT * FROM products WHERE name ~ '^(苹果|华为).*手机';
-- Bitmap Index Scan using idx_products_name_trgm ✓
-- 官方:trgm 索引支持 SIMILAR TO 与 POSIX 正则的索引搜索
关键结论 :正则查询也吃同一份三元组索引 ------~ / ~* / SIMILAR TO 都走 trgm 预筛;索引是"一份投入,三类查询共用"。
场景3:前后模糊查询------没 trgm 索引真的别用
表设计:products 表,WHERE name LIKE '%手机%'(中间模糊,第 13 篇结论:B-tree 无解)
❌ 错误写法(没有 trgm 索引就上前后模糊)
sql
-- 没有 trgm 索引:
SELECT * FROM products WHERE name LIKE '%手机%';
-- Seq Scan ← % 在开头,B-tree / 反转索引都救不了(反转也只管后缀)
-- 大表上这就是定时炸弹
✅ 正确写法(有 trgm GIN 索引后才推荐)
sql
-- 前提:已建 idx_products_name_trgm
SELECT * FROM products WHERE name LIKE '%手机%';
-- Bitmap Index Scan using idx_products_name_trgm ✓
关键结论 :前后模糊查询要"先建索引、后上查询" ------没有 trgm GIN 索引时,LIKE '%xxx%' 在核心查询路径上禁用;有索引后中间模糊、前后模糊一网打尽。
场景4:验证 + 阈值调节 + 短模式警告
表设计:products 表,已建 trgm GIN 索引
✅ 正确验证(对照 + 调阈值)
sql
-- ① 验证走了索引
EXPLAIN (ANALYZE, BUFFERS)
SELECT * FROM products WHERE name ~ '手机.*壳';
-- Bitmap Index Scan using idx_products_name_trgm ✓

-- ② 近似度阈值太松导致误匹配多 → 调严
SET pg_trgm.similarity_threshold = 0.5;   -- 默认 0.3,可调
SELECT * FROM products WHERE name % '苹果手机';

-- ③ 短模式警告:'ab' 只有 2 字符,提取不出三元组
EXPLAIN SELECT * FROM products WHERE name LIKE '%ab%';
-- 索引退化为全索引扫描(官方原文:无可提取三元组的模式会退化)
关键结论 :阈值按业务精度调、短模式心里有数 ------similarity_threshold 默认 0.3(越低越宽、越高越准);模式短于 3 字符时索引帮不上忙,这类查询要单独评估。
五、绝对禁止的写法汇总
- 没有 trgm GIN 索引就在核心查询路径 上写
LIKE '%xxx%'/ 正则 /%近似度(全表扫描); - 模式短于 3 个字符还指望 trgm 索引提速(官方:无可提取三元组 → 退化全索引扫描);
- 近似度查询只 ORDER BY similarity() 不先
%过滤(打分要全表算,索引形同虚设); - 高频写表上无脑选 GIN(GIN 写入维护更重;写多场景考虑 GiST);
- 建完不 EXPLAIN 验证 (出现
Seq Scan/Index Only Scan on 全索引说明没吃上候选预筛)。
六、最终评审口诀(记住不踩坑)
正则模糊近似度,trgm GIN 全兜住;
模式短于三字符,退化扫描白辛苦。
七、总结
- 何时用 :正则(
~/~*)、前后/中间模糊(LIKE '%x%')、文本近似度(%/similarity()/<->)------一份pg_trgm+ GIN 索引三合一; - 怎么写 :
CREATE EXTENSION pg_trgm;后CREATE INDEX idx_tab_colname ON 表名 USING gin (colname gin_trgm_ops);; - 红线 :没有 trgm GIN 索引,
LIKE '%xxxx%'前后模糊在核心路径上禁用;模式提取不出三元组(<3 字符)时索引退化,帮助有限; - 调优 :近似度阈值
pg_trgm.similarity_threshold默认 0.3 可调;读多写少用 GIN、写多场景考虑 GiST; - 验证 :EXPLAIN 出现
Bitmap Index Scan using ...才算吃上索引。
标签:PostgreSQL 数据库 性能优化
参考来源
- PostgreSQL 官方文档 F.35 pg_trgm(GiST / GIN 操作符类、相似度运算符、LIKE / ILIKE / SIMILAR TO / POSIX 正则索引搜索、无可提取三元组退化为全索引扫描、similarity_threshold)------ www.postgresql.org/docs/curren...