作者:来自 Elastic Meghan Murphy
你的 Agent Builder 跟踪数据可以回答的四个 agent 性能问题,包括按 模型 统计 token 消耗、工具错误率、缓慢的对话轮次以及最近的提示词。这里提供了每个问题对应的 ES|QL,包括 SUM() 所需的类型转换。
Agent Builder 现已正式发布。通过Elastic Cloud 试用版开始使用,并查看 Agent Builder 的文档。
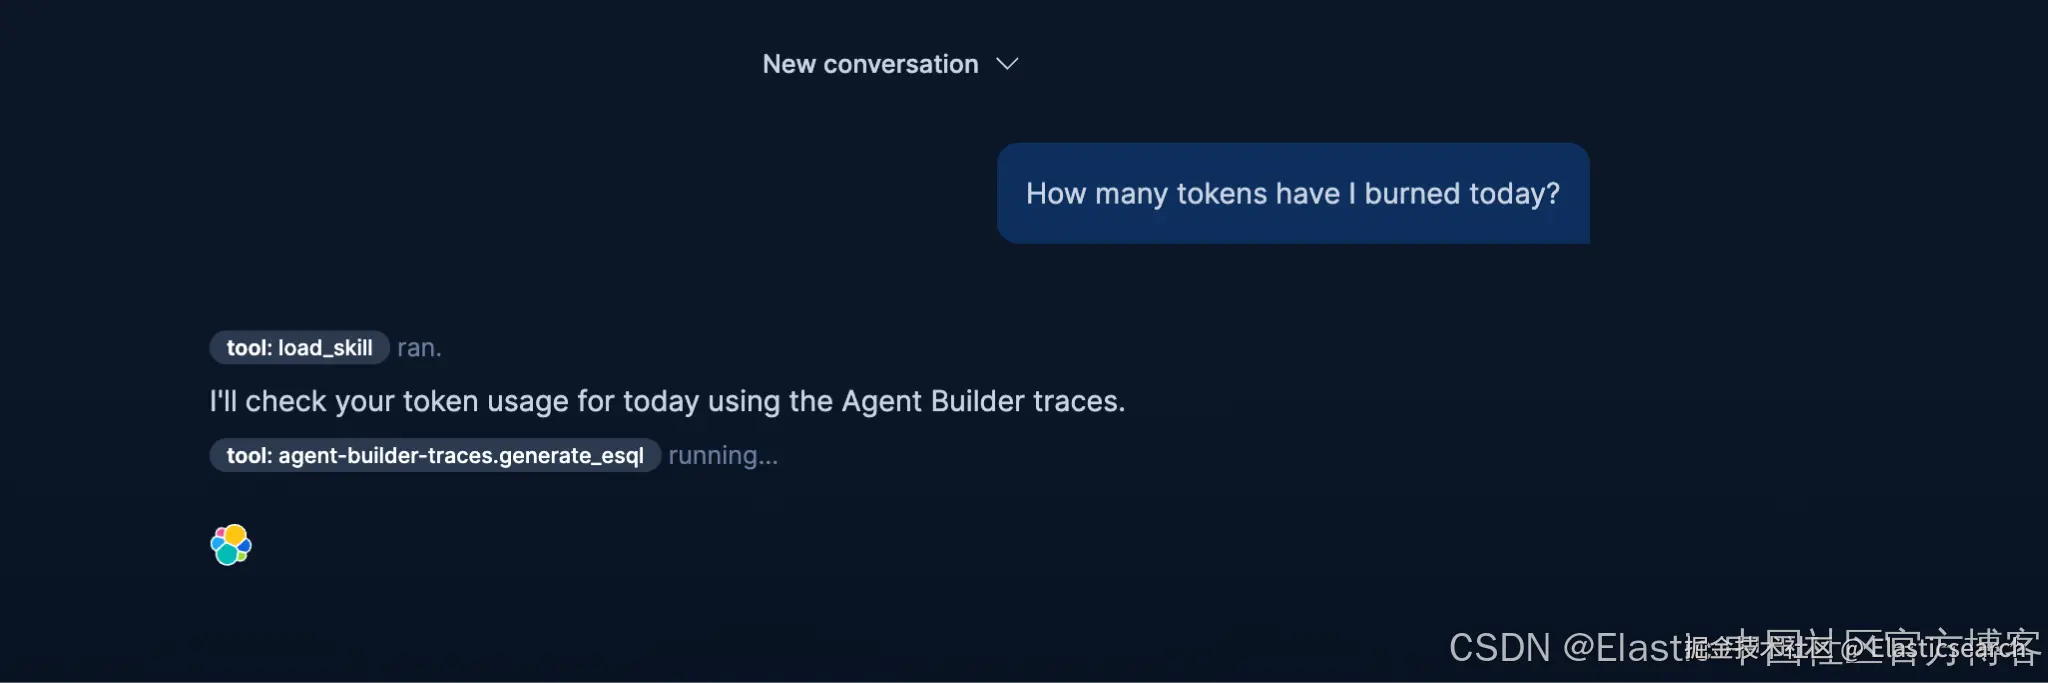
询问 Elastic Agent Builder 你的 agent 今天消耗了多少 token,它会编写Elasticsearch 查询语言(ES|QL),并针对你的 OpenTelemetry(OTel)跟踪数据运行该查询。然后,它会在聊天界面中给出答案。对于其他 agent 性能问题也是如此:哪个工具失败次数最多?哪些对话轮次最慢?用户实际都在询问什么?Elastic Agent Builder 就是为此而设计的。它允许用户在几分钟内构建基于你的数据的 agent。
如果启用了跟踪功能,那么 agent-builder-traces 技能 已经加载到你空间中的每个 agent 上,无需安装任何东西。我们系列中的第一篇文章介绍了如何启用 OTel 跟踪,以及开箱即用(OOTB)的仪表板和阈值告警。这篇文章讨论的是如何进行提问。
什么是 agent-builder-traces 技能?
agent-builder-traces 是 Agent Builder 的内置技能。它接收一个自然语言问题,从中生成 ES|QL 查询,针对你的跟踪索引执行该查询,然后返回一份自然语言 摘要 。它针对的索引是 traces-agent_builder.otel-<space-id>,其中 <space-id> 是你正在使用的 Kibana 空间。使用精确的、限定空间的索引模式,而不是通配符,可以避免其他空间的数据出现在你的结果中。
在底层,该技能使用单个内联工具:agent-builder-traces.generate_esql。你不需要直接调用此工具,而是提出一个问题,然后 agent 会代表你调用该工具,并将你的问题作为生成 ES|QL 的提示词传递给它。该工具会解析当前空间的跟踪索引,使用默认模型构建查询,针对 Elasticsearch 执行查询,然后返回结果。
哪些隐私设置控制你的跟踪数据捕获哪些内容?
多个包含敏感信息的字段默认处于关闭状态。你可以在 Gen AI 设置 (Stack Management > AI Assistants )中的 "Agent Builder Traces" 部分启用这些字段。展开高级隐私设置即可找到它们。
| 设置键 | 捕获的内容 |
|---|---|
agentBuilder:tracing:includeUserPrompts |
用户消息 |
agentBuilder:tracing:includeLlmResponses |
大型语言模型(LLM)响应文本 |
agentBuilder:tracing:includeToolDetails |
工具调用参数和结果 |
agentBuilder:tracing:includeSystemPrompt |
agent 的系统提示词 |
agentBuilder:tracing:includeRealNames |
真实的工具、agent 和对话名称(关闭时进行哈希处理) |
agentBuilder:tracing:includeRealIds |
真实的对话和工作流 ID(关闭时进行哈希处理) |
agentBuilder:tracing:includeUserData |
真实的用户 ID 和用户名(关闭时进行哈希处理) |
为什么我的跟踪分析查询返回空行?
如果技能返回空行,或者告诉你某个字段不可用,请检查两件事:相关设置是否已在你的配置中启用,以及你的查询时间范围是否与任何已记录的跨度重叠。技能会准确报告查询返回的内容;当字段为空时,它不会编造内容。
可以询问哪些 agent 性能问题?
你可以询问的问题示例包括:
我的 agent 按模型使用了多少 token?
询问: 在过去 24 小时内,我的 agent 按模型分别使用了多少输入和输出 token?
ES|QL:
sql
`

1.  FROM traces-agent_builder.otel-<space-id>
2.  | WHERE span.name LIKE "chat *" AND @timestamp >= NOW() - 24 hours
3.  | STATS
4.      input_tokens  = SUM(TO_LONG(attributes.gen_ai.usage.input_tokens)),
5.      output_tokens = SUM(TO_LONG(attributes.gen_ai.usage.output_tokens))
6.    BY attributes.gen_ai.request.model
7.  | SORT input_tokens DESC

`AI写代码
每个 token 字段外层的 TO_LONG() 类型转换都是必需的。这些字段在不同索引版本中可能以混合的 integer 和 long 类型出现,而 ES|QL 的 SUM() 需要先进行显式的数值转换,然后才能对它们进行聚合。如果你针对该索引编写自己的查询时遇到意外的类型错误,通常就是这个原因。
哪些工具失败次数最多?
询问: 在过去 7 天内,每个工具的错误率是多少?
ES|QL:
sql
`

1.  FROM traces-agent_builder.otel-default
2.  | WHERE @timestamp >= NOW() - 7 days
3.  | WHERE span.name LIKE "execute_tool *"
4.  | STATS total_calls = COUNT(*), error_count = COUNT(*) WHERE status.code == "Error" BY tool_name = attributes.gen_ai.tool.name
5.  | EVAL error_rate_pct = ROUND(error_count * 100.0 / total_calls, 2)
6.  | SORT error_rate_pct DESC
7.  | LIMIT 100

`AI写代码
工具错误率查询会聚合名称为 'execute_tool' 的跨度,并将 status.code == "Error" 的计数与每个工具名称的总计数进行比较。结果会显示哪些工具最经常失败。
哪些对话轮次最慢?
询问: 显示过去一小时内最慢的 10 个对话轮次。
ES|QL:
sql
`

1.  FROM traces-agent_builder.otel-default
2.  | WHERE @timestamp >= NOW() - 1 hour
3.  | WHERE span.name LIKE "invoke_agent *" AND attributes.elastic.inference.span.kind == "CHAIN"
4.  | EVAL duration_seconds = duration / 1000000000.0
5.  | KEEP attributes.gen_ai.conversation.id, attributes.gen_ai.agent.id, @timestamp, duration_seconds
6.  | SORT duration_seconds DESC
7.  | LIMIT 10

`AI写代码
该技能会查询满足 span.name LIKE "invoke_agent *" 且 attributes.elastic.inference.span.kind == "CHAIN" 的跨度。这些跨度对应单个对话轮次,从用户发送消息开始,到 agent 返回响应结束。持续时间以纳秒存储,因此该技能会先将其转换为秒,然后再进行排序。
用户都在询问我的 agent 什么?
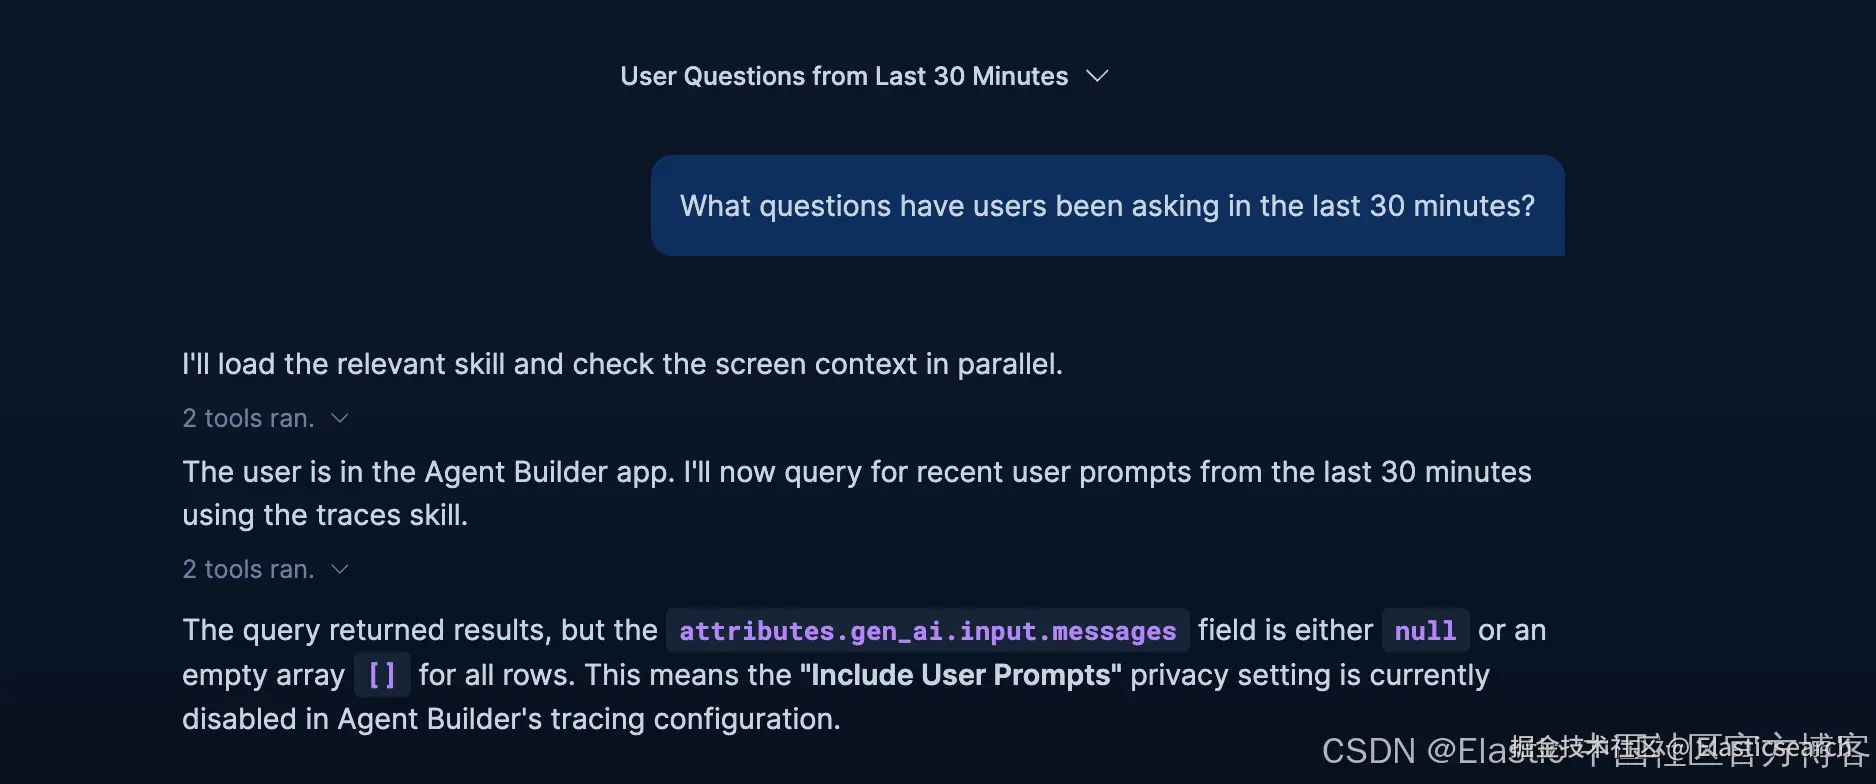
询问: 过去 30 分钟内,用户都向我的 agent 提出了哪些问题?
ES|QL:
sql
`

1.  FROM traces-agent_builder.otel-default
2.  | WHERE @timestamp >= NOW() - 30 min
3.  | WHERE span.name LIKE "chat *"
4.  | WHERE attributes.gen_ai.input.messages IS NOT NULL
5.  | SORT @timestamp DESC
6.  | KEEP @timestamp, attributes.gen_ai.conversation.id, attributes.gen_ai.input.messages
7.  | LIMIT 100

`AI写代码
最近提示词查询仅在 agentBuilder:tracing:includeUserPrompts 设置为 true 时返回数据。当该设置关闭时,attributes.gen_ai.input.messages 字段为空,该技能会建议你检查包含用户提示词隐私设置。
什么时候应该改用 Discover 或 Kibana Lens?
该技能针对一个索引模式:traces-agent_builder.otel-<space-id>。有两种场景超出了这一范围。
该技能可以查询我自己的应用索引吗?
如果你想针对自己建立索引的数据运行临时查询,请使用通用数据探索技能,或者直接在 Discover 中编写 ES|QL。agent-builder-traces 技能不会查询 Agent Builder 跟踪索引之外的数据。
该技能可以创建或编辑仪表板吗?
该技能专注于临时查询和生成摘要文本。如果你的目标是根据跟踪数据构建永久可视化,请改用 Lens 或 dashboard-management 技能。我们在系列第一篇文章中详细介绍了这一具体流程。
该技能与另外两种监控 agent 的方式并列存在。
| 工具 | 最适合 | 你在什么情况下使用 |
|---|---|---|
agent-builder-traces 技能 |
临时的 agent 性能问题 | 你注意到某些问题,希望在不离开聊天界面的情况下获得答案 |
| 开箱即用仪表板 | 持续可见性 | 你希望在不提出任何问题的情况下查看一段时间内的趋势 |
| 阈值告警 | 自动化监控 | 你定义一次条件,并在条件被突破时收到通知 |
如何根据 agent 跟踪数据构建评估流水线
traces-agent_builder.otel-<space-id> 中的跨度会捕获你空间中每个对话轮次和 LLM 调用的实际执行数据。这些记录是评估流水线的原始材料:针对每种 agent 类型自动检查响应质量和延迟预算,以及在更新系统提示词时进行回归检测。我们系列的下一篇文章将介绍如何利用 Agent Builder 已经收集的跟踪数据构建这些评估循环。
原文:Agent performance trace analysis: Ask Elastic Agent Builder | Elasticsearch Labs