去年还在强调语义搜索,今年怎么开始用 grep 了?
Cursor 前后的公开说法,确实发生了变化。顺着这件事,我们用一个登录问题,看看 AI 是怎样从"等人喂资料",变成"自己追线索"的。
先限定范围:本文讨论部分编程 Agent 的检索设计。现有资料不能证明全行业的向量数据库用量都在下降。
1. 同一个 Cursor,前后说了什么?
2025 年 11 月:语义搜索能改善结果。
Cursor 在官方博客里公布了一组对照测试:给 Agent 配上语义搜索工具,受测模型的表现都有提升。1
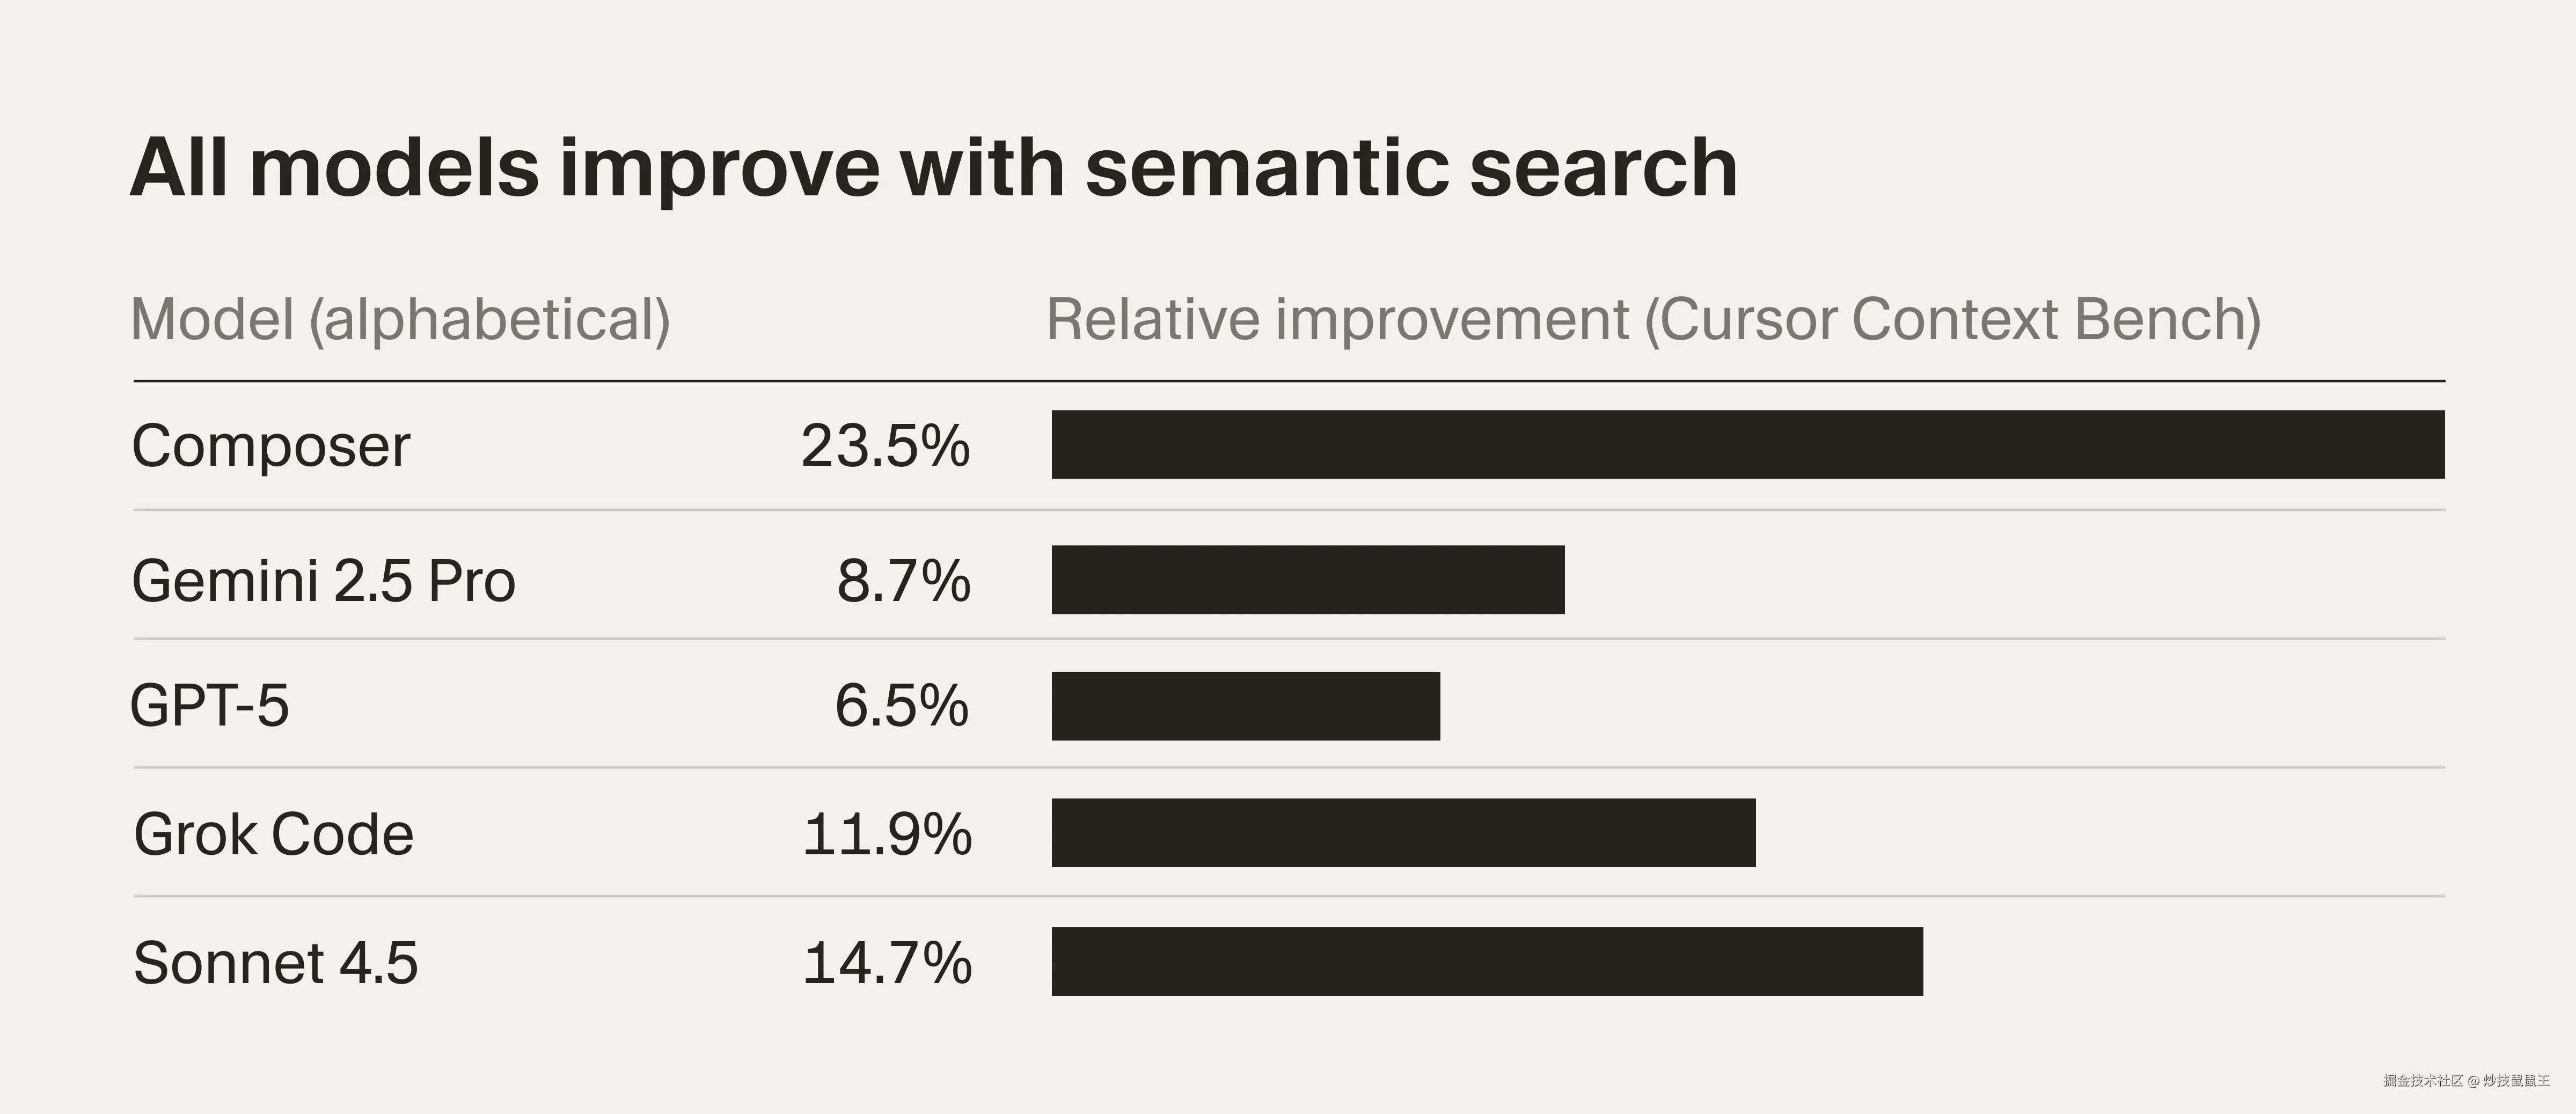
图 1|这张图,来自当时支持语义搜索的证据。
来源:Cursor,2025-11-06。横条表示其代码问答评测中的相对提升,不是提升了同等数量的百分点,也不代表 2026 年模型的结果。
2026 年 7 月:逐步转向基于 grep 的检索。
Cursor 官方论坛的 Colin 确认,语义/embedding 索引正在逐步停用。现在的模型会尝试多个搜索词,再看目录、读文件,继续缩小范围。2
把两份资料放一起看,值得关注的是:模型和工具变了,合适的检索组合也会变。 用去年的测试证明"永远需要",或用今年的调整证明"彻底没用",都走得太远。
2. 先把三个词拆开
Harness:让模型持续干活的配套机制。
模型提出"我要查文件",Harness 调用工具、接回结果,让模型继续判断;它还处理权限、历史信息和执行边界。这里说的不是某家同名公司的产品。
向量检索:按意思找内容。
你问"怎么退出账号",文档写"终止会话"。文字没对上,意思却接近。Embedding 把文本变成一串数字,检索系统据此寻找相似内容。
向量数据库:存储和查询这些向量。
它是实现方式之一。PostgreSQL 加上 pgvector,也能做向量相似度搜索,不一定要再部署一种数据库。5
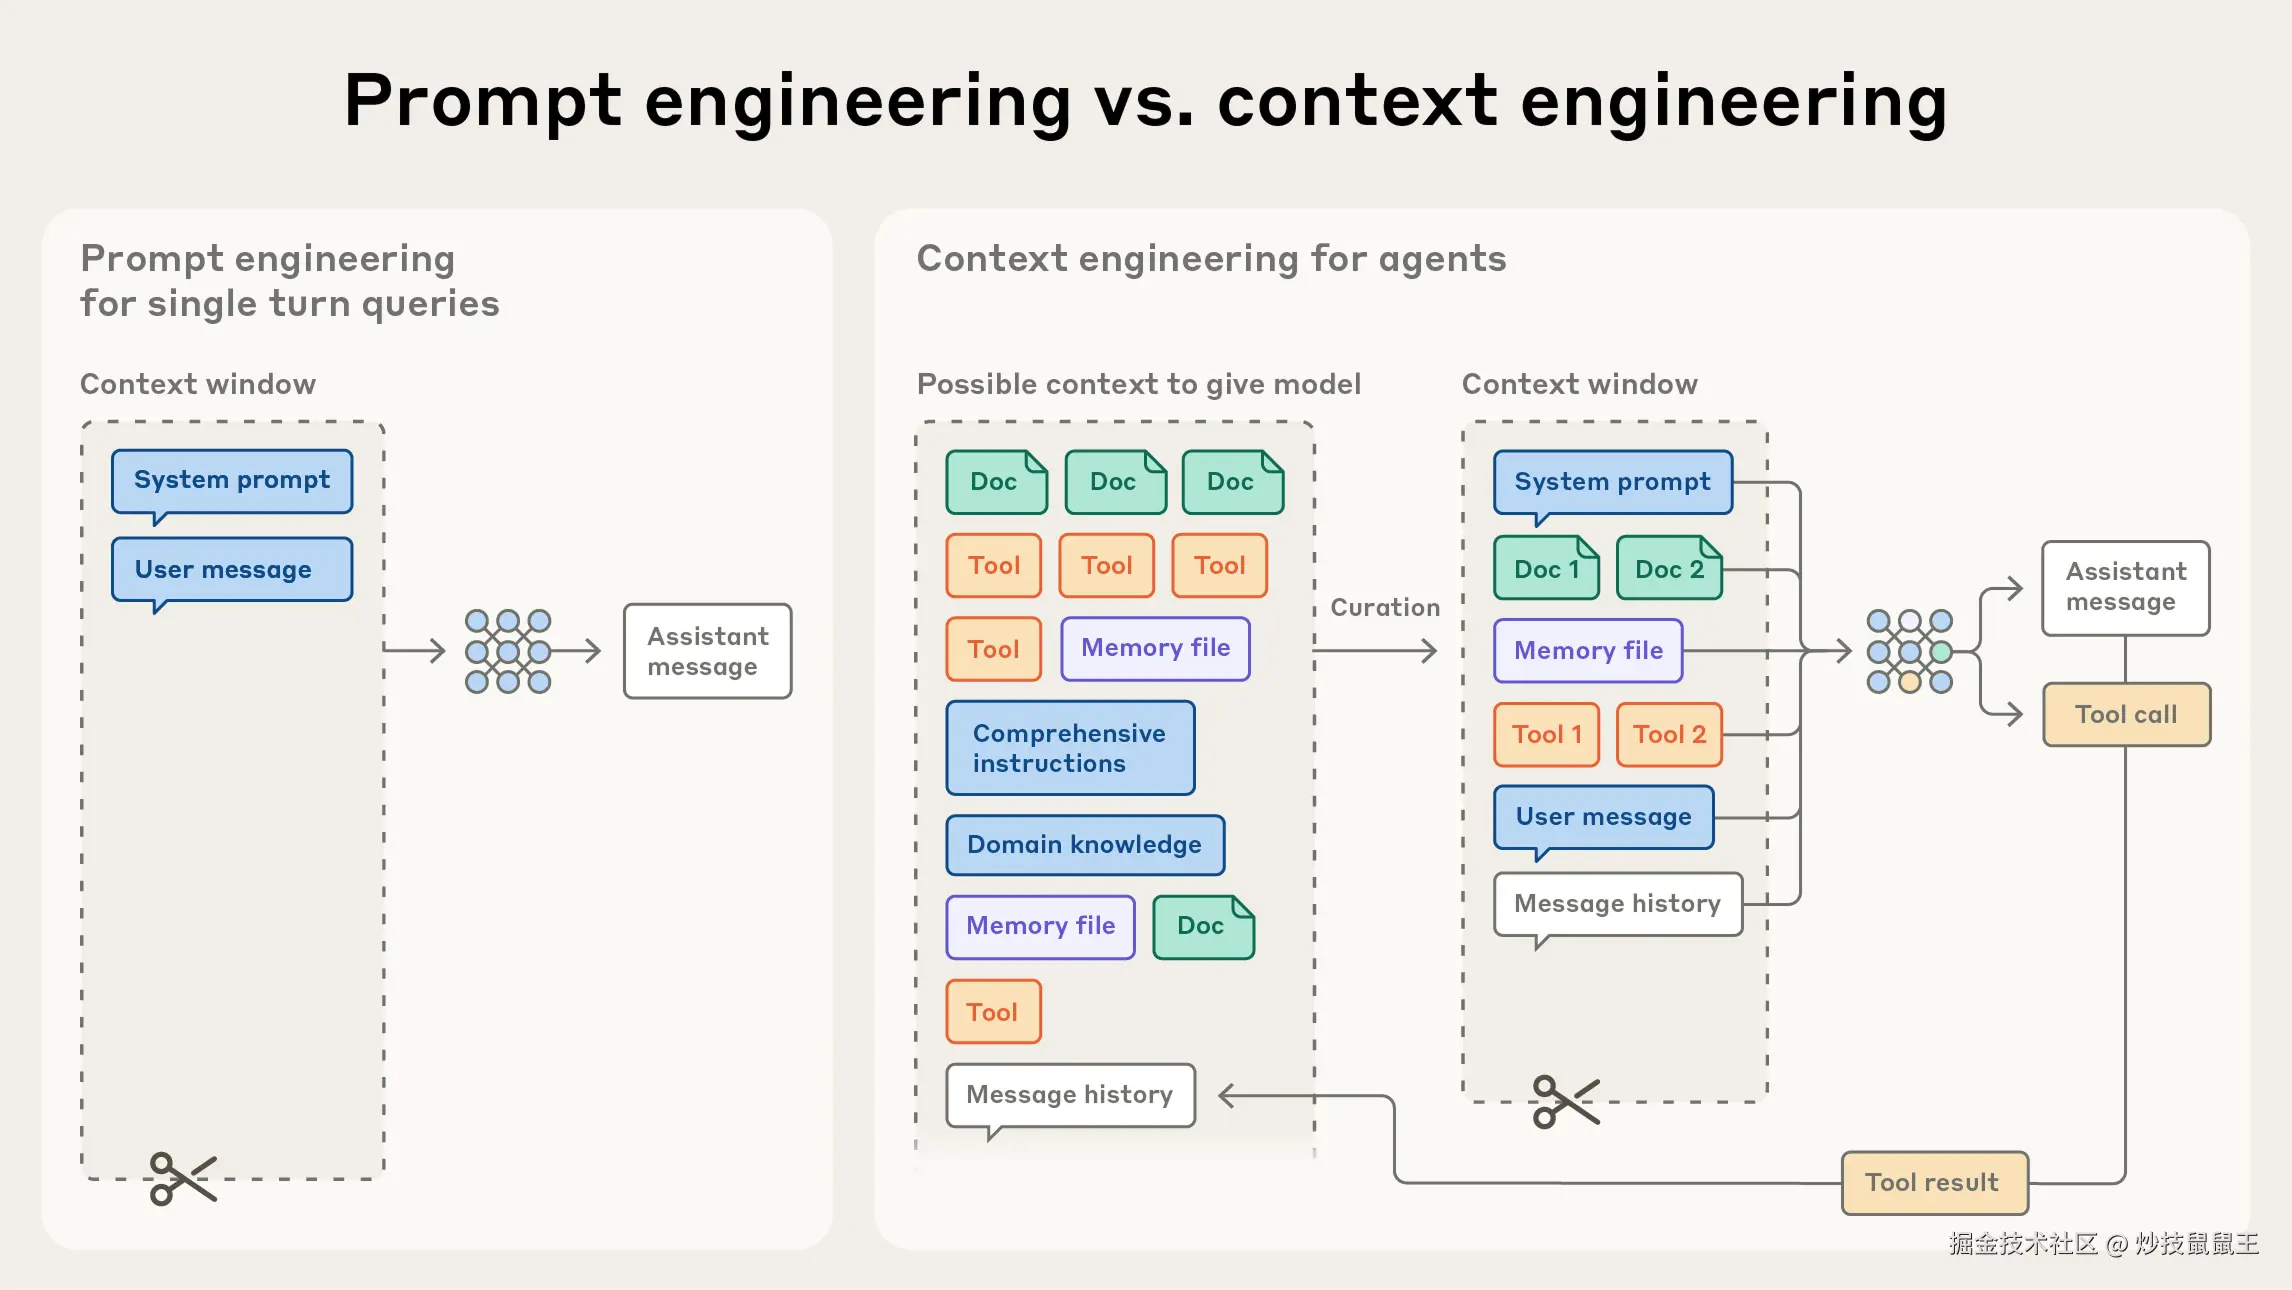
图 2|模型每次看什么,需要有人组织。
来源:Anthropic,2025-09-29。左边是单轮提示,右边把文档、工具、记忆和历史筛选后交给模型;工具结果再进入下一轮。重点看右侧的回路。3
这也是为什么换掉向量检索,未必等于放弃 RAG。RAG 的核心是找资料,再借助资料回答;查资料有多种办法。
3. 用一个登录问题,看懂变化
用户:登录明明成功了,为什么又跳回首页?
以下是假设项目中的机制示例,不是产品实测。先别管数据库,跟着 Agent 查一次。
第一步:找一个入口。
grep 类工具可以理解成"在文件里查文字"。如果假设项目有 src 目录,Agent 可以用 ripgrep 搜索登录和跳转线索:
sh
rg -n 'login|redirect|returnTo' src不用记命令。看懂它的意思就够了:在源码里找这几个词,并带上行号。
第二步:读到具体字段,换更准的线索。
假设打开的函数里有这样一行:
js
const next = session.returnTo || "/";现在问题具体了:returnTo 没有有效值时,会回到 /。接下来要查的是它在哪里被写入、是否中途被清空,以及产品本来希望怎样跳转。
第三步:继续查,最后验证。
text
搜登录线索 → 读跳转函数
           ↓
       查 returnTo 的来源
           ↓
     核对预期 → 修改 → 运行测试
找到这一行,只是提出了假设。测试通过、行为符合预期,才算完成排查。
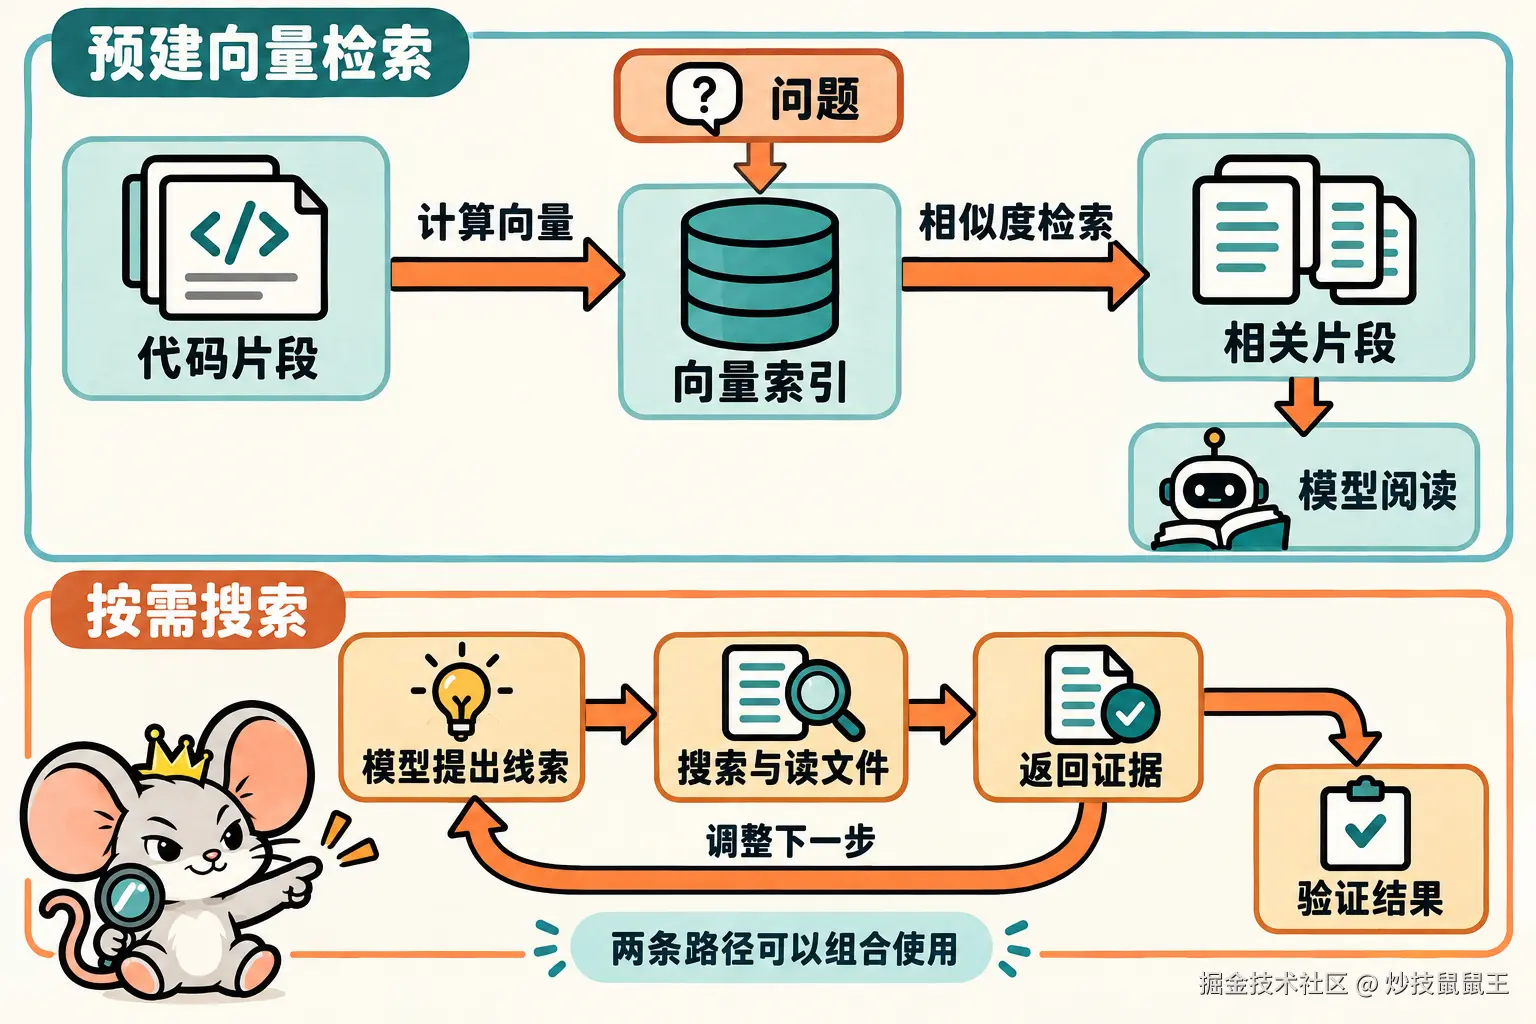
图 3|检索可以是一次找入口,也可以是一边做一边找。
上半部分是预建向量索引的一条常见路径;下半部分是按需搜索循环。二者能组合使用。图中省略了问题的向量化、权限与错误处理。
变化发生在"下一步搜什么"的判断上。 grep 负责找字,模型读完结果后,负责调整方向。第一次没搜准,也有机会沿新线索继续找。
4. 为什么现在更愿意这么做?
模型更会追线索了
一个搜索词没命中,可以换词、看目录、读相邻函数。Cursor 7 月的解释,强调的就是当前模型与快速搜索工具的组合。2
代码经常需要精确对号
returnTo、错误码、接口路径,都是明确线索。相似片段能帮忙找入口,真正排错还得追到变量、分支和调用位置。
少维护一条同步链路
代码向量索引通常要经历"发现文件---切分---计算向量---更新索引"。项目改动、分支切换,都要处理内容是否及时同步。
搜索当前工作区,可以省去其中一些环节。但 grep 也可能使用索引:Cursor 的 Instant Grep 就维护本地文本索引。少用向量索引,不等于彻底不用索引。24
省下向量服务,不等于整个任务必然更便宜。
多搜几轮,也会增加模型调用和等待时间。要比较的是把任务做完的总成本。
5. 我的项目,要跟着删数据库吗?
先看手里有什么线索。
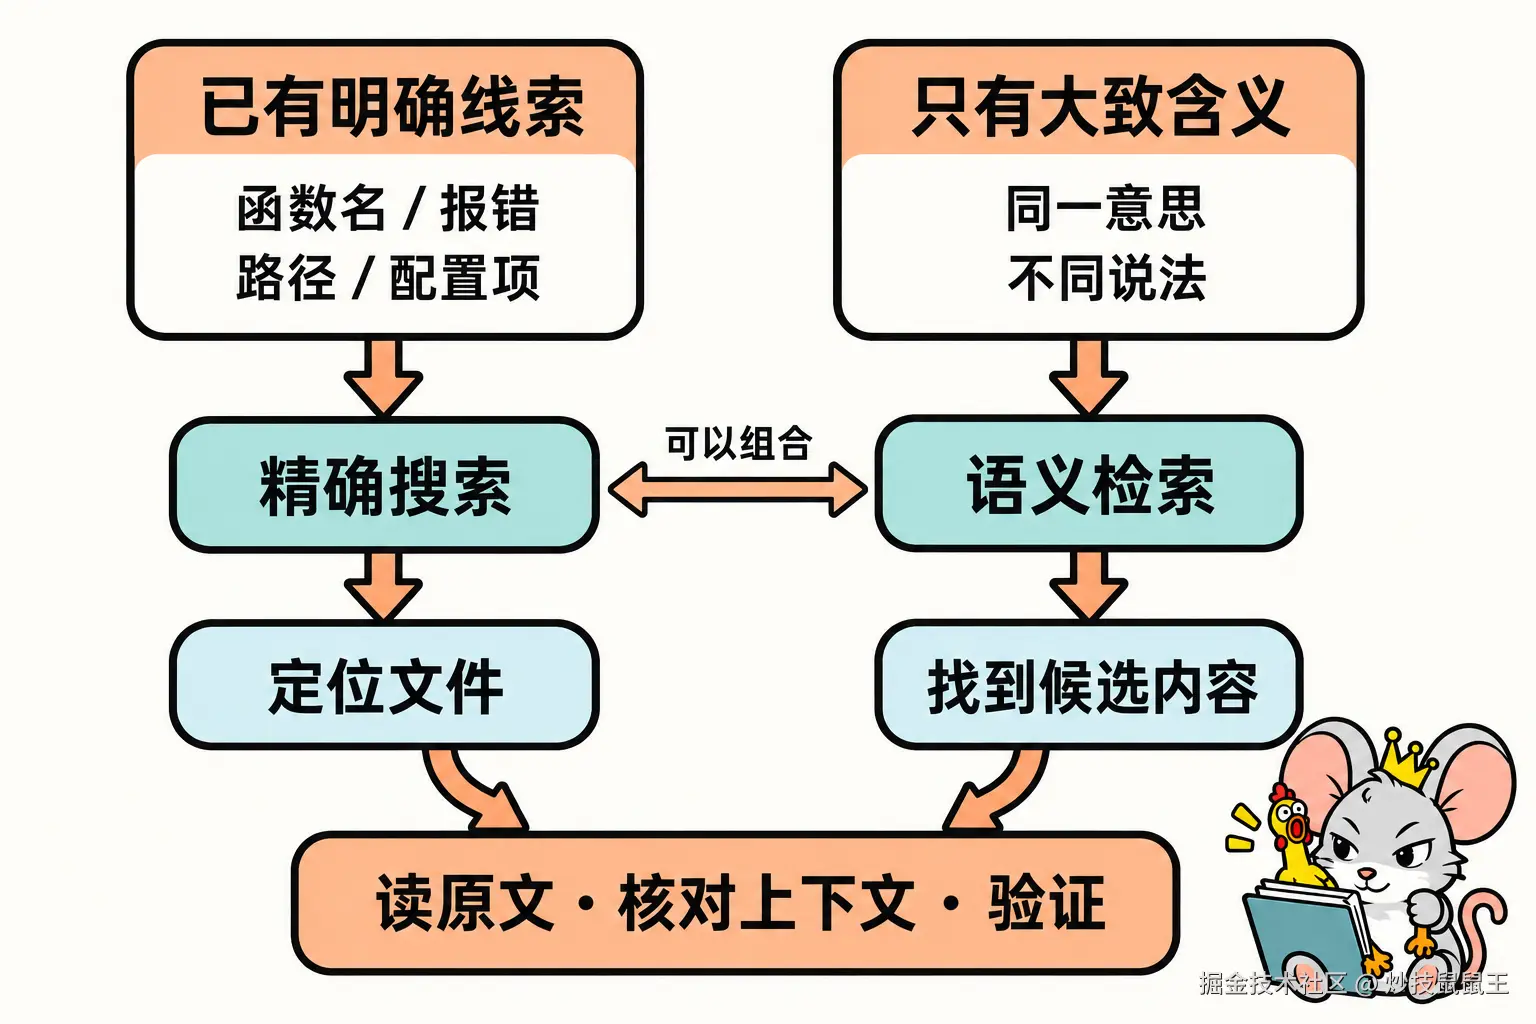
图 4|按线索选工具,比按热词选架构实用。
已有名字、路径或报错,可以从精确搜索开始;只有大致意思、资料用词差别很大,可以尝试语义检索。两条路都要核对原文。
例如你想找"换平台后旧数据会不会丢",客服记录写的是"历史订单能否迁移"。这类表达变化多的资料,仍然是语义检索值得发挥作用的地方。
也可以搭配:语义检索找业务模块 → 精确搜索定位函数 → 读完整代码 → 验证。
已经有能工作的方案,我会先留着。挑一组真实问题,在相同模型和代码版本下,对比:
| 要记录什么 | 为什么要看 |
|---|---|
| 最后做对了吗 | 搜到相似片段不等于解决问题 |
| 花了多久、多少钱 | 把多轮调用和索引维护算进去 |
| 失败漏了什么 | 判断该补关键词、语义搜索还是工具设计 |
下一次 Agent 漏掉你明明写过的代码,就把问题、正确文件和搜索过程留下来。先找到它到底卡在哪,再决定删哪一层。
资料与图片来源
核对日期:2026-09-24。登录代码为教学示例,选型部分为建议。
- Cursor:语义搜索测试与图 1,2025-11-06。
- Cursor 官方论坛:索引调整说明,2026-07-22。
- Anthropic:上下文工程与图 2,2025-09-29。
- Cursor:Instant Grep 的文本索引,2026-03-23。
- pgvector 官方文档。