本文基于 FAST Kit 官方 SDK 页与华为开发者官方渠道发布的 API 26 Beta2 新能力说明整理。文中代码为说明接入结构自写的示意代码,精确函数签名以官方 API 参考为准;性能数字均为官方口径(非V哥实测),已逐条标注出处;涉及真机表现的部分以真机实测为准,未做任何实测数据编造。
引子:卡的那几百毫秒,藏在你自己写的循环里
应用性能优化做到深处,拼的不是布局技巧,是算法:文件列表按名字排序,中文排序乱七八糟;缓存用普通 Map,条目一多增删改查就钝;音频处理手写循环,一条 track 算完电也掉了半格。这些事的共同点是------底层逻辑谁都写得出来,但写得高效的没几个。
FAST Kit(算法加速服务)解决的就是这个 :华为把难编写、易出性能问题的底层算法做了系统级封装,开发者不用自研底层逻辑,一步调用拿结果(FAST Kit 官方页)。HarmonyOS 7(API 26)Beta2 起又新增四项核心能力,这期V哥把它们逐一拆开:各自管什么、快多少、什么场景该上。
一、定位:系统级算法库,不是又一个三方库
FAST Kit 的官方定位是"以理论计算机为基础、面向开发者提供算法加速能力"。当前的功能域覆盖:高阶数据结构(线段表、并发哈希表)、规划求解(矩形划分求解器、多项式零点求解器)、数字信号处理(向量运算、FFT、二阶 IIR 滤波)、容器(哈希表)、算法(通用排序、自然语言排序)、数理预测(智能序列预测)。
和三方库的区别在两层:算法有理论保证 (不是工程上的"大概快",是有复杂度证明的那类结构),实现贴硬件(DSP 接口基于 ARM NEON 指令集做向量计算深度优化)。
一条硬边界先记住:FAST Kit 目前仅中国大陆可用,支持手机、平板、PC/2in1 设备,模拟器支持(官方约束)。面向海外的应用要另做备选方案。
二、四大新增能力逐一拆
能力 1:高效自然语言排序------列表体验的"直觉补丁"
传统字符编码排序低效且反直觉。FAST Kit 的自然语言排序按人类直觉处理:中文按拼音排,数字序列按数值比较------file1、file2、file10,而不是 file1、file10、file2。
官方性能口径:热点列表场景对比基线三方库国际化排序,性能提升 60%~70%。适用场景很明确:文管类应用的文件名、人名、地名排序及字符串索引。
能力 2:高性能数据结构------单线程多线程各有一个
两个哈希表,分工不同:
- 高性能哈希表(单线程) :对比 std::unordered_map 性能提升 30%~80%(官方口径),适用缓存管理、常量对象池这类高性能 key/value 存储;
- 并发哈希表(多线程) :12 核场景下对比 std::unordered_map + 全局锁方案,并发吞吐量提升约 8~10 倍(官方口径),适用分布式网关路由 Session 查找、游戏引擎光照区域管理、网络连接池句柄映射。
并发哈希表还配套调试支持:DFX 错误码标记接口运行情况,DevEco Studio Debug 模式下可用 LLDB 追踪句柄状态------性能库不带调试能力,出了问题就是黑盒,这点官方想在了前面。
能力 3:数字信号处理接口------NEON 指令集的白嫖通道
针对音频处理、信号处理、数组计算场景,API 26 新增底层 DSP 接口,基于 ARM NEON 指令集做向量计算深度优化。核心接口四组(接口名引自官方说明):
| 接口组 | 管什么 |
|---|---|
Vsmul / Vsdiv / Svdiv / Vsadd |
音频归一化与增益 |
Zvabs / Zvmags / Zvphas |
幅值 / 相位提取 |
Mmul / Conv |
矩阵变换 / 卷积 |
FFT |
快速傅里叶变换 |
官方给的使用注意就一条但很致命:stride(元素间隔)与 length(元素个数)必须正确设置,避免数组越界。向量接口跑在裸内存上,越界不是抛异常,是未定义行为。
能力 4:多项式零点求根------金融与科学计算的精度保障
一元多项式的实根隔离与精确求解:输入稀疏格式描述的多项式(FAST_Poly 结构体),通过 HMS_FAST_PolyRoot_ComputeRoots 等接口求解(接口名引自官方说明)。适用金融年化利率计算、计算机辅助设计、信号处理、控制理论。这个能力小众,但对做金融计算的应用是刚需------利率求根手写迭代,精度和收敛性都难保证。
三、场景到能力的映射:对号入座
V哥把选型压成一张表(见配图),四个高频场景对应四个能力:
| 你的场景 | 上的能力 | 官方性能口径 |
|---|---|---|
| 文管/通讯录列表排序 | 自然语言排序 | 热点列表提升 60%~70% |
| 缓存、对象池(单线程) | 高性能哈希表 | 提升 30%~80% |
| 网关 Session、连接池(多线程) | 并发哈希表 | 吞吐量提升约 8~10 倍 |
| 音频/传感器信号处理 | DSP 向量接口 + FFT | NEON 指令集级优化 |
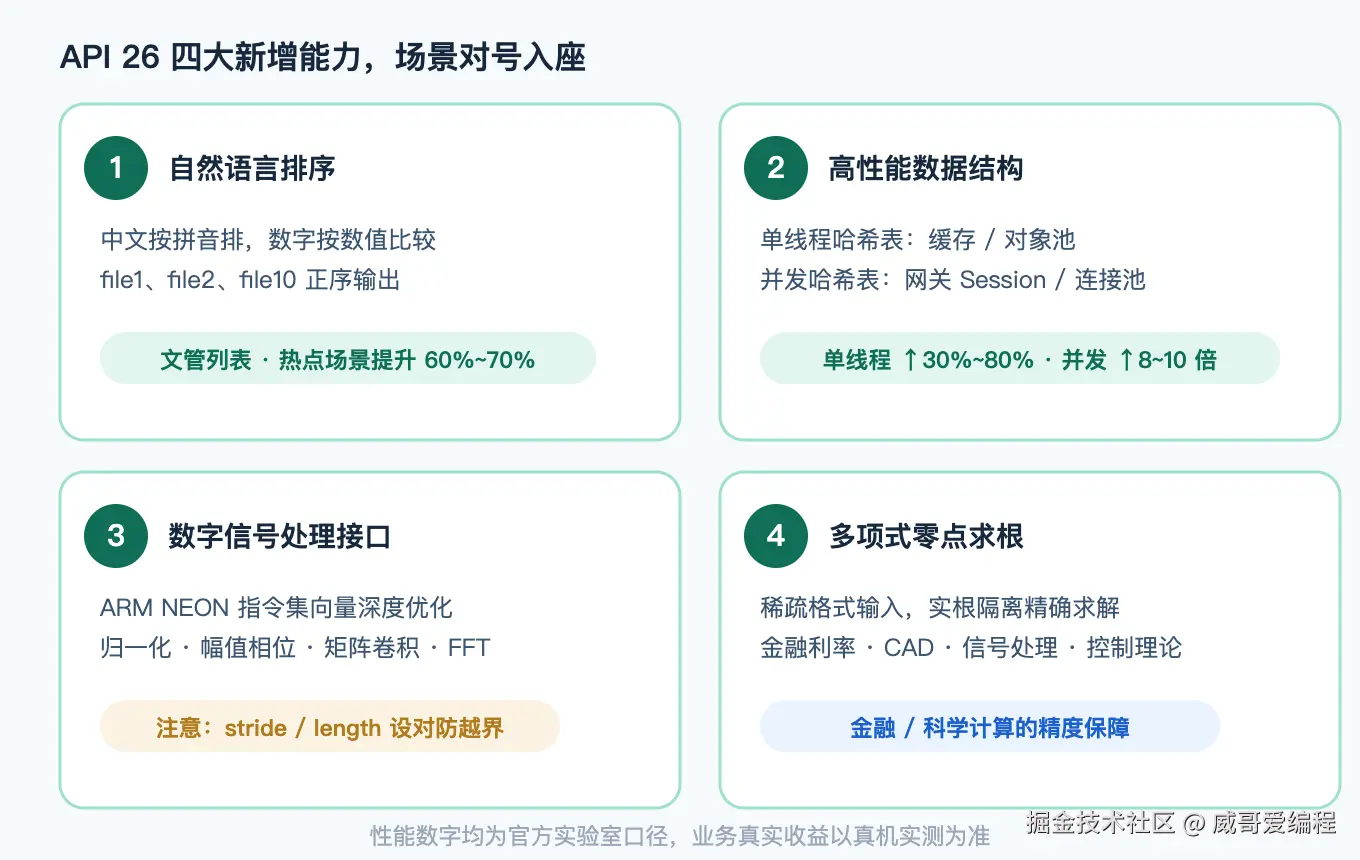
再强调一次:以上数字均为官方实验室口径,你自己业务的真实收益以真机实测为准------接入前后各跑一轮基准测试,拿数据说话。
四、接入注意:三条工程纪律
① 这些接口的主战场在 NDK 侧。 线段表、DSP、求根器都是底层 C 接口,ArkTS 业务要通过 N-API 桥接。桥接层的纪律:句柄 Create 和 Destroy 成对出现(挂在 onDestroy 里显式销毁),缓冲区用智能指针管理,别裸奔。
② 向量运算的输入要对齐、等长。 DSP 接口为极致优化要求参与运算的数组长度一致;浮点输入里的亚正规数可能引发处理管线排空,先做阈值校验。
③ 并发哈希表别再外面套全局锁。 8~10 倍的吞吐提升来自去掉锁竞争,你在外面再包一把大锁,等于白接。
五、V哥的判断:什么时候值得接
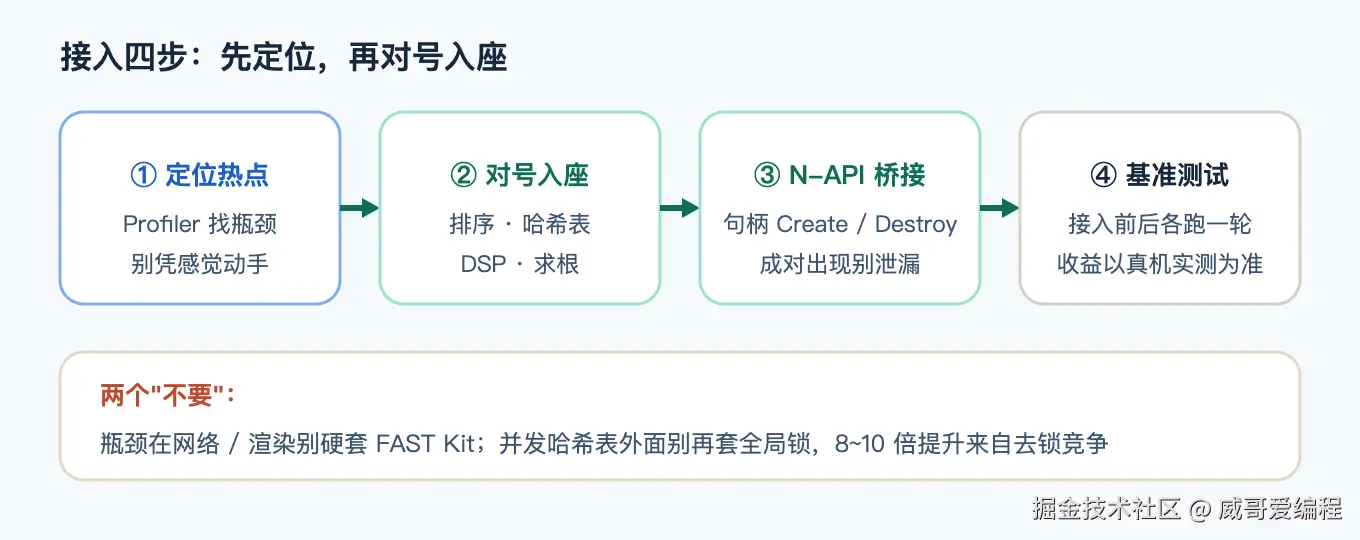
FAST Kit 不是"用了就快"的万金油,它解决的是计算密集型场景:启动、数据解析、格式转换、信号处理、大规模数据统计。你的瓶颈如果在线程调度、网络、渲染,该去的地方是 TaskPool、网络库和渲染优化,别拿着向量接口硬套。
一个实用的接入顺序:先用 Profiler 定位热点 → 热点落在排序/哈希/信号计算上 → 对号入座上 FAST Kit → 基准测试对比收益。跳过定位直接全量接入,大概率是白忙。
参考与出处
本文涉及的能力说明与性能数字来自以下官方材料,均为V哥动笔前逐条核验的原文出处:
最后一句:性能优化的尽头不是把循环写得更花,而是承认"系统里已经有人把这道题解到最优"------FAST Kit 把理论计算机科学的保证封装成一次调用,你要做的只是找到热点、对号入座、然后相信数学。