Session、Thread 持久化与 Memory
这部分只抓三条线:
| 层 | 保存什么 | 用途 |
|---|---|---|
Session.state.history |
当前会话的内存历史 | 继续当前 Agent Loop、编译下一轮 Prompt |
ThreadStore / Rollout |
可恢复的过程记录 | 重启恢复、审计、分叉 |
Memory |
从多个 Rollout 提取的长期知识 | 后续会话读取和引用 |
1. 一次消息怎样写入
需要进入模型历史的用户输入、完整模型输出、工具调用和工具结果,会进入 Session 的记录入口。这里以 record_conversation_items 为例:先把 ResponseItem 封装成带元数据的 ResponseItemEnvelope,再更新内存历史、记录持久化项并发送原始响应项通知。文本增量等实时事件不必先进入这条记录链。
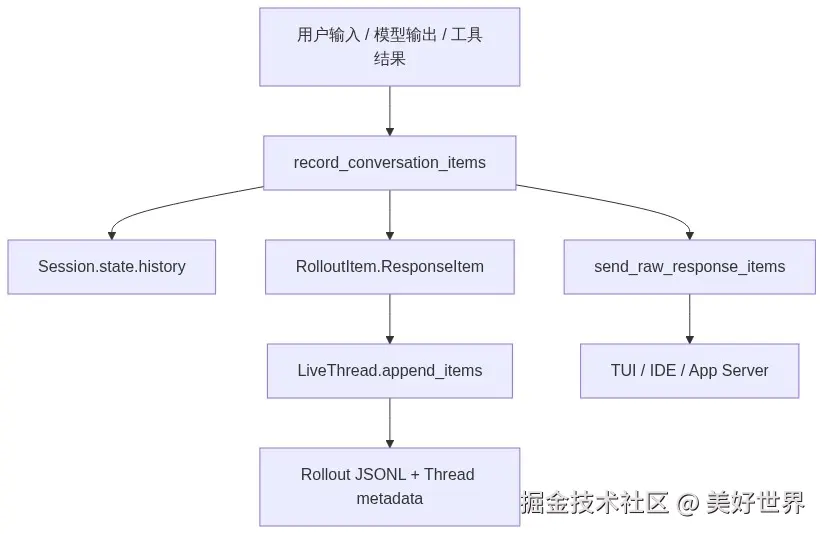
核心入口位于 session/mod.rs:3245:
rust
pub(crate) async fn record_conversation_items(
    &self,
    turn_context: &TurnContext,
    items: &[ResponseItem],
) {
    let (items, image_preparations) =
        self.prepare_conversation_items_for_history(turn_context, items);

    let items = items
        .into_owned()
        .into_iter()
        .map(ResponseItemEnvelope::new) // 给记录绑定统一 envelope/metadata
        .collect();

    self.record_prepared_conversation_items(
        turn_context,
        items,
        image_preparations,
    ).await;
}
进入 record_prepared_conversation_items() 后,先更新内存历史:
rust
let mut state = self.state.lock().await;
state.history.record_annotated_items(
    &items,
    turn_context.model_info().truncation_policy.into(),
);
这保证同一进程内下一轮 clone_history() 能立即看到新数据,不需要重新读磁盘。
随后把同一批记录转换并落盘:
rust
let rollout_items: Vec<RolloutItem> = items
    .into_iter()
    .map(RolloutItem::ResponseItem)
    .collect();

self.persist_rollout_items(&rollout_items).await;
最后发布原始响应项:
rust
self.send_raw_response_items(items).await;这个事件路径只负责通知展示层,不替代历史写入。
2. ThreadStore 怎样把过程写到磁盘
Session 的持久化入口是 session/mod.rs:4020:
rust
pub(crate) async fn persist_rollout_items(&self, items: &[RolloutItem]) {
    if let Some(live_thread) = self.live_thread()
        && let Err(e) = live_thread.append_items(items).await
    {
        error!("failed to record rollout items: {e:#}");
    }
}LiveThread::append_items()(live_thread.rs:203)继续做两件事:
rust
let items = self.persist_appended_items(raw_items).await?;
// 将新增 RolloutItem 写入本地记录

let update = self.metadata_sync.lock().await
    .observe_appended_items(items.as_slice());
// 从新增记录更新 Thread 可查询的 metadata
底层 Rollout 文件是一行一个 JSON 记录。rollout/src/recorder.rs:1980 的核心逻辑是:
rust
let line = serde_json::to_vec(&RolloutLineRef::Item(item))?;
file.write_all(&line).await?;
file.write_all(b"\n").await?;
file.flush().await?;
所以 ThreadStore 保存的是可重放的过程,不是已经拼好的下一轮 Prompt;Prompt 仍由 Session 根据内存历史重新编译。
3. 重启后怎样恢复
恢复入口在 session/mod.rs:1395:
rust
InitialHistory::Resumed(resumed_history) => {
    let turn_context = self.new_default_turn().await;
    let rollout_items = resumed_history.history;
    self.apply_rollout_reconstruction(&turn_context, &rollout_items).await;
}
它不是读取"最后一条消息",而是重放 RolloutItem,恢复用户消息、模型消息、reasoning、tool-call、tool-result、Turn 设置和压缩记录。恢复完成后,主循环仍然通过:
text
clone_history() → for_prompt() → 模型请求把内部对象转换成模型协议消息。
4. 压缩、分叉怎样回到主流程
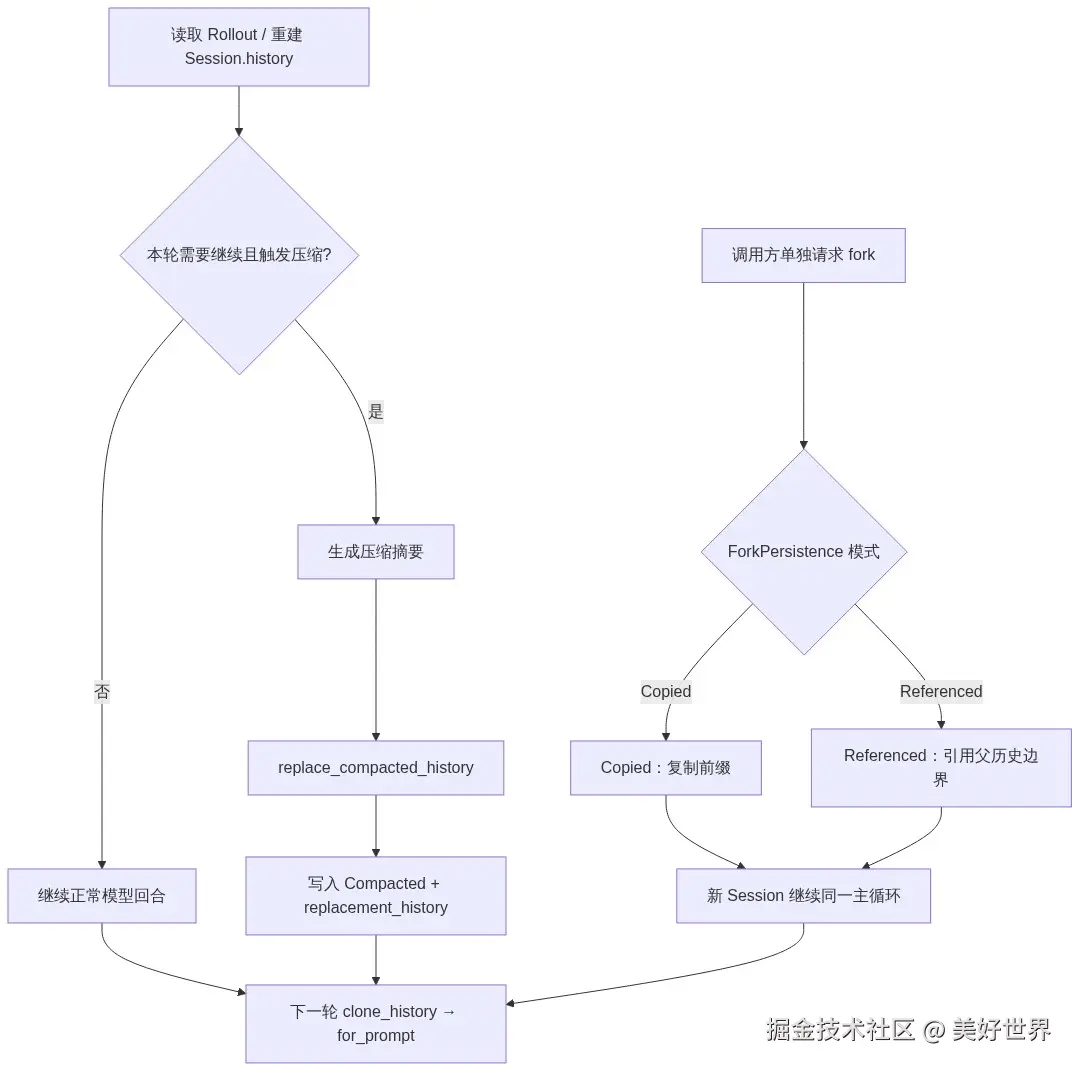
上下文窗口、压缩和 Session fork 都是在"已有历史"上产生新的历史边界;它们不会绕过统一持久化入口。
上下文限制
context_window.rs:35 计算的是活动上下文:
rust
let active_context_tokens = sess.get_total_token_usage().await;
let full_context_window_limit = model_info
    .resolved_context_window()
    .map(|window| window * model_info.effective_context_window_percent / 100);
let token_limit_reached = ...;超过限制时,持久化历史仍保留;只有送给模型的活动窗口被压缩。replace_compacted_history() 会构造 CompactedItem,保存摘要、替换历史和窗口标识,然后更新内存历史并持久化 RolloutItem::Compacted。
Session fork
源码中的 ForkPersistence 有两种边界:
Copied:把父 Session 的历史前缀复制到新 Rollout。Referenced:保存父历史基线和继承项数量,恢复时重放继承部分。
fork 是调用方单独触发的操作,不是每次模型回合后的固定步骤。它只改变新 Session 的历史起点,不改变"记录 → 持久化 → 下一轮 Prompt"的主流程。
5. Memory:从 Rollout 派生长期知识
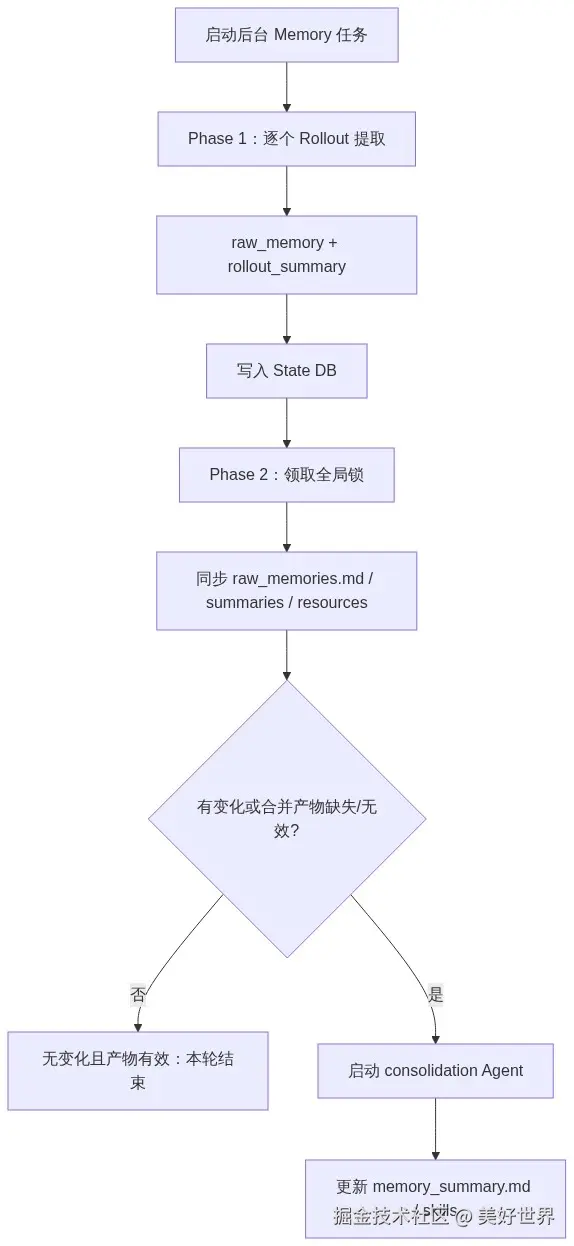
Memory 不是 Session 历史的别名,而是异步派生管线。启动任务在 memories/write/src/start.rs:17 中跳过 ephemeral、禁用 Memory、非 root agent 或缺少 State DB 的场景,然后启动两个阶段。
Phase 1:单个 Rollout
memories/write/src/phase1.rs:55 从 State DB 领取候选任务,并以并发上限处理。sample() 会加载 Rollout、过滤不需要的响应项,构造模型请求并要求结构化输出:
text
RolloutRecorder::load_rollout_items()
    → serialize_filtered_rollout_response_items()
    → 模型生成 StageOneOutput
       { raw_memory, rollout_summary, rollout_slug }
    → mark_stage1_job_succeeded()
这一阶段只写 State DB,不修改当前 Session。
Phase 2:全局合并
memories/write/src/phase2.rs:45 先领取全局锁,再把 Phase 1 产物同步到 $CODEX_HOME/memories,计算 workspace diff 并校验合并产物。只有"没有变化且产物有效"才直接结束;有变化,或产物缺失/无效,都需要启动 consolidation Agent。全局锁避免多个进程并发修改同一套 Memory 文件。
Memory 读取
Memory 工具的根目录由 ext/memories/src/local.rs:29 定位到 $CODEX_HOME/memories。list / read / search / add_ad_hoc_note 都经过 MemoriesBackend,本地实现拒绝 ..、绝对路径、隐藏路径和符号链接逃逸。
读取不是"把所有 Memory 全部塞进 Prompt",而是先给摘要,再由模型按任务选择具体文件:
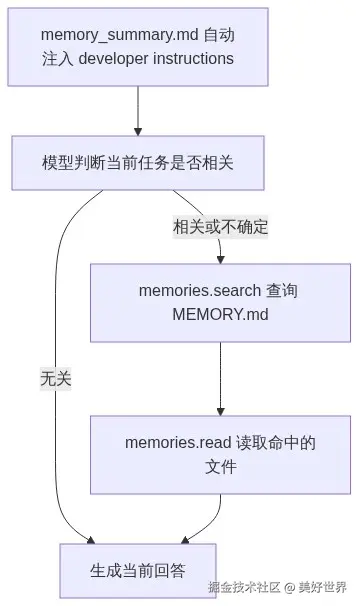
build_memory_tool_developer_instructions()(ext/memories/src/prompts.rs:26)只读取并截断记忆摘要文件,然后将"记忆摘要 + 查找规则"放入 developer instructions:
rust
let memory_summary =
    fs::read_to_string(&memory_summary_path).await.ok()?;
let memory_summary = truncate_text(
    &memory_summary,
    TruncationPolicy::Tokens(
        MEMORY_TOOL_DEVELOPER_INSTRUCTIONS_SUMMARY_TOKEN_LIMIT,
    ),
);
查找规则要求模型按"摘要 → MEMORY.md 索引 → 1~2 个相关摘要或 Skill → 必要时原始 Rollout"的顺序进行轻量检索。因此,程序提供入口和工具,模型根据当前问题决定关键词与文件。
memories.search 的执行代码在 ext/memories/src/tools/search.rs:59:模型传入 queries / path / max_results 等参数,后端再对本地文件做受限文本搜索;搜索结果给出路径后,模型再调用 memories.read 读取详情。它不是自动向量召回,也不是固定读取某几个文件。
最后,模型依据检索结果在最终回答中生成 <oai-mem-citation> 隐藏引用块。Core 从 assistant 输出中剥离该块,再交给 memories/read/src/citations.rs:6 解析引用条目和 Rollout 标识。search/read 工具提供检索内容与路径,不是直接产生最终引用块。
6. 最终关系
text
Session.history
    = 当前进程继续 Loop 所需的事实

Thread / Rollout
    = 可恢复、可重放、可审计的原始过程

Memory
    = 从多个 Rollout 提取并合并后的长期知识
三者不是三份重复数据:Session 负责"现在怎么继续",Thread/Rollout 负责"之前发生过什么",Memory 负责"哪些经验值得下次复用"。
源码基线:OpenAI Codex
d58d0e5841e0de08e251673db2d5af8cf3a1ad51。文中的流程图用于标出本篇所处的运行阶段。