第四部分:上下文压缩与继续执行
一句话
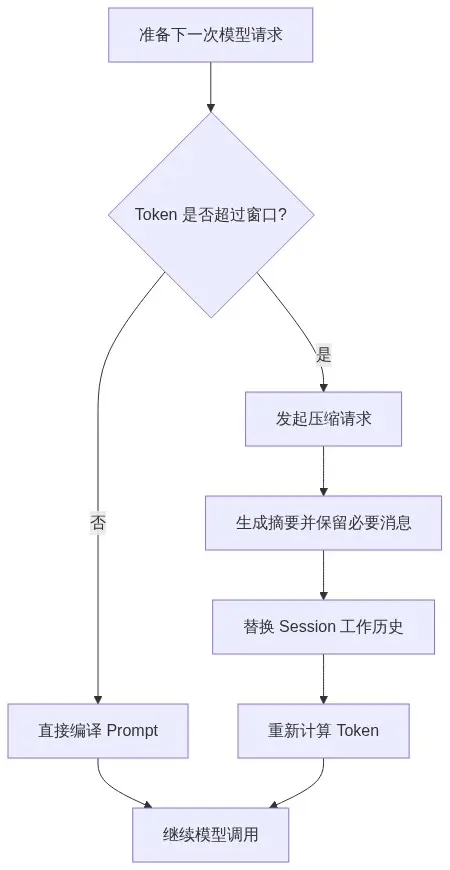
工具执行会让会话历史不断变长。Codex 在模型请求前检查上下文容量;达到阈值时,先用一次压缩流程生成摘要,替换当前工作历史,再继续同一个 Turn。
主流程
text
准备下一次模型请求
  ↓
检查 token / context window
  ├─ 未达到上限 → 直接编译 prompt
  └─ 达到上限 → 运行 compact
                    ↓
              生成摘要、保留必要用户消息
                    ↓
              替换 Session 的工作历史
                    ↓
              重新计算 token 用量
                    ↓
              编译新的 prompt,继续模型调用
压缩是主循环中的分支,不是 Turn 的终止状态。压缩成功后,原任务继续执行;只有上层 Loop 判断不再需要后续步骤时,Turn 才结束。
触发点
session/turn.rs:1033:开始正常采样前执行run_pre_sampling_compact。session/turn.rs:461附近:本轮还需要继续时,发现上下文窗口不足,进入 mid-turn compact。session/turn.rs:1199:run_auto_compact根据配置和 Provider 能力选择本地或远端压缩路径。
压缩产生什么
压缩请求从当前历史提取摘要,随后构建新的历史:
text
新历史 = 预算内保留的用户消息 + CompactionSummary必要时还会把环境、工作区等初始上下文插回摘要前的指定位置。最后通过 Session::replace_compacted_history 替换工作历史,并重新计算 token 使用量。
对应代码:
compact.rs:352-398:收集用户消息、生成摘要、构建替代历史并写回 Session。compact.rs:657-734:按 token 预算保留用户消息并追加CompactionSummary。compact_remote.rs:281-295:远端压缩完成后同样替换 Session 历史。
压缩后怎样进入下一次模型请求
压缩并不会直接修改某个已经发出的请求,而是修改 Session 的当前工作历史。下一次采样时,run_sampling_request 重新读取它:
text
Session.clone_history()
  → history.for_prompt(...)
  → build_prompt(...)
  → client_session.stream(...)
对应 session/turn.rs:1394-1411 和 :2239-2254。因此模型看到的是压缩后的历史,而不是原来完整、超长的历史。
需要注意的边界
- 压缩请求本身也是一次模型或后端请求,但它的产物是摘要,不是面向用户的最终回答。
- 实际历史对象仍由 Session 持有;压缩只是替换"供后续请求使用的工作历史"。
- 压缩和工具执行是两个阶段:工具结果先写入历史,容量检查发现不够时,才触发压缩。
- "继续还是结束"仍由 Agent Loop 决定,压缩层只负责降低上下文体积并返回可继续使用的历史。
源码基线:OpenAI Codex
d58d0e5841e0de08e251673db2d5af8cf3a1ad51。文中的流程图用于标出本篇所处的运行阶段。