这篇文章记录的是一次真实的架构决策过程:我想要搭一套 D2C(Design to Code)系统,把 Figma 设计稿转成可用的前端代码。团队的设计师已经大范围使用 Figma 的 Auto Layout,也有一套相对成熟的设计系统(组件库 + Design Token),这两个前提决定了后面很多技术选型不是"理论上最优",而是"在我们的实际约束下最优"。
Auto Layout 是 Figma 里 Frame 的一个布局规则开关------打开后,Frame 里的子元素不再靠你手动摆坐标,而是按「方向 + 间距 + 内边距 + 对齐 + 尺寸规则」自动排队、自动增减尺寸。
它的底层思路来自 CSS 的 Flexbox (弹性盒子),Figma 在 2019 年把它搬进了设计工具,就是为了解决那个经典痛点:改一个按钮文字,要重排半个界面。
下面按我们真正走过的决策顺序展开:先理清 D2C 的整体链路、找到真正的难点在哪,再逐个啃掉两个最难啃的环节------设计稿解析的精度问题,和布局推断这个没有直接转换公式的核心难题。
每一节都会先说清楚"这里为什么难",再给出我们最终拍下的决策,以及被否掉的备选方案。
关于 D2C 的通用原理
D2C(Design to Code)从技术链路上通常拆成几个环节:
| 环节 | 核心问题 | 常见做法 |
|---|---|---|
| 设计稿解析 | 如何拿到设计的结构化数据 | Figma/Sketch 插件读取图层树(节点类型、位置、尺寸、样式属性),而不是直接对图片做视觉识别 |
| DOM/节点归一化 | 设计工具的图层模型和前端代码模型不是一一对应的 | 把 Frame/Group/Vector 等图层节点映射为语义化的容器结构(div/flex box),做扁平化和去冗余 |
| 布局推断 | 设计稿是绝对定位,代码要变成响应式布局 | 通过图层的对齐关系、间距规律推断出 Flex/Grid 规则(这是最难的一步,也是各家方案差异最大的地方) |
| 样式提取 | 图层的视觉属性转成 CSS | 颜色、字体、圆角、阴影等直接映射;有的方案会做 Design Token 对齐(找项目已有的变量/组件库做替换,而不是每次都写死数值) |
| 组件识别与复用 | 避免生成一堆无意义的 div 拼接 | 通过图层命名规则、结构相似度聚类,识别出"这是一个 Button"、"这是一个 Card",进而套用项目已有组件而不是重新生成 |
| 代码生成 | 把上面的中间表示(IR)渲染成目标框架代码 | 类似 IR → AST → 目标语言的编译过程,IR 是关键抽象层,方便支持多技术栈输出 |
其中真正决定 D2C 效果好坏的,通常不是"能不能转出代码",而是:
- 布局推断的准确度(能不能生成真正响应式、可维护的布局,而不是绝对定位堆砌)
- 组件/变量复用度(生成的代码是不是在"抄"项目已有的设计系统,还是自己造了一套新样式)
- 语义命名质量(生成的代码人能不能看懂、能不能改)
这三点几乎是所有 D2C 方案共同的技术难点,也是各家差异化竞争的地方。
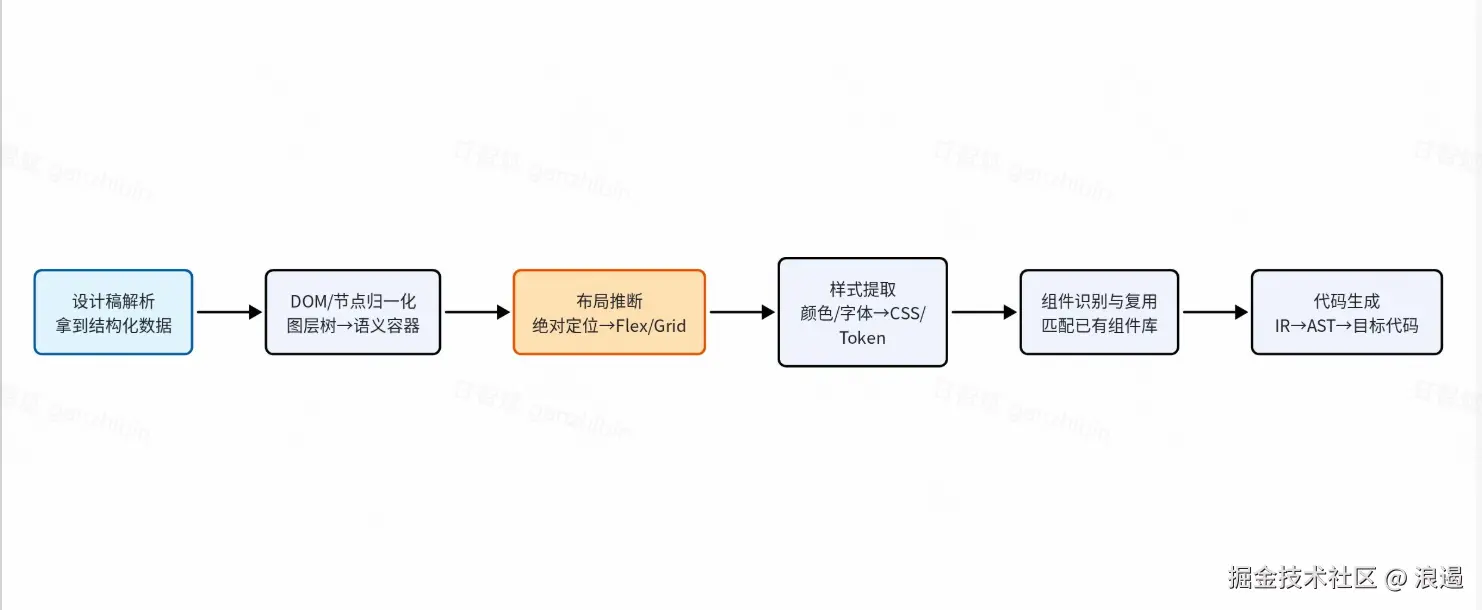
设计稿解析与还原精确度
拿到这张链路全景图后,我们没有从头到尾平铺展开,而是先挑了"设计稿解析与还原精度"这一环节深入------因为它是整条链路的地基。这一步拿到的数据不准,后面布局推断、组件识别都是在错误的输入上做二次加工,越到后面越难纠正。
一、Figma vs Sketch:数据可获取性完全不同,这决定了架构起点
这是第一个必须先确认的前提,因为两者的技术路径差异很大:
| 维度 | Figma | Sketch |
|---|---|---|
| 数据获取方式 | 官方 REST API(GET /v1/files/:key)直接返回完整 JSON 节点树,无需插件即可拿到 | 文件是本地 .sketch 包(zip 内嵌 JSON),需要插件在客户端内运行,或解析文件包 |
| 实时性 | 可以做成服务端拉取,不依赖设计师本地环境 | 基本只能走插件方案,强依赖 Sketch 客户端运行时 |
| 生态成熟度 | 目前行业内 D2C 方案几乎都优先支持 Figma(imgcook、Figma-to-code 类工具、各大厂内部方案) | 逐渐边缘化,很多新方案已经不再优先支持 |
这里有个关键判断:如果你的设计师主要用 Figma,架构会简单很多------可以做成纯服务端流程(拉取 JSON → 解析 → 生成),不需要在设计工具里跑代码。如果必须支持 Sketch,则要接受"必须有一个插件运行时"这个约束,架构上要多一层「插件采集 → 上传结构化数据」的通道。
二、拿到节点树之后,"解析"到底在解析什么
拿到 Figma 返回的 JSON 后,节点树的原始结构大致是这样的层级:
Plain
Document
 └─ Page
     └─ Frame (画板,对应一个页面/区块)
         └─ Group / Frame (嵌套容器)
             └─ Vector / Rectangle / Text / Instance...
每个节点上会挂:
- 几何信息:absoluteBoundingBox(x/y/width/height,是绝对坐标)
- 视觉信息:fills(填充色/渐变)、strokes(描边)、effects(阴影/模糊)、cornerRadius
- 文本信息:characters、style(字号/字重/行高/字间距)
- 约束信息:constraints(水平/垂直是 SCALE / LEFT_RIGHT / CENTER 等,这个字段其实已经隐含了一部分响应式意图,很多方案会忽略它,是个可以挖的点)
- 组件信息:如果设计师用了 Figma Component/Instance,节点会带 componentId,这是识别"这是一个可复用组件"最直接、最可靠的信号,比后面靠算法去猜要精确得多
所以"解析精度"这个问题,本质上分成两类误差来源:
- 信息缺失型误差:原始 JSON 里有的信息你没提取全(比如漏掉了 constraints、漏掉了 blend mode),这类是工程严谨性问题,理论上可以做到接近 100% 还原
- 信息本身不足型误差:设计稿里根本没有表达"这块内容超出会怎样"、"这个文字是动态数据还是静态文案",这类信息 Figma 节点树里天然就不存在,靠解析是解决不了的,必须靠后续的推断/规则/人工标注介入
很多团队在做 D2C 时把这两类误差混为一谈,觉得"解析不准",其实第一类是可以通过工程手段彻底解决的,第二类才是真正的技术难点(属于布局推断范畴,不是解析范畴)。
三、解析层要不要做"归一化",这是个架构分歧点
拿到原始节点树后,业界主要有两种做法:
做法 A:保留原始结构,延迟决策 直接把 Figma 的节点树转成自己的中间表示(IR),但结构上尽量贴近原始层级,所有推断(布局、组件识别)都在后续独立的 Pass 里做。
做法 B:解析阶段就做扁平化/去冗余 比如 Figma 里设计师经常会有大量无意义的嵌套 Group(为了对齐随手加的容器),解析阶段直接把这些"空转"节点消掉,只保留有视觉意义的节点。
这两种做法的权衡在于:
- 做法 A 更"纯粹",解析层职责单一、可测试性好,但后续每个 Pass 都要自己处理冗余节点,逻辑会重复
- 做法 B 能让后续处理更干净,但解析阶段的规则一旦写死,容易把设计师"有意为之"的结构误删(比如那个 Group 其实是为了做局部动画分组)
行业内主流方案(包括我了解的一些内部工具)倾向于折中:解析阶段只做"确定性无损"的归一化(比如:单一子节点且无自身样式的 Group 直接拍平),带有歧义的判断留给后续 Pass。
四、还原精度的度量:不能只靠"看起来像不像"
如果要做工程化的精度评估,通常从这几个维度量化:
| 维度 | 度量方式 |
|---|---|
| 几何还原 | 生成后截图与设计稿截图做像素级 diff(如 pixelmatch),给出差异百分比 |
| 样式还原 | 提取的颜色值、字号是否命中 Design Token 表,而非硬编码数值的偏差 |
| 结构还原 | 生成的 DOM 层级深度、节点数量 与设计稿嵌套复杂度的比值(层级爆炸是常见问题) |
这一步很多团队会漏掉,但它直接决定了"这个 D2C 系统是不是能持续迭代"------没有量化指标,每次调整解析规则都是凭感觉,容易出现"改好了这个 case,坏了那个 case"的反复。
布局推断:绝对定位如何转换成Flex/Grid等自适应布局
解析精度的问题解决之后,我们碰到了整条链路里真正难啃的一块骨头。
这是 D2C 里技术含金量最高的一环,因为它要解决一个本质矛盾:设计稿里的每个元素都是精确到像素的绝对坐标(x/y/width/height),但代码要跑在各种屏幕宽度、各种内容长度下都不能崩。这中间没有直接的转换公式,必须靠"推断",而推断的准确率决定了生成代码是能直接用还是要推倒重写。
一、先弄清楚:布局推断到底在猜什么
绝对定位转自适应布局,本质上是要靠有限的静态信息去猜测设计师没有明确表达的"意图"。具体要猜三类东西:
| 要猜的意图 | 举例 | 猜错的后果 |
|---|---|---|
| 排列方向 | 这一组元素是横着排还是竖着排 | 生成 flex-direction 错误,换屏宽直接错位 |
| 伸缩规则 | 这个元素该固定宽度,还是该跟着内容/容器伸缩 | 文案变长时溢出或挤爆布局 |
| 对齐/间距规则 | 这几个元素是等间距排列,还是两端对齐中间留白 | justify-content 用错,视觉上"看起来差不多但一变化就露馅" |
Figma 的 absoluteBoundingBox 只告诉你"现在长这样",不会告诉你"设计师希望它怎么变化"。所以这一步的准确率天花板,其实取决于能拿到多少额外信号,而不是算法本身有多聪明。
二、三种信号来源,决定了推断能做到多准
信号一: Figma 的 constraints 字段(最容易被忽略,但是最该优先用的)
上面提到过,Figma 每个节点其实自带 constraints.horizontal / constraints.vertical,取值是 LEFT / RIGHT / CENTER / LEFT_RIGHT(两端拉伸) / SCALE(等比缩放)。
这其实是设计师在 Figma 里手动设置过的"这个元素在容器变化时怎么响应"的显式声明------虽然它是给"自动布局在 Figma 内部预览用"的,但拿来做代码侧的布局推断,信息可靠度远高于靠几何关系去猜。
如果设计师用了 Figma 的 Auto Layout(这是关键分水岭),节点上会直接带 layoutMode(HORIZONTAL/VERTICAL)、itemSpacing、padding、primaryAxisAlignItems、counterAxisAlignItems 这些字段------这些几乎是 Flex 属性的直接映射,几乎不需要"推断",是"翻译"。
信号二: 几何关系推断(没有 Auto Layout 时唯一的退路,也是精度上限最低的方案)
如果设计师没用 Auto Layout(纯手动摆放),就只能靠算法去猜:
- 统计一组兄弟节点的 y 坐标是否近似相等 → 猜测是横向排列(flex-direction: row)
- 统计元素间距是否等差 → 猜测有统一的 gap
- 判断某元素宽度是否总是等于父容器宽度减去固定 padding → 猜测该元素是 flex: 1 自适应,而不是写死宽度
这类推断本质是"拟合",一定存在误判概率。比如两个元素恰好在同一行但其实设计师是想让它们各自独立(不是一个 flex 容器),算法容易误判为强关联。
信号三:内容语义辅助(用来纠偏几何推断的误判)
比如识别到某个节点是 Text 类型且 characters 内容较长,可以提高"这个元素应该是自适应宽度而非固定宽度"的置信度------这是用内容类型反推布局意图,是对纯几何推断的补充,不能单独作为主要依据。
三、这里有个必须想清楚的架构决策:要不要把"有没有 Auto Layout"作为技术分支点
这是个绕不开的分叉:
方案 A:强制要求设计规范里必须用 Auto Layout,没用的直接拒绝/降级处理 优点是布局还原精度可以做到很高(因为本质是直接翻译,不是猜),工程上可控性强 缺点是对设计师有约束,如果团队规范推不动,大量老设计稿或不遵守规范的稿子会直接进入"降级通道"(比如直接生成绝对定位代码,或标记为"需人工介入")
方案 B:两条通道并行,Auto Layout 走高精度翻译,非 Auto Layout 走几何推断算法 优点是覆盖率更高,不挑设计稿 缺点是几何推断这条通道天然有误判率上限,而且这个算法会成为团队投入最大、维护成本最高的模块------业界很多 D2C 项目做到后期,大部分工程精力都花在"不断修正这个推断算法的边界 case"上
这个决策直接影响你团队接下来的资源投入方向:如果选 A,重点工作在"设计规范推动+校验工具"(相对轻量,门槛在于组织协作而非技术);如果选 B,重点工作在"几何推断算法迭代"(技术投入重,且收益递减------从 70% 准确率提到 85% 可能比从 0 到 70% 还费力)。
这也是为什么,在真正拍板之前,我们先去摸了一圈团队设计师的实际使用习惯------这个前提直接决定了这一环节该往哪个方向投入资源。
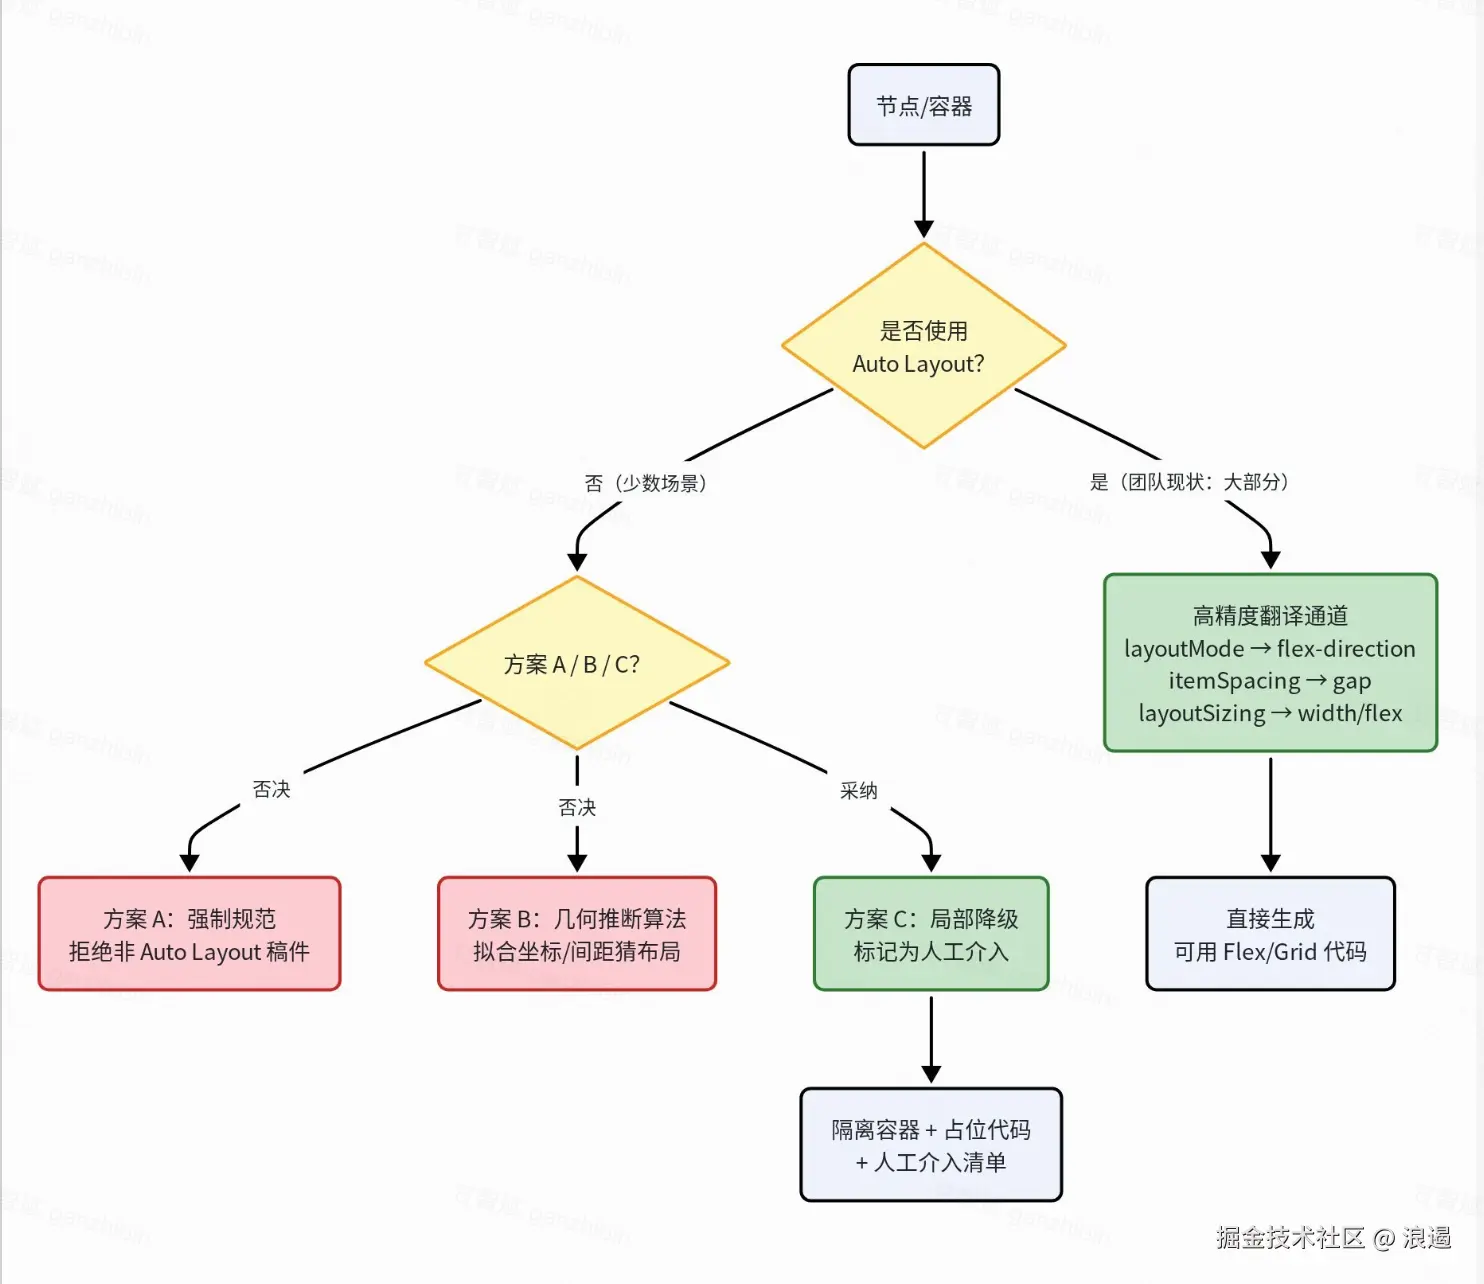
针对 非Auto Layout 的难点
摸底之后,我们发现一个关键事实:团队里大部分设计师已经在用 Auto Layout。这个事实直接决定了后面的选择------非 Auto Layout 是少数场景,为它单独投入一套准确率有天花板、维护成本还会持续爬升的几何推断算法,性价比并不高。
我们最终定下的方案是:非 Auto Layout 节点不做算法推断,直接标记为人工介入。但这只是一条原则,落地成可执行的系统设计之前,还有两个绕不开的技术问题必须先想清楚。
一、Auto Layout 翻译通道:字段映射不是无脑的一一对应
虽然说"这几乎是直接翻译",但有几个映射点容易被低估复杂度:
| Figma Auto Layout 字段 | 目标 CSS | 容易踩坑的地方 |
|---|---|---|
| layoutMode: HORIZONTAL/VERTICAL | flex-direction: row/column | 直接映射,基本无歧义 |
| primaryAxisAlignItems | justify-content | Figma 的取值(MIN/CENTER/MAX/SPACE_BETWEEN)和 CSS 语义不是文本对应,需要一张映射表 |
| counterAxisAlignItems | align-items | 同上,还要考虑 counterAxisAlignItems: BASELINE 这种 CSS 里没有直接对应值的情况 |
| itemSpacing | gap | 直接映射,但如果目标要兼容不支持 gap 的旧浏览器/小程序端,要生成 margin 兜底方案 |
| layoutSizingHorizontal: FIXED/HUG/FILL | width: 固定值 / fit-content / flex:1 | 这是最关键也最容易漏的字段------它才是真正决定"这个元素该不该随容器伸缩"的信号,如果漏掉这个字段光看 boundingBox 宽度,会退化回"猜"的层面 |
也就是说,即使走的是"高精度翻译通道",也不是简单的字段搬运,而是需要一张完整、经过验证的映射表,并且 layoutSizingHorizontal/Vertical 这两个字段的优先级要高于几何尺寸------这是保证 Auto Layout 场景做到真正高精度的关键,如果这里做得潦草,整套方案的前提(Auto Layout 通道足够可靠)就会打折扣。
二、人工介入通道:不能只是"标记",要嵌入到 Pipeline 的什么位置
"标记为需人工介入"说起来简单,但落到系统里具体怎么实现,有两种设计思路,直接影响开发体验:
思路 1:阻断式------遇到非 Auto Layout 节点,整个页面/组件的生成直接失败,报告清单 适合"宁可不生成,不要生成错的"的团队文化,倒逼设计师规范化,但会导致一个页面里 90% 都规范、10% 不规范时,整体产出为零,开发体验较差。
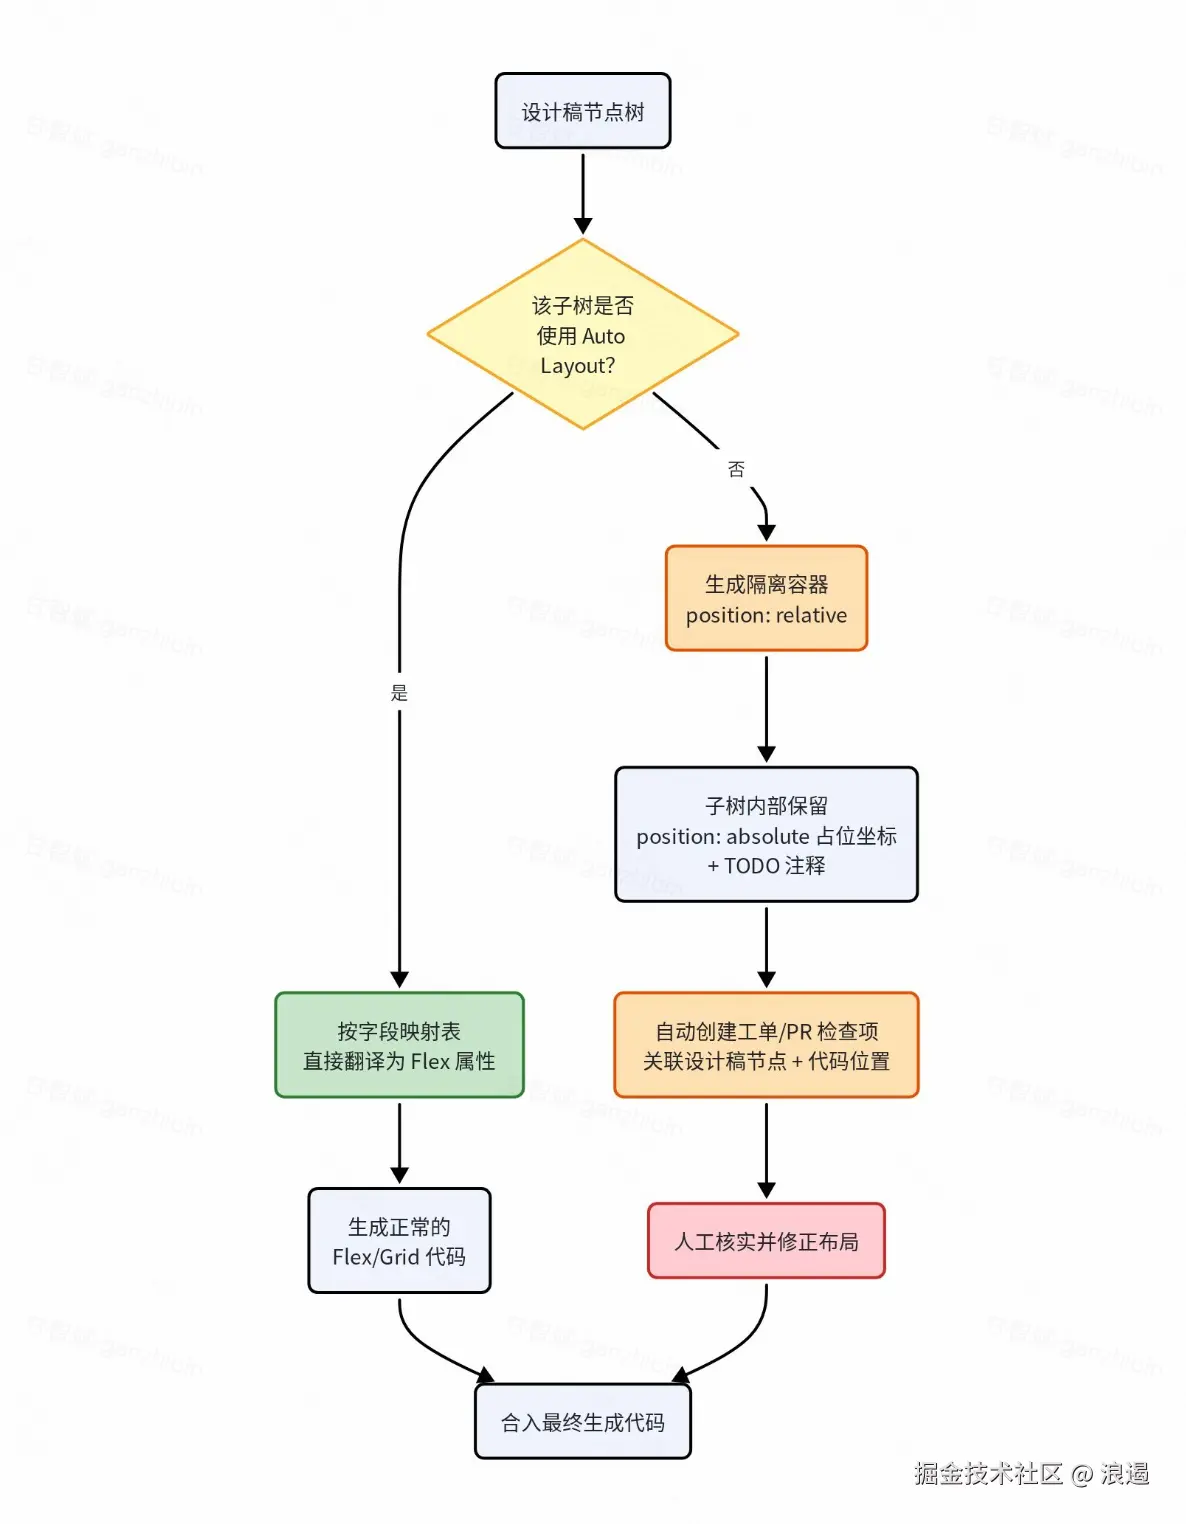
思路 2:局部降级式------非 Auto Layout 的子树单独标记,其余部分正常生成,该子树生成绝对定位占位代码 + TODO 注释 可用性更好(不阻塞整体产出),但存在"局部绝对定位混入 flex 布局"的兼容性问题------比如父容器是 flex,子节点却是 position: absolute,虽然能跑,但会有意料之外的层叠/溢出问题,需要生成时额外包一层容器做隔离。
考虑到团队 Auto Layout 已经是主流,思路 2 里"非规范子树占比小"这个前提是成立的,阻断式那种"可能 90% 都白费"的代价显得没必要。所以从可用性角度,我们最终选了思路 2,但代价是要多一层"隔离容器"的生成规则------这个工程量需要提前规划进去,不是简单加个 if 判断就完事。
到这里,D2C 链路里争议最大的两块------设计稿解析的精度问题、布局推断的核心决策------都已经有了明确的落地方案。但"组件识别"和"代码生成"这两个环节并不是可以随便应付的收尾工作,它们决定了生成出来的代码到底是能直接合入项目的"真代码",还是一堆看起来对但没法维护的临时拼凑。下面继续把这两块也过一遍。
组件识别与复用:别让代码生成变成一堆无意义的 div
如果说前面两块决定了生成代码"能不能用",组件识别决定的是生成代码"值不值得用"。
我们团队已经有一套相对成熟的设计系统------组件库 + Design Token。这个前提很关键:意味着组件识别不是要从零"发明"组件的概念,而是要把设计稿里的图层,匹配回项目里已经存在的组件。如果匹配不上,生成出来的代码会是自己又造了一套样式,跟项目原有的组件库两套并存,越用越乱。
一、识别的两种信号,可靠度天差地别
信号一:Figma Component/Instance(强信号,几乎零成本)
如果设计师在 Figma 里用了 Component(组件)功能,并且把设计系统里的组件同步维护成了 Figma 组件库,那节点上会直接带 componentId,指向具体是哪个组件的哪个变体(Variant)。这种情况下识别不需要"猜",只需要维护一张 componentId → 项目组件 的映射表,几乎是确定性匹配。
这也是为什么我们在"设计稿解析"那一节就强调过:componentId 是解析阶段最值得优先提取的字段之一,它的价值一直延续到组件识别这一步才真正兑现。
信号二:结构相似度聚类(弱信号,兜底用)
如果设计师没有用 Figma 组件(很多历史设计稿、或者不遵守规范的稿子就是这样),就只能靠结构特征去猜:图层命名(比如叫"Button"、"Card")、子节点的组合模式(一个 Frame 里包一个 Text 加一个 Icon,很像是个按钮)、以及视觉特征(固定的圆角+固定的高度,符合项目里按钮组件的规格范围)。
这类推断和布局推断里的"几何关系推断"是同一个套路------本质是拟合,存在误判率,而且这个误判往往更隐蔽:识别错了顶多是没匹配上组件、退化成普通 div,不会像布局推断错了那样直接导致页面跑不起来,所以很容易被忽视,但代码质量的伤害是实实在在的。
二、我们的决策:识别失败不是"错误",而是明确的降级路径
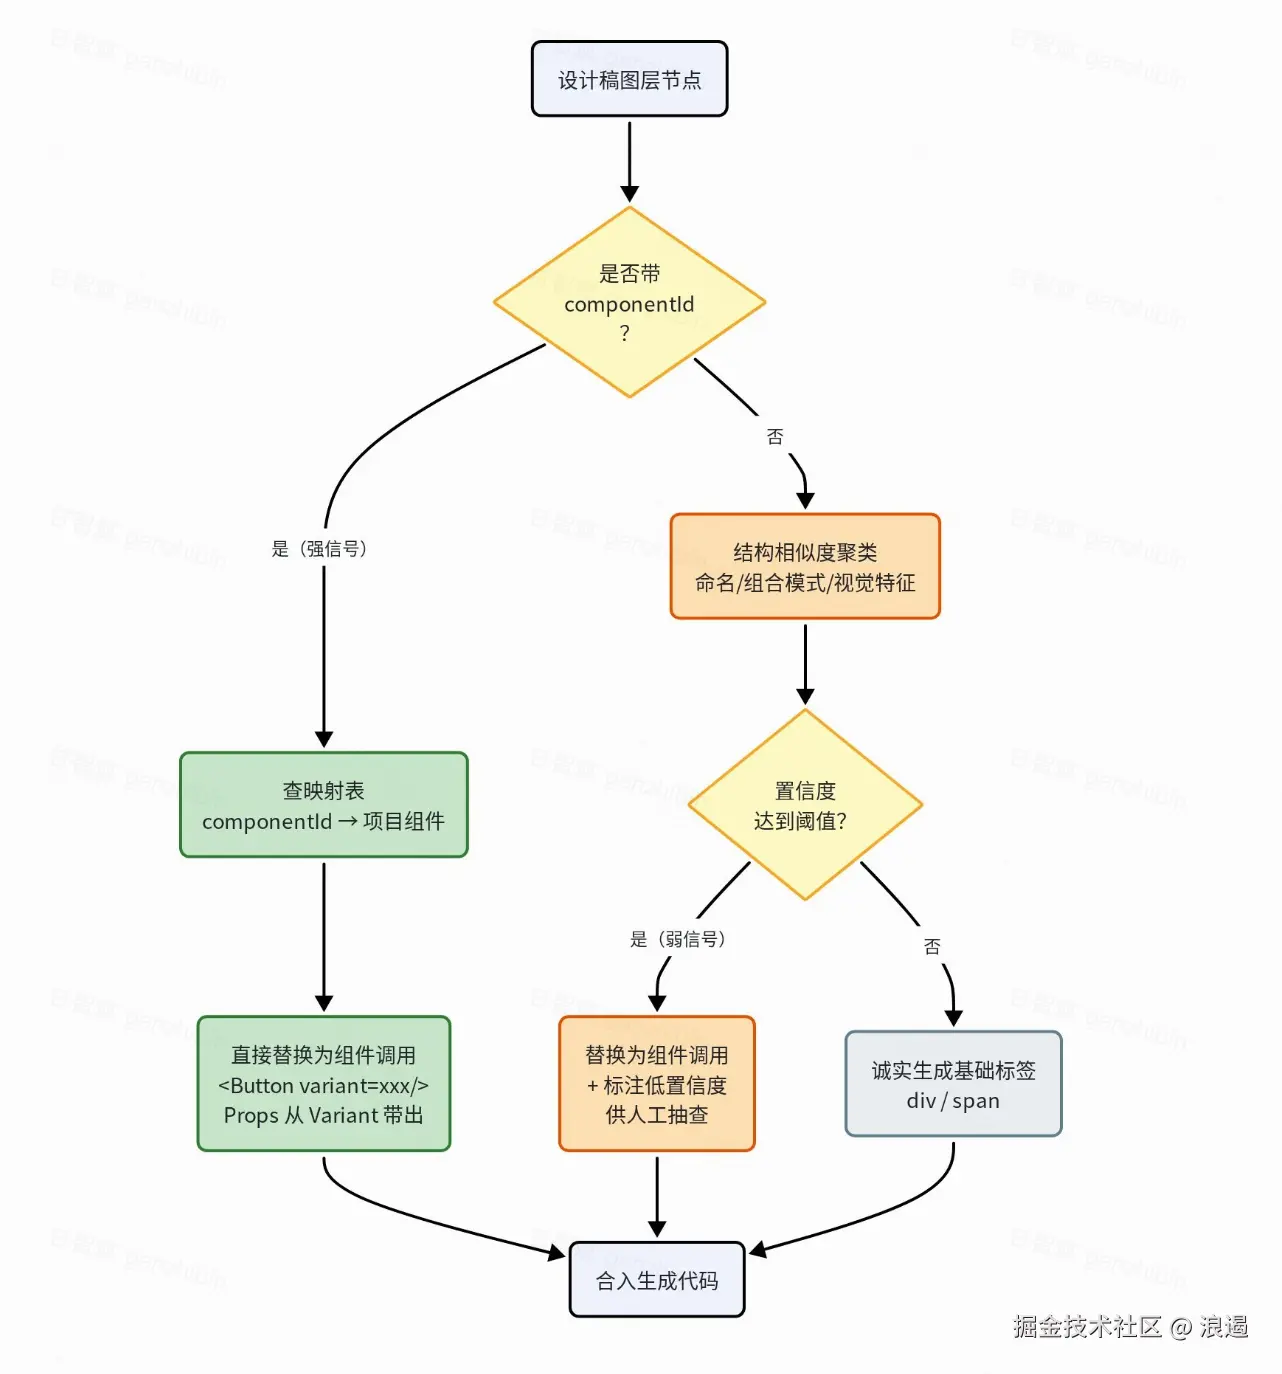
基于这两种信号可靠度的巨大差异,我们没有把组件识别做成一个"必须成功"的强绑定环节,而是分了清晰的优先级:
- 优先匹配 componentId :命中就直接替换成项目组件的调用代码(比如
<Button variant="primary">),连 props 也可以从 Figma 组件的 Variant 属性里带出来 - 其次尝试结构相似度匹配:命中且置信度达到阈值,同样替换为组件调用,但会在生成报告里标注"低置信度匹配",方便后续人工抽查校对
- 匹配不到就正常生成基础标签:不强行拼一个"看起来像组件"的结构,诚实地生成 div/span,避免把一个误判包装成正确答案
这个思路和我们在布局推断那一节的选择是一脉相承的:对置信度没有把握的场景,选择明确的降级,而不是让算法硬撑出一个看起来合理但实际上是猜的结果。 这也是这篇文章里反复出现的同一种判断标准------宁可让问题在生成阶段就显性地暴露出来,也不要把不确定性偷偷埋进产出的代码里,等到后面出 bug 才被发现。
代码生成:IR 是那道决定生成代码能不能维护的分水岭
前面所有环节------解析、布局推断、组件识别------最终都要汇总成一份中间表示(IR,Intermediate Representation),代码生成就是把这份 IR 渲染成最终的目标框架代码。这一步看起来像是"收尾",但 IR 的设计质量,直接决定了整套系统未来能不能低成本地支持新的目标框架、新的代码风格。
先直观看一眼, IR 到底长什么样
拿一个最简单的例子:设计稿里有一个"提交"按钮,前面组件识别那一步已经把它匹配到了项目里的 Button 组件(variant=primary)。经过解析、布局推断、组件识别这几步之后,它不会直接变成某种框架的代码,而是先变成一份这样的 IR------这里用 JSON 来表示,方便直观理解,实际实现里可以是内存中的一棵对象树:
json
{
  "type": "component",
  "component": "Button",
  "props": { "variant": "primary" },
  "children": [
    { "type": "text", "content": "提交" }
  ]
}
注意看这份 IR 里完全没有出现 div、JSX、template 这类任何框架相关的词汇------它只是在客观地描述"这是什么组件、传了什么 props、里面装了什么内容"。这就是前面说的"语义描述"具体指什么。
一、为什么一定要有 IR,而不是直接从 Figma JSON 生成代码
如果没有 IR 这一层,相当于把"Figma 的数据结构"和"目标框架的代码结构"直接耦合在一起。今天只需要生成 React,看起来省了一层转换,但只要团队里出现第二个目标(比如小程序、Vue、或者未来接入其他设计工具),前面解析、布局推断、组件识别这些环节全部要重新写一遍------因为所有逻辑都掺杂了"最终要生成什么代码"的假设。
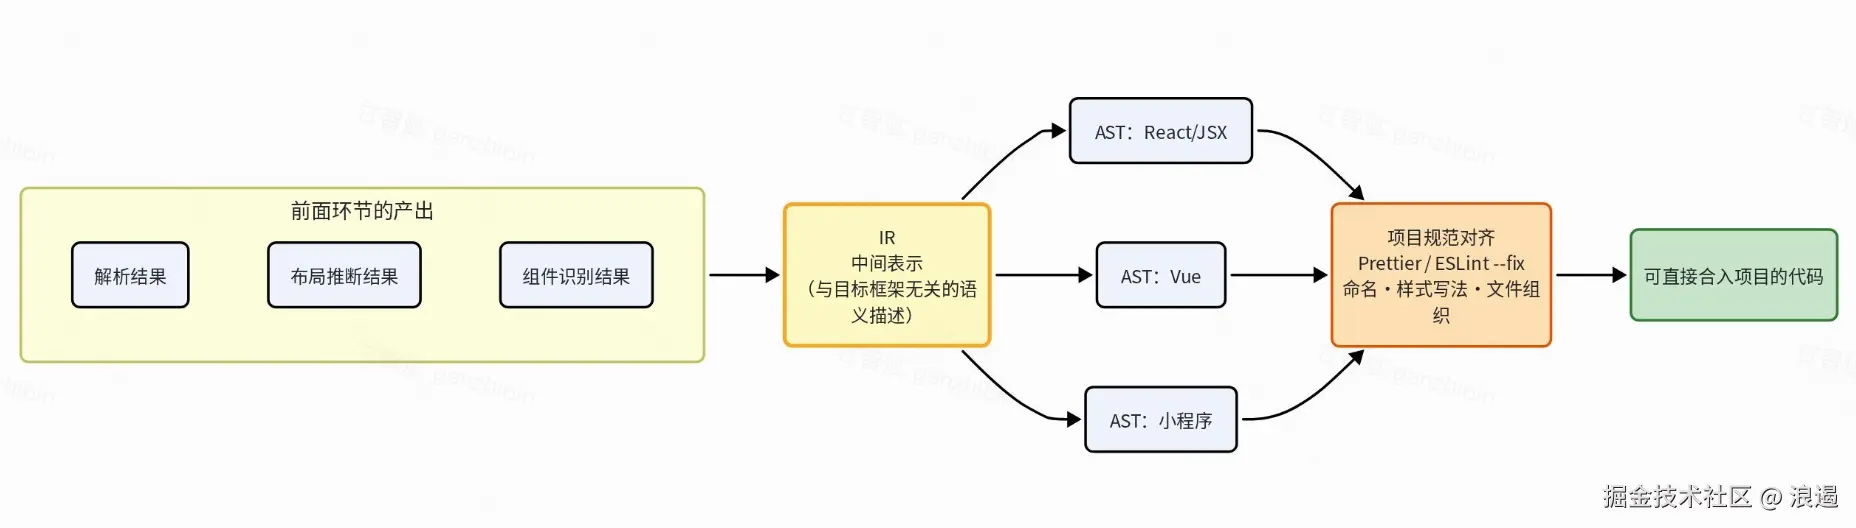
IR 的作用就是把"从设计稿里提炼出的语义"和"最终渲染成什么代码"彻底解耦:前面几个环节的产出只描述"这是一个什么容器、什么样式、什么组件、什么布局规则",不关心目标框架;代码生成这一步只做"把这份语义渲染成 React/Vue/小程序代码",不关心这些语义是怎么来的。这跟编译器的 IR 是同一个思路------前端(解析)和后端(生成)通过一份中立的中间表示解耦,各自独立演进。
把 耦合 具体拆开看:同一份 IR ,喂给不同的渲染器
还是刚才那个 Button 的 IR,代码生成阶段拿到它之后,只需要写一个"渲染器"去遍历这份 IR、按目标框架的语法拼代码。同一份输入,换一个渲染器,输出就完全不同------这就是"解耦"两个字具体发生的地方:
渲染成 React :
jsx
<Button variant="primary">
  提交
</Button>
渲染成 Vue:
jsx
<Button variant="primary">
  提交
</Button>
这个例子刻意选得简单,是因为 Button 本身语法差异不大,看不出太大区别;但换成一个需要循环渲染列表的场景,差异就会立刻显现------React 要生成 {list.map(item => ...)},Vue 则要生成 <div v-for="item in list">。这两种完全不同的目标语法,靠的是同一份 IR、配两个不同的渲染器就能覆盖,而不需要把"循环怎么判断"这件事在解析、布局推断阶段就先想好、写两遍逻辑。这才是前面说的"前端环节不需要重新写一遍"真正的含义。
二、代码生成阶段真正要做的两件事
第一件事:IR → AST → 目标代码,这是相对成熟的工程问题
这一步类似于写一个小型编译器后端:遍历 IR 树,按目标框架的语法规则拼接 AST(比如 React 用 JSX 语法树),再把 AST 序列化成源代码字符串。因为前面的环节已经把布局、样式、组件这些"难点"消化掉了,这一步的技术不确定性反而是最低的------已经是相对确定的工程实现,不再是需要反复论证的架构决策。
回到 Button 那份 IR,"拼接 AST"具体是怎么做的:
渲染器读到
type: "component",就知道要生成一个 JSX 元素节点;读到component: "Button",就把这个当作元素的标签名;读到props,就把每个键值对转成 JSX 属性;读到children,就递归处理子节点,塞进这个元素内部。这个"读一个 IR 字段、拼一小块 AST 节点"的过程逐层往下走,走完整棵树,就拼出了完整的 AST,最后再把 AST 序列化(说白了就是把树形结构转成一行行文本),就是我们前面看到的那段<Button variant="primary">提交</Button>。这个过程里没有任何需要"猜"的地方,纯粹是按规则做转换,这也是为什么说这一步技术不确定性最低。
第二件事:代码风格与项目规范的对齐,这一步容易被低估
生成的代码要真正被合入项目,还必须符合团队已有的代码规范------组件命名习惯、样式写法(CSS Module/styled-components/Tailwind,看项目用的是哪种)、文件组织方式、甚至 ESLint/Prettier 规则。如果这一步做得潦草,即便前面所有环节都做对了,生成出来的代码依然会因为"风格不对"被开发者随手推倒重写,前面的技术投入就白费了。
拿一个具体的例子看这一步在做什么:渲染器刚拼出来的代码往往是这样的,功能没问题,但格式很随意------
js
const Card=({title,desc})=>{return <div className="card"><h3>{title}</h3><p>{desc}</p></div>}过一遍项目里的 Prettier/ESLint 规则之后,会变成这样------这才是团队里其他人打开文件时习惯看到的样子:
js
const Card = ({ title, desc }) => {
  return (
    <div className="card">
      <h3>{title}</h3>
      <p>{desc}</p>
    </div>
  );
};
这两段代码的功能完全一样,区别只在于换行、缩进、空格这些格式细节。但对于要长期维护这份代码的人来说,这个区别决定了这份代码是"能立刻看懂、能直接改",还是"看着眼熟但风格跟项目其他文件不一样,得先手动重新格式化一遍才敢动"。
我们的做法是:代码生成阶段不是"裸生成"完就结束,而是把生成结果再过一遍项目里已有的格式化工具链(Prettier/ESLint --fix),并且在 IR 到 AST 的映射规则里,直接对齐项目约定的写法(比如统一用什么方式写行内样式),而不是生成之后再靠人工去改。这样才能让生成代码的"能读、能改"落到实处------这正是我们在文章开头就提到的、几乎所有 D2C 方案共同的技术难点之一。
写在最后
回过头看,这次架构讨论里真正花时间拉锯的,从来不是"能不能把设计稿转成代码",而是每一步该怎么处理"信息不够用"或者"置信度不够高"的情况:解析阶段有信息缺失、布局推断阶段要在几何关系里猜意图、组件识别阶段要在结构相似度里判断该不该信任。我们最终的选择,几乎都指向同一个原则------ 能确定的地方尽量做到高精度,不确定的地方明确降级,而不是用一个看起来聪明的算法去掩盖不确定性。
这个原则比任何具体的技术方案都更值得沉淀下来,带进下一次架构决策里。