作者:来自 Elastic Bao Tong, Manas Singh, Corey Nolet
将索引构建任务转移到 GPU 后,CPU 可以空出来处理查询,因此向量索引吞吐量提升了 7 倍,在索引运行期间 p90 搜索延迟降低了 6 倍,同时召回率没有变化。
亲自尝试向量搜索,你可以使用这个面向 Search AI 的自定进度动手实践学习。你现在可以开始免费云试用,或者立即在你的本地计算机上试用 Elastic。
现代企业应用正在摄取 TB 级到 PB 级的非结构化数据,为语义搜索、基于大型语言模型( LLM )的检索增强生成( RAG )以及推荐系统提供支持。在这一规模下,基于 CPU 的向量索引可能需要数天甚至数周,这会减缓实验速度,并使大型索引更新在运维方面成本高昂。对于需要定期重建索引的工作负载,这一问题尤其突出,例如由频繁的数据更新或频繁的嵌入模型更新驱动的工作负载。例如,一些电子商务团队每晚都会刷新产品目录,并训练自己的嵌入 模型 ,而每次都需要重建索引。
基于 CPU 的索引还可能降低搜索性能,尤其是在电子商务平台和广告投放流水线等在线系统中,当索引和搜索同时进行时,这种情况更加明显。这是因为索引构建会消耗大量 CPU 资源,可用于查询的计算周期因此减少,从而导致搜索延迟和延迟波动上升。即使索引构建完成后,由于索引碎片化,延迟仍可能保持较高水平。客户通常会执行强制 合并 来整合分片,但在 CPU 上执行这一操作可能很慢,从而进一步将搜索延迟恢复到预期水平的时间推迟数小时甚至数天。
Elasticsearch 已经推出了由 NVIDIA cuVS 提供支持的 GPU 加速向量索引。在本文中,我们展示了 Elasticsearch 如何通过将分层可导航小世界(HNSW)索引构建卸载到 GPU,将向量索引吞吐量最高提升 7 倍,并使用 8 个 NVIDIA RTX PRO 6000 GPU 在不到 10 分钟内为 1.38 亿个向量建立索引。
在不到 10 分钟内为超过 1 亿个向量建立索引
图 1 展示了来自 MS MARCO 数据集的 1.38 亿个 1,024 维向量的向量索引吞吐量,这些向量代表大约 4 TB 的 多模态 文档(图 1)。该基准测试使用 Rally 运行,这是 Elasticsearch 的宏基准测试框架。测试运行在一台配备 8 个 NVIDIA RTX Pro 6000 GPU 和双路 AMD EPYC 9555 的服务器上。GPU 测试开启 GPU,CPU 测试则关闭 GPU。结果显示,Elasticsearch 实现了高出 7 倍的索引吞吐量,将 1.38 亿个向量的索引时间从使用 CPU 时的 1 小时缩短至使用 GPU 时的不到 10 分钟。
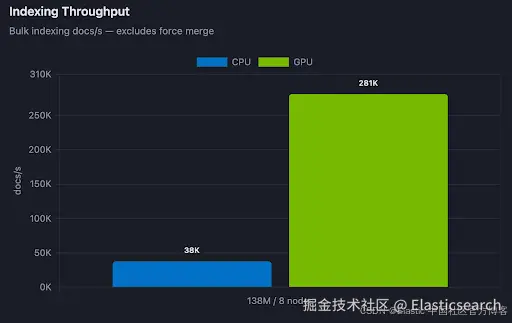 图 1:本地部署场景下开启 GPU(8 个 NVIDIA RTX Pro 6000,搭配双路 AMD EPYC 9555)和关闭 GPU(仅使用双路 AMD EPYC 9555)时的索引吞吐量。目标召回率为 95%。
GPU 向量索引会改变召回率吗?
如果 GPU 构建的索引相比 CPU 构建的索引具有更低的搜索质量,那么索引加速就没有意义。GPU 构建索引和 CPU 构建索引的吞吐量与召回率曲线相互重叠,这表明 GPU 索引能够提供与 Elasticsearch 基于 CPU 的索引路径相同的召回率表现,同时几乎不会带来准确率或搜索时间性能方面的损失(图 2)。
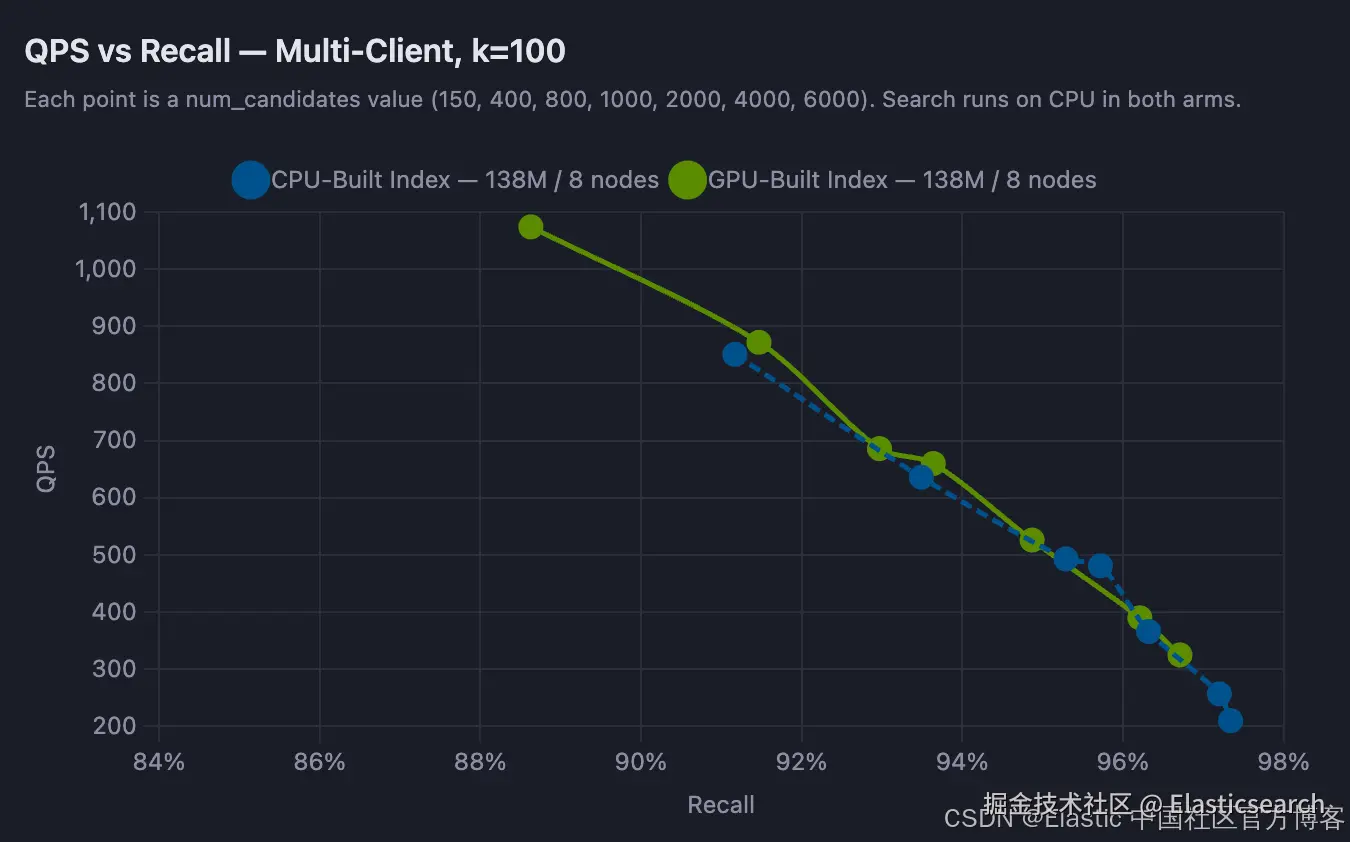 图 2:使用 GPU 与 CPU 创建的索引进行 HNSW 搜索时的召回率与吞吐量权衡曲线。
并发索引负载下的搜索延迟
将索引任务卸载到 GPU 后,在索引和搜索同时运行时,CPU 上的搜索延迟提升了 6 倍(图 3),因为在 GPU 上进行索引可以释放 CPU 资源,从而降低搜索延迟。这使单个 Elasticsearch 集群能够同时支持实时数据摄取和低延迟检索,而无需在数据新鲜度和搜索性能之间做出取舍。
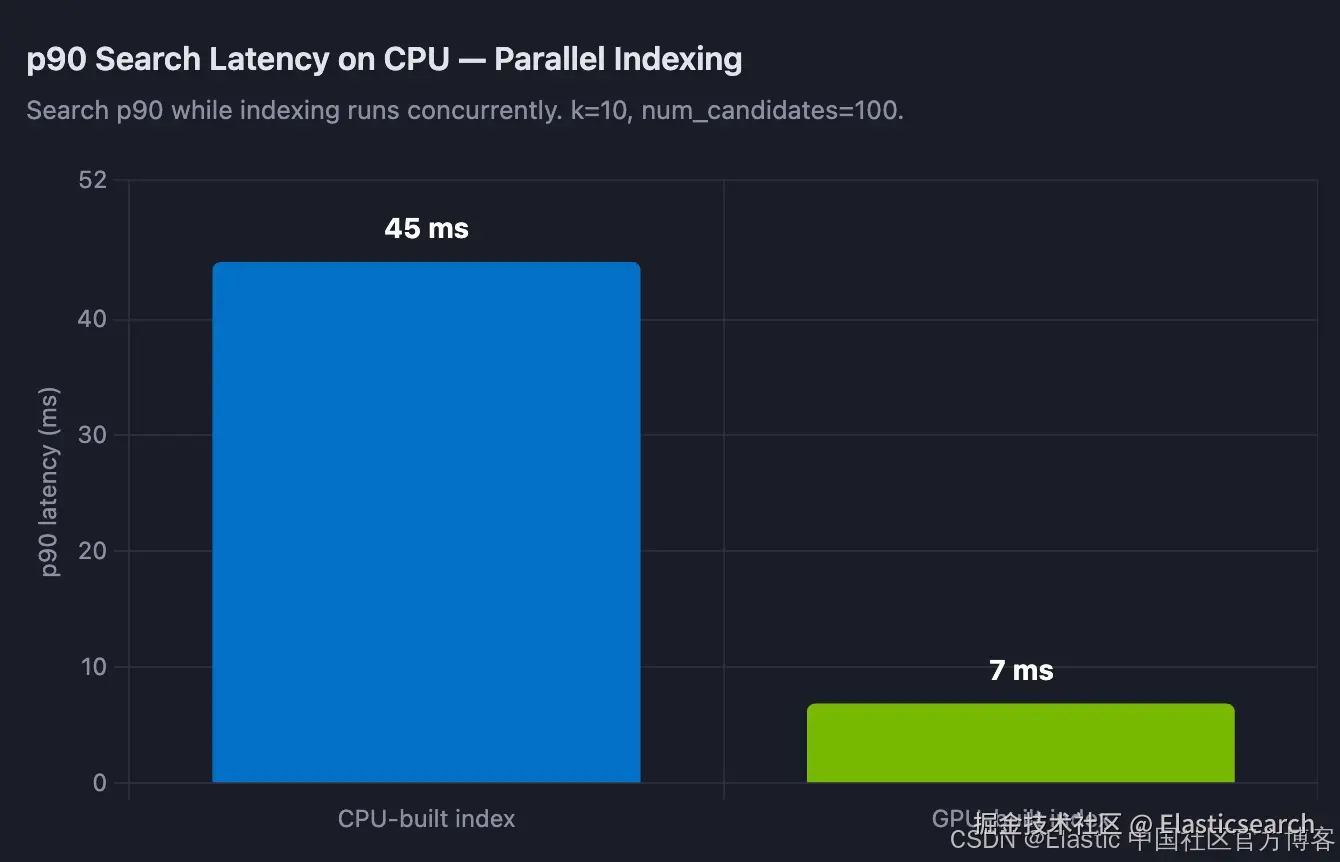 图 3:并发索引负载下 CPU 搜索的搜索延迟(p90)。
GPU 与 CPU 上 HNSW 索引的强制合并时间
此外,Elasticsearch 中的 GPU 加速索引将强制合并时间从大约 4 小时缩短至 5 分钟,从而帮助实时恢复低延迟搜索(图 4)。注意:使用强制合并将每个分片合并为 4 个段。
以下是 Elasticsearch 中 GPU 与 CPU 向量索引的完整结果:
| 指标 | CPU | GPU | 变化 |
|---|---|---|---|
| 索引构建时间,1.38 亿个向量 | 约 1 小时 | 少于 10 分钟 | 吞吐量提升 7 倍 |
| 索引负载下的 p90 搜索延迟 | 基线 | 降低 6 倍 | 6 倍 |
| 强制合并,每个分片 4 个段 | 约 4 小时 | 约 5 分钟 | 约 48 倍 |
| 目标召回率 | 95% | 95% | 未变化 |
GPU 向量索引对 Elasticsearch 用户意味着什么
Elasticsearch 集成 NVIDIA cuVS 后,将 GPU 加速向量索引引入生产环境中的 AI 搜索,使搜索延迟降低超过 84%,从而在 CPU 开销更低且基础设施权衡有限的情况下,实现更快的数据摄取和 640% 的索引吞吐量提升。这为新一类应用解锁了可能性,例如更快的 RAG 流水线、 语义搜索 、多模态检索以及大规模欺诈检测。
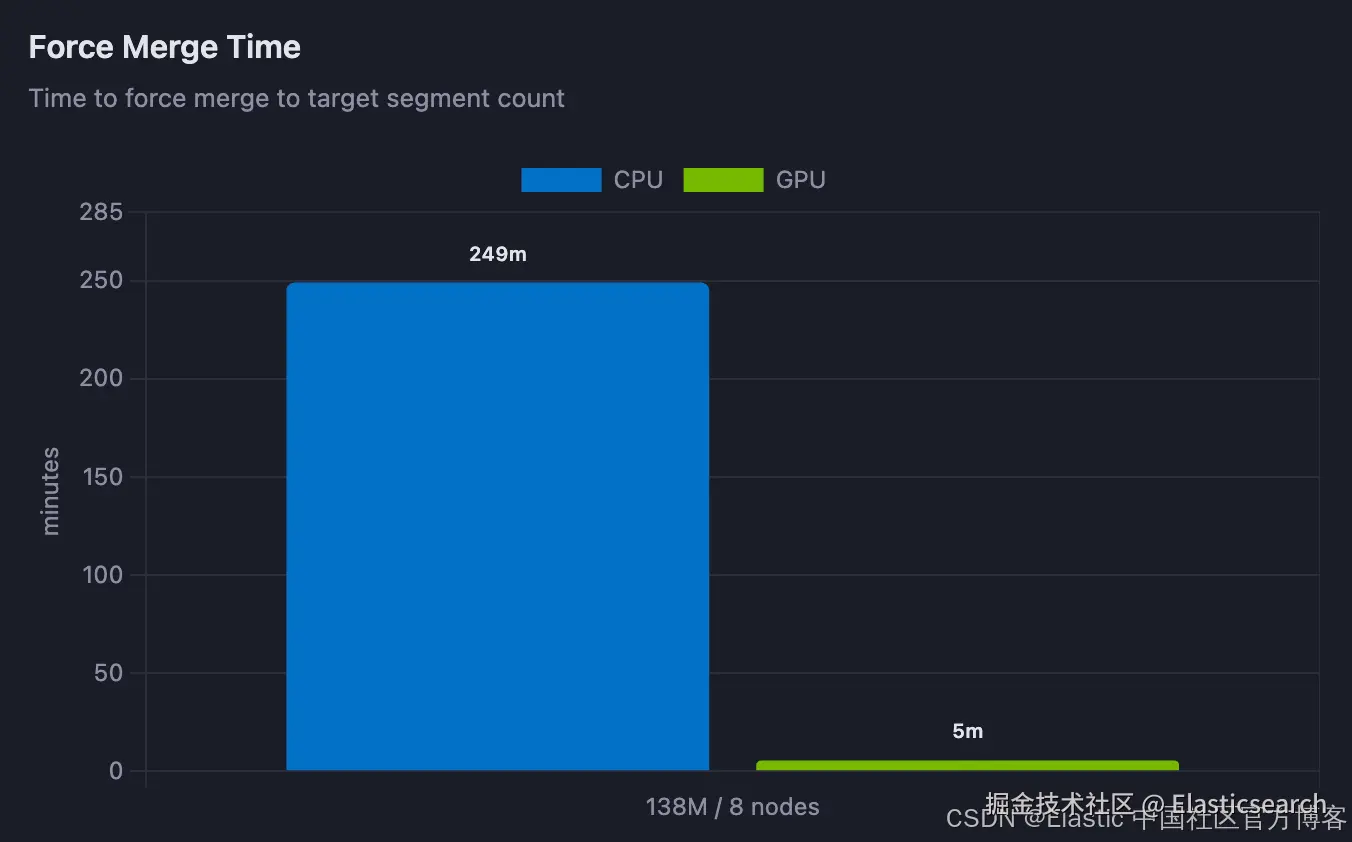 图 4:GPU 与 CPU 的强制合并时间。
开始在 Elasticsearch 中使用 GPU 向量索引
按照这些说明安装支持 GPU 加速向量索引的 Elasticsearch。通过使用GitHub issue中的参数运行Rally msmarco track,复现上述基准测试。访问NVIDIA cuVS,进一步了解 GPU 加速向量索引、搜索和预处理。
致谢
作者感谢来自 Elastic 的 Chris Hegarty、Gilad Gal 和 Mayya Sharipova,以及来自 NVIDIA 的 Nathan Stephens 对本文所作的贡献。
原文:Vector indexing on GPU: 138M vectors in under 10 minutes | Elasticsearch Labs