从 Prompt 到 Harness:AI Agent 的竞争层为什么转移到了"外骨骼"
阅读约定 :本文所有论断均标注证据强度------已核验 可查证事实 / 自述 厂商或作者自述(README、标题、描述等未经独立核实的表述)/ 推断 本文推演。凡出现代码块,均为抽象示意(示意格式,非任何真实 API),除非明确标注为源码摘录。文中提及的性能数字、能力计数、项目规模一律不作为论据,仅作为"待验证的宣传口径"出现或直接省略。
近两年,围绕编码代理(coding agent)的讨论正在换轨。过去比较的是"谁的 prompt 写得好"、"谁的模型更聪明";现在越来越多的工程精力被投入到模型之外的那一圈系统:工具怎么注册、技能怎么打包、长会话怎么压缩、长任务怎么异步执行、限流怎么治理。这一圈系统,业内开始用 harness(直译"挽具",本文取"外骨骼"义)来称呼------模型是肌肉,harness 是把肌肉变成能干活的身体的那副骨架与传动装置。
本文的核心论点是:当底层模型在同类编码任务上的可用性趋于接近,编码代理的可用性与差异化越来越多地由 harness 层决定。 这一论点目前只有现象级证据支撑(见第 1 章证据矩阵),没有公开 benchmark 支撑,因此全文以"行业观察 + 工程推演"的方式呈现,并在第 8 章给出可证伪路径。
读完你能带走:一套概念边界图、五个可落地的工程模式(各配度量口径)、一张"案例 × 模式"映射矩阵、一套开源 harness 核对清单、一份五维成熟度自评表,以及一份术语速查表。
1|现象:竞争层正从 prompt 滑向 harness
1.1 三条线索在同一时间窗出现
判断"竞争层是否转移",最直接的证据是看新工具长在哪一层。本次可获得的素材(CSDN 文章元数据 + GitHub 仓库元数据)中,能观察到三类线索同时出现。
线索 A|理念侧 :有人开始给这层东西起名字。CSDN 有一篇标题为《模型不是产品:从 Prompt Engineering 走向 Harness Engineering》的文章 自述 ,另一篇《LLMOps 不完全指南------发布原子不是模型,是 Prompt/数据/模型版本三元组》自述 则把"发布原子"从模型扩到三元组。两篇的正文论点均未核验,此处仅作为"术语正在被命名"的信号。
线索 B|实现侧 :新仓库开始以 harness 自我定位。zai-org/ZCode 的 README 自述为 "Z.ai's coding agent harness. Powerful, intelligent, extensible." 自述 ;unreallabsai/unreal-agent 自述为 "Async-first agent harness" 自述 ;kerpopule/hermes-jev-skills 的描述清单覆盖模型路由、记忆、压缩、技能选择、电脑与浏览器操作 自述。注意:这些组织与仓库的实际归属关系未核验,本文不写"某某公司出品"。
线索 C|痛点侧 :最能说明问题的是反向信号。gylive/ccodex-sleep-state 是一个专门治理 Codex "降智、限流、连接体验"的仓库,其 README 自述中明确写着"不保证取得指定 state 或提升模型质量"自述。一个用户要为"模型状态"单独写工具,且自我免责------这通常意味着产品级的治理层缺位,用户在用经验性的仪式化操作补偿系统能力的空白。
| 线索 | 出处 | 证据类型 | 强度 | 待核验项 |
|---|---|---|---|---|
| A 概念命名 | CSDN《模型不是产品》《LLMOps 不完全指南》 | 仅标题 | 低 | 正文定义与措辞 |
| A 术语落地 | 同上,"三元组"表述 | 仅标题 | 低 | 是否为原文表述 |
| B 自我定位 | ZCode / unreal-agent README | README 自述 | 中 | README 原文、源码是否兑现 |
| B 能力清单 | hermes-jev-skills 描述 | 仓库描述 | 中 | 各项实现深度 |
| C 治理缺位 | ccodex-sleep-state | README 自述 + 免责声明 | 中 | 免责声明逐字原文 |
| 时序共振 | GitHub 条目集中在 2026-09-18~23(6 天窗口) | 元数据 | 低 | 时间戳是否真实、采集口径 |
推断 :理念命名(A)与工具实现(B)出现在同一时间窗,是"术语---实现同步期"的典型特征------通常意味着这个概念刚从个别团队的内部实践溢出为公共话语。但需要强调:本批 GitHub 元数据的时间戳集中在 6 天窗口内,且存在生态聚集现象(多个同名生态仓库、若干 awesome-* 目录仓),这批数据的时间真实性与生态真实性都未经核验,上述"同期共振"的判断应视为待验证假设。
1.2 "模型能力趋同"是一个需要严格限定的前提
这句话必须写窄,否则全文都会夸大。
推断 本文所说的趋同,指的是:在常见编码任务(读代码、改代码、跑测试、写脚本、查资料)上,主流编码代理的"能不能用"这一层差异在收窄------不是能力完全等价,更不涉及推理、数学、长程规划等仍在拉开差距的能力维度。
由此可得更精确的表述:模型之下的杠杆在变短,模型之外的杠杆在变长。 在模型权重上做微调带来的边际收益(对多数工程团队而言),与在工具契约、错误语义、会话压缩、调度策略上做工程带来的边际收益相比,后者的性价比正在上升。这不代表模型不重要------模型是能力下限的决定者;harness 决定的是同样的能力下限,能被兑现成多稳定的产出。
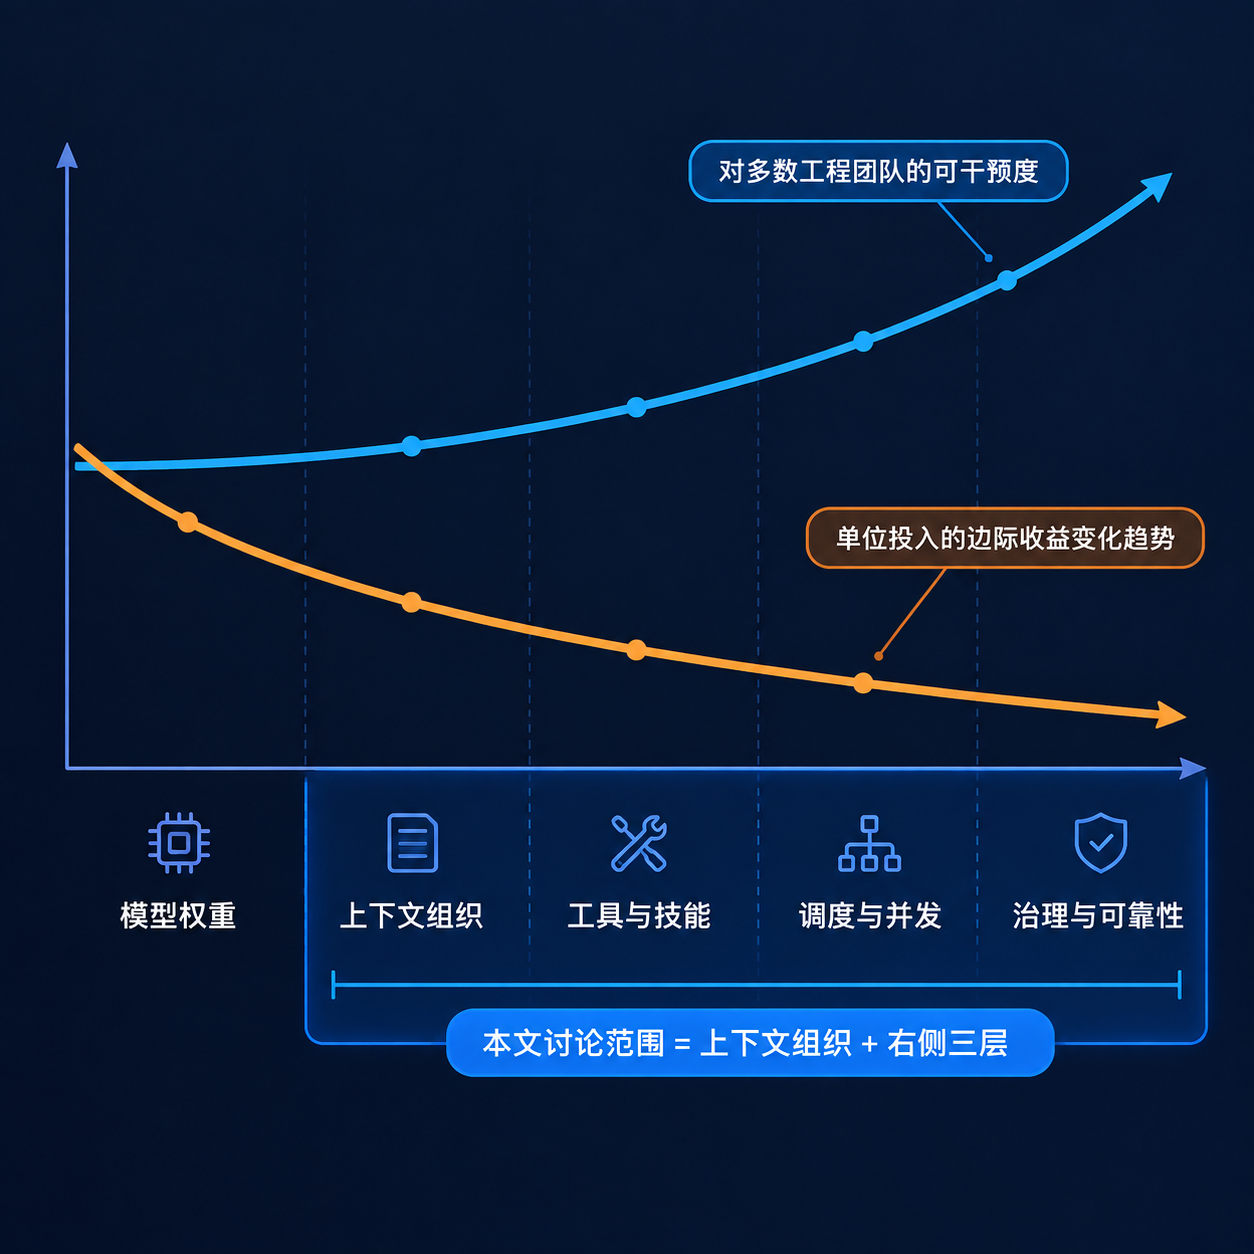
边界声明:本章的"趋同"没有硬数据支撑,全文涉及模型对比处一律不引用未核验的 benchmark。
2|界定:Harness Engineering 是什么、不是什么
2.1 一次解剖:模型之外的五层外骨骼
把 harness 拆开,可以看到五个相对独立、各有明确失败征兆的层。本文第 3 章按这五层展开,此处只做定义。
| 层 | 管什么 | 输入 / 输出 | 失败时的症状 |
|---|---|---|---|
| ① 工具注册 | 能力的描述、发现、校验、调用契约 | 能力描述 → 可调用句柄 | 模型找不到工具、调错参数、错误信息无法自愈 |
| ② 技能封装 | 把"工具 + 领域知识 + 流程 + 约束"打包 | 领域工具链 → 可复用技能 | 代理反复读手册、步骤遗漏、输出不合规范 |
| ③ 会话与上下文管理 | 长任务中的记忆保真与压缩 | 原始上下文 → 摘要 + 关键槽位 | 重复执行、忘记约束、"上下文幻觉" |
| ④ 调度与并发 | 长任务/多任务的派发、回收、取消 | 任务描述 → 结果回调 | 界面卡死、任务丢失、无法取消 |
| ⑤ 治理与可靠性 | 限流、退避、断点、审计、版本回滚 | 调用记录 → 治理动作 | 频繁限流、无效重试、行为不可复现 |
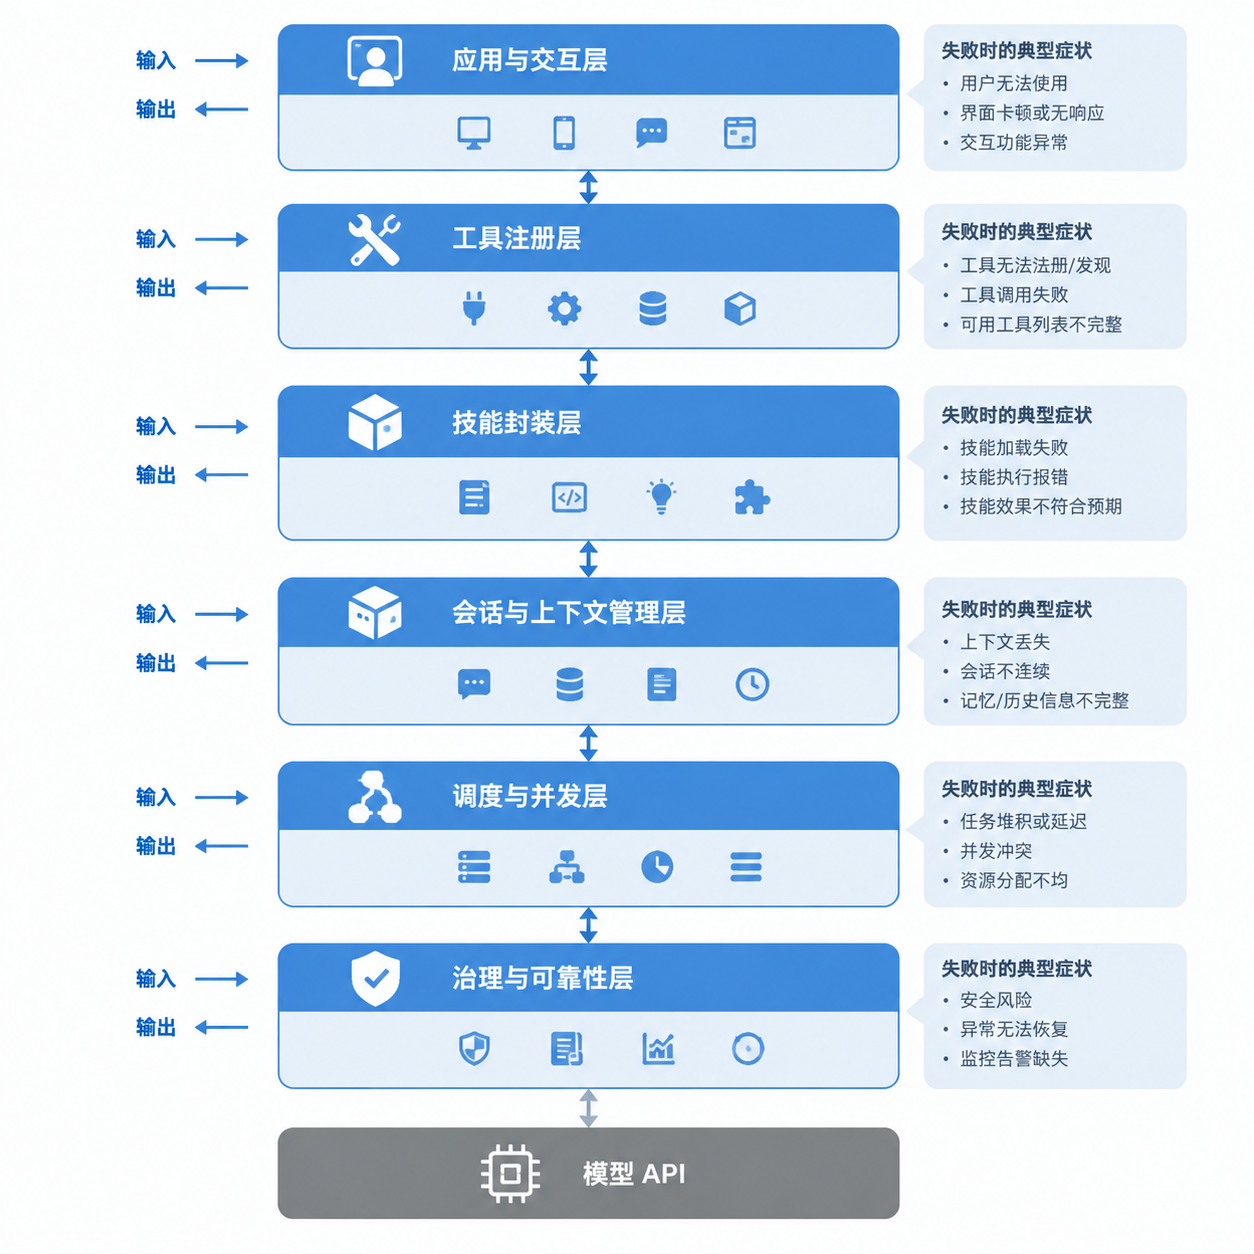
需要注意的是:这五层不是全部都"必须自建"。有些编码代理把 ①② 内置,有些把 ④⑤ 交给外部编排器。Harness Engineering 的工作就是决定每一层由谁承担、契约怎么定。
2.2 与 Prompt / Context Engineering、AgentOps 的分工
这几个术语经常被混用,划清边界有助于讨论。
| 术语 | 管什么 | 与 harness 的关系 |
|---|---|---|
| Prompt Engineering | 对模型"说什么":指令措辞、示例、角色设定 | 输入侧手艺,是 harness 中提示模板的一部分,但远不是全部 |
| Context Engineering | "装什么进窗口":检索、排序、截断、注入 | harness 的第 ③ 层,是子集关系 |
| AgentOps | 运行后的观测、计费、评估、告警 | harness 第 ⑤ 层的运维面,是子集关系 |
| Harness Engineering | 让模型可执行真实任务的整套外围系统(①--⑤) | 上位概念 |
推断 三者部分重叠、并不互斥。一句便于记忆的分工:Prompt 管"说什么",Context 管"装什么",AgentOps 管"看着它跑",Harness 管"让它跑得起来、跑得住、跑得回来"。
待核验:《模型不是产品:从 Prompt Engineering 走向 Harness Engineering》一文对 Harness Engineering 的原始定义尚未读取。若该文给出正式定义,本节应以其为准或显式说明差异,避免无意改写他人术语。
2.3 责任归属:harness 在组织里由谁持有
推断 五层的划分不仅是技术划分,也是责任划分。一种常见的分工形态是:
- 平台 / 工具链侧持有 ①④⑤:工具注册表、调度队列、限流与审计。这三层是跨领域复用的基础设施,越统一越有价值。
- 领域侧持有 ②:技能包的内容(领域知识、流程、约束)只有领域所有者写得准。
- **上下文管理(③)**通常归 harness 核心统一实现,但其"保留槽位"的定义需要领域侧参与------保留什么,取决于该领域任务的验收标准。
两侧的接口就是工具描述 + 技能 manifest:这两份文件同时是给模型看的说明、给运行时看的契约、给审计看的记录。一份契约承担三重读者,是 harness 工程里最容易被低估的复杂度来源。
判断 harness 是否有明确的组织归属,可以看三个信号:工具描述的变更是否有 review 与版本;技能包是否有 owner 与下线机制;限流与配额策略是否有人对结果负责。三条都答不上来,通常意味着这层处于"人人可改、无人负责"状态。
3|五个工程模式:harness 的核心承重墙
本章是全文重心。以下五个模式各讲一次机制;第 4--7 章只做映射、解剖、反例与自评,不再重复机制解释。每个模式末尾附一条度量口径 推断,用于把改进变成可回归验证的指标。
3.1 模式一 · 工具注册(Tool Registration):让能力"可被发现、可被安全调用"
要解决什么 :模型本身不会"知道"你的系统有哪些能力。工具注册层把能力转译成模型可理解、可校验、可安全调用的契约。注册机制的质量,直接决定了代理的可发现性 与可恢复性。
一个合格的工具契约至少要定义六件事:
- 能力描述:名称、语义说明(这段文字是给模型看的,写得含糊等于能力不存在)、参数 schema(类型、必填项、取值范围)。
- 权限与作用域:这个工具能碰哪些路径、哪些域名、哪些命令;是否有写权限。
- 幂等性与超时:重复调用安全吗?多久算失败?
- 失败语义 ------这是最容易被忽略、也最值钱的一项。模型看到的错误信息必须是"可行动的":错在哪、参数错还是环境错、重试有意义吗。错误反馈的质量直接决定代理能否自愈。
- 版本与弃用:契约变了怎么通知模型侧与调用侧,旧版本保留多久。
- 调用成本提示:预估耗时/资源,供调度层决策是否异步。
jsonc
// 示意格式,非任何真实接口;具体字段以所用框架文档为准
{
  "name": "media.probe",                      // 能力名(命名空间.动作)
  "description": "读取媒体文件的时长/编码/码流信息,只读不写",
  "parameters": {
    "type": "object",
    "required": ["path"],
    "properties": {
      "path": { "type": "string", "pattern": "^/workspace/" }   // 作用域约束
    }
  },
  "semantics": {
    "idempotent": true,
    "timeout_ms": 15000,
    "on_error": "retryable | fatal | need_user_input"           // 失败语义三分类
  },
  "version": "1.2.0",
  "deprecated": null
}整条链路可以概括为一个闭环:注册(能力描述 + schema)→ 发现(模型侧检索或注入)→ 校验(参数与权限)→ 调用(执行 + 超时)→ 错误回流(结构化错误 → 模型自愈,或升级到用户)。闭环的关键在最后一环:错误不是日志的终点,而是下一次调用的输入。
失败征兆 :模型反复用错参数、把只读工具当写工具用、报错后原样重试三次然后放弃。
自查项 :把最近 20 次工具调用失败日志拿出来,看错误信息里有没有"下一步该做什么"。
度量口径 推断:调用成功率、参数校验失败率、错误自愈率(报错后同一会话内恢复成功的比例)、平均恢复步数。
3.2 模式二 · 技能封装(Skills):把领域工具链打包成可复用能力
工具与技能的区别:工具是"一次调用",技能是"一套做法"。
技能 = 工具 + 领域知识 + 操作流程 + 约束条件 的打包。
典型收益:把"读手册"变成"调技能"。CSDN《把 80+ 项音视频能力装进 Claude Code 后,我合上了 FFmpeg 手册》这个标题 自述 描述的正是这一形态------把一条庞大的 CLI 工具链(FFmpeg 及其周边)封装进编码代理的能力空间,使代理不必在会话中反复检索手册。待核验:"80+ 项"的统计口径、封装形态(脚本/技能包/斜杠命令)以及正文细节均未核验,此处仅作现象引用。
什么时候该做封装:当一个任务模式第三次出现,且每次都要重新解释同样的领域约束时。
封装的反面:技能爆炸。数量上百之后,技能描述本身会挤占上下文窗口,选择成本转嫁给模型,命中率反而下降(见 6.2)。
text
# 技能包目录结构(示意布局,非任何框架的官方规范)
skills/
└── media-pipeline/
    ├── manifest.yaml      # 名称、触发语、输入输出契约、约束、版本
    ├── GUIDE.md           # 领域知识:常见坑、参数含义、许可注意事项
    ├── steps.md           # 操作流程:先探测→再转码→再校验
└── bin/ # 脚本入口(薄封装,真正逻辑可审计)复用单位是区分三层封装的实用判据:工具的复用单位是"调用",技能的复用单位是"任务",工作流(技能编排)的复用单位是"项目"。 三层自下而上,越往上越接近业务语义,也越需要显式的约束声明。
失败征兆 :代理在技能之间来回切换、执行到一半才想起某条约束、输出格式忽左忽右。
自查项 :任取一个技能,能否不看代码,仅凭 manifest 说清它"什么时候不该被用"?说不清就是约束缺失。
度量口径 推断:技能命中率(选对技能的比例)、同一任务内的重复检索次数、输出规范符合率、技能使用分布的长尾占比。
3.3 模式三 · 会话压缩(Session Compaction):长任务中的记忆保真
为什么必须压缩:长任务(重构一个模块、跑通一条流水线)天然超出单个上下文窗口;硬截断会丢掉约束与未决事项,导致代理"失忆式返工"。
压缩不是删减,是重新分配保真度:丢掉过程细节,保住决策要素。
- 触发时机 :窗口占用到达阈值;或任务阶段边界("测试通过了,进入下一阶段")------后者通常比前者更好,因为阶段边界天然是语义安全点。
- 保留优先级(从高到低):目标与验收标准 → 约束与禁令 → 未决事项与风险 → 已修改文件清单 → 关键决策及其理由 → 过程性对话(可丢)。
- 失败征兆:重复执行已完成的步骤、忘记早期设定的约束、编造"之前说过"的内容(上下文幻觉)。
text
# 会话压缩策略(抽象伪代码,示意算法,非任何真实 API)
def compact(session):
    if not (window_full(session) or at_stage_boundary(session)):
        return session
    keep = {
        "goal":        session.goal,            # 目标与验收
        "constraints": session.constraints,     # 约束与禁令
        "open_items":  session.unresolved(),    # 未决事项
        "touched":     session.files_changed(), # 已改文件清单
        "decisions":   session.decisions(),     # 决策 + 理由
    }
    summary = summarize(session.transcript)     # 过程压缩为摘要
    snapshot = save_rollback_point(session)     # 压缩前留回滚点,可回退
    return Session(keep=keep, summary=summary, rollback=snapshot)
压缩发生在时间轴上的形态是:前半程为密集的原始上下文 → 到达压缩点(阈值或阶段边界)→ 生成摘要并落入固定槽位(目标 / 约束 / 未决 / 已改文件 / 决策)→ 后半程在压缩后的上下文上继续。压缩点之前必须留一个回滚点,使"压缩错了"成为可恢复事件而非不可逆损失。
压缩好坏的判据 :压缩后让代理复述"当前目标、三条约束、两件未决事项",能完整复述即为合格。这一条应做成自动检查而非人工抽查。
度量口径 推断:压缩后复述检查通过率、重复执行率、约束违反次数、回滚点被使用的比例。
待核验 :hermes-jev-skills 描述中提及"记忆、压缩"能力 自述,但其具体机制(是截断、摘要、还是外部存储)需要读源码才能判断,本文不作机制断言。
3.4 模式四 · 异步调度(Async-first Scheduling):长任务与多任务的解耦
解决什么:构建、测试、批量抓取、多页截图这类长时任务,会把交互线程占死。同步串行的代理在跑长任务时"人只能等",也无法并行推进第二件事。
什么时候必须异步 :单步耗时可能超过用户可忍耐阈值(经验值:约十几秒以上 推断,此为工程常识而非实测数据)、或任务可拆分为多个独立子任务、或需要"发起后离开、回头收结果"的使用形态。
关键语义(很多 harness 在这一层语义不完整):
- 超时:每个任务必须有超时,且超时后状态是确定的(失败/部分完成),不能是"不知道还在不在跑"。
- 取消:取消必须真正传播到 worker,且已产生的副作用有确定处理(保留/回滚)。
- 结果回收:结果要能按任务 id 找回,含结构化产物与错误。
- 背压:队列满时的策略(拒绝/排队/降级),不能无限堆积。
text
# 任务队列骨架(抽象伪代码,示意结构,非任何真实 API)
task = queue.submit(kind="screenshot.run", payload=spec, timeout_s=300)
# ... 用户继续做别的事 ...
result = queue.await(task.id)          # 或 on_done(task.id, handler)
if result.status == "timeout": ...     # 状态必须确定
task.cancel()                          # 取消需传播到 worker
同步与异步的差别可以压缩成一张对比:同步串行是"用户 → 代理 → 长任务"的阻塞链,用户在整条链上等待;异步调度是"用户提交后继续交互 / worker 并行执行 / 完成后回调结果"的三段结构,超时、取消、回收三个语义点各自有明确归属。
失败征兆 :界面卡住、任务"消失"(既不在跑也没有结果)、取消后再看进程还在。
自查项 :你的 harness 里,超时/取消/回收三件事分别由哪段代码负责?能指出文件与函数即可通过。
度量口径 推断:任务成功率、超时率、取消有效率(取消后进程确实终止的比例)、结果回收成功率、队列积压长度。
3.5 模式五 · 限流治理(Rate-limit & Reliability Governance):从"无效重试"到可观测治理
职责归属 :限流、连接抖动、并发超限、配额耗尽,都是调用侧系统的问题,不是模型的锅。把它们记在"模型不行"账上,会导致错误的优化方向(换模型、改 prompt),而真正的病灶在治理层。
最小治理闭环包含五件事:
- 配额与并发上限:全局与每租户/每任务的并发上限、令牌预算。
- 退避策略:指数退避 + 抖动(jitter),避免同步重试风暴。
- 断点续跑:长任务可从最近的确定状态恢复,而不是从头再来。
- 可观测记录:每次调用记录 token、时延、错误类型、重试次数------没有记录就没有治理。
- 降级策略:当上游状态不可控时,降级到确定行为(排队、限速、只读模式、转人工)。
text
# 令牌桶 + 指数退避(通用算法,不涉具体 API)
def call_with_governance(req):
    for attempt in range(MAX_ATTEMPTS):
        bucket.acquire(tokens=estimate(req))          # 令牌桶限流
        try:
            return invoke(req)
        except RateLimited as e:
            sleep(min(CAP, BASE * 2**attempt) * jitter())   # 指数退避 + 抖动
            record(req, error="rate_limited", attempt=attempt)  # 可观测
        except Fatal as e:
            record(req, error="fatal", attempt=attempt)
            raise
    escalate(req)   # 升级到用户/人工,不做无意义的第 N+1 次重试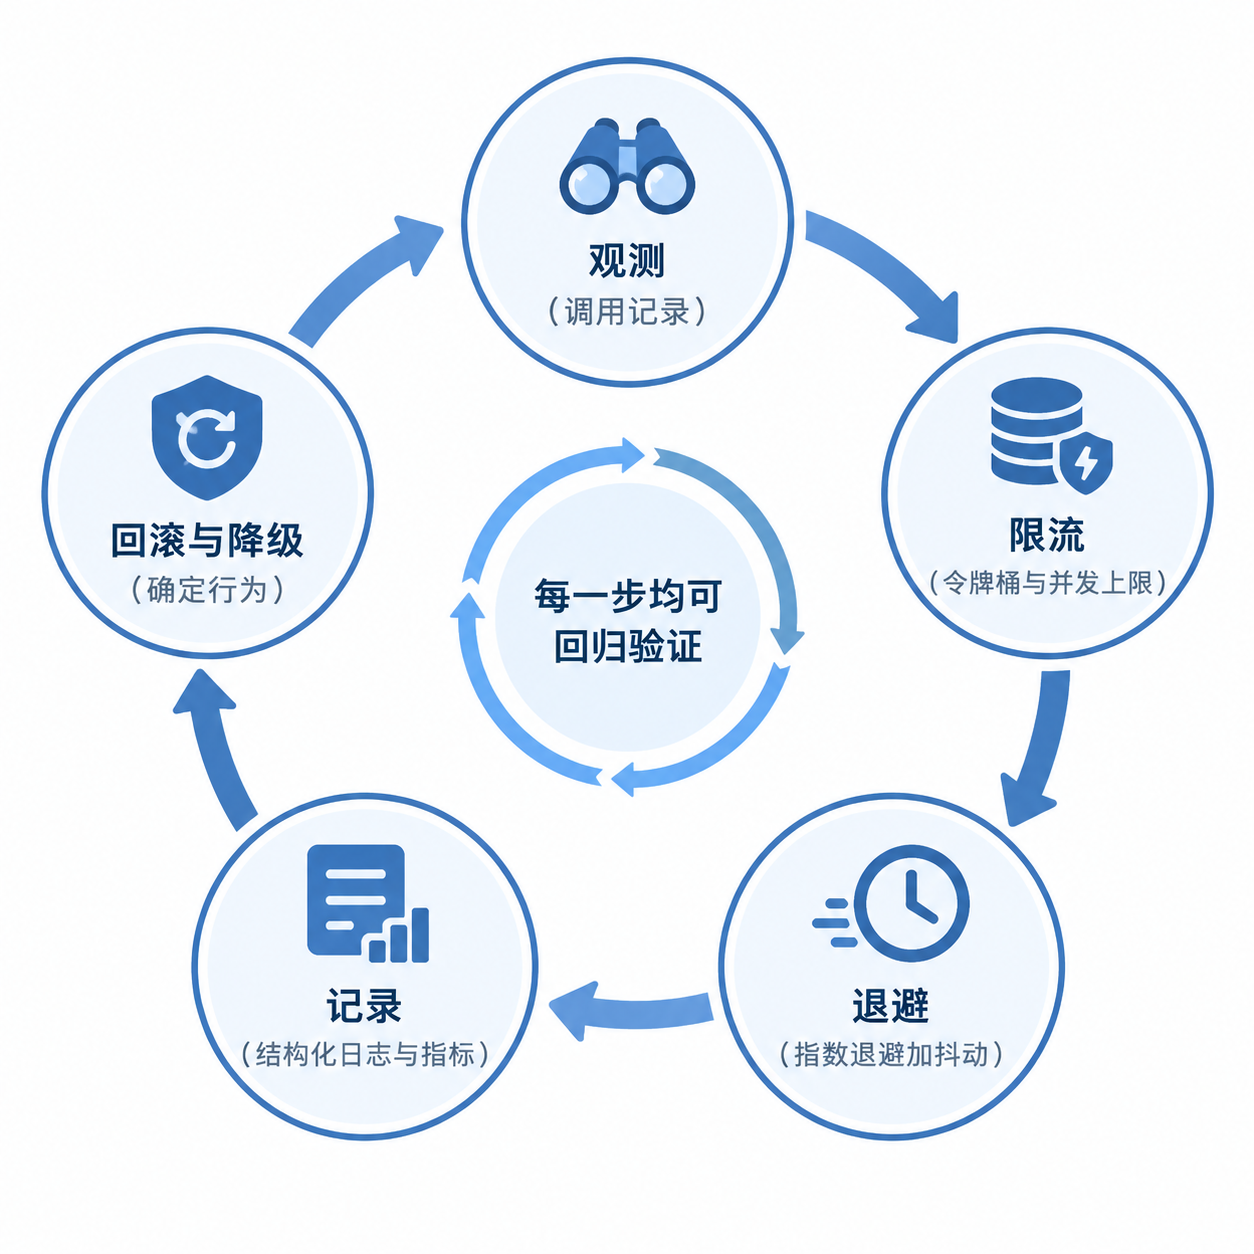
一个值得严肃对待的反面教材 :ccodex-sleep-state 这类"改善模型状态/降智/限流体验"的工具,其 README 自述中写明"不保证取得指定 state 或提升模型质量"自述 。一种不可证伪的治理手段,本质上不是治理,是祈祷。 这类工具的出现,本身就是治理层缺位的用户侧补偿(详见 6.1)。
度量口径 推断:限流触发次数与分布、重试后成功率、配额使用率、p95 调用时延、升级到人工的比例。
待核验:该仓库的实际做法与免责声明需逐字核对 README 与源码;本文不对其效果作任何断言。
4|三个实战切片:Codex / Claude Code / CodeBuddy 验证了什么
本章证据说明 :以下三个案例目前仅有标题级信息 ,正文未核验。因此本章不复述具体操作步骤、不引用教程代码,只做"任务形态 ↔ harness 模式"的映射分析。涉及具体产品(Codex / Claude Code / CodeBuddy)的权限模型、技能机制、上下文管理,一律以各产品官方文档为准,本文不凭印象描述。
选这三个案例的理由:它们分别代表三类典型任务形态------多源编排(fan-out)、领域工具链封装、长链路 I/O 任务------恰好落在五层模型的不同承重点上,适合作为映射分析的样本,而非作为产品优劣的证据。
4.1 Codex × 聚合搜索应用:能力编排与工具注册
CSDN《Codex 开发聚合搜索应用项目实战操作详解》自述 (该条目在本批 CSDN 元数据中热度值最高,但热度口径未经确认,且 CSDN 与 GitHub 热度不可横向比较,故本文不作任何排名表述)。
推断 从"聚合搜索应用"这一任务形态推断,其 harness 承重结构主要落在两处:
- 工具注册:多源搜索意味着多个能力入口(不同搜索后端、不同结果格式),每个都需要清晰的参数 schema 与失败语义;单源超时不能拖垮整体。
- 调度:多源并行查询 + 结果归并,是典型的异步 fan-out / fan-in 结构。
映射 :① 工具注册(主)→ ④ 调度(次)。待核验:原文是否真的以并行方式调用多源、超时与降级如何处理、结果归并策略。
4.2 Claude Code × 音视频能力封装:技能封装的典型样本
CSDN《把 80+ 项音视频能力装进 Claude Code 后,我合上了 FFmpeg 手册》自述。
收益面(推断):把领域工具链封装为技能后,代理的单次任务内检索成本显著下降,输出一致性上升------"合上手册"这个说法恰好指向"知识从上下文移到技能包"这一工程动作。
代价面(推断):能力数量上去后,技能描述本身成为窗口负担;同时音视频处理是重计算、长耗时操作,若没有超时与调度层支撑,技能调用会阻塞交互。
映射 :② 技能封装(主)→ ① 工具注册(次)。
待核验:"80+ 项"的统计口径、封装形态(脚本 / 技能包 / 斜杠命令)、是否处理了 FFmpeg 的许可与调用方式说明。
4.3 CodeBuddy × Playwright 全链路截图:长链路中的压缩与调度
CSDN《基于 CodeBuddy 使用 Java + Playwright 给网页自动"拍照":从列表页到文章详情页的全链路截图实战》自述。
推断 从"列表页 → 文章详情页的全链路"这一任务形态推断,它是长链路任务的典型样本:步骤多、中间态多、单步耗时不可控(页面加载)。这类任务最容易暴露两个 harness 弱点:
- 会话压缩:链路一长,前面页面的状态(已抓到哪些、哪些失败、哪些待重试)极易被压缩掉,导致重复抓取或漏抓。
- 异步调度:截图/加载是 I/O 密集长耗时操作,串行阻塞会让整个会话不可用。
映射 :③ 会话压缩 + ④ 调度(两者并重)。
待核验:原文代码的真实用法(Playwright 为公开 API,但具体调用须以原文与官方文档核对后引用,本文不凭印象编写示例)。
4.4 反面切片:当用户开始 hack "模型状态"
gylive/ccodex-sleep-state(GitHub)自述"尝试改善 Codex 降智、限流与连接体验",并声明"不保证取得指定 state 或提升模型质量"自述。
这一现象说明了什么(推断):当用户开始为"模型状态"写脚本,通常意味着三件事之一------① 治理层(限流、重试、连接管理)没有暴露可观测接口,用户只能从外部"感觉";② 缺少降级策略,用户只能自行寻找"好时段";③ 缺少可回归验证的评估手段,效果只能靠体感。三者都属于 harness 层的欠账,而不是模型能力问题。
映射:⑤ 治理(缺位)。
四个样本与五层模式的映射关系汇总如下(每个案例只承担一个主论点,矩阵中只有一个"主"格;"未提及"表示标题级信息中无对应线索,不等于该产品没有该能力):
| 案例 | ① 工具注册 | ② 技能封装 | ③ 会话压缩 | ④ 异步调度 | ⑤ 限流治理 |
|---|---|---|---|---|---|
| Codex × 聚合搜索 | 主 | 不适用 | 次 | 次 | 未提及 |
| Claude Code × 音视频技能 | 次 | 主 | 未提及 | 次 | 未提及 |
| CodeBuddy × 全链路截图 | 次 | 不适用 | 次 | 次 | 未提及 |
| ccodex-sleep-state | 不适用 | 不适用 | 不适用 | 不适用 | 缺位(用户侧补偿) |
5|开源 harness 解剖:ZCode 与 unreal-agent
本章证据说明 :以下三个仓库均未 clone、未读源码 ,当前只能给出"解剖框架 + 核对方法"。任何架构性结论都必须在读完源码后才能成立,本文不提前下结论。组织归属(
zai-org/unreallabsai/kerpopule等)与仓库的实际关系未核验,请勿据本文推断"某某公司出品"。
5.1 ZCode:自述 "Powerful, intelligent, extensible" 的编码代理 harness
README 自述定位为 "Z.ai's coding agent harness. Powerful, intelligent, extensible." 自述。
解剖框架(读源码时按此顺序):
- 扩展点在哪:"extensible" 必须落到具体机制上------是插件系统、工具注册表,还是配置文件?找到那个"第三方可以加一个能力"的入口函数。
- 工具契约长什么样:参数 schema 如何声明、错误如何结构化回流、是否有权限/作用域概念。
- 上下文管理:窗口接近上限时的策略(截断 / 摘要 / 外置存储),保留槽位是哪些。
- 治理:有无限流、退避、重试封装,是否记录调用指标。
待核验清单:组织归属与 LICENSE;技术栈;扩展机制的实际入口;是否包含会话压缩与限流逻辑;README 中 "powerful / intelligent" 是否有任何可核验的支撑材料(若无,按营销话术处理)。
5.2 unreal-agent:自述 "Async-first agent harness" 的调度取向
README 自述为 "Async-first agent harness" 自述 。"async-first" 是一个可证伪的架构声明------它在代码结构上应当留下清晰痕迹:
| README 声明 | 源码里应看到什么 |
|---|---|
| async-first | 任务队列 / 协程或 actor 模型 / 非阻塞事件循环;入口函数是否大量返回 future/句柄而非结果 |
| ------ | 取消(cancel)是否真的传播到 worker,而非只改一个标志位 |
| ------ | 超时语义是否确定(超时后状态可判定) |
| ------ | 结果回收机制(按 id 取回 / 回调 / 轮询)与错误的结构化 |
| ------ | 工具层与调度层的耦合方式:工具是否被强制声明"可异步/可超时" |
待核验:任务模型实现(队列/协程/子代理派发)、取消与超时语义、结果回收机制、与工具层的耦合方式。若源码中找不到任务队列或并发模型,则 "async-first" 只是宣传标签。
5.3 附:能力清单型样本 hermes-jev-skills
kerpopule/hermes-jev-skills 的描述清单为:模型路由、记忆、压缩、技能选择、电脑与浏览器操作 自述。
这反映的产品观(推断) :一张 README 能力清单几乎覆盖本文五模式中的四个(技能封装、会话压缩、调度/路由、工具操作),可作为模式完整性的对照样本------说明本文的五层划分不是纯理论推演,而是业界实际在补的清单。
但必须区分 :"列在 README" 与 "在源码中实现" 是两件事。待核验 :各项能力的实现深度(真实现 / 薄封装 / 仅占位);该仓库与 Jev/TypeSafe 生态的关系------本批数据中该生态呈现明显聚集(多条同名生态条目 + 若干 awesome-* 目录仓),存在定向推广或数据造势的可能,在完成真实性审计前,涉及该生态的任何数量性表述均不可引用。
5.4 方法论:看到 README 标签后,去源码里核对什么
这张表可以独立复用------拿到任何一个 "agent harness" 仓库,按下表核对,30 分钟内能判断它靠不靠谱。
| README 常见标签 | 去源码核对什么 | 通过判据 |
|---|---|---|
| async-first / 并发 | 任务队列、并发模型、事件循环 | 找到真实队列与 worker,且取消可传播 |
| extensible / 插件 | 工具注册表 / 插件加载入口 | 第三方无需改核心代码即可加能力 |
| memory / 记忆 | 上下文截断、摘要、外置存储 | 能指出压缩触发条件与保留槽位 |
| skills / 技能 | manifest 格式、加载与选择逻辑 | 技能有版本、有约束声明、有过滤机制 |
| resilient / 可靠 | 重试、退避、超时、降级 | 退避带抖动;错误被结构化;有升级路径 |
| observable / 可观测 | 日志、指标、trace | 每次调用有时延/错误类型/重试次数记录 |
| secure / 沙箱 | 权限作用域、命令白名单、审计 | 权限默认最小;写操作可审计可回滚 |
| benchmarks / 性能数字 | 测试脚本、口径说明(batch、输入长度、预热) | 可复现;口径完整。否则按营销话术处理 |
补充判据(推断):核对时优先看三处------测试目录(有测试的语义才是真语义)、变更历史(契约是否被反复破坏)、issue 区(失败语义是否被用户反复抱怨)。这三处比 README 更接近实现真相。
6|反模式:harness 做错时会发生什么
6.1 不可证伪的治理(Cargo-cult Reliability)
"调 state""让它先睡一会""找个好时段跑"------这类做法的共同特征是不可证伪:失败了可以解释为 state 不对,成功了无法归因。
为什么会走到这一步(推断) :当治理层不暴露可观测接口(当前并发、剩余配额、上次错误类型),用户只能从外部体感推断系统状态,于是发明出拟人化的解释模型。替代方案:任何治理动作都必须满足两条------可观测(能看到为什么触发)、可回归验证(改了之后有指标证明变好或变坏)。做不到这两条的手段,不进生产。
自查项:你手上的"经验性技巧",能否写成一条 if 判断 + 一个可测量的指标?写不成的,就是仪式化操作,不是工程手段。
6.2 技能/工具爆炸与选择失效
工具注册不是越多越好。数量上百后会出现三种病:
- 命名冲突与语义重叠:三个都能"导出图片"的工具,模型随机选一个,行为不稳定。
- 窗口挤占:工具/技能描述本身占上下文,把真正要处理的代码挤出去。
- 选择成本转嫁:选择难度上升,命中率下降,用户体感是"变笨了"------其实模型没变。
治理手段(推断):命名空间分组;按任务类型过滤(只注入相关工具);懒加载(描述瘦身 + 需要时取详情);定期合并/下线低使用率能力(和下线 API 一样需要弃用期)。
自查项:你的工具清单里,有多少个在最近 30 天内一次都没被调用?
6.3 不可回滚:harness 缺少版本化
LLMOps 文章《发布原子不是模型,是 Prompt/数据/模型版本三元组》自述 提出把发布原子从"模型"扩到三元组。待核验:该文正文论点未核验,此处仅按标题转述。
推断 把这个思路推演到 harness 层,结论是:只版本化模型远远不够。下列对象同样需要版本与回滚能力------
- 工具描述与参数 schema(改一句话就可能改变模型的调用行为)
- 技能包(流程与约束变了,行为就变了)
- 提示模板(system prompt、技能触发语)
- 治理参数(重试次数、退避基数、并发上限)
失败征兆 :上周还好好的代理,本周行为变了,但没人改过模型。
自查项:能否回答"上周三下午那次成功的运行,用的是哪个版本的工具描述和技能包"?答不上来,就是不可回滚。
6.4 治理缺位的安全代价
harness 通常会拿到高危权限:shell、文件系统、浏览器、网络。权限越大,治理层的安全基线越是硬约束:
- 最小权限 + 作用域:默认只读;写权限限定路径前缀;网络访问限定域名白名单。
- 命令白名单 / 危险操作确认:删除、外发、安装类操作必须过一道闸。
- 审计日志:谁(哪个任务)、何时、对什么、做了什么,可追溯。
- 密钥隔离:凭据不进上下文、不进日志;由工具侧注入而非让模型持有。
- 回滚:文件级快照/沙箱,使误操作可逆。
待核验 :Codex / Claude Code / CodeBuddy 的实际权限模型(沙箱机制、审批策略、命令白名单)须查各产品官方文档,本文不凭印象描述。
7|落地:Harness 成熟度自评与最小起步
7.1 五维成熟度自评表
对自家 agent 工作流逐行打分,取最低分作为整体水位(短板决定稳定性)。
| 维度 | L1 临时脚本 | L2 基本可用 | L3 可观测可回滚 |
|---|---|---|---|
| ① 工具注册 | 工具散落在 prompt 里,参数靠自然语言约定 | 有 schema 声明与基本校验 | 失败语义结构化 + 版本/弃用机制 + 作用域权限 |
| ② 技能封装 | 每次现场教,靠复制粘贴经验 | 有技能包目录与 manifest | 技能带约束与"禁用条件",有使用统计与下线机制 |
| ③ 会话压缩 | 窗口满了硬截断 | 达阈值触发摘要 | 阶段边界触发 + 关键槽位固定保留 + 回滚点 + 自动复述检查 |
| ④ 异步调度 | 长任务阻塞交互 | 有队列,能后台跑 | 超时/取消语义确定 + 结果按 id 可回收 + 背压策略 |
| ⑤ 限流治理 | 失败就重试,靠体感调参 | 有退避与重试上限 | 令牌桶/并发上限 + 指标记录 + 降级路径 + 升级到人工 |
7.2 最小可用 harness(从 0 到 1 的顺序)
资源有限时的推荐优先级:
① 工具注册契约 → ② 失败语义与重试 → ③ 会话压缩 → ④ 技能封装 → ⑤ 异步调度
理由(推断) :前两项决定稳定性下限 ------契约不清、错误不可行动,后面做得再好也会频繁失败且无法自愈;后三项决定效率上限 ------在稳定的基础上提升吞吐与复用。治理(限流治理)不是最后才做,而是贯穿①②(重试与退避属于失败语义的一部分),完整闭环在有量之后补齐。
text
# 最小 harness 抽象骨架(示意架构,非任何真实 API)
loop:
    task   = user_input()
    plan   = model(task, context=compact_if_needed(session))   # ③ 压缩钩子
    for step in plan:
        tool = registry.resolve(step)                           # ① 工具分发
        out  = with_retry(tool.run(step.args))                  # ①⑤ 失败语义 + 退避
        session.append(step, out)                               # ③ 记录关键槽位
        metrics.record(tool, latency, err_type)                 # ⑤ 可观测
    emit(session.result())
说明:刻意省略了调度(④),因为在最小形态里串行是可接受的;当单步耗时开始让用户等待时,再把
tool.run换成queue.submit,这是加法而非重构。
7.3 落地顺序上的三个常见误区
推断,来自上述五层之间的依赖关系:
- 先建技能库、后补工具契约:技能是工具之上的封装,底层契约不稳定时,技能包会被反复推翻重写,且每次重写都会连带改变模型行为。
- 把治理等同于重试:只有重试上限而没有退避、记录与降级,等于把限流问题放大成重试风暴;治理的第一件事是可观测,第二件事才是自动动作。
- 用一个超长 system prompt 承担全部约束:prompt 是没有版本、没有测试、没有回滚的载体。凡是需要长期生效的约束,都应该沉到工具契约、技能 manifest 或治理参数里去。
8|趋势判断与可证伪的开放问题
以下全部标注为 推断,并给出各自的触发信号与证伪条件。
判断一:harness 层会出现事实标准之争。 争夺焦点在三处------工具描述格式、技能包规范、会话压缩协议。谁先被多个运行时共同接受,谁就掌握了生态位。触发信号:出现跨框架的工具描述互操作提案或转换器。
判断二:治理从"可选项"变"采购项"。 限流、审计、版本回滚会从"内部脚本"变成有 SLA 的正式组件,甚至独立产品线。触发信号:团队为治理单独排期、单独考核;采购清单里出现"agent 治理/审计"条目。
判断三(也是本文论点的潜在证伪路径):harness 层可能被模型侧部分吸收。 如果模型的上下文窗口与内置工具能力继续增强,部分 harness 层(尤其是上下文管理与基础工具调用)会被吸收回模型/平台侧,本文"竞争层外移"的判断就会被削弱。触发信号:厂商把技能机制、长任务调度、限流重试直接做进模型服务或官方 SDK,且第三方 harness 明显退潮。这一条必须写出来------一个不给证伪条件的趋势判断,价值接近零。
| 情景 | 触发信号 | 对团队的影响 |
|---|---|---|
| A:harness 标准化 | 出现跨框架工具描述/技能包互操作规范 | 自建 harness 的投资保值;应积极参与规范而非自造方言 |
| B:厂商吸收 | 模型服务内置技能/调度/治理能力 | 深度自研 harness 的投入需重新评估;差异化上移到业务工作流与私有技能 |
| C:生态碎片化 | 各家方言互不兼容,工具描述与技能包无法跨框架复用 | 自建成本被方言锁定抵消;应优先投资可迁移的中间层(如统一工具描述适配器、跨框架测试集) |
三种情景下的共同动作(推断) :无论走向哪种情景,有两类投入都不会贬值------一是契约的显式化 (工具描述、技能 manifest、失败语义写成可校验的文件),二是行为的可回归验证(每次改动 harness 都有一组任务集证明变好或变坏)。这两类资产不绑定任何框架,且在情景 B 下正是差异化上移的落点。
9|写在最后
回到开头的论断:竞争层正从 prompt 滑向 harness。它现在仍是一个待验证的行业观察,而不是被 benchmark 证实的结论------本文在每一处都保留了这个限定。
但对工程团队而言,"尚未被证实"不等于"可以不准备"。五层外骨骼(工具注册、技能封装、会话压缩、异步调度、限流治理)是任何编码代理走向真实任务都绕不开的承重结构,区别只在于由你自建、由框架提供、还是由模型服务吸收。今天把契约写清楚、把失败语义定义完整、把关键槽位和回滚点留出来,在任何一种情景下都是可迁移的投入。
最后重申本文的证据纪律:文中所有案例目前停留在标题与 README 层,所有机制性描述都是抽象示意。欢迎以源码、官方文档与可复现实验来修正本文------尤其欢迎证伪"竞争层转移"这一判断本身。
附录 A|术语速查
| 术语 | 含义 | 出处章节 |
|---|---|---|
| Harness | 包围模型、使其可执行真实任务的整套外围系统(工具注册、技能、上下文、调度、治理五层) | 2.1 |
| 工具注册(Tool Registration) | 把系统能力转译为模型可发现、可校验、可安全调用的契约 | 3.1 |
| 失败语义(Failure Semantics) | 错误的结构化表达:错在哪、可否重试、是否需人工介入 | 3.1 |
| 技能(Skill) | 工具 + 领域知识 + 操作流程 + 约束条件的可复用打包 | 3.2 |
| 会话压缩(Session Compaction) | 长任务中按保留优先级重新分配上下文保真度,并留回滚点 | 3.3 |
| 上下文幻觉 | 压缩或截断后,代理编造"之前说过"的不存在内容 | 3.3 |
| 异步优先(Async-first) | 以任务队列/句柄为核心的调度取向,要求超时、取消、结果回收语义确定 | 3.4 |
| 背压(Backpressure) | 队列满时的显式策略:拒绝、排队或降级 | 3.4 |
| 限流治理(Governance) | 配额、退避、断点续跑、可观测、降级五件套的闭环 | 3.5 |
| Cargo-cult Reliability | 不可证伪的仪式化"优化",成功无法归因、失败可随意解释 | 6.1 |
| 发布原子 | 被版本化与发布的最小单元(本文语境中从"模型"扩展为 Prompt/数据/模型三元组) | 6.3 |
| Context Engineering | 决定"装什么进上下文窗口"的工程,属于 harness 第 ③ 层 | 2.2 |
| AgentOps | 运行后的观测、计费、评估、告警,属于 harness 第 ⑤ 层的运维面 | 2.2 |