用 MaaS 平台的人大概都纠结过同一件事:简单任务用旗舰模型嫌贵,复杂任务用便宜模型怕它翻车。于是每次发请求前都要做一道选择题------这个任务该用哪个模型?任务一多,切换模型本身就成了新的心智负担。
"智能路由"就是冲着这个痛点来的:请求只管发,平台替你挑模型。但宣传语谁都会写,真正的问题是------它到底是看任务下菜碟,还是无脑往池子主力上派?编辑路由的那些选项,调了真的有用吗?
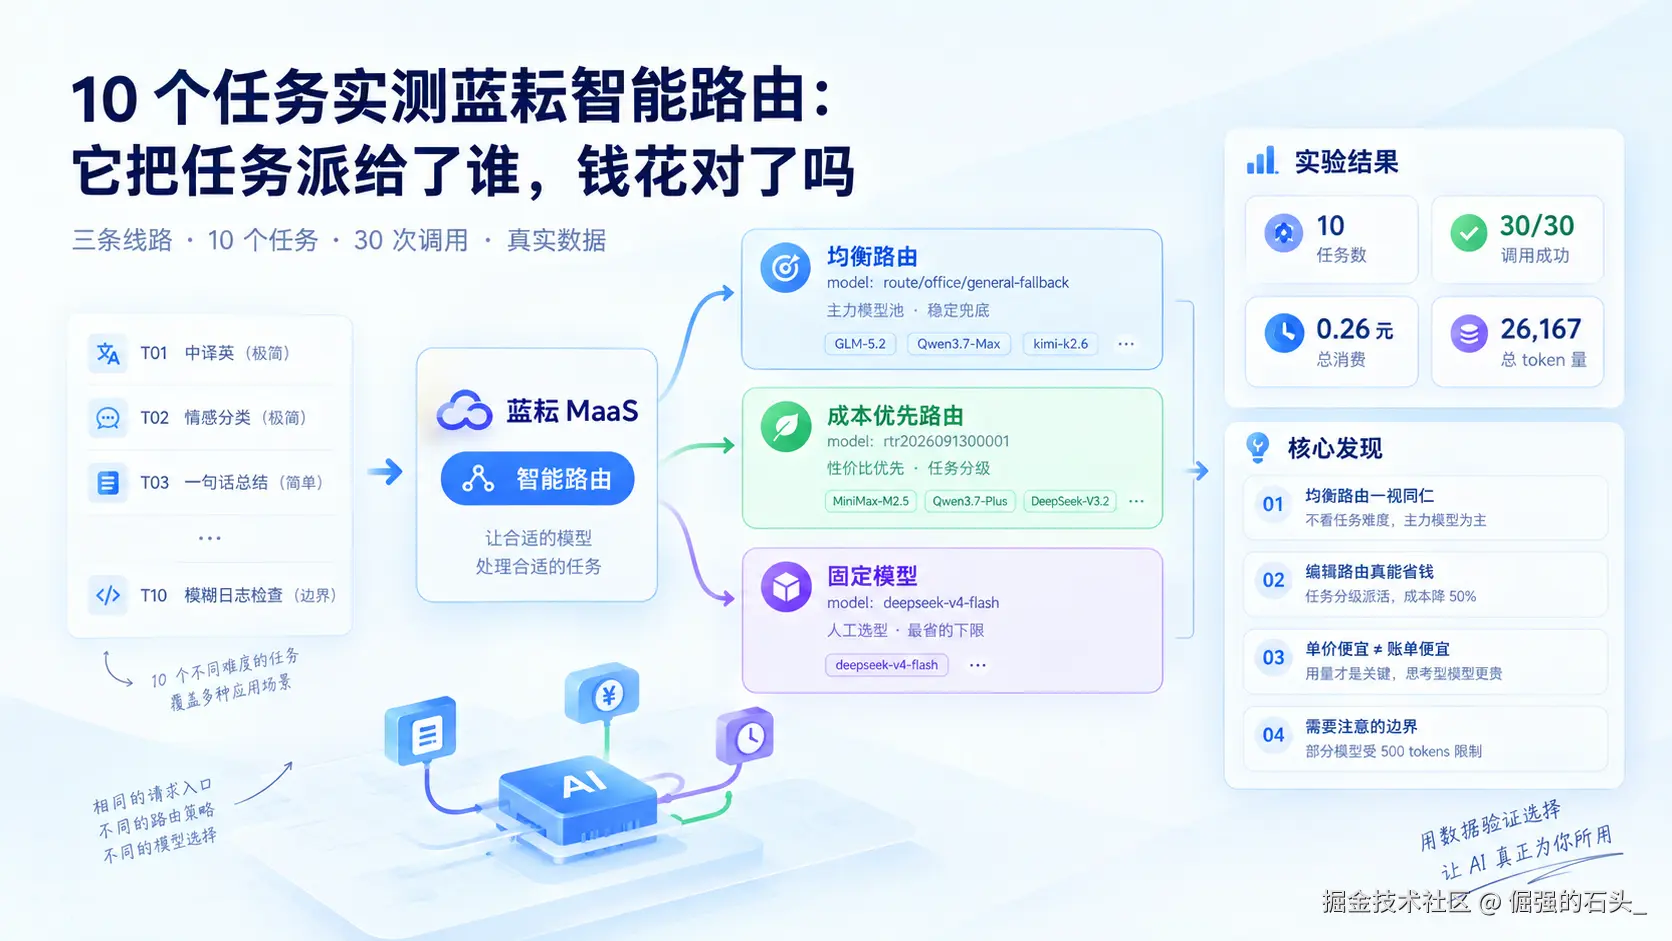
这次我拿蓝耘 MaaS 的智能路由做了一组三线对照实验:10 个不同难度的任务,分别经内置"通用"路由、自建的"成本优先"路由和固定的 deepseek-v4-flash 各跑一遍,逐条记录实际响应模型、耗时和 token 用量。30 次调用全部成功,本文是完整的实验过程与结果。
@toc
一、蓝耘的智能路由是什么
蓝耘 MaaS 左侧的「智能路由」页面里,平台内置了一批按场景划分的路由策略:通用、智能客服与工单、邮件与即时消息辅助、企业知识库问答(RAG)、合同与法务审阅、公文与文档写作、财务票据与报表处理、代码开发与评审、数据分析与商业智能、营销文案与多媒体创作。 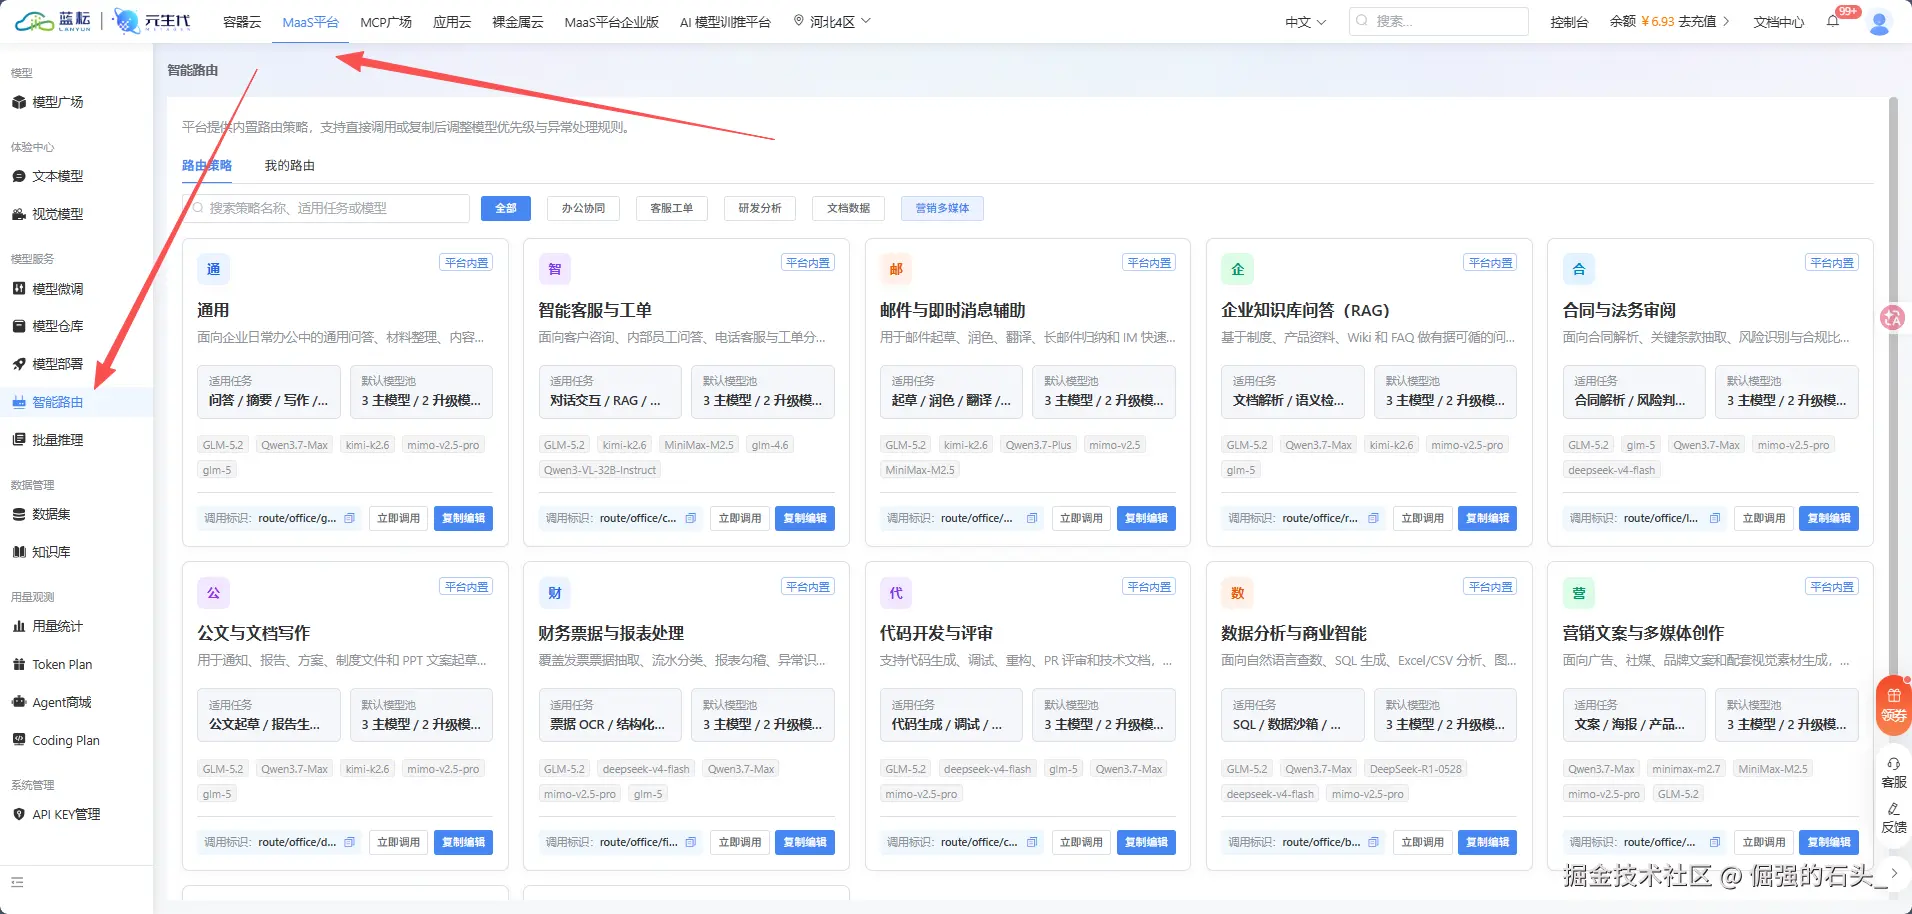
每条策略公开两件关键信息:适用任务 和模型池 。以本文的主角"通用"策略为例,池子是 GLM-5.2、Qwen3.7-Max、kimi-k2.6 三个主力模型加两支升级模型------派活范围一目了然,不是黑盒。 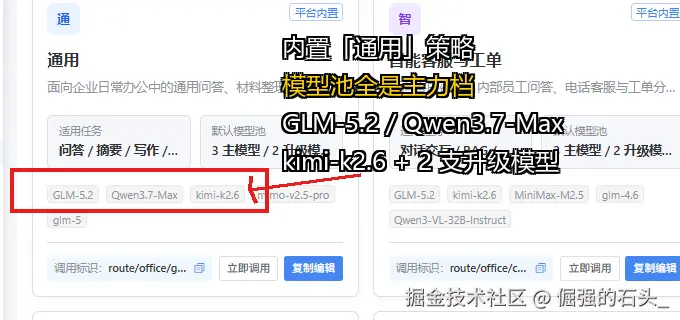
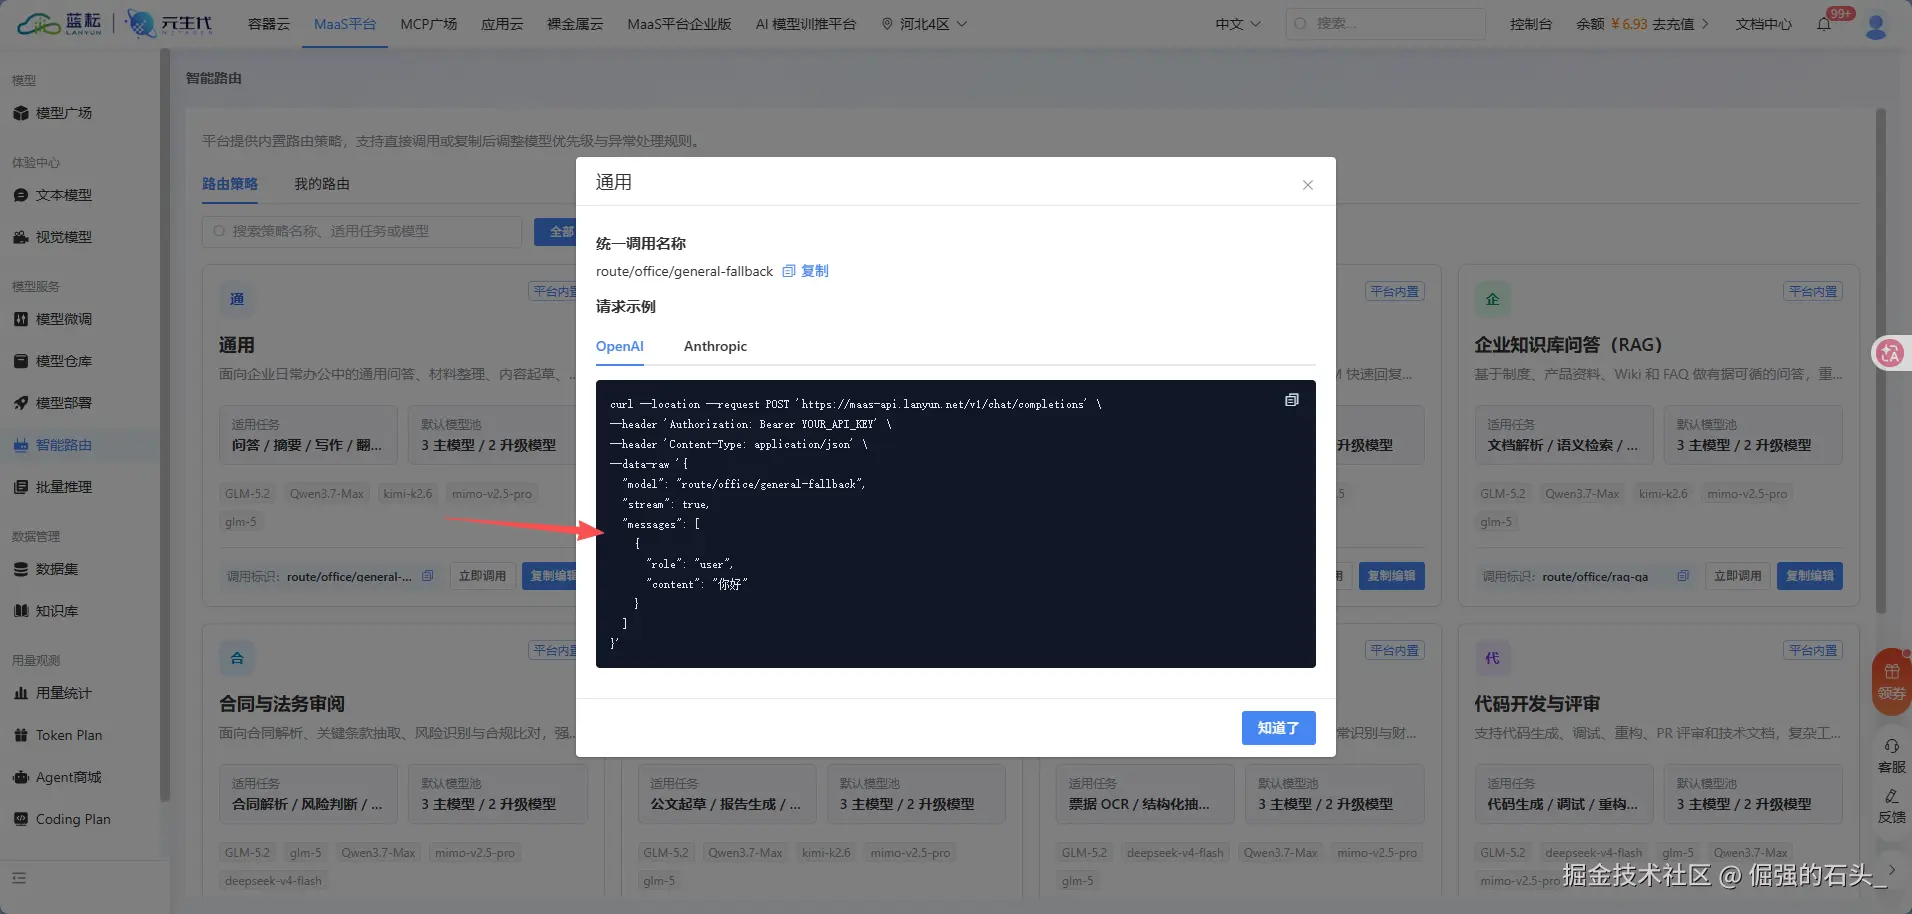
调用方式出乎意料地简单:还是原来的 OpenAI 兼容接口,只是把 model 字段从具体模型名换成路由标识。"通用"策略的标识是 route/office/general-fallback(以页面显示为准):
bash
curl --location --request POST 'https://maas-api.lanyun.net/v1/chat/completions' \
--header 'Authorization: Bearer YOUR_API_KEY' \
--header 'Content-Type: application/json' \
--data-raw '{
    "model": "route/office/general-fallback",
    "stream": true,
    "messages": [{ "role": "user", "content": "你好" }]
}'
二、三条线路,各司其职
先交代一个设计上的自我纠正。我最初的方案是"通用路由 vs 固定 deepseek-v4-flash"直接比成本------动手前发现这是个陷阱:通用路由的池子全是主力模型,单价比 deepseek-v4-flash 高,这么比,路由天生必输,输的不是派活能力,是池子构成。对照实验的公平性取决于对照组的角色摆得正不正。
于是最终的三条线路这样分工:
| 线路 | model 字段 | 角色 |
|---|---|---|
| 均衡路由 | route/office/general-fallback |
平台默认答案:看它是否按任务难度派活 |
| 成本优先路由 | rtr2026091300001(自建) |
回答"编辑路由到底有没有用" |
| 固定模型 | deepseek-v4-flash |
"人工选型·最省"的下限:省到底,质量行不行 |
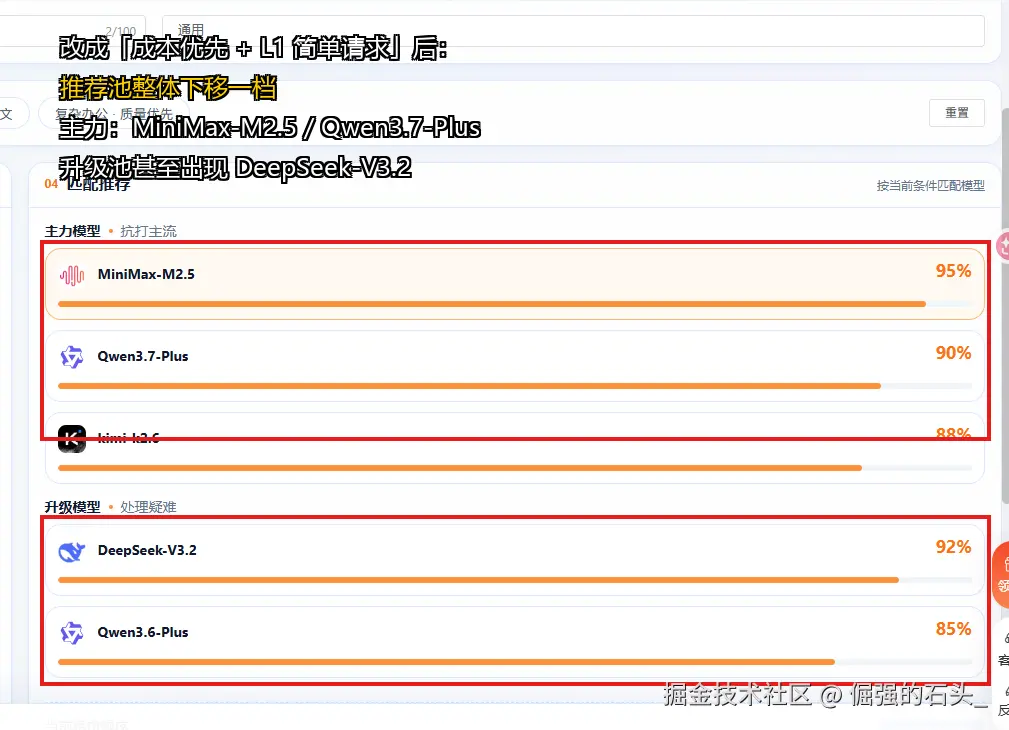
第二条线路值得一提。"通用"策略支持"复制编辑":复制一份到我的路由,就能看到它的决策参数------默认偏好、办公任务、任务复杂度、数据要求、附加能力五个维度,外加超时自动切换、限流自动降级两组异常处理开关。我把默认偏好改成"成本优先"、任务复杂度选"L1 简单请求"后,平台重新匹配的推荐池整体下移了一档:主力变成 MiniMax-M2.5、Qwen3.7-Plus,升级池里甚至出现了 DeepSeek-V3.2 和 Qwen3.6-Plus。 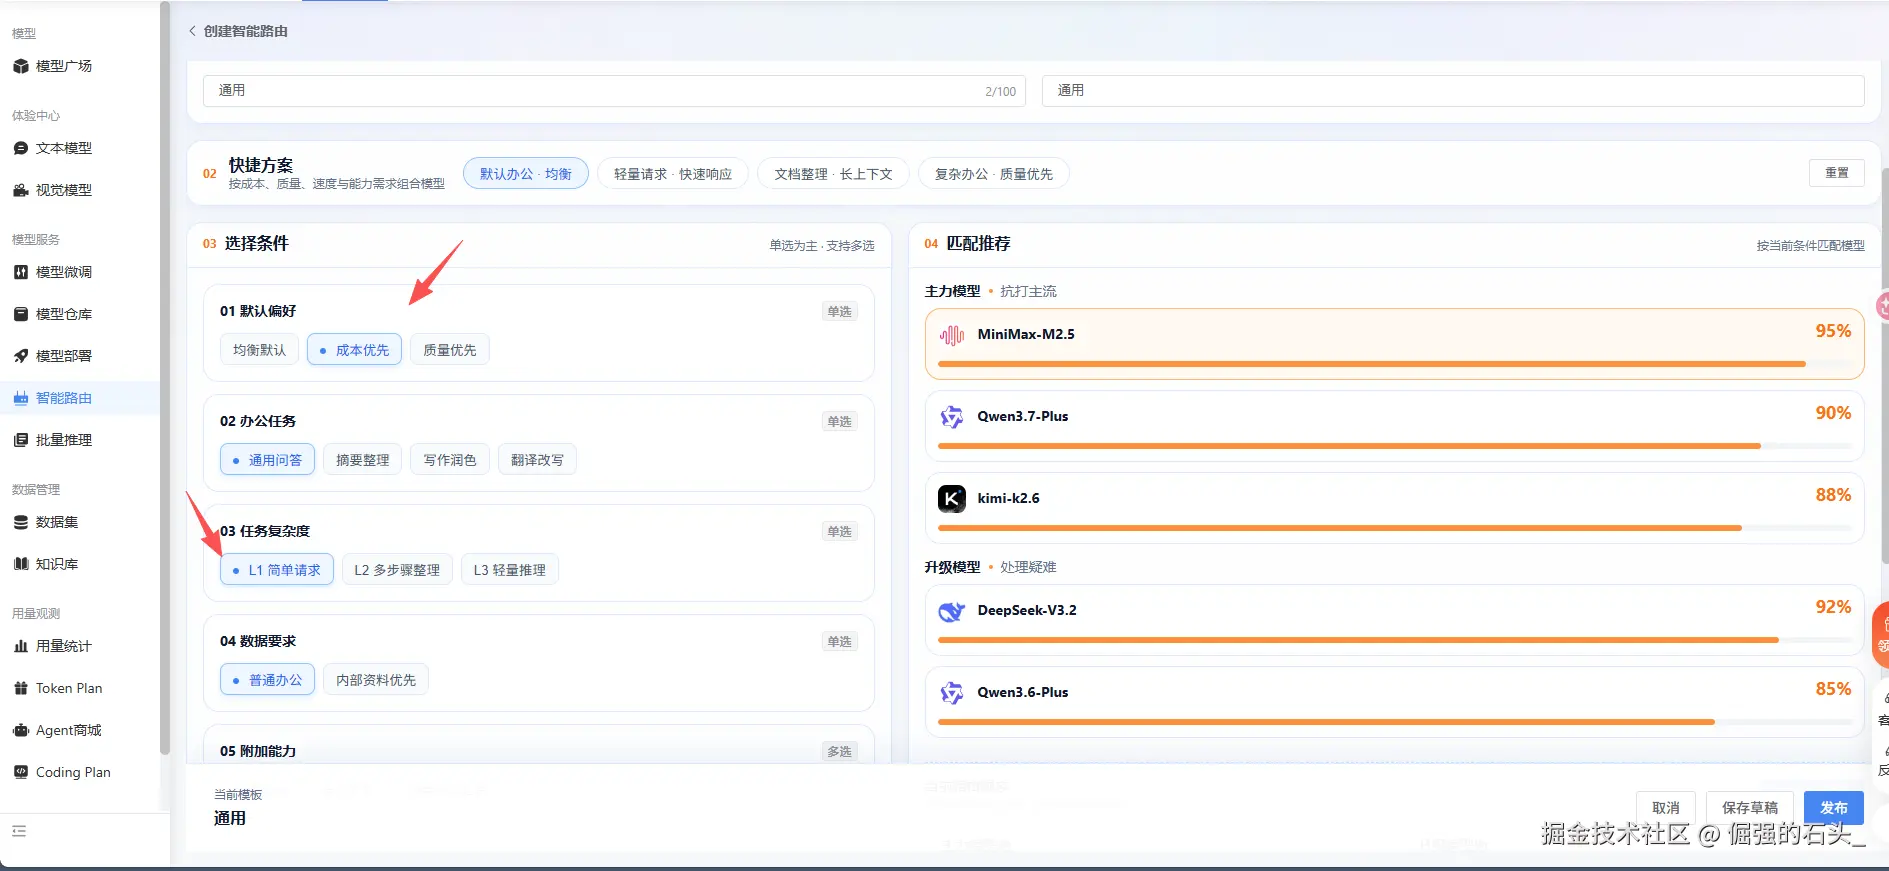
发布之后,这条路由拿到了自己的独立调用标识: 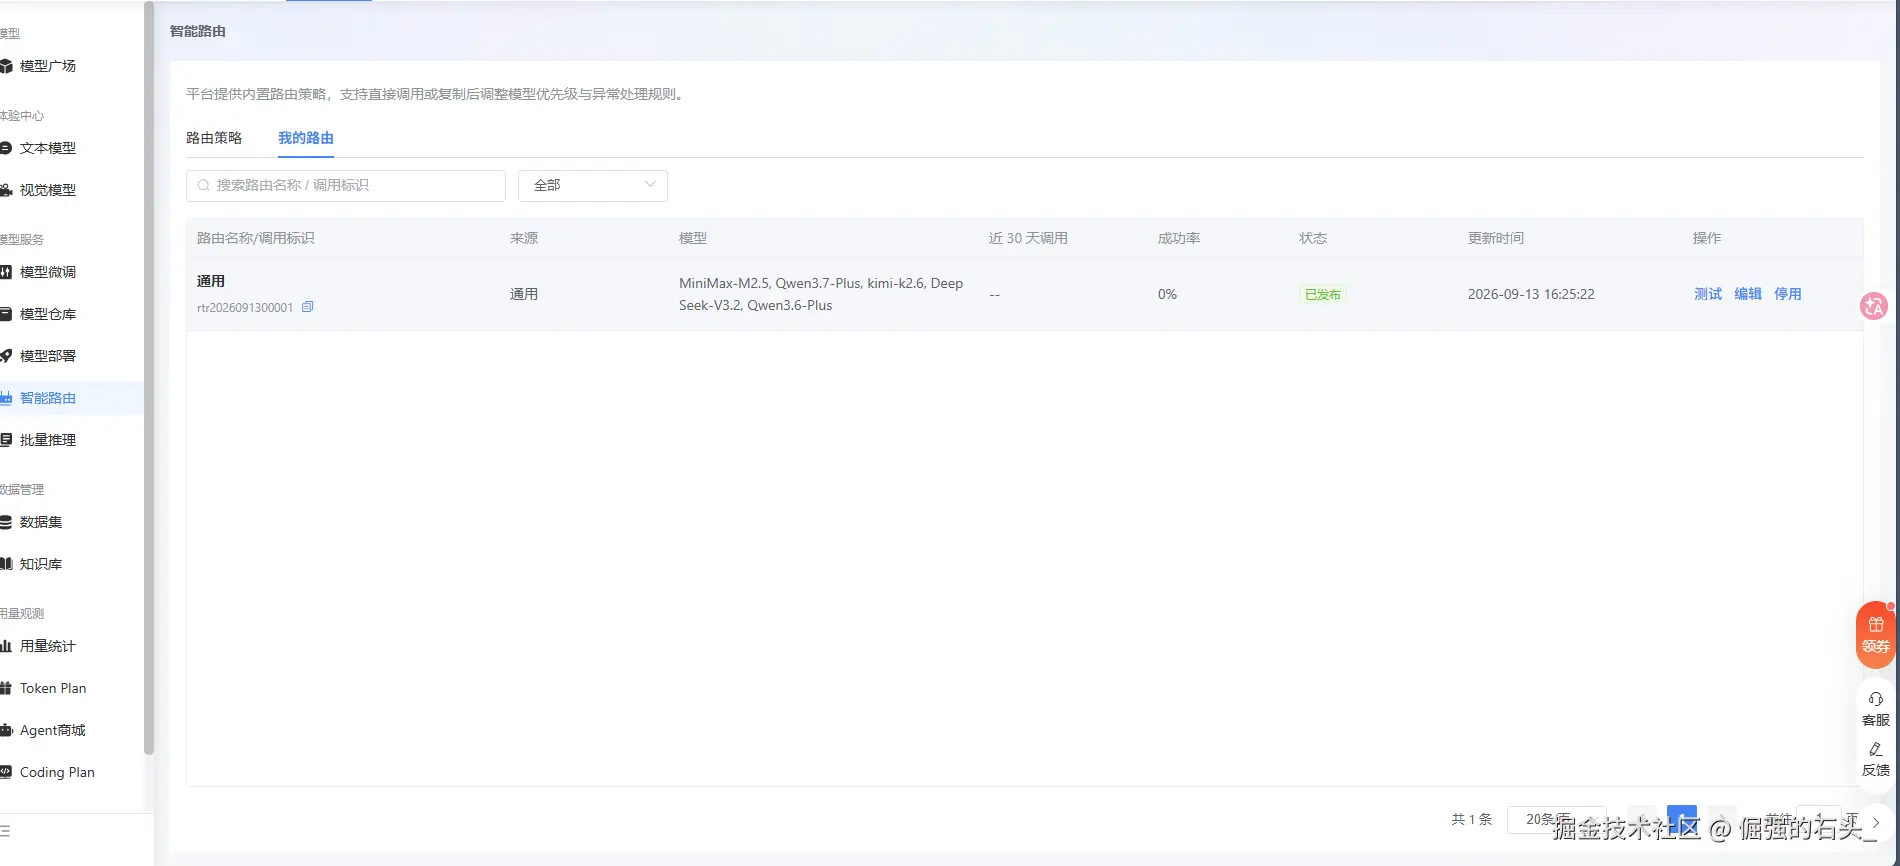
任务集还是那 10 个:从"一句话中译英"到"多约束编码题",5 档难度各 2 个。其中 T01(翻译)和 T07(多约束编码)是刻意安排的对照------一个 hello world 级,一个需要设计稳定排序并附测试用例,前后脚发出去,路由是区别对待还是一视同仁,这一个对照基本决定了全文结论。
三、跑实验与归因
执行脚本很小:OpenAI SDK 逐条调用,temperature=0.2,单次输出上限 500 tokens(控成本),每条记录请求模型、响应中的模型字段 、耗时和 token 用量,结果落盘为 JSON。 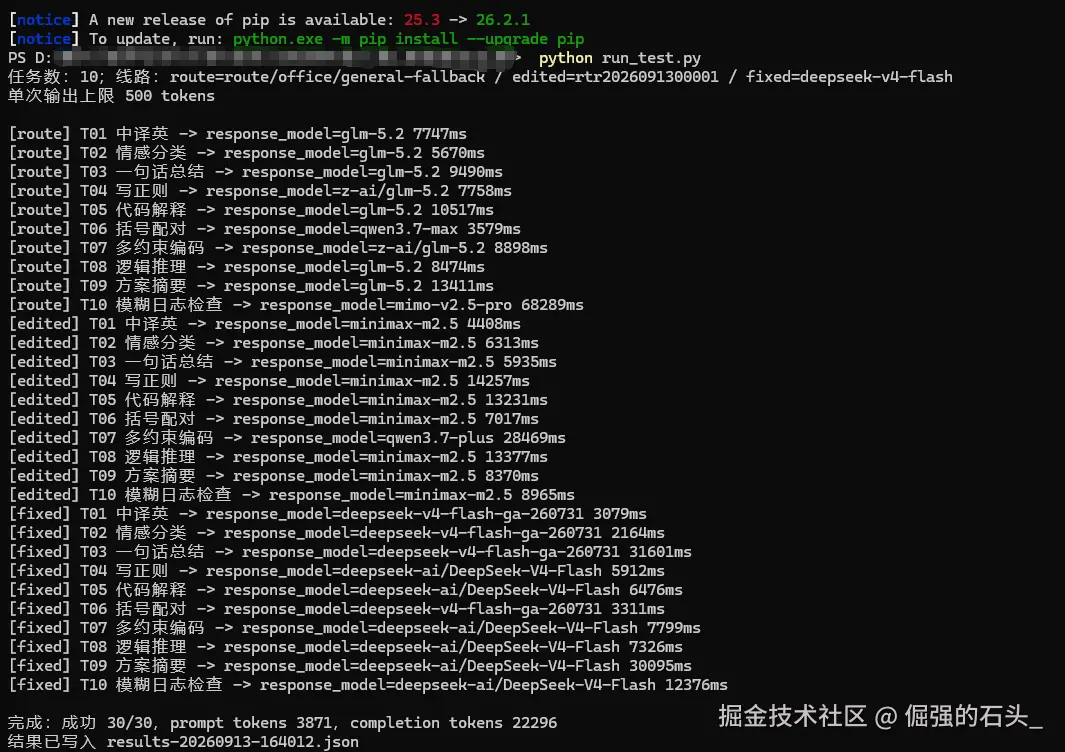
归因比预想顺利:响应里的模型字段直接返回了实际执行模型的真名 (如 glm-5.2、minimax-m2.5、qwen3.7-plus,以及 z-ai/glm-5.2、deepseek-ai/DeepSeek-V4-Flash 这类带供应商前缀的网关署名)------不需要猜测,也不依赖用量统计事后核对。 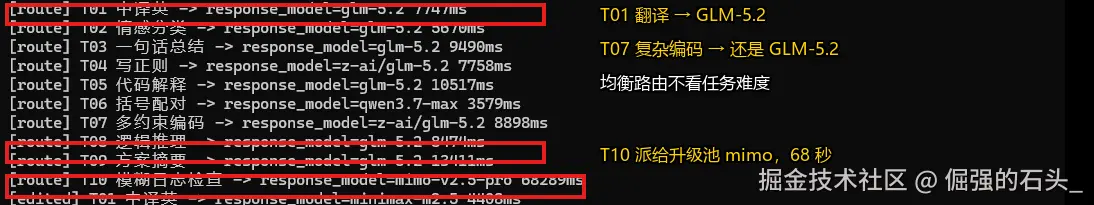
四、结果:四个发现
先把 30 条结果压缩成一张总表(耗时为单次请求耗时,含网络与模型推理;标注"截断"的说明见发现四):
| 任务 | 难度 | 均衡路由 | 成本优先路由 | 固定 deepseek-v4-flash |
|---|---|---|---|---|
| T01 中译英 | 极简 | glm-5.2 · 7.7s | minimax-m2.5 · 4.4s | deepseek-v4-flash · 3.1s |
| T02 情感分类 | 极简 | glm-5.2 · 5.7s | minimax-m2.5 · 6.3s | deepseek-v4-flash · 2.2s |
| T03 一句话总结 | 简单 | glm-5.2 · 9.5s | minimax-m2.5 · 5.9s | deepseek-v4-flash · 31.6s |
| T04 写正则 | 简单 | glm-5.2 · 7.8s(截断) | minimax-m2.5 · 14.3s | deepseek-v4-flash · 5.9s |
| T05 代码解释 | 中等 | glm-5.2 · 10.5s(截断) | minimax-m2.5 · 13.2s | deepseek-v4-flash · 6.5s |
| T06 括号配对 | 中等 | qwen3.7-max · 3.6s | minimax-m2.5 · 7.0s | deepseek-v4-flash · 3.3s |
| T07 多约束编码 | 复杂 | glm-5.2 · 8.9s(截断) | qwen3.7-plus · 28.5s | deepseek-v4-flash · 7.8s(截断) |
| T08 逻辑推理 | 复杂 | glm-5.2 · 8.5s | minimax-m2.5 · 13.4s(截断) | deepseek-v4-flash · 7.3s |
| T09 方案摘要 | 长文本 | glm-5.2 · 13.4s(截断) | minimax-m2.5 · 8.4s | deepseek-v4-flash · 30.1s |
| T10 模糊日志检查 | 边界 | mimo-v2.5-pro · 68.3s | minimax-m2.5 · 9.0s | deepseek-v4-flash · 12.4s(截断) |
发现一:均衡路由"一视同仁",不看任务难度
10 个任务里 8 个被派给了 GLM-5.2------包括 hello world 级的 T01 翻译和最复杂的 T07 多约束编码。我最期待的"T01 与 T07 落差"没有出现 :默认路由并不评估单条请求的难度,它更像"这个场景池的主力是谁,就都用谁"。仅有的两次例外是 T06 派给了 Qwen3.7-Max、T10(无标准答案的模糊日志检查)派给了升级池的 mimo-v2.5-pro------后者提示升级池不是摆设,但派活逻辑整体偏"稳"。
发现二:编辑路由真的改变了派活
同样的 10 个任务,成本优先路由 9 个派给了 MiniMax-M2.5------和均衡路由的 GLM-5.2 完全不同的选择。更有意思的是唯一一次例外:T07 多约束编码被升级到了 Qwen3.7-Plus,跑了 28.5 秒、输出 2208 tokens,交出了带稳定排序说明和 pytest 用例的完整实现。两分钟的编辑,换来的是"日常任务走性价比、复杂任务自动升级"的派活模式 ------这是三条线里唯一观察到"按任务分级"行为的线路。 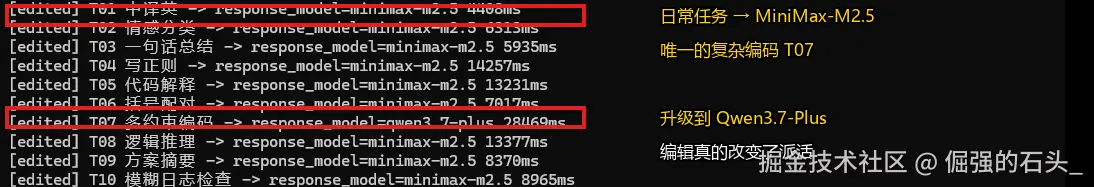
发现三:单价便宜 ≠ 账单便宜
固定 deepseek-v4-flash 线贡献了本次实验最意外的数据。它的单价是三条线里最低的(输入 2 元/输出 8 元每百万 token),但作为一个思考型模型,它在简单任务上的推理开销惊人:T03 一句话总结耗时 31.6 秒、烧掉 5485 个 completion tokens;T09 方案摘要同样 30.1 秒、5050 tokens 。对比之下,均衡路由线 10 个任务的 completion 总量才 3937。 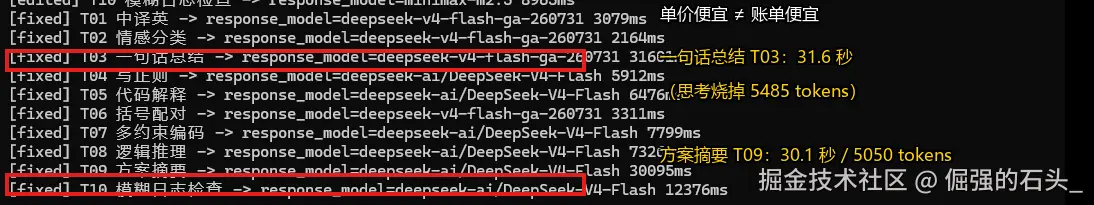
三条线的真实账单(同期用量统计)把这笔账钉死了:
| 线路 | 调用 | prompt tokens | completion tokens | 消费金额 |
|---|---|---|---|---|
| 均衡路由 | 10 | 1,240 | 3,937 | ¥0.10 |
| 成本优先路由 | 10 | 1,032 | 4,981 | ¥0.05 |
| 固定 deepseek-v4-flash | 10 | 1,599 | 13,378 | ¥0.11 |
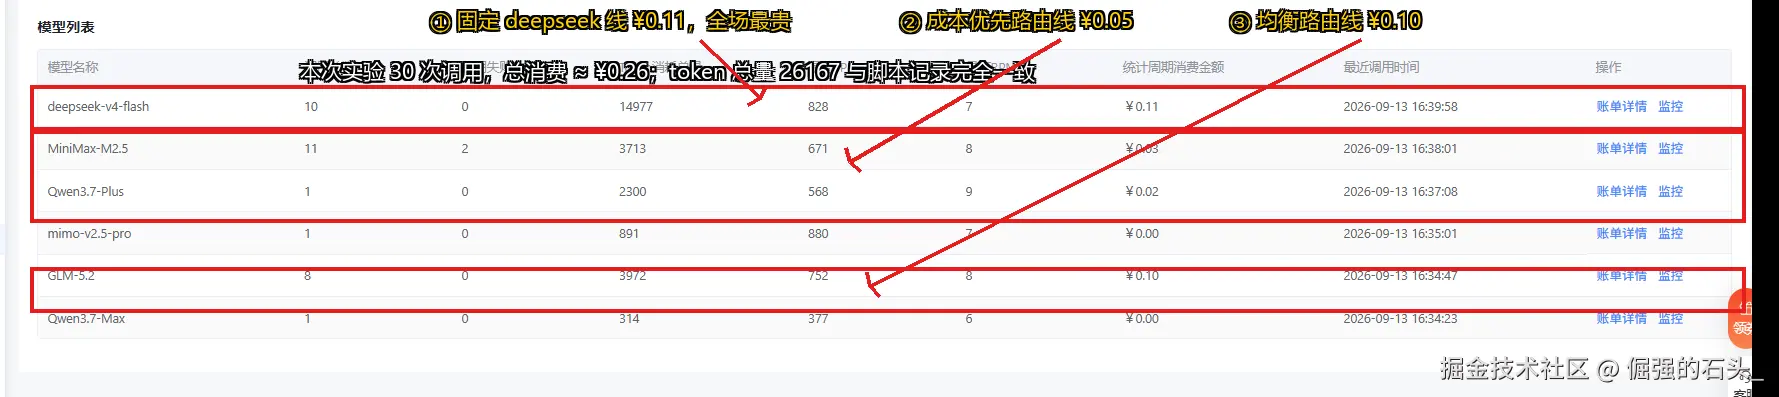 |
整场实验 30 次调用,总消费约 0.26 元;平台侧 token 总量 26,167 与脚本记录完全一致。(一个细节:账单里 MiniMax-M2.5 显示 11 次调用、2 次失败------多出的两次是发布路由后在控制台点"测试"的尝试,与实验无关;成功的 9 次恰好对应实验中派给它的 9 个任务。)
结论就此成型:"最省"从来不是单价的函数,而是单价 × 用量的乘积。一个爱思考的便宜模型,账单反而输给了克制的主力模型;而编辑过的成本优先路由(¥0.05)只有均衡路由(¥0.10)的一半------编辑路由能省钱,不是宣传语,是这次实测出来的数字。
发现四:一个必须交代的实验伪影
细心的读者会注意到表里几处"截断":T04、T07、T09(均衡路由线)等位置的输出为空。这不是路由或模型的故障,而是我为控成本设置的 max_tokens=500 与思考型模型的相互作用------推理先行,预算耗尽,正文一个字都没轮到输出。它对本文结论(派给谁)没有影响,但给所有调用思考型模型的开发者提了个醒:给它们设过小的输出上限,饿死的会是正文而不是思考。若复现本文实验且需要完整输出,建议把上限放到 2000 以上。
五、结论:三条线路各自适合谁
均衡路由(默认策略)适合:不想在选型上花心智的混合办公负载。它的价值是"稳定地用主力模型兜住一切",而不是"按任务省钱"------指望它自动给简单任务降档,实测不支持。
编辑路由值得学:两分钟把池子从旗舰档调到性价比档,实测派活模式真的变了,成本从 ¥0.10 降到 ¥0.05------直接减半,还附赠复杂任务的自动升级。如果你的调用以轻量任务为主,这一步是实打实的省钱动作。
固定便宜模型仍然不可替代 :翻译、分类、摘要、常规编码这些任务上 deepseek-v4-flash 的质量没有掉链子(逻辑推理题也给出了完整正确的推演),核心链路要锁定行为基线时,固定模型依旧是唯一选择------但要留意思考型模型的推理开销,必要时在网关或提示词层面控制它的"思考欲"。
结语
回到标题的两个问题。它把任务派给了谁? ------默认情况下,派给了池子的主力,不管你是翻译还是复杂编码;但花两分钟编辑之后,它真的会按任务分级派活。钱花对了吗?------0.26 元的实验账单给出了答案:省钱的关键变量不是"用不用路由",而是"池子里装了什么"加上"模型爱不爱思考"。
蓝耘把智能路由做得透明的方式值得认可:模型池公开、调用入口与普通模型完全一致、每次派活都能在响应字段里看到实际执行的模型名。"替你选模型"的产品不少,让你能验证它选得对不对的不多。建议照着本文的三线设计把自己的任务分布测一遍------半小时的事,买一个"放心"或者"不放心",都值。