作者:来自 Elastic Peter Simkins
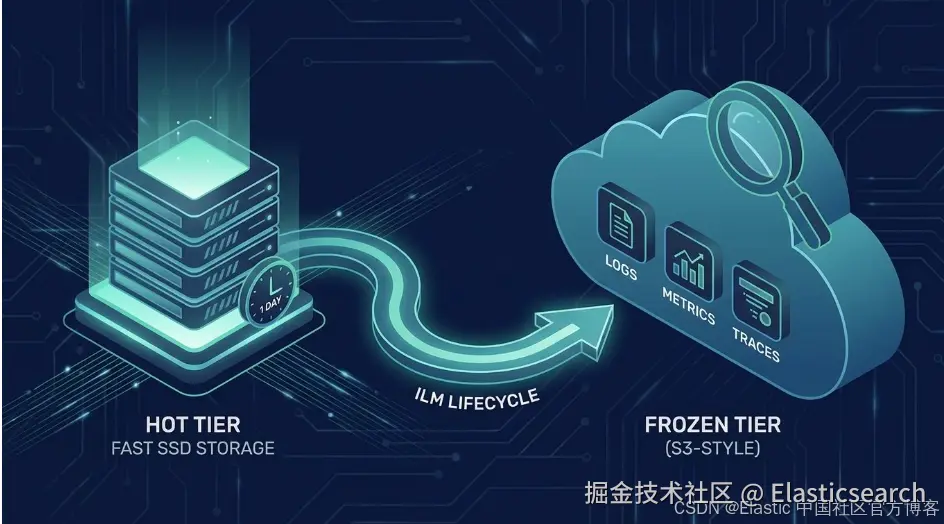
Elastic 对一天的日志在 SSD 上进行了基准测试,并将更早的数据全部移至冻结的可搜索快照中,结果显示,与将所有数据保持在热层相比,成本降低了 16 倍。文章中同时提供了 ILM 策略和成本模型。
Elasticsearch 在数据摄取时会将原始日志转换为结构化、可搜索的数据。按照收集和分析日志教程,可以端到端地了解整个过程。现在可以开始免费云试用,或者在你的本地计算机上试用 Elastic。
多年来,标准的 Elastic 存储方案会让数据依次经过四个层级:热层 、温层 、冷层 和冻结层。每向前一步,都会以性能换取成本。这个模型可以正常工作,但当数据规模达到 PB 级别时,它会增加你并不需要的运维开销。
更简单的路径是热层 → 冻结层:将一天的数据保存在 SSD 上,用于实时故障排查,然后通过 索引生命周期管理(ILM) 将其余所有数据作为存储在 Blob 存储中的可搜索快照移动到冻结层。不需要温层。不需要冷层。冻结索引是部分挂载且只读的。你不会继续向其中写入数据。但你可以在 Kibana 和 ES|QL 中直接搜索这些数据,而不需要先恢复、再查询的 工作流程 。
Elasticsearch 会在数据摄取时动态映射字段,因此在发送日志、指标、追踪数据或安全日志之前,你不需要预先定义严格的模式。同一个两层 ILM 策略可以覆盖这些数据流。当你需要针对每个数据流进行处理、丢弃、聚合、降采样或保留时,可以在此基础上使用 Elastic Streams。有关配套的成本分析,请参阅并非每条日志都值得保留 90 天:Elastic Streams 中的按数据流保留策略。
四个数据层级超出日志存储需求的情况
传统的 Elastic Cloud Hosted 部署通常会采用类似这样的层级结构:
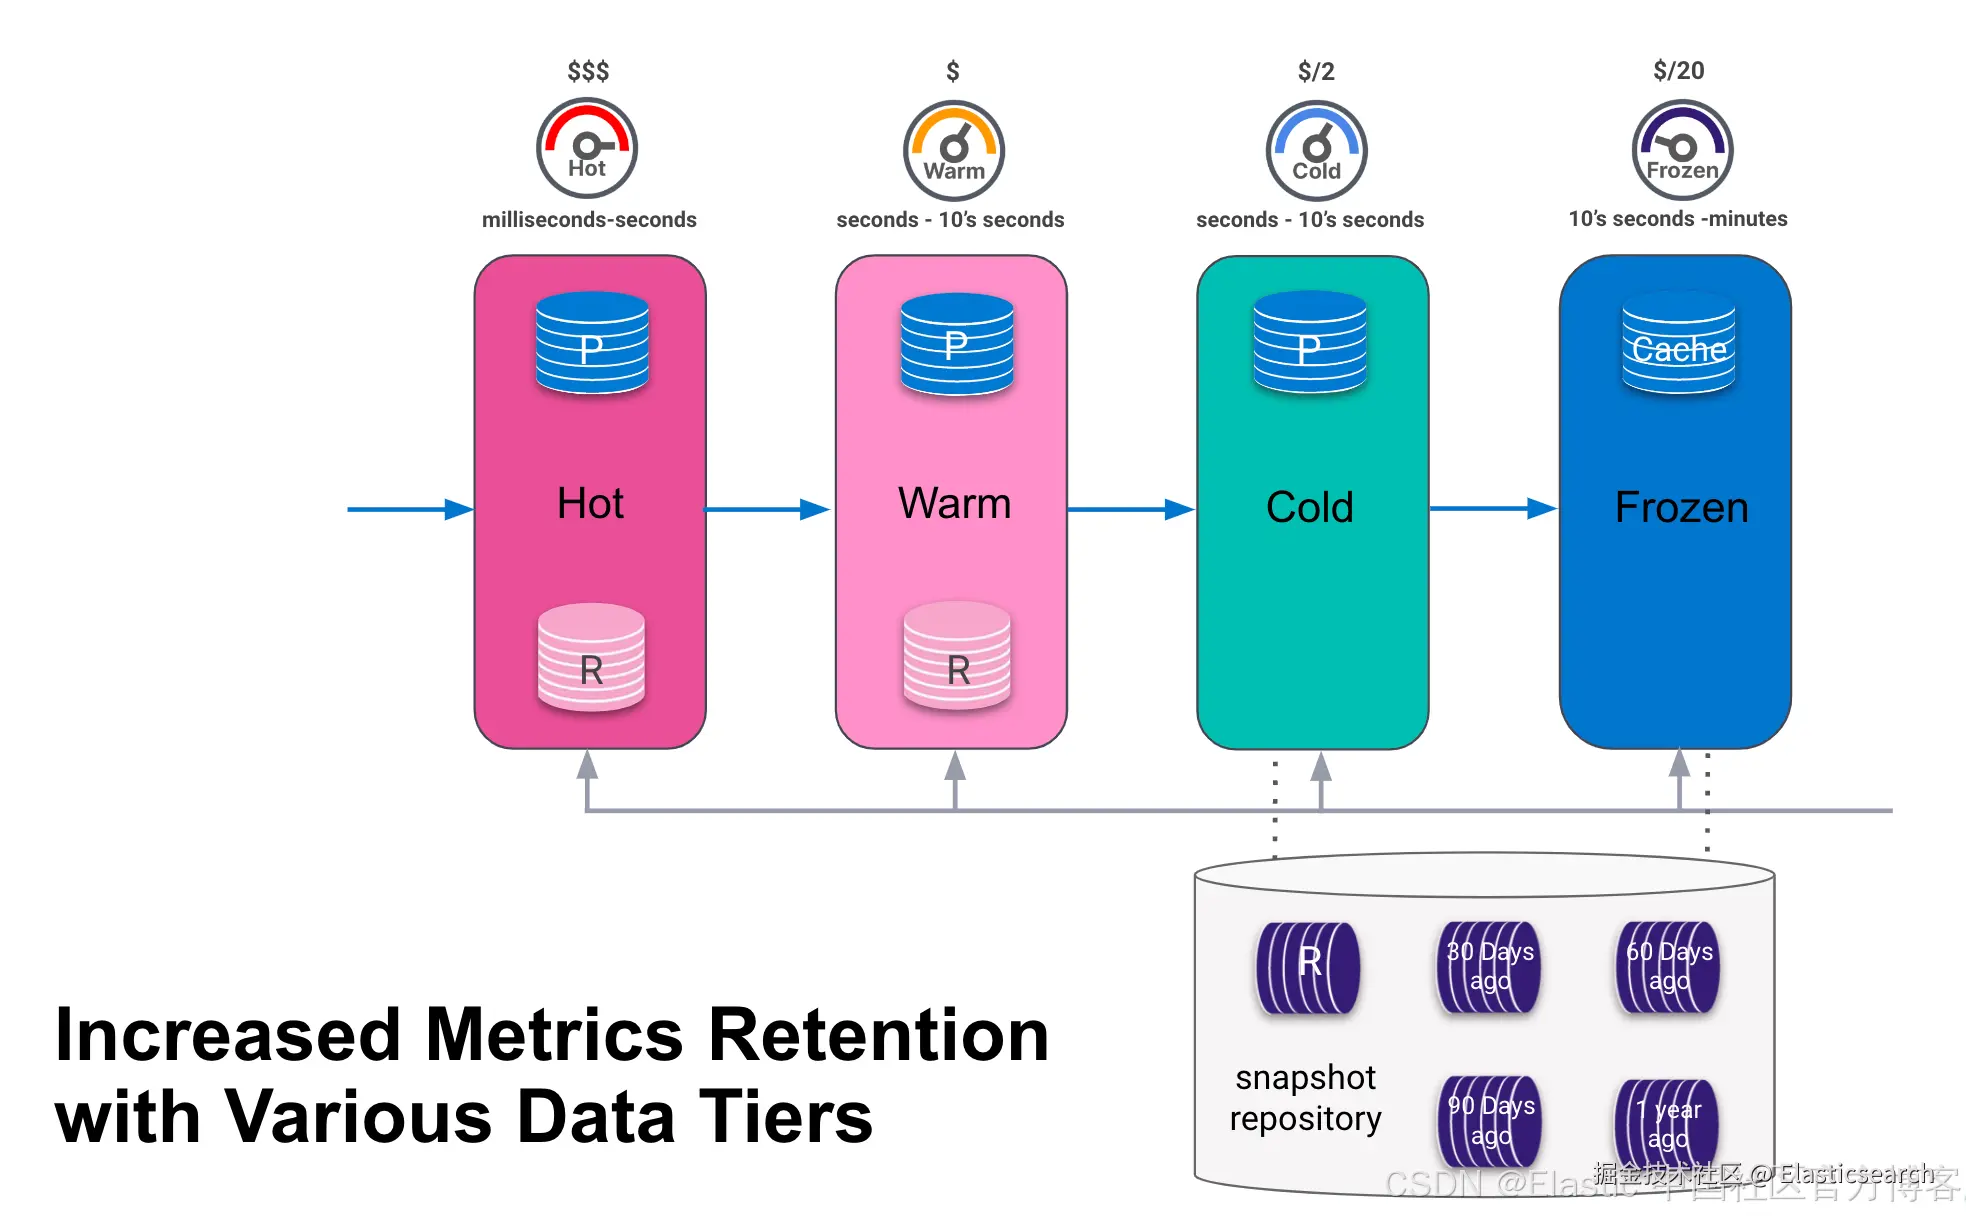
每次转换都需要调整 ILM 策略、根据温层和冷层的硬件配置进行节点规格规划,以及管理不同层级之间的副本。冻结层仍然依赖快照存储库,但在此之前,你还需要经过温层和冷层。
当每天的数据量达到数百 TB 或数 PB 时,这些中间层的运维成本会变得很高,也很难向财务团队解释。你需要为那些已经不再需要秒级延迟查询的数据支付旋转磁盘和副本分片的成本。
热层到冻结层的日志存储如何工作
两层的热层/冻结层架构简化了整个层级结构:
| 阶段 | 存储 | 用途 |
|---|---|---|
| 热层(1天) | SSD,高 IO | 活跃故障事件、告警、SLO 消耗率、持续数据摄取 |
| 冻结层 | Blob 加缓存节点 | 审计、合规、历史搜索(只读的可搜索快照) |
在最初的 24 小时之后,ILM 会将索引转换为存储在 found-snapshots 存储库中的可搜索快照,该存储库由 Elastic Cloud Hosted 针对云对象存储进行配置。数据仍然可以查询。你可以完全省略温层和冷层。
热层到冻结层的模式符合 Elastic 对大型时序 Observability 和 Security 部署的文档说明,这些部署中的数据在摄取后不需要更新。新事件继续写入热层。老化的后备索引则移动到冻结层。
Elastic 在 Elastic Cloud Hosted 上对一种相关的热层/冻结层模式进行了基准测试,涵盖 90 天内的 105 TB 日志。对于大多数任务,冻结层 Discover 查询的 p99.9 延迟保持在个位数秒以内;将一天的数据保留在热层、其余数据保留在冻结层,与仅将完整数据集保留在热节点上相比,成本大约低 16 倍。请参阅可搜索快照性能测试。
Elastic Cloud Hosted 上 PB 级日志存储的成本
下面的数据是基于电信级工作负载模型的示例,仅用于说明,并非 Elastic 的报价或定价承诺。你的成本会因数据摄取量、保留时间、查询模式、云区域、硬件配置和许可层级而有所不同。请使用 Elastic Cloud Hosted 定价 并咨询你的客户团队,以获取针对具体项目的估算。
Elastic Cloud Hosted 的定价与 Serverless 有何不同?
Elastic Cloud Hosted(ECH)主要根据你运行的资源的内存占用量计费:热层和冻结层节点容量(GB RAM-小时),以及快照存储和数据传输。即使采用两层的热层到冻结层 ILM 策略,你仍然需要为执行基于 Blob 数据查询的 Elasticsearch 节点和冻结缓存层确定规格并支付费用。
Elastic Cloud Serverless 根据数据摄取量和存储数据量计费,而不是根据预配置的集群 RAM 计费。这种模式无需进行节点规格规划、容量规划以及大部分 生命周期 管理。你发送多少数据、保留多少数据,就为多少数据付费。
本示例仅针对 ECH 建模。下面的表格不包含 Serverless,因为 Observability Serverless 目前还不支持将老化数据写入 S3 或 Blob 存储,以进行长期冻结保留。当这一能力发布后,Serverless 上相同的热层到 Blob 模式应该能够在保持数据摄取加存储计费模式的同时,进一步减少管理工作。在此之前,对于基于 Blob 的 PB 级审计和合规场景,采用热层到冻结层 ILM 的 ECH 是可行路径。
本示例假设数据在热层保留 1 天,然后通过 ILM 移至 Blob(冻结的可搜索快照)进行长期保留。请将每 PB 的数据视为混合遥测数据的规划基准,而不要认为 1 PB 的原始日志与 1 PB 的原始指标会占用相同的磁盘空间。时序数据流存储指标的效率远高于普通数据流。计算采用已发布的 ECH 容量、快照存储和数据传输费率,并使用 Enterprise 许可。
不使用 Streams 时,每天 1 PB 日志的存储成本
在本示例中,每天摄取 1 PB 数据时,根据 elastic.co/pricing/clo... 公布的费率,ECH 本身的成本按每月 17.8 万美元(每年 214 万美元)计算。
按线性比例扩展:
| 每日数据摄取量 | ECH 每月成本 | ECH 每年成本 |
|---|---|---|
| 1 PB/天 | 17.8 万美元 | 214 万美元 |
| 2 PB/天 | 35.7 万美元 | 428 万美元 |
| 3 PB/天 | 53.5 万美元 | 642 万美元 |
| 4 PB/天 | 71.3 万美元 | 856 万美元 |
| 5 PB/天 | 89.1 万美元 | 1,070 万美元 |
| 6.5 PB/天 | 116 万美元 | 1,390 万美元 |
| 8.45 PB/天 | 151 万美元 | 1,807 万美元 |
即使不进行 Streams 优化,两层模型也针对每天 PB 级的数据规模而设计:较短的热层保留时间、基于 Blob 的冻结层搜索,以及不需要温层或冷层硬件配置。竞争对手的 TCO 取决于数据摄取组成、保留时长,以及其他厂商是否将长期可搜索性按照高价热存储计费。请将已公布的 ECH 费率与你当前获得的报价进行比较,而不要将任何单一百分比视为普遍适用的节省比例。
Elastic Streams 如何将日志保留成本降低 28%
在相同的热层到冻结层 ILM 基础架构之上增加 Elastic Streams 控制功能(丢弃、聚合、降采样、保留),可以使示例中的运行成本降低约 28%:
| 每日数据摄取量 | Streams 优化后每月成本 | Streams 优化后每年成本 |
|---|---|---|
| 1 PB/天 | 12.7 万美元 | 152 万美元 |
| 2 PB/天 | 25.4 万美元 | 304 万美元 |
| 3 PB/天 | 38 万美元 | 456 万美元 |
| 4 PB/天 | 50.7 万美元 | 608 万美元 |
| 5 PB/天 | 63.4 万美元 | 760 万美元 |
| 6.5 PB/天 | 82.4 万美元 | 988 万美元 |
| 8.45 PB/天 | 107 万美元 | 1,285 万美元 |
在每天 5 PB 、同比增长 30% 的情况下,三年的对比如下:
| 年份 | 每日数据量 | ECH 每年成本 | Streams 优化后每年成本 |
|---|---|---|---|
| 第 1 年 | 5 PB/天 | 1,070 万美元 | 760 万美元 |
| 第 2 年 | 6.5 PB/天 | 1,390 万美元 | 988 万美元 |
| 第 3 年 | 8.45 PB/天 | 1,807 万美元 | 1,285 万美元 |
在这个示例中,与仅使用 ECH 相比,采用 Streams 优化后三年可以降低 1,230 万美元。可以将这一差额作为敏感性检查,然后根据遥测数据组成进行调整。TSDS 中的指标、降采样序列和详细日志并不共享同一个存储倍数。
当 Serverless 为 Observability 数据增加 Blob 层保留功能后,可以基于Serverless 定价重新进行这一比较。数据摄取加存储计费,再加上无需进行节点管理,对于大规模长期保留工作负载而言,应该能够让 Serverless 成为更简单的运维选择。
ILM 策略示例:一天热层、冻结层合规保留
在 ECH 上关联一个策略,使数据每天在热层进行滚动,并转换为冻结的可搜索快照。当审计要求在 Blob 中进行无限期保留时,可以省略温层、冷层和删除阶段。
bash
`
1. PUT _ilm/policy/obs-hot-frozen
2. {
3. "policy": {
4. "phases": {
5. "hot": {
6. "min_age": "0ms",
7. "actions": {
8. "rollover": {
9. "max_age": "1d",
10. "max_primary_shard_size": "50gb"
11. }
12. }
13. },
14. "frozen": {
15. "min_age": "1d",
16. "actions": {
17. "searchable_snapshot": {
18. "snapshot_repository": "found-snapshots"
19. }
20. }
21. }
22. }
23. }
24. }
`AI写代码searchable_snapshot 操作在冻结阶段会挂载一个只读、部分挂载的快照(partial-*)。将数据摄取保持在热层。让历史 Discover 和 ES|QL 查询指向冻结层。
通过索引模板、Kibana 索引管理或 Streams 保留选项卡应用该策略。冻结层节点会在本地缓存经常查询的 Blob 区域。首次访问新的时间范围可能会较慢;重复查询会命中缓存,查询延迟会更接近热层。
对于受监管的工作负载,可以将无限期冻结层保留与 Streams AI Partitioning 配合使用,这样合规要求较高的数据流(支付审计、安全事件)可以继承更长的生命周期,而详细的调试数据流则可以在子数据流上使用更短的 DSL 删除策略。
为什么 Elasticsearch 数据层适用于 PB 级日志存储
在托管 Observability 平台中,据我们所知,Elastic Cloud Hosted 是唯一将以下能力结合在一起的选项:
-
PB 级遥测数据摄取,在一个平台上处理日志、指标、追踪数据、安全日志等更多数据。
-
两层 ILM,从热层直接进入冻结层,不需要温层或冷层硬件配置。
-
可搜索快照,直接查询 Blob 存储,无需重新水合步骤。
-
基于公开费率的 TCO 建模 ,你可以在与财务团队沟通之前,根据 ECH 定价进行测算。
竞争性的 Observability SaaS 工具通常会对长期热层保留收取高价,按照遥测数据类型计费,或者将老化数据移至无法使用与实时故障事件相同查询工具进行搜索的归档中。当每天的数据摄取量达到 PB 级别时,这些定价模式会进一步扩大差距。Elastic 将分层能力构建到了搜索引擎本身,因此 Discover、ES|QL 和 APM 视图可以透明地跨热层和冻结层数据工作。
如何为 PB 级日志存储规划热层和冻结层节点
确切的节点数量取决于每日数据摄取量、查询并发量和硬件配置。根据 Elastic 的基准测试,一个实用的初始比例是:
-
热层节点按照一天的数据摄取量以及索引开销余量进行配置。
-
冻结层缓存节点根据并发查询模式进行配置,而不是根据 Blob 总数据量进行配置。
在投入生产之前:
-
测量每日遥测数据摄取量(日志、指标、追踪数据、安全日志)。
-
在具有代表性的数据流上试运行一天热层策略。
-
对冻结层数据运行 Discover 和 ES|QL 查询,以验证缓存配置。
-
应用 Streams 丢弃和分区功能,减少进入热层的数据量。
将告警评估和 SLO 消耗率查询保持在热层。规划故障事件工作流程:先从最近 24 小时开始,然后扩展到冻结层以获取历史上下文。缓存驱逐后首次执行冻结层查询时,可能会出现更高的延迟。
可搜索快照和冻结层需要相应的 Elastic Cloud 功能。在大规模启用冻结层之前,请查看 Elastic Cloud 定价和你的部署层级。
如何将日志保留策略迁移到热层到冻结层
-
用热层到冻结层 ILM 策略替换 Observability 数据流中的温层和冷层阶段。
-
使用公开的 ECH 定价,根据你的数据摄取速率进行 TCO 建模,然后加入 Streams 优化场景。
-
将 OpenTelemetry 遥测数据发送到已配置的数据流,并应用 Streams TCO 控制。
PB 级 Observability 不需要四个存储层,也不需要在成本和可搜索性之间做选择。一天的数据保留在热层,其余所有数据作为冻结的可搜索快照存储在 Blob 中,再加上 Streams 控制:这就是 Elastic Cloud Hosted 如何以财务团队可以接受的 TCO,让完整历史数据保持可查询。
原文:Log storage at petabyte scale: hot to frozen, no warm tier | Elastic Observability Labs