【声明】本博客所有内容均为个人业余时间创作,所述技术案例均来自公开开源项目(如Github,Apache基金会),不涉及任何企业机密或未公开技术,如有侵权请联系删除
标题
233、【AI】【模型部署】基座模型研究:基座与 Instruct 的差别
背景
上篇 blog
【AI】【模型部署】基座模型研究:一次前向、KV cache 与采样
在推理侧做了三个实验:一次前向把 (1,1) 的 token 变成 (1,1,151936) 的 logits(24 层维持 (1,1,896) 同形);KV cache 复用历史 K/V,实测开 6.83s、关 10.91s(慢约 60%);采样用 do_sample/temperature/top_k 控制"稳定 vs 多样"。结构、训练、推理三条线闭环。本篇做最后一个对比实验:把同一系列的两个模型 ------Qwen2.5-0.5B(基座)与 Qwen2.5-0.5B-Instruct(指令版)------放到同一提示下,看"预训练"与"指令微调"到底差在哪
模型部署
前面下载的一直是 -Instruct(对话版)。本篇把不带后缀的基座版也下下来,两个模型用同一个分词器、同一句提示,输出却会完全不同------这正是理解"基座是什么"最直观的一次实验。
🧩 两个模型,一个分词器
Qwen2.5-0.5B 与 Qwen2.5-0.5B-Instruct 共用同一套词表与分词器,参数量也相同(都是 0.494B),差别只在训练阶段:
python
INST = home / "Qwen--Qwen2.5-0.5B-Instruct/snapshots/master"
BASE = home / "Qwen--Qwen2.5-0.5B/snapshots/master"
tok = AutoTokenizer.from_pretrained(INST)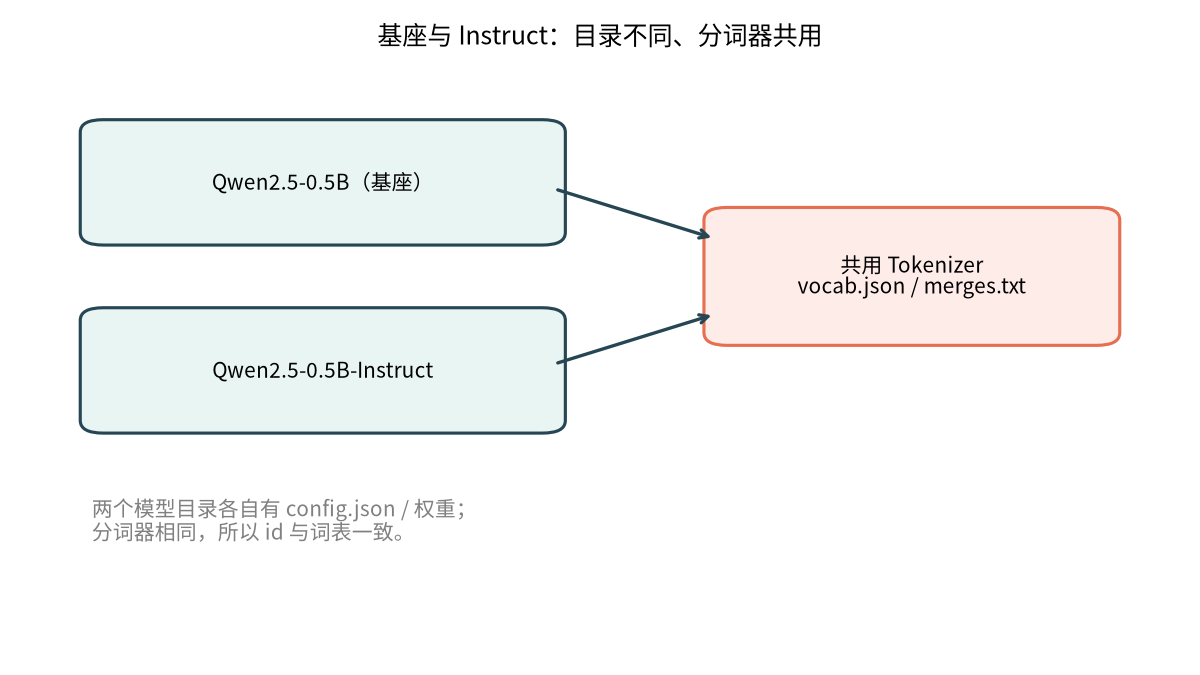
本机内存只有 14GiB,两个 0.5B 模型不能同时常驻(fp32 各约 2GB,加上运行时开销会撑爆),所以实验里"先用基座、释放后再加载 Instruct"------这也顺带印证了模型常驻内存的代价(223 的服务化讨论过)。
🧩 基座版:只会"续写",不会"回答"
基座(Base)是纯预训练产物,训练目标只是"预测下一个 token",所以它的行为是把提示词当成文章开头继续写下去(实测):
python
ids = tok(prompt, return_tensors="pt")["input_ids"]
o = base.generate(ids, max_new_tokens=48, do_sample=False)
print(tok.decode(o[0], skip_special_tokens=True))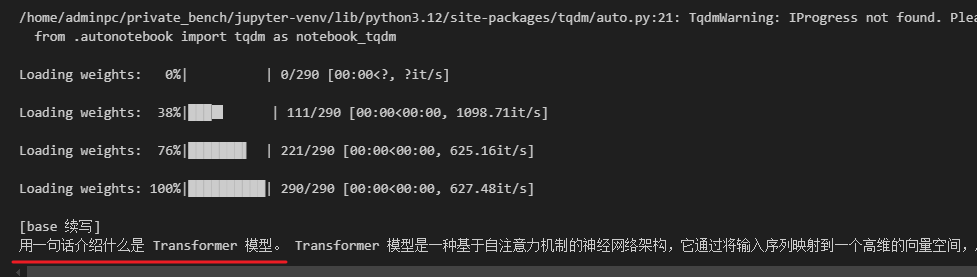
实测输出:
text
用一句话介绍什么是 Transformer 模型。 Transformer 模型是一种基于自注意力机制的
神经网络架构,它通过将输入序列映射到一个高维的向量空间,从而能够捕捉到序列中的
上下文信息。这种架构特别适用于自然语言处理任务注意开头:它把提问原样复述了一遍,然后接着往下写------因为在预训练语料里,"用一句话介绍什么是 Transformer 模型。"更可能出现在文章中间,后面本来就该跟着正文。基座没有"该轮到助手作答"的概念。
🧩 Instruct 版:听得懂"指令"
-Instruct 版在基座之上做了指令微调(SFT,Supervised Fine-Tuning,监督微调):用大量"指令 → 回答"数据训练,让它学会按对话格式回应。同样的提示,输出是直接给答案(实测):
python
msg = [{"role": "user", "content": prompt}]
inp = tok.apply_chat_template(msg, add_generation_prompt=True, tokenize=True, return_tensors="pt", return_dict=True)
o = inst.generate(**inp, max_new_tokens=48, do_sample=False)
print(tok.decode(o[0][inp["input_ids"].shape[1]:], skip_special_tokens=True))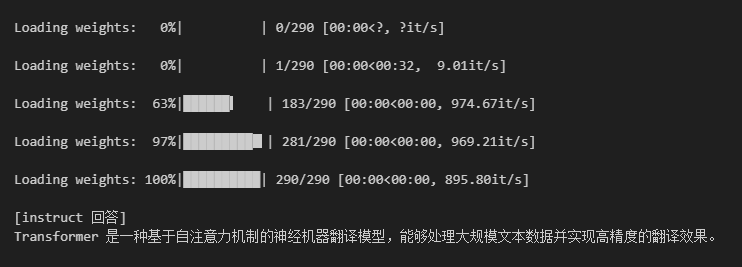
实测输出:
text
Transformer 是一种基于自注意力机制的神经机器翻译模型,能够处理大规模文本数据
并实现高精度的翻译效果。关键差别:没有复述问题,直接作答 。
apply_chat_template给输入套上了对话格式(<|im_start|>user ... <|im_end|>),模型在这种格式下被训练成"轮到 assistant 说话"。
🧩 换个提示再验证一次
再用"什么是机器学习?"测一遍(实测):
| 模型 | 输出(节选) |
|---|---|
| 基座 | "什么是机器学习?它有哪些应用领域? 机器学习是一种人工智能技术..." |
| Instruct | "机器学习是一种人工智能的分支,它使计算机能够通过数据自动改进和优化其性能..." |
基座版又把问题复述一遍、还反问一句 (像在续写一篇 FAQ 文章),Instruct 版直接给定义------两次实验结论一致:差别来自训练阶段,不是参数。
📊 同一个基座,两种行为
| 维度 | 基座 Qwen2.5-0.5B |
指令版 -Instruct |
|---|---|---|
| 训练目标 | 预测下一个 token | 先预训练,再指令微调 |
| 对提示的反应 | 当作文章开头续写 | 当作问题来回答 |
| 输入格式 | 原始文本 | 对话模板(带角色标记) |
| 典型用途 | 作为微调的起点 | 直接对话/助手 |
这也解释了前面几篇的一个现象:221 里如果没加
add_generation_prompt=True,模型会自己回显user角色标记------因为对话格式是 Instruct 版才"认得"的约定。
🧩 对话模板:Instruct 的"暗号"
Instruct 版能"听懂",靠的是输入被套上了训练时见过的格式。apply_chat_template 生成的文本大致长这样:
text
<|im_start|>system
You are Qwen...<|im_end|>
<|im_start|>user
什么是机器学习?<|im_end|>
<|im_start|>assistant
<|im_start|> / <|im_end|> 就是 225 里那些特殊 token。模型看到"assistant 开头",就知道该自己接着说了------这也是 221 里不加 add_generation_prompt=True 会回显 user 的原因。
🧩 SFT 用的数据长什么样
指令微调的数据是"指令 → 回答"对,比如 {"instruction": "用一句话解释...", "response": "..."},训练时把 response 当作要预测的目标,损失函数仍是 next-token 交叉熵------目标没变,变的是数据形态:预训练喂文章,SFT 喂问答。
| 阶段 | 数据 | 学到的行为 |
|---|---|---|
| 预训练 | 海量原文 | 语言与知识(会续写) |
| SFT | 指令-回答对 | 听懂指令(会对话) |
| 对齐 | 人类偏好 | 更符合期望(安全、有用) |
所以"基座是地基、Instruct 是精装修":能力上限由预训练决定,后两步只改变"怎么用这些能力"。
🧩 回到"研究基座"这条线
把 224 到本篇连起来看:config.json 定义结构 → 分词器把文字变 id → 嵌入层变向量 → 24 层(RMSNorm/RoPE/GQA/SwiGLU)做变换 → LM 头出 logits;训练用"预测下一个 token"把随机权重变成基座;指令微调再把它变成助手。基座是这一切的地基,Instruct 只是在地基上加的一层"行为规范"。
📌 一句话记忆
基座与 Instruct 共用分词器和 0.494B 参数,差别只在训练阶段:基座只做 next-token 预测,把提示当文章开头续写 (实测会把问题原样复述再往下写);Instruct 经过指令微调,用对话模板把提示当问题回答(直接给答案);想研究"模型本身"就看基座,想直接当助手用就取 Instruct------下一篇收尾讲预训练到底在做什么。
OK,本篇先到这里,如有疑问,欢迎评论区留言讨论,祝各位功力大涨,技术更上一层楼!!!更多内容见下篇 blog