一、LangGraph图
LangGraph 的图,本质上是一个有向图:节点是"处理单元",边是"数据流向"。数据在节点之间流动,每个节点对数据做一次加工。
和普通流程图不同的是:LangGraph 的图共享一个全局状态(State),每个节点读取它、修改它,而不是把数据从一个节点"传给"下一个节点。
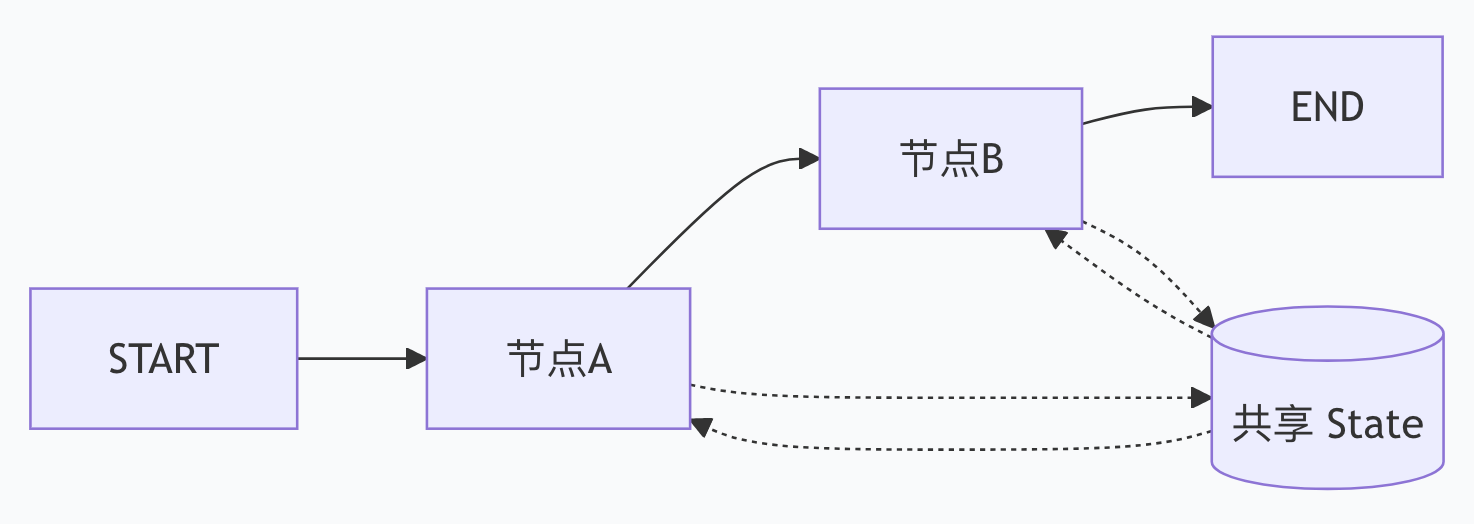
这个设计是 LangGraph 的核心:节点之间不直接通信,所有数据都通过 State 中转。
二、State:图的"共享容器"
State 是贯穿整个图的数据容器。它通常用 TypedDict 定义。
from typing import TypedDict, Annotated
from operator import add

class MyState(TypedDict):
    messages: Annotated[list, add]  # 追加式更新
    count: int                       # 覆盖式更新
    result: str
1. 普通字段 vs Annotated 字段
| 写法 | 更新行为 |
|---|---|
count: int |
节点返回的新值直接覆盖旧值 |
messages: Annotated[list, add] |
节点返回的新值追加到旧值后面 |
def node_a(state):
    return {"count": 10}   # count 被覆盖为 10

def node_b(state):
    return {"messages": ["新消息"]}  # 追加到 messages 列表
为什么需要 add? 因为对话消息需要累积,而不是每次覆盖。如果 messages 是普通字段,第二个节点返回的消息会把第一个节点返回的消息冲掉。
2. 常用的 reducer
| reducer | 作用 |
|---|---|
add |
追加(列表相加、数字相加) |
operator.or_ |
字典合并 |
| 自定义函数 | 任意逻辑 |
def merge_dict(left: dict, right: dict) -> dict:
    return {**left, **right}

class MyState(TypedDict):
    data: Annotated[dict, merge_dict]
3. 状态更新的本质
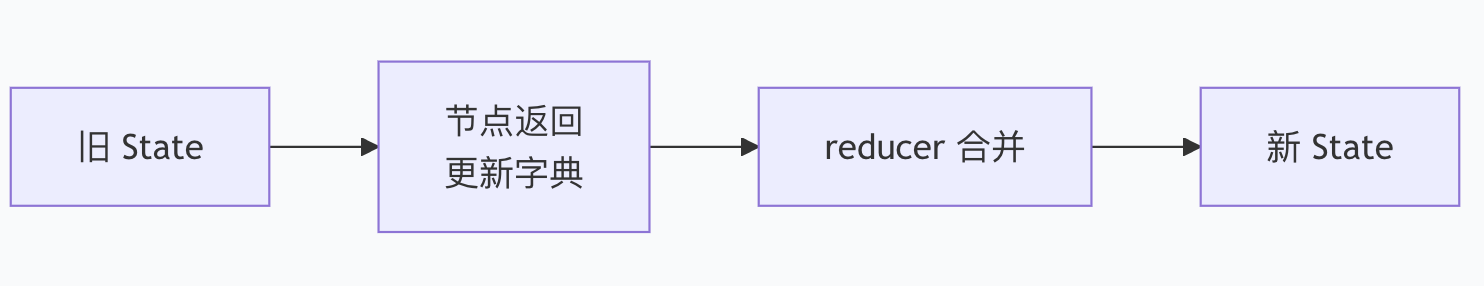
每个节点返回的字典,会经过 reducer 处理后,合并回全局 State。
三、Node:图的"处理单元"
节点就是一个普通的 Python 函数,接收 State,返回更新字典。
def my_node(state: MyState) -> dict:
    # 读取 state
    current_count = state["count"]
    # 返回更新
    return {"count": current_count + 1}
1. 节点的形参规则
LangGraph 会根据函数的参数名来决定传入什么:
| 形参名 | 传入内容 |
|---|---|
state |
全局状态 |
config |
运行配置(如 thread_id) |
runtime |
运行时上下文(LangGraph 1.0+) |
def my_node(state: MyState, config: RunnableConfig, runtime: Runtime):
    ...
顺序必须固定 :state, config, runtime,且参数名不能改。
2. 节点的返回值
节点必须返回一个字典 ,表示对 State 的更新。返回空字典 {} 表示不更新。
def no_change(state) -> dict:
    return {}
3. 节点可以有异步版本
async def my_async_node(state: MyState) -> dict:
    result = await some_async_call()
    return {"result": result}
四、Edge:图的"连接线"
边定义了节点之间的执行顺序。
1. 入口和出口
from langgraph.graph import START, END

builder.add_edge(START, "first_node")   # 入口
builder.add_edge("last_node", END)      # 出口
2. 普通边
固定跳转,从 A 到 B。
builder.add_edge("node_a", "node_b")3. 设置入口点的两种方式
# 方式一:用 START
builder.add_edge(START, "first_node")

# 方式二:用 set_entry_point
builder.set_entry_point("first_node")
两种写法等价。
五、示例
from typing import TypedDict, Annotated
from operator import add
from langgraph.graph import StateGraph, START, END

# 1. 定义 State
class MyState(TypedDict):
    messages: Annotated[list, add]
    count: int

# 2. 定义节点
def node_a(state: MyState) -> dict:
    print(f"节点A收到 count={state['count']}")
    return {"count": state["count"] + 1, "messages": ["A执行了"]}

def node_b(state: MyState) -> dict:
    print(f"节点B收到 count={state['count']}")
    return {"count": state["count"] + 10, "messages": ["B执行了"]}

# 3. 构建图
builder = StateGraph(MyState)
builder.add_node("node_a", node_a)
builder.add_node("node_b", node_b)
builder.add_edge(START, "node_a")
builder.add_edge("node_a", "node_b")
builder.add_edge("node_b", END)

# 4. 编译并运行
graph = builder.compile()
result = graph.invoke({"count": 0, "messages": []})
print(result)输出:
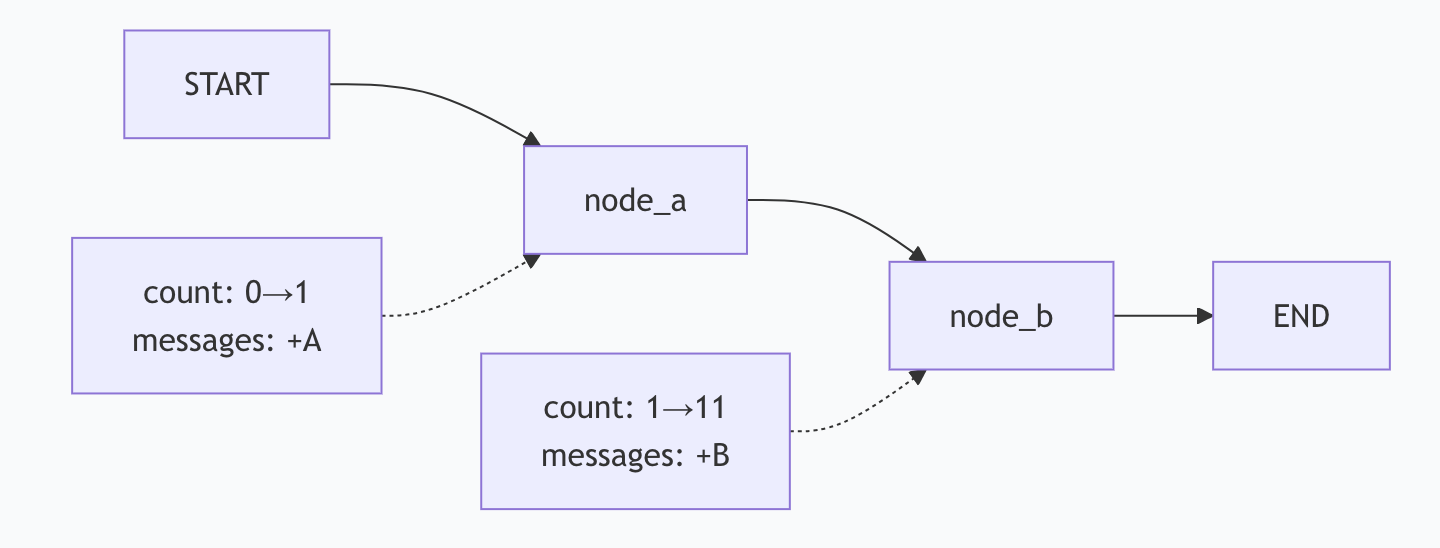
节点A收到 count=0
节点B收到 count=1
{'count': 11, 'messages': ['A执行了', 'B执行了']}执行过程:
-
初始 State:
{count: 0, messages: []} -
节点A执行:count 变成 1,messages 追加
"A执行了" -
节点B执行:count 变成 11(1+10),messages 追加
"B执行了" -
到达 END,返回最终 State
State 的关键理解
-
State 是全局的:所有节点共享同一份 State,不是节点之间互相传参。
-
更新是增量的:节点只返回需要变更的字段,不需要返回完整 State。
-
合并靠 reducer :普通字段覆盖,
Annotated字段按 reducer 逻辑合并。