今年openai和anthropic两家公司轮番更新模型,两家各有一系列的便宜模型和贵模型,其差别到底在哪里?
💰 先看硬数据:Fable 5 到底比 Sonnet 5 强多少
第三方评测机构FACTA做了一份相当扎实的横向对比,把两者摆在同一张表里。
| 测试项目 | Claude Fable 5 | Claude Sonnet 5 | Opus 4.8(参考) |
|---|---|---|---|
| SWE-bench Verified | 95.0% | 未公布 | 88.6% |
| SWE-bench Pro(真实GitHub issue端到端) | 80.3% | 63.2% | 69.2% |
| Every Senior Engineer测试(满分100) | 91 | 未公布 | 63 |
| Terminal-Bench 2.1 | 80.5% | 未公布 | 74.6% |
| 输入/输出定价(每百万token,早鸟价) | 10/50 | 2/10 | --- |
这张表里最关键的一行是SWE-bench Pro。这个测试的规则很朴素------让模型去读一个真实的GitHub仓库,写一个修复补丁,补丁跑隐藏测试用例,通过就是通过,不通过就是不通过,没有中间分。Fable 5拿到80.3%,Sonnet 5是63.2%,17个百分点的差距意味着什么呢------在一个复杂的多文件bug修复任务上,Sonnet 5大概每三次尝试就要失败一次,而Fable 5的失败率明显更低。
价格差距看起来是5倍( 10/50对 2/10),但FACTA的分析指出这个倍数其实被低估了。Fable 5的深度思考模式是常开的,关不掉,这意味着它在处理任何非琐碎任务时都会多吐出一大截思考token和输出token,而输出token恰好是计费最贵的那一档($50/M)。Sonnet 5虽然默认也开思考,但可以用effort参数调低甚至关闭。结果就是------账单上的真实差距往往比5倍的标价还要大。
不过FACTA给出的结论其实相当克制,不是无脑推荐贵的。他们建议的路由策略是------日常分类、摘要、代码重构这类工作交给Sonnet 5,只有前沿级的高风险代码任务(补丁写错代价很高的场景)才值得掏钱上Fable 5,多数团队应该两个都配,按任务分流,而不是非此即彼。
📊 第三方评分体系怎么看这两个模型
DocsBot这个模型对比站给出了另一个视角------Artificial Analysis Intelligence Index(一个综合多项基准做出的智力指数)里,Claude Sonnet 5的得分是53.4,而Fable 5.1这一项没有被收录进榜单 。这个细节挺有意思,说明并不是所有贵模型都会去跑遍所有第三方榜单,一部分厂商的旗舰模型走的是限量发布、按场景开放的路线,根本不追求在公开榜单上刷分。
DocsBot的资料还提到一个容易被忽略的技术细节------Sonnet 5用的是更新过的分词器(tokenizer),同样一段文字会被切分成更多token,英文大概多算1.4倍,西班牙语多算1.33倍,但中文基本没受影响。这个变化听起来技术性很强,但直接关系到你的账单------如果计费是按token数算的,分词器一变,同样的内容账单可能就悄悄涨了。
🗣️ 真实用户怎么说:Reddit上的一线反馈
跑分数字固然重要,但真正用这些模型写代码、跑agent的开发者的吐槽,往往比官方数据更接近真相。这次翻了OpenAI Codex社区(r/codex)的几个热门讨论,挑出两条很有代表性的声音。
第一条来自一个每天跑多个并行编程会话的开发者,他的原话大意是------"我感觉Luna已经强到能覆盖我99%的编程需求了,Sol我只在做代码审查、调研和真正的长周期规划时才会用。" 更实际的是他给出的成本数字------从每天20到50美元的token开销,切换到主要用Luna之后,直接降到每天2到3美元。这条反馈几乎是把上面Fable/Sonnet那套便宜模型覆盖大部分场景的逻辑,原封不动地搬到了GPT-6这条产品线上。
第二条讨论更有意思,是关于GPT-6发布后一场关于跑分意义的争论。有人吐槽说GPT-6的跑分看起来是个disappointment,结果评论区炸出一堆不同意见。有人指出GPT-6在ARC-3这个高难度推理测试上从7%直接跳到99%,在exploitbench上拿到100%,还在攻克一些人类此前没能解决的数学问题。但更冷静的声音也不少------有人提出benchmark测试就像标准化考试衡量教育质量一样,存在天然的过拟合风险,厂商完全可能针对已知题库去优化模型表现。还有个特别精准的类比,拿三星和苹果打比方------三星手机参数表上几乎全面碾压苹果,但很多用户依然觉得iPhone体验更顺手,纸面数据和真实体感之间永远存在一道鸿沟。
这场讨论里还有一条评论值得单独拎出来------有人提到当GPT-6发布逼近Fable的跑分成绩时,即便分数差距很小,GPT-6在成本上却比Fable便宜出一大截,这意味着运行速度更快、单位成本更低,这才是真正决定日常可用性的关键变量,而不是榜单上那零点几个百分点的差距。
🧩 综合下来,价格差异的三层真相
把这几轮搜集到的证据拼在一起,价格差异背后的逻辑可以归纳成三层,一层比一层贴近真实决策。
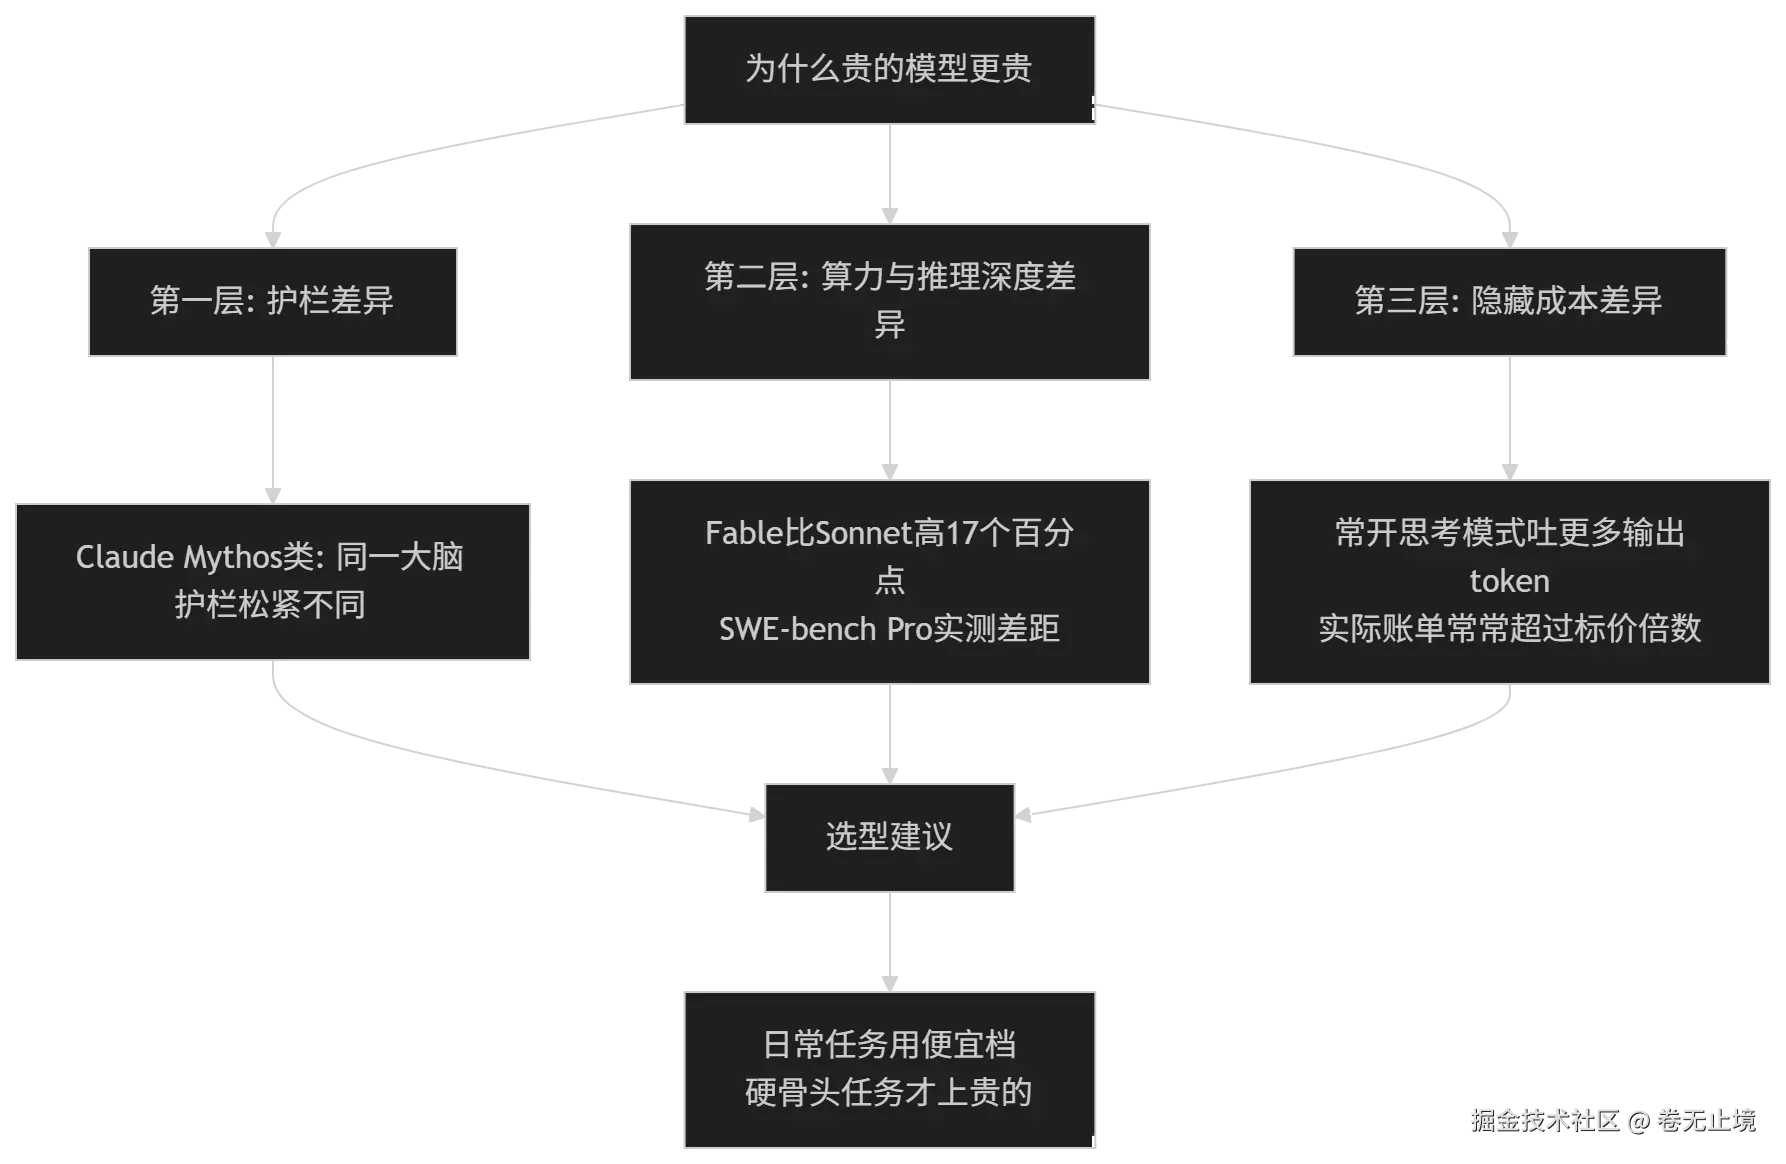
第一层是护栏差异 ------像Claude Mythos系列这种情况,模型底层能力其实一样,贵的版本只是把某些安全限制解除了,买的是权限 不是智商,这一点在第一版报告里已经讲过。
第二层是真实的能力差异------Fable 5和Sonnet 5这对组合就是活生生的例子,17个百分点的SWE-bench Pro差距不是噪音,是能实打实转化成任务成功率的硬指标。
第三层最容易被忽视,却往往是账单上最大的坑------常开的深度思考模式会让贵模型的输出token量悄悄膨胀,标价上的5倍差距,落到实际账单上可能变成6倍、7倍甚至更多。这也解释了为什么Reddit上那位开发者的日均开销能从50美元砍到3美元------他不只是换了个便宜的模型,更是绕开了那个会不断膨胀输出量的贵模型。
💡 写在最后
在Claude这条线上,Fable确实比Sonnet强,强得有理有据,17个百分点的SWE-bench Pro差距摆在那里没法否认,但账单上的真实倍数往往比标价还狰狞,因为它的思考模式关不掉。而在GPT这条线上,一线开发者的真实用量数据讲了一个更朴实的故事------大多数人的日常工作根本用不上顶配模型的全部实力,把便宜模型用好、把贵模型留给真正的硬骨头任务,才是把钱花在刀刃上的正确姿势。
参考资料
CometAPI, Claude Mythos 5.1 vs Fable 5.1: Performance, Access, and Pricing Comparison DocsBot AI, Claude Fable 5 vs Claude Mythos 5 Miraiyo, What is Claude Fable 5 and Mythos 5? Investing.com (South Africa), Anthropic launches Claude Fable 5 model with new safety features TradingView (FR), OpenAI expands GPT-6 universe with GPT-6 Sol and GPT-6 Luna StreetInsider, OpenAI expands GPT-6 lineup with cheaper Sol and Luna models LinkedIn / Tech Enquirer, OpenAI Releases GPT-6 Sol and Luna for Complex Tasks OpenAI Developer Community, GPT-5.6 Sol vs Terra: what are you seeing in real-world development? FACTA, Claude Fable 5 vs Sonnet 5 (2026): 5x Pricier, When It Pays DocsBot AI, Claude Sonnet 5 vs Claude Fable 5.1 - Detailed Performance & Feature Comparison Reddit r/codex, I would take a cheaper faster luna over stronger models Reddit r/codex, Looking at all the benchmarks, I have to say 6 looks like a big disappointment