在这个钱多圈子摸爬滚打这么久,我见过一种极其普遍的前端工程师画像👇:
他的 React 写得很溜,组件抽象能力极强,CSS 布局信手拈来。但每次和后端联调 API 时,后端说这个接口只能这么设计 ,他就沉默了。后端说这个字段加不了 ,他也沉默了。后端说分页只能用 offset,他依然沉默了。
不是因为他性格软弱,而是因为他根本不知道对方在说什么,更不知道对方说的到底对不对。
一个不懂数据库的前端,在技术讨论中永远是被动的接收者。后端丢过来什么数据结构,他就用什么;后端说做不到的需求,他就乖乖去和产品经理说做不了。他从来没有能力提出:你这个 API 设计有问题,换一种查询方式,前后端的成本都能降一半🤔。
而 2026 年的技术趋势------Next.js 的 Server Actions、Cloudflare D1、Supabase、Drizzle ORM------正在把前端和数据库之间的最后一堵墙彻底推倒。如果你还在觉得数据库是后端的事,你正在被时代甩开。
你以为的 API 问题,其实是数据库查询问题🤷♂️
先讲一个极其真实的场景。
你在做一个商品列表页,产品经理要求支持按价格排序、按销量排序、按上架时间排序,同时还要支持按分类筛选和关键词搜索。
后端给你的接口大概长这样:
sql
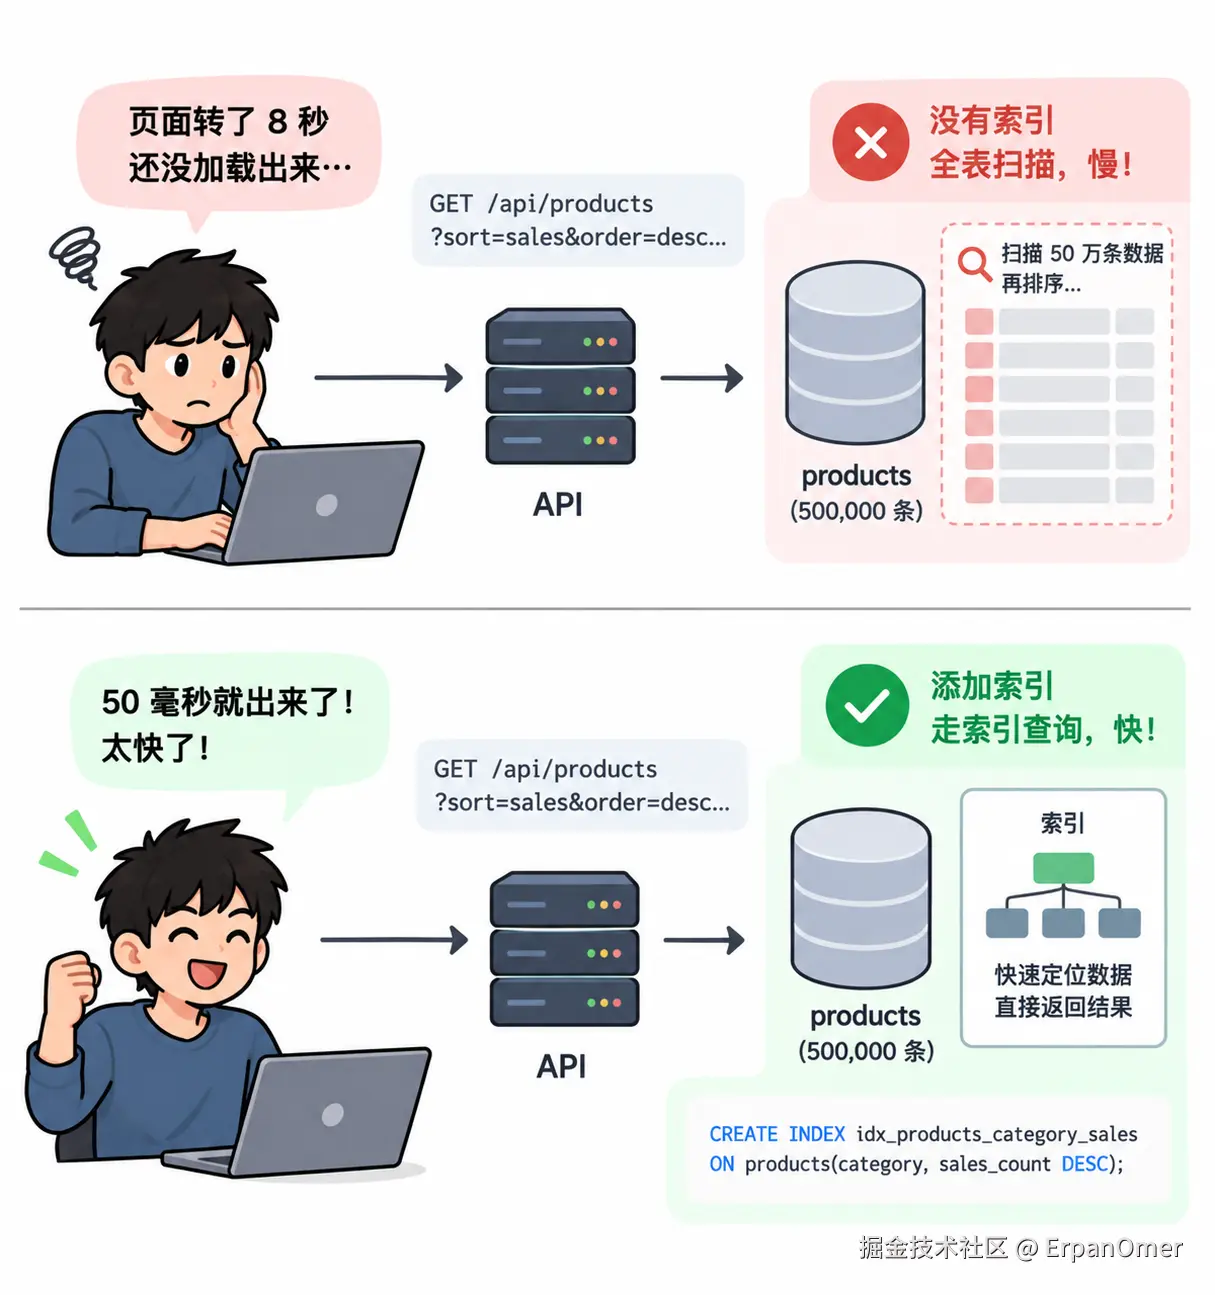
GET /api/products?sort=price&order=desc&category=electronics&keyword=手机&page=2&pageSize=20你写完前端代码,测试环境一切正常。上线后,当商品表里有 50 万条数据时,用户反馈:按销量排序的时候,页面要转 8 秒的圈。
你去找后端,后端告诉你:数据库查询太慢了,我也没办法。😖
如果你不懂数据库,这个对话就到此为止了。你只能告诉产品经理技术限制,做不了🫡。
但如果你懂一点数据库,你会知道这 8 秒的延迟,大概率是因为 sales_count 这个字段上没有建索引。数据库在没有索引的字段上做排序,必须把 50 万条记录全部扫一遍(全表扫描),然后在内存里排序,再取出第 21 到第 40 条。这个操作的时间复杂度是灾难性的。
你甚至可以直接建议后端:
sql
-- 这条索引能让按销量倒序 + 按分类筛选的查询,从全表扫描变成索引命中
CREATE INDEX idx_products_category_sales
ON products(category, sales_count DESC);
一条索引,查询从 8 秒降到 50 毫秒。
你不需要精通 SQL 调优,但你需要知道排序慢的本质大概率是索引缺失。 这一个认知,就够你在和后端的沟通中,从被动变为主动🫵。
你设计的 UI 交互,可能在后端引发一场灾难
前端很多看起来极其自然的交互设计,如果不理解背后的数据库成本,会在不知不觉中把后端推进深渊。
无限滚动的分页陷阱
你的无限滚动列表用的是 offset 分页:
bash
第 1 页:GET /api/posts?offset=0&limit=20
第 2 页:GET /api/posts?offset=20&limit=20
第 50 页:GET /api/posts?offset=980&limit=20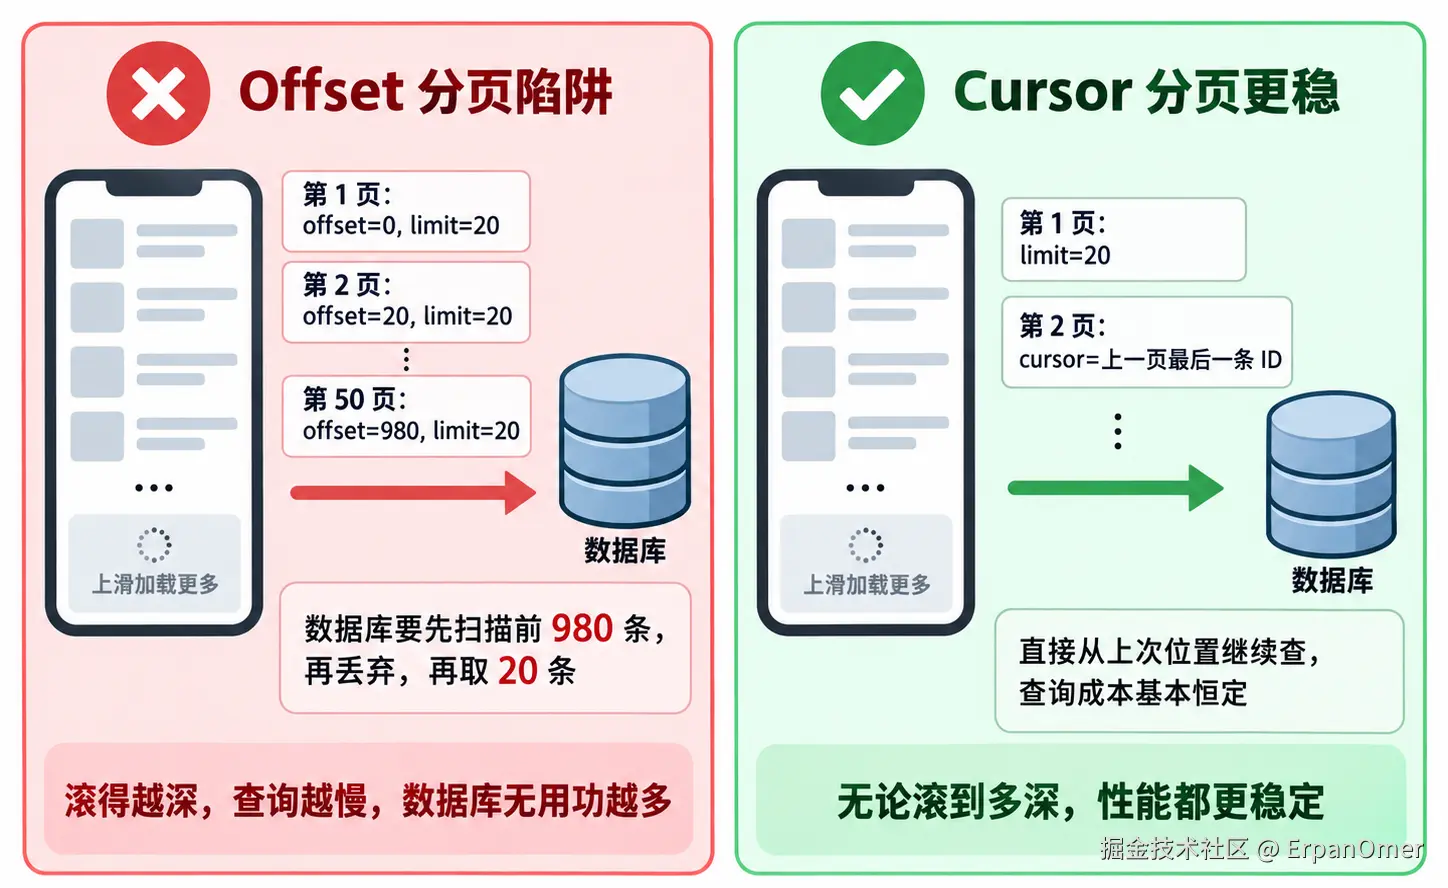
在前端看来,这只是 offset 参数加了 20 而已。但在数据库层面,OFFSET 980 的意思是:先扫描前 980 条记录,全部丢弃,再取 20 条返回。 用户滚得越深,数据库做的无用功越多,查询越慢。
如果你理解这一层,你在设计无限滚动时就会主动和后端讨论使用游标分页(Cursor-based Pagination):
bash
第 1 页:GET /api/posts?limit=20
第 2 页:GET /api/posts?cursor=上一页最后一条的ID&limit=20
游标分页无论用户滚到第多少页,查询成本始终恒定。这个优化不是后端自己能完成的------它需要前端在请求参数和状态管理上做对应的调整,这是一个典型的前后端协同决策🤔。
列表页的 N+1 深渊
产品经理说:商品卡片上要展示卖家的头像和店铺名。
不懂数据库的前端会觉得这是理所当然的。但如果后端在实现时不够谨慎,这个需求会导致一个臭名昭著的 N+1 查询问题:
sql
-- 先查 20 个商品
SELECT * FROM products LIMIT 20;

-- 然后对每一个商品,再去查一次卖家信息(循环 20 次)
SELECT * FROM sellers WHERE id = ?;  -- 执行 20 次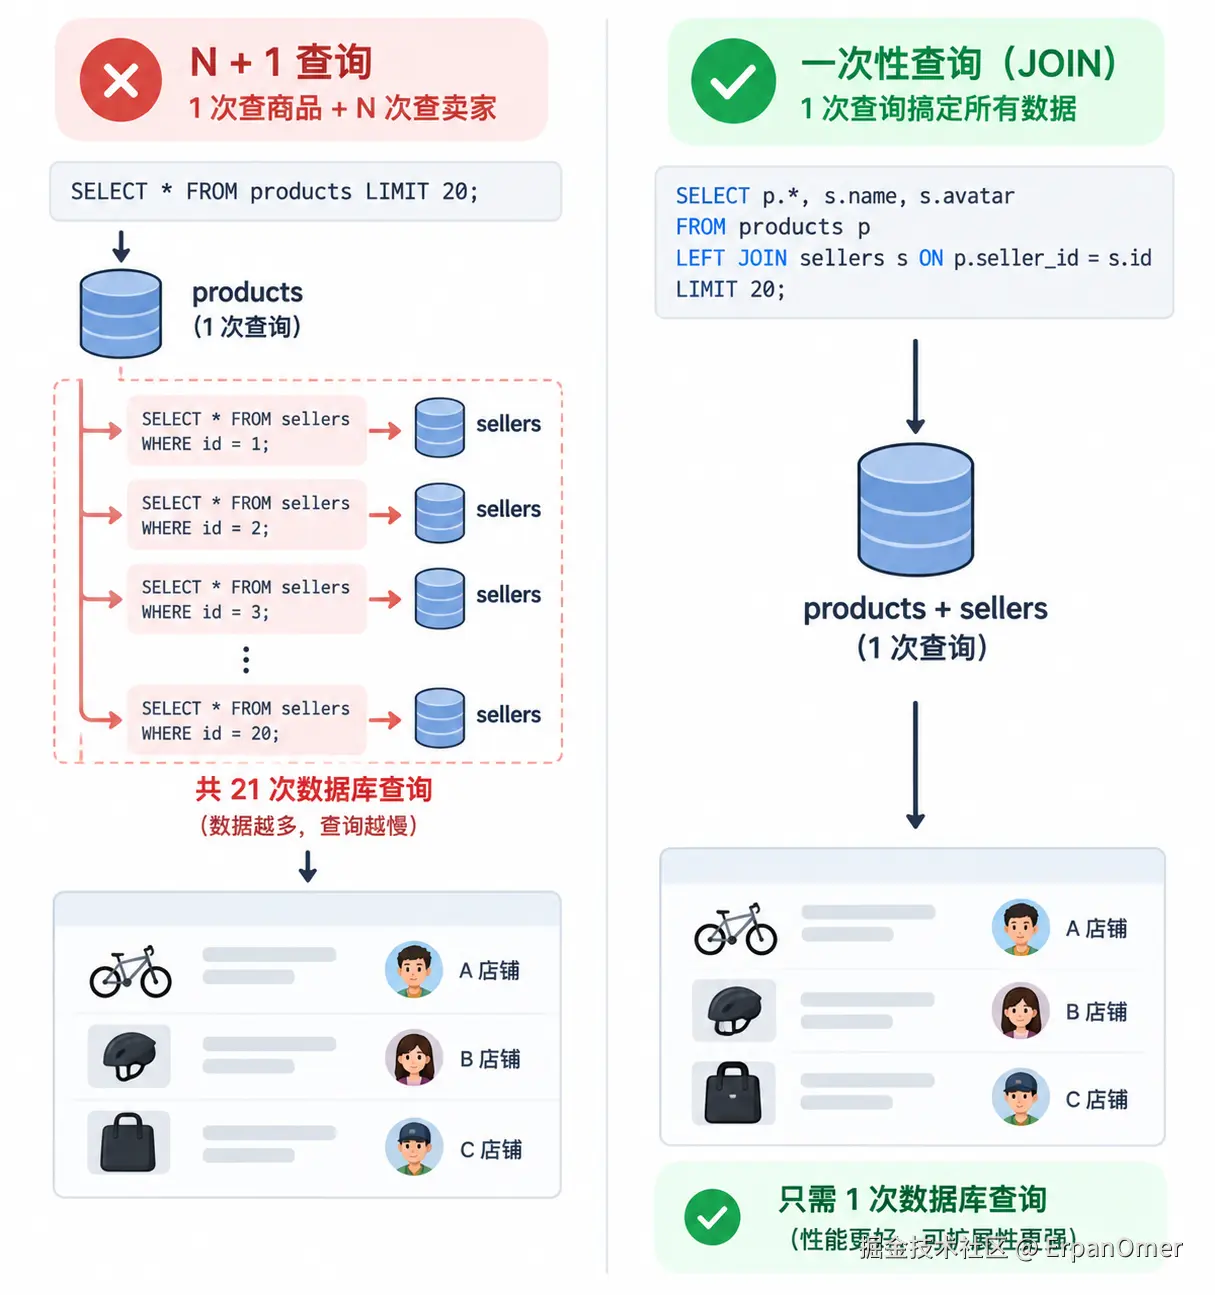
一个列表页,21 次数据库查询。如果这个页面还有所属分类、最新评价等关联数据,查询次数可能飙升到 60 甚至 100 次。
懂数据库的前端,会在 API 设计阶段就和后端约定:
这个列表接口必须用
JOIN或者批量查询一次性把关联数据带出来,不要每条记录单独查。如果数据结构太复杂,我们做一个 BFF 中间层来聚合,或者把卖家信息做成冗余字段直接存在商品表里。
这种判断力,只有理解了数据库查询成本的前端才具备🤔。
2026 年的前端,已经在直接写数据库了
如果你觉得上面的场景只是和后端沟通更顺畅,那下面这个趋势会真正击中你的生存焦虑😃。
在 Next.js 的 Server Components + Server Actions 架构下,前端工程师已经在直接写服务端逻辑了。在 Cloudflare Workers + D1(边缘 SQLite 数据库)的组合下,前端工程师正在独立完成从 UI 到数据持久化的完整链路。
typescript
// 这是一段 Next.js Server Action:前端工程师直接在组件里写数据库操作
// 文件:app/actions/posts.ts
'use server';

import { db } from '@/lib/db';
import { posts, users } from '@/lib/schema';
import { eq, desc, and, like, sql } from 'drizzle-orm';

interface GetPostsParams {
  cursor?: string;
  category?: string;
  keyword?: string;
}

export async function getPosts({ cursor, category, keyword }: GetPostsParams) {
  // 构建筛选条件
  const conditions = [];
  if (cursor) conditions.push(sql`${posts.id} < ${cursor}`);
  if (category) conditions.push(eq(posts.category, category));
  if (keyword) conditions.push(like(posts.title, `%${keyword}%`));

  // 游标分页 + 关联查询一把搞定,不存在 N+1
  const result = await db
    .select({
      id: posts.id,
      title: posts.title,
      createdAt: posts.createdAt,
      authorName: users.name,
      authorAvatar: users.avatarUrl,
    })
    .from(posts)
    .leftJoin(users, eq(posts.authorId, users.id))
    .where(conditions.length > 0 ? and(...conditions) : undefined)
    .orderBy(desc(posts.id))
    .limit(21); // 多取一条,用来判断是否还有下一页

  const hasMore = result.length > 20;
  const items = hasMore ? result.slice(0, 20) : result;
  const nextCursor = hasMore ? items[items.length - 1].id : null;

  return { items, nextCursor };
}这段代码里,游标分页、JOIN 关联查询、条件动态拼接------全部是前端工程师自己在写。没有后端帮你封装好 API,没有人告诉你应该 JOIN 还是 subquery,一切判断都落在你自己的头上。
如果你不懂数据库,你在这些新架构面前就是一个裸泳的人🤔。
你不需要什么都懂
一个前端工程师只需要搞透以下这几件事,就能在绝大多数场景中获得对后端的对等对话能力👇
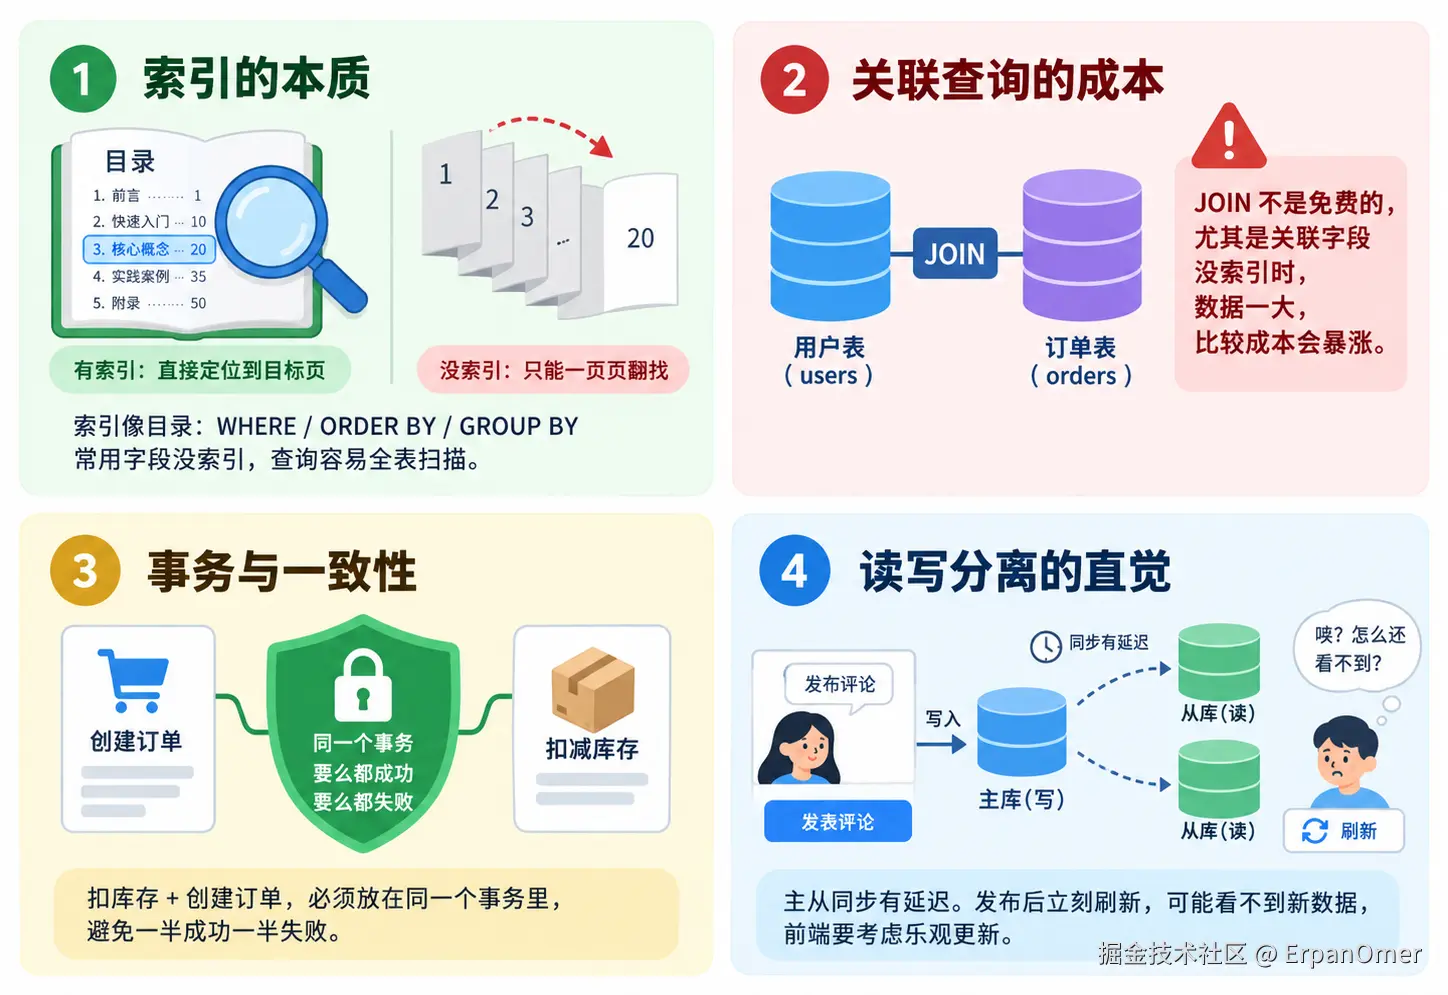
你可以在设计阶段就把问题搞定🤔
不懂数据库的前端,问题发现在联调阶段。 懂数据库的前端,问题解决在设计阶段。
这种判断力,来自于你对数据库物理层面的理解,而不是来自于你写 CSS 的经验。
大家怎么看呢😃?
喜欢我的文章,也欢迎关注我的微信公众号:【前端技术官】。
主要分享:前端架构 · AI 编程 · 职场认知 · 开发者成长
微信扫码关注 👆
不定期更新,不刷屏,聊点真正有用的干货。