在追求极致性能的系统中,减少一切不必要的计算是优化的核心。以手游为例,帧率和流畅度是其基础体验的关键,而游戏的发行版本往往被一个"不可能三角"所困扰:
- 性能足够好(日志少写)
- 方便追述问题(日志应写尽写)
- 节约存储空间(日志最好就别写)
国内发行的手游通常优先选择保1和3,放弃2。而HOK作为《王者荣耀》的国际服,由于面向全球的发行背景,面临时差、语言和隐私观念等问题,在遇到疑难杂症时很难直接与用户沟通。这种时候我们就需要一种产品,能帮助我们"既要又要",打破这个不可能三角。BqLog就是在这样的背景下诞生的。
BqLog不仅适用于客户端,也适用于服务器,能用于多种编程语言,也能兼容多种操作系统,具体请见Github地址:
本文是系列文章的第二篇,点击查看
本篇是系列第二篇。第一篇定了文件格式;但日志进文件之前,还要从几十个业务线程交到一个后台线程手上。本篇讲这条内存通道怎么建:从普通环形队列出发,走到 BqLog 的自适应数据总线。
为何 BqLog 如此快之二:从环形队列到自适应数据总线
English · 系列目录 · 上一篇:压缩文件 · 下一篇:执行路径优化
上一篇讨论了压缩文件如何减少格式化和写入量。但日志在进入文件之前,还要从业务线程交给后台线程。几十个线程同时写入时,即使每条记录都很小,共享队列的写游标也可能成为热点。
BqLog 的 log_buffer 为低频线程提供共享队列,为高频线程分配专用队列。下面从普通环形队列讲起,看看多生产者写入、变长记录、线程增删和崩溃恢复分别带来哪些麻烦。
本文对应 BqLog 2.5.0。MISO、SISO 是项目里的命名习惯:MISO 表示多生产者单消费者(Multi In, Single Out,也就是常说的 MPSC),SISO 表示单生产者单消费者(Single In, Single Out,即 SPSC)。代码里的对齐常量
BQ_CACHE_LINE_SIZE是 128 字节,下文简称 C。它是库自己选的布局单位,不代表所有 CPU 的硬件缓存行都是 128 字节。
1. 测试数据与讨论范围
参与比较的有 C++ 的 spdlog(异步模式)、glog、fmtlog、quill 和 Java 的 Log4j2,各组件的完整配置见 BENCHMARK_CHS.md。下表是 1--10 个线程的结果:每线程写 200 万条日志,每条带 4 个格式化参数;机器为 PC(AMD Ryzen 9 9950X,16 核 32 线程,96 GB,Windows 11 Pro;Java 用 JBR 21.0.9)。
这里每增加一个线程,总日志量也增加 200 万条。例如 10 线程对应 2000 万条日志,比较吞吐时要用这份总量除以耗时。
每条日志带 4 个参数的总耗时(单位:毫秒)
| 1线程 | 2线程 | 3线程 | 4线程 | 5线程 | 6线程 | 7线程 | 8线程 | 9线程 | 10线程 | |
|---|---|---|---|---|---|---|---|---|---|---|
| BqLog Compress(C++) | 95 | 144 | 210 | 210 | 226 | 267 | 362 | 395 | 439 | 507 |
| BqLog Compress+Encrypt(C++) | 102 | 166 | 167 | 190 | 236 | 308 | 350 | 391 | 453 | 493 |
| BqLog Text(C++) | 258 | 513 | 777 | 1054 | 1324 | 1587 | 1891 | 2143 | 2465 | 2811 |
| fmtlog | 548 | 1173 | 1665 | 2194 | 2881 | 3440 | 4386 | 5242 | 5888 | 6926 |
| quill | 639 | 1429 | 2232 | 3082 | 3915 | 4726 | 5609 | 6246 | 6957 | 7812 |
| Log4j2 (Java) | 873 | 1484 | 2087 | 2727 | 3738 | 4541 | 4889 | 6127 | 9475 | 7192 |
| spdlog(异步) | 560 | 1649 | 3402 | 5737 | 9069 | 13827 | 21494 | 24518 | 28463 | 32939 |
| glog | 4485 | 8548 | 14875 | 21387 | 28295 | 36060 | 45742 | 62368 | 102370 | 127550 |
10 线程时,BqLog 压缩模式用时 507 毫秒:约为 Log4j2 的 1/14、异步 spdlog 的 1/65,对 fmtlog 和 quill 也快约 13.7 倍和 15.4 倍。加密模式 493 毫秒,与不加密持平(差异在测量噪声内)。这些是整条写入路径的测试结果,不能单独归因于队列。用例和配置见 Benchmark 与 BENCHMARK_CHS.md。
格式化、缓存访问、I/O 和线程间通信都会影响总耗时。本文只讨论最后一项:共享 MISO 队列如何处理多生产者分配,以及高频线程如何转到各自的 SISO 队列。相关方案已在 BqLog 开源前申请专利。
2. 两种环形队列的起点
熟悉单生产者环形队列和 Disruptor 的读者可以直接看 [第 3 节](#第 3 节 "#3-miso-%E9%98%9F%E5%88%97%E7%94%A8-fetch_add-%E5%88%86%E9%85%8D%E7%A9%BA%E9%97%B4")。这里主要讨论并发控制,不展开内存模型的全部细节。
先记住队列要回答的两个问题:生产者能写哪段空间,消费者能读到哪里。前一个问题要防止覆盖未读数据,后一个问题要防止读到尚未写完的数据。单生产者时两个游标就能协调好;生产者一多,空间预留和写入完成就得分开处理。
2.1 Linux kFifo:单生产者、单消费者
kFifo 是 Linux 内核提供的循环队列(FIFO)实现。这里取其单生产者、单消费者用法:一个线程写,一个线程读。
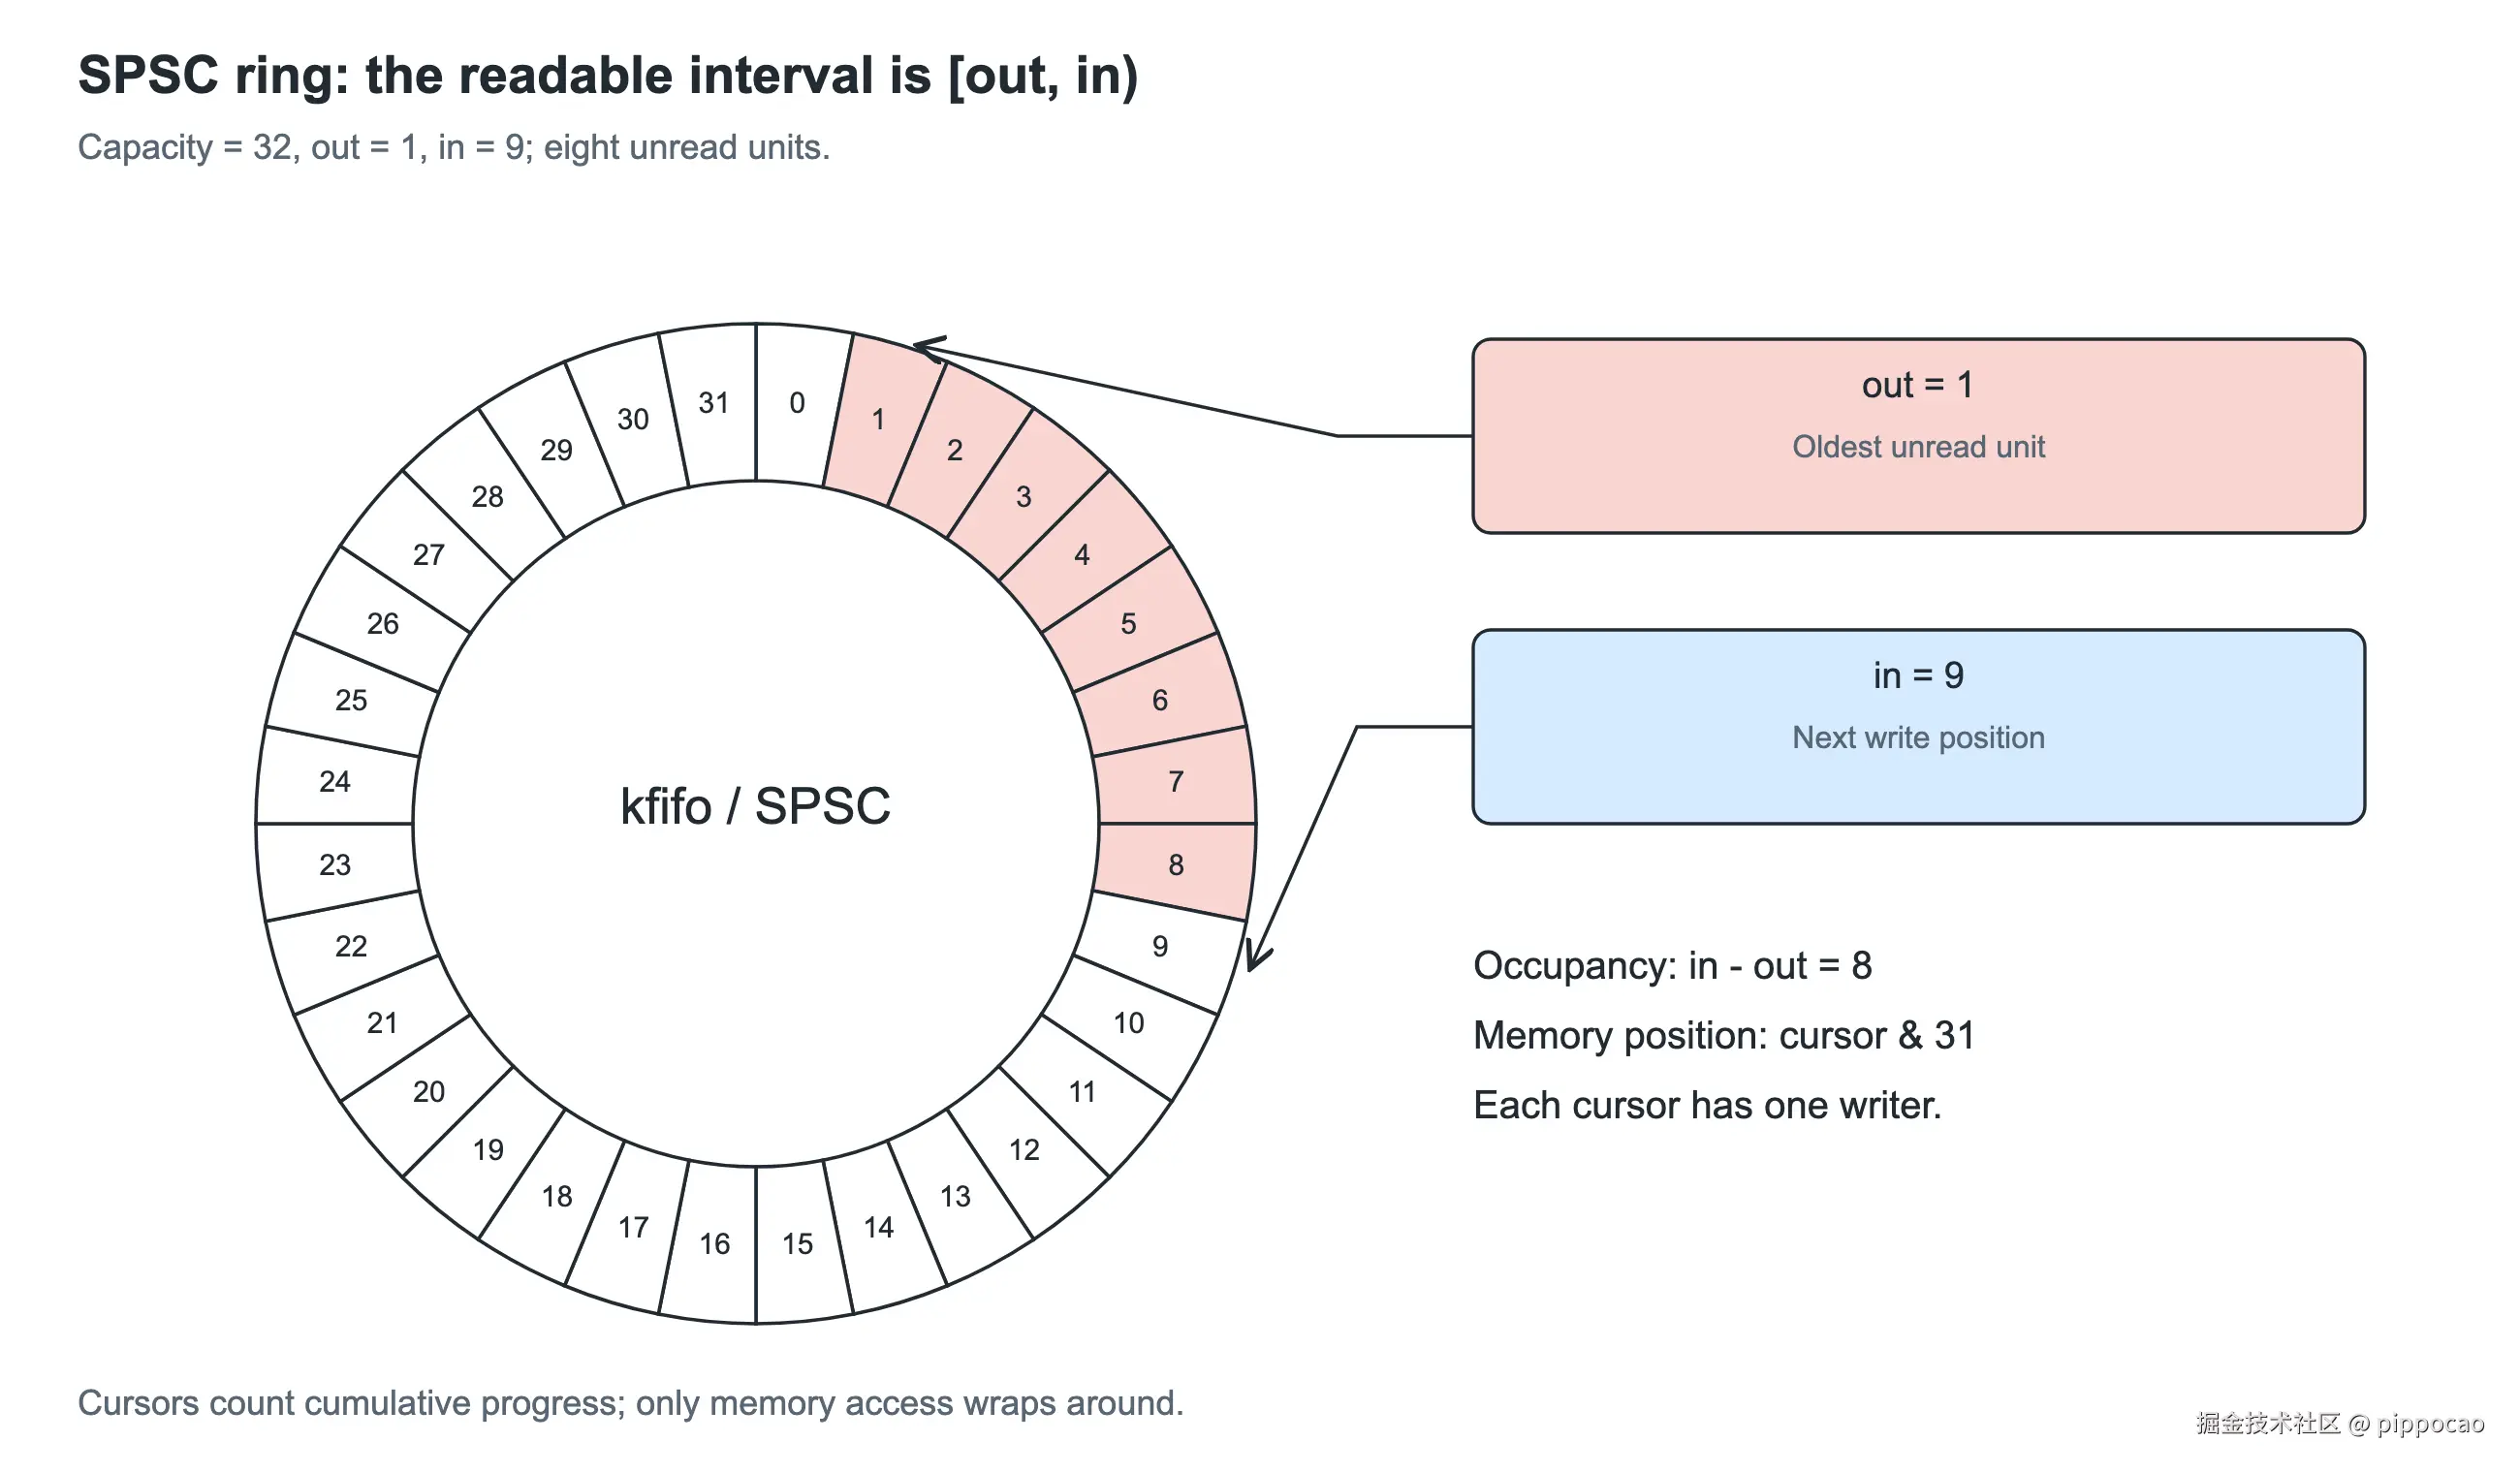
图 1:kFifo 的环形结构------In、Out 两个游标各只有一个主人。
队列用 in 和 out 记录累计写入、读出的进度,只有访问内存时才取模映射到环上。例如容量为 16,out=12、in=20,就有 8 个单位尚未读出,下一处写入的物理位置是 20 % 16 = 4。后文出现 1000、1030 这样的游标,也是在表示累计进度。
图中红色格子是尚未消费的数据,Out 对应最老的位置,In 对应下一处可写位置。容量取 2 的幂时,取模可以写成 cursor & (size - 1)。
用 acquire/release 伪接口写出单生产者、单消费者的基本过程:
c
/// 写线程调用
unsigned int kfifo_in(struct kfifo *fifo, const void *buf, unsigned int len)
{
    unsigned int in = fifo->in.load_relaxed();
    unsigned int out = fifo->out.load_acquire();
    unsigned int n = min(len, fifo->size - (in - out));
    unsigned int offset = in & (fifo->size - 1);
    unsigned int first = min(n, fifo->size - offset);

    memcpy(fifo->buffer + offset, buf, first);                // 先写到环尾
    memcpy(fifo->buffer, (const char*)buf + first, n - first); // 剩余部分写到环首
    fifo->in.store_release(in + n);                          // 数据写好后再发布
    return n;
}

/// 读线程调用
unsigned int kfifo_out(struct kfifo *fifo, void *buf, unsigned int len)
{
    unsigned int out = fifo->out.load_relaxed();
    unsigned int in = fifo->in.load_acquire();
    unsigned int n = min(len, in - out);
    unsigned int offset = out & (fifo->size - 1);
    unsigned int first = min(n, fifo->size - offset);

    memcpy(buf, fifo->buffer + offset, first);
    memcpy((char*)buf + first, fifo->buffer, n - first);
    fifo->out.store_release(out + n); // 读完后通知写线程:这些空间可以复用
    return n;
}
写线程独占修改 in,读线程独占修改 out,因此不需要用 CAS 争取游标。写线程先拷贝数据,再以 release 语义发布 in;读线程以 acquire 语义取得这个进度后,也能看到此前写好的数据。读完后的 out 则反向告诉生产者:这些空间已经可以覆盖。
这里的原子读写负责双方可见性,CAS 则是用来协调多个修改者。若两个生产者同时执行上述写入过程,它们可能读到相同的 in,随后向同一位置拷贝数据。要支持多生产者,首先得让每个线程取得不同的位置。
2.2 LMAX Disruptor:先分配,再发布
LMAX Disruptor 是 LMAX 开源的并发框架,Log4j2 的异步日志也使用它。代码和文档见 LMAX-Exchange/disruptor。
它也使用环形结构。以下按日志场景示意:槽位(Slot)持有 Log Entry 的引用,实际数据在对象中。
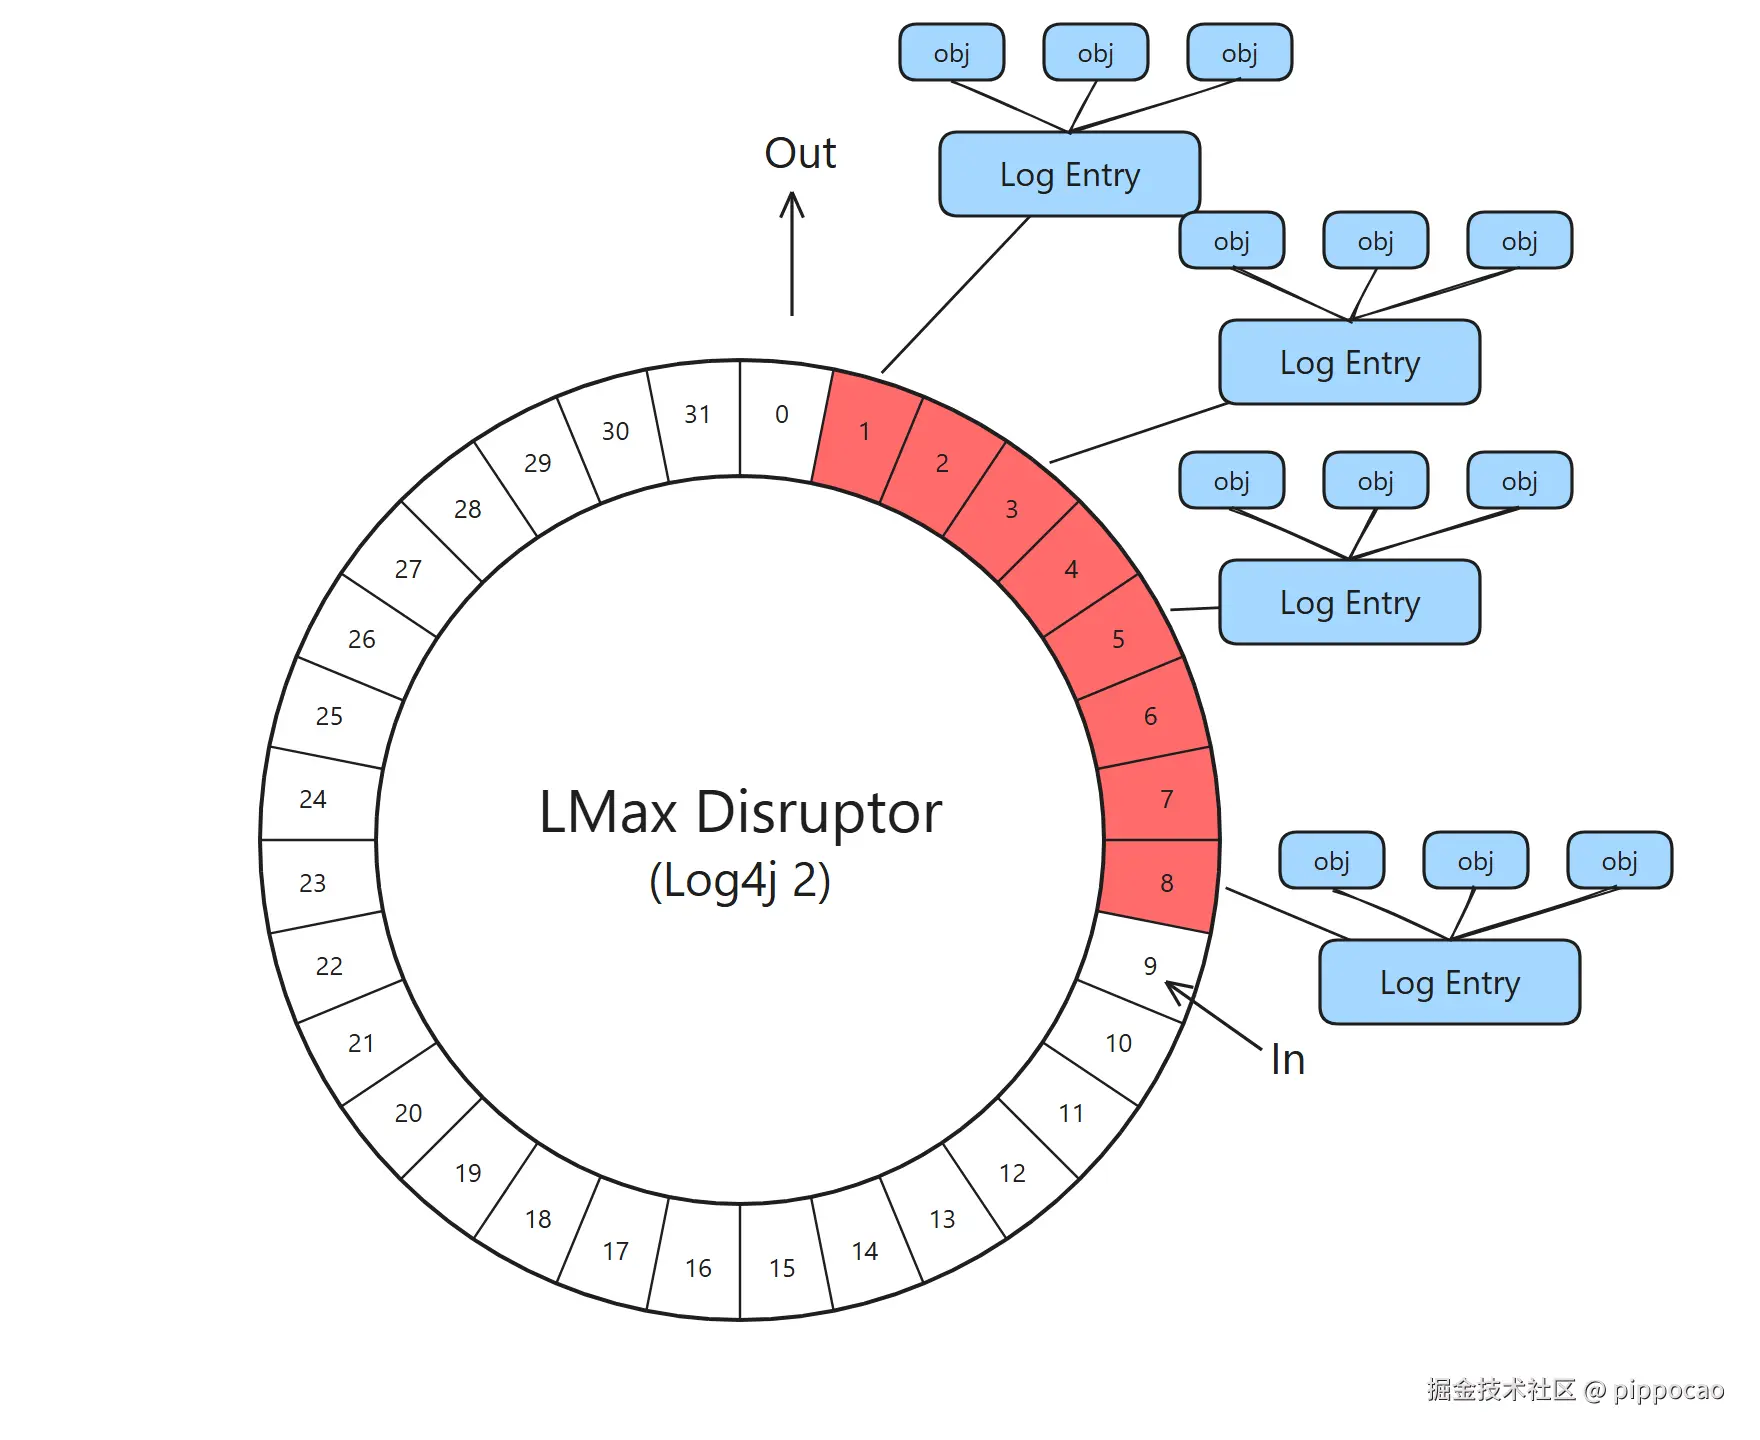
图 2:Disruptor 的环------槽位里放的是 Log Entry 引用,不是数据本身。
多生产者可用 CAS(Compare-And-Swap) 争取写入位置:只有当前值与预期值相同才更新;失败的线程重新读取游标并重试。
我们试着用 CAS 改造 kfifo_in,让它支持并发写入:
c
unsigned int kfifo_in_concurrent(struct kfifo *fifo, const void *buf, unsigned int len)
{
    unsigned int old_in, new_in, free_space;

    do {
        // 1. 获取当前的in指针位置
        old_in = fifo->in;

        // 2. 计算ring_buffer剩余的可用空间
        free_space = fifo->size - (old_in - fifo->out);
        if (len > free_space) {
            return 0;  // 如果空间不足,写入失败
        }

        // 3. 计算新的in指针位置
        new_in = old_in + len;

        // 4. 尝试通过CAS更新in指针
        // 如果当前的in值还是old_in,那么成功更新为new_in,否则需要重试
    } while (!__sync_bool_compare_and_swap(&fifo->in, old_in, new_in));

    // 5. 现在已经安全地申请到空间,开始写入数据
    write_data_to(old_in/*to*/, buf/*from*/, len/*size*/);

    return len;
}
CAS 成功时,当前线程取得从 old_in 开始的区间;失败说明别人推进了游标,需要重新计算容量并重试。空间分开了,接下来还要解决完成状态的发布。
预留游标不能直接当作可读边界。单生产者可以先写数据、再发布 in;多生产者先各自取得位置,再写数据,完成顺序可能与预留顺序不同。
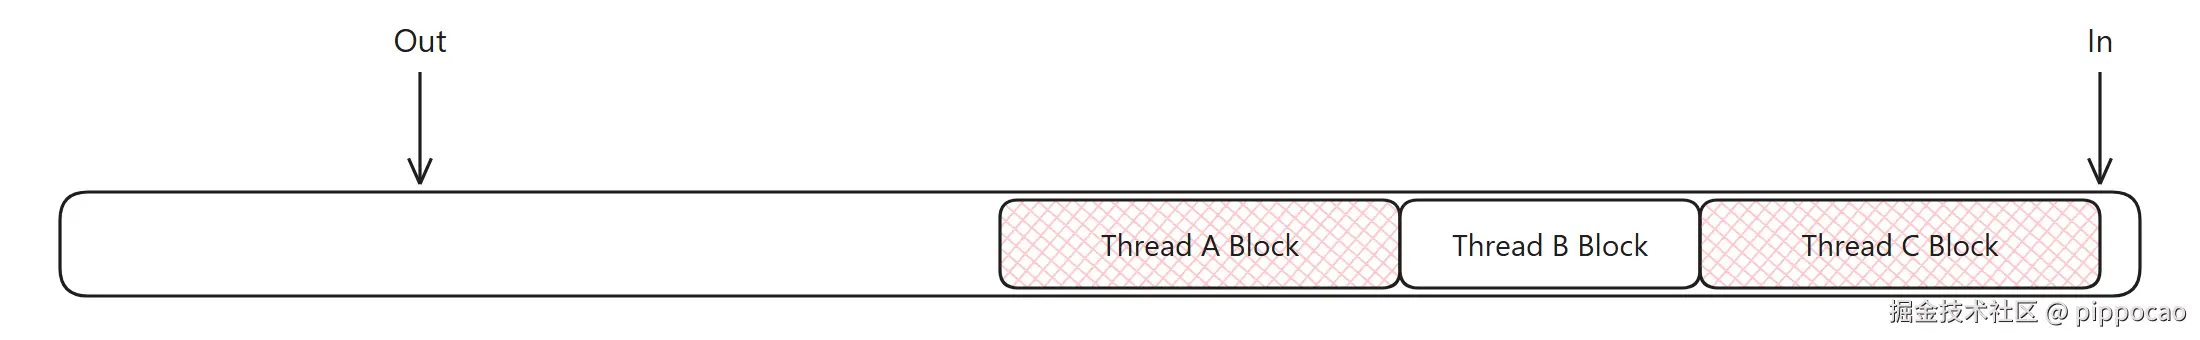
图 3:先申请后写入的麻烦:A 和 C 的块已经写完(阴影),B 还没写完,In 不再能当可读边界。
图中 A 和 C 已经写完,B 尚未写完。消费者不能越过 B 读取 C,因此需要独立的完成状态。Disruptor 通过槽位序号跟踪发布进度;BqLog 把变长数据直接放在环形内存里,采用后文的块状态。
3. MISO 队列用 fetch_add 分配空间
3.1 CAS 重试的代价
多个线程同时用 CAS 更新同一个游标时,失败的一方必须重读再重试。线程一多,重试就频繁到不能忽略。MISO 队列在空间分配这条常用路径上改用 fetch_add。
3.2 fetch_add:先预留,再检查容量
fetch_add 原子地增加游标,并返回增加前的值。所有调用对这个变量仍有先后次序,但每个线程都能拿到自己的旧值,程序不必再写一轮"比较失败就重试"的循环。
只看预留动作,伪码可以写成:
c
unsigned int kfifo_in_concurrent(struct kfifo *fifo, const void *buf, unsigned int len)
{
    // 1. 直接申请内存,申请到的就是[from, from+len)这一段
    unsigned int from = __sync_fetch_add(&fifo->in, len);

    // 2. 这段内存已经归当前线程独占,直接写
    write_data_to(from/*to*/, buf/*from*/, len/*size*/);
    return len;
}
假设 in 初始值是 0,三个线程 A、B、C 同时申请 10、5、15 字节,执行完后它们拿到的起始位置可能是:
- 线程A :0,线程B :10,线程C :15,
in最终是 30
也可能是:
- 线程B :0,线程C :5,线程A :20,
in最终还是 30
看下图:

图 4:fetch_add 为不同线程分配不同区间;容量上限仍需单独检查。
顺序取决于线程的实际执行次序,但拿到的区间互不重叠。两种方式的脾气不一样:CAS 是"确认没人动过才更新,失败就重来";fetch_add 是"先把号拿到手,有问题再处理"。图中还画出了容量上限:fetch_add 不检查剩余空间,预留之后还要验证拿到的区间是否有效。
3.3 越界后的回滚
fetch_add 只保证游标增加是原子的,不能保证队列有足够容量。
图中容量上限 Limit 为 25,多个线程预留后,In 到了 40。C 的末尾和 D 的全部区间都超出当前可写范围,不能直接写入。
消费者把 Out 推进到 15 时,可写上限也移到 45。先前越界的区间此时可能重新变得有效;回滚判断要考虑这个变化。
CAS 不会有这个问题,因为最后一次更新时必须确认 in 和当初判断时一模一样,中间有人动过就失败重来。
bq::miso_ring_buffer 在预留后检查容量,必要时回滚。下面的伪码省略了环回绕等细节(伪码里的 in_、out_ 就是源码里的写游标 write_cursor_、读游标 read_cursor_,§4 起用源码的名字):
c
void* bq::miso_ring_buffer::alloc(size_t len)
{
    // 1. 先用缓存的读游标检查,空间不足时刷新一次
    size_t in = this->in_.load_relaxed();
    if (in + len - this->out_cache_ > this->size_) {
        this->out_cache_ = this->out_.load_acquire();
        if (in + len - this->out_cache_ > this->size_) {
            return nullptr;
        }
    }

    // 2. 原子预留:[from, from + len)
    size_t from = this->in_.fetch_add_relaxed(len);

    // 3. 预检查之后可能又有其他生产者分配,必须检查实际拿到的区间
    while (from + len > this->out_.load_acquire() + this->size_)
    {
        // 4. 确实越界了,只能回滚(Rollback)
        size_t expected_in = from + len;
        if (__sync_bool_compare_and_swap(&this->in_, expected_in, from))
        {
            // 如果in_的值等于from + len,就把它回滚成from,否则自旋继续尝试回滚
            return nullptr;  // 回滚成功,返回空间不足
        }
    }

    // 5. 内存有效,直接返回(可能申请时就有效,也可能是等待回滚期间消费者腾出了新空间)
    return to_addr(from);
}
回滚仍然需要 CAS,而且可能反复失败。BqLog 把这份协调工作放在预留越过容量上限时:空间充足的常用路径用一次 fetch_add 取得位置,容量不足时才等待后续预留撤销,或等消费者腾出空间。真实实现里恰好写满也按越界处理(判断用 ≥);游标是 32 位无符号数,源码注释自己交代了边界------所有线程累计分配达到数百 GB 量级才可能出现环绕,离日志缓冲区的实际规模很远。
为什么不能直接执行 fetch_add(&this->in_, -len)?看下面的交错顺序:多个生产者已经预留空间,消费者又在推进 out,直接减去自己的长度可能让后续分配与仍有效的区间重叠。
图中给出一个例子:
图 5:A、B、C 预留空间后,B 和 C 的区间越过当前可写上限。
分配前 in 为 1000,可写上限为 1012。A、B、C 先后预留后,in 到了 1030,B 和 C 的区间越界。如果 B 直接减去自己的长度,可能出现以下顺序:
- B 执行
fetch_add(&in, -5),把in减到 1025; - 消费线程释放空间,可写上限移到 1040;
- B 再申请 5 字节,得到 1025--1030,此时
in又到了 1030; - C 发现自己的 1015--1030 区间已在容量内,也开始写入。
结果如下图:
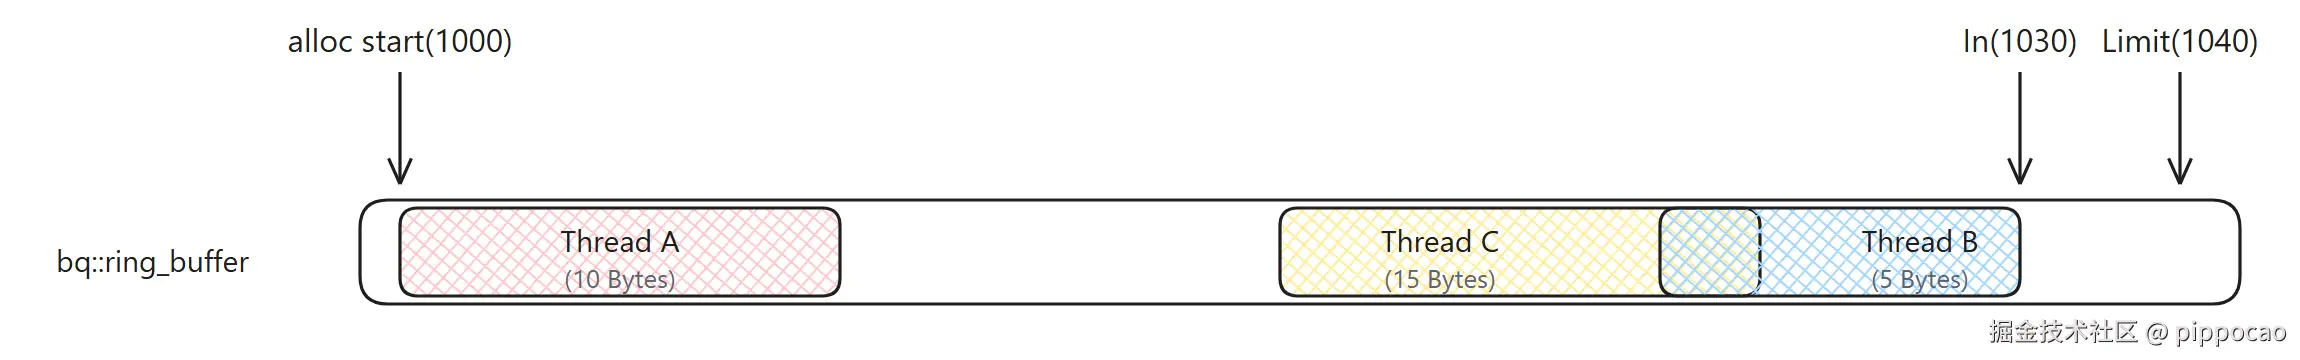
图 6:B 直接减去自己的长度并再次申请,结果与 C 的区间重叠。
此时 B 与 C 会写到重叠的区间。回滚必须从队尾开始,逆序逐个撤销:每个线程只在 CAS 确认 in == from + len(也就是自己还占着队尾)时才撤销自己的预留,不是队尾就继续等。若等待期间消费者释放了足够空间,该线程就可以保留区间直接写入。图中的顺序是 C 先把 1030 退回 1015,B 再从 1015 退回 1010。
对应的真实实现可以看这里:
3.4 抢到位置不等于写完数据:块状态
预留游标仍不能代表数据已经写完。A 先取得位置但尚未写入,B 随后完成写入时,消费者需要停在 A 的区间前。
BqLog 的 MISO 把环形内存按 128 字节(C)一个 block 划分。每条数据(chunk)的第一个 block 有 8 字节头部,其中包含发布状态:
text
block_num: 3 B | status: 1 B | data_size: 4 B | payload ...status 有三个值:unused 表示尚无可读数据,used 表示写入完成,invalid 表示该区间需跳过。生产者拷贝完成后以 release 语义写入 used;消费者以 acquire 语义读到 used,才读取 payload。它与前面发布 in 的作用相同,只是多生产者必须按记录分别报完成。
空间预留只需要保证不同线程取得不同位置,不负责告诉消费者数据已经写好,因此 fetch_add 可用 relaxed 序------relaxed 只保证这次加法本身原子完成,不附带其他内存的可见性,而这里需要的恰好只有前者。预留空间的原子性和发布数据的可见性,是这里分开的两件事。
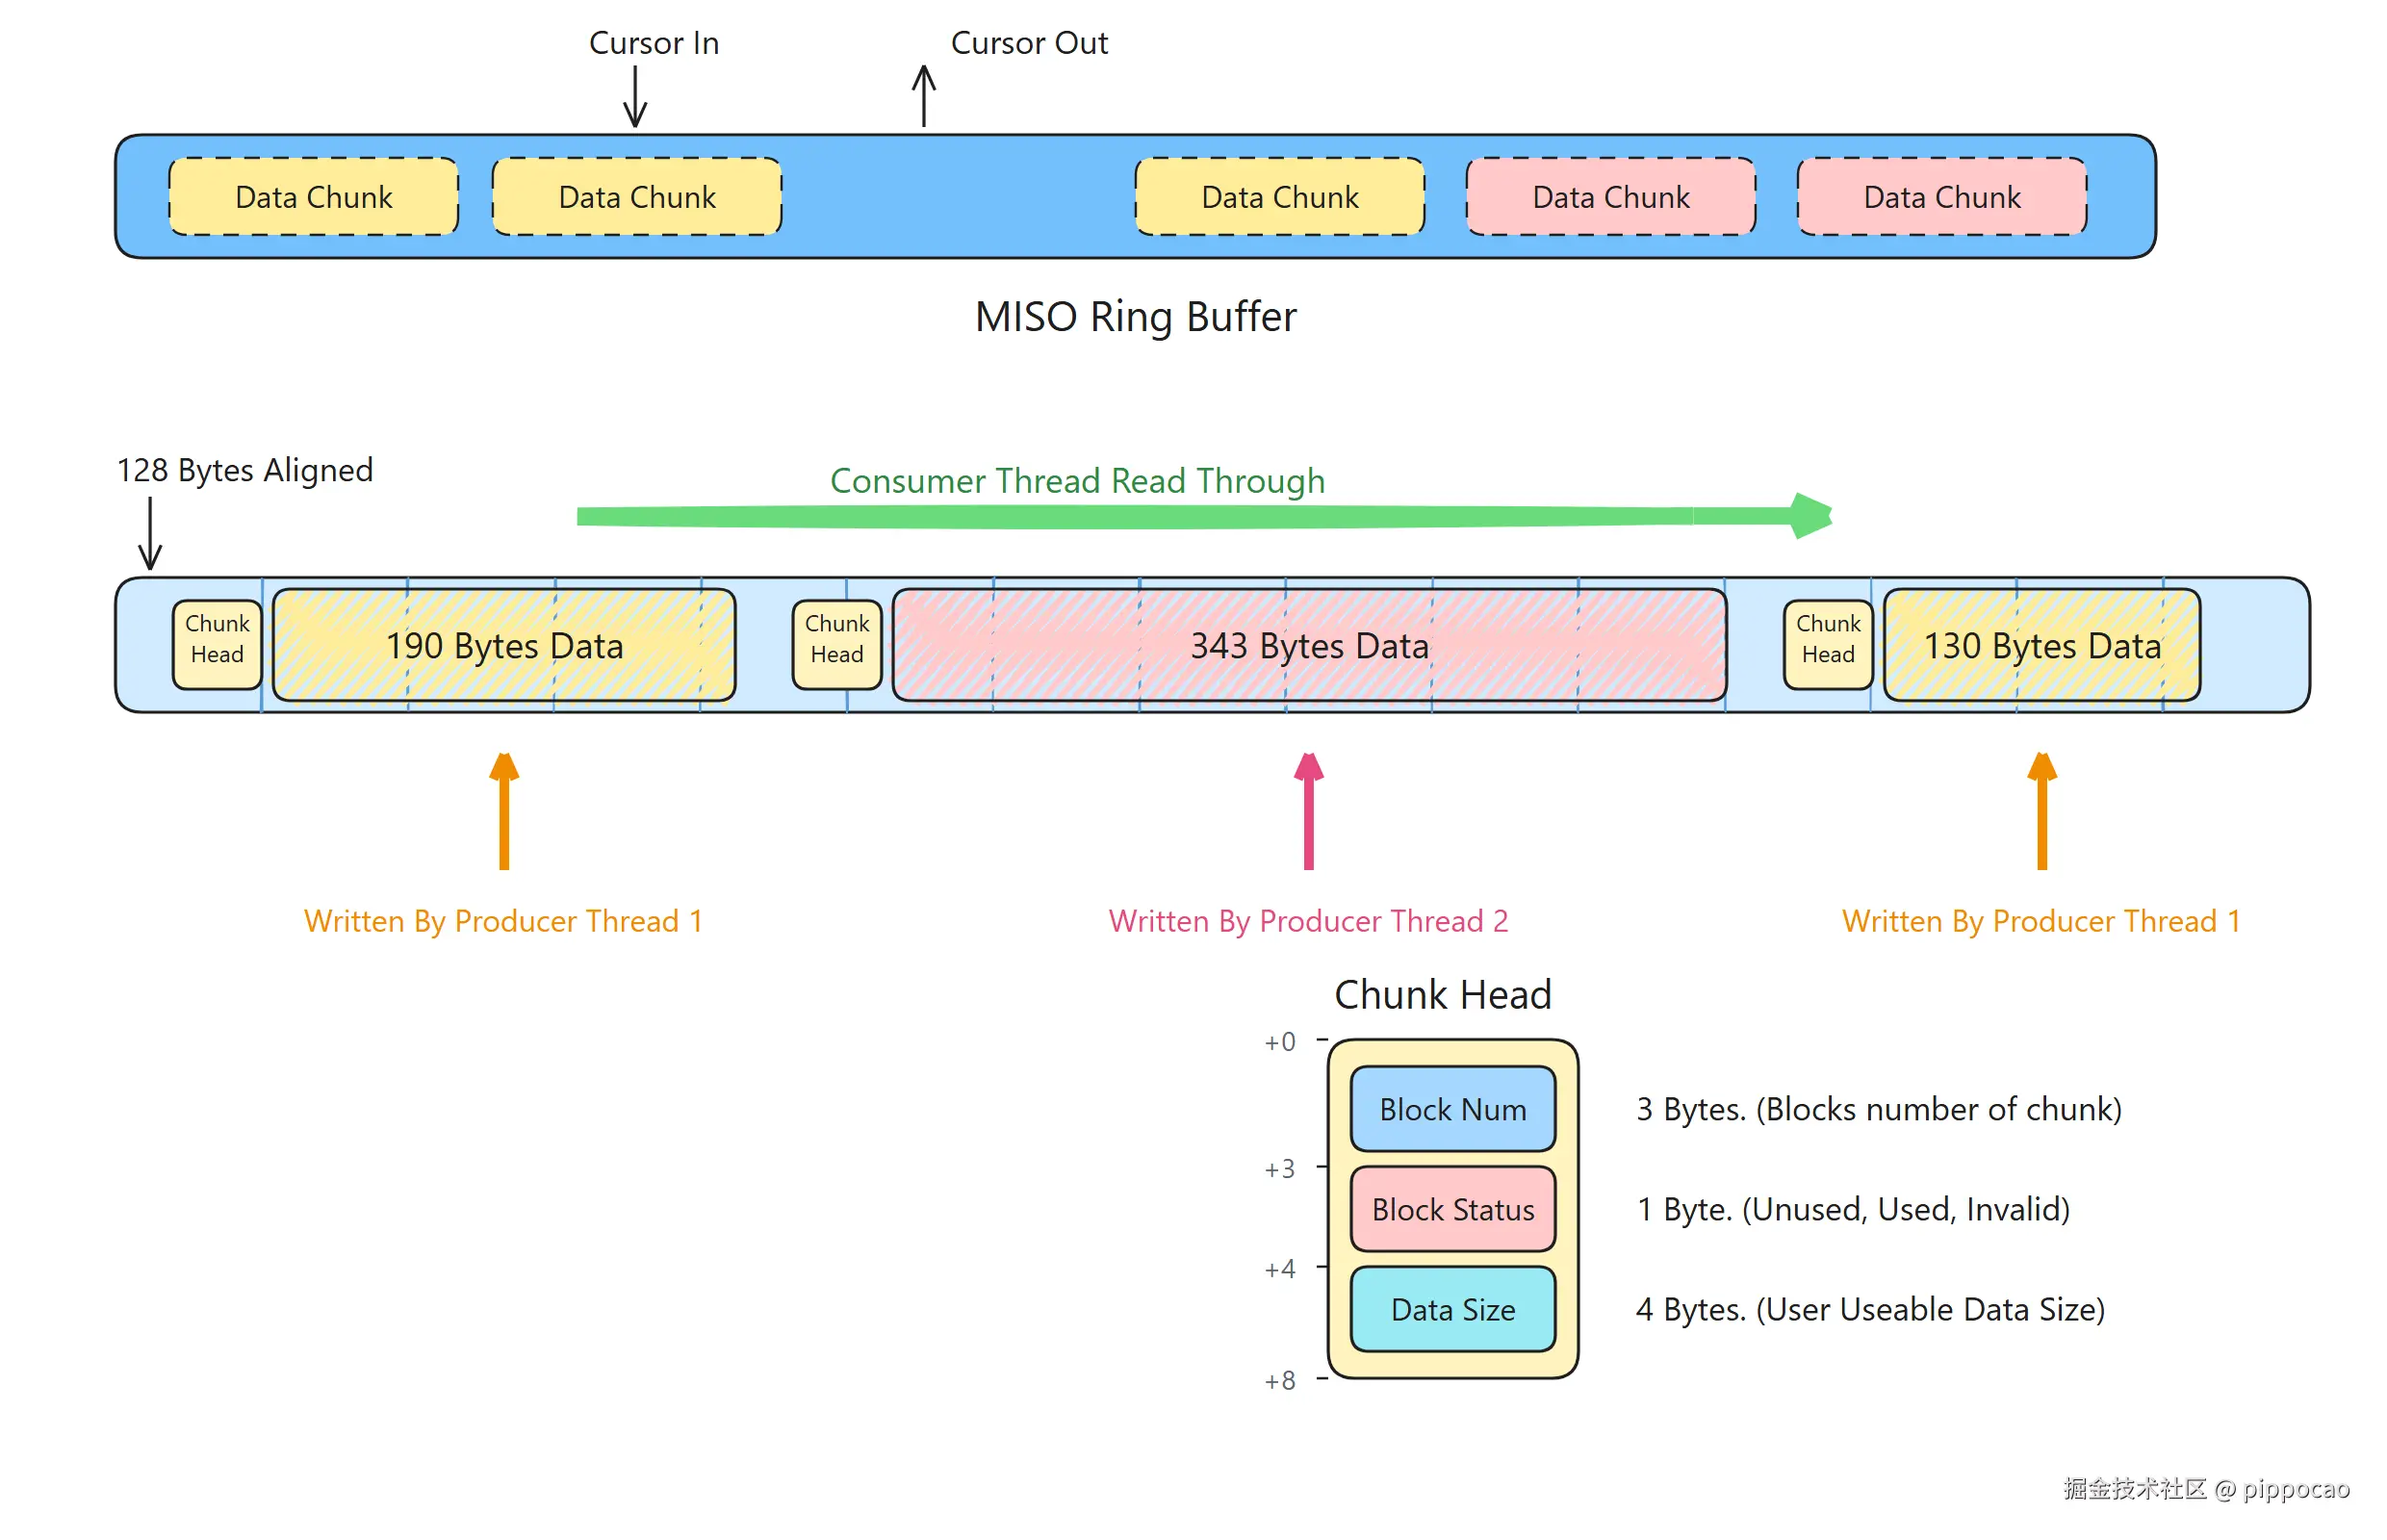
图 7:MISO 环由 128 字节 block 组成;每条 chunk 的头部占 8 字节,消费者按游标顺序读取。
invalid 用来处理跨越环尾的预留。普通字节 FIFO 可以把一次拷贝拆成两段,BqLog 却不能:上层拿到这块内存的地址后要直接往里写格式和参数(第三篇 §3.1),拆成两段就得拷两次。若本次预留跨过环尾,就把整个预留区间标成 invalid,让消费者跳过,再重新申请连续空间。
128 字节的分配粒度会产生内部碎片。例如 61 字节的内部日志,加上 LP 路径的 16 字节 context(记录顺序与线程身份,[第 7 节](#第 7 节 "#7-%E7%94%A8%E4%B8%89%E4%B8%AA%E5%9C%BA%E6%99%AF%E4%B8%B2%E8%B5%B7%E8%BF%99%E5%A5%97%E7%BB%93%E6%9E%84")细讲)和 8 字节块头,共 85 字节,仍占一个完整 block。这样分配可让不同生产者的数据落在不同的对齐区域,减少伪共享;代价是小记录占用更多缓冲空间。下一节就看共享游标上的竞争。
游标同步还有两处可摊销:
- 写线程把读游标缓存一份在线程本地存储(TLS,每个线程各自一份、随线程退出失效),平时用缓存值判断容量,不够了才去读真正的共享
read_cursor_。缓存值只会偏旧,偏旧只会低估可用空间,顶多白刷一次,绝不会因此覆盖没消费的数据。 - 消费者也不是每读一条就发布一次
read_cursor_,而是攒够四分之一环或者读空了,才批量把状态置unused、发布读游标。同步成本被摊薄到一大批数据上。
下图对照 kFifo 与 MISO 的同步步骤:
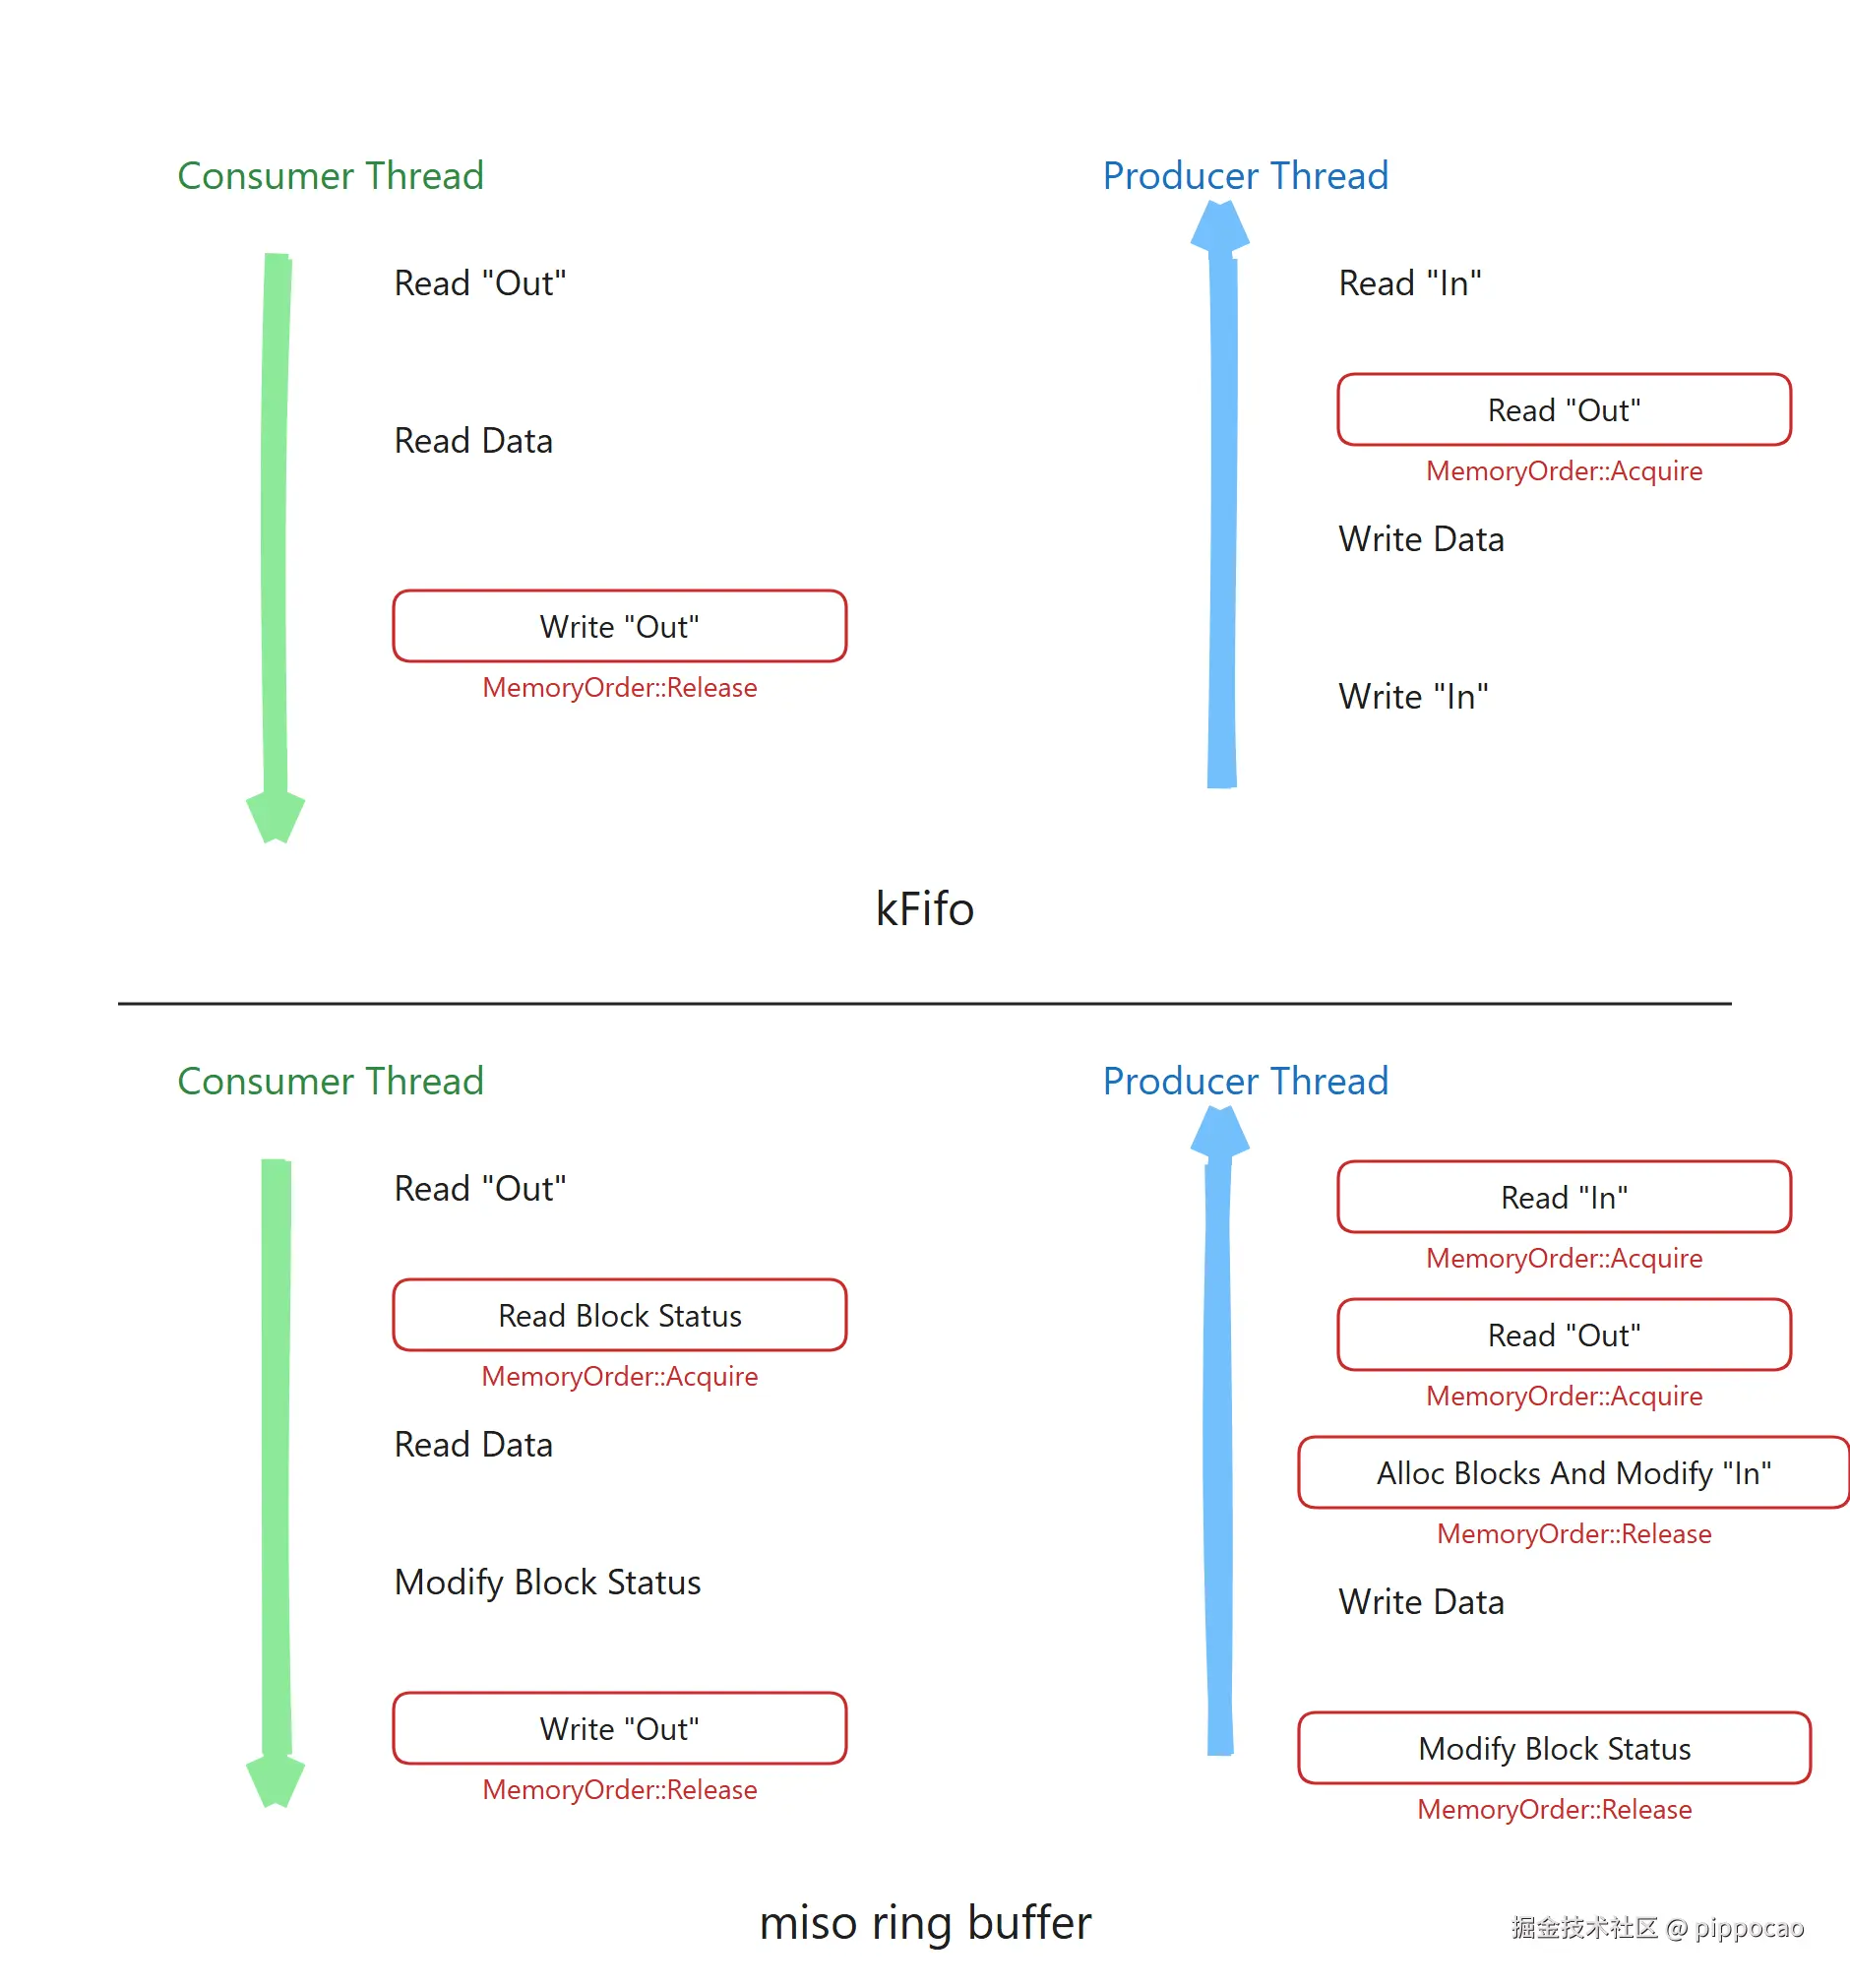
图 8:MISO 除游标更新外,还需发布并读取每条 chunk 的完成状态。
单生产者队列主要发布写、读游标。MISO 除了更新游标,还要为每条 chunk 发布完成状态;消费者读取状态后,批量归还空间。同步集中在分配、发布和归还阶段,数据拷贝本身不争用共享游标。
4. 共享写游标的硬件代价
MISO 在空间充足时省掉了 CAS 重试,多个核仍然要修改同一个 write_cursor_。这个共享变量会让核之间发生什么?
假设核 A 和核 B 各有一个生产者。A 更新游标前,需要取得所在缓存行的写权限;轮到 B 更新时,一致性协议又要让 B 取得写权限,并使其他核的旧副本失效。两个核轮流高频写入,就会反复为同一条缓存行协调。fetch_add 的原子更新也要遵守这套规则。
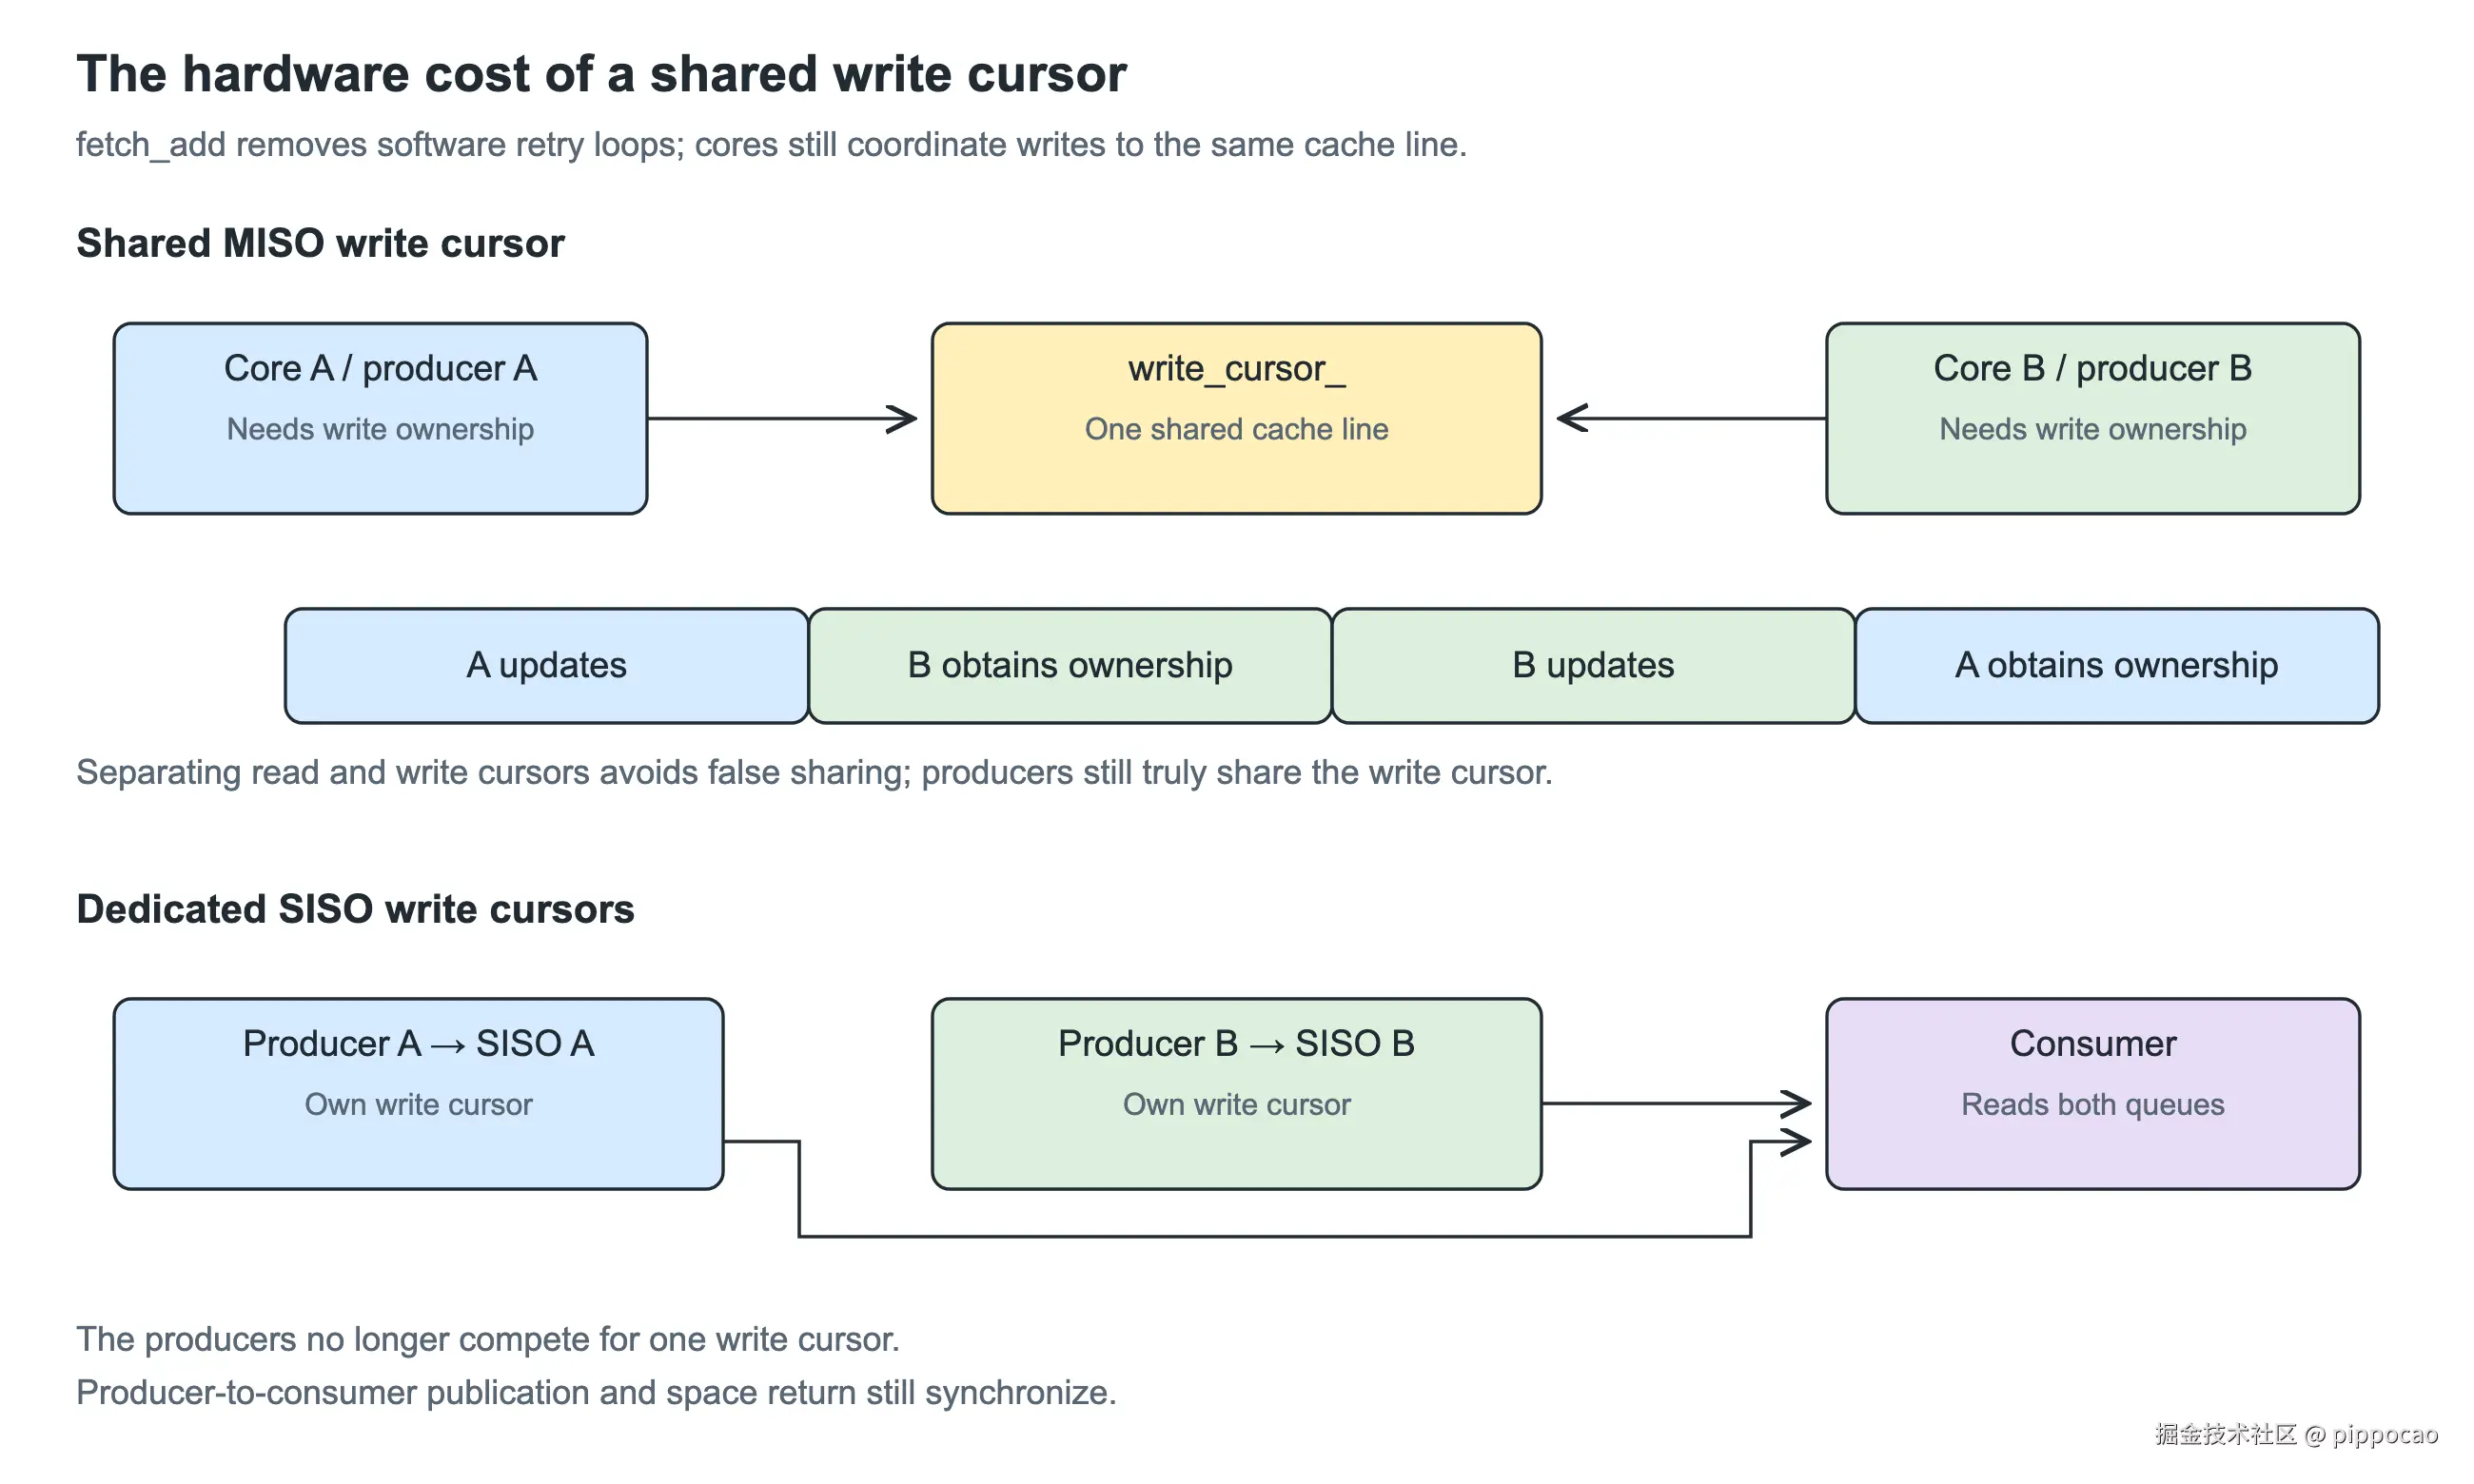
图 9:两个核更新同一游标,需要交替取得写权限;专用 SISO 将生产者各自的写游标分开。
MISO 已经把 write_cursor_ 和 read_cursor_ 分开布局,避免两个不同变量挤在同一缓存行里相互影响,也就是伪共享(false sharing)。但所有生产者更新同一写游标属于真共享(true sharing),给它加 padding 也分不开这些访问。
要继续减少生产者之间的竞争,就得减少共同修改的数据。BqLog 为高频生产者分配各自的写游标。
5. 高频线程使用专用 SISO 队列
5.1 SISO 是什么
siso_ring_buffer 只有一个生产者和一个消费者。生产者独占写游标,消费者独占读游标;高频线程各用一条队列,就不必在每条日志上争用同一个写游标。
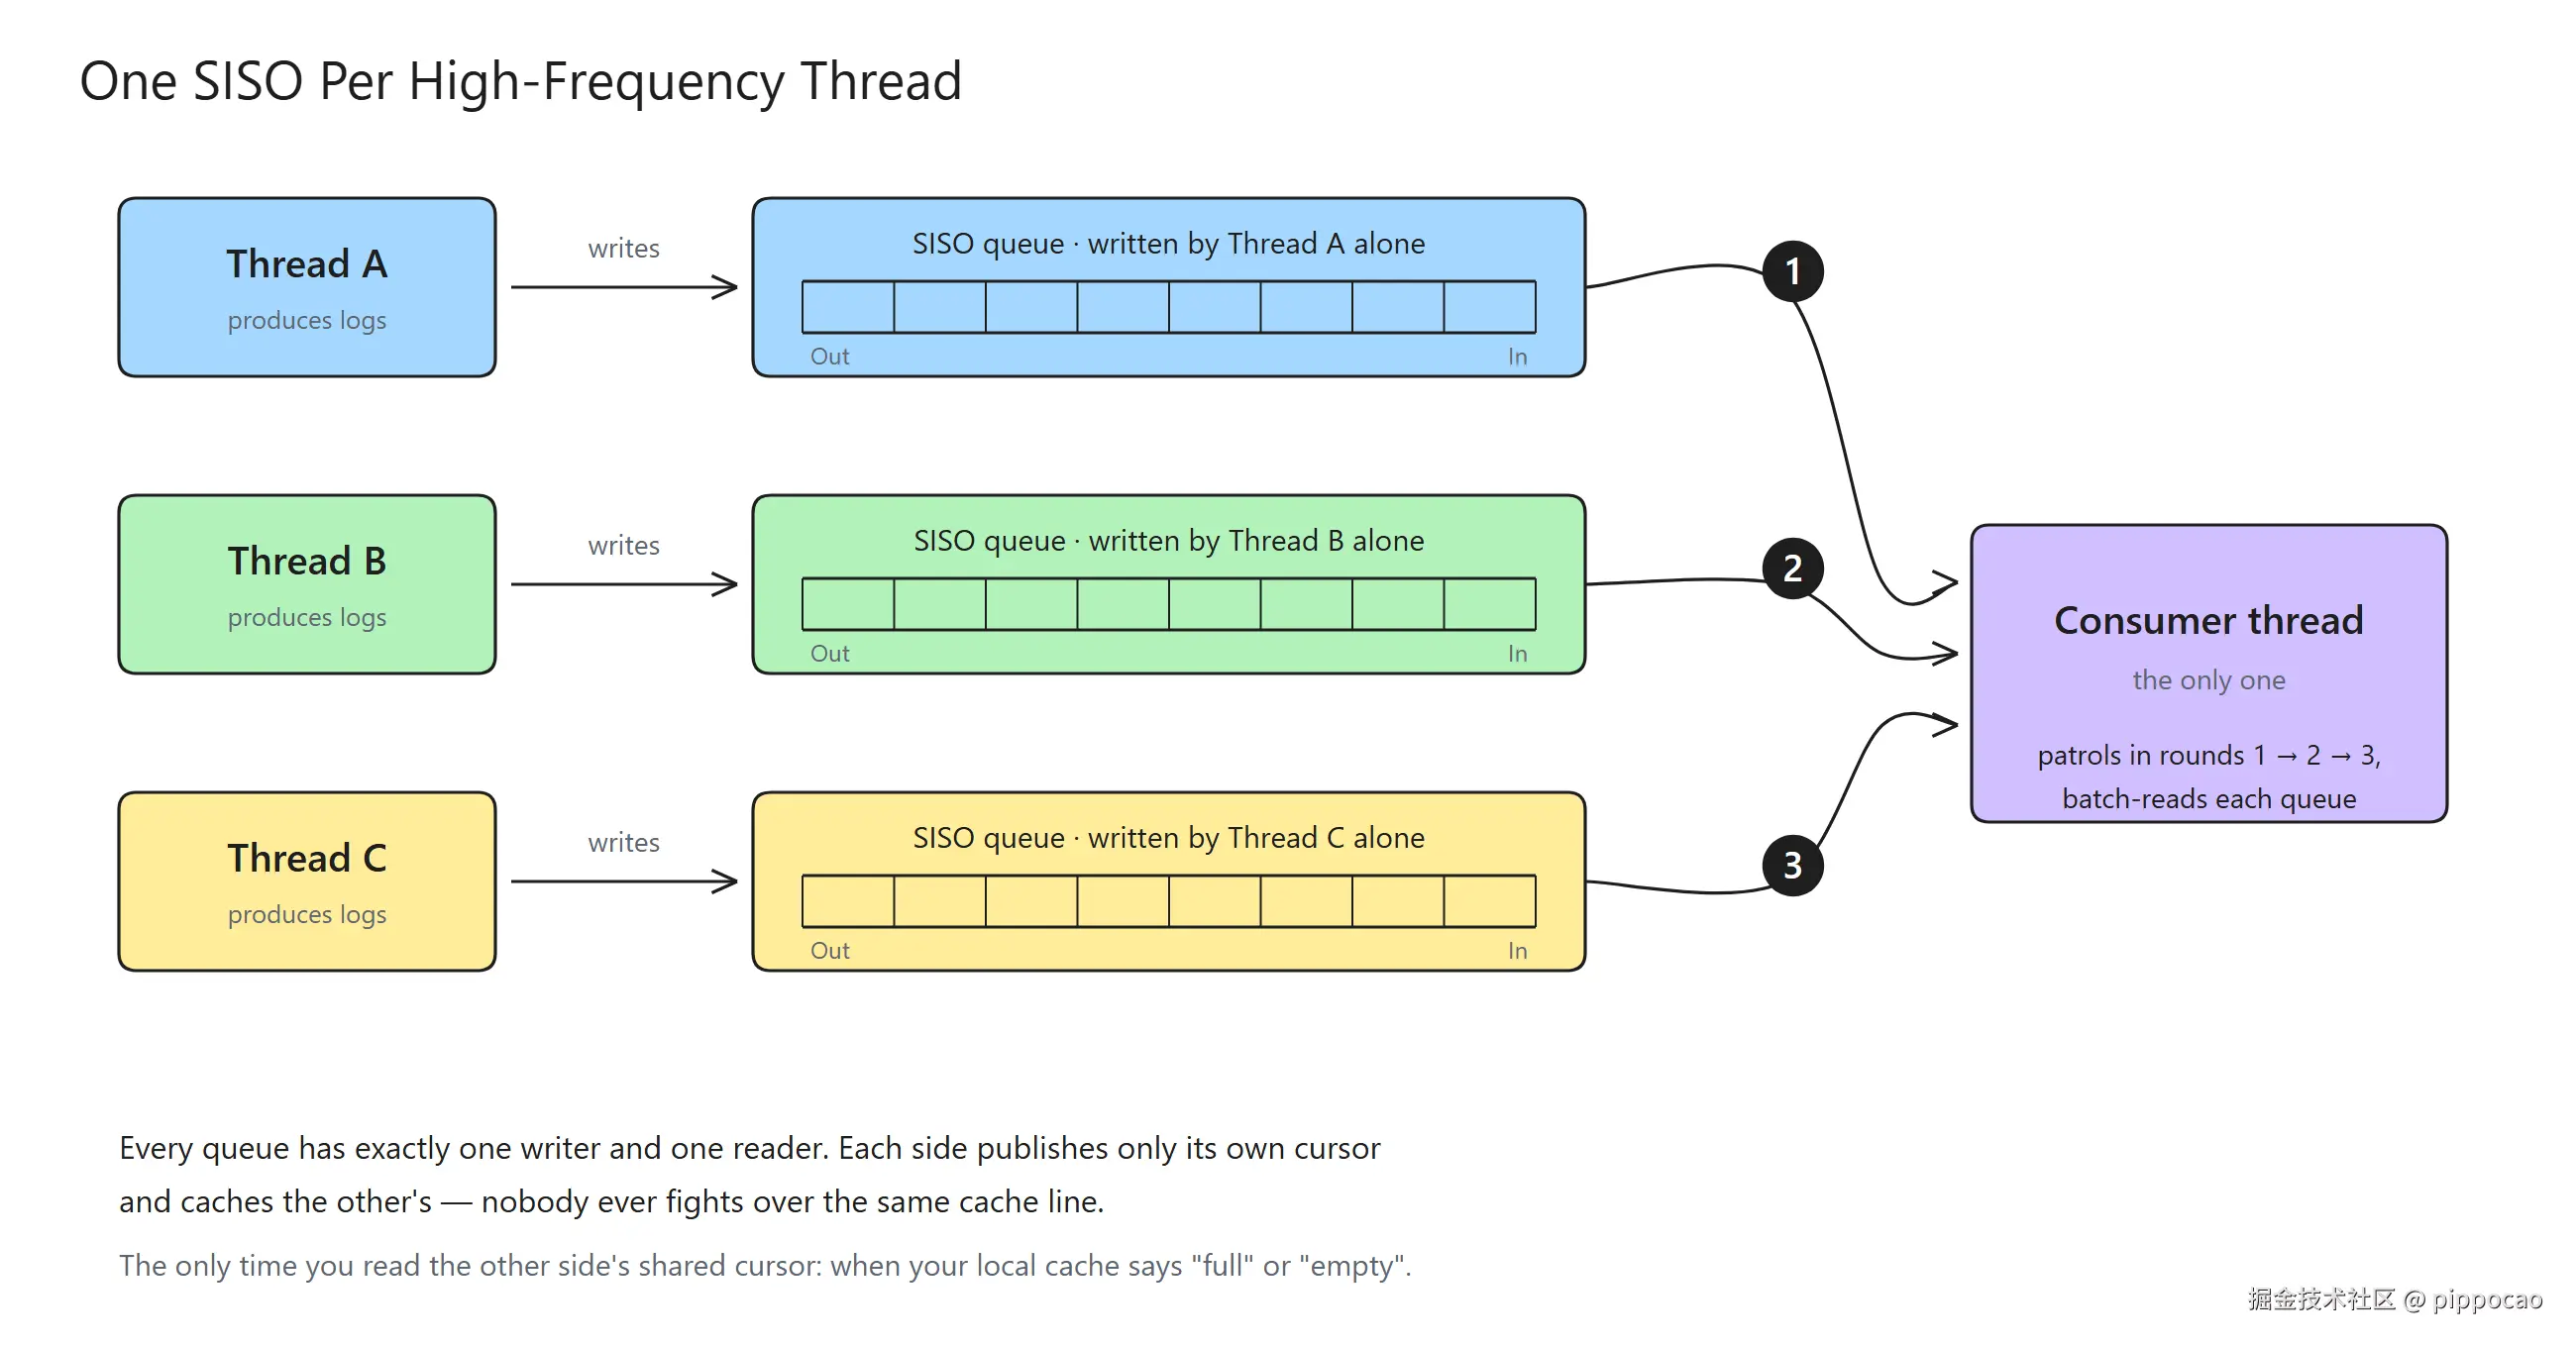
图 10:高频线程分别写入专用 SISO,消费者按顺序轮询并批量读取。
kFifo 里两个游标各归一方就够用了,SISO 的头部为什么却要占四个 C 字节区?因为要让双方平时只用本地缓存的位置,只有空间不足或读空时才刷新对方的共享游标------每个共享游标旁边配一份本地副本,绝大多数访问就不碰共享内存。四个区域分别是:
- 消费者本地状态:缓存的读位置、已知写位置和容量;
- 生产者本地状态:本地写位置、缓存的读位置;
- 共享读游标;
- 共享写游标。
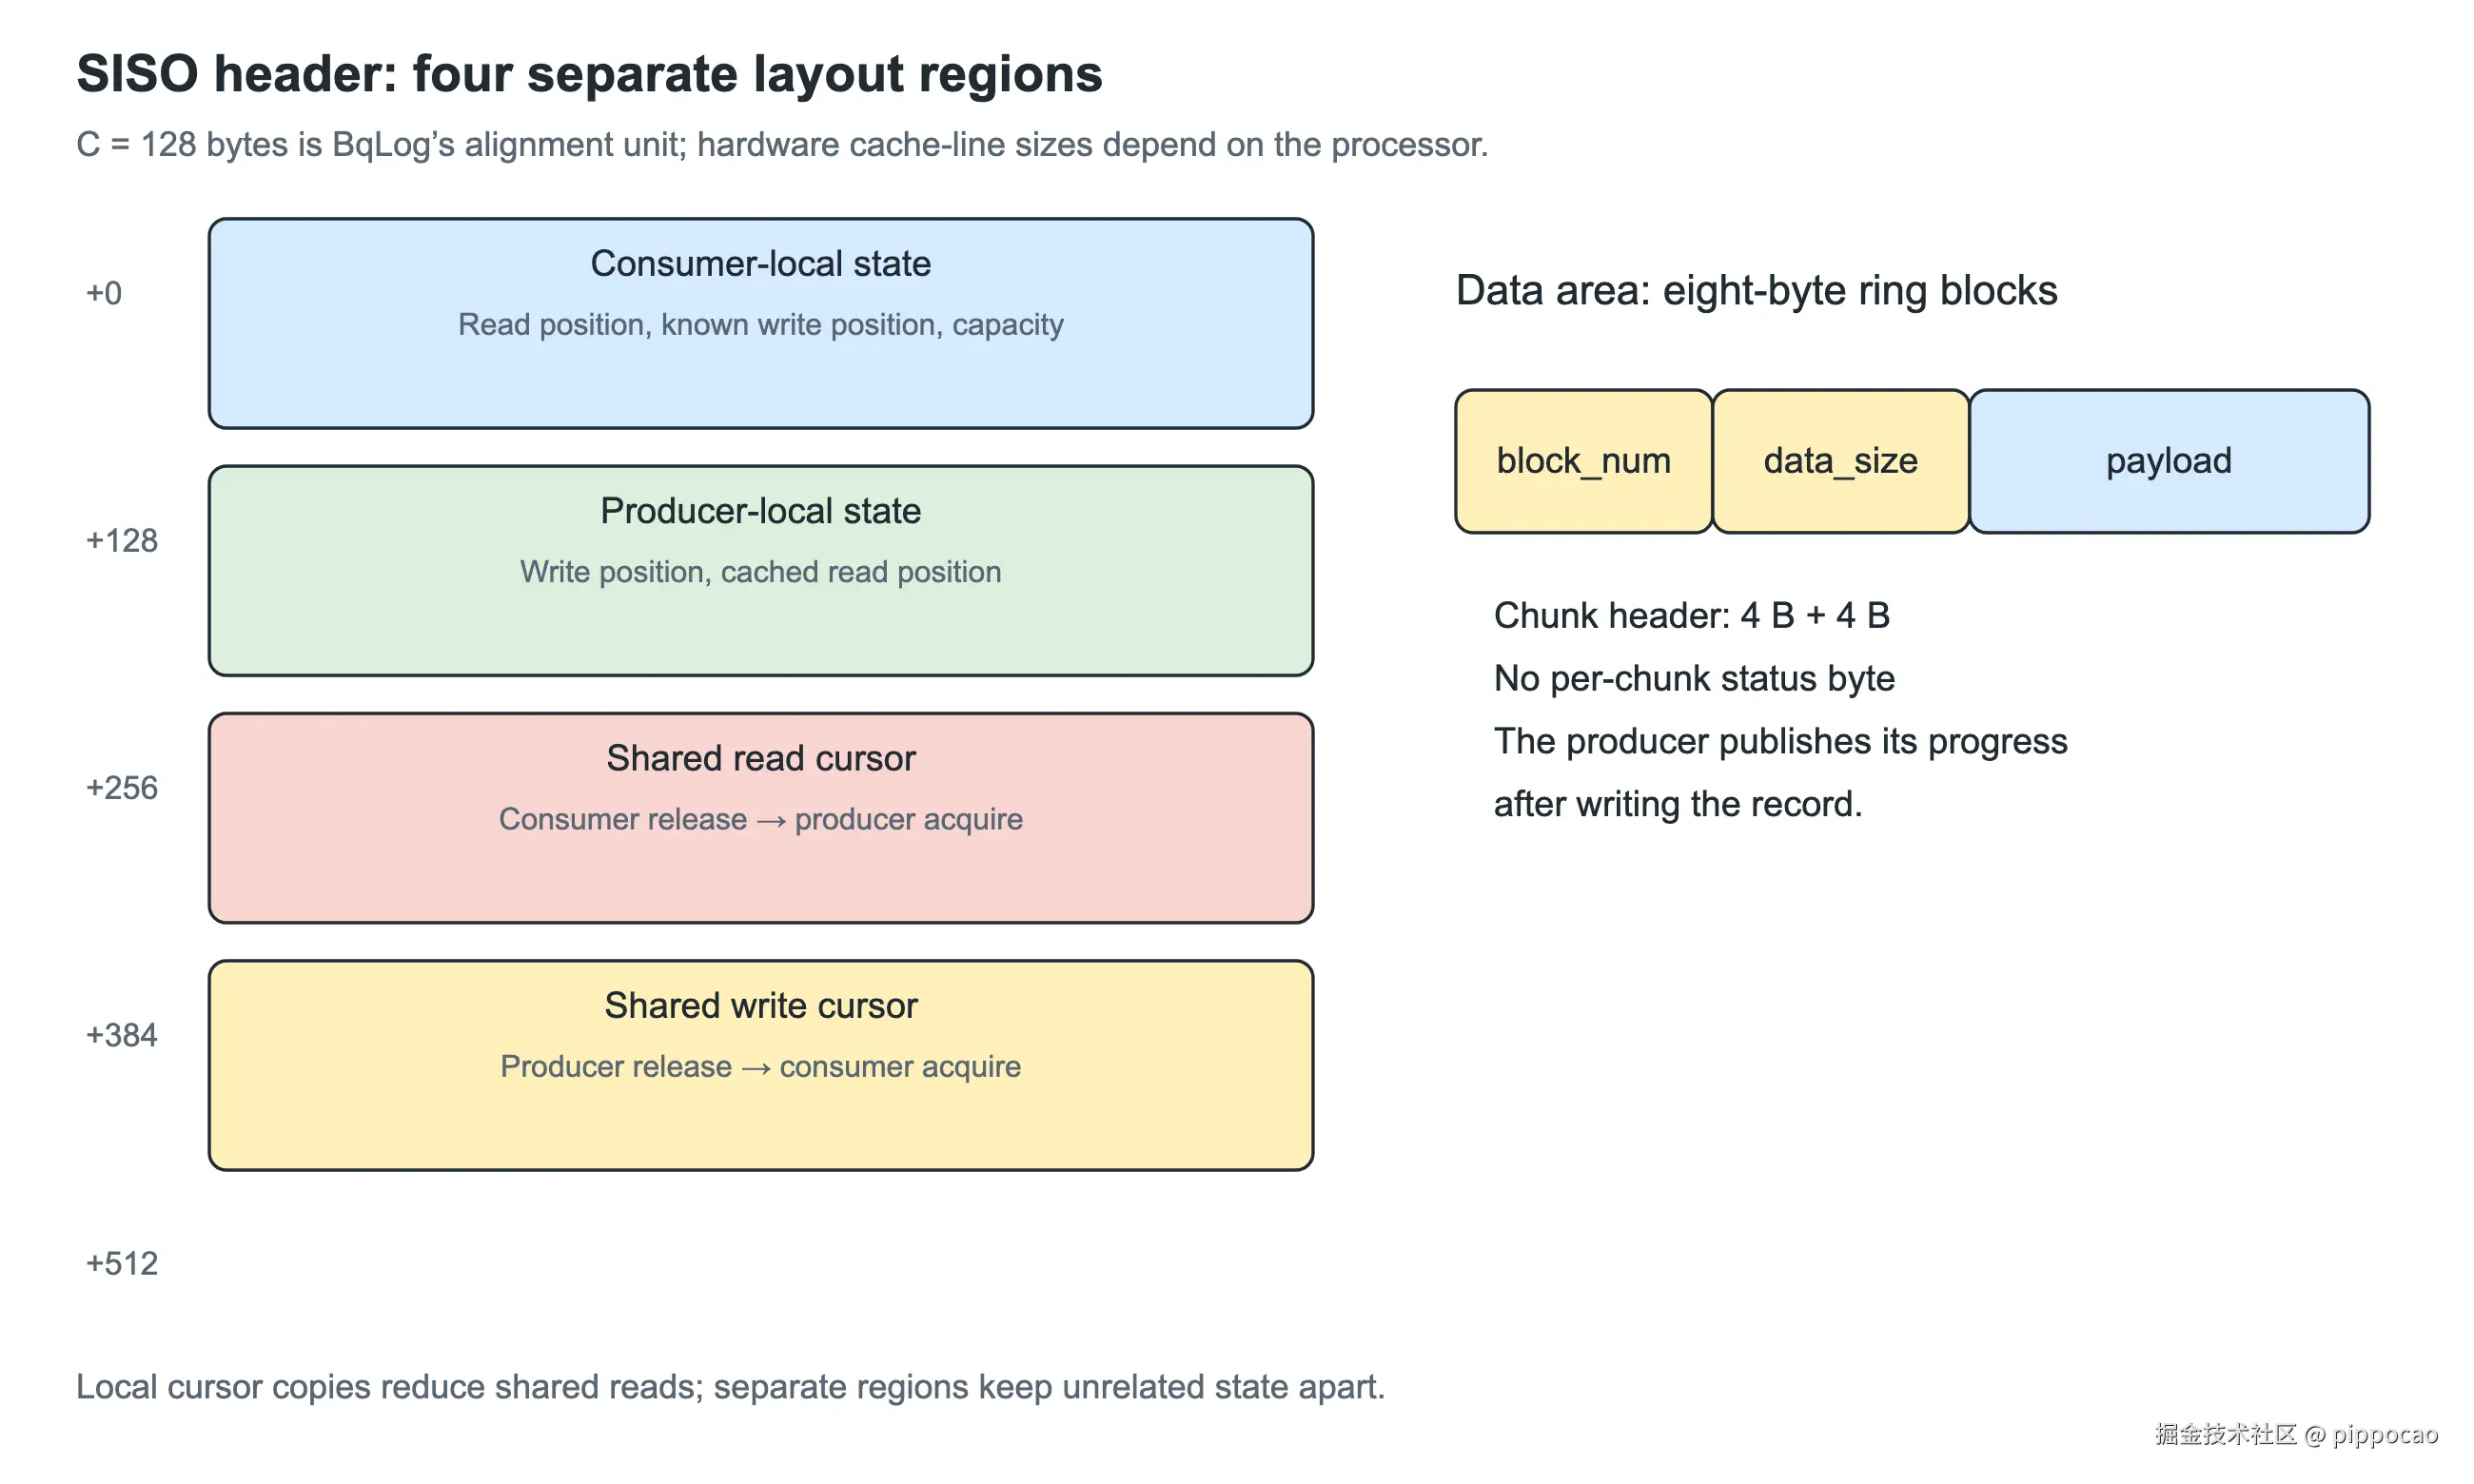
图 11:SISO 头部按四个 C 字节区分开读写状态,后面的数据区按 8 字节单位使用。
单生产者还无需 MISO 的逐块状态位:和 §2.1 的 kFifo 一样,先写数据再推进游标即可,不必按块报完成。chunk 头为 8 字节(block_num 和 data_size 各 4 字节),分配粒度缩到 8 字节。
消费者在一批开始时读取写游标,以该位置为本批终点。读完并归还空间后,再轮询其他队列。批读减少共享游标访问,也避免一个持续写入的线程占住消费者。
5.2 为什么低频线程仍共用 MISO
如果给 1000 个线程各分配 64 KiB,光数据区就占 62.5 MiB,还不包括管理结构。低频线程长期占着专用缓冲,利用率会很低。因此专用 SISO 只分配给高频线程。
BqLog 把两种队列组合起来:
text
LP(Low Performance):低频线程共用一条 MISO
HP(High Performance):每个"线程 × Log"使用自己的 SISO
每个线程的 TLS 按 Log 记录写入频率。默认阈值是每秒 1000 条:达到阈值转 HP,频率降低后退回 LP。这个计数只用于决定是否分配专用缓冲,无需逐条维护精细统计。
顺带说明消费者的数量:默认异步模式下,整个进程的所有 Log 共享一条后台消费线程;也可以给某个 Log 配独立线程,或选同步模式(调用线程直接写,不经过总线)。本文说的"消费者",默认指那条共享线程。
6. SISO 多了以后,怎样管理
每个高频线程都有一条 SISO 后,还得回答三个问题:新线程从哪里领队列,退出时怎样归还,消费者又怎样遍历这些队列。这里还要处理线程随负载加入、退出带来的内存变化。
6.1 为什么不用数组
最先想到的结构可能是数组:把 SISO 对象直接放进去,消费者按下标扫描。在所有线程一起启动、一起退出的 benchmark 里,它很好用。真实程序里的线程却会随时加入和离开。
比如线程池随负载伸缩,或者加载线程写完几条日志就退出。数组这时遇到两个麻烦。
第一,数组扩容可能搬动已有元素,而生产者还持有队列地址。预分配足够大的数组可以避开搬迁,却又要提前占用大量内存。
第二,消费者遍历数组时,生产者可能注册或移除队列。若用一把锁保护整个数组,结构变化就会阻塞消费者。改用指针数组可以保持 SISO 地址稳定,但槽位的发布、复用和队列生命周期仍需同步。
消费者只有一个。它一旦停住,所有生产者仍可能继续写入,队列逐渐填满。因此这里希望线程增删时只锁住局部结构,让消费者继续处理其他队列。
链表更适合这种局部修改:每个 next 指针都可以单独保护,插入和删除不必锁住整个集合。
6.2 把链表修改限制在少数位置
链表节点称为 Group ,是一块连续内存,通常对应一个内存映射文件(mmap)------把缓冲放进文件映射的内存,进程崩溃后内容仍可检查,这正是 §7.3 恢复的基础。Group 内有多个 block。每个 block 先放 128 字节管理区,记录链表索引、链表类型和其他状态;后面原地放 SISO 对象及其数据区。一个 block 对应一条高频线程的专用队列。
这里的 Group block 是队列的管理单元,里面容纳整条 SISO;[第 3 节](#第 3 节 "#3-miso-%E9%98%9F%E5%88%97%E7%94%A8-fetch_add-%E5%88%86%E9%85%8D%E7%A9%BA%E9%97%B4") 的 ring block 则是环内分配记录的单位。下文讨论 Group 时,block 都指前者。
Group 通过链表连接。生产者如果能随意摘除 Group,消费者遍历时会遇到失效指针。因此规定:
生产者只许在头部插;只有消费者能摘。
生产者只在头部插入,新节点指向原来的头节点;消费者这轮看见或下一轮才看见它都可以。摘除只由消费者执行,它在日常遍历时便不需要为每个节点加锁。
锁只用于结构变化。每个节点用读写自旋锁保护自己的 next 指针:
- 生产者找空闲队列时,手递手地获取读锁:锁住下一个指针后,释放上一个。这样消费者不能在它访问节点时将节点摘除。
- 新 Group 插在头部,只短暂锁住头指针,不影响消费者对链表中段的遍历。
- 消费者回收 Group 时,获取前驱链接的写锁,并短暂获取待删除 Group 的 next 写锁,等正在手递手遍历的读者离开。确认 block 全部归还后,再摘除 Group。摘除的 Group 不马上销毁,而是进对象池等待复用------它的完整去向见 §6.5 末尾。
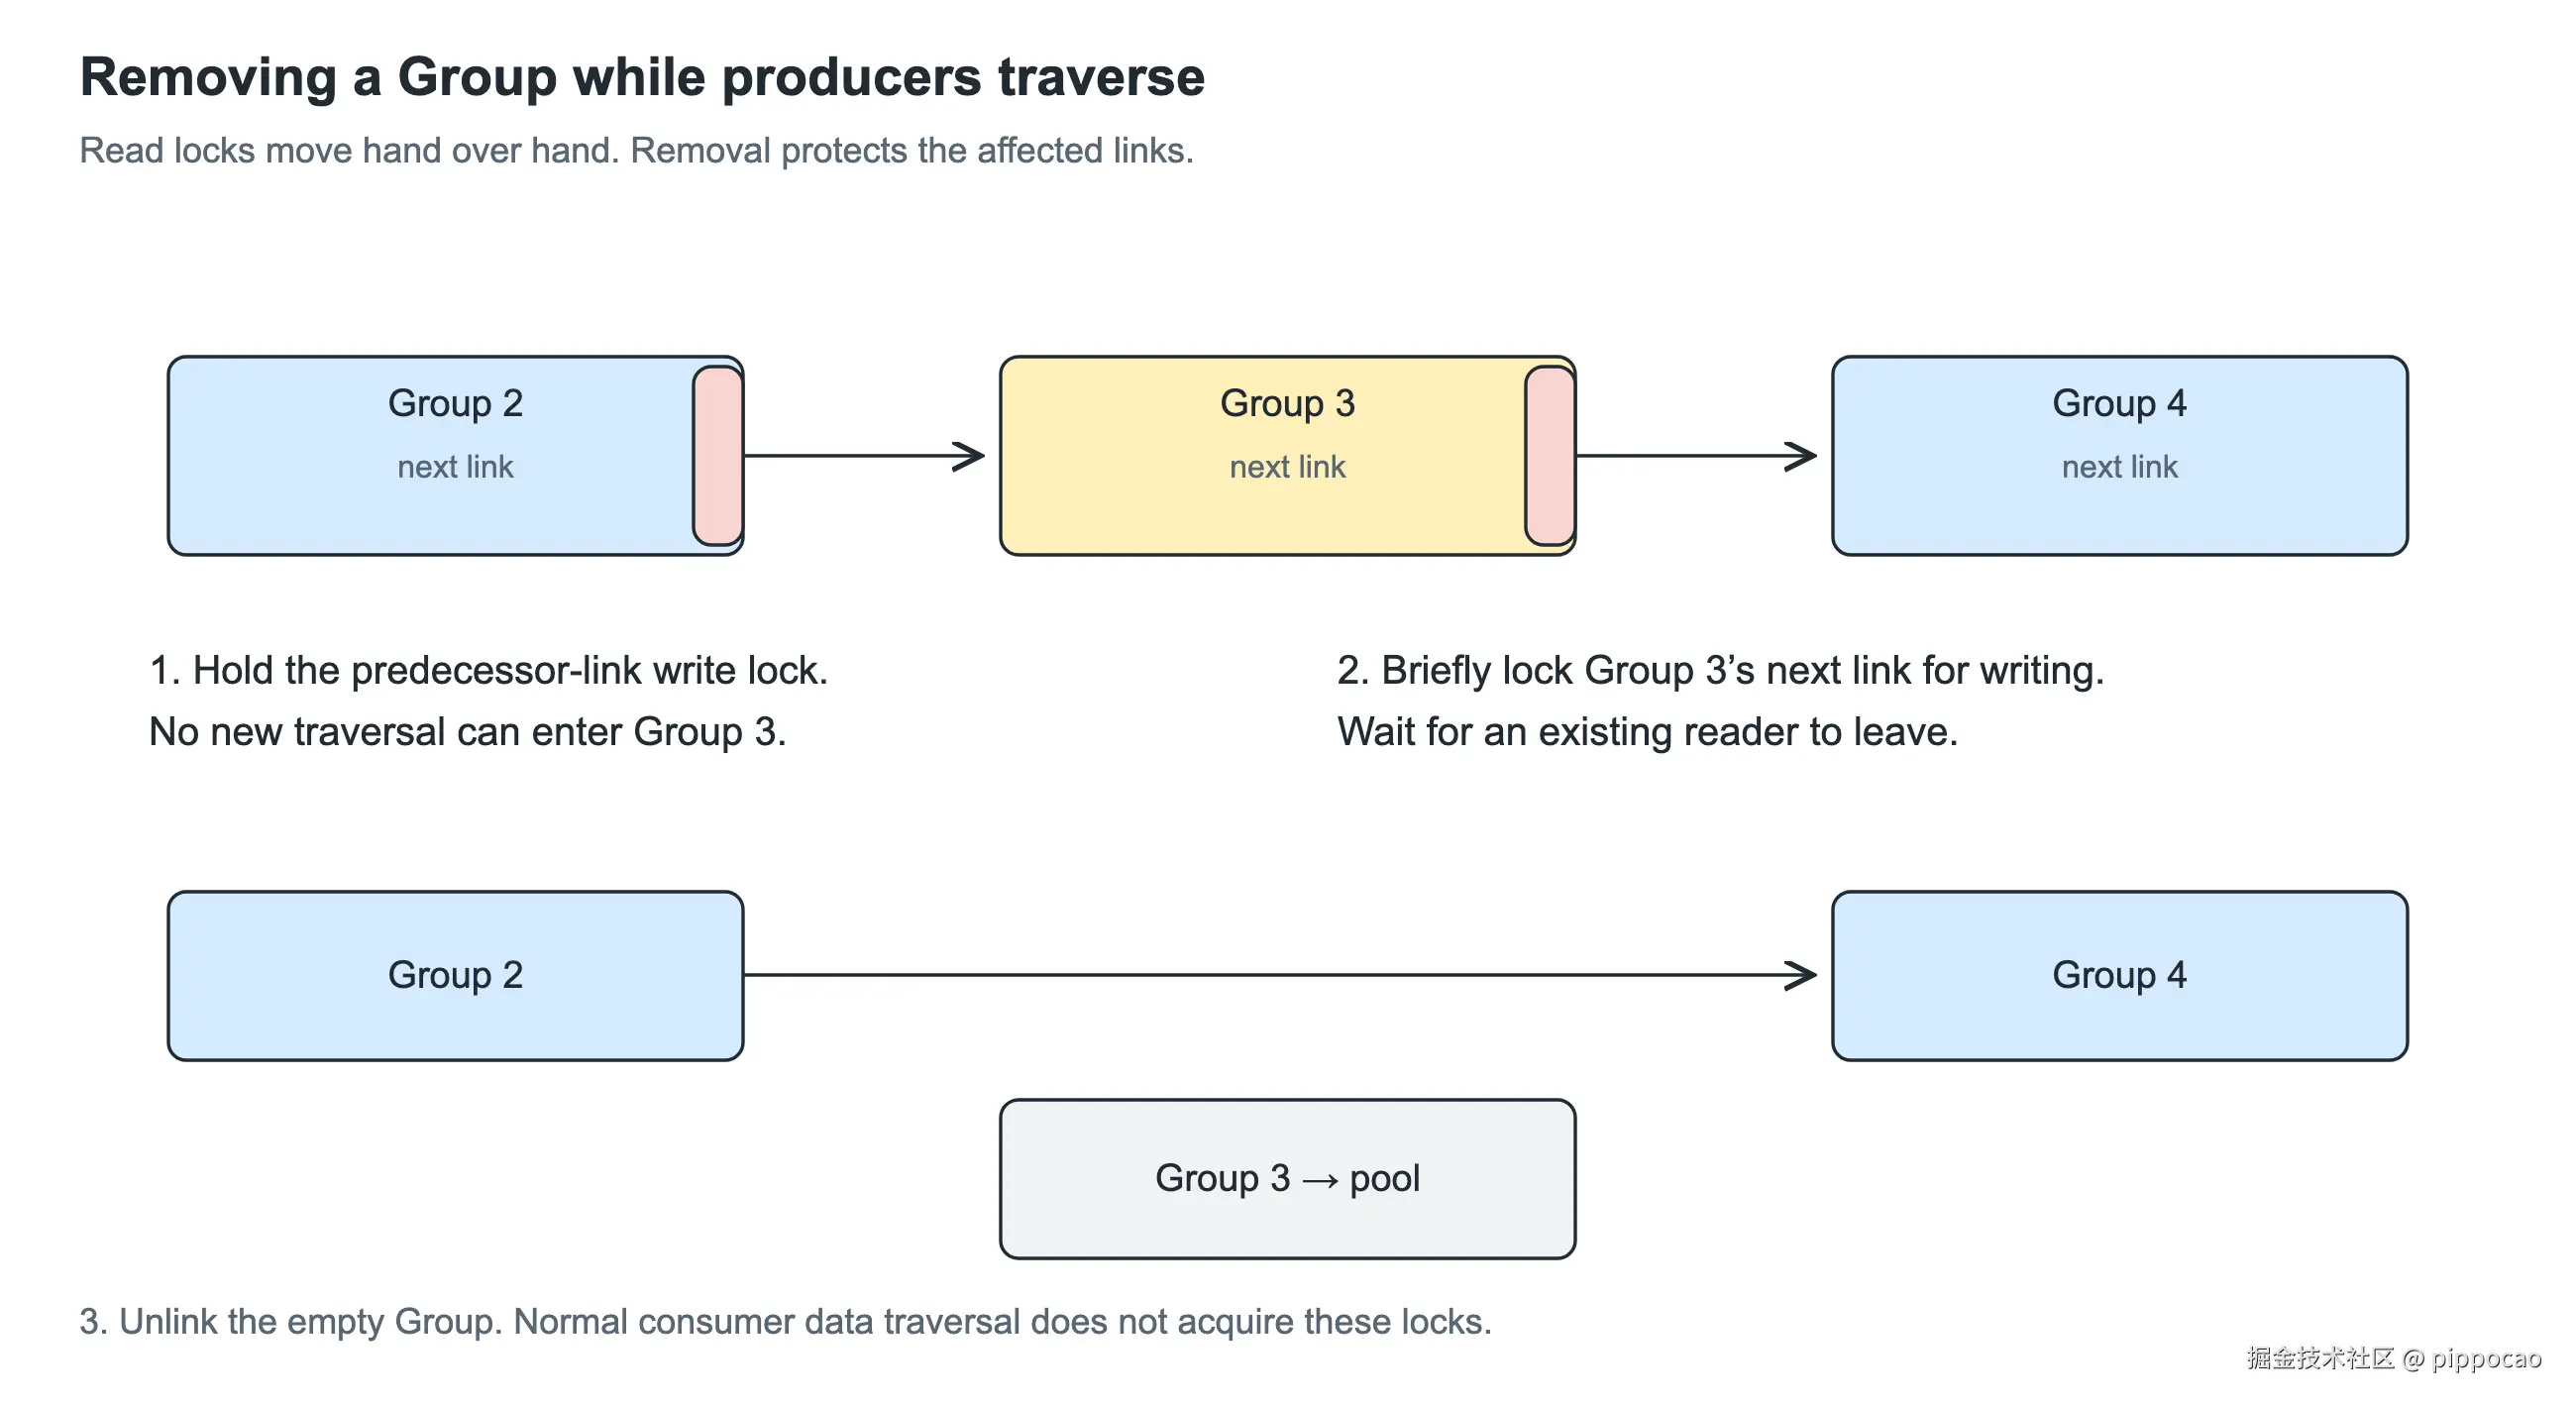
图 12:删除 Group 3 时保护前驱链接,并等待经过 Group 3 的读者离开;消费者平时遍历数据不获取这些锁。
关键是把会修改链表的时机限制在线程加入与回收时;逐条消费日志无需经过这些锁。
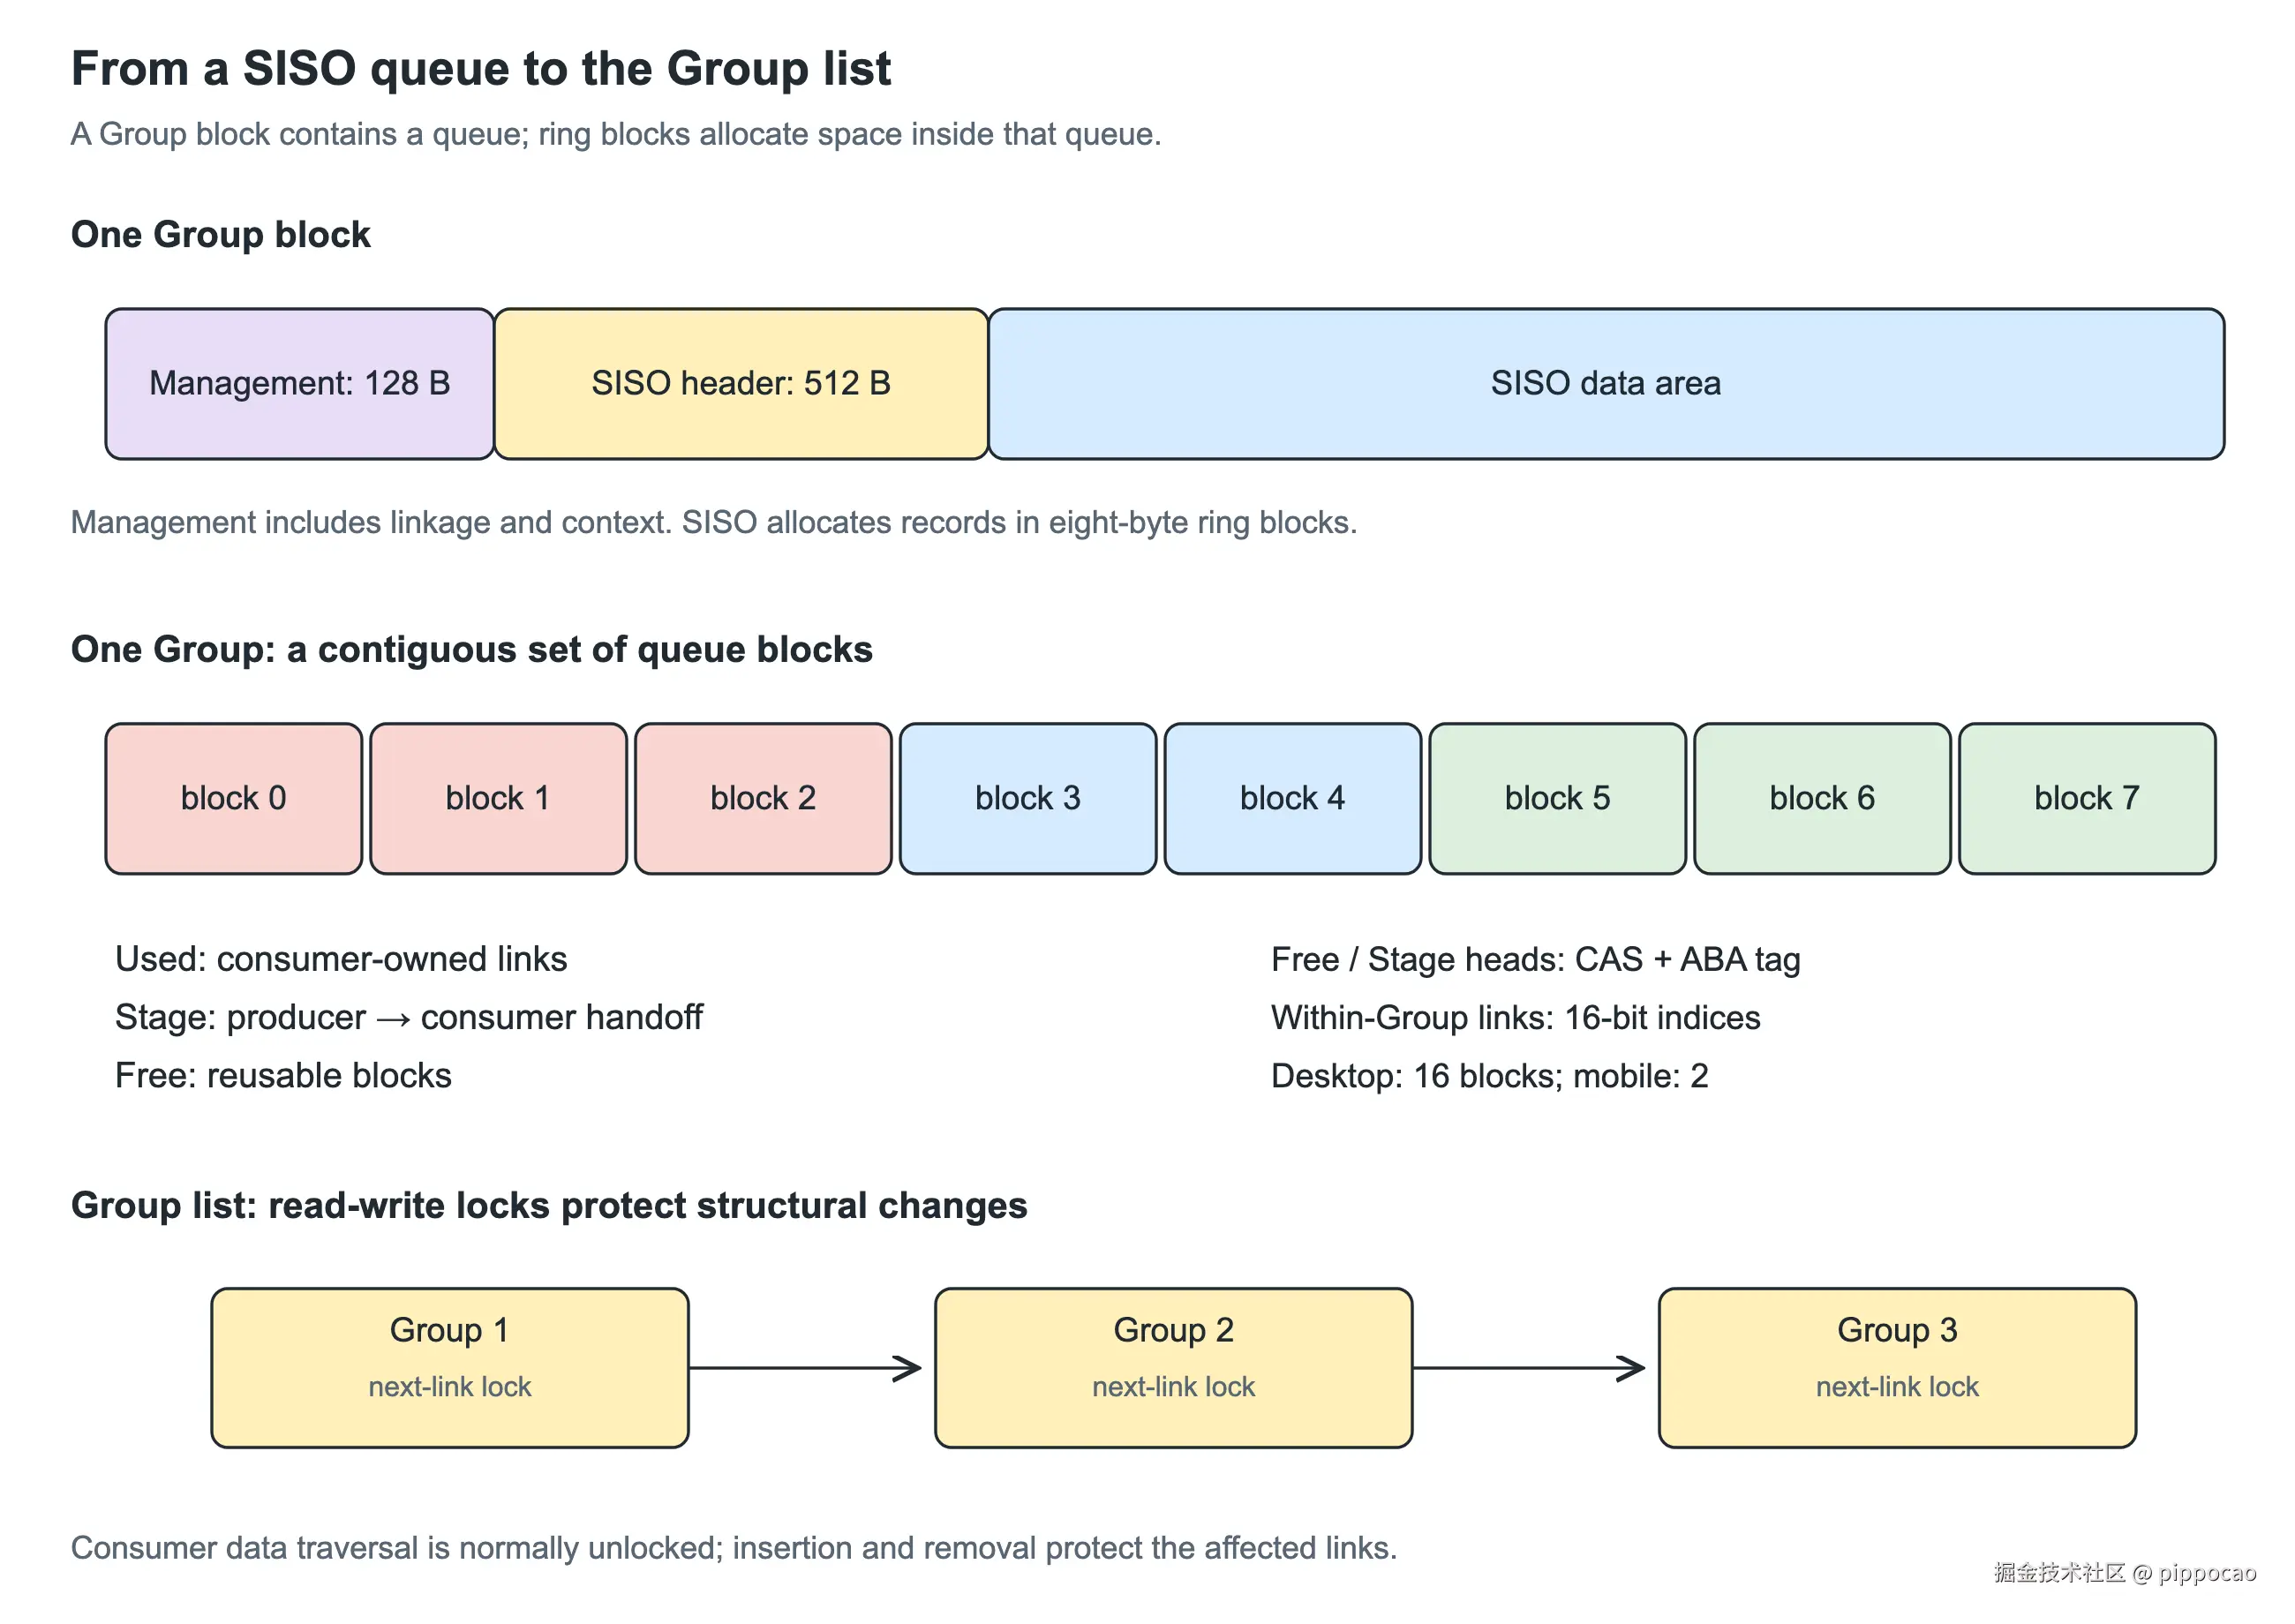
图 13:每个 block 的管理区后是 SISO;多个 block 组成 Group,Group 再连接成链。图中标出了 Free/Stage 头部 CAS 与 Group 指针读写锁这两类同步点。
6.3 Group 内部的三条链
如果 Group 内只有一条带"忙/闲"标志的链,生产者领块和消费者找数据都要扫描、修改它。竞争只是从整个数组缩小到了一个 Group。BqLog 按 block 所处阶段分成三条链:
| 链表 | 生产者 | 消费者 |
|---|---|---|
| Free(空闲链) | 领块时 CAS pop | 回收块时 CAS push |
| Stage(交接链) | 初始化完 CAS push | 轮询时 CAS pop |
| Used(使用链) | 只往自己的 SISO 写数据,不修改链表 | 独占遍历、接入和摘除 |
消费者只有一个,可以独占 Used 链的遍历、接入和摘除。生产者在升级到 HP 时,从 Free 取一个 block,初始化后放进 Stage。生产者与消费者同时访问的只有 Free 和 Stage 的头部,CAS 集中在这些低频操作上。
Free 和 Stage 的头部有多个线程访问,用 CAS 更新还要处理 ABA。假设 Free 原来是 A→B→C,线程甲记住头节点 A 和后继 B,随后暂停;其他线程取走 A、B,又把 A 归还。甲醒来时,头仍是 A,但 B 已经在使用中。只比较 A 的 CAS 会错误地把头设为 B。
头部因此用 32 位同时保存"16 位 block 索引+16 位递增标记"。A 再次成为头时,标记已经变化,甲的旧 CAS 就会失败。标记随更新递增,按 16 位计数循环。Used 只有消费者修改,链接操作使用普通赋值即可。
为什么要多设一条 Stage?生产者如果直接往 Used 上挂节点,就会撞上正在遍历的消费者。先把初始化好的 block 推到 Stage,消费者轮询时自己取出来、自己接入 Used,Used 链就始终只有消费者一个修改者。
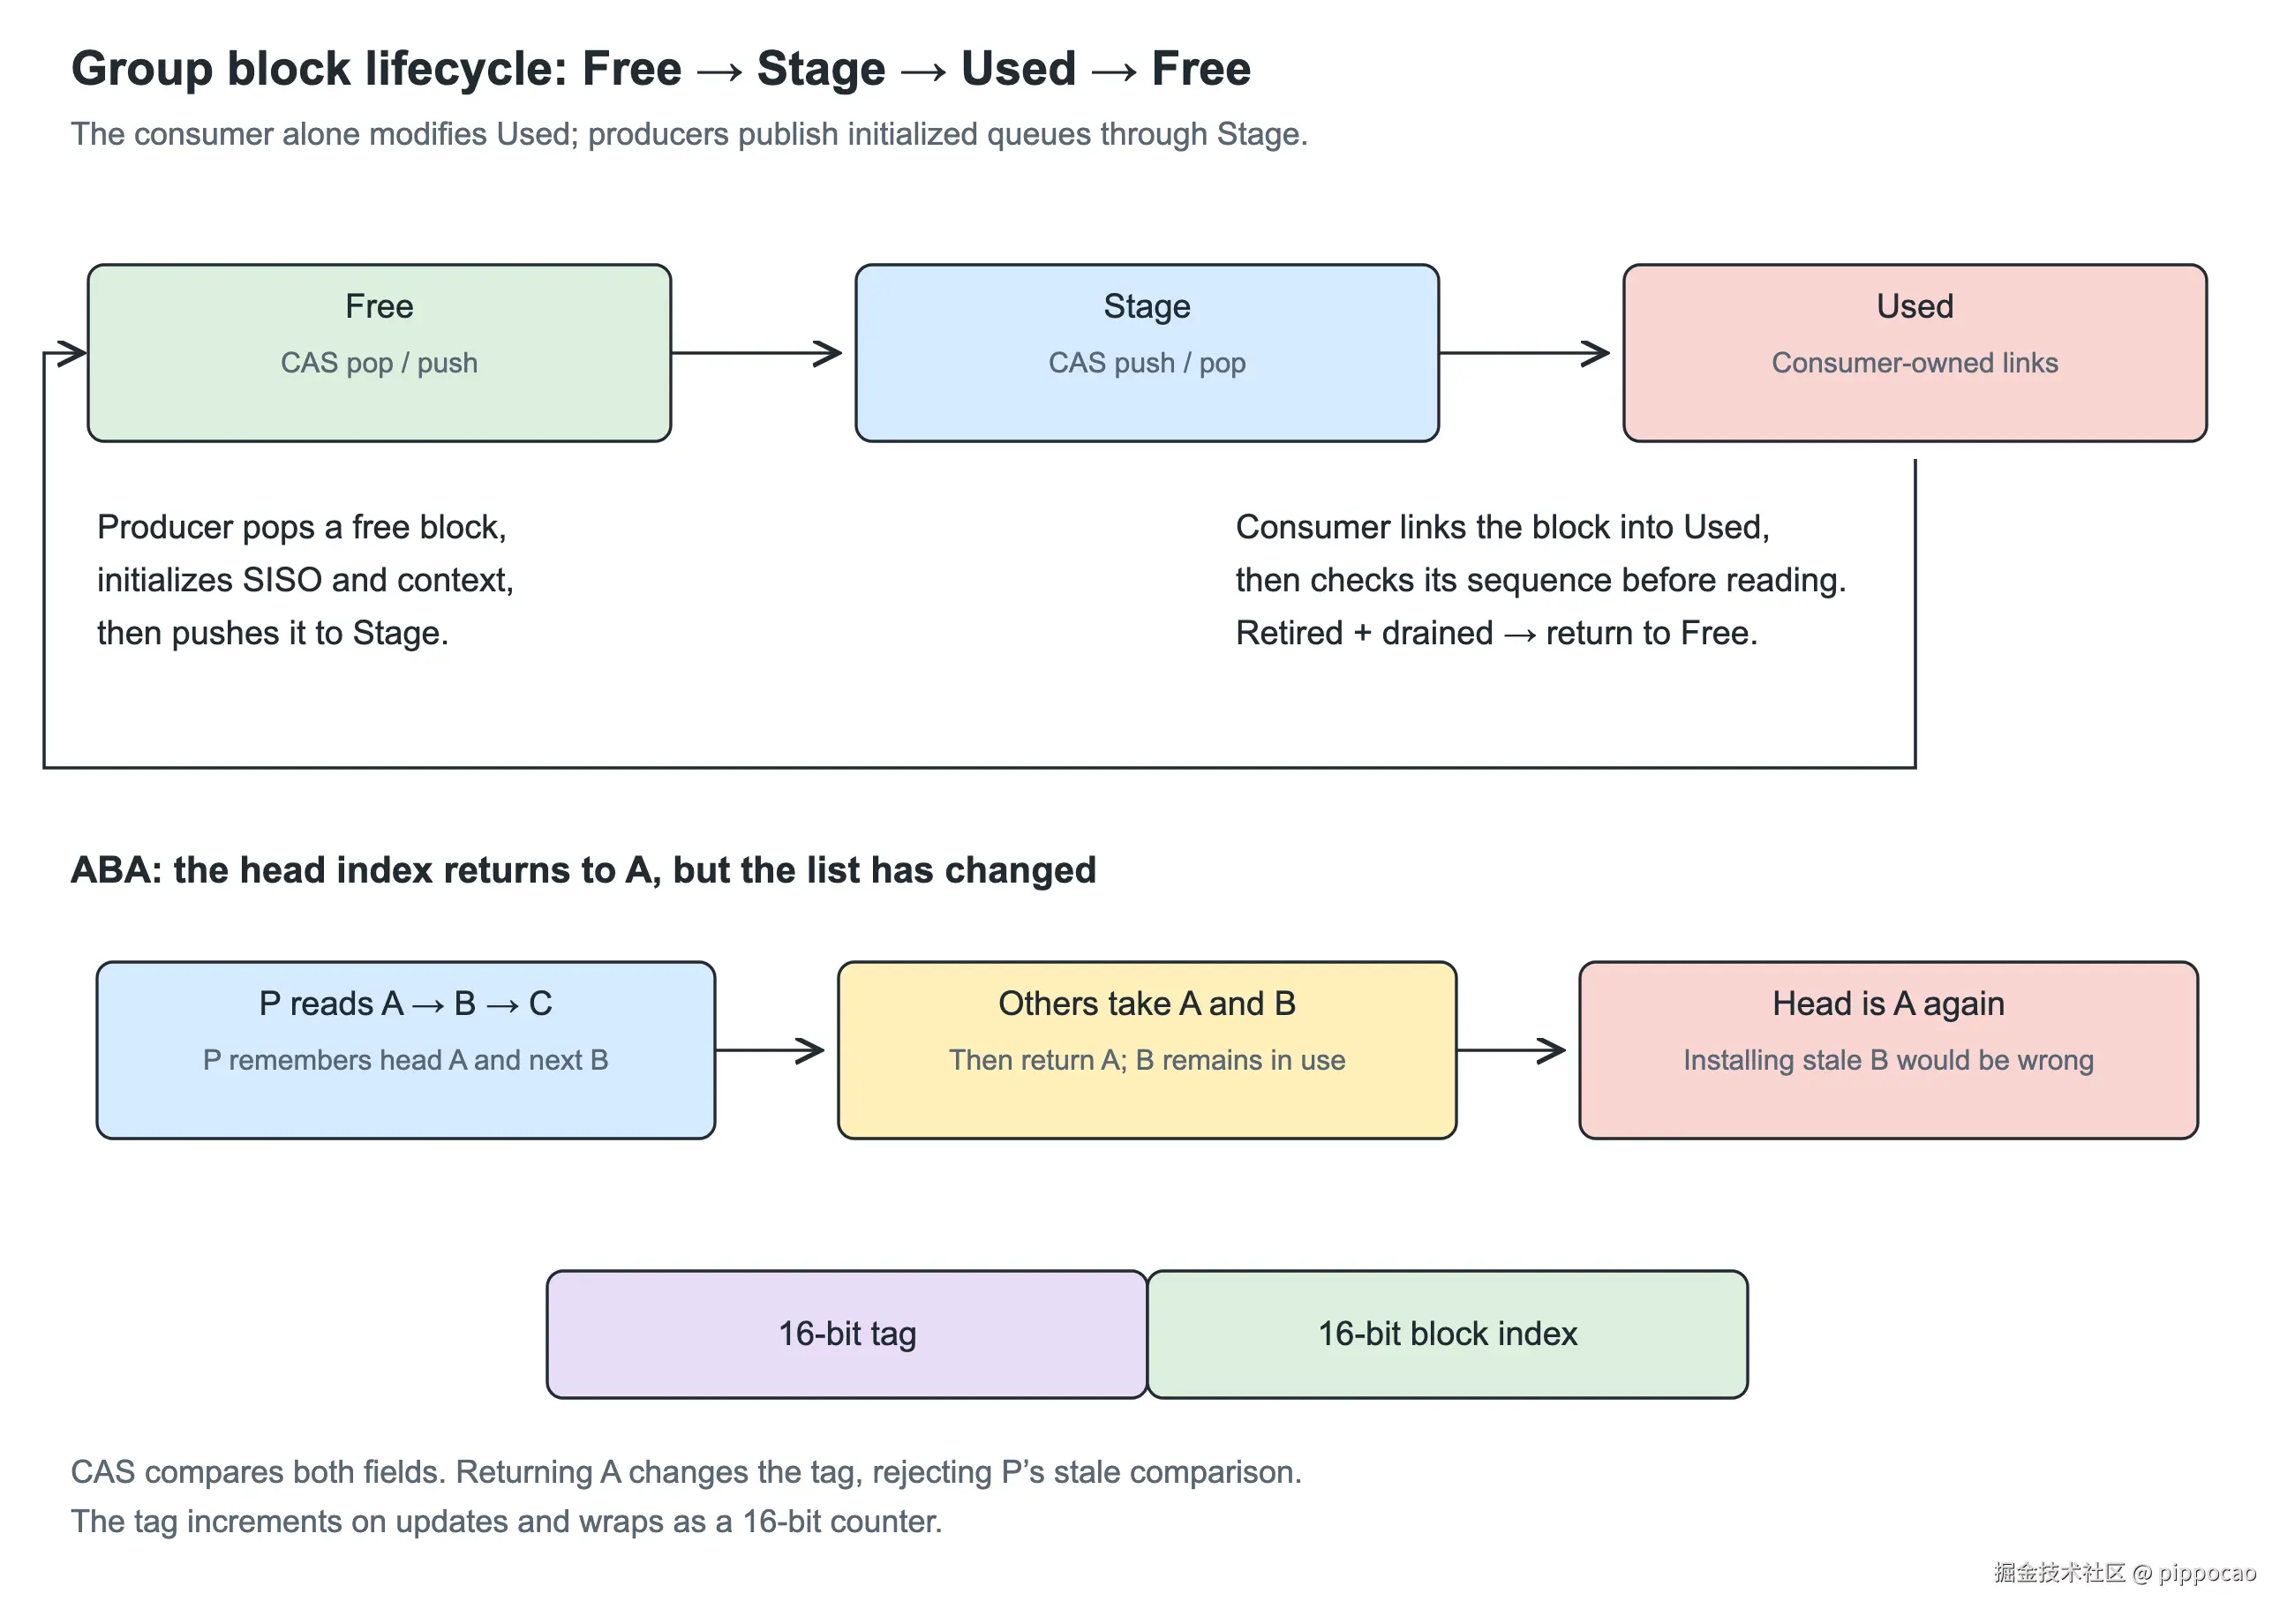
图 14:生产者从 Free 取 block,初始化后放入 Stage;消费者将它移到 Used,退役后再放回 Free。Free 和 Stage 的头部带 ABA 标记。
链表用 16 位索引 连接 block,FFFF 表示空。block 在 Group 中连续排列,索引足以定位。mmap 重新映射后基址可能改变,原指针不能继续用,索引则仍然有效。恢复时会用到这个性质。
6.4 Group 的大小
Group 可以只放一个 block,但把多个 block 放在一起有几个实际好处:
- 一次 mmap 可以为多个队列提供内存,不必每个线程单独申请。
- 每个 Group 对应独立的 mmap 文件。文件头保存 Log 配置的校验和,恢复时可逐个检查,单独丢弃损坏文件。
- 摘除的空闲 Group 进对象池等待复用,不必马上销毁。
桌面平台一个 Group 装 16 个 block;内存紧张的移动平台装 2 个。
6.5 空位很多,为什么内存还回收不了
假设三个 Group 各剩一条活跃队列。虽然大部分 block 已经空闲,但三个 Group 都不能整体释放。只等线程退出,可能长期收不回这部分内存。这和内存碎片是同一个问题:活跃数据太散,整块的资源就腾不出来。
BqLog 的做法是主动归拢,就像内存碎片整理------但经典碎片整理搬的是存活数据,这里整理的对象是写入的去向:在用的队列原地不动,只有"以后的写入"改道去前面的空洞。分五步:
- 消费者沿链表轮询时,顺手累计前方(靠近头部)Group 里空位的数量;
- 空位有富余,就给后方 Group 里的活跃 block 打上"需要重新分配"的标记;
- 生产者下次写日志时看到标记:把旧 block 标为移除,从最靠前有空位的 Group 领一个新 block,写入不中断;
- 新日志进新队列;旧队列由消费者继续读空,顺序由 seq 保证(见本节末尾);
- 读空的旧 block 回到 Free;一个 Group 完全腾空后被摘除、进对象池。
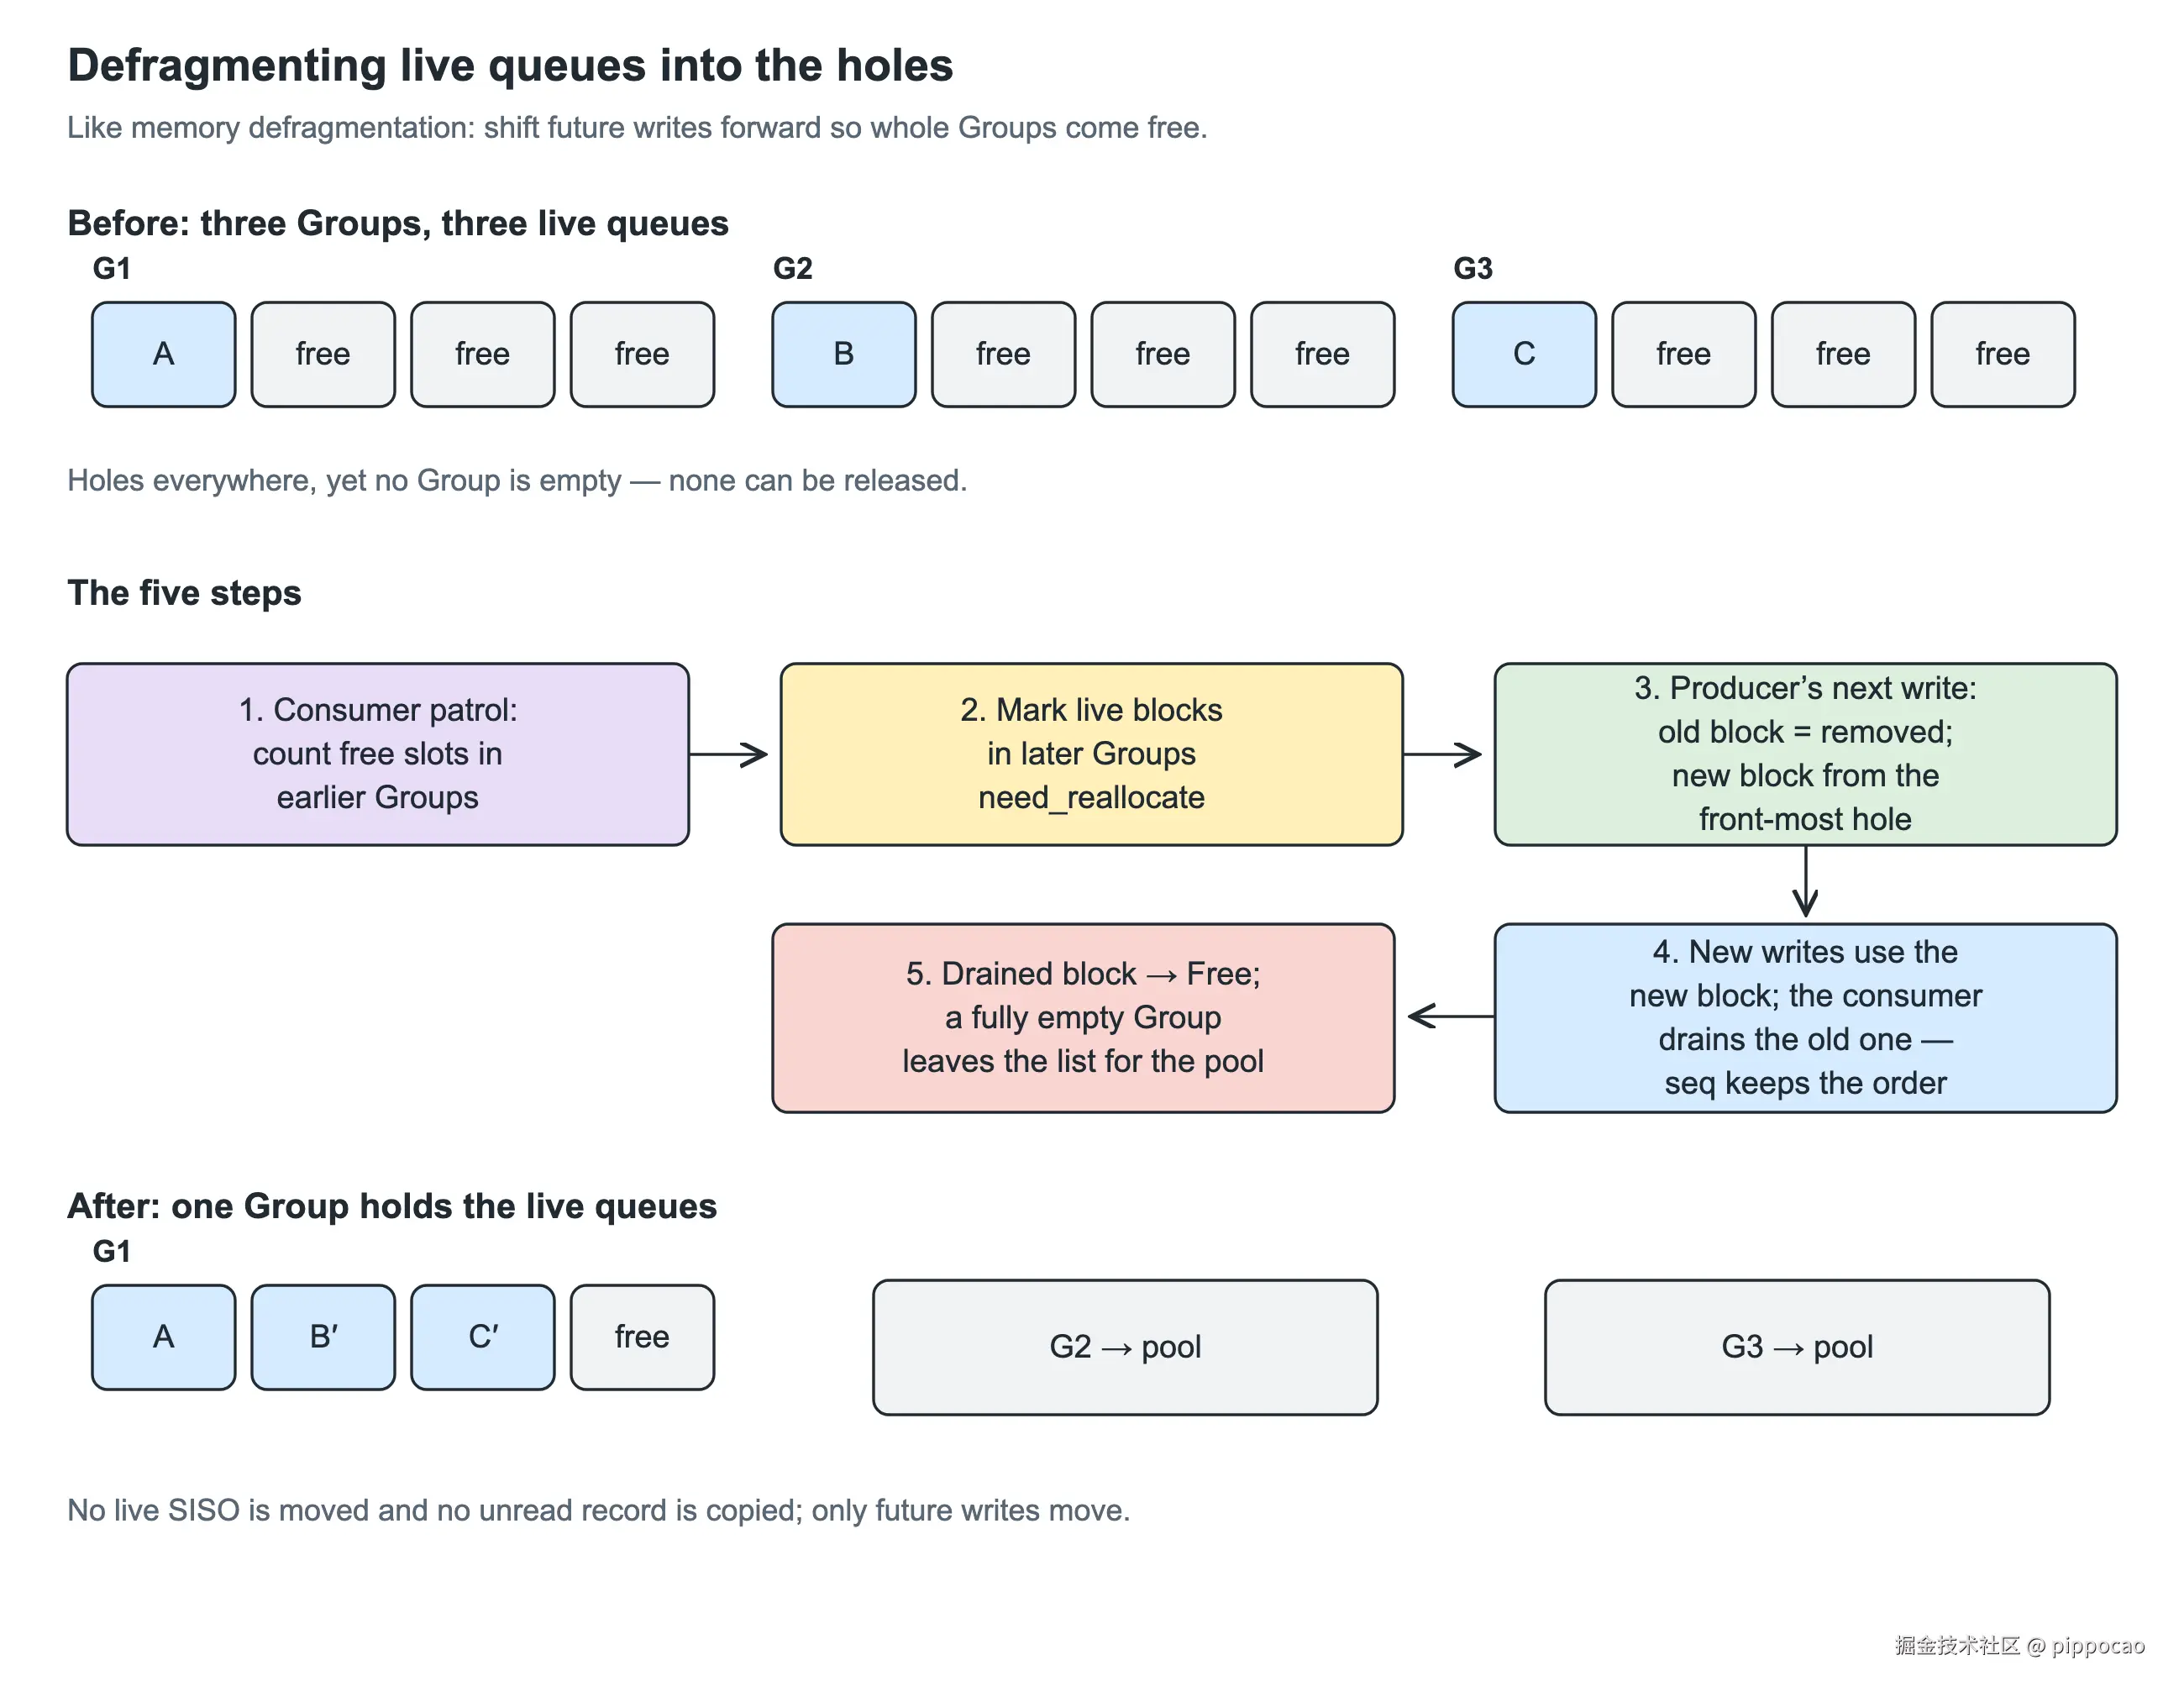
图 15:归拢的五步。空位总从最靠前处补齐,靠后的 Group 更容易整体腾空------归拢收敛,不会来回震荡。
腾空的 Group 由消费者从链表摘除(§6.2 的双写锁)后进对象池,去向是"复用优先,销毁殿后"。建一个 Group 要一次 mmap 加初始化,而池里的 Group 下次取用不用再付这两笔;池按后进先出取用,刚归还的那个最可能还留在 CPU 缓存里。
池子会不会越攒越多?不会。新 Group 只在"池空了、且所有 Group 都满了"的时候才创建,所以池里的 Group 最多就是程序历史上同时活跃过的峰值;峰值过后它们留在池里当缓存,负载回来时直接复用。这是有上限的缓存,不是泄漏。
直到 Log 销毁(通常就是进程退出),销毁才真正发生:解除 mmap 映射、关闭文件句柄;mmap 文件默认留在磁盘上,正是 §7.3 崩溃恢复要读的数据(不需要恢复的模式下,下一次启动会清掉这个 Log 的 mmap 目录)。代码里还留了一个超时逐出接口(garbage_collect),供单元测试演练销毁路径;生产路径不调用它------按上面的上限,也用不上。
换 block 还有一个问题要回答:同一线程的日志分散到了两条队列里,消费者按什么顺序读?答案不需要新机制:新旧 block 各带一个递增序号(seq),消费者按序号接回先后------高低频切换用的就是这套规则(§7.2 有完整例子),顺序机制没有为归拢新增一行。另外,标记只在生产者下一次写入时生效;线程若转为低频或直接退出,旧 block 也会沿同样的移除路径读空归还,不存在永远挂着的标记。扩容也沿用换 block 的方式:新记录进新 block,旧记录原地排空。
6.6 管理成本在什么时候支付
线程升级、降级、退出,以及扩容、归拢时,才需要领取或归还 block。高频线程稳定写入时,只访问已领取的 SISO,Free、Stage、Used 不参与逐条记录的写入。Group 负责把内存分配和生命周期管理集中起来,专用队列负责日常的数据传递。
7. 用三个场景串起这套结构
单独看每条链表还不容易看出它们如何配合。下面依次看线程加入、频率切换和崩溃恢复。
7.1 场景一:一个新的高频线程加入
假设业务线程在一秒内达到 high_frequency_threshold_per_second(默认 1000 条),需要从 LP 升级到 HP。它领取专用 SISO 的过程如下:
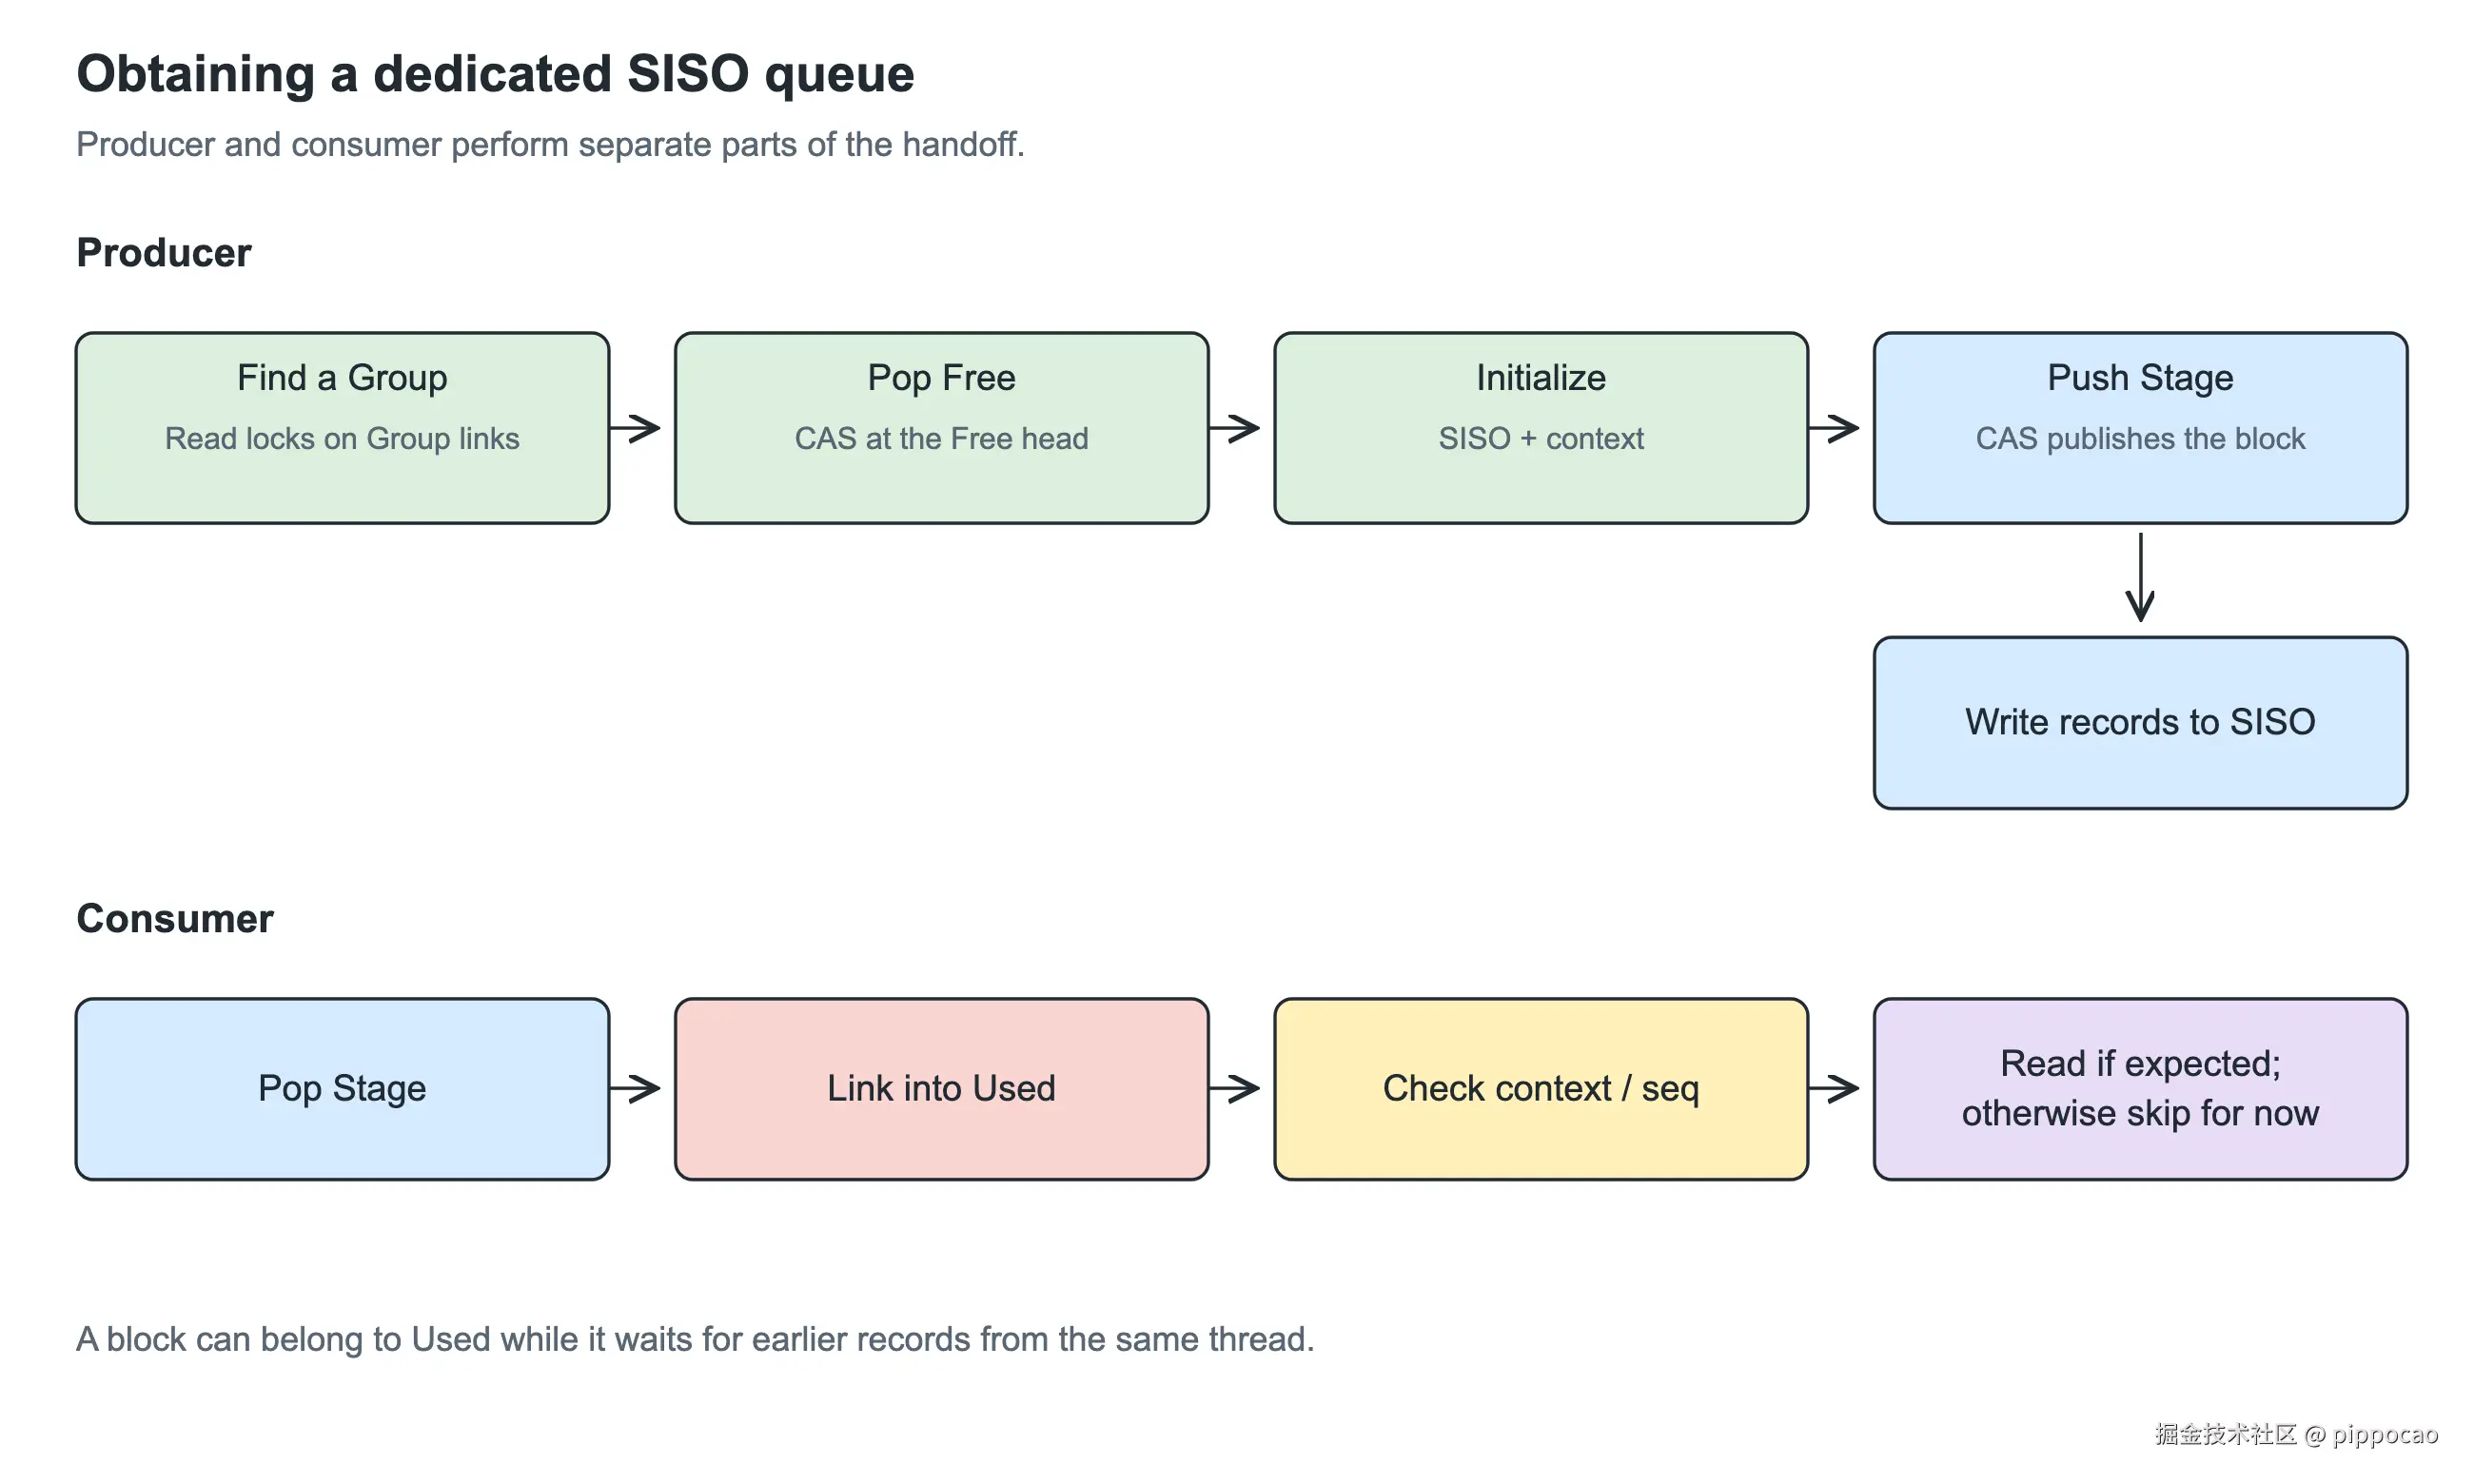
图 16:高频线程从 Free 取 block,初始化后放入 Stage,随后由消费者接入 Used。
生产者执行四步:
-
- 在 Group 链表中寻找空闲 block,遍历时手递手地获取读锁,再从 Free 头部用 CAS 取出 block。若所有 Group 都已用满,才创建新 Group 并插入链表头部。
-
- 原地初始化 block 内的 SISO,在管理区写入 16 字节 context,包括版本、序号和 TLS 身份。
-
- 用 CAS 把 block 推入 Stage。
-
- 开始向这条 SISO 写日志。
消费者轮询到该 Group 时,从 Stage 取出 block,接入自己管理的 Used 链,再核验 context。若尚未轮到它的 seq,就先跳过,后续轮询再检查。接入 Used 表示消费者已接管其生命周期,是否立即读数据则由顺序检查决定。
7.2 场景二:一个线程在高低频之间来回切换
每条队列内部都有序,为什么最终文件还可能乱序?问题出在同一线程切换 LP 和 HP 时。
一个线程先在 LP 写日志 A,升级到 HP 后写 B、C,降级回 LP 后再写 D。
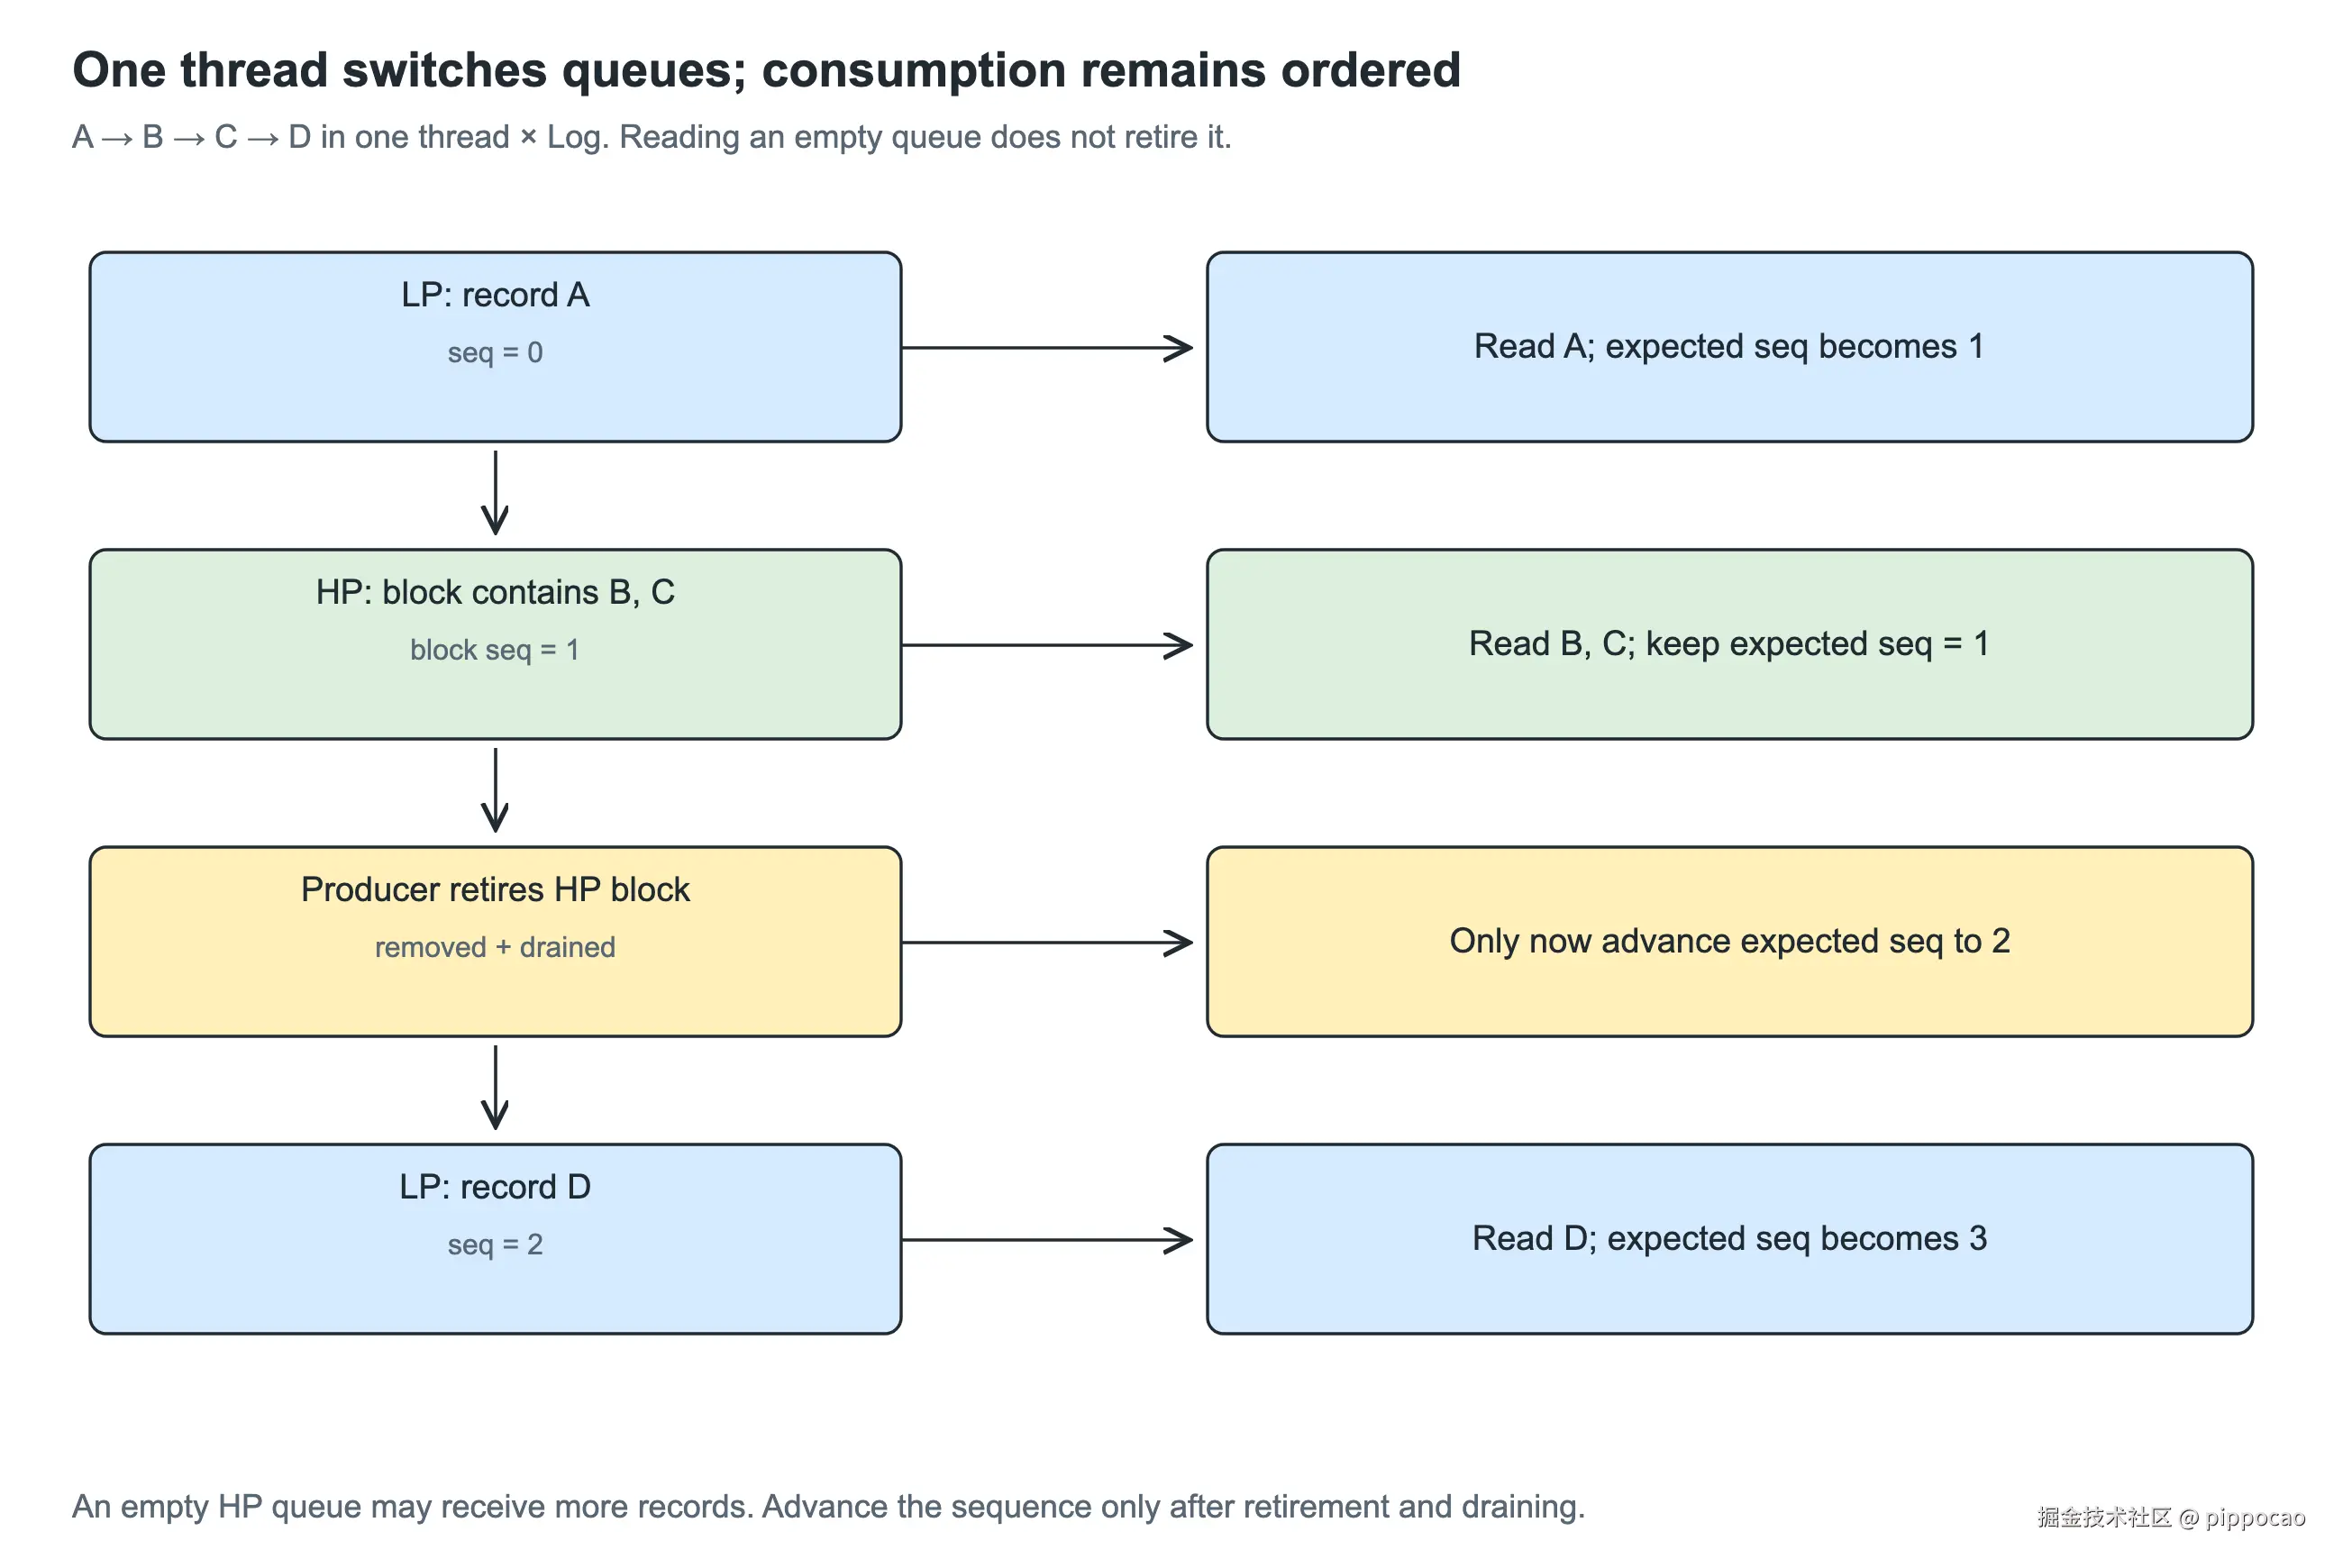
图 17:同一线程在 LP、HP、LP 三个阶段写入 A、B、C、D;context 序号把同一线程跨队列的写入顺序接起来。
LP 与 HP 各自有序,但消费者轮询时可能先碰到 B、C,也可能在处理 B、C 之前就碰到 D。仅靠队列自身顺序,无法还原这个线程写入 A、B、C、D 的先后。
BqLog 用 16 字节 context 记录版本、顺序和所属线程。seq 在同一"线程 × Log"内递增:LP 每条记录用一个号,HP 每次领取一个 block 用一个号,块内记录共用。
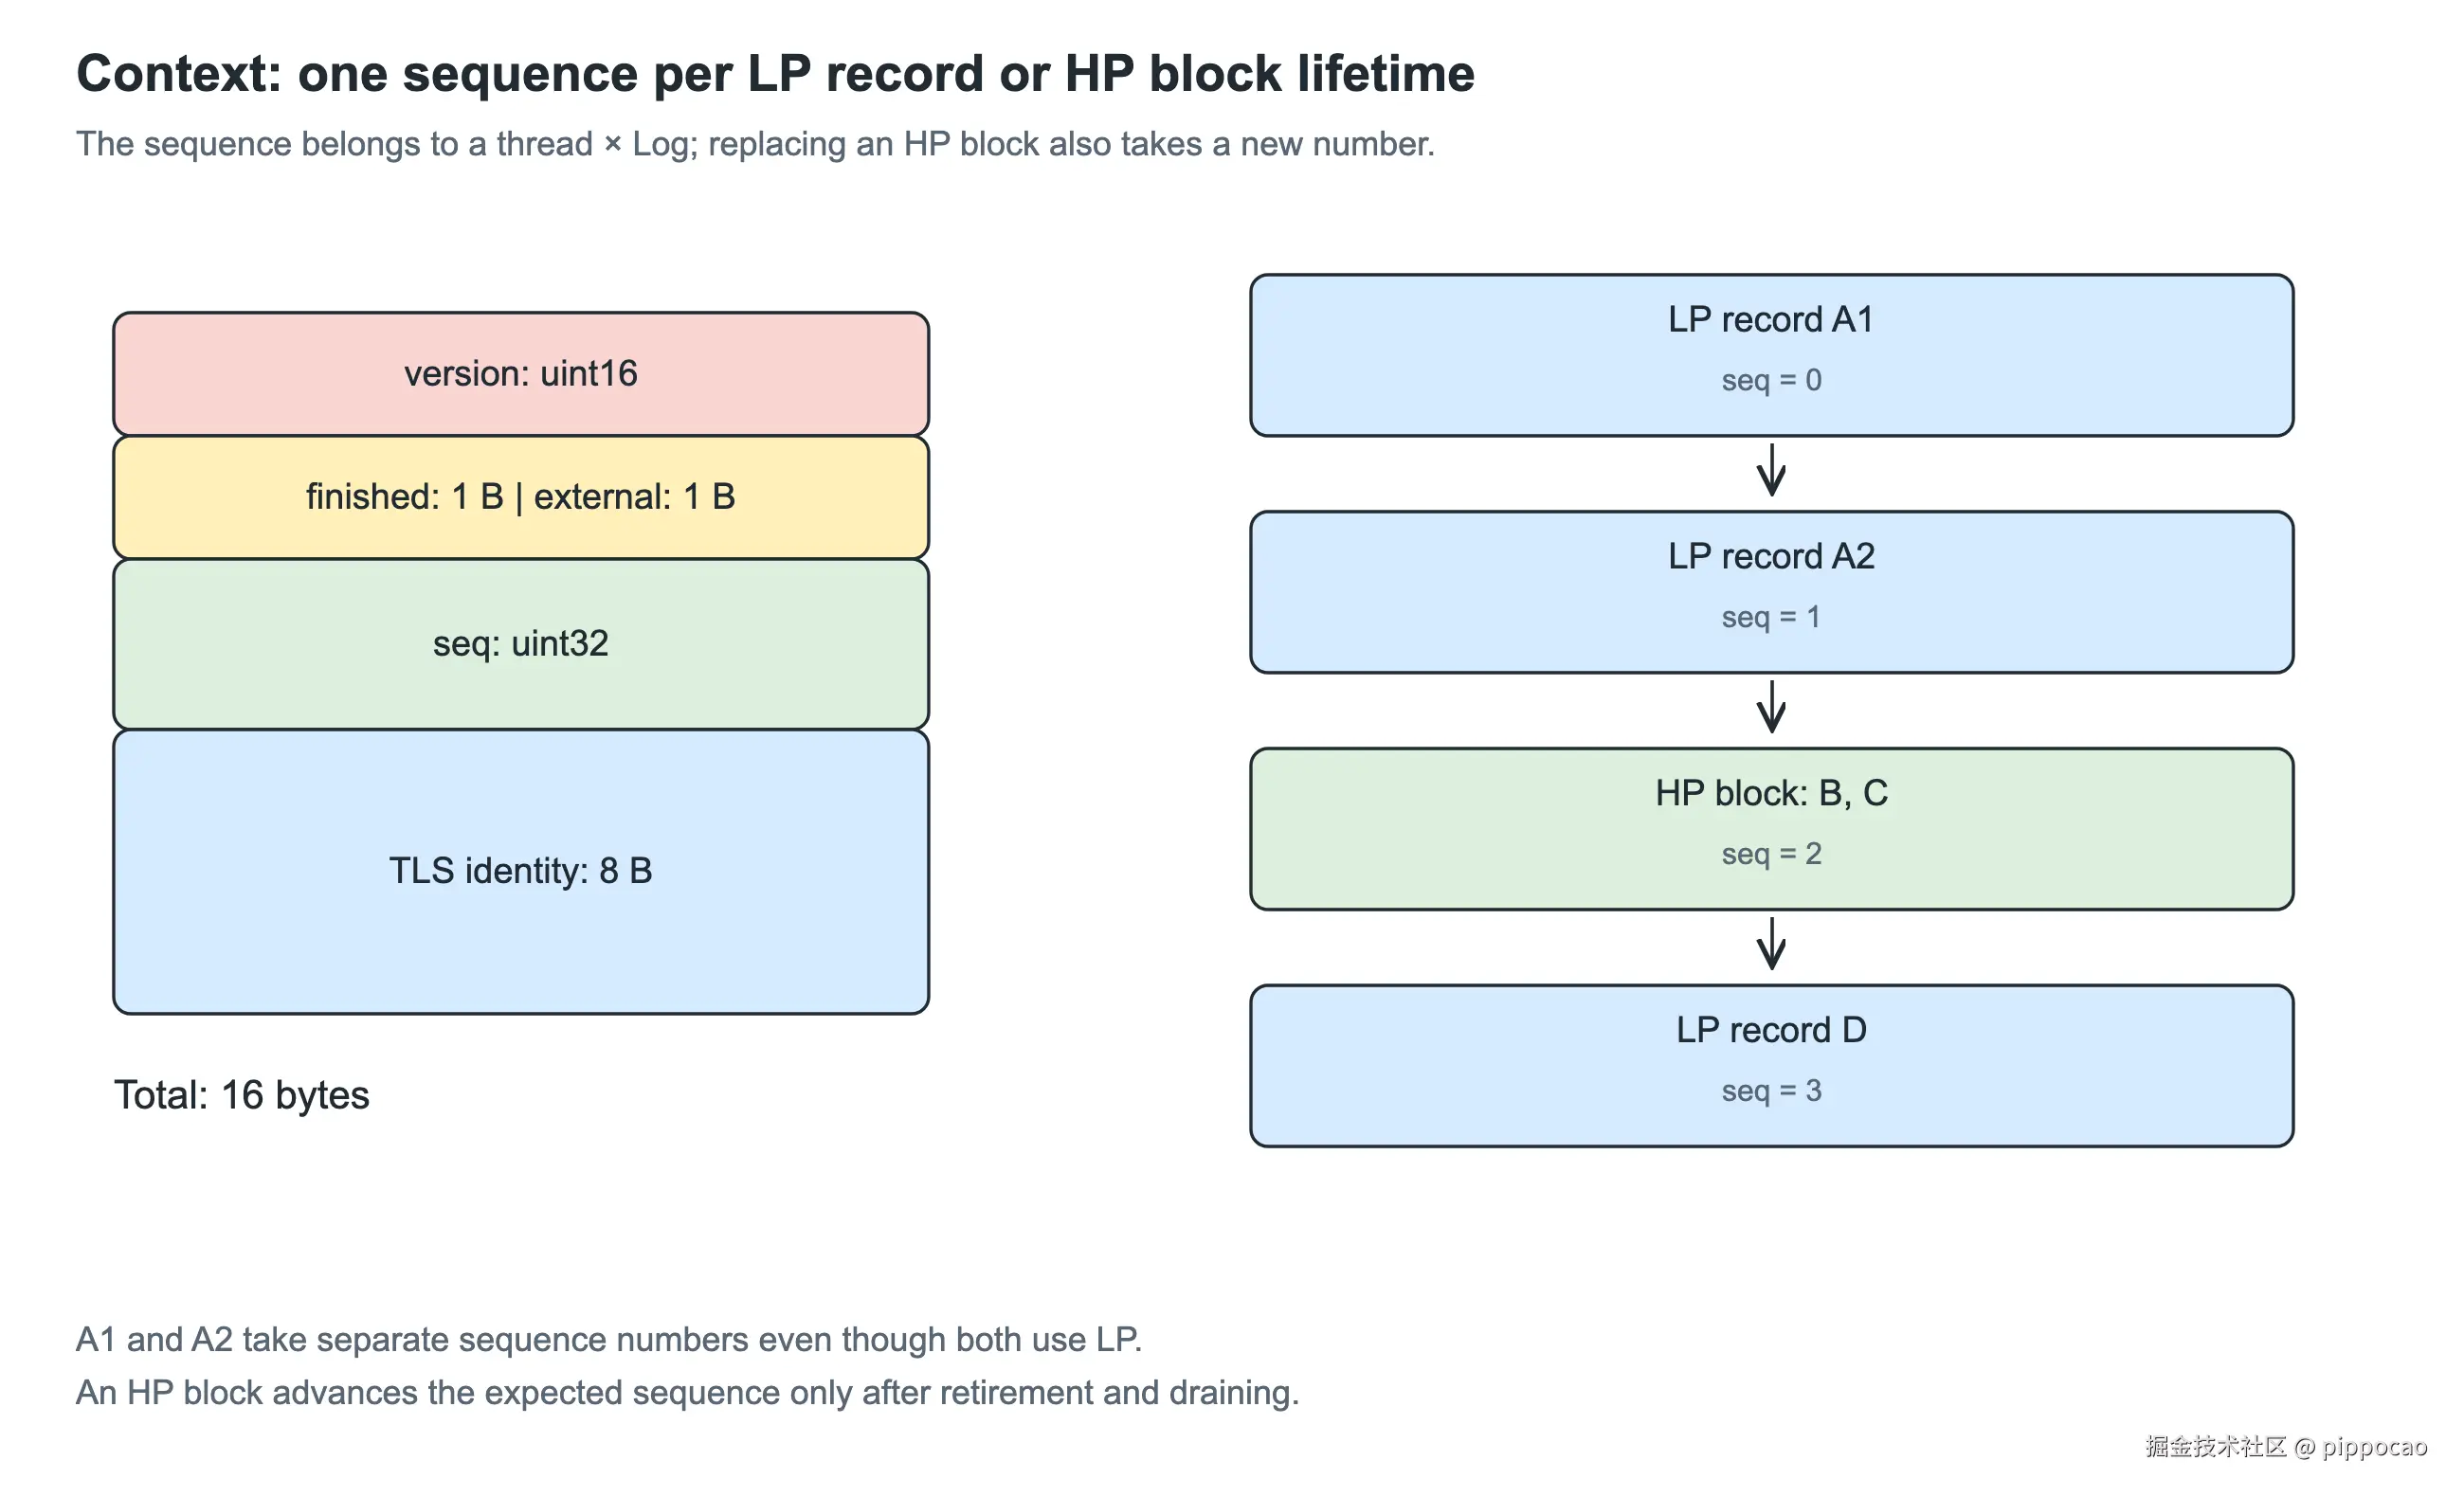
图 18:16 字节 context 的逐字节结构。右半部分演示 LP 阶段连写两条记录的情形:每条 LP 记录各占一个序号,HP 一个 block 的生命周期占一个序号。
context 里有版本号、线程结束标记、外部引用标记、序号 seq 和 TLS 身份。LP 路径上每条记录带一份;HP 路径上每个 block 存一份,块内所有消息共用。
回到上面的场景:LP 记录 A 用 seq=0,HP block 用 seq=1 写 B、C,回 LP 后的 D 用 seq=2。如果 LP 阶段连着写两条记录,它们各占一个号;持续高频期间因扩容或归拢换了 block,新 block 也领一个新号。
消费者只需接回同一线程在不同队列中的顺序,局部序号就够用。全局编号反而会让所有生产者再次争用一个共享计数器。
消费者为每个 TLS 维护期望序号。假设先看到 seq=1 的 HP 块,而当前期望是 0,就暂时跳过它,先处理 LP 记录 A。A 处理完后期望变为 1,才能读取 B、C;待生产者不再使用该块且消费者将它读空,期望才推进到 D 的序号。
这个 HP 块什么时候才算读完?队列暂时为空还不够,生产者可能继续写。降级时,生产者给 block 标记"已移除";线程退出时还会在 context 中写结束标记。消费者看到标记后读完剩余数据,才把 block 从 Used 摘除并放回 Free。
只使用 LP 的线程没有 HP block 可标记。它退出时会向公共 LP 写一条带 seq 的结束记录;消费者读到后清理该线程对应的顺序状态。
§6.5 归拢和扩容触发的换 block 走的也是这套规则:旧 block 标移除、新 block 领新 seq,消费者先读空旧 block,才让期望序号越过它。生产者换队列时不用做任何额外动作------序号机制本来就覆盖这种切换。
这里也接回第一篇的一个细节:多线程交错时,记录的消费顺序与取时间戳的顺序可能不同;消费端编码前会把时间戳钳成非递减,所以文件里一般见不到负差。第一篇格式保留的负数能力,是用在续写碰上系统时钟回拨的时候。
7.3 场景三:崩溃了,怎么复盘
BqLog 可以把缓冲区放在内存映射文件(mmap)中。异常退出后,恢复逻辑要重新识别留下的 block,并按线程阶段顺序处理其中的日志。
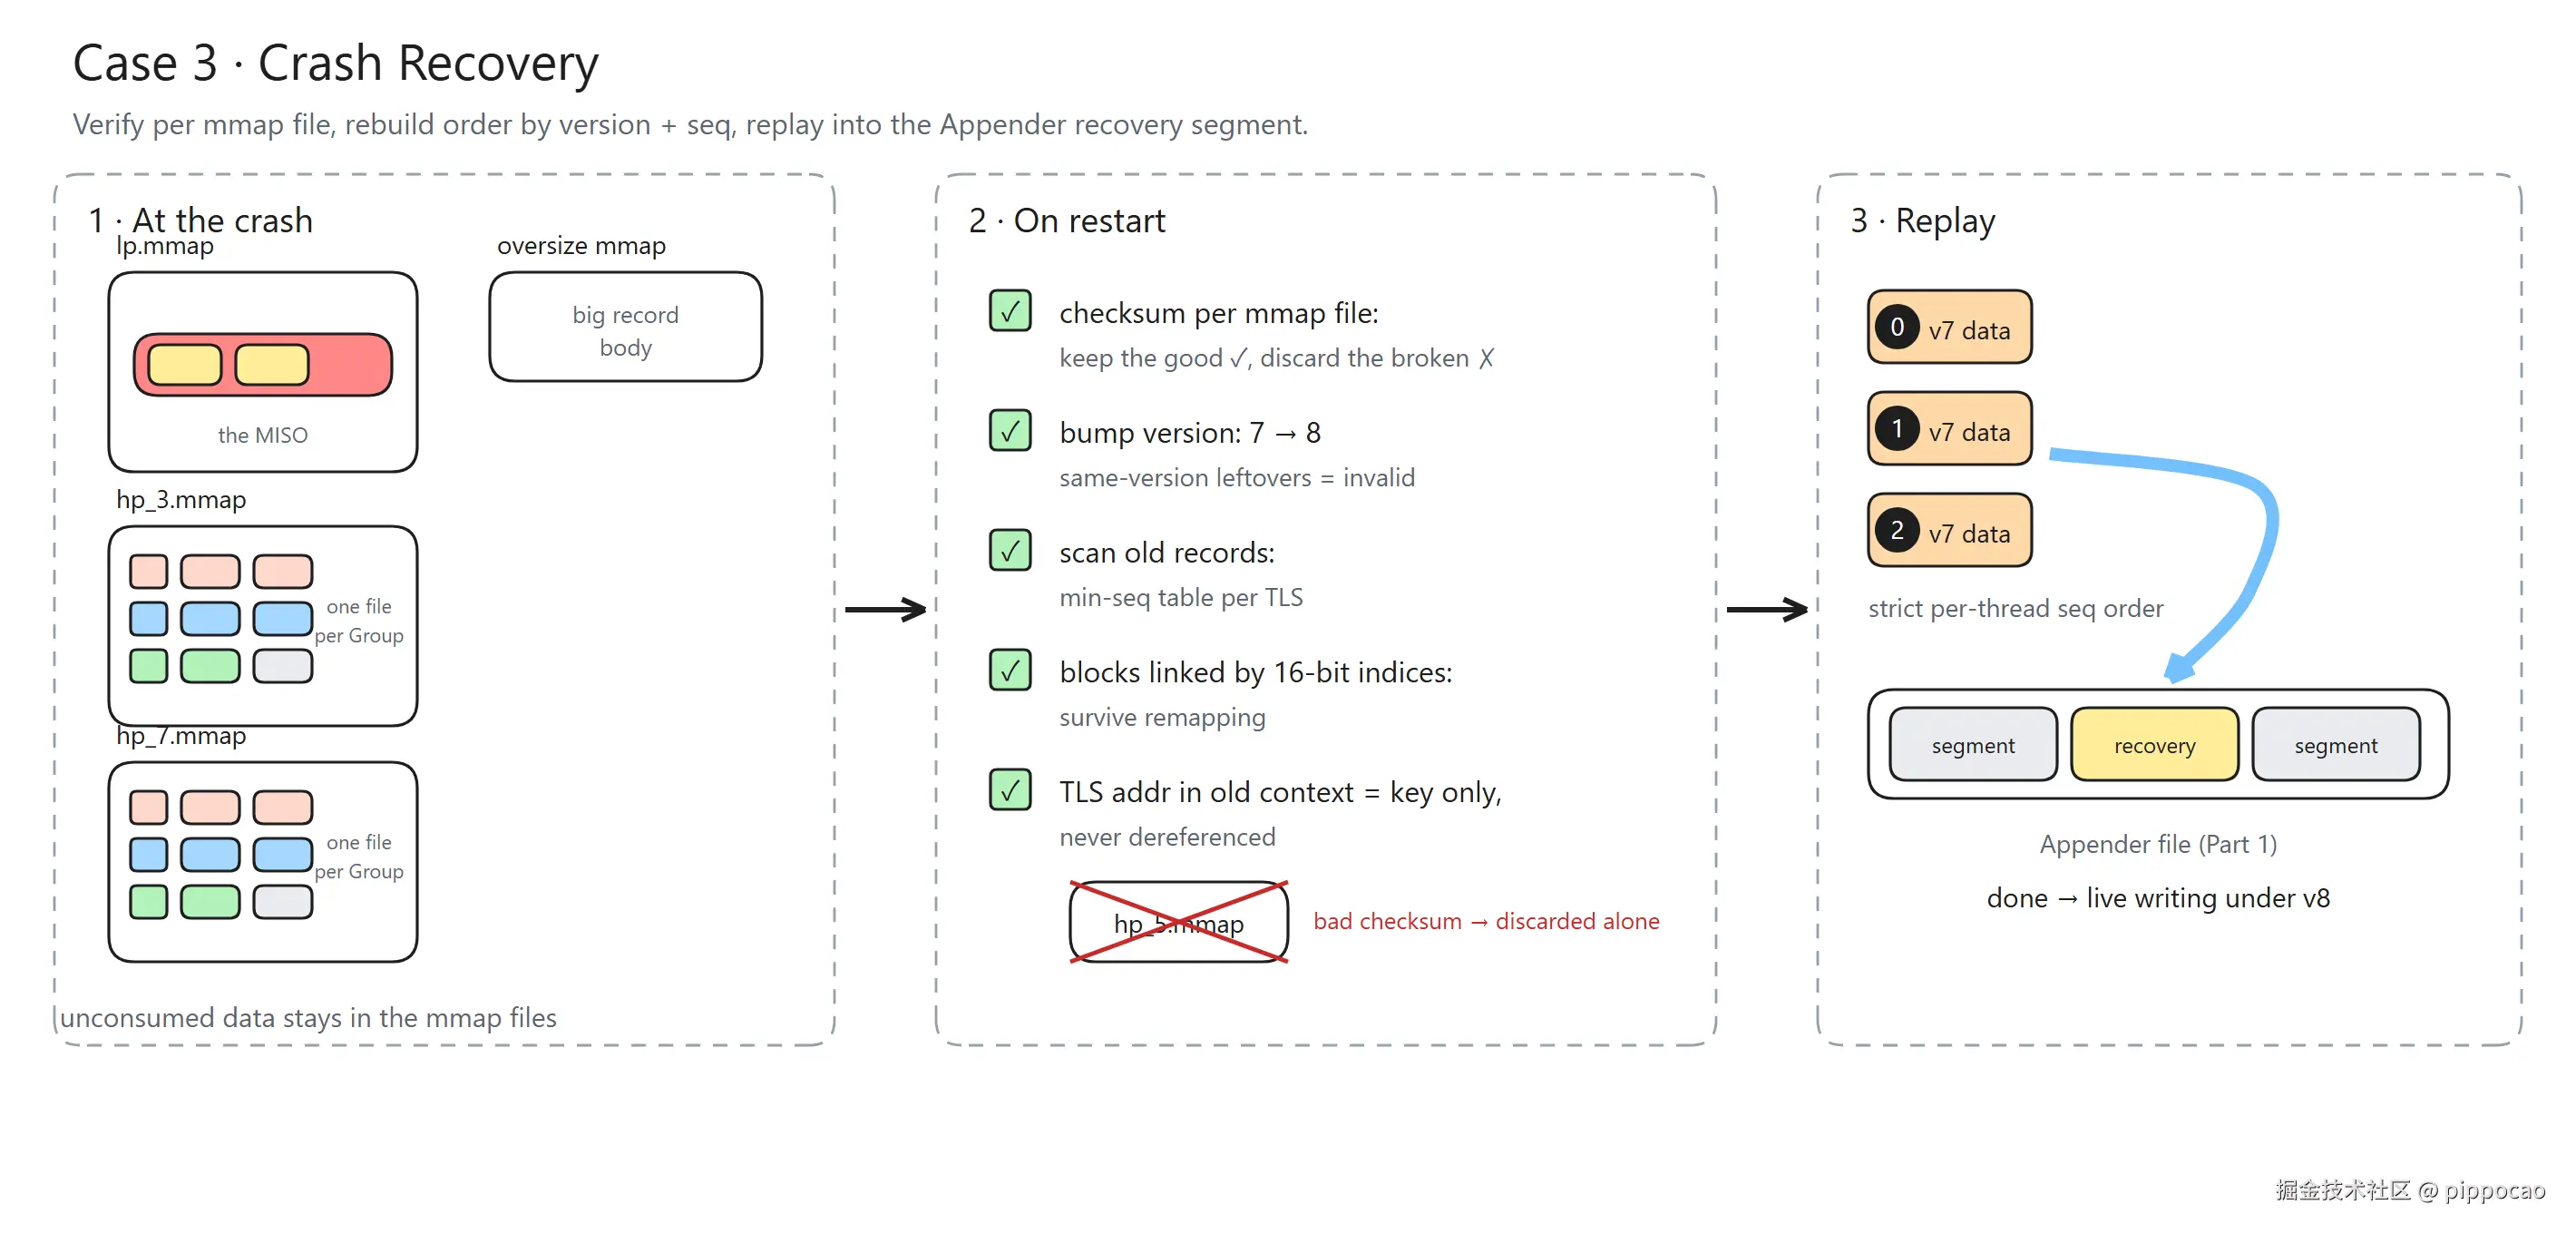
图 19:重启后逐个校验 mmap 文件,跳过未完成的数据,再按 seq 重放。
按恢复顺序看:
公共 MISO、各 Group 和超大日志分别使用 mmap 文件。退出时,文件中可能留有 Used/Stage/Free 链、context 和尚未消费的数据。
重启后逐个检查文件头、配置校验信息和内部结构,损坏或不匹配的文件单独丢弃。完成状态用于识别哪些记录可以读;版本号则用于区分它们属于哪次运行。
例如本次运行把版本从 7 推进到 8,恢复代码会收集允许范围内的旧版本记录,并为每个 TLS 身份找到最小 seq。若旧映射中竟然出现标着本次版本 8 的残留------正常旧数据只可能是 7 或更早------就将其作废,避免把异常旧数据当成本次记录。发布构建的 MAX_RECOVERY_VERSION_RANGE 为 2(单元测试构建为 5)。
重新映射可能改变基址,所以 Group 内用 16 位索引连接 block。context 中的 TLS 地址也只作为旧线程的身份 key,不会被解引用。这样才能找到"哪些记录属于同一个线程",再用 seq 接回顺序。
mmap 脏页的落盘顺序不一定等于程序的写入顺序。例如 Used 链中已经留下一个 block,而 Stage 链中摘除它的修改尚未落盘,恢复时就会在两条链中看到同一个 block。恢复代码会去掉 Stage 中的重复节点。
消费者先按各线程的 seq 处理旧版本数据,再消费本次运行的新记录;生产者可以先将新记录写入总线。恢复的总线记录还带着原始格式和参数,要经过 Appender 重新编码。在第一篇讲的加密重启场景中,它们进入新文件的总线恢复段;已经编码的 Appender 缓存则另行接回原文件。
Group 分文件便于隔离损坏数据;索引链和 context 则让重新映射后的 block 与线程顺序仍可识别。这些恢复需求也参与决定了前面的数据结构。
8. 超大日志与缓冲区满时的处理
8.1 超大日志的载荷单独存放
有些日志会大于普通 ring 的容量,例如一整段内存 dump。如果为这种偶发记录放大每条常驻队列,大部分空间平时都会闲置。BqLog 将载荷放进专门的 oversize buffer,在 LP 中保留一条带 external-ref 标记的父记录。父记录仍参与正常的顺序控制。
提交时先发布外部载荷,再发布父记录,因为消费者一旦看到父记录,就会立即查找它引用的载荷。消费者根据父记录中的版本、TLS 身份和序号找到载荷,校验后读取。若载荷分配失败,已预留的父位置要标成"可跳过",并修正序号,否则后续消息会一直等待缺失的前驱。
8.2 消费者追不上的时候
如果生产速度持续超过消费速度,有限容量的缓冲最终会写满。BqLog 提供三种处理方式:
discard:新消息直接写失败,丢掉;block:唤醒消费者,生产者等待并重试,队列积压会延长业务调用;expand:LP 紧张时转 HP,HP 紧张时换新 block,用内存吸收突发积压;持续超出消费能力时,内存需求仍会增长。
expand 不会原地 realloc 正在使用的 ring,而是通过 LP/HP 切换或增加 block 扩容。因此 log.buffer_size 只控制结构中的一部分;估算总内存还要计入 HP 数量、Group、超大日志和 Appender 缓存。
生产者只在空间不足或剩余空间偏低时请求唤醒消费者;awake_flag 合并重复请求。消费者有数据时持续处理,空闲时再等待通知或超时。
9. 回到最初的问题
开头的问题是:怎样让许多业务线程把日志交给一个消费者,而不让它们总在同一个写游标上排队?各层结构分别解决一部分:
- 连续 ring:省掉了逐条 new 节点的分配;
- 游标缓存和批量归还:省掉了大部分共享变量访问;
- MISO 的 fetch_add + 回滚:空间充足时,预留不需要 CAS 重试;
- HP SISO:高频线程使用各自的写游标,减少共享缓存行争用;
- Group + Free/Stage/Used:集中处理队列交接、归拢与回收,让消费者独占 Used 链;
- context 序号:用局部顺序接通各条路径,不强求全局序号;
- oversize:把少见的大记录从常驻容量里摘出去。
代价也在对应的位置:LP 的 128 字节粒度会浪费小记录的空间,HP 占用更多内存,Group 的管理操作仍会用锁,满缓冲时还要按配置丢弃、等待或扩容。选哪条路径取决于线程的写入频率。这些设计还会影响后续处理:批读一条 SISO 会带来连续的同线程记录,消费者便能复用刚查到的线程模板。下一篇沿着一条日志,继续看拷贝、哈希、查表和编码怎样配合。
对照源码继续看
- log_buffer.h、log_buffer.cpp:TLS、context、切换顺序、大日志与回收。
- miso_ring_buffer.cpp、siso_ring_buffer.h、siso_ring_buffer.cpp:预留、发布、环尾、批读。
- group_list.cpp、block_list.h:连续分配和索引链。
- bq_log_api.cpp、log_worker.cpp:背压和唤醒。
- test_log_buffer.h、test_miso_ring_buffer.h、test_siso_ring_buffer.h:现有对应测试。