成为全栈·Next.js 网站前台篇·数据获取与缓存:60 秒再验证背后到底发生了什么
revalidate: 60不是每 60 秒跑一次定时任务,也不保证第 61 秒的用户立即看到新内容。只有理解过期、旧值和再生成的时序,才能知道自己向用户承诺了什么。
前言
这个网站在本地联调时,最容易让人误判的现象是:管理后台已经改了站点名称,API 直接请求也返回新值,前台却还显示旧名称。下意识的判断是"接口没调通"或"React 没更新",实际上两者都没有出错,前台只是命中了一份尚未再验证的公开缓存。
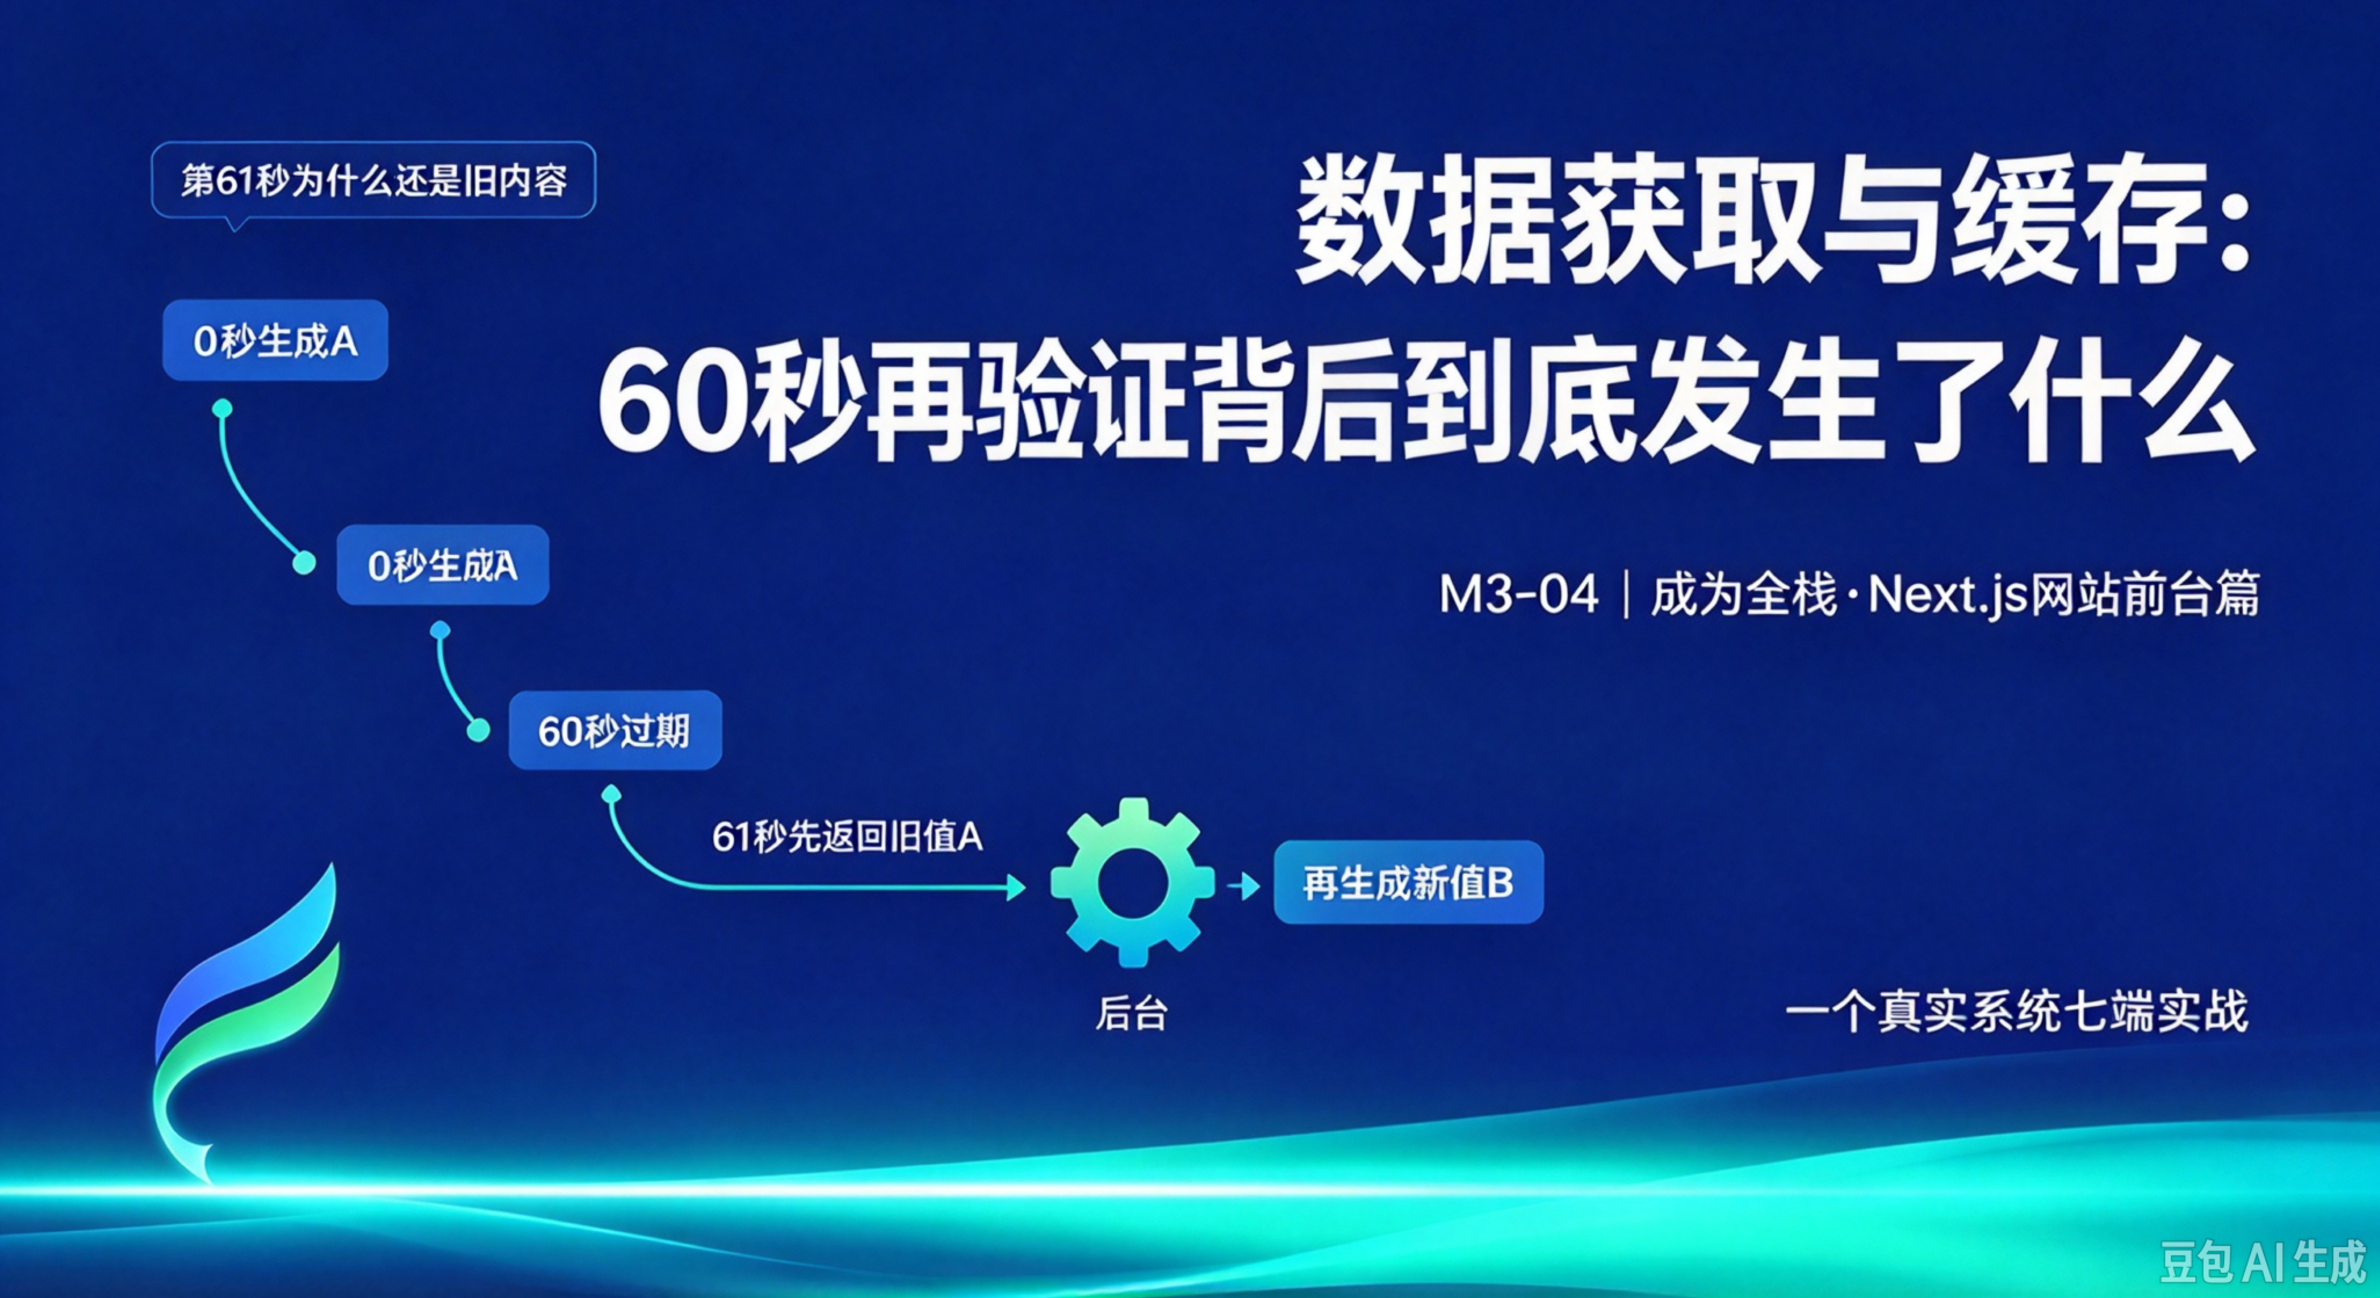
更麻烦的是,当第 61 秒的访客仍看到旧值时,开发者很容易认为 ISR 失效了。但时间再验证采用的是 stale-while-revalidate 思路:先把已有内容快速返回,再在后台生成新版本。
这篇不只讲 API 怎么写,而是把用户真正看到的时间线拆开。
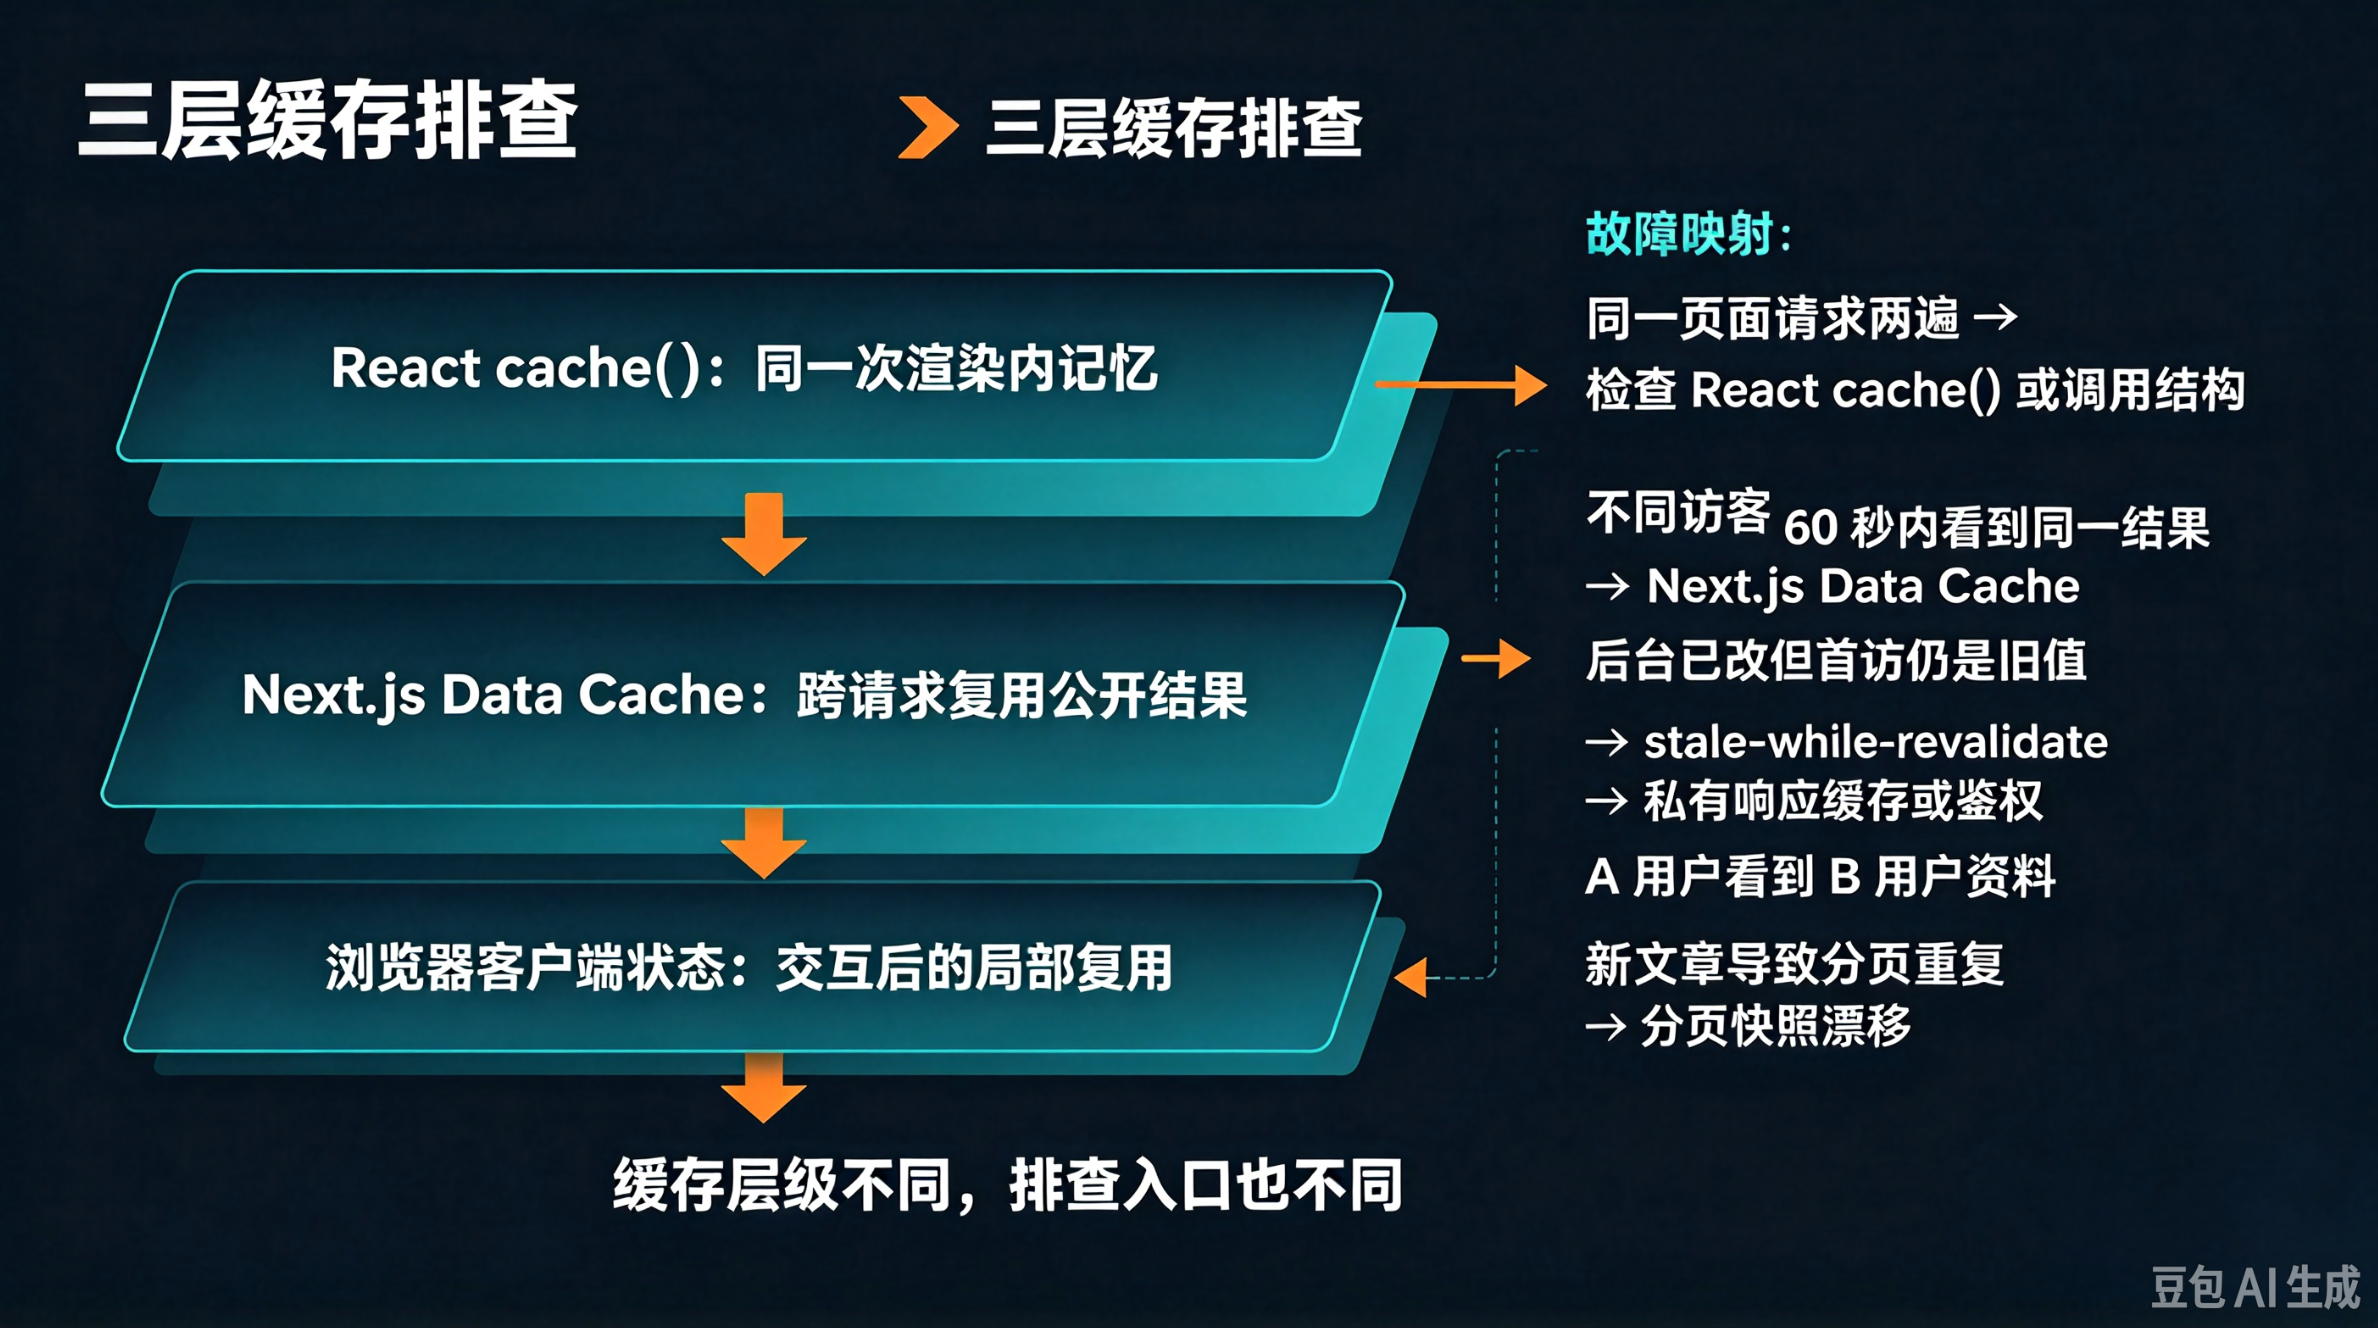
当前项目有三种不同的"缓存"
这些概念很容被都叫成 cache,实际职责完全不同:
| 层次 | 项目中的例子 | 解决什么 | 生命周期 |
|---|---|---|---|
React cache() |
categories()、settings()、详情页 load() |
同一次服务端渲染里的重复计算 | 渲染请求范围 |
| Next.js Data Cache | fetch(..., { next: { revalidate: 60 } }) |
跨请求复用公开 API 结果 | 由缓存与再验证规则决定 |
| 浏览器客户端状态 | React Query 中的收藏、评论、会员数据 | 交互后的局部复用与失效 | 页面会话和 QueryClient 规则 |
React cache() 是请求记忆化工具,并不是一个"缓存 60 秒"的持久存储。当详情页的 generateMetadata 和页面正文都调用 load(slug) 时,它能避免同一次渲染里重复取文章。而跨用户请求的复用,是 Next.js fetch 缓存在工作。
如果把两者混为一谈,就会出现两种相反误判:以为 cache() 会让数据永久不更新,或者以为它能替代跨请求的 Data Cache。
公开请求层把策略写明白
项目的 serverFetch 专门服务公开内容:
ts
export const serverFetch = async <T>(path: string, options = {}): Promise<T> => {
  const response = await fetch(url, {
    cache: options.cache || 'force-cache',
    ...(options.cache === 'no-store'
      ? {}
      : { next: { revalidate: 60, ...options.next } }),
    signal: AbortSignal.timeout(12000),
  })

  // 解析统一信封,非 0 业务码同样抛错
  return envelope.data
}
这里有三个明确决定:
- 公开内容默认
force-cache,不依赖 Next.js 的隐式猜测。 - 缓存内容默认 60 秒再验证,个别请求可以覆盖。
no-store请求不再附加再验证参数,避免同一请求表达两种相反意图。
我喜欢这种显式写法,因为 Next.js 的默认缓存语义曾随版本变化。当前项目固定使用 Next.js 16.3.5,且未开启 cacheComponents,代码应当说清自己选的模型,不让读者靠某一个版本的默认值猜。
第 61 秒发生的不是定时刷新
假设第一个请求在 10:00:00 生成了首页缓存,内容在 10:00:30 被后台修改。一条简化时间线是:
text
10:00:00  首次请求,生成版本 A
10:00:30  后台发布版本 B,缓存中仍是 A
10:00:50  未过期,返回 A
10:01:01  已过期,可先返回 A,同时触发后台再生成
10:01:03  版本 B 生成并写入缓存
10:01:04  后续请求返回 B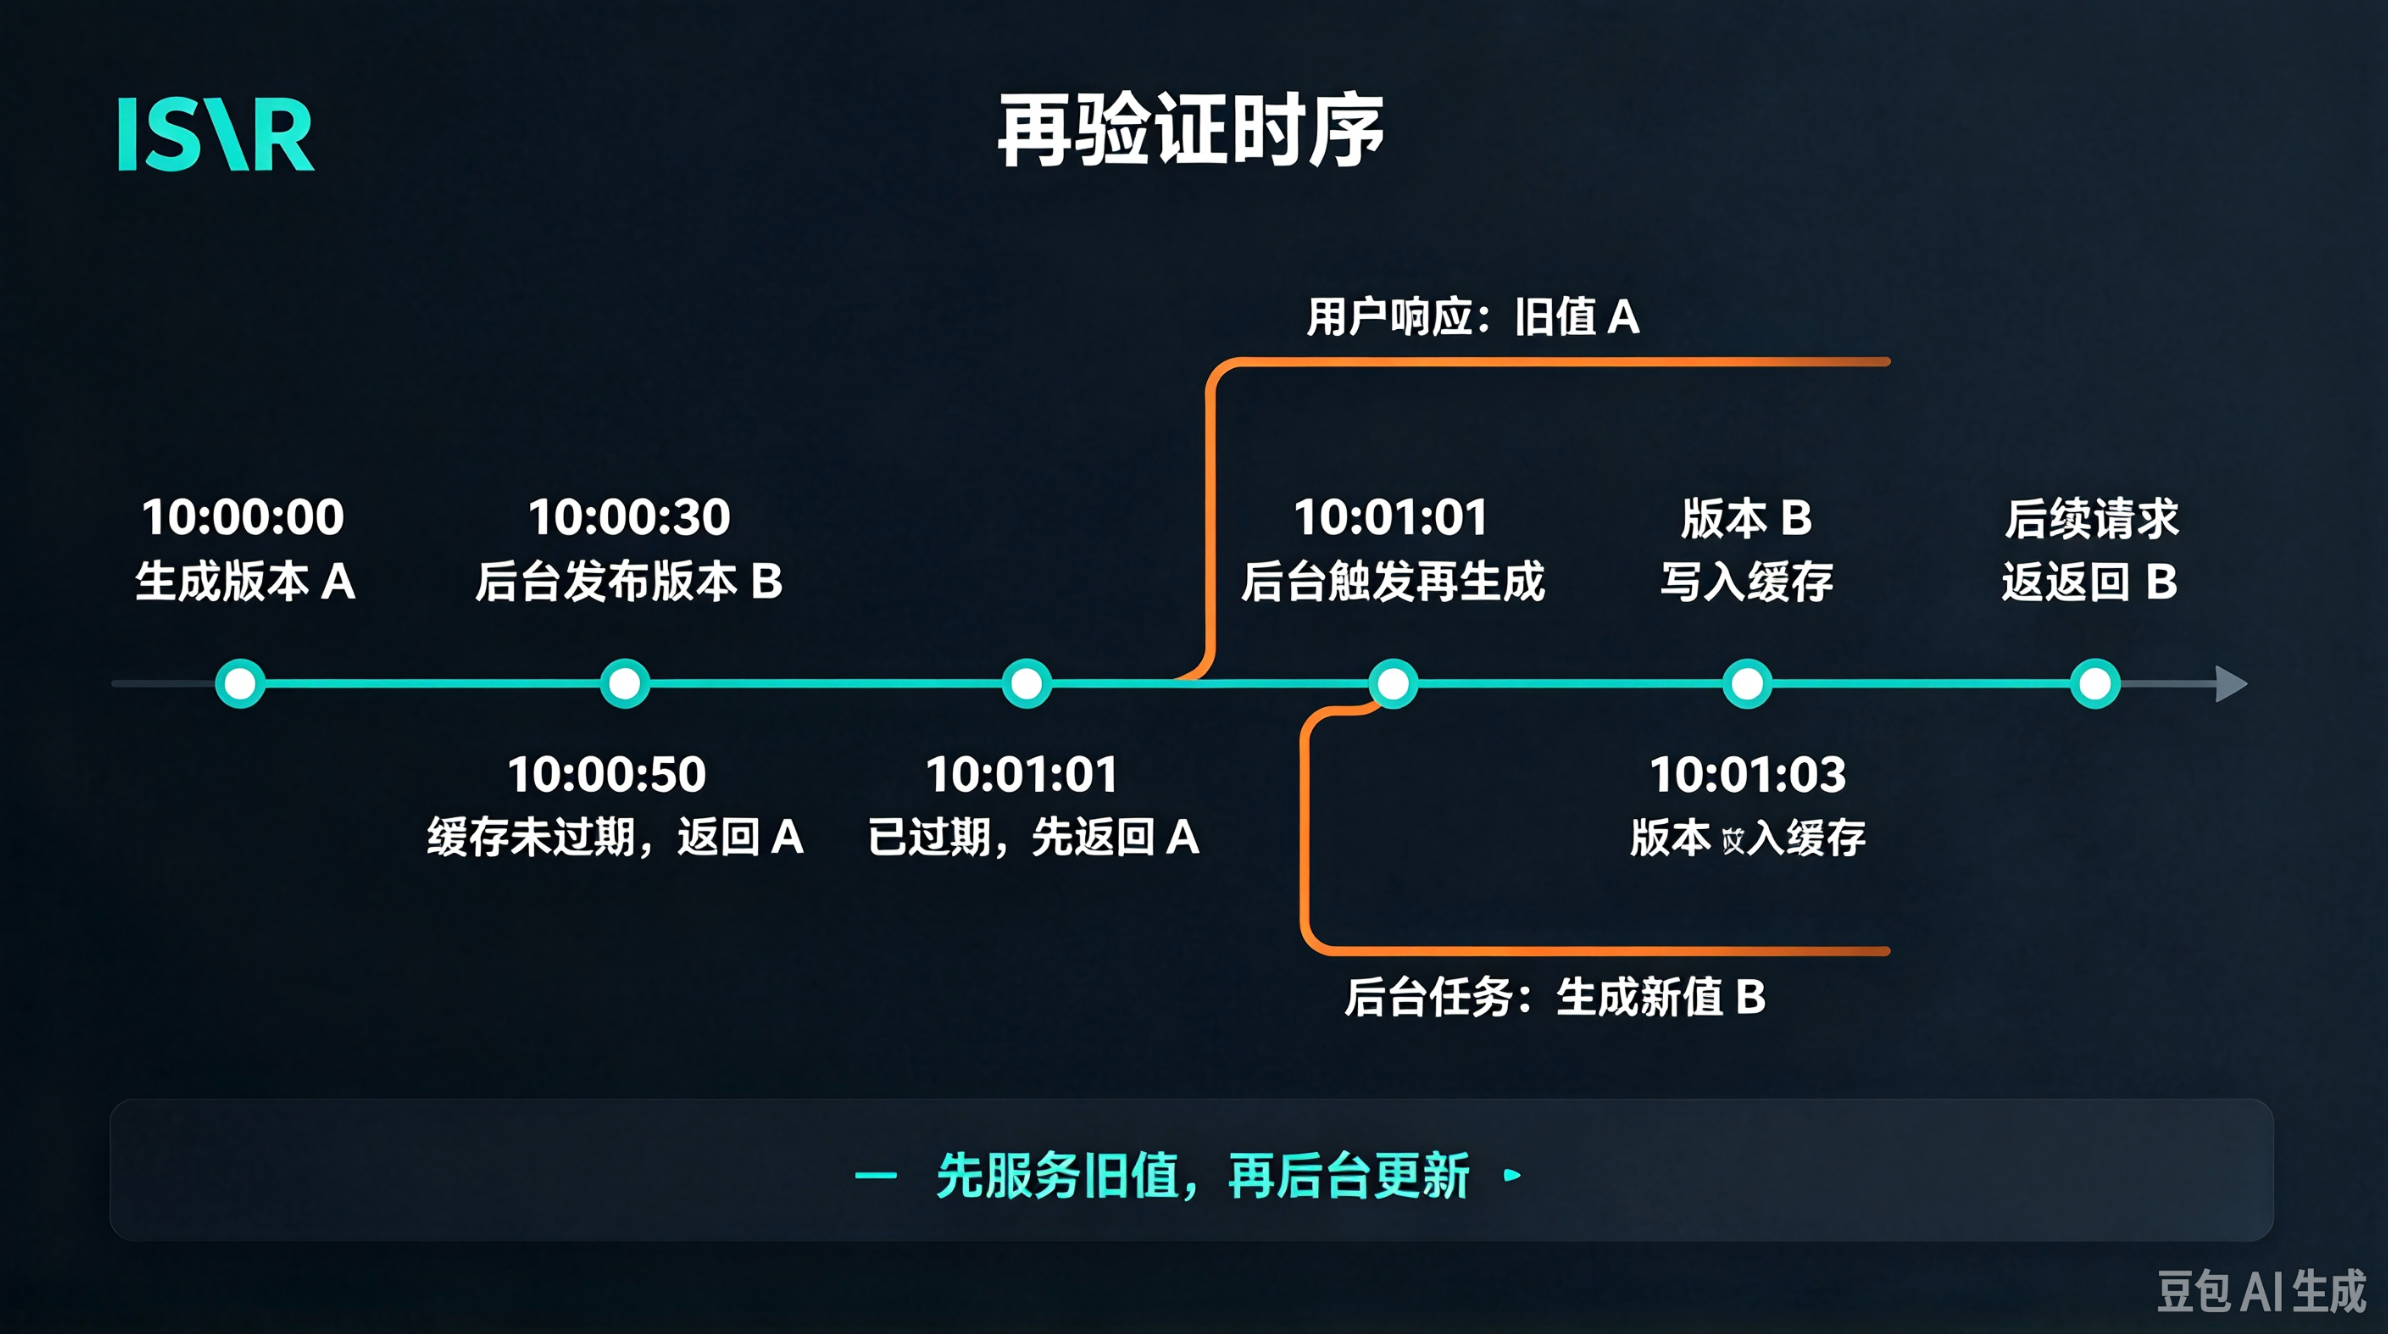
这条时间线解释了为什么"等 60 秒然后刷新一次"不一定立即看到新值。对可以短暂陈旧的内容站,这种行为优先保证响应速度和可用性。对价格、权限或会员私有数据,它就可能完全不合适。
缓存键不只有路径
serverFetch 会把 query 参数拼进 URL。文章第 1 页与第 2 页、不同分类和排序会形成不同请求。因此说"文章列表缓存 60 秒"仍然不够准确,实际上是每组 URL 与请求选项对应的内容各自管理新鲜度。
这对分页尤其重要。当新文章插入第 1 页时,旧第 1 页的最后一篇可能被挤到第 2 页。若两页在不同时刻再生成,客户端持续加载就可能遇到重复或短暂缺口。所以后面的文章流必须按 article.id 去重,而不能把分页视为永远不变的快照。
私有请求不只是 TTL 设为 0
会员数据统一走客户端请求和 /api/v1/[...path] 同源代理。代理访问上游时使用 cache: 'no-store',返回浏览器时设置 Cache-Control: private, no-store。
两层都有意义:前者告诉 Next.js 不要复用上游结果,后者告诉浏览器与中间代理不要储存这份私有响应。只写 revalidate: 0 而忽略响应缓存头,不能完整表达私有数据的边界。
这里也有一条底线:缓存策略不是鉴权。 即便响应从不缓存,后端仍必须校验 access token 和数据归属。
请求失败时,别把缓存当成全能降级
当前 serverFetch 对上游响应做了严格解析:JSON 无法识别、HTTP 非成功、业务码非 0 或缺少 data 都会抛出 ApiError。核心文章请求的错误会进入路由错误边界,而页头站点信息这类可选模块才会使用默认值。
这种分界很重要。若所有请求失败都吞掉并返回空数组,一次 502 会被页面误写成"还没有文章"。缓存可以在再验证时优先提供旧内容,但业务代码仍要区分真正的空内容和上游故障。
验证缓存要改数据,不能只刷新页面
serverFetch 还需要正确处理 URL、超时与业务错误
文章里前面的代码省略了请求构造,完整职责至少应包含下面几步:
ts
type ServerFetchOptions = RequestInit & {
  query?: Record<string, string | number | undefined>
  next?: NextFetchRequestConfig
}

export async function serverFetch<T>(path: string, options: ServerFetchOptions = {}) {
  const url = new URL(path, API_ORIGIN)
  Object.entries(options.query || {}).forEach(([key, value]) => {
    if (value !== undefined) url.searchParams.set(key, String(value))
  })

  const response = await fetch(url, {
    ...options,
    cache: options.cache || 'force-cache',
    next: options.cache === 'no-store'
      ? undefined
      : { revalidate: 60, ...options.next },
    signal: AbortSignal.timeout(12_000),
  })

  const envelope = await response.json()
  if (!response.ok || envelope.code !== 0) throw new ApiError(envelope.message, response.status)
  return envelope.data as T
}
缓存只能复用成功获得的数据,不能代替超时和信封校验。否则一个 HTML 错误页或业务失败响应也可能沿着"成功路径"进入组件。
React cache() 解决的是同一次渲染的重复调用
ts
import { cache } from 'react'

export const getCategoryTree = cache(async () => {
  return serverFetch<CategoryNode[]>('/categories/tree', {
    next: { revalidate: 60, tags: ['categories'] },
  })
})
tsx
// layout、导航或页面在同一次服务端渲染中都可以调用
const categories = await getCategoryTree()
外层 cache() 负责请求内去重,内层 fetch 负责跨请求缓存。把层次写出来,才能解释为什么它们可以同时存在。
标签为以后按需失效留下接口
ts
return serverFetch<ArticlePage>('/articles', {
  query: params,
  next: { revalidate: 60, tags: ['articles'] },
})
未来后台发布成功后,可以由受保护的内部通道调用 revalidateTag('articles')。不过标签只是失效索引,不是权限机制;再验证入口必须鉴权,也要限制允许失效的标签集合。
私有代理的响应头必须由服务端写出
ts
const outgoing = new Headers(upstream.headers)
outgoing.set('cache-control', 'private, no-store')
outgoing.delete('set-cookie') // 普通转发不应意外复制上游会话

return new Response(upstream.body, {
  status: upstream.status,
  headers: outgoing,
})| 现象 | 更可能检查哪一层 |
|---|---|
| 同一页面一次渲染里请求两遍 | React cache() 或调用结构 |
| 不同访客 60 秒内看到同一公开结果 | Next.js Data Cache,通常是预期行为 |
| 后台已改但过期首访仍是旧值 | stale-while-revalidate 时序 |
| A 用户看到 B 用户资料 | 私有响应缓存或鉴权,必须立即处理 |
| 新文章导致分页重复 | 分页快照漂移,客户端按 ID 去重 |
一个更可靠的测试脚本思路
bash
curl -s http://localhost:3000/ -o /tmp/home-before.html
# 在管理后台将唯一测试标题 A 修改为 B
curl -s http://localhost:3000/ -o /tmp/home-within-ttl.html
# TTL 过期后请求一次触发再验证,再请求一次保存结果
curl -s http://localhost:3000/ -o /tmp/home-after.html
不要只比较 HTTP 状态码,而要比较那个唯一测试标题,同时观察后端访问日志。若要验证故障行为,就在再验证阶段让测试上游返回一次 502,再恢复服务;记录旧页面是否仍可读以及后续是否恢复为 B。
缓存验收需要一个可识别的上游版本。可以先记录页面中的站点描述或文章标题 A,再通过后台将它改为 B。接下来分别在 TTL 内、TTL 过期后的第一次请求、再生成完成后访问,才能看到 A 如何过渡到 B。
如果只在浏览器里连续按刷新,很容易忽略客户端路由缓存、预取和浏览器本身行为。更稳妥的方式是同时观察上游请求计数、页面内容和必要的响应头,并使用一个新会话复查。
还要故意测失败路径。在再生成时暂时让上游返回 502,观察系统是继续服务已有内容,还是将错误扩散给全部访客。恢复上游后,再确认后续请求能更新。只验证理想状态下的 TTL,无法证明缓存真正提升了可用性。
我们实际验证了什么
本项目已经完成了 Next.js 标准生产构建、OpenNext Cloudflare 构建,以及本地 Worker 环境下的运行验证。本地 Worker 使用模拟 R2 缓存来检查增量缓存链路。
这些证据能支持以下结论:
- 当前代码能在 Next.js Node 产物和 OpenNext Worker 产物中完成构建。
- 公开内容与私有代理使用了不同缓存语义。
- 本地可观察再验证前后的内容变化。
它们不能证明远端 Cloudflare 部署已经完成,也不能证明真实 R2、多地节点和 CDN 的失效传播时间。"Worker 构建通过"和"生产缓存正确"之间,还有一整条基础设施验收链。
适用边界
60 秒是当前内容站对新鲜度的取舍。如果发布操作要求立即对外可见,应在后台发布成功后调用一条受保护的再验证通道,对相关 tag 或 path 主动失效。
如果站点部署到多个实例,还要保证缓存条目和失效事件在实例间共享。否则 A 实例已经更新,B 实例仍可能服务旧值。这时问题已经从一行 revalidate 扩展到分布式缓存协调。
小结
revalidate: 60 真正表达的是:这份公开内容可以在一段时间内复用,过期后的访问允许先获得旧值,系统再生成新版本。它是新鲜度、响应速度与上游压力之间的契约。
各位看官,下次看到一个 TTL,不要只问数字够不够小。先画出过期前、触发再验证和新值写入后的三段时间线,你才会知道第 61 秒的用户会看到什么。
延伸阅读
- SSR、SSG、ISR 与动态渲染
- TanStack Query 不只是缓存:失效、派生与失败恢复
- OpenNext 部署 Cloudflare
如果这篇文章对你有帮助,欢迎订阅我的 CSDN 专栏 「成为全栈」:
🔗 专栏地址:https://blog.csdn.net/fungleo/category_13204651.html
📦 本系列配套代码仓库:https://github.com/fengcms/become-a-full-stack-developer