在追求极致性能的系统中,减少一切不必要的计算是优化的核心。以手游为例,帧率和流畅度是其基础体验的关键,而游戏的发行版本往往被一个"不可能三角"所困扰:
- 性能足够好(日志少写)
- 方便追述问题(日志应写尽写)
- 节约存储空间(日志最好就别写)
国内发行的手游通常优先选择保1和3,放弃2。而HOK作为《王者荣耀》的国际服,由于面向全球的发行背景,面临时差、语言和隐私观念等问题,在遇到疑难杂症时很难直接与用户沟通。这种时候我们就需要一种产品,能帮助我们"既要又要",打破这个不可能三角。BqLog就是在这样的背景下诞生的。
BqLog不仅适用于客户端,也适用于服务器,能用于多种编程语言,也能兼容多种操作系统,具体请见Github地址:
本文是系列文章的第三篇,点击查看
本篇是系列第三篇。前两篇定了文件格式和数据通道;本篇沿着一条日志的写入路径往下走,看每两个相邻步骤的交接处还能省掉多少重复工作。
为何 BqLog 如此快之三:一次内存读取,能顺便做多少事情
本文对应 BqLog 2.5.0。文中的简化伪码用于解释思路,实际分支以文末列出的源码为准。
前两篇把两件事定了下来:日志在文件里长什么样,数据怎么从业务线程搬到消费者。但路到这儿还没走完------消费者拿到一条记录,要查模板、要编码、要写盘;业务线程那边拷贝、算哈希,一样没少干。这些零零碎碎的工作单看都便宜,架不住每条日志都来一遍。这一篇就顺着一条日志往下走,看 CPU 的时间到底花在哪,哪些是能省的。
先从一个谁都绕不过的动作说起。异步日志有个硬约束:调用方的格式字符串随时可能失效,所以必须把它拷进总线。拷完还没完------压缩格式要回答"这个格式以前见过没有",得给字符串算个哈希。最朴素的写法长这样:
cpp
memcpy(destination, source, length);  //从生产者线程拷贝进数据总线
hash = hash_bytes(destination, length); //消费者线程从总线里读出来并计算Hash看出毛病了吗?同一段内存,从头到尾读了两遍。第二遍大概率命中 CPU 缓存,可缓存命中也要执行加载指令,把字节重新喂进寄存器。这一篇就从这个"能不能少读一遍"开始问,一路问下去。
1. 拷贝的时候顺手把哈希算了
为了追求极限性能,我们会去思考,第二遍读取能不能省掉?当然能,办法就是:加载一次,用两次。字符串字节反正都要进寄存器才能写进目标内存,那就在它们路过寄存器的时候,顺手喂给哈希。
当前 __api_log_write_begin 对有直接地址的 UTF-8/UTF-16 格式字符串,用的就是这个融合函数:
cpp
head->format_hash = bq::util::bq_memcpy_with_hash(
    handle.format_data_addr, format_str_data, format_str_bytes_len);
看循环里的载入和写回,就能看到两项工作怎样共用同一份数据:
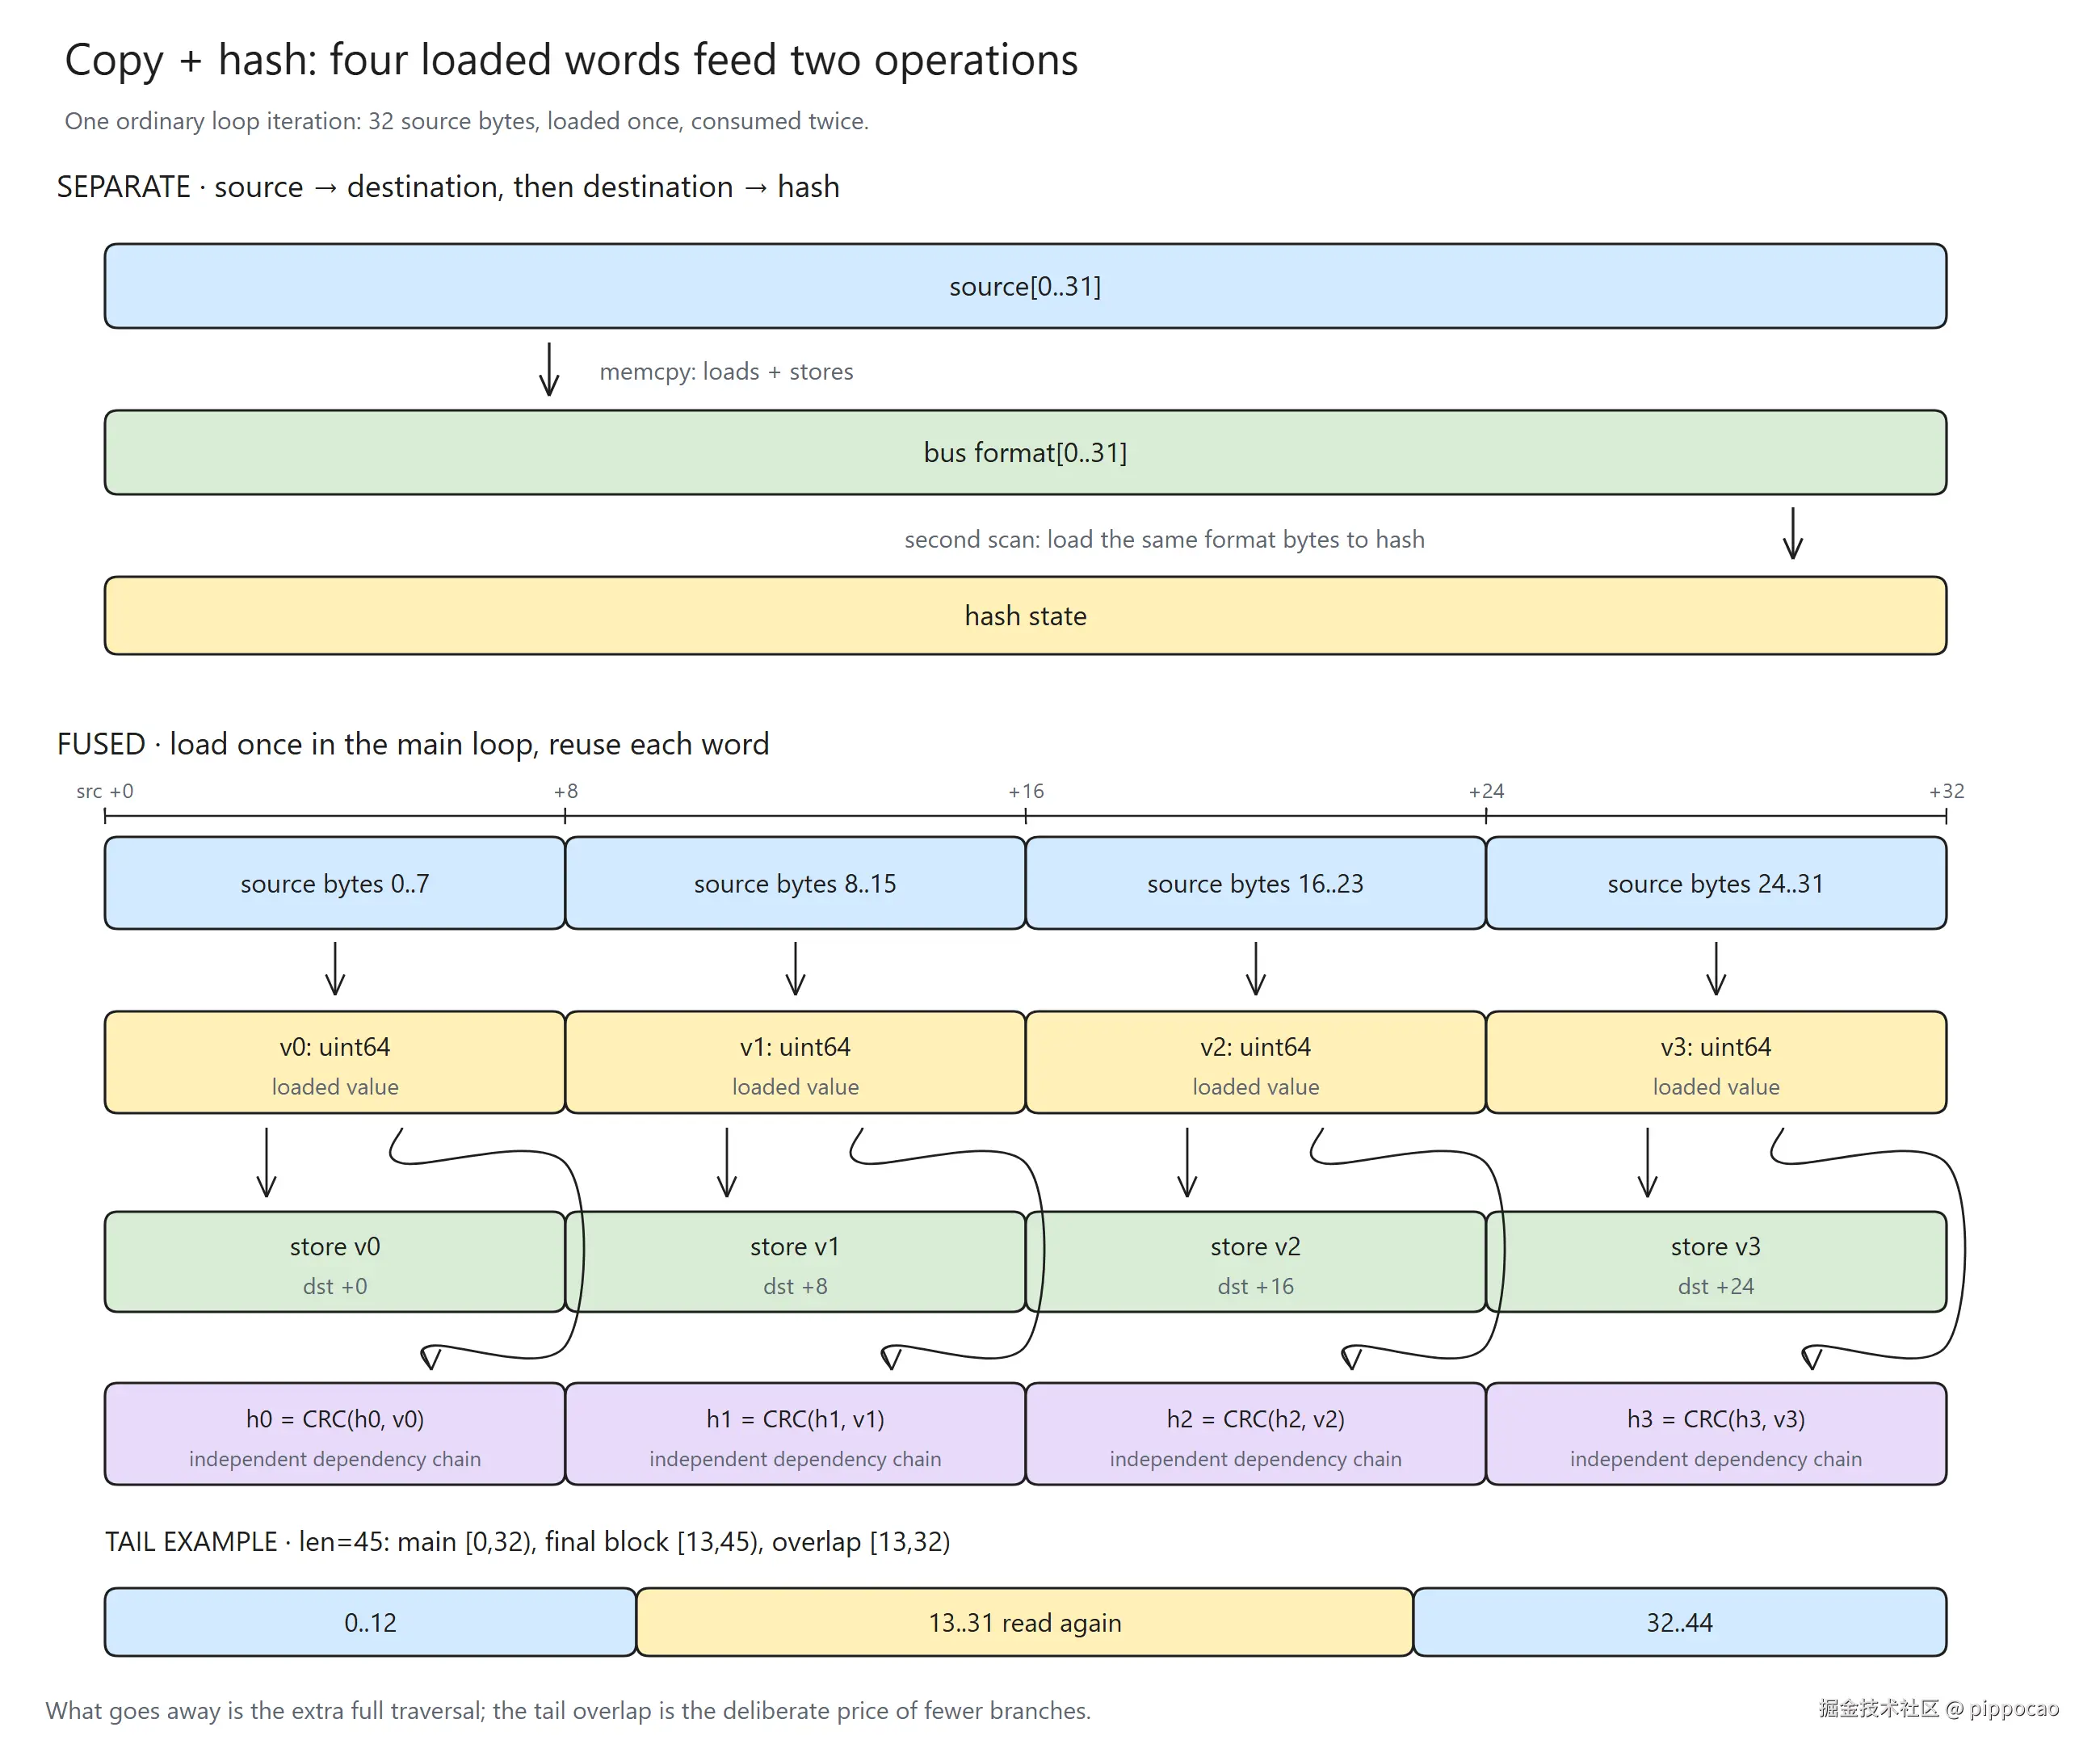
图 1:32 字节主循环一次拿到四个 64 位值,同一份值既写进目标内存,也用于更新 CRC。下方还画出了长度 45 时的尾部重叠。
主体可以简化成这样:
cpp
// 示意:生产实现包含长度分支、硬件选择和尾部处理
load_8_bytes(v0, source + 0);
load_8_bytes(v1, source + 8);
load_8_bytes(v2, source + 16);
load_8_bytes(v3, source + 24);

store_8_bytes(destination + 0, v0);
store_8_bytes(destination + 8, v1);
store_8_bytes(destination + 16, v2);
store_8_bytes(destination + 24, v3);

h0 = crc_update(h0, v0);
h1 = crc_update(h1, v1);
h2 = crc_update(h2, v2);
h3 = crc_update(h3, v3);
四个载入值 v0..v3,既写目标缓冲,又更新 CRC 状态。哈希部分因此不用再为整段字符串单独发一轮加载。CRC 本来是循环冗余校验码,现代 CPU 给它备了单条指令,BqLog 借这条指令算哈希------一次更新就是一条指令。
固定 8 字节的 memcpy 通常会被编译器展开成载入和存储指令,也避免源码直接对未对齐指针解引用。
到这儿,第二遍读取是省掉了。但别急着庆祝:那八条 crc_update 指令本身也要执行时间。拷贝免费了,哈希不免费------这笔账怎么算,下一节见。
2. 一个 CRC 累加器为什么喂不饱 CPU
算哈希最自然的写法是一个累加器从头算到尾:
text
h = crc(h, v0)
h = crc(h, v1)
h = crc(h, v2)
h = crc(h, v3)
问题出在依赖上:第二次更新要用第一次算出的新 h,第三次又要等第二次。CPU 即使会乱序执行,也没法在输入还没算出来的时候开工------四条指令只能串行排队。
这里要分清两个经常被混为一谈的概念:延迟 和吞吐。一条 CRC 指令从进入流水线到出结果,可能要经过几个流水级------这是延迟,假设 3 个周期。但执行单元并不需要等上一条出结果才收下一条,只要新指令不依赖前面的结果,它每个周期都能接收一条------这是吞吐。
回头算那笔账。单个 h:第 0 个周期发射第一条更新,第二条要用它的结果,得等 h 在(假设的)第 3 个周期出炉,于是四次更新分别在第 0、3、6、9 个周期发射,中间的发射槽全空着。换成四个独立状态 h0..h3:四次更新谁也不等谁,第 0、1、2、3 个周期陆续进入流水线。数字是假设的,但差别是真的------上一节的代码里写成 h0..h3 四个变量,就是为了把一条长依赖链拆成四条短链。每条链内部仍有依赖,链与链之间互不拖累;乱序调度器还能见缝插针,把已经准备好的 load、store 填进等待的空隙。这是同一个核里的指令级并行,一个额外线程都不用。
循环结束后,四个状态通过旋转、异或组合成 64 位哈希。所以这个哈希不等于把全部字节喂给单个累加器算出的标准 CRC------没关系,它只是模板查找的内部 key,只要融合拷贝和纯哈希两条路径遵循同一个定义就行。
还有个小尾巴:主循环每次吃 32 字节,末尾余数怎么办?按 16、8、4、2、1 字节逐级分支当然行,但分支本身也是钱。当前实现干脆从字符串末尾取最后 32 字节------以长度 45 为例,主体处理 [0,32),尾部处理 [13,45),中间 [13,32) 重读一遍。目标偏移相同,拷贝结果不变,哈希算法本来就按这个重叠方式定义。用少量重读,换尾部没有分支------和前面"用少量内存换少一轮加载"是同一个抠门思路。短于 32 字节的输入另走短串分支。
3. 算好的哈希给谁用:模板表的 L1 和 L2
哈希算完了,拿去干什么?第一件事是别浪费:生产者把结果写进 40 字节日志头的 format_hash 字段(第一篇图 4 里那个头部),跟着记录一起交给消费者。消费者遇到非零 format_hash 就直接用,为零才走纯哈希路径现场重算(调用栈拼接、wrapper 填充格式这类拿不到字符串地址的路径,以及哈希值恰好为零的情况),日志不会丢。这个 64 位值只是运行时 key,不写进文件。
消费者拿它干什么?查模板。第一篇把重复格式抽成了模板,每条日志只存模板索引,于是消费端每来一条日志都要回答一遍:这个格式对应哪个索引?
先想清楚访问模式再选数据结构。日志有极强的时间局部性:程序反复执行同一批日志语句,刚用过的格式很可能马上再用。所以 Appender 在大表前面放了一张很小的直接映射表:格式 L1 有 256 槽(约 4 KiB),线程 L1 有 64 槽(约 1 KiB)。每个 key 只对应一个候选槽,比对完整 key,命中就完事,一次探测都不用多走。
这里的 L1、L2 是 Appender 自己维护的两层软件缓存,借的是 CPU 缓存层次的思想:让常用的数据留在手边。小表反复访问的范围集中,更容易一直待在 CPU 数据缓存里;一次 L1 命中,既省掉大表查找,也省掉访问大内存的机会。名字像,但这两张表并不固定在处理器的哪一级。
两个 key 撞上同一个 L1 槽时,后来的替换原来的,下次找不到再去 L2 查,查到了填回 L1。常用格式走短路径,冷门格式有大表兜底。另外线程模板还有一步更省的:SISO 批读让同一线程的记录连续到来,这条线程 ID 若和上一条相同,上次的模板索引直接复用,连选槽都免了。
L2 用的是开放寻址加线性探测:表项直接放数组槽位里,目标槽被占就往后找。沿指针跳节点的开销没了,而且 CPU 按缓存行取数,读进一个槽位时邻近槽位往往一起进缓存,向后探测经常白捡------这是空间局部性,和上面的时间局部性打配合。表数据怎么摆也有讲究:key 8 字节、value 4 字节,放进一个 struct 会被对齐撑成 16 字节;拆成 keys[] 和 values[] 两个数组,每槽合计 12 字节,整张表小四分之一,同样的缓存装下更多表项。
这张表还有一处省指令的设计:查找失败时,把空槽的位置记下来。假设一个 key 从 3 号槽开始探测,3、4 号都被占,5 号发现是空------查找到此为止。可如果接口只有 find 和 insert,等 Appender 写完新模板要插入时,还得把 3、4、5 重新探测一遍。当前 find 未命中时返回一个 insert_token,记下槽位号和表的 table_revision:表没变过,插入就直接用这个槽;revision 变了(比如扩容,槽位全移位了)就老老实实重新查。重新探测的那些计算、判空、比较,连指令一起省了。
还有一个容易踩的坑:选槽位,说到底是取 key 的若干位出来做掩码。可输入可能是对齐过的线程 ID(低位整齐划一),也可能分类值摆在高位(低位几乎不动)------直接取低位,某些输入会成片挤在同一小片槽位里,探测段越拖越长。所以选槽之前先过一遍位混合(Murmur3 的 fmix64),取混合后的高位,让原 key 的每一位都参与决定起点。
格式 key 本身是把字符串哈希、分类和级别拼起来的:
cpp
key = format_hash ^ ((uint64_t(category_index) << 32) | level);同一格式串用在不同分类或级别,对应不同模板,所以 key 得同时带这几个字段。两种碰撞要分清:不同 key 选中同一槽,继续探测就是;不同格式撞上完全相同的 64 位 key,快路径不做字符串复核,会被当成同一个模板------全靠 64 位 key 说话,就得付这个代价。缓存满了也有讲究:L2 每 64 次新插入才接纳一次,没被接纳的格式照样写文件,下次找不到就再写一份模板------文件大一点,日志照样解码。
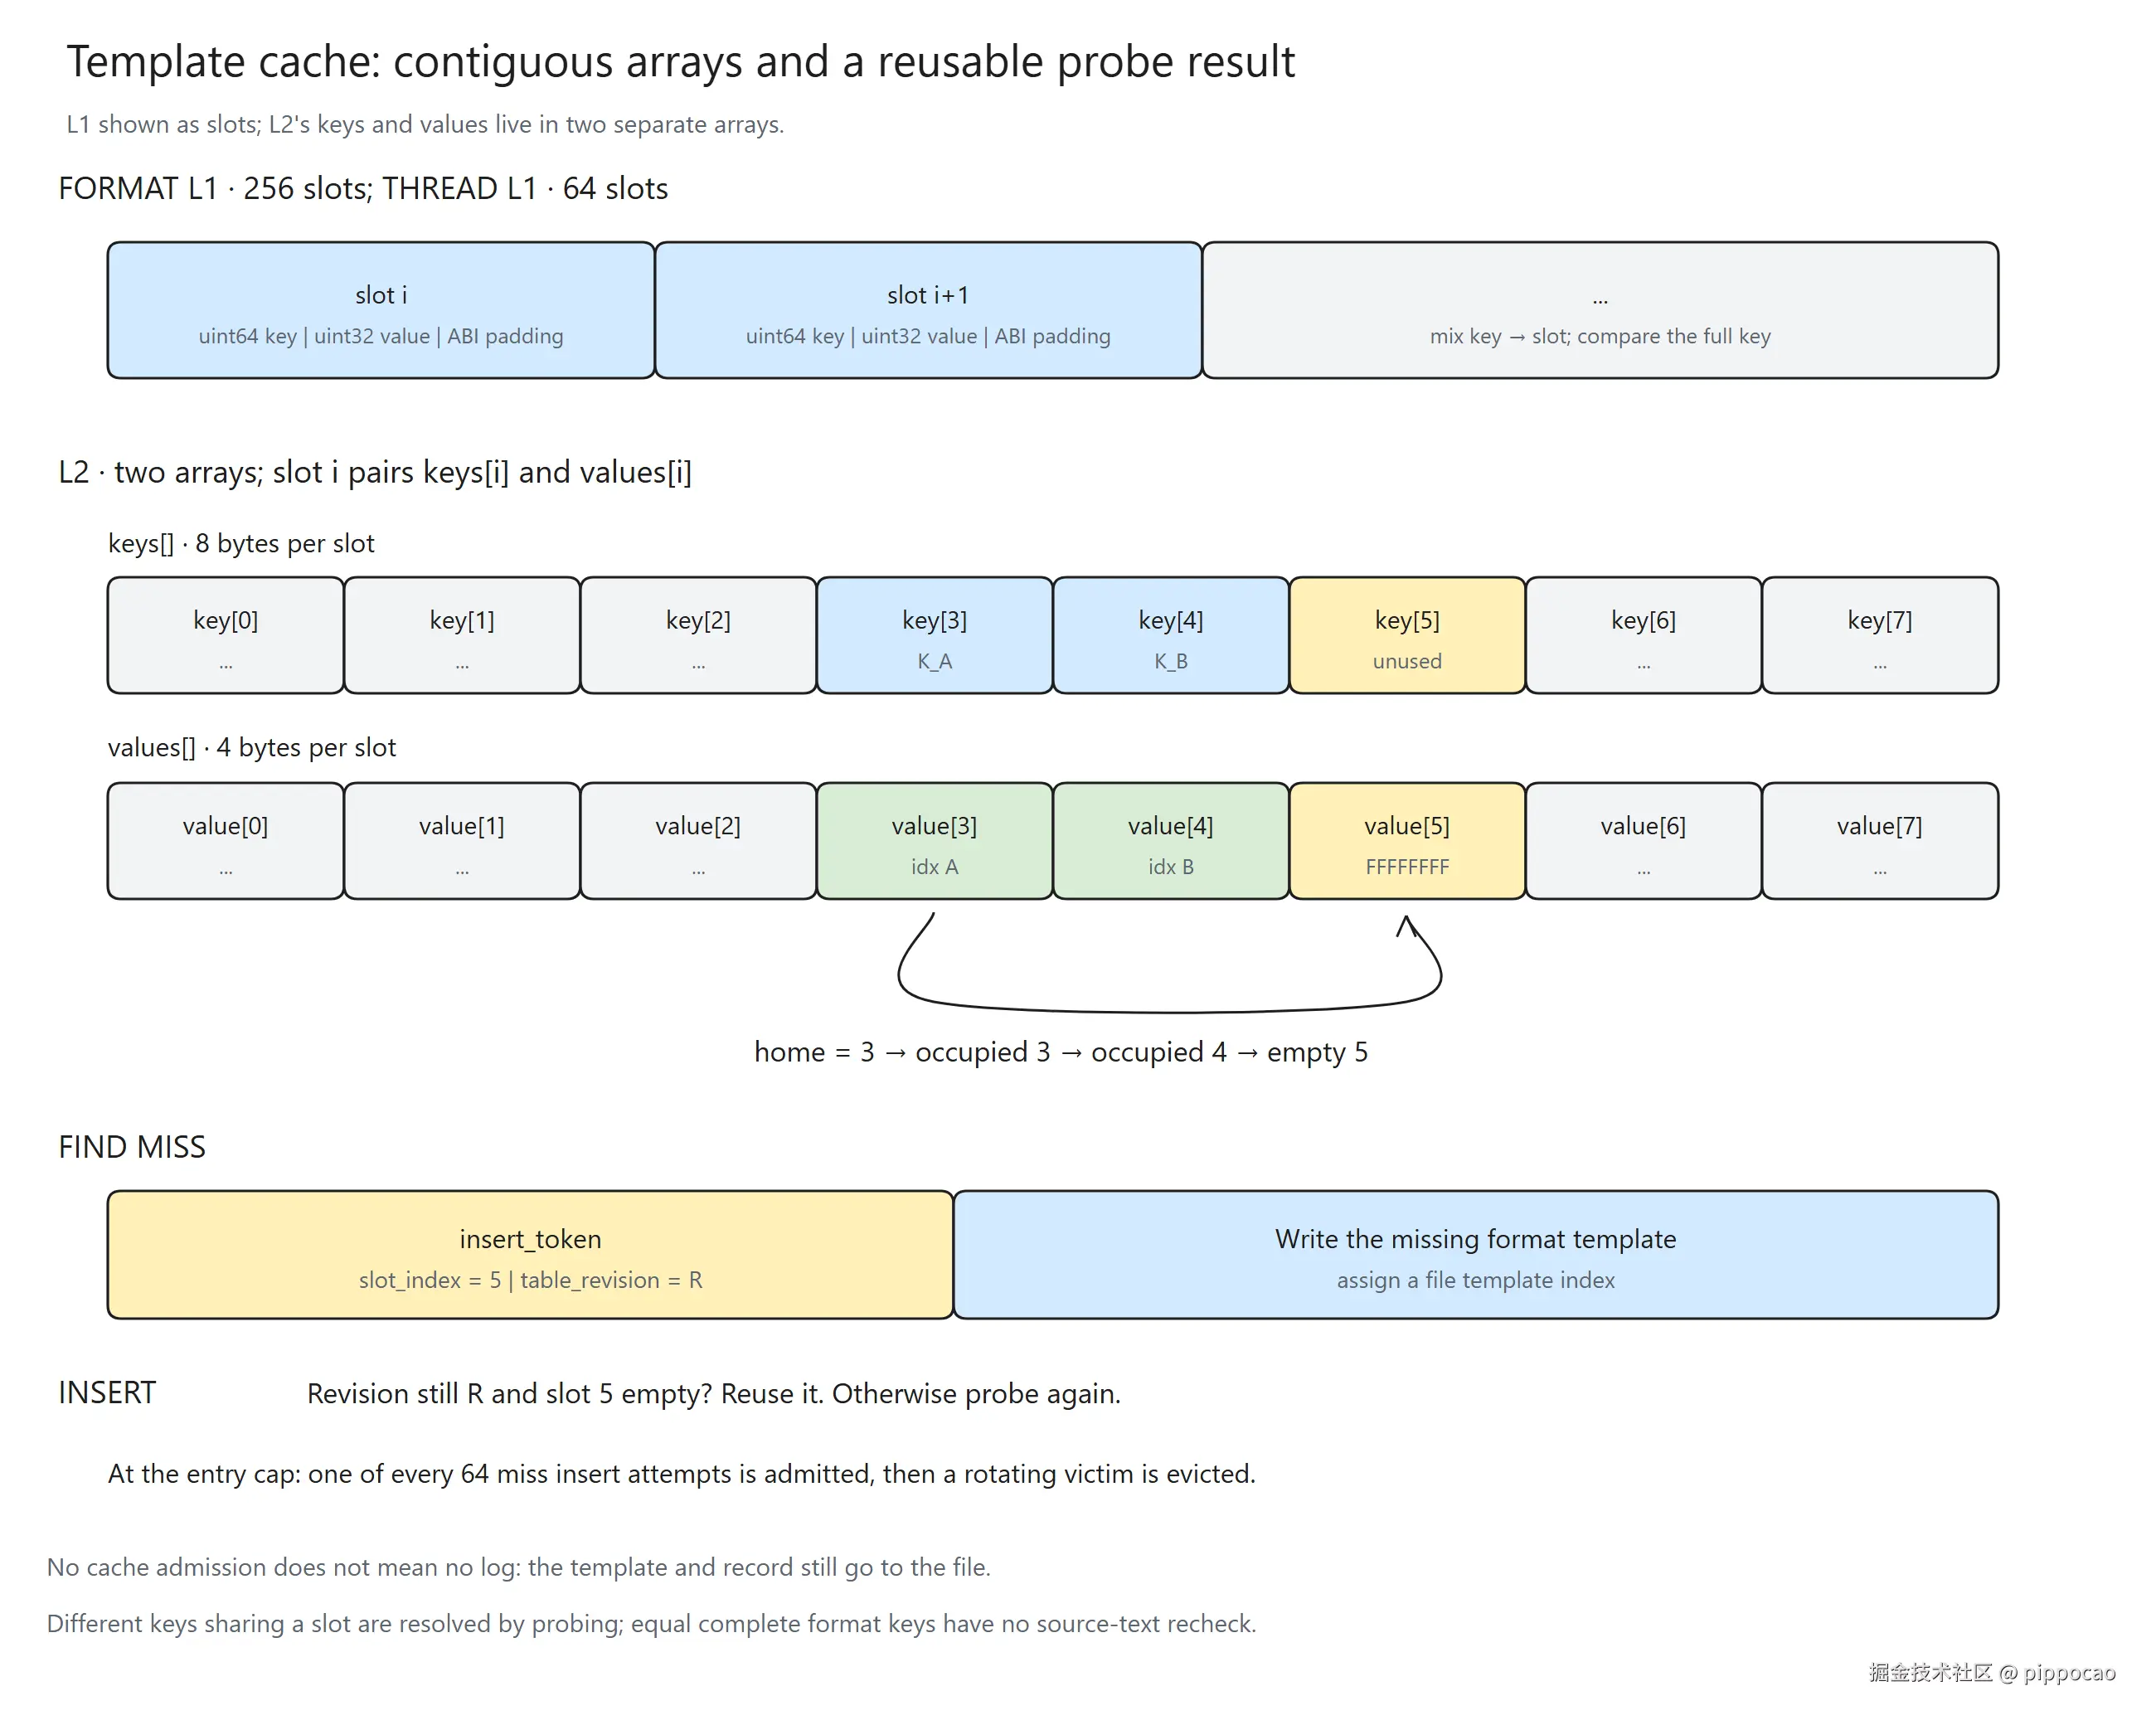
图 2:256 槽直接映射的 L1 在上,keys 和 values 分成两个连续数组的 L2 在下;查找走过的空槽位置,交给后续插入复用。
4. UTF-Mixed:别把每个字符都当成最复杂的那种
模板查到了,接下来编码参数。字符串参数里也藏着讲究。
第一篇讲过 UTF-Mixed 的格式:ASCII 字符收窄成单字节,遇到不适合快速处理的内容,剩下的整个后缀按 UTF-16 原样保存。为什么不定下心完整转 UTF-8?因为完整转码要逐个字符判断"你占几个字节",多字节序列还得一个个拼------太贵。UTF-Mixed 的取舍是:简单字符走快车道,复杂内容整个打包带走,绝不为难自己。
快车道的关键判断是"这个字符是不是 ASCII"。UTF-16 里 ASCII 编码值在 0x0000..0x007F,高 9 位全是零。标量版本一次把四个 UTF-16 编码单元读进一个 64 位值,一个掩码同时查四组高 9 位:
text
v & 0xFF80FF80FF80FF80结果为零,四个字符全在 ASCII 范围,直接抽低字节打包。一次载入,检查和编码一起完------这是全文我最喜欢的一行。
SIMD 把同样的思路放大到整块:确认整块都是 ASCII 后一起收窄存储;碰到含非 ASCII 的块,就结束快速转换,写入 FF 标记,剩余内容按 UTF-16 原样保存。按块检查意味着分界处可能把几个本来能收窄的 ASCII 也留在 UTF-16 里------多留几个字节,换不用逐字符找精确分界。这笔账和 CRC 尾部的重叠重读,是同一种算法审美。
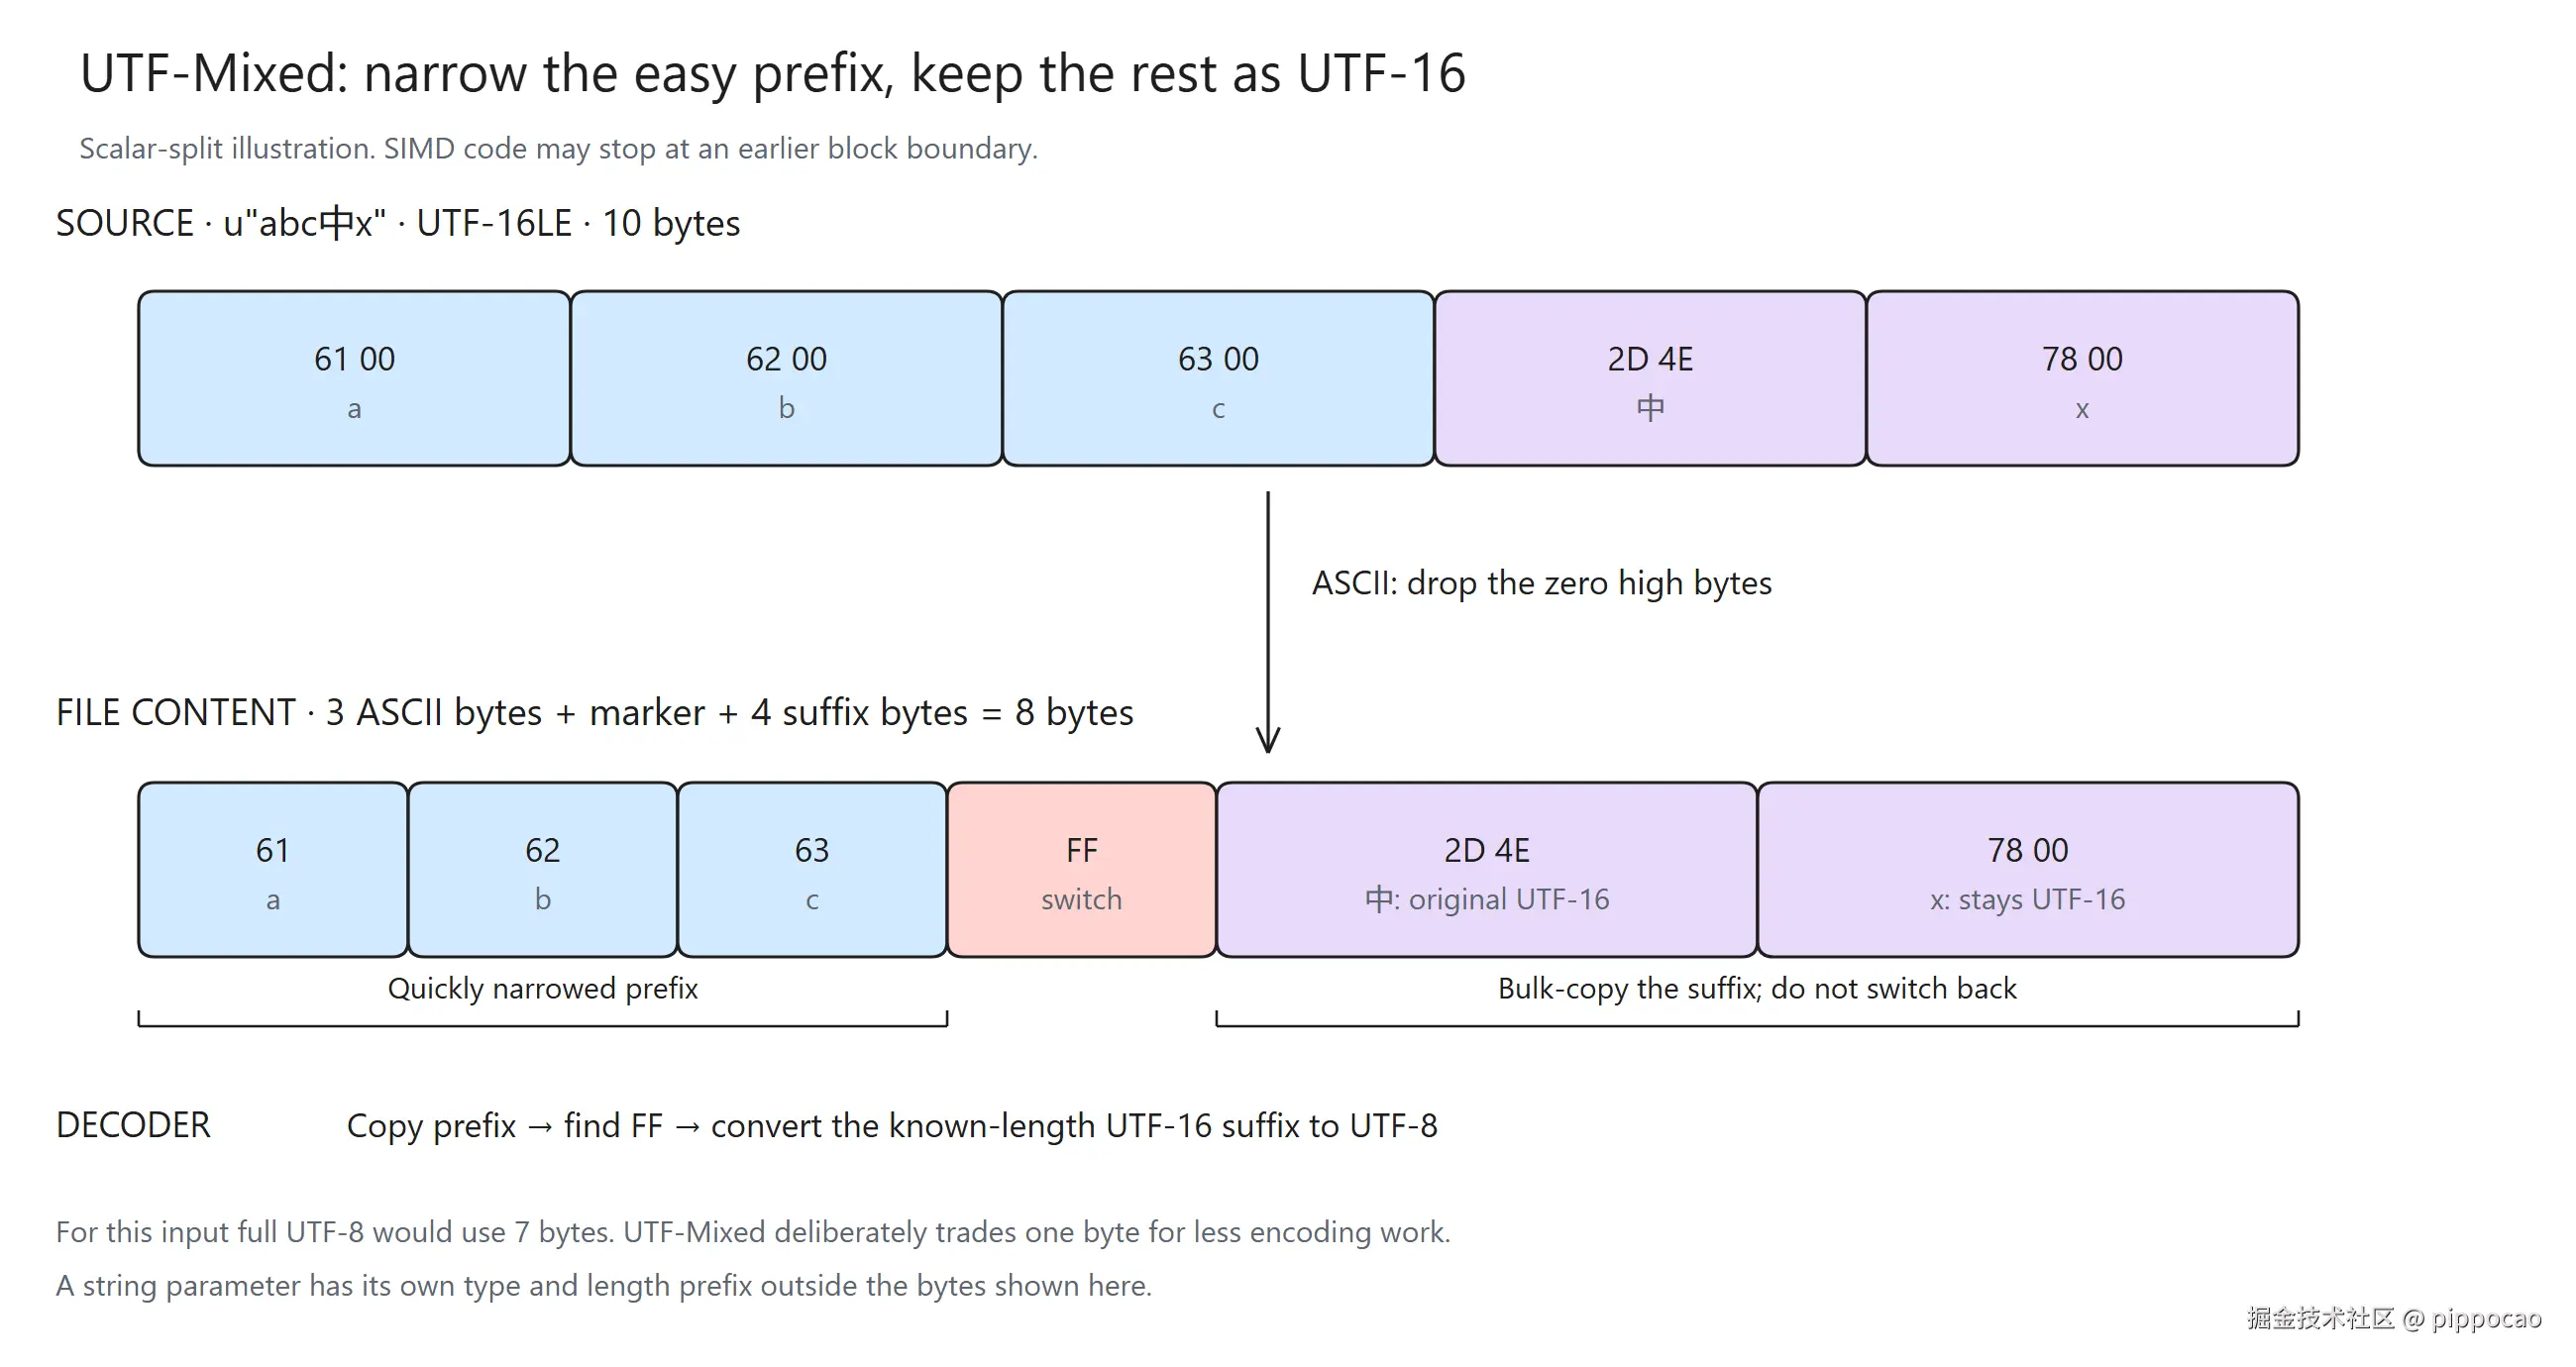
图 3:u"abc中x" 的 UTF-Mixed 编码全程------ASCII 收窄成单字节,FF 标记之后汉字保留 UTF-16;完整转 UTF-8 是 7 字节,UTF-Mixed 用 8 字节,多这一字节换的是不用逐字符转码。
模板命中后,相同格式不必每条日志重新转换;每次变化的参数字符串才需要单独过这条路径。续写旧文件时要把 UTF-Mixed 还原回临时缓冲才能恢复原始格式的哈希,但这次额外读取发生在打开文件时,不在逐条写入路径上。
5. 固定成本按批分摊:批量写出与分段加密
最后这两处优化招数不同,打的却是同一套拳:找到带固定成本的操作,让一批数据分摊它。
第一处是批量写出。一条日志几十字节,逐条调文件写入接口,每次都把系统调用的固定开销付一遍。Appender 把记录连续编码进写缓存,攒一批再写。write_cache_size 目标范围 64 KiB--4 MiB 按 2 的幂规整,缓存越大写调用越少,代价是内存占用和待刷出的数据变多;特别大的记录可能临时超过目标值,所以它不是绝对内存上限。加密的批量 XOR 还多一个讲究:数据和掩码要同时载入,两个地址得方便一起上 SIMD------以 32 字节对齐为例,两边地址除以 32 余数相同,先处理掉零头就能同时对齐、连续跑 AVX2 循环;余数不同就怎么也凑不齐。掩码的位置由文件绝对偏移决定,所以只要把写缓存开头的 padding 调成对应值,两边的相对对齐就能维持一整段;Appender 在创建段、刷新这些边界上调一次 padding(可能要 memmove 一下缓存里已有的数据),后面整批记录都受益。
第二处是分段加密,第一篇讲过结构,这里算成本:
text
总成本 ≈ 段数 × 每段初始化成本
       + payload 字节数 × 稳定变换成本
       + 批次数 × I/O 固定成本
段初始化包括用 RSA 包装 AES 密钥、用 AES 处理 32 KiB 掩码,只在建段时做一次;后续 payload 在原地按批循环 XOR。段越长,初始化被越多日志分摊。实测第二篇那个用例:单线程 200 万条,压缩 95 ms、加密压缩 102 ms;10 线程 2000 万条,507 ms vs 493 ms------加密占比会随并发和写入量变化,不是恒定税。提个醒:这套方案没有 AEAD 认证标签,要验证日志没被篡改得另加机制。
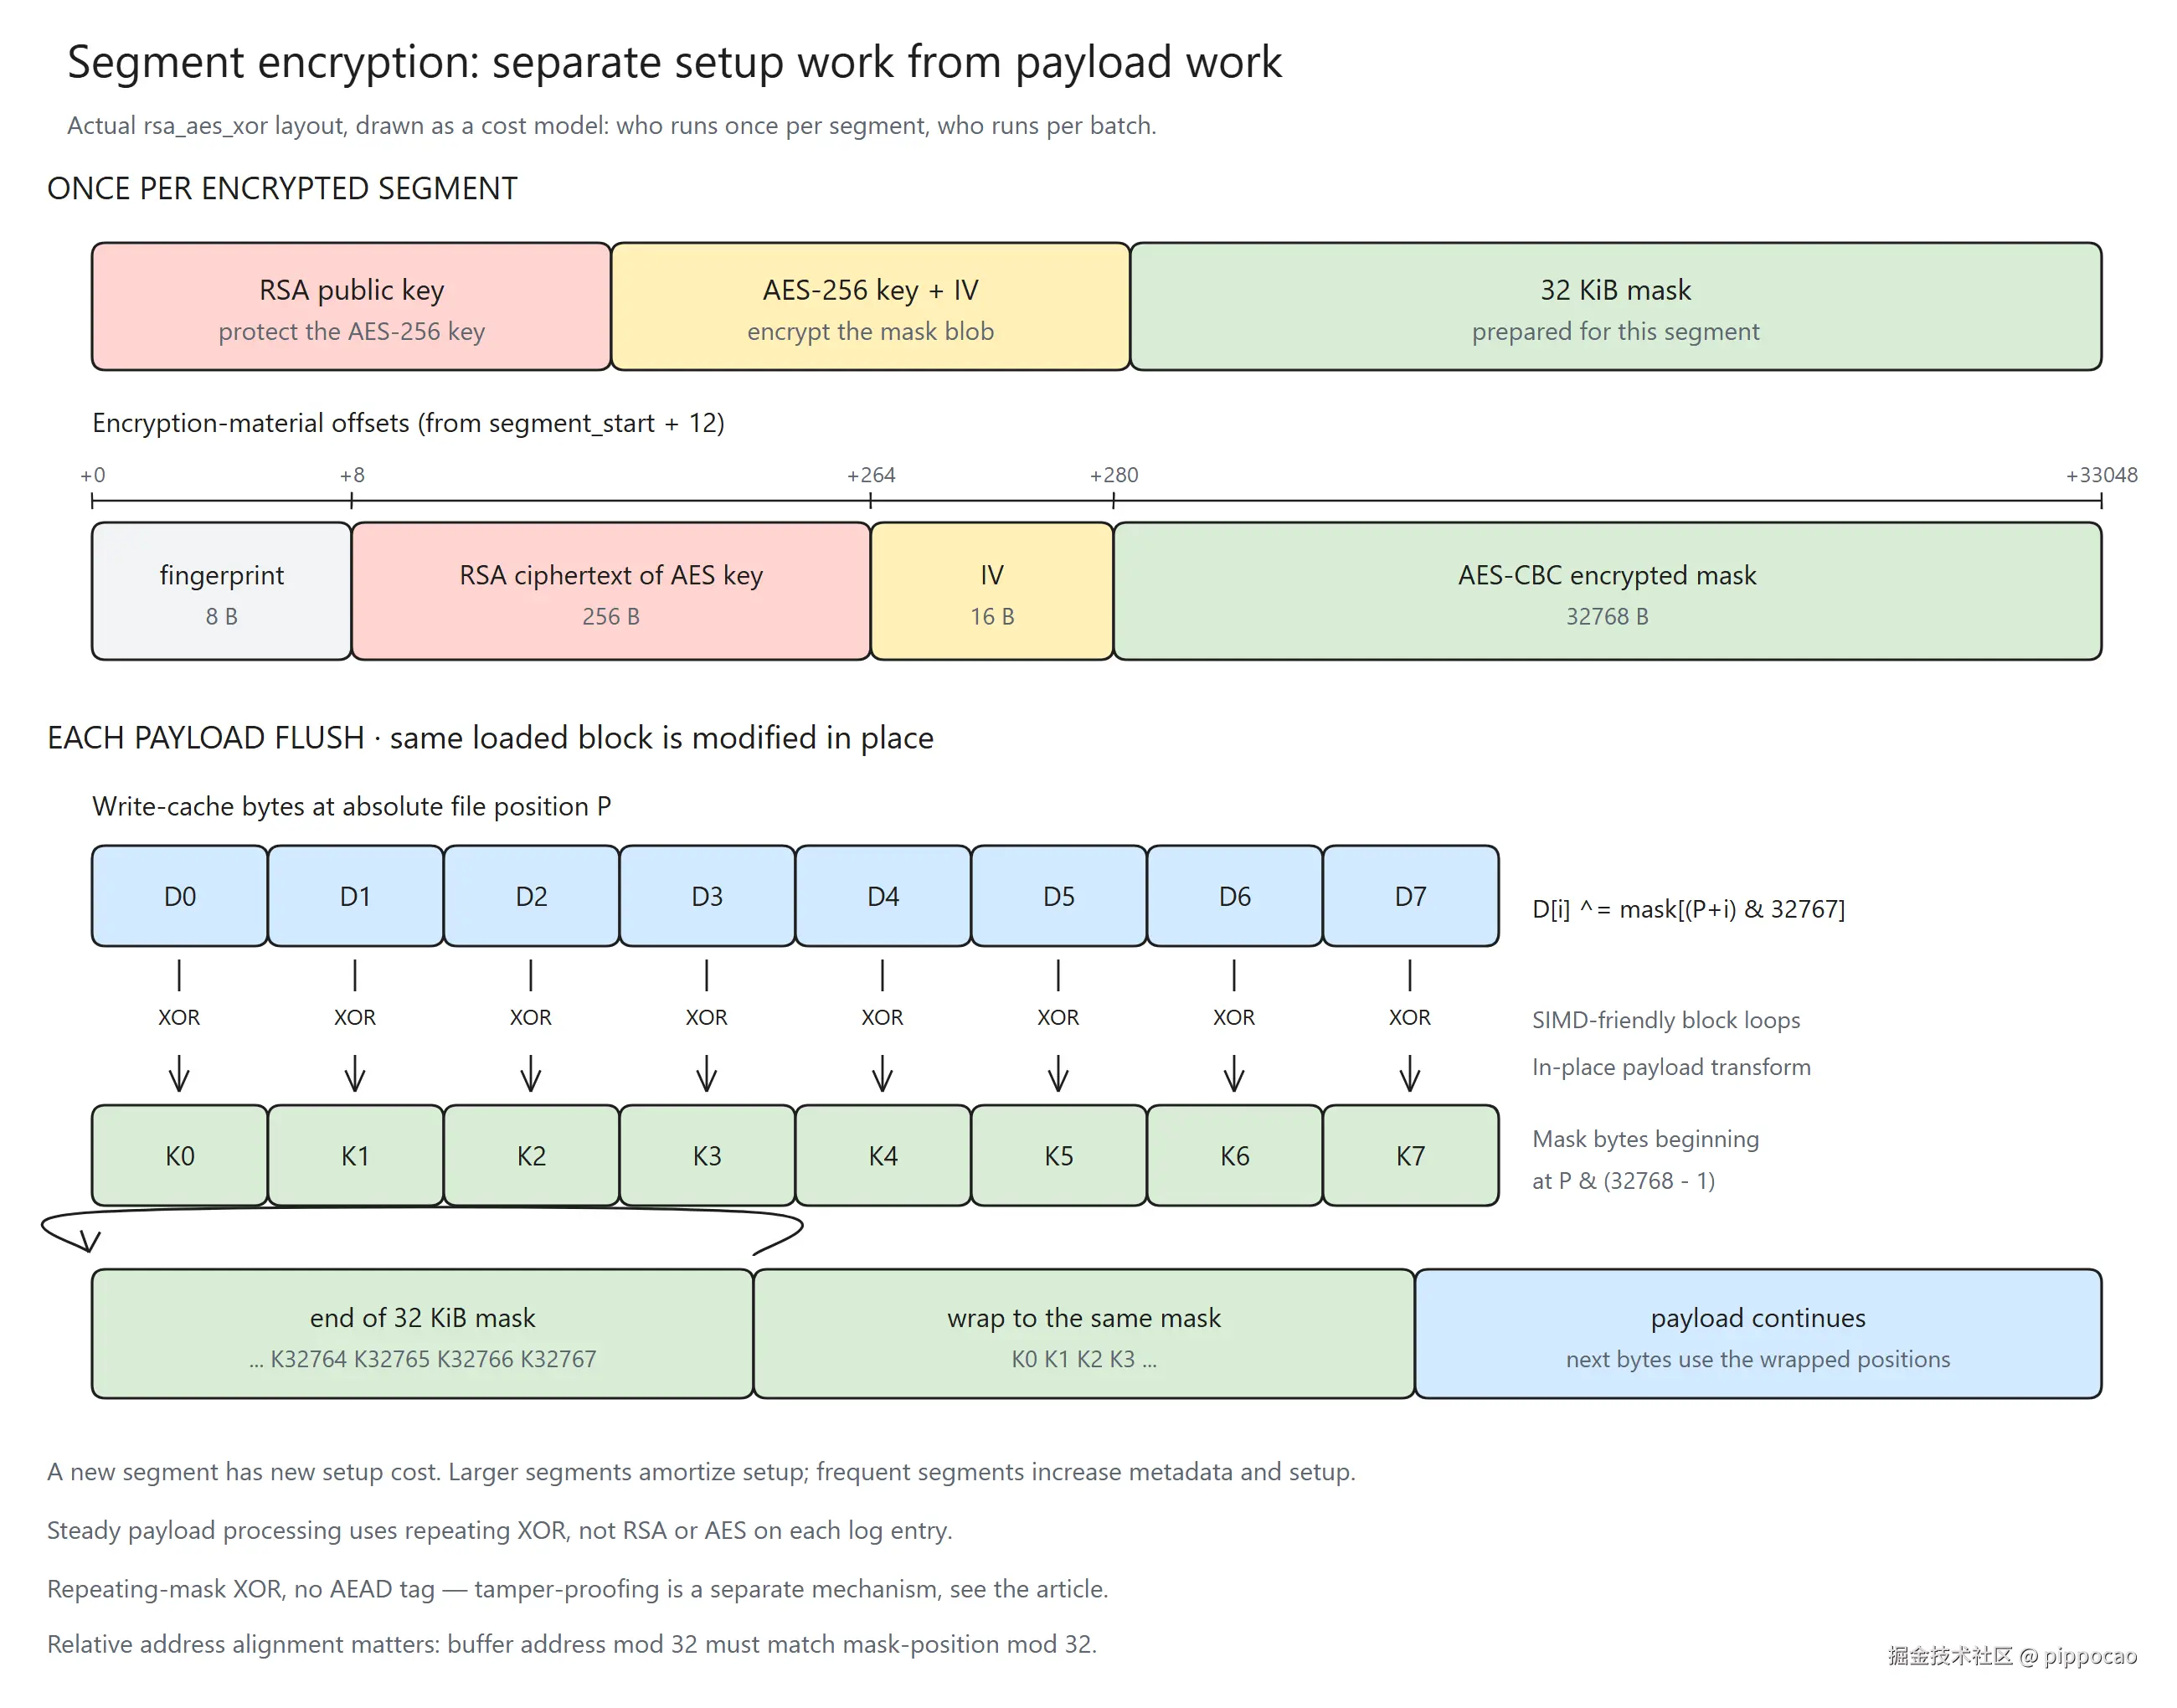
图 4:分段加密的成本结构------每段开头一次性支付 RSA 包密钥和 AES 生成掩码,段内 payload 按文件偏移循环 XOR;段越长,初始化被摊得越平。
6. 总结
这几招拆开看,没有一招是了不起的学问:拷贝时顺便算个哈希,多摆几个累加器,查找失败时记住一个空槽,一个掩码查四个字符。都是顺手就能做的小事。但日志的特点就是量大,同一条路径每秒走几万遍,顺手省下来的每一点,最后都会影响性能。
执行路径上的功夫先聊到这。这个系列还没写完,后面有什么好题目,接着聊。
附录:怎么知道优化是真有效,而不是只看起来聪明
上面这些改动降低了部分工作量,但不能从"少一次遍历""指令更宽"直接推算总耗时。要测单项收益,对照组只能变一个因素:
| 想验证的变化 | 对照方式 | 同时检查 |
|---|---|---|
| 融合拷贝哈希 | 同一哈希算法,融合 vs 拷贝后独立 hash | 数据相同、长度、对齐、冷热缓存 |
| 四条 CRC 链 | 固定输入长度和 CRC 更新次数,只改变状态依赖关系 | 查看汇编和每字节周期;这是指令依赖实验,两者哈希定义不同 |
| 软件 L1 | 保持 L2 和输入不变,比较启用与旁路 L1 | 软件命中率、CPU 缓存未命中、查找耗时 |
| L2 布局与 token | 相同容量与接纳策略,比较 struct 数组和分离数组;相同 miss 序列,是否复用探测位置 | 探测次数、缓存未命中;扩容后 token 是否正确失效 |
| UTF-Mixed 与 SIMD | 相同 UTF-16 输入,比较完整转 UTF-8、标量 UTF-Mixed、SIMD UTF-Mixed | 英中混合内容的耗时和体积;切分位置可不同,解码内容必须一致 |
| 批量写出 | 相同输出和满缓冲策略(第二篇 §8.2),调整缓存大小 | I/O、RSS、调用时延与 flush 时间 |
整体压测还要统计最终能解码多少条日志。一组配置在缓冲满时丢弃、另一组阻塞,只比调用速度会高估前者。
test_utils.h 检查不同长度和偏移下的拷贝/哈希一致性;test_bounded_hash_cache.h 覆盖 token 失效、容量和分配失败;test_compressed_cache.h 检查缓存行为与最终可解码输出。仓库的 benchmark 自带多格式模板用例(benchmark/cpp/main.cpp 里的 test_compress_multi_format_*),可直接用于模板缓存的对照测量。
对照源码继续看
- util.cpp:融合拷贝哈希、CRC 多链与 UTF-Mixed。
- bq_log_api.cpp、bq_log_go.cpp:format_hash、native 调用与总线提交。
- appender_file_compressed.cpp、bounded_hash_cache.h:模板缓存、token、编码。
- appender_file_base.cpp、appender_file_binary.cpp:写缓存、相对对齐、分段与加密。
- test_utils.h、test_bounded_hash_cache.h、test_compressed_cache.h:对应正确性检查。