周日晚九点半,书房台灯底下,老周在群里甩过来两份 JD,说明早十点截止,问我哪个值得投。一份是大厂的 AI 应用工程师,写得规规矩矩;另一份是家中小公司的,八条硬性要求,没写加分项。我简历改到第三版,实在不想再靠感觉拍板,就把 tri-jobhunt 翻出来当裁判用。
结果两份跑下来,一份 70 分,另一份也是 70 分。而我清清楚楚知道,其中一份我八条硬性要求全中,另一份缺了 onnx。
我手上的判据,其实有两套
tri-jobhunt 是单入口分发的,JD 匹配这块归它儿子 tri-jd 管。判据写在两处:references/ats-compliance.md 第四节给了两个公式,children/tri-jd/SKILL.md 给了五级档位。
第一个公式叫 Match Score,等于匹配到的关键词除以必需关键词总数,目标 80 分以上。第二个叫 Overall,是 (Required% × 0.7) + (Preferred% × 0.3)。档位分五档:90-100 过度合格、75-89 优秀立即投、60-74 良好配强求职信、50-59 stretch、50 以下除非 dream job。
我当时没多想,直接按第一个算。大厂那份 JD 我数了数,七条硬性要求命中六条,85.71%,过了 80 的线,落在「75-89 优秀立即投」。我甚至已经开始想求职信开头怎么写。
第一次反转:85 分和 70 分说的是同一份 JD
准备动手写求职信的时候,我回头看了一眼 tri-jd 的步骤表,发现它第 2 步写的是 Overall 那个加权公式。同一份 JD,加分项三条我只中一条,那 Overall 就是 85.71 乘 0.7 加 33.33 乘 0.3,等于 70.00。
70 分落在「60-74 良好配强求职信」。
同一份 JD,一个说优秀立即投,一个说配强求职信。我把这套判据按字面敲成脚本,拿六个真实形态的用例跑了一遍,两个用例两套口径差了两个档位------像「硬性九中十、加分零中五」这种,Match Score 给 90 分判过度合格,Overall 给 63 分判良好。六分之二,三分之一的概率会打架,这已经不是我粗心的问题了。
第二次反转:全中也只能拿 70
更让我愣住的是第二份。那家小公司 JD 只有八条硬性要求,没有加分项,我八条全中。
我以为这至少得是满分。但按 Overall 公式,Required% 是 100,Preferred 那 0.3 的权重没有分母,实现上只能按 0 算,100 乘 0.7 加 0,等于 70。
八条全中,70 分,和第一份缺了 onnx 的那个岗位一模一样。
我把这条单独拆出来看了会儿才反应过来:加权公式里,没写加分项不是「加分项为零分」,是「这一项不适用」。把不适用的项当成零分,等于硬性要求全中最多也只能拿七成分------「90-100 过度合格」这一档,在 JD 没写加分项的形态下根本不可达。而现实里,中小公司的 JD 不写加分项是常态。
顺手量出来的另外四处
既然已经把公式敲成脚本了,我就顺手把整条判定链扫了一遍。
分级区间写成了「90-100 / 75-89 / 60-74 / 50-59」这种整数闭合写法。加权之后分数是小数,比如 Required 一中一、Preferred 七中十一,算出来是 89.09。89.09 够不上 90,又超出 89,哪一档都落不进去。我穷举了 Required 一到十五项、Preferred 零到十五项的全部组合,18360 组里有 528 组落在缝里,占 2.88%,缝隙集中在 (89,90)、(74,75)、(59,60)、(49,50) 这四个开区间。
再往下是除零。JD 里如果没解析出 Required 关键词,第一个公式就是零除零,整包文档里没有任何一句说这时候该怎么办。
还有否决和分级的顺序。tri-jd 第 3 步分级、第 4 步否决,可它没写谁覆盖谁。于是同一个岗位可以既「过度合格」又「否决」------硬性加分全中给 100 分,同时因为缺必需执照被否决,两条结论并排输出,看的人自己挑。
还有一处是术语没闭环。关键词分 Hard / Soft / Industry 三类,进公式却按 Required / Preferred 二分,两类之间没有任何映射;密度目标写「Critical 2-4 次、Important 1-2 次」,但 Critical 对应哪一类、超几次算堆砌,全都没说。
没去放宽公式,我写了八条裁决
这时候有两条路。省事那条是动数字:把目标线从 80 调到 70,或者把权重改成 0.8 和 0.2,让全中的那份显得好看点。
我没走那条。这分数是拿来回答「投不投」的,动分母让它变好看,等于把结论往我想要的方向推------那我还算它干什么。
所以我把它敲成了脚本,scripts/jd_match.py,零第三方依赖,八条规则:Required 为空直接报 UNKNOWN 退出码 3,绝不除零;Preferred 没列出就把权重还给 Required,显式标注 weight_reallocated;对外只给一个 score,旧的 Match Score 降级成分项指标不参与分级;分级改成 ≥90、≥75、≥60、≥50 的连续区间,无缝隙;否决优先于分级,命中就覆盖档位并标 superseded_by_disqualifier;写错的否决词不静默放过,退出码 3 上报;三分类只标注不进分;密度超上限标 stuffing_risk。
bash
$ python scripts/jd_match.py --required arkts,harmonyos,rag,python,prompt-engineering,agent,onnx \
    --preferred ocr,vector-db,typescript --resume arkts,harmonyos,rag,python,prompt-engineering,agent,ocr
Required 命中 6/7 (85.71%)  Preferred 命中 1/3 (33.33%)
score = 70.00  ->  GOOD_APPLY  [60-74 良好配强求职信]
缺失必需项:onnx
核心那两行是这样的:
python
if pre:                                  # R2 权重重分配
    score = req_cov * 0.7 + (len(pre_hit) / len(pre)) * 100 * 0.3
else:
    score = req_cov                      # 没加分项不等于加分项零分
# R4 连续区间:>=90 / >=75 / >=60 / >=50,其余落 DREAM_ONLY
第二份 JD 现在跑出来是 100 分,档位「过度合格」,并且会明确告诉你权重重分配过。第一份还是 70 分,但这次它是唯一答案,不会再有第二个公式跳出来说 85。
顺便一提,这套「没有精确数字就用保守估算」的问句,我后来搬去写季度述职了,雷达鸭自动生成的周报也照这个口径填,省得每次被问「这个 40% 哪来的」。
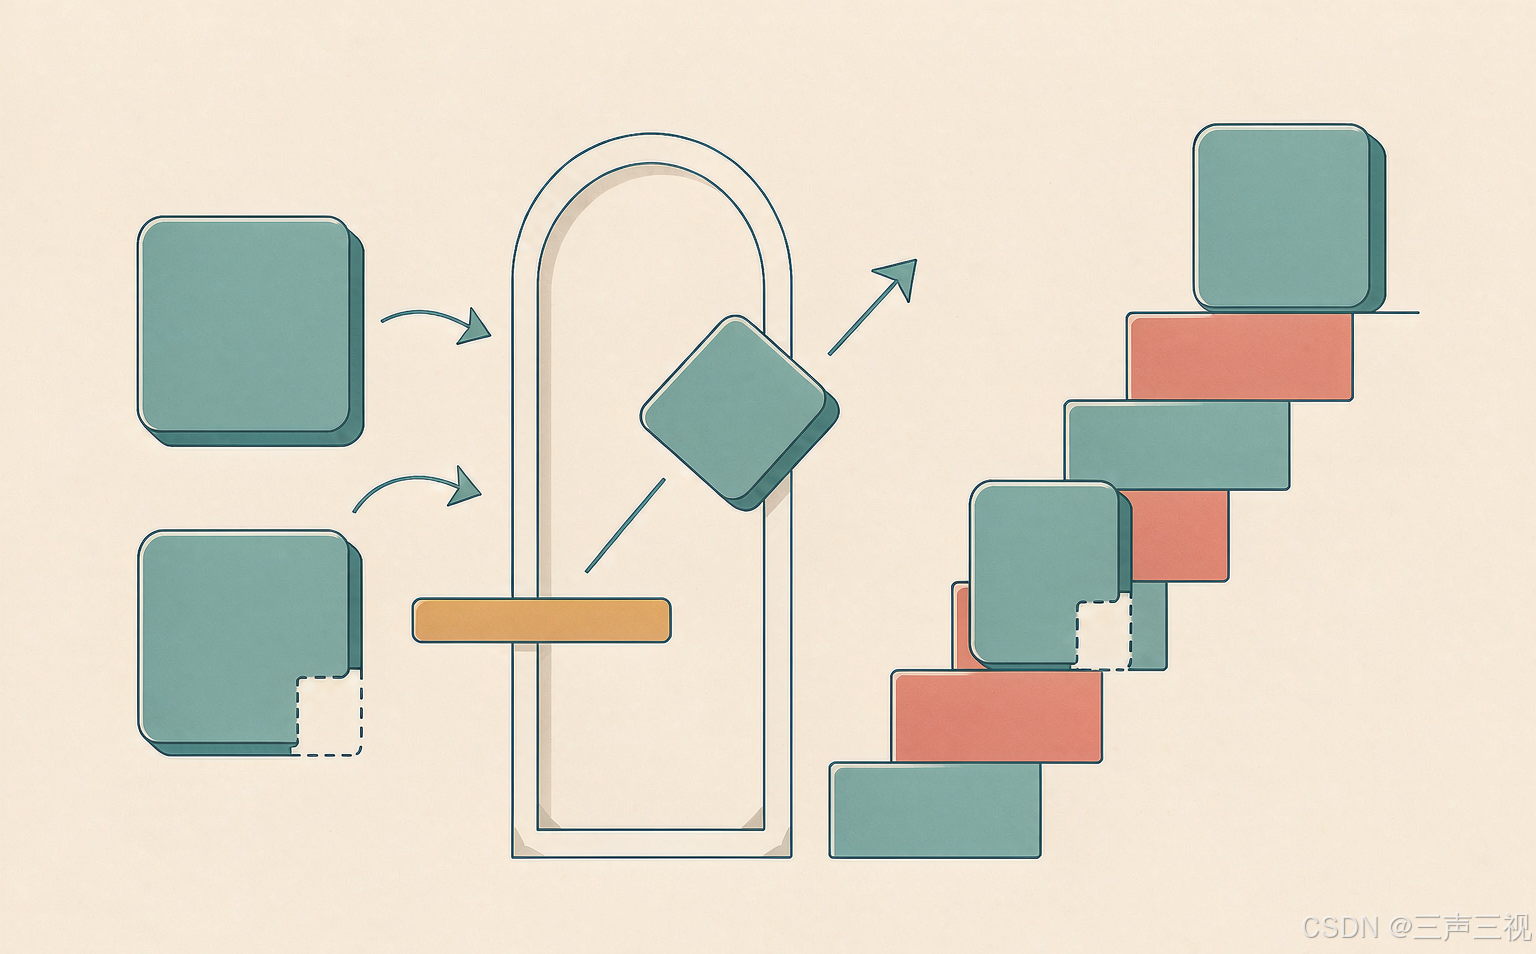
上图为示意:左侧两份 JD 在旧口径下都挤进同一个「良好」档,右侧经裁决后一份落到「良好配强求职信」、一份升到「过度合格」;中间闸门口那几格代表连续区间,格与格之间不留缝隙。方块与配色只表达结构,不代表精确计数。
前后差多少
| 指标 | 修之前 | 修之后 |
|---|---|---|
| 两份 JD 定级耗时 | 手算约 25 分钟,返工 3 遍 | 单次裁决 101 毫秒,我复核 6 分钟 |
| 同一输入的档位结论 | 2/6 用例两套口径打架 | 1 个 score,唯一档位 |
| 匹配分口径 | 2 套(Match Score / Overall) | 1 套,旧口径降级为分项指标 |
| 无加分项形态 | 全中仅 70 分,最高档不可达 | 权重重分配,全中 100 分 |
| 分级漏档 | 528/18360 组取值无档位(2.88%) | 连续区间,0 组漏档 |
| 空集行为 | Required 为 0 时零除零 | 显式 UNKNOWN,退出码 3 |
| 否决与分级 | 可同时输出「过度合格」与「否决」 | 否决优先,档位标 superseded |
| 判定块带置信三要素 | 0/4 | 4/4 |
顺带把上游依赖检测也敲成了脚本 dep_check.py,原来那句「检查 children 与 references 存在性」只是说明文字,没有东西执行它。版本从 1.0.3 提到 1.1.0,SKILL / CHANGELOG / _meta / tests 四处一致,check_update.py 跑出来 state=A 退出码 0。回归方面,jd_match.py --selfcheck 12 条全过,dep_check.py --selfcheck 2 条全过,测试补了 T13-T21 九条。
末了
最具体的感受是:我以前那种「数一数关键词、过没过 80」的判断,跟抛硬币的区别只在于它看起来很认真。现在两份 JD 摆在一起,一个 70 一个 100,我五秒钟就知道该把求职信的时间花在哪份上------这不是因为它算得更准,是因为它只剩下一种算法。
下次拿到一份号称能替你做决策的判据,我建议你先别问它有多全面,先给它两份你已经知道答案的输入。一份你明显配得上,一份明显够不着,看它给不给得出不一样的分。给不出,那它现在还是篇好文章,不是个好工具。
我是 老三,十年软件开发,软件设计师、注册人工智能工程师,这两年在做 Web 前端和鸿蒙 ArkTS 北向应用,顺手折腾 AI 自动化这套东西,不定期在写点鸿蒙和 AI 的实战笔记。
本文遵循 MIT 协议,转载请注明出处。