https://arxiv.org/pdf/2501.05767
摘要
多模态大语言模型(MLLMs)的最新进展显著提升了其对单图像的细粒度感知能力以及对多图像的一般理解能力。然而,现有的 MLLMs 在复杂的多图场景中实现精确定位(Grounding)方面仍面临挑战。为此,我们首先探索了一种思维链(CoT)框架,将单图定位与多图理解相结合。虽然该方法部分有效,但由于其非端到端的特性,仍然不稳定且难以捕捉抽象的视觉信息。因此,我们推出了 Migician,这是首个能够在多张图像间执行自由形式且精确定位的模型。为支持这一研究,我们发布了 MGrounding-630k 数据集,该数据集包含从现有数据集衍生的多种多图定位任务数据,以及新生成的自由形式定位指令跟随数据。此外,我们提出了 MIG-Bench,这是一个专门为评估多图定位能力而设计的综合基准测试。实验结果表明,我们的模型实现了显著优越的多图定位能力,比现有最佳 MLLMs 高出 24.94%,甚至超越了许多 70B 规模的模型。我们的代码、模型、数据集和基准测试已在 https://migician-vg.github.io/ 完全开源。
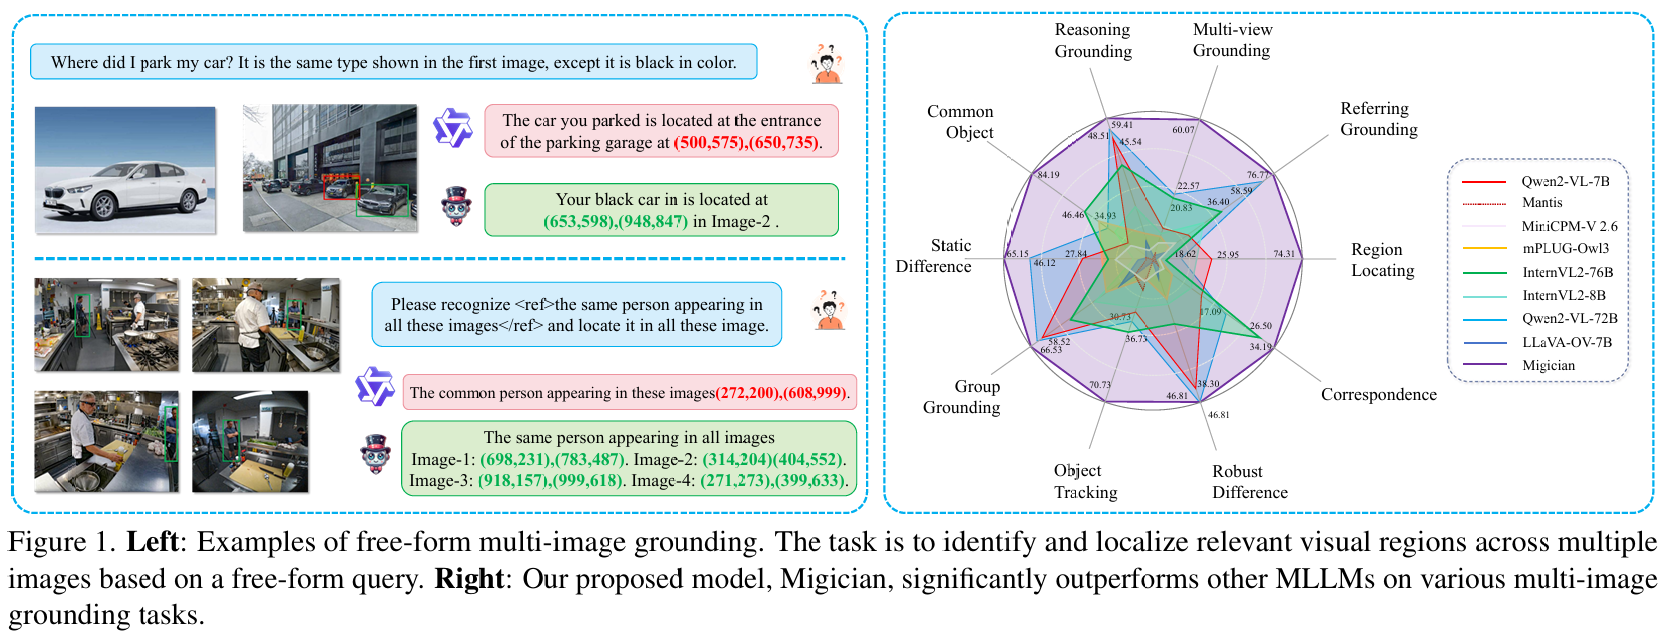
1. 引言
近年来,多模态大语言模型(MLLMs)取得了显著进步,展现出卓越的跨模态理解能力,并在各种视觉-语言任务中取得了杰出表现 1, 7, 13, 16, 21, 30, 49。随着这些模型的不断演进,其能力已从图像级理解扩展到细粒度的视觉定位 5, 40, 51。这使得 MLLMs 能够处理特定区域的输入和输出,从而开启了更广泛的现实世界多模态应用场景 35。
尽管现有 MLLMs 展示了令人期待的视觉定位能力,但这些能力主要局限于单图场景 20, 51。MLLMs 在自由形式多图定位(MIG)方面的潜力仍未得到充分探索。自由形式 MIG 要求模型有效地在多张图像间进行定位,其中输入查询和图像上下文可以以任意形式组织,从而实现灵活动态的交互。例如,如图 1 所示,模型必须理解查询图像中的白色汽车,并将其与文本提示"黑色"联系起来,以识别目标图像中的对应目标。这种能力解锁了广泛的应用场景,如自动驾驶中的细粒度环境感知 42、监控系统中的异常检测 2 以及具身机器人的目标定位 12。要解决自由形式 MIG 问题,模型需要具备视觉定位能力的同时,实现跨图像理解。
由此自然产生一个问题:我们能否整合现有 MLLMs 的单图定位和多图理解能力来解决 MIG 任务?在本工作中,我们提出了一种思维链(CoT)框架,首先利用多图理解生成文本指代查询,然后利用该查询通过单图定位进行目标定位。事实证明,这种方法对 MIG 任务非常有效,特别是在文本描述足够独特的简单场景中,展示了当前 MLLMs 处理此类任务的潜力。
然而,所提出的 CoT 框架在描述多图场景中的抽象视觉语义时存在困难,且两步过程导致推理时间翻倍。为解决这一问题,我们进一步提出了 Migician,这是一种具有竞争力的 MLLM,能够在多张图像间进行自由形式且精确的定位,作为 MIG 的端到端解决方案。为了逐步建立灵活的定位能力,我们基于提出的大规模 MIG 数据集(MGrounding-630k)采用了两阶段训练程序。首先,通过结合 MIG 任务和通用任务的数据来增强 Migician 的定位能力。然后,使用高质量的自由形式 MIG 指令数据对 Migician 进行进一步优化。此外,为了评估自由形式 MIG 场景的挑战,我们构建了一个综合的多图定位基准测试 MIG-bench,共包含 10 种不同的任务、5900 张多样化图像和超过 4200 个测试实例。我们观察到现有主流 MLLMs 在 MIG-bench 上的表现与人类表现之间存在显著差距。相比之下,Migician 能有效缩小这一差距并提升自由形式 MIG 的性能。
综上所述,我们的贡献总结如下:
- 我们探索了 MLLMs 的多图定位任务,并通过提出的 CoT 框架揭示了当前 MLLMs 的潜力和挑战。
- 我们介绍了 Migician,这是首个能够有效执行自由形式 MIG 的 MLLM。我们还发布了 MGrounding-630k,这是首个用于训练该模型的大规模 MIG 指令微调数据集。
- 我们引入了 MIG-Bench,一个用于评估多图定位能力的综合基准测试。实验结果表明,Migician 显著优于当前最佳方法。
2. 相关工作
多模态大语言模型 近年来,多模态大语言模型(MLLMs)的发展已从单图文本理解转向更多样化的能力 3, 24, 41, 48。在这些努力中,一些工作专注于使模型实现细粒度的视觉定位,要么通过简单的指令微调 5, 35,要么通过集成额外的辅助视觉组件 4, 51, 54。然而,这些模型主要关注单图内的视觉定位。其他一些研究探索了多图理解任务,如多图比较、推理和时间理解 3, 18, 24, 25, 48, 50。尽管如此,多图级别的细粒度视觉定位仍是一个未被充分探索的领域。据我们所知,我们提出的 Migician 是首个旨在解决多图定位挑战的 MLLM。
MLLM 基准测试 大多数现有的 MLLM 评估基准都集中在单图任务上 9, 23。最近的一些基准测试开始评估 MLLMs 在多图理解方面的性能 11, 18, 28, 31, 39,但它们主要强调图像级的理解。与我们工作最相关的基准测试是 MC-Bench 45,这是一项同期研究。MC-Bench 通过要求 MLLMs 根据给定的一对图像中的文本提示准确定位相应对象,来评估其多上下文定位能力。然而,它在输入图像数量固定和查询形式受限方面存在局限性。相比之下,本工作提出的 MIG-Bench 提供了更灵活的任务格式,专注于评估模型在自由形式多图理解方面的能力。
3. 任务定义
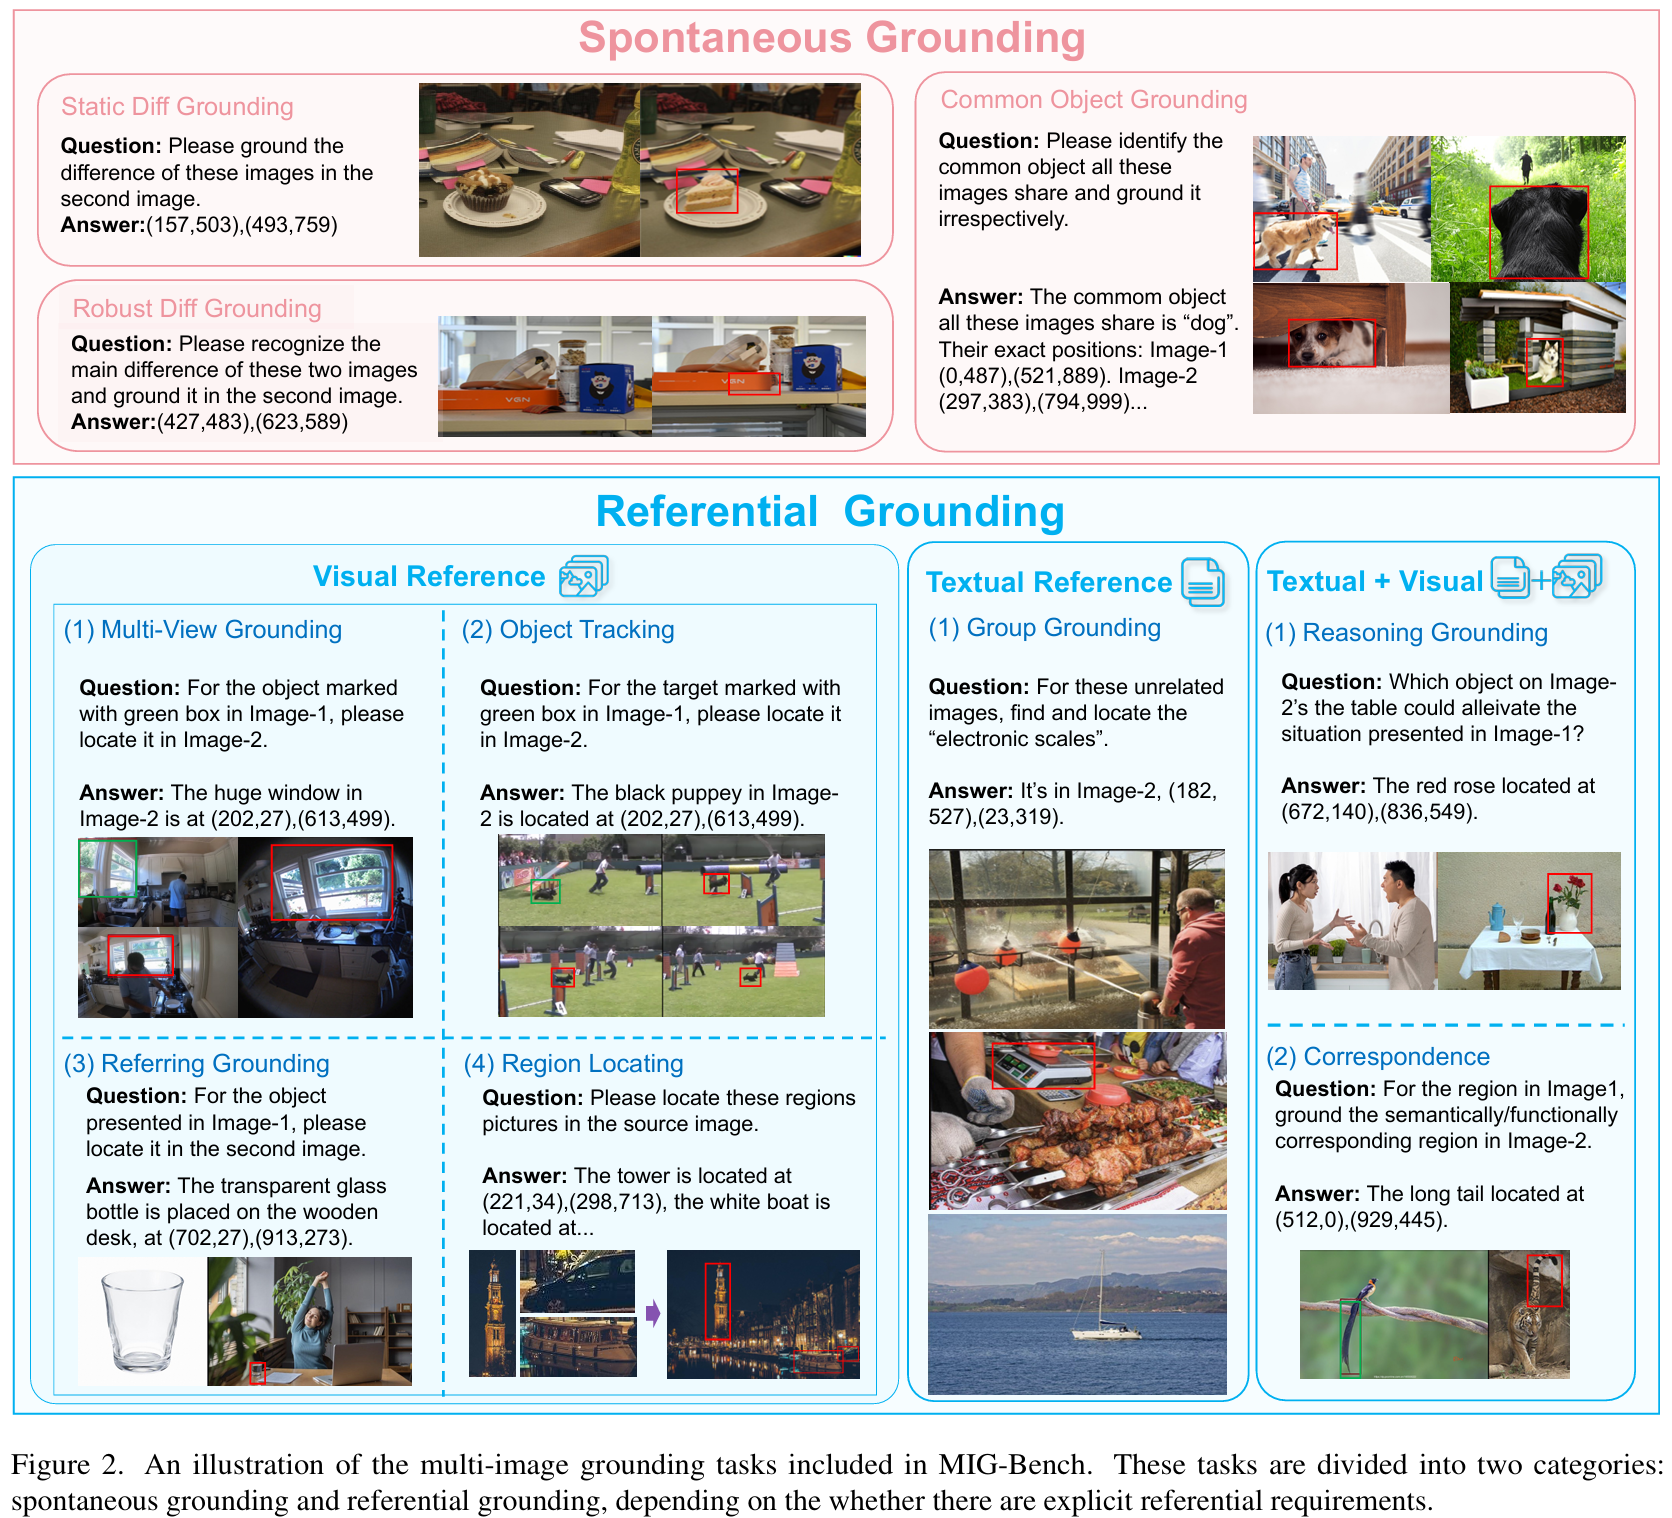
自由形式多图定位的任务是根据自由形式的查询,在一组图像中识别并定位相关的视觉区域。与传统具有固定输入格式的定位任务不同,自由形式多图定位中的查询可以是文本和图像的任意组合,使其具有高度的灵活性和多功能性。形式上,设查询 QQQ 由自然语言描述、参考图像 {R1,R2,...,Rk}\{R_1, R_2, ..., R_k\}{R1,R2,...,Rk} 或两者的混合组合组成(例如,"一张白色汽车的图片 找一辆像这张图但是黑色的车")。给定一组目标图像 {I1,I2,...,In}\{I_1, I_2, ..., I_n\}{I1,I2,...,In},任务是识别一组视觉区域 {G1,G2,...,Gm}\{G_1, G_2, ..., G_m\}{G1,G2,...,Gm},其中 GiG_iGi 是图像 IjI_jIj 中满足 QQQ 定义的语义和上下文约束的目标区域。如图 2 所示,根据任务是否涉及显式引用要求,多图定位任务可进一步分为两类:自发定位(Spontaneous Grounding) 和 指代定位(Referential Grounding)。自发定位是指在没有明确指出的情况下,识别并定位对应图像中的目标对象。与传统的指代表达理解任务 20 明确指代目标对象不同,自发定位通常利用多张图像之间的关系作为上下文线索,自主识别并定位待定位的对象(例如,查找并定位图像间的差异)。另一方面,指代定位需要对目标对象进行显式引用。如前所述,这种引用可以采用图像和文本描述的任意组合形式。
4. 方法
在本节中,我们将深入探讨在 MLLMs 中实现自由形式多图定位能力的方法。我们首先探索一种思维链(CoT)框架,以激发已有 MLLMs 的能力来处理此任务。然后,我们通过指令微调开发端到端的 MIG 模型 Migician,以克服 CoT 框架的局限性并实现增强的 MIG 性能。
4.1. 思维链框架
如图 3(a) 所示,直接提示现有 MLLMs 执行 MIG 任务通常会导致性能显著下降。为了更好地探索现有模型的潜力,我们设计了一种 CoT 框架,将 MIG 任务解耦为两个阶段,如图 3(b) 所示。模型首先理解输入图像和问题,生成描述目标对象的文本指代表达式。接着,模型使用前一步生成的指代表达式在相应图像中定位对象。
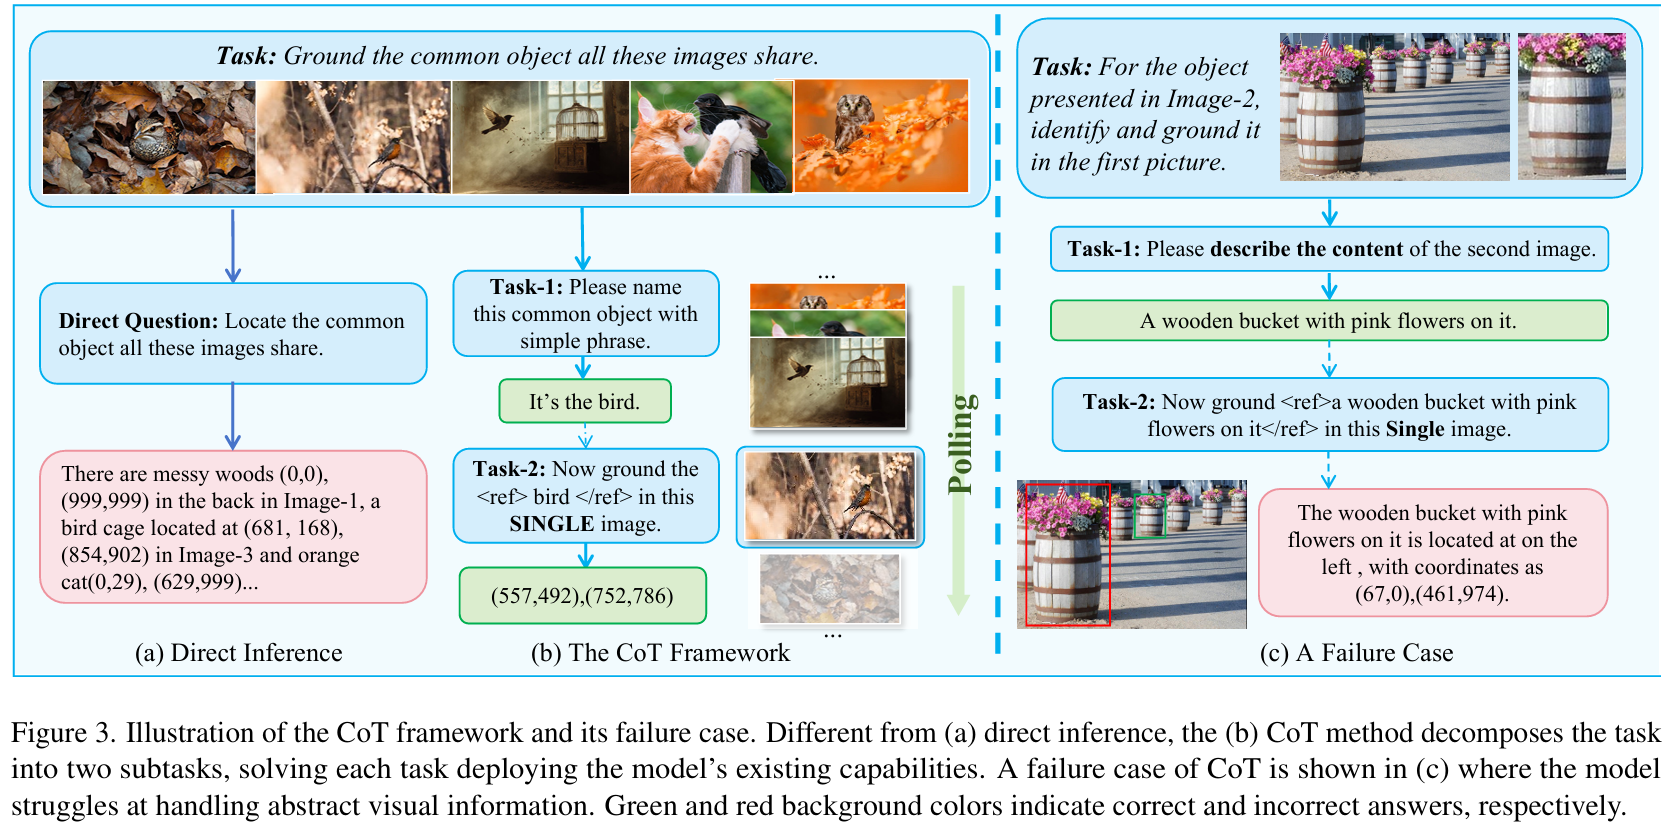
该框架在 MIG 任务上带来了显著的性能提升。然而,CoT 框架存在固有的局限性,例如其多步过程导致的错误传播,这也降低了推理效率 47。此外,如图 5© 所示,许多场景需要通过抽象的视觉语义在多张图像间进行定位,而这无法通过文本表达式有效捕捉。附录 C 中详细介绍了更多失败类型。这凸显了对能够直接执行 MIG 任务的端到端模型的需求。
4.2. 数据构建
CoT 框架表明,同时具备多图理解和单图定位能力的 MLLM 本质上具有处理自由形式 MIG 的巨大潜力。在接下来的部分中,我们采用指令微调来显式地桥接现有 MLLMs 中的这些能力以实现 MIG。为此,我们首先构建了一个名为 MGrounding-630k 的 MIG 指令微调数据集,其统计数据如图 4 所示。该数据集主要通过以下两种方式构建。
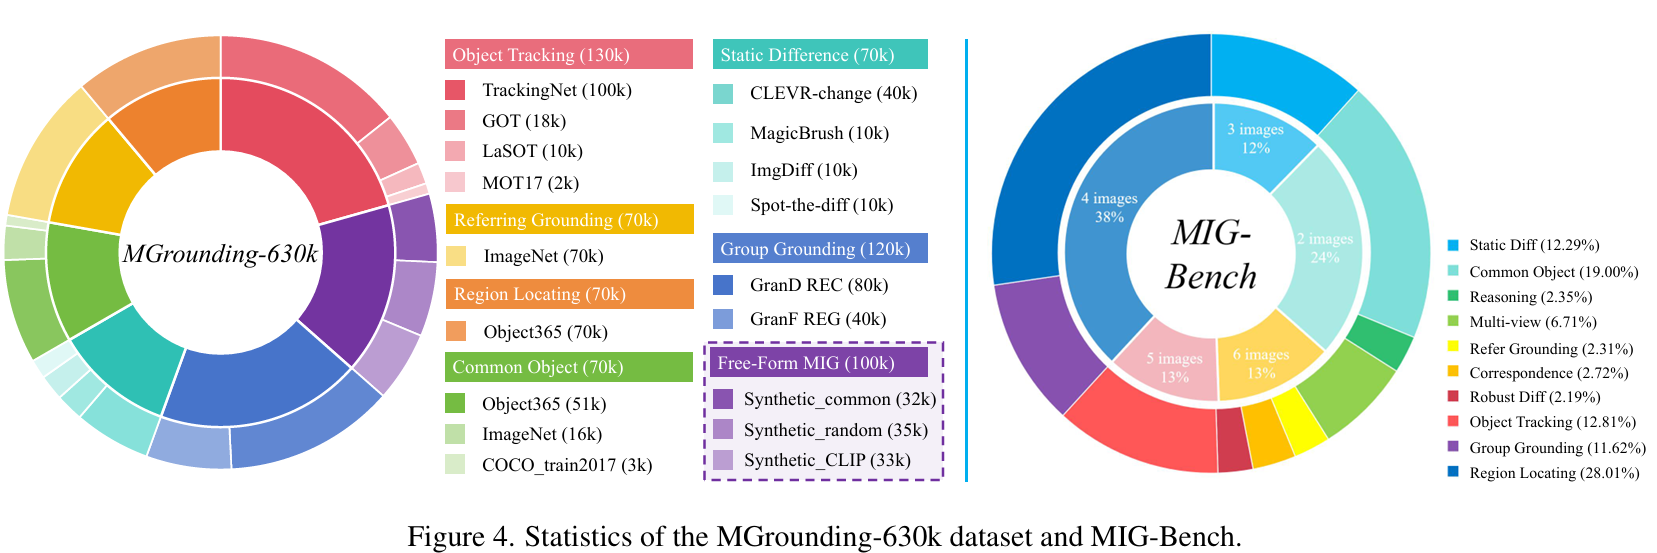
转换现有数据。 通过分析现有数据集的任务和标注类型,我们确定了多种可以通过转换现有数据获得的多图定位(MIG)任务。具体而言,我们从现有来源收集并组织数据,结合或自动合成单图标注,为 6 类 MIG 任务创建数据集。每个任务包含超过 7 万个样本,总共产生 53 万个训练样本。这些任务数据的详细信息见附录 D.1。
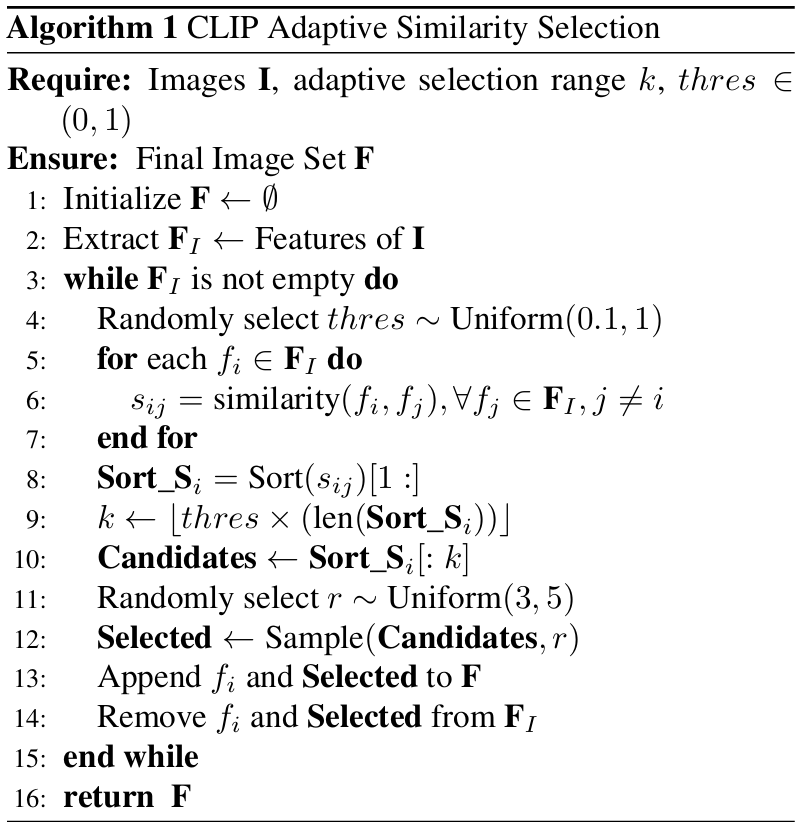
合成自由形式 MIG 数据。 通过上述方法获得的数据仍不能完全满足自由形式 MIG 的要求。为了获取格式更丰富、更多样化的 MIG 数据,以增强模型的指令跟随能力和灵活定位能力,我们设计了一个 MIG 数据合成流程。该流程使用带有对象标注的 Object365 38 图像,选择多张图像作为一组,并生成高质量的多图定位指令。具体而言,我们首先使用 Qwen2-VL-72B 41 生成每张单独图像的描述,然后对标注的边界框进行错误过滤和优化。接下来,我们提示 Qwen2.5-72B 46 通过整合多张图像的信息,自动生成高质量的自由形式 MIG 问答对。为了优化合适图像组的选择,我们采用了不同的图像分组方法,包括随机选择、选择具有共同对象的图像,以及基于 CLIP 相似度对语义相似的图像进行分组。使用这些方法,我们共生成了 10 万条自由形式 MIG 数据。详细信息可在附录 D.2 中找到。
4.3. MIG 指令微调
利用构建的数据集,我们基于 Qwen2-VL-7B 41 进行指令微调以开发 Migician,使其能够实现端到端的自由形式 MIG 能力。
两阶段训练。 为了有效地赋予模型自由形式 MIG 能力,我们提出了一种两阶段训练方法。在第一阶段,模型通过在 MGrounding-630k 的六个代表性 MIG 任务上进行训练,学习执行多图定位,获得同时理解多张图像和执行视觉定位的能力。在第二阶段,模型在 MGrounding-630k 的自由形式 MIG 指令数据上进一步微调,使其能够适应更灵活多样的指令类型,并将第一阶段学到的 MIG 技能迁移到更广泛的场景中。为了防止模型在训练过程中遗忘现有能力,我们在每个训练阶段还加入了单图理解、多图理解和单图定位数据。更多细节请参阅附录 E。
模型合并。 在第二阶段微调后,我们观察到模型性能和灵活性之间存在权衡:虽然模型适应了自由形式 MIG 指令,但在常规多图定位任务上的性能有所下降。为了更好地平衡这两方面,我们采用了模型合并技术 15,将两个训练阶段获得的模型权重取平均值作为最终权重。我们发现这种方法减轻了常规 MIG 任务中的性能损失,同时保留了有效遵循自由形式 MIG 指令的能力。
5. MIG-Bench
我们推出了 MIG-Bench,这是一个人工策划的基准测试,旨在评估当前 MLLMs 的 MIG 能力。它包含 5900 张图像和 4300 个测试实例,涵盖图 2 所示的 10 种不同任务,详情见附录 A。这些任务的分布如图 4 所示。
MIG-Bench 是从多个数据源手动构建的。最初,我们从现有数据集中选择带标注的数据样本,并将其调整为 MIG 任务。我们从 Objects365 38 中收集具有挑战性的样本用于共同对象定位和区域定位。对于对象跟踪,我们使用 GOT-10k 14 中表现出显著运动的样本。对于多视角定位,我们利用了 Ego4D 12 中丰富的标注。静态差异任务的数据来源于 MagicBrush 53。我们将 GranD 36 中的多个样本组合成一组用于群组定位。此外,对于推理定位、对应关系、指代定位和鲁棒差异定位等缺乏合适现有数据集的任务,我们收集了网络图像和手动拍摄的照片,并由受过良好培训且充分理解这些任务的标注人员进行标注。
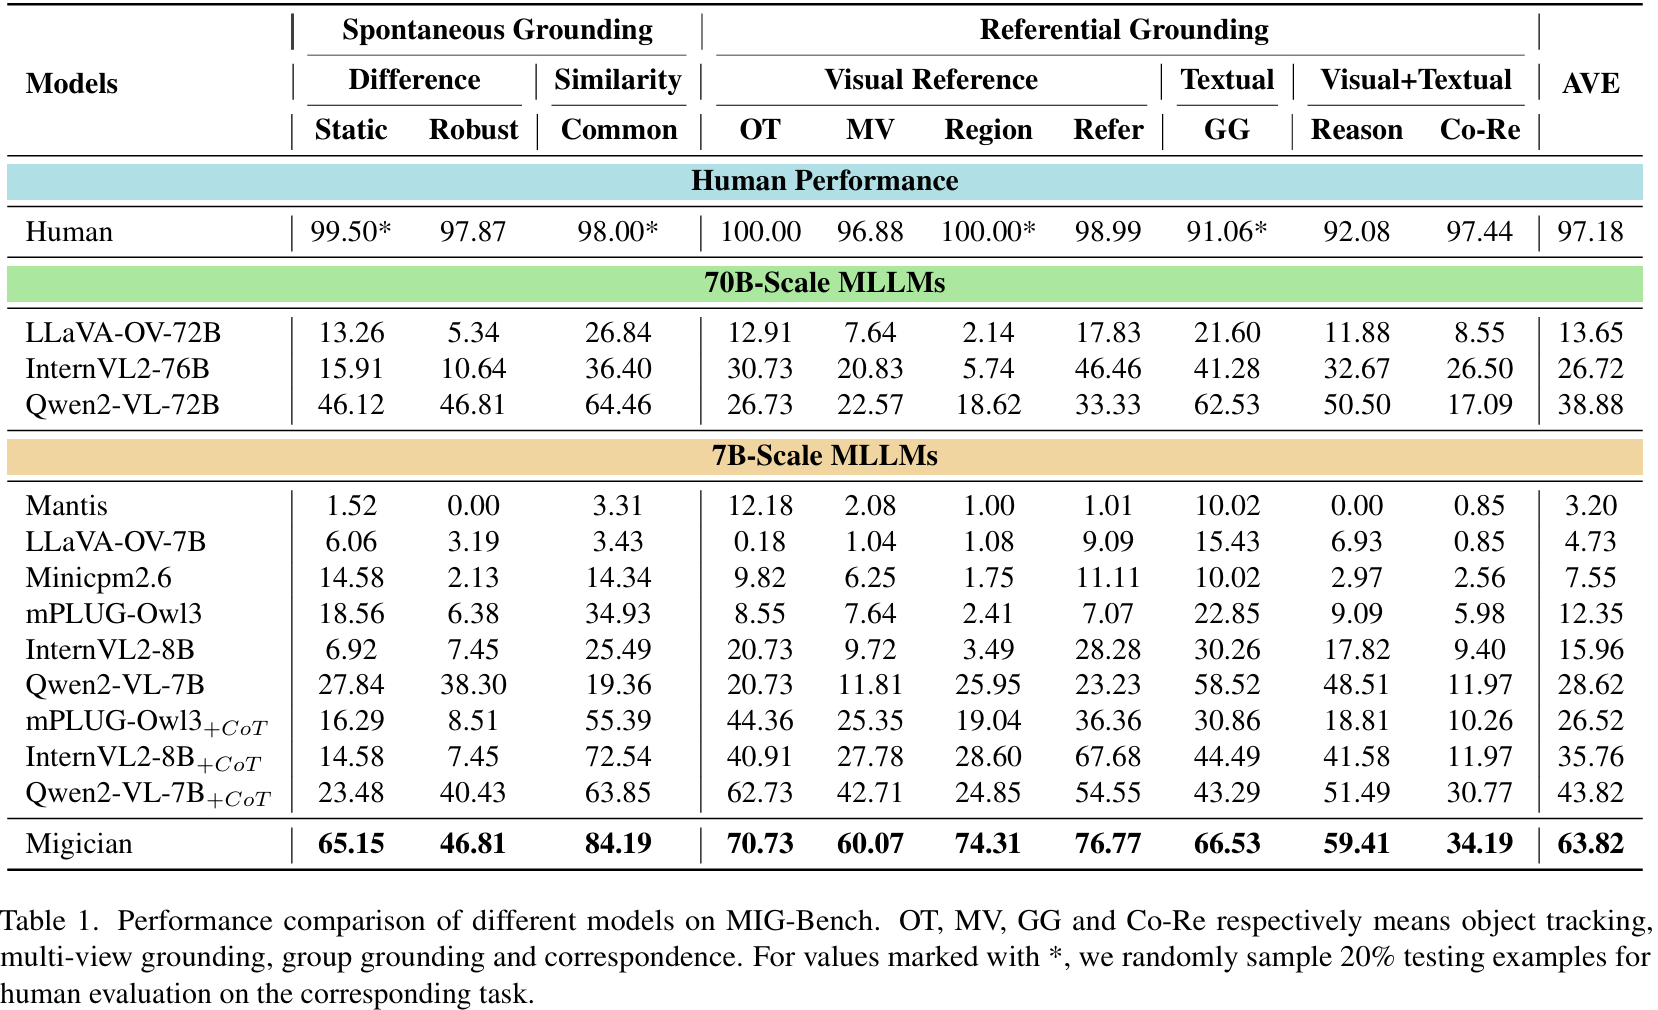
所有实例均由两名不同的人工标注员审核,以保证 MIG-Bench 的质量。这包括移除标注错误的实例,确保问题可回答,过滤过于简单的问题,以及修正模糊的查询。我们还邀请了五名志愿者回答问题,以评估人类在该基准测试上的表现(详见附录 F)。如表 1 所示,人类回答的平均准确率为 97.18%,表明该任务对人类来说较为容易,进一步证明了 MIG-Bench 的高质量。
与现有基准测试不同,MIG-Bench 在多图设置中引入了定位任务,从而填补了先前基准测试无法衡量 MLLMs 自由形式 MIG 能力的空白。与其他基准测试的详细比较见附录 B。
6. 实验
6.1. 实施细节
Migician 基于 Qwen2-VL-7B 41 基础模型开发,全局批量大小为 48,两阶段训练过程共计 25,000 步,学习率为 5×10−65 \times 10^{-6}5×10⁻⁶,使用 8 张 A100-80G GPU。在我们提出的 MIG-Bench 评估中,我们使用指代表达理解中的常规定量指标 Acc@0.5 20。该指标衡量对象定位的准确性,如果预测结果与真实值的交并比(IoU)大于 0.5,则定义为正确预测。
6.2. MIG-Bench 上的结果
如表 1 所示,Migician 在 MIG-bench 的所有任务中均达到了最先进的性能,与排名第二的模型 Qwen2-VL-72B(38.88%)相比,平均提升了 24.94%,尽管其参数量明显更少。值得注意的是,在所有任务中,人类表现与所有 MLLMs 的表现之间都存在巨大差距,表明 MLLMs 在自由形式 MIG 方面仍有巨大的提升潜力。特别是对于 7B 规模的模型,即使是先进的多图模型如 InternVL2-8B 和 Qwen2-VL-7B 也难以胜任,尤其是在多视角定位、区域定位和对应关系等任务中。
对于具备定位能力的模型,如 mPLUG-Owl3、InternVL2 系列和 Qwen2-VL 系列,它们表现出优于其他基线的优势。此外,所提出的单图 CoT 方法(+CoT)有效地整合了 MLLMs 的定位和多图理解能力,不同的能力在不同的推理步骤中相互辅助,在多图定位任务上实现了全面的提升。而且,该方法对上述所有模型均被证明是有效的。
6.3. 多图理解基准测试上的结果
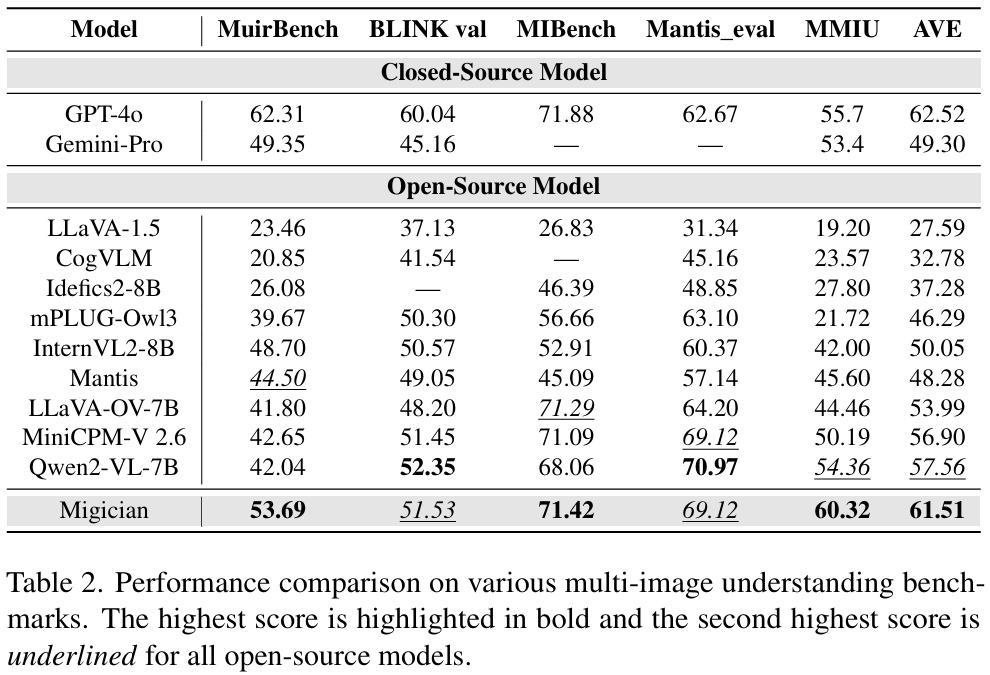
如表 2 所示,Migician 不仅确立了其多图定位能力,还显著激发了其通用的多图理解能力。特别是,Migician 在 MuirBench 上以 9.19% 的优势超越了第二好的模型(Mantis),并在 MMIU 和 MIBench 上达到了 SOTA 性能。我们将此归因于在多图理解和定位混合数据上的训练,这表明我们提出的 MGrounding-630k 数据集能有效增强通用的多图理解能力。
6.4. 单图基准测试上的结果
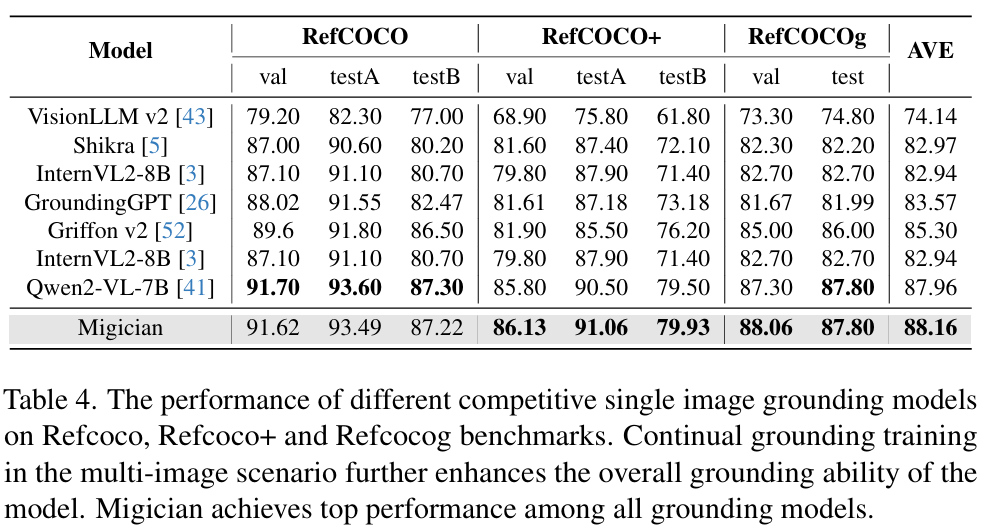
表 3 列出了典型单图理解基准测试(包括 MME 10 和 MMBench 29)的实验结果,表明 Migician 保留了强大的单图理解能力。具体而言,在 MME 基准测试上,Migician 超越了 InternVL2-8B 和 MiniCPM 等知名 MLLMs,同时在 MMBench 上与闭源模型表现出同样强劲的性能。值得注意的是,与 LLaVA-OV 和 Mantis 等专用多图模型(其单图能力已大幅退化)相比,Migician 具有显著优势,实现了全面的能力保持。如表 4 所示,我们的模型在单图 REC 任务上也保持了强劲性能。
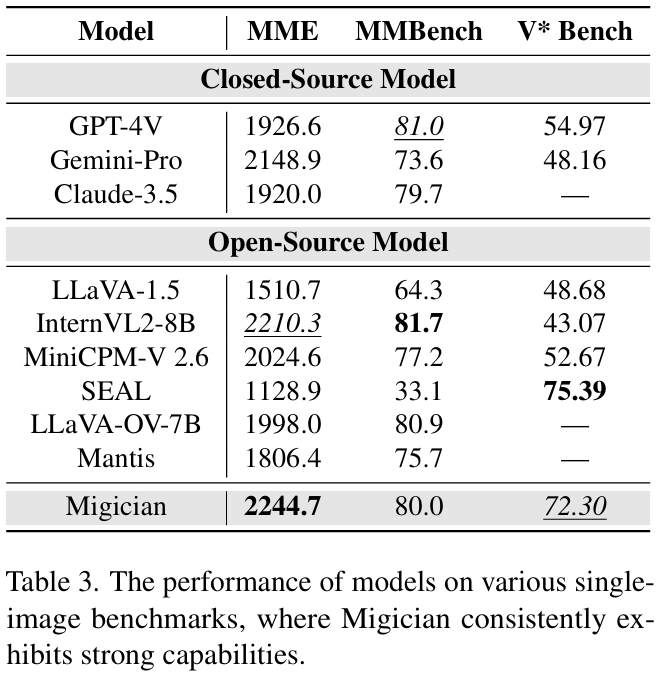
此外,我们发现 Migician 的 MIG 能力可用于解决高分辨率图像中的视觉细节查找任务,例如 VBench 44。具体而言,我们将 VBench 中的单张高分辨率图像分割成多个子图像,并将问题转化为 MIG 任务(详见附录 F)。结果显示,Migician 能很好地泛化到这种分布外设置,其表现与专用视觉搜索系统 SEAL 44 相当。
7. 分析
7.1. 不同 CoT 策略的效果
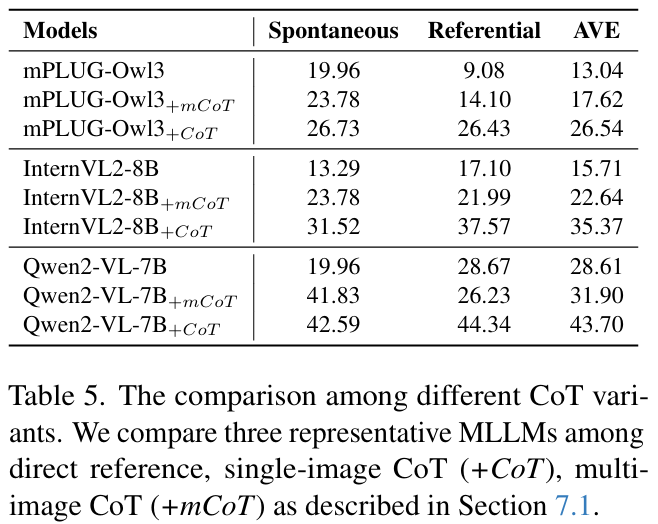
第 4.1 节中的 CoT 框架在获得指代表达式后,让 MLLM 以轮询方式在每张图像中执行定位(称为单图 CoT),这会产生显著的推理开销。在此,我们探索多图 CoT,即 MLLM 基于获得的指代表达式直接在所有图像间执行定位。如表 5 所示,多图 CoT 取得了一定效果,但仍显著落后于单图 CoT。相比之下,我们提出的 Migician 能够在多图设置下执行端到端推理,在效率和效果上均具有显著优势。
7.2. 不同数据对多图理解的影响
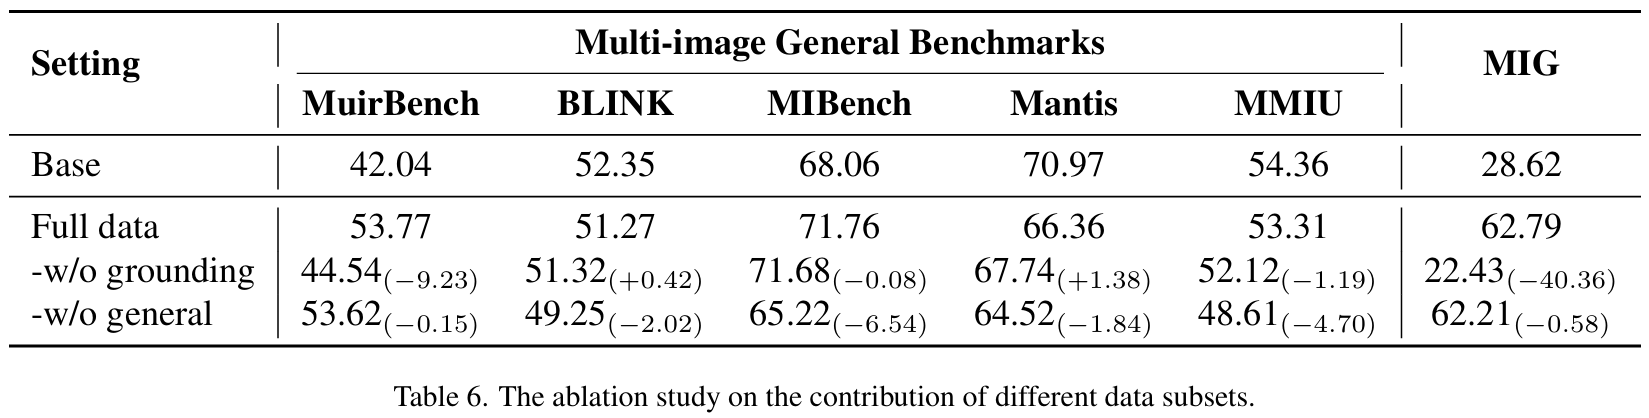
如表 2 所见,Migician 在多图理解方面有所提升。我们进一步进行消融研究,分析不同数据子集的影响。具体而言,我们训练了两个模型,分别从原始训练集中移除 MGrounding-630k 或多图理解数据。表 6 的结果显示,定位数据通常有助于多图理解。在 5 个基准测试中的 4 个里,完整数据集达到了最高性能,优于移除任何数据子集的模型。相比之下,仅使用通用数据进行微调并不能持续带来性能提升。然而,当与细粒度定位数据结合时,模型经历了显著提升。
7.3. 不同难度级别下的性能
为了全面评估 Migician 在 MIG-Bench 中不同场景复杂度下的表现,我们通过综合考虑三个关键因素建立了三级难度分类(简单/中等/困难):(1) 输入图像的数量;(2) 四个代表性基线模型(Qwen2-VL、InternVL2 及其 CoT 变体)的准确率;(3) 应用 CoT 时的平均 IoU 提升。具体而言,如果 (a) 超过两个模型在少于四张输入图像的情况下获得正确答案,或 (b) CoT 增强模型的 IoU 提升超过 0.15,则该实例被归类为简单。相反,如果在处理超过四张输入图像的情况下不超过一个模型成功,则实例被视为困难。介于这些阈值之间的所有其他情况被归类为中等难度。
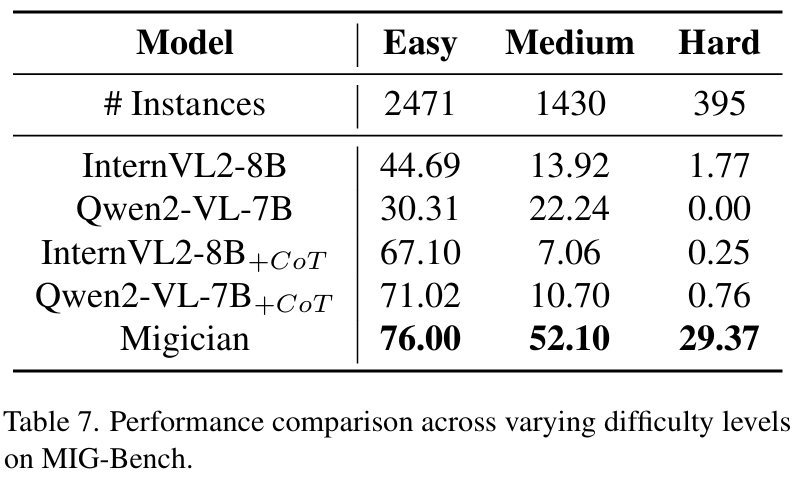
通过这种方式,我们可以评估模型在不同场景复杂度下的能力。如表 7 所示,Migician 在所有难度级别上均表现出显著的性能优势,尤其在具有挑战性的场景中表现出特别强的能力。值得注意的是,在中等和困难设置中,性能差距显著扩大,Migician 的准确率比基线模型高出约 30%。这种在复杂场景中的显著优势突显了 Migician 在自由形式 MIG 方面的卓越能力。
8. 结论
在本工作中,我们探索了多图定位任务,并提出了 Migician,这是首个克服细粒度视觉定位与多图输入之间障碍的 MLLM。借助我们提出的大规模 MGrounding-630k 数据集,Migician 无缝整合了跨多图的定位能力,实现了自由形式多图定位。为进一步推动该领域的研究,我们引入了 MIG-Bench,一个用于评估 MLLMs 多图定位能力的综合基准测试。实验结果表明,我们的模型显著优于现有方法。我们希望这项工作能激发多图定位的进一步发展,并为未来创建更多功能的多模态模型做出贡献。
局限性
尽管我们对 MIG 挑战进行了全面讨论,但仍存在一些局限性。首先,由于计算资源的限制,我们尚未在更大的 70B 规模模型上验证我们训练方法的有效性。其次,当前的模型有时仍会像传统 MLLMs 一样产生幻觉输出。最后,我们的训练方法和基准测试构建主要集中在 REC 任务上。虽然 Migician 具备不错的 REG(指代表达生成)能力,但这一话题的讨论仍不够充分。
致谢
本工作由中国中央高校基本科研业务费专项资金(项目编号 2024JBGP008)和国家自然科学基金(项目编号 62406018)资助。
我们要向致力于人类水平性能评估的志愿者们------Mai Sun, Pujian Zhan, Xingyu Zhang, Binhao Liu 和 Huiting Pei 表示衷心的感谢,对他们的辛勤付出致以最诚挚的谢意。
附录
A. 基准测试任务定义 (Benchmark Tasks Definition)
A.1. 自发定位 (Spontaneous Grounding)
我们的基准测试通过以下三个不同的任务来评估自发定位能力,旨在评估模型自主发现不同图像之间隐蔽联系并准确定位目标的能力。
- 找不同 (Spot the Difference):类似于"找不同"游戏,给定两张只有一处差异的相似图像,模型被指令识别并在第二张图像中定位这一差异,这要求模型同时对两张图像进行敏锐的感知。
- 共同物体定位 (Common Object Grounding):指自动识别并定位在一组图像中所有图像都出现的共同物体。在我们的基准测试中,这些图像组共享一个明确的共同物体。
- 鲁棒图像差异定位 (Robust Image Difference Grounding):模型必须关注从略微不同角度拍摄的两张图像之间的主要差异,忽略由视角偏移引起的其他微小变化。视角变化的引入给模型带来了更大的挑战,更好地反映了现实世界中视角变化不可避免的场景。
A.2. 指代性定位 (Referential Grounding)
文本指代查询 (Textual Reference Query)
这一挑战主要包括组定位 (Group Grounding),测试模型在图像组中将文本指代链接到其对应图像中的目标物体的能力。给定一组图像和一个文本查询,模型必须首先识别正确的图像,然后在该图像中准确定位目标物体。与传统的定位任务相比,这 additionally 包含了图像级别的定位。
视觉指代查询 (Visual Reference Query)
这些任务侧重于有效利用视觉参考信息并将其融入定位过程。
- 视觉指代表达定位 (Visual Referring Grounding):在此任务中,提供一对图像------一张包含清晰物体的源图像和一张包含多个元素的目标图像。模型必须感知源图像中的指代物体,然后在目标图像中定位它。
- 区域定位 (Region Locating):模型的任务是在源图像中识别多个区域图像,这通常需要敏锐和细致的观察,因为模型可能会遇到人物识别、相似物体区分、微小物品搜索等情况。
- 物体追踪 (Object Tracking):此任务涉及在视频帧序列中追踪目标物体。物体在第一张图像中用红色边界框高亮显示,模型必须在整个序列中持续追踪它。
- 多视角定位 (Multi-view Grounding):在此,模型必须在从不同视角(例如第一人称视角和第三人称视角)拍摄的多张图像中定位同一个目标。
视觉+文本指代查询 (Visual+Textual Reference Query)
这些任务结合来自两种模态的信息,以评估跨模态推理和定位能力。
- 对应关系 (Correspondence):模型必须在目标图像中定位语义或功能上相似的区域。这项更细粒度的任务关注的是物体区域而不是整个物体,要求对视觉语义有深入的理解。
- 推理定位 (Reasoning):此任务要求模型通过整合跨模态信息执行基于推理的定位。图2中展示了几个示例。
我们的 MIG-Bench 提供了丰富、多方面的评估,涵盖了各种现实世界的场景和领域,超越了简单的图像对,包括了更长、更复杂的图像上下文。通过确保每个任务都定义明确且无歧义,我们促进了客观和确定的评估。
B. MIG-Bench 与其他基准测试的比较
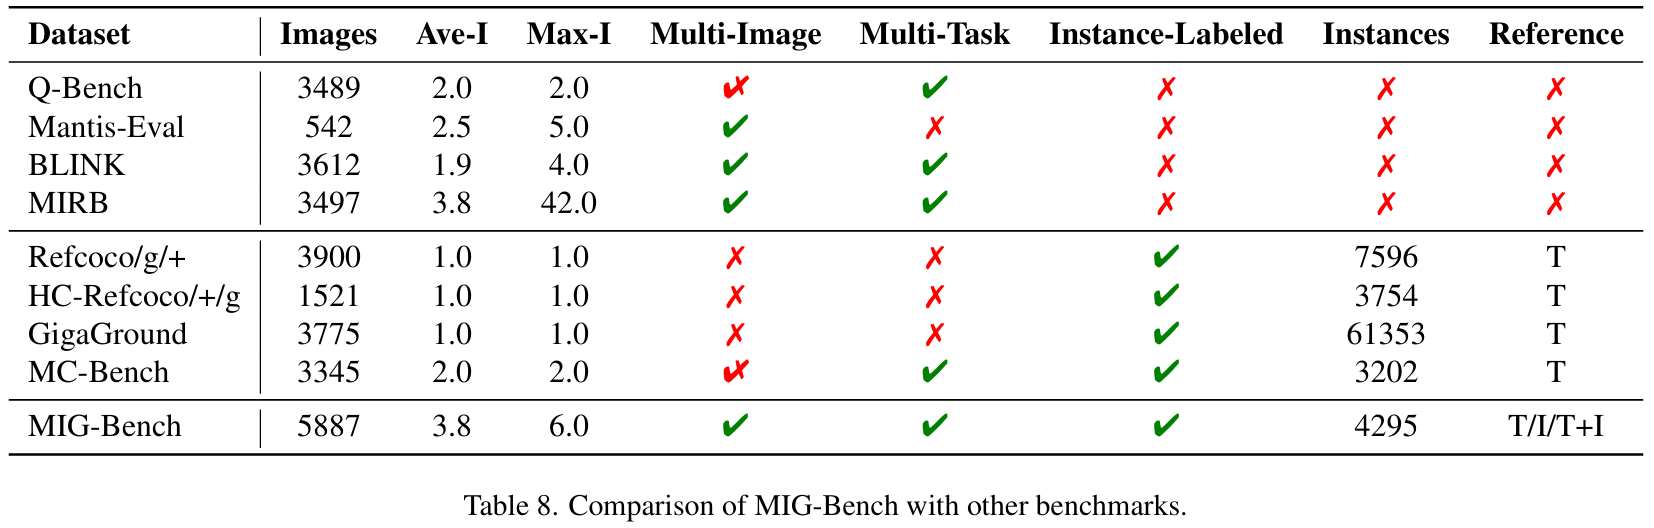
表8提供了与其他基准测试的详细比较。当前对 MLLMs 的评估主要集中在单图像感知、理解、推理或定位(例如 MME, MMBench, Refcoco),而多图像场景在很大程度上未被探索。虽然 Mantis-eval, BLINK 和 MIRB 等基准测试代表了多图像评估,但它们集中于图像级别和多图像的通用理解,未能全面评估模型在多图像场景中的细粒度定位技能。
与传统的定位基准测试或多图像基准测试不同,MIG-Bench 将定位任务引入多图像场景,涵盖了10个不同的任务系列。与我们工作最相关的基准测试是 MC-Bench,这是一项同期研究。MC-Bench 通过要求 MLLMs 根据文本提示在给定的图像对中正确图像里准确定位相应物体,来评估 MLLMs 的多上下文视觉定位能力。然而,它在输入图像数量固定和查询形式受限方面存在局限性。相比之下,本文提出的 MIG-Bench 提供了更灵活的任务格式,专注于评估模型在自由形式多图像理解方面的能力。
C. 单图像思维链 (CoT) 的失败模式
我们在图5中分析了 CoT 框架的更多失败模式,将其分为感知缺陷和推理缺陷两类。
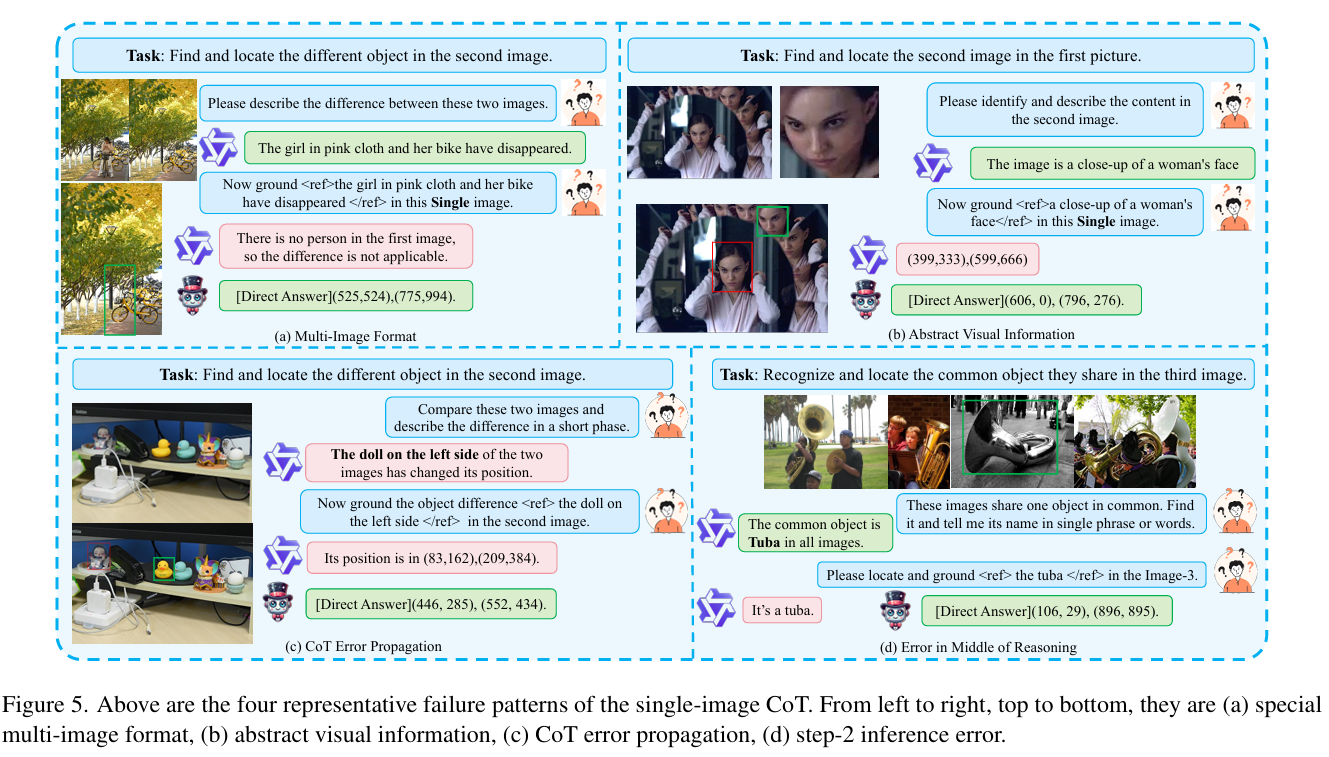
对于前者,当多张图像以只有整合所有视觉信息才能解决 MIG 的方式组织时(即在第二张图像中寻找失踪人员的位置),或者当文本内容不足以充分代表视觉信息时,该框架就会显得力不从心。
关于推理错误,不准确可能出现在推理过程的各个阶段,从而削弱框架的整体准确性和有效性。
这些失败模式突显了仅仅通过简单的 CoT 框架整合当前模型不同能力的显著局限性,强调了需要一种能够直接执行 MIG 任务的端到端模型。
图5说明: 以上是单图像 CoT 的四种代表性失败模式。从左到右,从上到下分别是:(a) 特殊的多图像格式,(b) 抽象视觉信息,© CoT 错误传播,(d) 推理中间步骤的错误。
D. MGrounding-630k 数据整理细节
D.1. 转换现有数据
静态差异 (Static Diff)
描述两张几乎相同图片之间的差异是一个被广泛讨论的话题,但以前的尝试通过文本短语捕捉差异,未能精确定位它们的位置。在对这一领域进行全面调查后,我们从各种现有数据集中收集了高质量且完全标注的图像差异数据:Spot-the-diff 17, Img-diff 19, MagicBrush 53 和 CLEVR-change 34。
由于这些收集的数据集本身包含很多噪声,例如不准确的差异标题、错误的边界框坐标等。我们过滤了 Spot-the-Diff 中不准确的 bbox 标签,仅保留正确的标签及其差异标题。此外,由于 Img-Diff 基于扩散生成 37 的性质及其 consequent 不准确性,我们对其进行了下采样。
在构建过程中,我们通过以下方式确保内容的多样性:(1) 纳入由 GPT-4 生成的多种提示格式,提高模型的指令遵循能力;(2) 构建 CoT 过程,通过充分利用数据集中可用的标注,协助模型逐步达到最终答案。
共同物体定位 (Common Object Grounding)
定位多张图像中的主要共同物体对模型来说是一项具有挑战性的任务。它要求模型同时感知多张图像,隔离出共同物体,然后准确地在每张图像中定位目标。
在我们的方法中,我们利用丰富的数据来源,包括 ImageNet 6, COCO 27 和 Object365,这些数据源拥有丰富的标注。为了组织图像,我们根据物体标签将包含相同物体的图像分组,应用阈值过滤掉在图像中占比过小的物体。这个经验确定的阈值有效地减轻了当多个候选物体可被视为共同物体时的歧义,从而产生清晰明确的训练样本。我们通过移除经常与其他物体共现的类别(例如键盘、刀、沙发、餐桌等)进一步减少歧义。
物体追踪 (Object Tracking)
多图像设置非常适合物体追踪任务,该任务涉及时间和空间定位。为了构建我们的数据集,我们精心选择了大规模、标注良好的数据集,包括 TrackingNet 33, LaSOT 8, GOT-10K 14 和 MOT-2017 32。在数据集构建过程中,我们以特定间隔从每个原始序列中提取4-6张图像,在保持效率的同时保留关键特征。此外,我们引入了少量来自连续视频帧的时间顺序判断数据,以加强模型的时间推理能力。
指代性定位 (Referring Grounding)
此训练数据模拟了在目标图像中定位源图像中物体的过程。我们主要使用 ImageNet-2012 数据集创建图像对,其中源物体在第一张图像中完全可见,而目标物体隐藏在第二张图像中。根据经验,这种设计生成了具有挑战性的训练样本,要求模型首先识别源物体,然后在目标图像中搜索它。
组定位 (Group Grounding)
传统的视觉定位通常局限于单图像上下文。然而,在现实世界场景中,通常需要在杂乱的图像集合中识别目标物体。组定位通过启用在一组图像中识别目标来解决这一限制,从而增强了传统定位方法的多功能性。
对于组定位训练数据的构建,我们利用了大规模的 GranD rec 和 reg 对话数据集 36,其中包含300万个示例。在过滤掉噪声数据并将每组3-5张图像分组后,我们策划了12万个高质量实例用于第一阶段训练。该数据集有效地增强了模型执行图像共指 18、图像级定位和实例级定位的能力。
区域定位 (Region Locating)
区域定位涉及将图像切片为几个语义丰富的区域,并识别这些区域在源图像中的精确位置。为了提取有意义的区域,我们使用 Objects365 数据集,选择标注的边界框区域作为感兴趣区域。为了进一步提高区域质量,我们应用了一系列过滤标准:(1) 内容丰富度 :我们选择具有超过10个边界框标注的图像,以避免过于简单或平淡的情况。(2) 纵横比 :我们保留纵横比在0.5到2之间的区域,以排除模型难以处理的过窄边界框。(3) 尺寸:我们确保区域与图像的比例在0.2到0.49之间,绝对像素数高于2,000,以排除缺乏足够细节的微小和模糊区域。值得注意的是,由于我们精心设计的过滤机制和任务的固有特性, resulting 训练数据主要包括人物识别、区分相似物体(即椅子、碗、汽车等)以及识别微小细节的情况------这些任务即使对人类来说也不平凡。
D.2. 合成自由形式 MIG 数据
CLIP 自适应相似性图像输入算法如算法1所示。我们在接下来的页面中进一步展示了用于图像标题生成、边界框标签优化和指令微调数据生成的提示模板,以及图8中的几个第二阶段数据示例。
具体而言,我们部署 Qwen2-VL-7B 进行详细图像标题生成,部署 Qwen2-VL-72B 进行 bbox 标签优化。推理过程通过 vLLM 框架 22 加速。
E. 两阶段训练细节
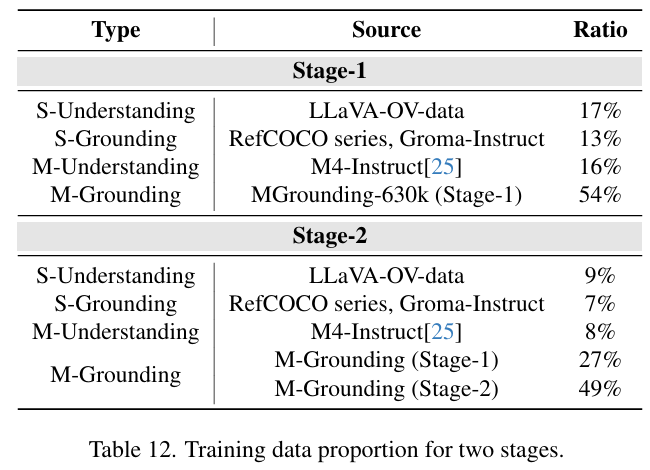
本节概述了两个训练阶段的数据比例及其各自来源,总结于表12。
在第一阶段,我们利用涵盖通用理解和定位任务的单图像和多图像数据集,以全面增强模型的能力。在此阶段,来自 MGrounding-630k 的第一阶段子集构成了训练数据的最大部分,共有53万个示例。第一阶段的总训练示例为100万。
在第二阶段,重点转向通过整合 MGrounding-630k 中的所有自由形式定位数据来激发模型的自由形式 MIG 能力。同时也重用了大量第一阶段数据以维持先前学到的能力。此阶段的总训练示例数量为20万。
F. 评估实施细节
基于轮询的评估 (Polling-based Evaluation)
当直接要求模型为每张图像生成边界框坐标时,由于其有限的多图像定位能力和不足的指令遵循能力,以这种方式获得的答案很大程度上是不可信的,且在指令遵循方面大多令人不满意,无法客观反映模型真实的定位能力。根据经验,指示模型直接生成所有边界框坐标会导致非常严重的指令遵循问题。模型难以产生合理的输出,其答案大多仅包含一个边界框或纯文本分析。
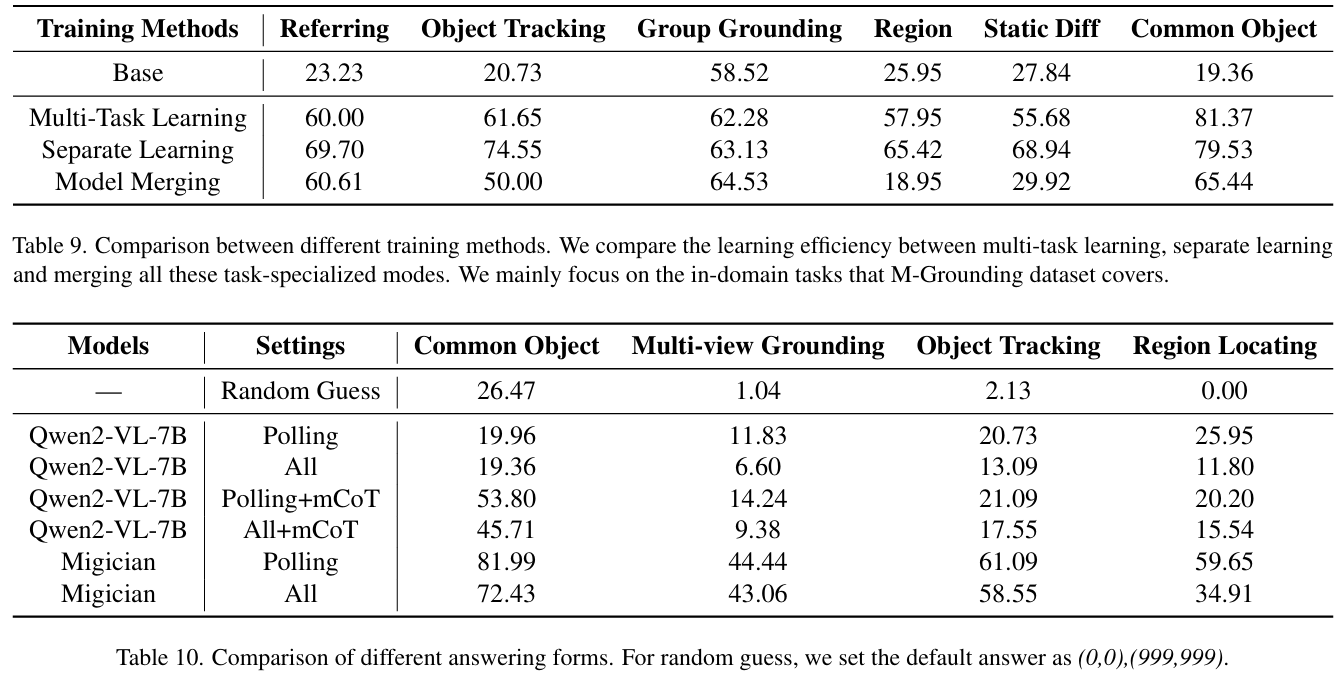
考虑到当前模型的表现薄弱,我们从直接生成所有答案转变为对每张单独图像进行轮询,这有助于进行明确和客观的评估。根据经验,直接为所有图像生成所有边界框坐标会导致性能较低。然而,如表10所示,Migician 仍然表现出对评估格式变化的强大鲁棒性。
V*Bench 评估实施
我们将高分辨率单图像定位任务转化为 MIG 挑战。具体而言,我们将单个高分辨率图像切片为多个子图像,并直接将问题转换为组定位任务,这首先要求模型执行图像级定位,然后在该特定图像中定位目标。通过利用 Migician 的 MIG 能力,我们可以定位与输入问题相关的区域。随后,模型将识别出的区域与原始图像结合,生成输入问题的答案,从而实现高精度结果。
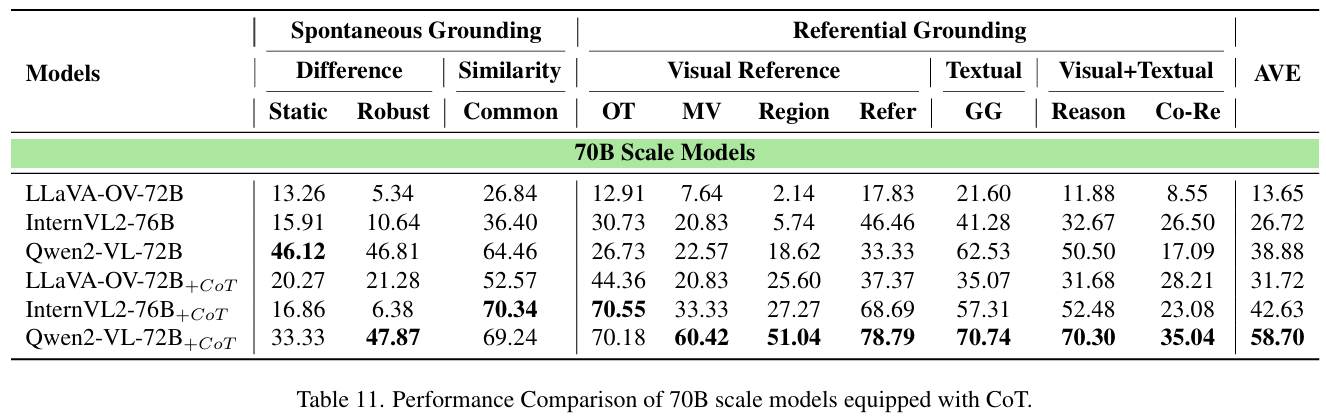
70B 规模模型
表11展示了三个竞争性70B规模模型在配备单图像 CoT 时的表现。CoT 框架的总体有效性巨大,平均性能提升约20个百分点。然而,即使是像 Qwen2-VL-72B (58.70%) 这样具有竞争力且大得多的模型,在多图像定位方面仍然无法超越我们的 Migician (60.49%),这展示了巨大的竞争力。
单图像定位
如表4所示,Migician 不仅获得了自由形式的多图像定位能力,而且在 RefCOCO 系列单图像定位基准测试中表现出持续且一致的性能改进,大幅超越了 Griffon v2 和 GroundingGPT 等专业定位模型。此外,Migician 在平均得分方面也优于 Qwen2-VL-7B。
人类水平评估
我们邀请了五名人类志愿者回答 MIG-Bench 的问题。对于静态图像差异、共同物体定位、区域定位和组定位任务,我们随机选择了20%的测试示例以进行高效评估。
志愿者被指示通过在图像上直接绘制边界框来回答 MIG 问题,然后将 resulting 标注与地面真值使用自动 IoU 计算进行比较。为了确保结果无偏,不同志愿者的评估分别进行,防止相互干扰或信息泄露。
G. 多任务学习
我们的整个训练过程涉及多个不同任务的学习过程与实际学习效率相比如何改变?它们能否相互贡献或在某种程度上构成冲突?
我们进行了仅让模型接触全任务数据集的实验,结果如表9所示 it clearly reveals the conflicts of learning various tasks, with mixes multi-task training consistently surpassing omni-task learning by a huge margin. When we directly merge the checkpoints of all these trained specialized models 15, the merged model fail at excelling at most tasks, with the average performance falling behind simple multi-task learning.
H. 案例研究
我们在图6和图7中提供了全面反映 Migician 自由形式 MIG 能力的详细案例,以及在图8中提供了我们的指令微调数据细节示例。
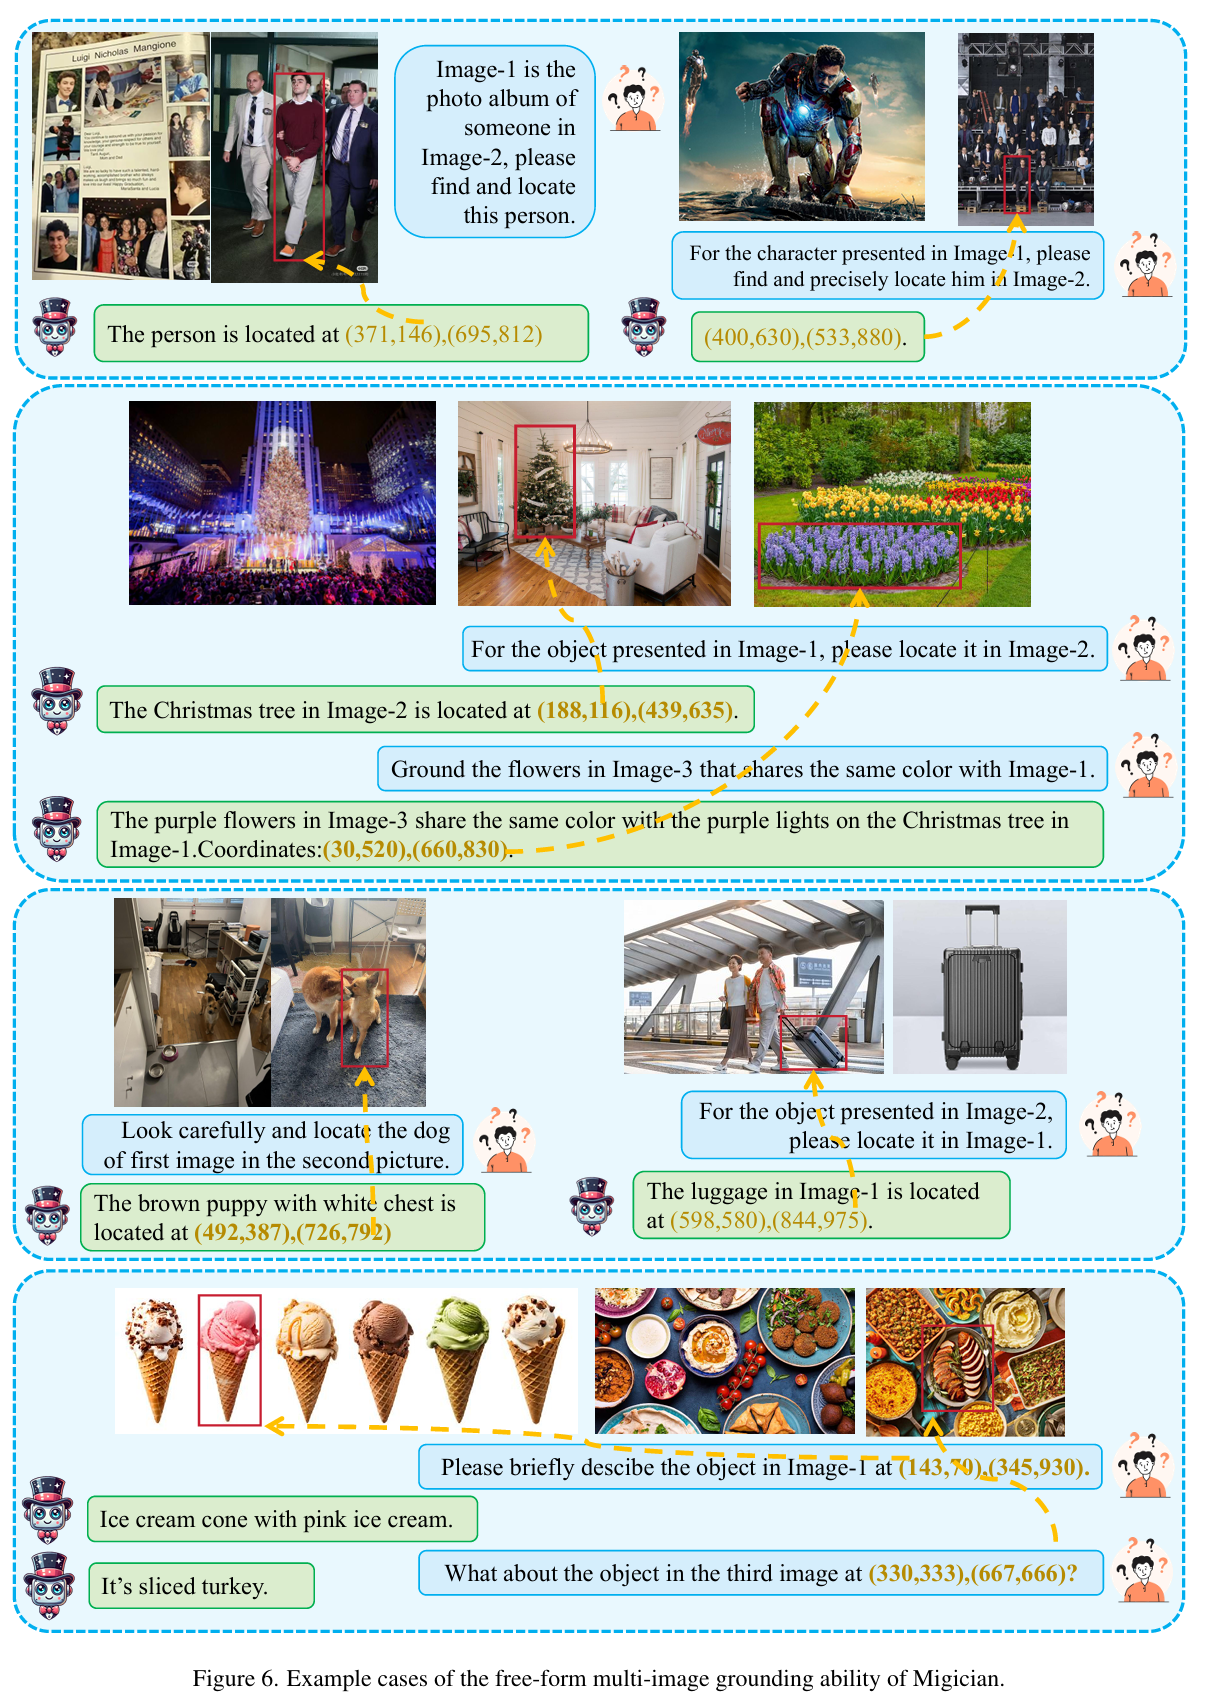
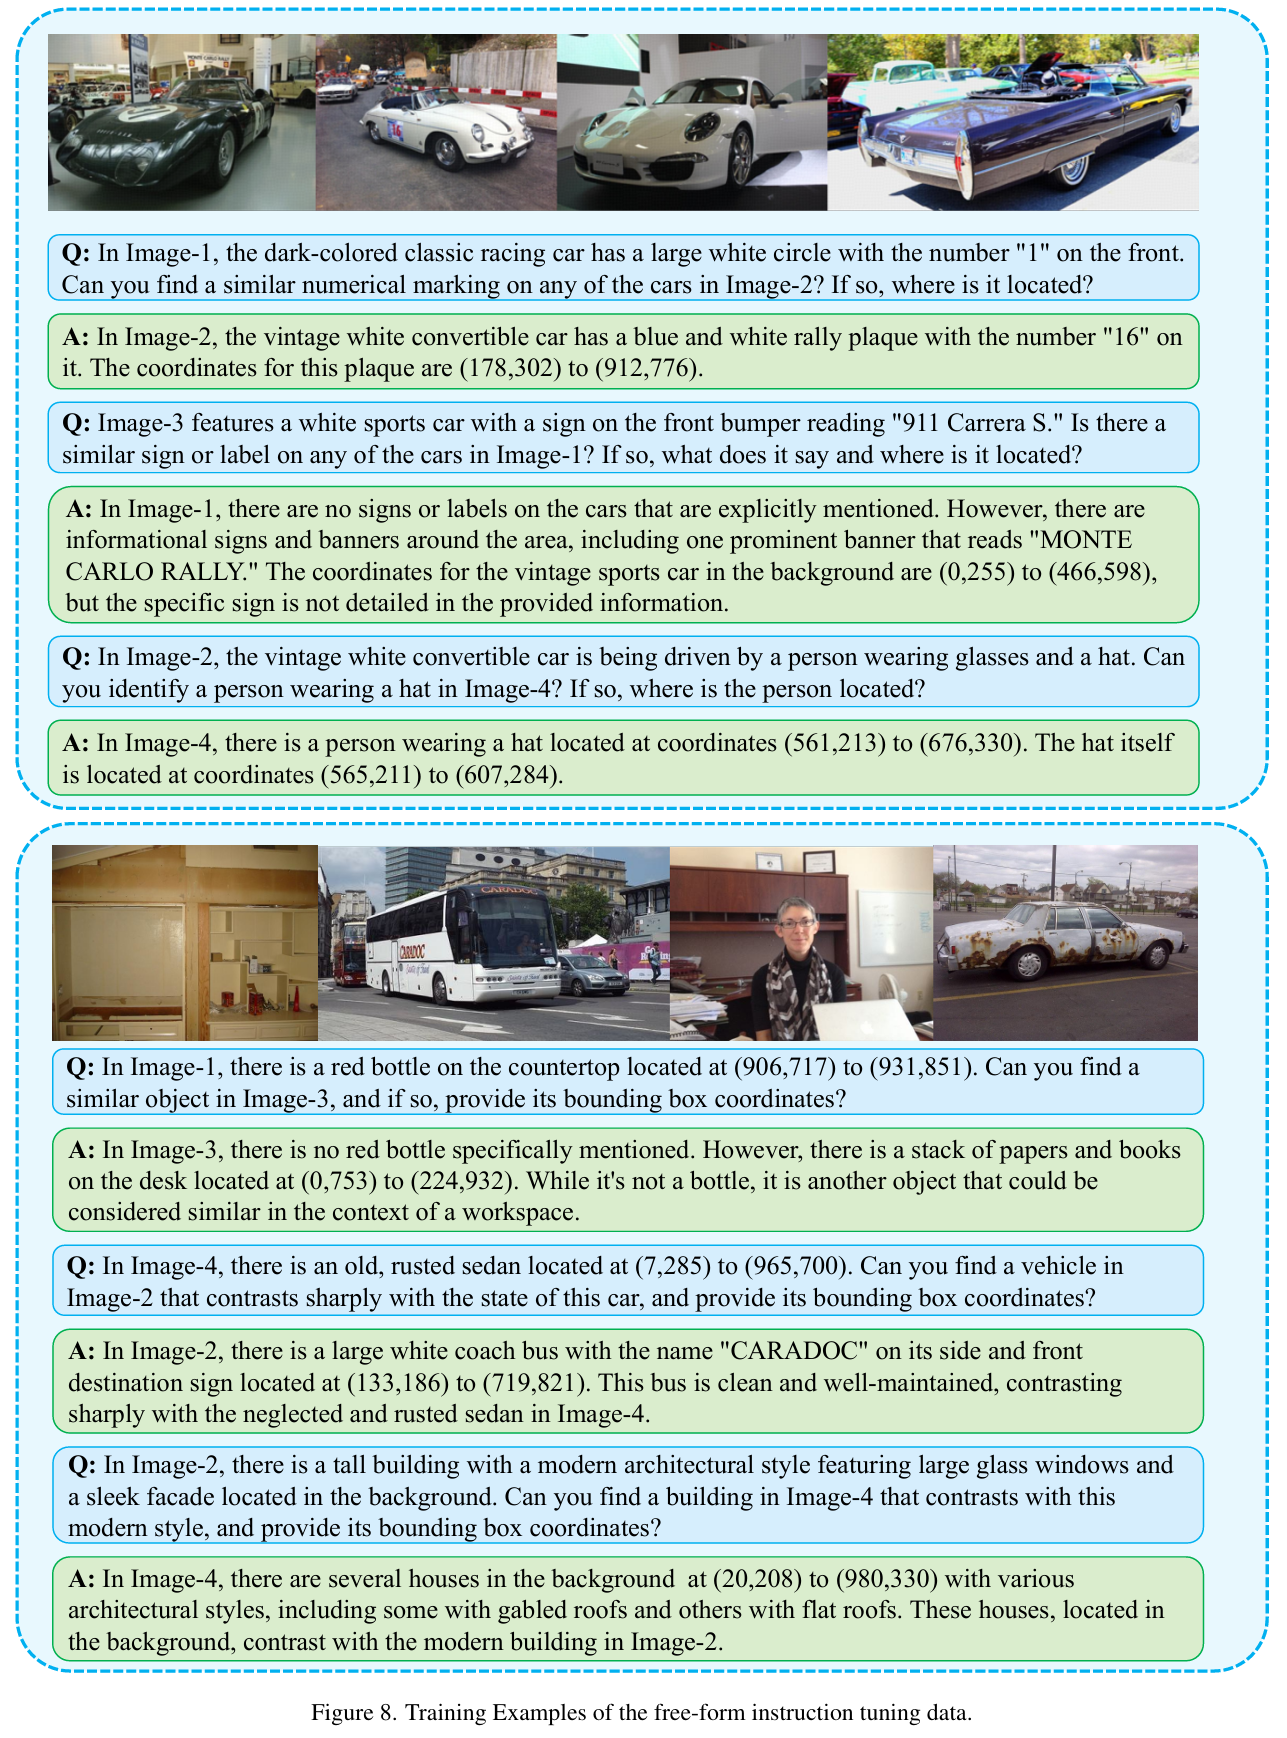
图8. 自由形式指令微调数据的训练示例。
(包含关于赛车编号、车牌、戴帽子的人、红色瓶子、生锈轿车与现代巴士对比、现代建筑与传统房屋对比等复杂跨图像推理和定位的问答对)
附录:提示模板 (Prompt Templates)
单图像 CoT 的提示模板
- 任务:静态差异 (Static diff)
- 步骤1:仔细比较这两张图像,告诉我它们在哪里不同。请用单个短语或单词简要回答。
- 步骤2:根据物体差异/变化:RESPONCE,请用边界框坐标定位这一差异。
- 任务:鲁棒差异 (Robust diff)
- 步骤1:仔细比较这两张图像,并用非常简单的单词或短语描述突出的不同物体。
- 步骤2:现在用边界框坐标定位物体差异/变化:"RESPONCE"。
- 任务:指代性定位 (Referring Grounding)
- 步骤1:仔细观察并简要描述图像1中的物体。
- 步骤2:请找到并用边界框坐标定位物体
<|object_ref_start|>[RESPONCE]<|object_ref_end|>。
- 任务:共同物体 (Common Object)
- 步骤1:这些图像共享一个共同物体。识别它并用单个短语或单词告诉我它的名字。
- 步骤2:请根据参考
<|object_ref_start|>[RESPONCE]<|object_ref_end|>定位并定位目标物体。
- 任务:区域定位 (Region Locating)
- 步骤1:用简单的短语或单词描述第XXX张图片的内容。
- 步骤2:请用边界框坐标定位物体
<|object_ref_start|>[RESPONCE]<|object_ref_end|>。
- 任务:多视角 (Multi-View)
- 步骤1:用简单的短语或单词描述第一张图像中标记有红色边界框 (
<|box_start|>(A,B),(C,D)<|box_end|>) 的物体。你可以参考其他图像以获得更精确的识别和描述。 - 步骤2:用边界框坐标定位并定位物体
<|object_ref_start|>[RESPONCE]<|object_ref_end|>。
- 步骤1:用简单的短语或单词描述第一张图像中标记有红色边界框 (
- 任务:物体追踪 (Object Tracking)
- 步骤1:用简单的短语描述第一张图像中标记有红色边界框的物体。
- 步骤2:现在用边界框坐标定位目标移动物体 RESPONCE。
- 任务:组定位 (Group Grounding)
- 步骤1:只需识别并告诉我是哪张图像。从以下选项回答:Image1 | Image2 | Image3...
- 步骤2:选定的图像+原始问题
- 注意:对于组定位,步骤2中的单张图像是通过匹配步骤1的答案选择的。如果框架未能提取目标图像,我们默认发送第一张图像。
- 任务:推理 (Reasoning)
- 步骤1:原始问题+ 用简单的短语命名图像2中的这个物体。
- 步骤2:请用边界框坐标定位并定位物体
<|object_ref_start|>[RESPONCE]<|object_ref_end|>。
- 任务:对应关系 (Correspondence)
- 步骤1:对于第一张图像,描述红色边界框标记区域 (
<|box_start|>(A,B),(C,D)<|box_end|>) 的语义/功能特征。 - 步骤2:定位共享相同语义或功能意义的区域:RESPONCE。
- 步骤1:对于第一张图像,描述红色边界框标记区域 (
格式提示 (Format Prompt)
格式:<|box_start|>(x1,y1),(x2,y2)<|box_end|>。不要生成额外的单词。
注意:我们部署此提示以获得更好的指令遵循效果。
标题和指令数据生成的提示模板
Bbox 优化模板
现在我希望你仔细检查原始图像。然后过滤、优化和增强这些标注的物体。最后,只给我你最终修改后的标注。
- 过滤:基于你对图像的深刻观察,请剔除明显不准确的(物体,bbox)对,这些错误对的数量应该很少。
- 优化 :将每个物体的原始类别/名称优化并增强为简短但更丰富的描述,包含其属性如颜色、位置、特征等(例如:plane
<|box_start|>(x1,y1),(x2,y2)<|box_end|>-> dark gray plane flying in the sky<|box_start|>(x1,y1),(x2,y2)<|box_end|>)。 - 扩增:如果任何重要物体在标注中缺失,并且你认为它们重要且必不可少,且你确信它们的位置,请随意将它们添加到最终标注中。
- 输出格式 :修改后的物体描述后跟其边界框坐标。
现在我给你的原始边界框标注是:
标题生成
用流畅的段落彻底描述这张图像。包括所有物体及其属性(颜色、形状、大小和特征)、相对位置和关系。
多图像定位指令生成
模板1
基于以下多张图像的详细信息,请组成有意义且灵活的跨图像 定位问题,通过属性相似性/对比(如颜色、位置、特征、性别、大小、形状等)或其他潜在逻辑联系将不同图像中的物体联系起来。
具体来说:
- 问题应包括跨图像定位请求,要求答案识别并定位不同图像中各种潜在连接的物体。你可以利用这些物体之间的联系或相似性来指代目标物品。
- 在问题中指代物体时,保持参考描述简洁,避免给出可能导致回答过于容易的不必要信息(如 bbox 或过度详细的标题)。鼓励通过物体之间的联系来指代要定位的目标物体,而不是明确指出物体。例如:"定位图像2中与图像4中破旧车辆质量对比最强烈的汽车",而不是"定位图像2中与图像4中破旧车辆质量对比最强烈的华丽红色跑车(明确指出)",这样做也可以引入一些推理过程。
- 在答案中包含指代物体的边界框坐标以及解释。(实际上你可以从坐标中获得很多信息,格式为 (x1,y1),(x2,y2)(x1,y1),(x2,y2)(x1,y1),(x2,y2))
- 严格将输出格式化为简单的 Q: A:。在答案中,对提到的物体遵循
<ref>object</ref>格式。
以下是详细的图像标题和相应图像中的物体: