作者:槿亦
对智能代码评审而言,识别通用问题只是第一步。能否理解代码库长期形成的技术约束、业务规则与团队偏好,决定了评审意见是否真正可信。云效智能评审新增「评审记忆」能力,将评审中已经澄清的上下文沉淀为可复用规则,让后续评审建立在团队真实的工程实践之上。
评审误报背后,是上下文无法复用
一次代码评审中,智能评审建议删除某个 DTO 的无参构造函数。开发者随即解释:"这个构造函数不能删除,旧版兼容链路会通过反射创建对象。"几天后,另一个合并请求(MR)出现相似改动,团队却不得不再次说明同一条规则。
这类重复沟通并不少见。智能评审能够识别通用的代码问题,但每个代码库都有一部分仅凭当前代码差异难以还原的背景:仍被旧系统调用的接口、团队统一采用的异常处理方式,以及修改某个字段时必须同步调整的关联逻辑。
很多看似合理、却不符合代码库实际情况的评审意见,往往与长期上下文缺失有关。
云效智能评审新增「评审记忆」能力。对于已经在评审中解释清楚的规则,团队可以将其保存为当前代码库的评审记忆。记忆生效后,后续评审遇到相关改动时,会将这些信息纳入判断依据,从而减少同类问题的反复沟通。
评审记忆沉淀的不是对话,而是工程规则
评审记忆并非简单保存临时评论,而是将能够长期复用的信息沉淀为代码库上下文。适合沉淀的内容主要包括以下四类:
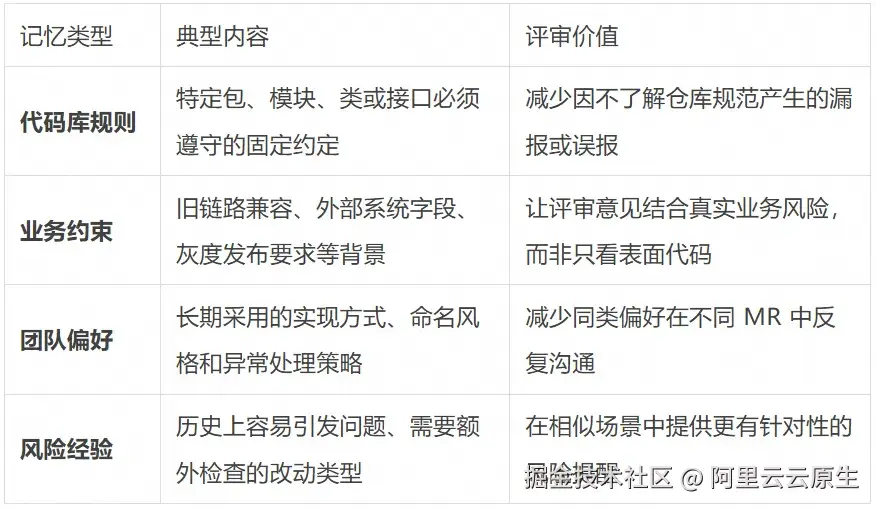
评审记忆的核心价值,是把依赖个别成员口头传递的隐性知识,转化为后续评审可以持续使用的显性规则。
下面两个场景,可以更直观地说明它如何参与评审判断。
场景一:由数据库维护更新时间
开发者修改了一段保存商品信息的代码,智能评审提示:"这里没有更新修改时间,可能导致数据不准确。"但在当前项目中,修改时间一直由数据库自动维护,业务代码无须重复赋值。
团队可以在评论中补充:
请记住:商品表的修改时间由数据库自动更新,保存商品信息时,业务代码不需要手动赋值。
记忆生效后,后续评审遇到类似代码时,会结合数据库的处理方式进行判断,减少"没有手动赋值就是遗漏"一类不符合项目实际情况的意见。
场景二:区分配送与自提规则
在商城业务中,快递配送订单必须填写收货地址,到店自提订单则只需选择自提门店。智能评审如果只比较两个下单流程的校验差异,可能会认为自提订单遗漏了地址校验。
团队可以明确告诉智能评审:
请记住:到店自提订单不要求填写收货地址,但必须选择自提门店;快递配送订单才需要校验收货地址。
这条记忆既能帮助评审识别两种流程的合理差异,也能在后续改动遗漏自提门店校验时,提供相应的检查依据。
一次说明,成为后续评审的判断依据
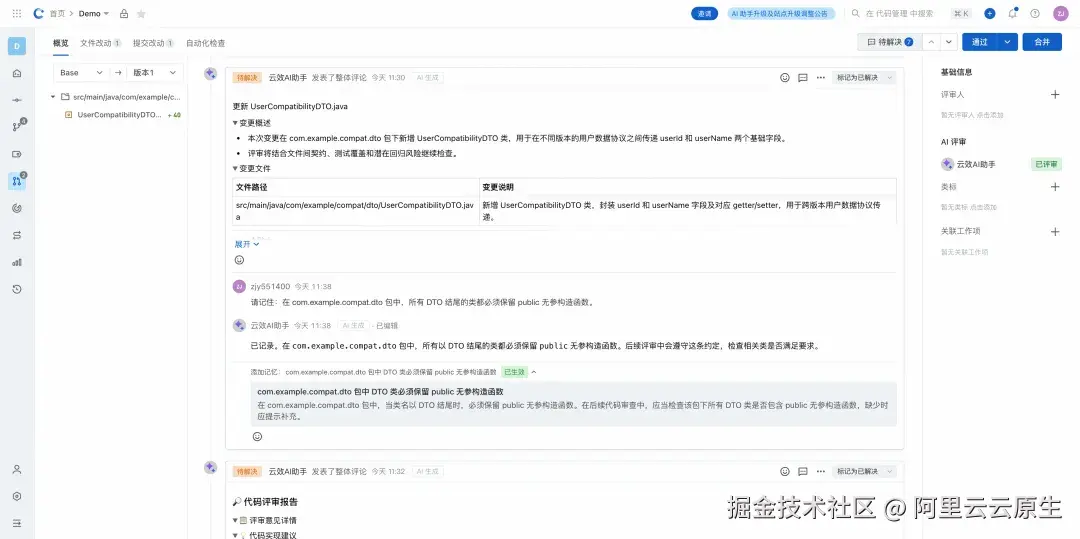
以兼容类 DTO 为例:某个包中的 DTO 必须保留 public 无参构造函数,虽然当前业务代码几乎不会直接调用,但旧版兼容链路仍需要通过反射创建对象。
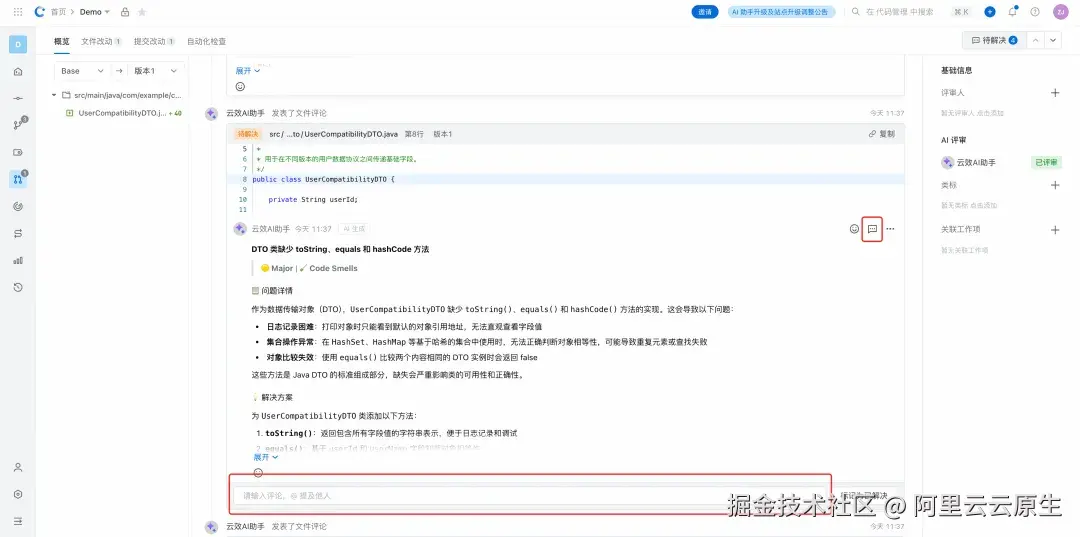
开发者可以在 MR 评论中告诉云效 AI 助手:
请记住:在 com.example.compat.dto 包中,所有以 DTO 结尾的类都必须保留 public 无参构造函数。
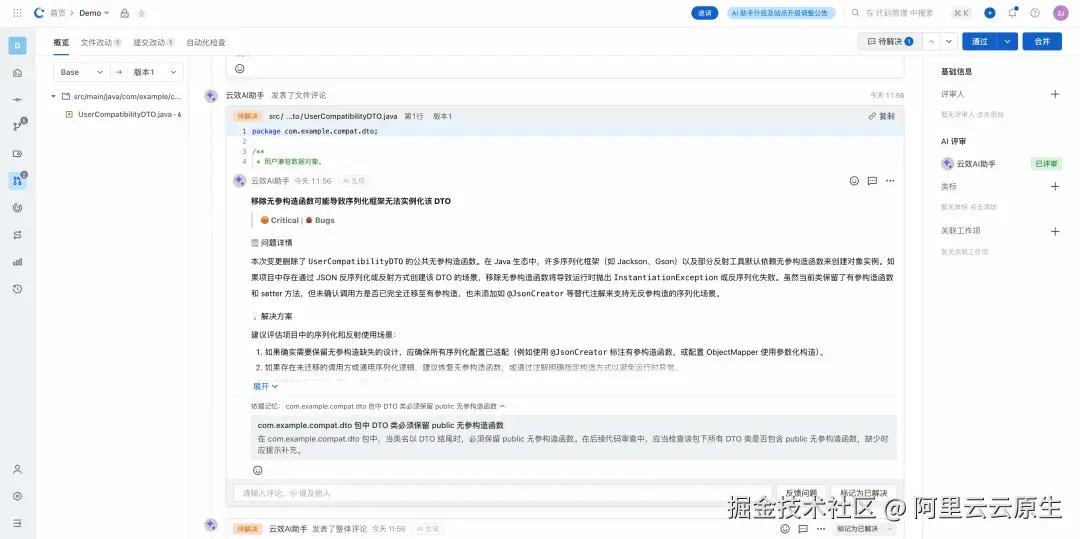
系统会将这条信息整理为当前代码库的候选记忆。记忆生效后,后续 MR 再出现相同或相似场景时,智能评审会把这条规则纳入判断依据;如果有人确实删除了相关构造函数,也可以据此提醒团队检查旧链路是否受到影响。
评审记忆为后续判断补充规则、适用范围及其背后的工程原因。
添加记忆
用户在评论中主动告知智能评审希望被记住的内容。
使用记忆
评审时,智能评审自动使用已经生效的记忆。
测试集验证:错误评审意见减少 96.9%
为验证评审记忆的实际效果,云效团队构建了测试集进行了对比测试,重点观察记忆能否减少因信息缺失、缺少代码库背景或不了解团队约定而产生的错误评审意见。
在该测试集样本中,使用评审记忆后,错误评审意见减少了 96.9%。这意味着,原本因缺少项目上下文而产生的大部分错误意见,在相关记忆的约束下得到了有效抑制。
96.9% 反映的是本次内部测试集上的错误意见降幅,其直接价值是验证"补充代码库上下文能够显著减少特定类型误报",不等同于所有代码库和全部评审场景下的通用准确率。
对研发团队而言,这一变化主要体现在三个方面:
- 降低低价值干扰: 错误意见减少后,真正需要关注的评审意见更容易被看到。
- 减少重复解释: 团队约定可以在日常评审中自然沉淀,并用于后续 MR。
- 提升评审一致性: 不同成员面对相似改动时,可以基于相同的代码库规则展开讨论。
可持续的记忆,需要配套治理机制
团队经验只有在准确、长期有效且边界清晰时,才适合作为后续评审的依据。如果一次性的场景或表达不完整的反馈直接长期生效,反而可能引入新的误判。因此,评审记忆不仅需要积累,也需要治理。
让智能评审获得长期上下文的同时,也要确保这些上下文可审查、可修订、可停用。
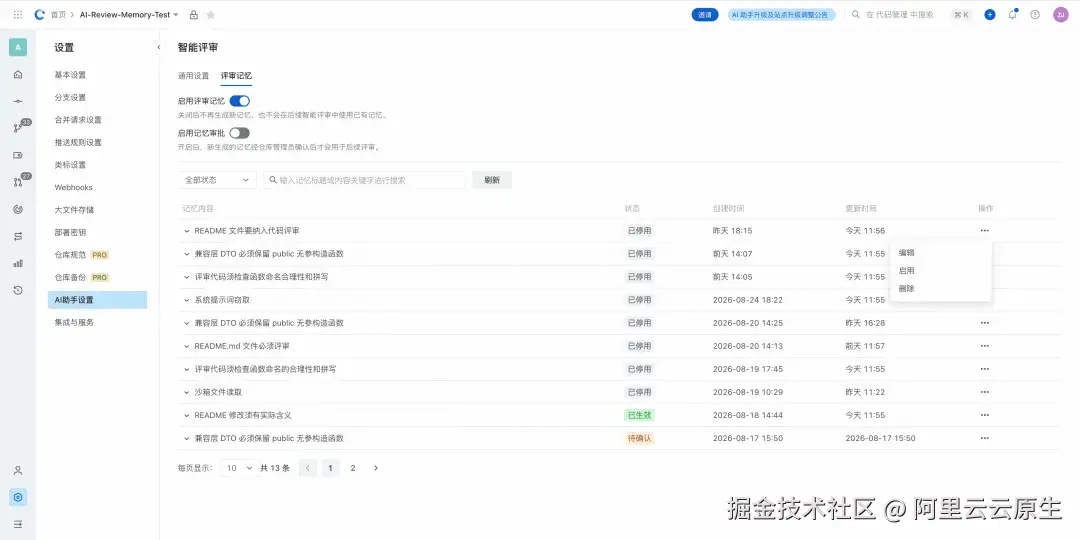
代码库管理员可以进入「代码库设置 --- AI 助手设置 --- 智能评审 --- 评审记忆」,开启或关闭当前代码库的评审记忆能力。
管理员还可以根据团队需要开启记忆审批。开启后,新生成的候选记忆需要经过管理员确认才会生效。管理员可以查看、编辑、通过、拒绝、停用、重新启用或删除记忆,从而避免一次性场景、表述不清或不适合作为长期规则的信息进入后续评审。
高质量记忆,需要明确四个要素
一条有效的评审记忆,不仅要说明"应该怎么做",还要让智能评审知道规则适用于哪里、为什么存在,以及在什么情况下需要提示。
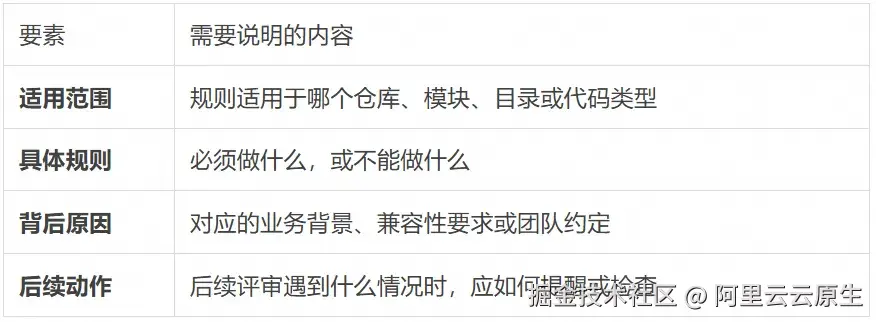
规则越具体、边界越清晰,记忆在后续评审中越容易被准确使用。
可以使用下面的基础模板开始:
请记住:当【适用范围或具体场景】出现【某类改动】时,需要遵循【规则或要求】,因为【业务背景或技术原因】;如果不符合,请提示【需要检查的风险】。
相比只说"这里不要改",完整描述规则及其原因,更有利于智能评审在相似但不完全相同的场景中作出合理判断。
写在最后
代码评审的质量,不仅取决于能否发现通用代码问题,也取决于能否理解代码库长期形成的工程约束。评审记忆将散落在评论、个人经验和重复沟通中的团队知识,转化为可被后续评审持续使用的上下文,使智能评审从单次代码分析进一步走向基于团队规则的持续协作。
这项能力的边界同样明确:长期有效、适用范围清晰的规则,更适合进入评审记忆。团队还可以按治理要求启用管理员审批并持续维护,在提升评审准确性的同时,保持规则本身的可靠性。
如果已经在使用云效智能评审,可以进入「代码库设置 --- AI 助手设置 --- 智能评审 --- 评审记忆」开启该能力,并从下一次 MR 中那条需要反复解释的规则开始沉淀。
云效 AI 智能代码评审帮助文档:help.aliyun.com/zh/yunxiao/...