你在调试 LangChain Agent 时,很容易看到这样的代码:
result = agent.invoke({
    "messages": [
        {"role": "system", "content": "你是一个天气预报员"},
        {"role": "user", "content": "北京天气怎么样?"}
    ]
})

print(result["messages"])
然后打印出来的并不是一句简单的回答,而是一长串:
SystemMessage(...)
HumanMessage(...)
AIMessage(...)
ToolMessage(...)
AIMessage(...)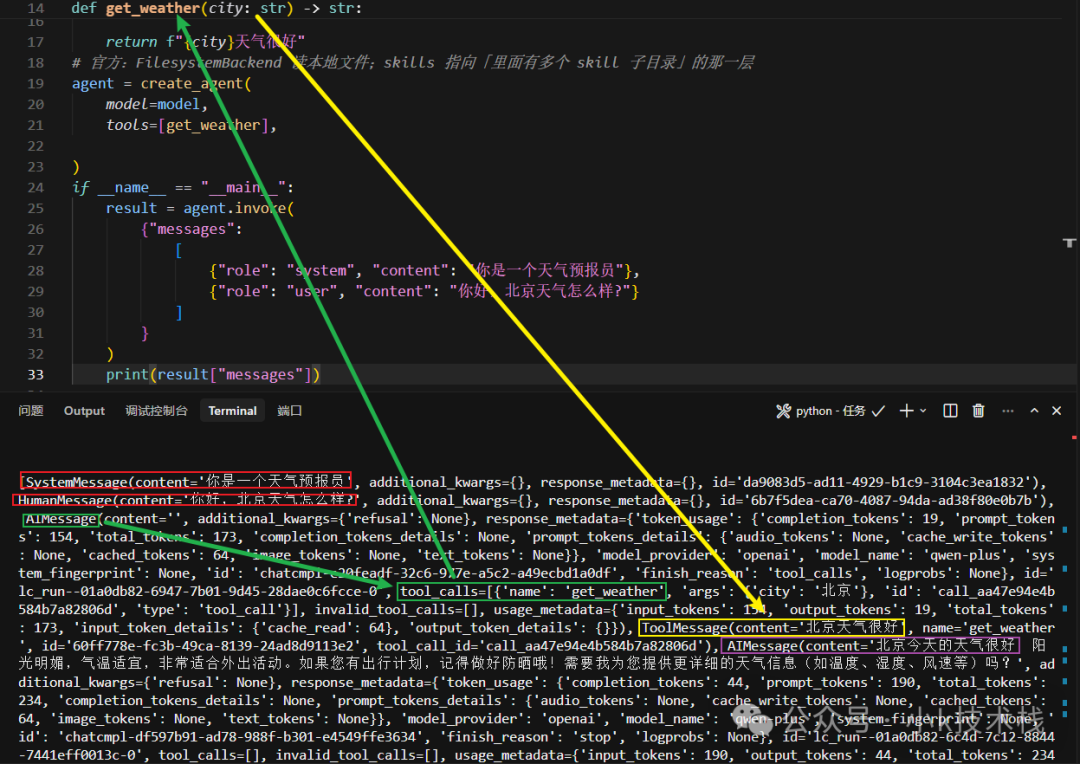
第一次看到这里,最容易产生两个疑问:
为什么一次提问会返回这么多消息?
这些 SystemMessage、HumanMessage、ToolMessage、AIMessage 到底分别代表什么?
其实只要先抓住一条主线就很好理解:
用户输入
   ↓
模型决策
   ↓
如果需要工具:发起 tool call
   ↓
工具执行
   ↓
工具结果返回模型
   ↓
模型继续决策或生成最终回答
LangChain 的 messages,本质上就是在记录这条执行链路。
先搞清楚:result"messages" 是什么?
在当前 LangChain Agent 中,Agent 会维护一个 AgentState。
其中最核心的内置字段就是:
AgentState
└── messages    # 当前线程中的消息历史,类型为 list[BaseMessage]
也就是说:
result = agent.invoke(...)拿到的 result 通常不是"模型的一句话回答",而是 Agent 执行结束后的状态。
而:
result["messages"]才是这次 Agent 执行过程中积累下来的消息序列。
可以简单理解成:
result
│
├── messages                # 消息历史
├── structured_response     # 如果配置了结构化输出,可能存在
└── 其他自定义 State 字段
所以以后看到:
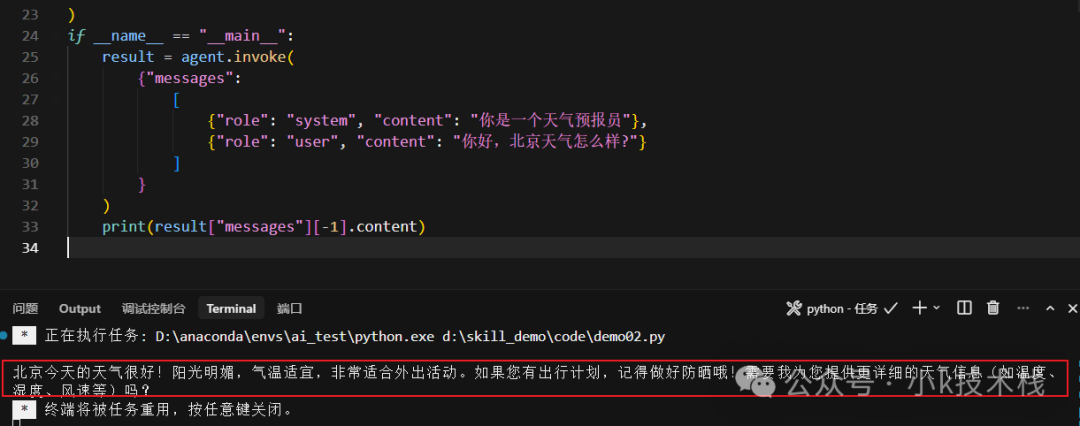
result["messages"][-1].content它的意思就是:
取当前消息历史里的最后一条消息。
在大多数普通 Agent 场景中,最后一条通常就是模型最终生成的 AIMessage。
BaseMessage:所有消息的共同父类
SystemMessage、HumanMessage、AIMessage、ToolMessage 都继承自 BaseMessage。
因此它们会共享一批基础字段。
按照当前 LangChain 的消息结构,可以重点理解成:
BaseMessage
│
├── content                  # 消息原始内容,可以是文本,也可以是内容块列表
├── additional_kwargs        # 模型供应商或扩展数据
├── response_metadata        # 响应元数据,如模型名、finish_reason、headers 等
├── name                     # 可选的人类可读名称
├── id                       # 消息唯一 ID
├── type                     # 消息类型,如 human / ai / tool / system
├── content_blocks           # 标准化后的内容块,例如文本、图片、文件、推理块等
└── text                     # 从消息内容中提取出的文本视图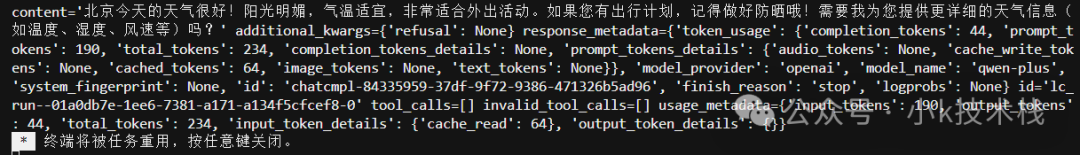
这里最需要记住的是:
content 是消息主体,其他字段更多是在描述"这条消息是什么、从哪里来、还带了什么额外信息"。
SystemMessage:告诉模型"应该怎么工作"
SystemMessage 主要负责给模型提供系统级规则。
例如:
from langchain_core.messages import SystemMessage

SystemMessage(
    content="你是一个天气助手,回答要简洁准确。"
)
它表达的是:
SystemMessage
│
├── content              # 系统提示词、规则、角色、行为约束
├── additional_kwargs    # 扩展字段
├── response_metadata    # 响应元数据
├── name                 # 可选名称
├── id                   # 消息 ID
└── type = "system"      # 固定类型
在普通聊天模型调用中,系统消息通常位于消息序列前面:
SystemMessage
   ↓
HumanMessage
   ↓
AIMessage
HumanMessage:用户输入
HumanMessage 最简单。
它就是:用户发送给模型的消息。
例如:
from langchain_core.messages import HumanMessage

HumanMessage(content="北京天气怎么样?")
核心字段可以理解成:
HumanMessage
│
├── content              # 用户输入
├── additional_kwargs    # 额外扩展数据
├── response_metadata    # 响应元数据,普通输入消息通常没有重要内容
├── name                 # 用户或发送者名称,可选
├── id                   # 消息唯一 ID
└── type = "human"       # 固定类型
当你这样调用 Agent:
agent.invoke({
    "messages": [
        {"role": "user", "content": "北京天气怎么样?"}
    ]
})
LangChain 会把这种标准消息格式转换成对应的消息对象。
也就是可以把它理解成:
{"role": "user", "content": "北京天气怎么样?"}

                 ↓

HumanMessage(content="北京天气怎么样?")
AIMessage:最重要的一种消息
AIMessage 不只是"AI 回答了什么"。
在 Agent 场景中,它还有一个更重要的作用:
记录模型这一轮做出的决策。
模型这一轮可能有两种典型行为。
情况一:直接回答
比如用户问:
1 + 1 等于多少?模型不需要调用工具。
那么可能直接产生:
AIMessage
└── content = "2"
情况二:模型决定调用工具
比如用户问:
北京天气怎么样?Agent 有一个天气工具。
模型可能不会立刻给最终答案,而是返回:
AIMessage
│
├── content = ""
└── tool_calls
    └── get_weather(city="北京")
所以在 Agent 里:
AIMessage 既可以表示最终回答,也可以表示"我要调用哪个工具"的中间决策。
AIMessage 里有哪些重要字段?
可以重点记住下面这些:
AIMessage
│
├── content                  # 模型输出正文
├── additional_kwargs        # 模型供应商原始扩展字段
├── response_metadata        # 模型名、finish_reason、响应头等
├── name                     # Agent 名称,可选,例如 Alice / Bob
├── id                       # 消息唯一 ID
├── type = "ai"              # 固定类型
├── tool_calls               # 已成功解析的工具调用
├── invalid_tool_calls       # 解析失败或格式异常的工具调用
└── usage_metadata           # LangChain 标准化后的 Token 使用统计
这里真正和 Agent 执行关系最大的,是:
tool_callstool_calls 里面又有什么?
假设模型决定调用:
get_weather(city="北京")对应的 tool_calls 大致可以理解成:
[
    {
        "name": "get_weather",
        "args": {
            "city": "北京"
        },
        "id": "call_123",
        "type": "tool_call"
    }
]
字段关系是:
tool_calls
└── ToolCall
    ├── name            # 要调用哪个工具
    ├── args            # 传给工具的参数
    ├── id              # 这一次工具调用的唯一标识
    └── type            # tool_call
所以:
AIMessage.tool_calls真正表达的是:
模型认为下一步应该执行哪些工具,以及分别传什么参数。
这一步非常关键。
模型本身并没有执行工具。
它只是生成了一个"工具调用请求"。
真正执行工具,是 Agent 框架后面的工具执行节点完成的。
ToolMessage:把工具执行结果重新交给模型
假设模型刚刚产生:
AIMessage
└── tool_calls
    └── id = "call_123"
        name = "get_weather"
        args = {"city": "北京"}
Agent 框架看到这个 tool call 后,就会真正执行:
get_weather(city="北京")假设工具返回:
北京今天晴,25°CLangChain 会把这个结果包装成:
ToolMessage
│
├── content = "北京今天晴,25°C"
└── tool_call_id = "call_123"
然后再交回给模型。
模型看到工具结果后,才继续生成最终回答。
一次完整工具调用,messages 是怎么变化的?
现在把整个流程串起来。
假设用户输入:
北京天气怎么样?Agent 有一个:
get_weather工具。
一次典型执行过程就是:
HumanMessage
用户:"北京天气怎么样?"
        ↓
AIMessage
模型:"我要调用 get_weather"
tool_calls = [
    {
        name: "get_weather",
        args: {"city": "北京"},
        id: "call_123"
    }
]
        ↓
ToolMessage
工具:"北京今天晴,25°C"
tool_call_id = "call_123"
        ↓
AIMessage
模型:"北京今天晴,气温约 25°C。"也就是说,result"messages" 最终可能类似:
[
    HumanMessage(...),
    AIMessage(tool_calls=[...]),
    ToolMessage(...),
    AIMessage(...)
]
这就是最典型的 Agent 消息链路。
用一棵树把四种消息理清楚
如果只看最常用字段,可以整理成下面这样:
BaseMessage
│
├── content                  # 消息主体内容
├── additional_kwargs        # 扩展数据
├── response_metadata        # 响应元数据
├── name                     # 可选名称
├── id                       # 消息唯一 ID
├── type                     # 消息类型
├── content_blocks           # 标准化内容块
│
├── SystemMessage            # 系统规则
│   ├── content              # 系统提示词、角色、规则、行为约束
│   └── type = "system"      # 固定类型
│
├── HumanMessage             # 用户消息
│   ├── content              # 用户输入
│   └── type = "human"       # 固定类型
│
├── AIMessage                # 模型输出 / 模型决策
│   ├── content              # 模型正文
│   ├── tool_calls           # 成功解析的工具调用请求
│   │   └── ToolCall
│   │       ├── name         # 工具名称
│   │       ├── args         # 工具参数
│   │       ├── id           # 工具调用 ID
│   │       └── type         # tool_call
│   ├── invalid_tool_calls   # 无效或解析失败的工具调用
│   ├── usage_metadata       # 标准化 Token 使用统计
│   └── type = "ai"          # 固定类型
│
└── ToolMessage              # 工具执行结果
    ├── content              # 返回给模型的工具结果
    ├── tool_call_id         # 对应 AIMessage 中的 ToolCall.id
    ├── artifact             # 完整附加工具结果
    ├── status               # success / error
    └── type = "tool"        # 固定类型
刚开始学习 Agent,其实先把这棵树记住就够了。