大家好,我是Java1234_小锋老师。
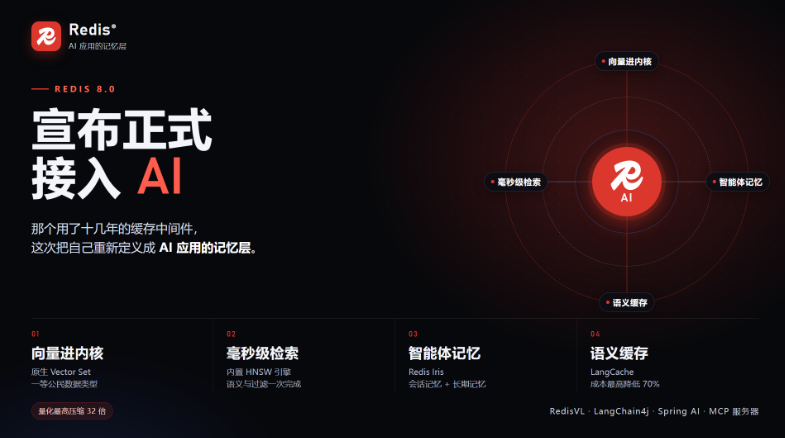
那个我们用了十几年的"缓存中间件",这次把自己重新定义成了 AI 应用的记忆层。
一、先聊聊 Redis:它到底是个什么东西
如果你写过三年以上的后端,大概率跟 Redis 打过交道。它的经典形象是这样的:一个跑在内存里的键值数据库,读写延迟在微秒级,用来扛住数据库前面的流量。
Redis 的全称是 RE mote DI ctionary Server,2009 年由 Salvatore Sanfilippo 开源。它最出名的设计是"数据结构服务器"这个定位------它不只是存字符串,还原生提供 List、Hash、Set、Sorted Set、Stream、Bitmap、HyperLogLog 这些结构。
所以过去十几年里,Redis 在项目里的角色大致是这么几类:
- 缓存:挡在 MySQL 前面,抗读流量;
- 分布式锁 :
SET key value NX PX 30000,几乎是标配; - 消息队列:早期用 List,后来用 Stream;
- 排行榜/计数器:Sorted Set 和 INCR 的主场;
- 会话存储:把 Session 从单机内存挪出来。
共同点很明显:快,而且结构灵活。而这两个特点,恰好是 AI 应用最缺的东西。
二、为什么是 Redis?AI 时代的"记性问题"
大模型有个天生的毛病:它没有记忆。
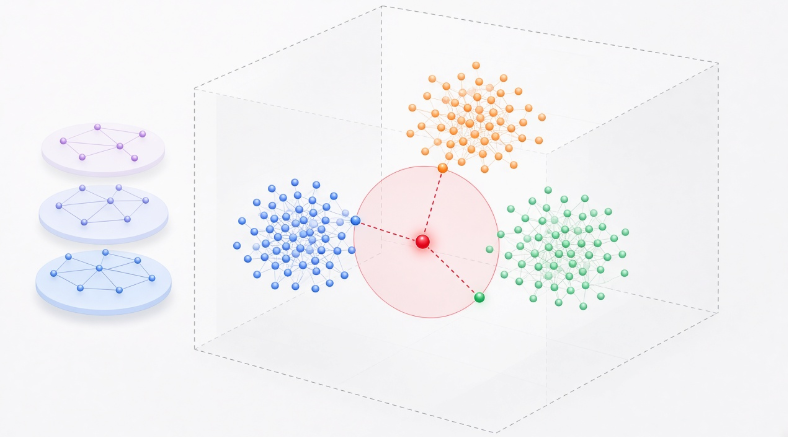
每一次调用 LLM,本质上都是无状态的。你上一轮说"我叫张三,不吃辣",下一轮它就忘了,除非你把这句话重新塞进 prompt 里。于是所有 AI 应用都在干同一件事------在调用模型之前,把相关的上下文找出来、拼进去。
这件事拆开看,就三个动作:
- 用户问了个问题,把问题变成向量;
- 去一堆知识/历史里找出语义最接近的几条;
- 拼成 prompt 丢给模型。
第 2 步要在几十毫秒内完成,否则用户就会觉得"这 AI 怎么这么卡"。而"低延迟 + 海量数据 + 结构化查询"这几个词凑在一起,正是 Redis 十几年来最擅长的活。
于是 Redis 做了一件很自然的事:把向量能力做进内核,然后顺着往上,把智能体记忆这一层也接管了。
三、核心基石:把向量能力做进内核
3.1 原生 Vector Set 数据类型
Redis 8.0 引入了 Vector Set,这是继 Sorted Set 之后少有的"一等公民"级新数据类型。
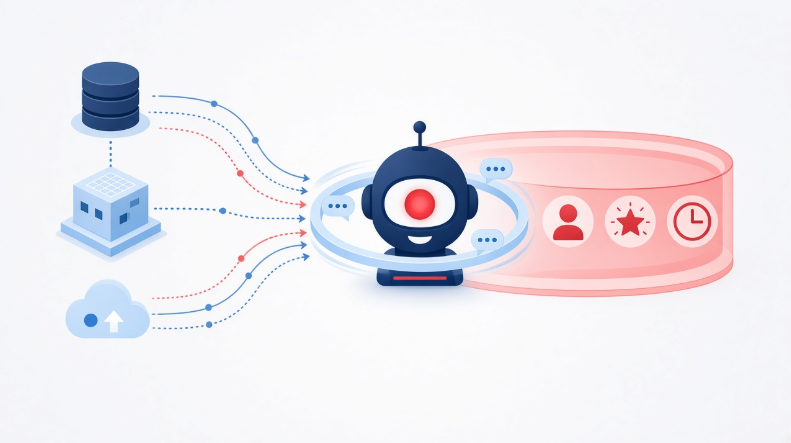
理解它最快的方式是类比:Sorted Set 里每个元素关联一个分数 (标量),Vector Set 里每个元素关联一个向量。前者按分数排序,后者按向量的相似度排序。
底层用的是 HNSW(分层可导航小世界图)算法,这是目前近似最近邻检索里最主流的方案之一------它在图上分层跳跃,能在对数级的时间里找到近似最近邻。
用起来相当朴素,就是几条命令:
bash
# ========== 向量集合基础操作 ==========

# VADD:往向量集合 movies 里添加元素
# FP32/VALUES 用于指定向量格式,这里用 VALUES 直接传浮点数
# 语法:VADD key VALUES <维度> <v1> <v2> ... <元素名>
VADD movies VALUES 4 0.12 0.88 0.35 0.91 "流浪地球"
VADD movies VALUES 4 0.15 0.85 0.31 0.88 "星际穿越"
VADD movies VALUES 4 0.91 0.12 0.77 0.05 "疯狂动物城"

# SETATTR:给元素挂上标量属性,用于后续过滤
VSETATTR movies "流浪地球"   '{"year": 2019, "type": "科幻"}'
VSETATTR movies "星际穿越"   '{"year": 2014, "type": "科幻"}'
VSETATTR movies "疯狂动物城" '{"year": 2016, "type": "动画"}'

# VSIM:相似性搜索,找出与给定向量最接近的 2 个元素
# WITHSCORES 会一并返回相似度得分
VSIM movies VALUES 4 0.13 0.86 0.33 0.90 COUNT 2 WITHSCORES
# 返回:1) "流浪地球" 2) "0.998"  3) "星际穿越" 4) "0.995"

# 关键能力:向量检索 + 标量过滤 一步到位
# 只在 2015 年之后的科幻片里做相似度检索
VSIM movies VALUES 4 0.13 0.86 0.33 0.90 COUNT 2 \
     FILTER '.year > 2015 and .type == "科幻"'
最后那个 FILTER 是重点。向量检索 + 标量过滤在一次调用里完成,不用先查一遍再回到应用层过滤,这在推荐系统、权限隔离的语义搜索场景里能省掉大量往返。
3.2 内置的向量搜索引擎
以前想在 Redis 里做向量检索,得单独装 RediSearch 模块。现在这个模块已经整合进 Redis 核心,开箱即用。
它比 Vector Set 更"重"一些,但能力也更全:支持 HNSW 和 FLAT 两种索引类型,并且能和全文检索、数值范围、标签过滤组合成混合查询。
bash
# ========== 创建一个向量索引 ==========
# ON HASH:索引 Hash 类型的数据
# PREFIX 1 doc::只索引 key 以 doc: 开头的数据
FT.CREATE idx:docs ON HASH PREFIX 1 doc: SCHEMA
  title      TEXT                      # 标题,支持全文检索
  category   TAG                       # 分类,支持精确过滤
  views      NUMERIC SORTABLE          # 浏览量,支持范围查询与排序
  embedding  VECTOR HNSW 6             # 向量字段,使用 HNSW 索引
    TYPE FLOAT32                       # 元素类型
    DIM 1536                           # 向量维度(对应 embedding 模型输出)
    DISTANCE_METRIC COSINE             # 距离度量:余弦相似度

# ========== 混合查询 ==========
# 含义:在 category 为"技术"且浏览量大于 1000 的文档里,
#       找出与查询向量最相似的 5 条
FT.SEARCH idx:docs
  "(@category:{技术} @views:[1000 +inf])=>[KNN 5 @embedding $vec AS score]"
  PARAMS 2 vec "<二进制向量>"
  SORTBY score ASC
  RETURN 2 title score
DIALECT 2这种"过滤条件写在前面,KNN 跟在后面"的语法,是 Redis 向量查询的标准写法。它意味着你可以把业务过滤和语义检索写在同一个查询里,而不是在应用层做两次拼接。
3.3 量化:用一点精度换 32 倍内存
向量很吃内存。一个 1536 维的 FLOAT32 向量占 6KB,一千万条就是 60GB------对内存数据库来说这个数字相当扎眼。
Redis 给的答案是量化(Quantization):
| 量化方式 | 存储压缩 | 召回精度 | 适用场景 |
|---|---|---|---|
| 不量化(FP32) | 1× | 最高 | 数据量小、精度要求极高 |
| 8 位量化(Q8) | 约 4× | 损失很小 | 大多数生产场景的默认选择 |
| 二进制量化(BIN) | 最高 32× | 有明显损失 | 超大规模、可接受粗召回 |
实践中常见的做法是两段式:先用 BIN 量化做一轮粗召回捞出几百条候选,再用原始精度向量做精排。既省了内存,精度也基本保住了。
bash
# 建索引时开启 8 位量化,内存占用直接降到约 1/4
VADD movies Q8 VALUES 4 0.12 0.88 0.35 0.91 "流浪地球"

# 二进制量化,内存压到极致
VADD movies BIN VALUES 4 0.12 0.88 0.35 0.91 "流浪地球"
四、智能体记忆与上下文引擎:Redis Iris
如果说向量能力是基石,那 Iris 就是 Redis 这次真正想讲的故事。
Iris 是一个专门给 AI 智能体设计的上下文与记忆平台 。它要解决的是一个很具体的生产问题:Demo 里跑得好好的 Agent,一上线就开始胡说八道。原因通常不是模型不行,而是数据碎片化 和信息过时------Agent 拿到的上下文本身就是错的。

Iris 由三个组件拼起来:
① Redis Context Retriever
让开发者对业务数据做语义建模------把"客户""订单""商品"这些实体以及它们之间的关系描述清楚,然后系统自动生成一批安全的数据获取工具(基于 MCP 协议)暴露给 Agent。
它的价值在于:Agent 不再自己拼 SQL。让大模型直接写 SQL 去查生产库,这件事在 Demo 里很酷,在生产里很危险------语法错误、全表扫描、越权访问,每一样都够运维喝一壶。
② Redis Agent Memory
双层记忆架构,这个设计其实很贴近人脑:
- 会话记忆(Working Memory):短期的,存当前对话的来龙去脉,会话结束后可以按 TTL 自动过期;
- 长期记忆(Long-term Memory):持久化的,存用户偏好、历史结论、关键事实,跨会话可复用。
有了长期记忆,用户三个月前说过的"我对花生过敏",今天下单时 Agent 还记得。
java
import com.redis.vl.extensions.session.ChatMessage;
import com.redis.vl.extensions.session.SemanticSessionManager;
import redis.clients.jedis.JedisPooled;

import java.util.List;

/**
 * 智能体双层记忆示例
 * 演示会话记忆的写入,以及按语义相关性检索历史
 */
public class AgentMemoryDemo {

    /**
     * 主方法:完整演示一次"写入记忆 ------ 检索记忆"的过程
     *
     * @param args 启动参数,本示例未使用
     */
    public static void main(String[] args) {
        JedisPooled client = new JedisPooled("localhost", 6379);

        // 创建会话管理器,sessionTag 用于区分不同用户的会话
        SemanticSessionManager session = SemanticSessionManager.builder()
                .name("assistant_session")
                .sessionTag("user:1001")
                .redisClient(client)
                .build();

        // 写入会话记忆:一问一答成对存储
        session.addMessage(new ChatMessage("user", "帮我推荐一家附近的川菜馆"));
        session.addMessage(new ChatMessage("llm", "推荐「蜀香居」,评分 4.8"));
        session.addMessage(new ChatMessage("user", "提醒一下,我对花生过敏"));

        // 语义检索历史:只捞出与当前问题相关的记忆,而不是把全部历史塞进 prompt
        // distanceThreshold 控制相关性阈值,值越小要求越严格
        List<ChatMessage> context = session.getRelevant(
                "今晚吃什么比较合适",   // 当前问题
                3,                      // 最多返回 3 条相关记忆
                0.3                     // 语义距离阈值
        );

        // 检索结果会包含"对花生过敏"这条,Agent 因此能给出安全的推荐
        for (ChatMessage item : context) {
            System.out.println(item.getRole() + " : " + item.getContent());
        }
    }
}
这里最值得注意的是 getRelevant():它不是把所有历史一股脑塞进 prompt,而是按语义相关性挑出最有用的那几条。上下文窗口是有限且昂贵的,这一步直接决定了成本和效果。
③ Redis Data Integration
负责从企业的数据库、数仓等源系统近实时地把数据同步进 Redis。听起来不性感,但它解决的是 Agent 最致命的问题:拿旧数据办新事。库存早就清零了,Agent 还在热情推荐。
五、开发者工具与生态集成
5.1 RedisVL:给 AI 应用准备的客户端库
RedisVL(Redis Vector Library)是官方为 AI 场景封装的客户端库,Java 版本可以直接用 Maven 引入。它把建索引、写向量、查相似这些事都包装成了顺手的 API。
xml
<!-- pom.xml 引入 RedisVL 的 Java 客户端 -->
<dependency>
    <groupId>com.redis</groupId>
    <artifactId>redis-vl-java</artifactId>
    <version>0.4.0</version>
</dependency>
java
import com.redis.vl.index.SearchIndex;
import com.redis.vl.query.VectorQuery;
import com.redis.vl.schema.IndexSchema;

import java.util.HashMap;
import java.util.List;
import java.util.Map;

/**
 * 基于 RedisVL 的最小可用 RAG 检索层
 * 流程:定义索引 ------ 创建索引 ------ 写入文档 ------ 语义检索
 */
public class RagRetrieverDemo {

    /** Redis 连接地址 */
    private static final String REDIS_URL = "redis://localhost:6379";

    /**
     * 主方法:串起 RAG 检索层的完整流程
     *
     * @param args 启动参数,本示例未使用
     */
    public static void main(String[] args) {
        // 1. 定义索引结构(也可以从 yaml 文件加载)
        IndexSchema schema = IndexSchema.builder()
                .name("kb_index")                       // 索引名称
                .prefix("kb")                           // 只索引 key 以 kb 开头的数据
                .storageType(IndexSchema.StorageType.HASH)
                .addTextField("content")                // 原文内容,支持全文检索
                .addTagField("source")                  // 来源标签,用于过滤
                .addVectorField("embedding", builder -> builder
                        .dims(1536)                     // 向量维度
                        .algorithm("hnsw")              // 使用 HNSW 索引
                        .distanceMetric("cosine")       // 余弦距离
                        .dataType("float32"))
                .build();

        // 2. 创建索引(false 表示已存在则复用,不覆盖)
        SearchIndex index = new SearchIndex(schema, REDIS_URL);
        index.create(false);

        // 3. 批量写入文档,embedding 由你选用的模型生成
        index.load(List.of(
                buildDoc("Redis 8.0 引入了原生 Vector Set 数据类型", "release-note"),
                buildDoc("HNSW 是一种基于图的近似最近邻算法", "wiki")
        ));

        // 4. 语义检索:返回最相关的 3 条,并限定来源
        VectorQuery query = VectorQuery.builder()
                .vector(embed("Redis 的向量类型叫什么"))
                .vectorFieldName("embedding")
                .returnFields("content", "source")
                .numResults(3)
                .filterExpression("@source:{release-note}")  // 标量过滤与向量检索同时生效
                .build();

        for (Map<String, Object> doc : index.query(query)) {
            System.out.println("[" + doc.get("vector_distance") + "] " + doc.get("content"));
        }
    }

    /**
     * 组装一条待写入的文档
     *
     * @param content 文档原文
     * @param source  文档来源标签
     * @return 可直接写入索引的文档字段集合
     */
    private static Map<String, Object> buildDoc(String content, String source) {
        Map<String, Object> doc = new HashMap<>();
        doc.put("content", content);
        doc.put("source", source);
        doc.put("embedding", embed(content));
        return doc;
    }

    /**
     * 文本向量化,实际项目中替换为你选用的 embedding 模型调用
     *
     * @param text 待向量化的文本
     * @return 向量数组
     */
    private static float[] embed(String text) {
        // TODO 接入 OpenAI、通义千问或本地部署的 embedding 模型
        return new float[1536];
    }
}
5.2 LangCache:语义缓存,省钱的那一环
这大概是最容易讲清楚 ROI 的一个功能。
传统缓存靠 key 精确匹配。但用户问问题时,"怎么退货""退货流程是什么""我想退货咋办"是三个不同的字符串,传统缓存全都会 miss,于是你付了三次 LLM 的钱。
语义缓存换了个思路:比的不是字符串,是语义相似度。三句话的向量足够接近,第二、三次请求直接命中缓存返回。
官方给出的数字是:LLM 成本最多降低 70%,缓存命中时响应速度提升约 15 倍。
#mermaid-svg-erTSP1ZsELgjAUAl{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-erTSP1ZsELgjAUAl .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-erTSP1ZsELgjAUAl .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-erTSP1ZsELgjAUAl .error-icon{fill:#552222;}#mermaid-svg-erTSP1ZsELgjAUAl .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-erTSP1ZsELgjAUAl .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-erTSP1ZsELgjAUAl .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-erTSP1ZsELgjAUAl .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-erTSP1ZsELgjAUAl .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-erTSP1ZsELgjAUAl .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-erTSP1ZsELgjAUAl .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-erTSP1ZsELgjAUAl .marker{fill:#333333;stroke:#333333;}#mermaid-svg-erTSP1ZsELgjAUAl .marker.cross{stroke:#333333;}#mermaid-svg-erTSP1ZsELgjAUAl svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-erTSP1ZsELgjAUAl p{margin:0;}#mermaid-svg-erTSP1ZsELgjAUAl .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-erTSP1ZsELgjAUAl .cluster-label text{fill:#333;}#mermaid-svg-erTSP1ZsELgjAUAl .cluster-label span{color:#333;}#mermaid-svg-erTSP1ZsELgjAUAl .cluster-label span p{background-color:transparent;}#mermaid-svg-erTSP1ZsELgjAUAl .label text,#mermaid-svg-erTSP1ZsELgjAUAl span{fill:#333;color:#333;}#mermaid-svg-erTSP1ZsELgjAUAl .node rect,#mermaid-svg-erTSP1ZsELgjAUAl .node circle,#mermaid-svg-erTSP1ZsELgjAUAl .node ellipse,#mermaid-svg-erTSP1ZsELgjAUAl .node polygon,#mermaid-svg-erTSP1ZsELgjAUAl .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-erTSP1ZsELgjAUAl .rough-node .label text,#mermaid-svg-erTSP1ZsELgjAUAl .node .label text,#mermaid-svg-erTSP1ZsELgjAUAl .image-shape .label,#mermaid-svg-erTSP1ZsELgjAUAl .icon-shape .label{text-anchor:middle;}#mermaid-svg-erTSP1ZsELgjAUAl .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-erTSP1ZsELgjAUAl .rough-node .label,#mermaid-svg-erTSP1ZsELgjAUAl .node .label,#mermaid-svg-erTSP1ZsELgjAUAl .image-shape .label,#mermaid-svg-erTSP1ZsELgjAUAl .icon-shape .label{text-align:center;}#mermaid-svg-erTSP1ZsELgjAUAl .node.clickable{cursor:pointer;}#mermaid-svg-erTSP1ZsELgjAUAl .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-erTSP1ZsELgjAUAl .arrowheadPath{fill:#333333;}#mermaid-svg-erTSP1ZsELgjAUAl .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-erTSP1ZsELgjAUAl .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-erTSP1ZsELgjAUAl .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-erTSP1ZsELgjAUAl .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-erTSP1ZsELgjAUAl .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-erTSP1ZsELgjAUAl .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-erTSP1ZsELgjAUAl .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-erTSP1ZsELgjAUAl .cluster text{fill:#333;}#mermaid-svg-erTSP1ZsELgjAUAl .cluster span{color:#333;}#mermaid-svg-erTSP1ZsELgjAUAl div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-erTSP1ZsELgjAUAl .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-erTSP1ZsELgjAUAl rect.text{fill:none;stroke-width:0;}#mermaid-svg-erTSP1ZsELgjAUAl .icon-shape,#mermaid-svg-erTSP1ZsELgjAUAl .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-erTSP1ZsELgjAUAl .icon-shape p,#mermaid-svg-erTSP1ZsELgjAUAl .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-erTSP1ZsELgjAUAl .icon-shape .label rect,#mermaid-svg-erTSP1ZsELgjAUAl .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-erTSP1ZsELgjAUAl .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-erTSP1ZsELgjAUAl .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-erTSP1ZsELgjAUAl :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 相似度超过阈值
命中
未命中
用户提问
把问题转成向量
在语义缓存中
检索相似问题
直接返回缓存答案
检索知识库
拼装 Prompt
调用 LLM 生成答案
把 问题向量 + 答案
写入语义缓存
返回答案给用户
代码上就是加一层包装:
java
import com.redis.vl.extensions.cache.CacheHit;
import com.redis.vl.extensions.cache.SemanticCache;

import java.util.List;

/**
 * 语义缓存示例
 * 对语义相近的问题直接复用历史答案,避免重复调用大模型
 */
public class SemanticCacheDemo {

    /** 语义缓存实例 */
    private final SemanticCache cache;

    /**
     * 构造方法:初始化语义缓存
     * distanceThreshold 为语义距离阈值,越小要求越相似才算命中
     * 0.1 ~ 0.2 是比较常用的区间,太大容易答非所问
     */
    public SemanticCacheDemo() {
        this.cache = SemanticCache.builder()
                .name("llm_cache")
                .redisUrl("redis://localhost:6379")
                .distanceThreshold(0.15)
                .ttl(3600)                  // 缓存有效期 1 小时
                .build();
    }

    /**
     * 带语义缓存的问答:先查缓存,未命中才调用大模型
     *
     * @param question 用户提出的问题
     * @return 问题对应的答案
     */
    public String ask(String question) {
        // 1. 先查语义缓存
        List<CacheHit> hits = cache.check(question, 1);
        if (!hits.isEmpty()) {
            System.out.println("缓存命中,省下一次 LLM 调用");
            return hits.get(0).getResponse();
        }

        // 2. 未命中则真正调用 LLM
        String answer = callLlm(question);

        // 3. 回写缓存,供后续语义相似的问题复用
        cache.store(question, answer);
        return answer;
    }

    /**
     * 调用大模型生成答案,实际项目中替换为你选用的模型接口
     *
     * @param question 用户问题
     * @return 模型返回的答案
     */
    private String callLlm(String question) {
        // TODO 接入 OpenAI、通义千问等大模型接口
        return "这里是大模型返回的答案";
    }

    /**
     * 主方法:演示缓存未命中与命中的两种情况
     *
     * @param args 启动参数,本示例未使用
     */
    public static void main(String[] args) {
        SemanticCacheDemo demo = new SemanticCacheDemo();
        demo.ask("Redis 怎么做向量检索?");      // 未命中,调用 LLM
        demo.ask("Redis 如何实现向量搜索?");    // 语义相近,直接命中缓存
    }
}
5.3 LangChain4j / Spring AI 集成
Redis 与主流的 AI 应用框架都做了深度集成。在 Java 生态里,LangChain4j 和 Spring AI 都把 Redis 作为官方支持的向量存储与对话记忆实现,它可以同时充当向量存储、语义缓存和对话历史持久化三种角色。
xml
<!-- pom.xml 引入 LangChain4j 的 Redis 集成 -->
<dependency>
    <groupId>dev.langchain4j</groupId>
    <artifactId>langchain4j-redis</artifactId>
    <version>0.36.0</version>
</dependency>
java
import dev.langchain4j.data.embedding.Embedding;
import dev.langchain4j.data.message.AiMessage;
import dev.langchain4j.data.message.ChatMessage;
import dev.langchain4j.data.message.UserMessage;
import dev.langchain4j.data.segment.TextSegment;
import dev.langchain4j.memory.chat.MessageWindowChatMemory;
import dev.langchain4j.model.embedding.EmbeddingModel;
import dev.langchain4j.model.openai.OpenAiEmbeddingModel;
import dev.langchain4j.store.embedding.redis.RedisEmbeddingStore;
import dev.langchain4j.store.memory.chat.redis.RedisChatMemoryStore;

import java.util.List;

/**
 * LangChain4j 与 Redis 的集成示例
 * 演示 Redis 同时承担向量存储与对话历史持久化两种角色
 */
public class LangChain4jRedisDemo {

    /** Redis 主机地址 */
    private static final String REDIS_HOST = "localhost";

    /** Redis 端口 */
    private static final int REDIS_PORT = 6379;

    /**
     * 主方法:演示两种角色的典型用法
     *
     * @param args 启动参数,本示例未使用
     */
    public static void main(String[] args) {
        // 角色一:向量存储(知识库检索)
        RedisEmbeddingStore embeddingStore = RedisEmbeddingStore.builder()
                .host(REDIS_HOST)
                .port(REDIS_PORT)
                .indexName("langchain_kb")
                .dimension(1536)                 // 向量维度需与 embedding 模型一致
                .build();

        EmbeddingModel embeddingModel = OpenAiEmbeddingModel.withApiKey("你的-API-KEY");

        // 把知识片段向量化后写入 Redis
        List<String> docs = List.of(
                "Redis 8.0 支持原生向量类型",
                "Iris 是面向智能体的上下文平台"
        );
        for (String doc : docs) {
            TextSegment segment = TextSegment.from(doc);
            Embedding embedding = embeddingModel.embed(segment).content();
            embeddingStore.add(embedding, segment);
        }

        // 角色二:对话历史持久化(服务重启也不丢)
        RedisChatMemoryStore memoryStore = RedisChatMemoryStore.builder()
                .host(REDIS_HOST)
                .port(REDIS_PORT)
                .ttl(86400L)                     // 会话保留 1 天
                .build();

        MessageWindowChatMemory memory = MessageWindowChatMemory.builder()
                .id("user:1001")                 // 按用户区分会话
                .maxMessages(20)                 // 最多保留最近 20 条消息
                .chatMemoryStore(memoryStore)
                .build();

        memory.add(UserMessage.from("介绍一下 Vector Set"));
        memory.add(AiMessage.from("Vector Set 是 Redis 8.0 引入的原生向量数据类型......"));

        for (ChatMessage message : memory.messages()) {
            System.out.println(message);
        }
    }
}
5.4 MCP 服务器:让 AI 助手直接操作 Redis
Redis 还提供了官方的 MCP(Model Context Protocol)服务器。配好之后,Claude 这类 AI 助手就能用自然语言直接跟你的 Redis 数据对话------"帮我看看有哪些 key 快过期了""把这个 Hash 的结构展示出来",不用手写命令。
json
{
  "mcpServers": {
    "redis": {
      "command": "docker",
      "args": [
        "run", "--rm", "-i",
        "-e", "REDIS_HOST=host.docker.internal",
        "-e", "REDIS_PORT=6379",
        "-e", "REDIS_PWD=123456",
        "mcp/redis"
      ]
    }
  }
}
此外,Redis 的 AI Incubator 还在持续放出一些实验性项目,比如把整个文件系统存进 Redis、为 Google ADK 和 Microsoft Agent Framework 提供集成支持等,虽然还带着实验性质,但方向很清楚。
六、一个完整的 RAG 请求长什么样
把上面这些能力串起来,一个生产级的 AI 应用请求链路大致是这样:
#mermaid-svg-39Y6pK4P5xyBIwya{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-39Y6pK4P5xyBIwya .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-39Y6pK4P5xyBIwya .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-39Y6pK4P5xyBIwya .error-icon{fill:#552222;}#mermaid-svg-39Y6pK4P5xyBIwya .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-39Y6pK4P5xyBIwya .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-39Y6pK4P5xyBIwya .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-39Y6pK4P5xyBIwya .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-39Y6pK4P5xyBIwya .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-39Y6pK4P5xyBIwya .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-39Y6pK4P5xyBIwya .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-39Y6pK4P5xyBIwya .marker{fill:#333333;stroke:#333333;}#mermaid-svg-39Y6pK4P5xyBIwya .marker.cross{stroke:#333333;}#mermaid-svg-39Y6pK4P5xyBIwya svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-39Y6pK4P5xyBIwya p{margin:0;}#mermaid-svg-39Y6pK4P5xyBIwya .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-39Y6pK4P5xyBIwya .cluster-label text{fill:#333;}#mermaid-svg-39Y6pK4P5xyBIwya .cluster-label span{color:#333;}#mermaid-svg-39Y6pK4P5xyBIwya .cluster-label span p{background-color:transparent;}#mermaid-svg-39Y6pK4P5xyBIwya .label text,#mermaid-svg-39Y6pK4P5xyBIwya span{fill:#333;color:#333;}#mermaid-svg-39Y6pK4P5xyBIwya .node rect,#mermaid-svg-39Y6pK4P5xyBIwya .node circle,#mermaid-svg-39Y6pK4P5xyBIwya .node ellipse,#mermaid-svg-39Y6pK4P5xyBIwya .node polygon,#mermaid-svg-39Y6pK4P5xyBIwya .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-39Y6pK4P5xyBIwya .rough-node .label text,#mermaid-svg-39Y6pK4P5xyBIwya .node .label text,#mermaid-svg-39Y6pK4P5xyBIwya .image-shape .label,#mermaid-svg-39Y6pK4P5xyBIwya .icon-shape .label{text-anchor:middle;}#mermaid-svg-39Y6pK4P5xyBIwya .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-39Y6pK4P5xyBIwya .rough-node .label,#mermaid-svg-39Y6pK4P5xyBIwya .node .label,#mermaid-svg-39Y6pK4P5xyBIwya .image-shape .label,#mermaid-svg-39Y6pK4P5xyBIwya .icon-shape .label{text-align:center;}#mermaid-svg-39Y6pK4P5xyBIwya .node.clickable{cursor:pointer;}#mermaid-svg-39Y6pK4P5xyBIwya .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-39Y6pK4P5xyBIwya .arrowheadPath{fill:#333333;}#mermaid-svg-39Y6pK4P5xyBIwya .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-39Y6pK4P5xyBIwya .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-39Y6pK4P5xyBIwya .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-39Y6pK4P5xyBIwya .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-39Y6pK4P5xyBIwya .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-39Y6pK4P5xyBIwya .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-39Y6pK4P5xyBIwya .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-39Y6pK4P5xyBIwya .cluster text{fill:#333;}#mermaid-svg-39Y6pK4P5xyBIwya .cluster span{color:#333;}#mermaid-svg-39Y6pK4P5xyBIwya div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-39Y6pK4P5xyBIwya .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-39Y6pK4P5xyBIwya rect.text{fill:none;stroke-width:0;}#mermaid-svg-39Y6pK4P5xyBIwya .icon-shape,#mermaid-svg-39Y6pK4P5xyBIwya .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-39Y6pK4P5xyBIwya .icon-shape p,#mermaid-svg-39Y6pK4P5xyBIwya .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-39Y6pK4P5xyBIwya .icon-shape .label rect,#mermaid-svg-39Y6pK4P5xyBIwya .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-39Y6pK4P5xyBIwya .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-39Y6pK4P5xyBIwya .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-39Y6pK4P5xyBIwya :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} Redis 统一承载
命中
未命中
用户
应用服务
语义缓存
LangCache
返回答案
读取智能体记忆
会话记忆 + 长期记忆
向量检索知识库
Vector Set / RediSearch
组装 Prompt
问题 + 记忆 + 知识
调用大模型
写回语义缓存
并更新长期记忆
注意虚线框圈起来的部分------语义缓存、智能体记忆、向量检索,全部落在同一个 Redis 里。
这正是 Redis 这次转身的核心逻辑:过去你可能需要 Pinecone 存向量、PostgreSQL 存会话、Redis 做缓存,三套系统三份运维成本,数据还要来回搬。现在这些活可以收敛到一个组件里,延迟统一在毫秒级,技术栈也简单了一大截。
七、写在最后
Redis 这次"接入 AI",说到底不是追热点贴标签,而是把自己一直以来的长处------低延迟、结构灵活、离业务最近------重新对准了 AI 应用的痛点。
几句话概括这次升级:
- 向量能力进内核:Vector Set 成为一等公民数据类型,RediSearch 整合进核心,不用再装模块;
- 量化省内存:Q8 约 4 倍压缩、BIN 最高 32 倍压缩,让大规模向量存储的成本变得可接受;
- Iris 管记忆:双层记忆架构 + 安全的数据获取工具 + 近实时数据同步,把 Agent 上下文这件事系统化了;
- 生态很齐全:RedisVL for Java、LangCache、LangChain4j / Spring AI 集成、MCP 服务器,接入成本很低。
对开发者来说,最实在的一点可能是:你不需要学一个全新的系统。还是那个 Redis,还是熟悉的连接方式和运维习惯,只是多了几个命令和几个库。
如果你手上正好有个 AI 项目在纠结向量库选型,不妨先看看已经跑在你集群里的那个 Redis------它可能已经能干这个活了。