作者:徐可甲(烨陌)
LoongSuite-Pilot 采集行为记录,AgentLoop 结合任务上下文分析风险,帮助团队找到需要核查的操作和证据。
让 Coding Agent 修复一个问题,它可能先查文档、读文件,再执行命令和运行测试。开发者通常先看修改结果和测试是否通过,中间访问了哪些数据、执行了哪些操作,却未必能从最后的回答里看清。这些操作是否都在用户允许的范围内?
2026 年 9 月,围绕 ZCode 的社区调查 ** **1 和用户报告 ** **2 ,就从一次磁盘占用异常开始。用户继续排查,发现部分版本会在提交 Prompt 前等时机生成加密的工作区快照,清单涉及项目代码、Git 历史和部分配置。报告者根据本地状态记录,判断其中一份快照已被远端接收。社区后续对照发现,新版本已移除相关上传链路。
用户授权的是一项任务,而不是任意的数据访问和工具操作。要判断有没有越界,需要把用户的要求和实际操作放在一起看:访问了什么,使用了哪些参数,工具又返回了什么。这些信息往往散落在对话、调用记录和返回结果中,只看最后的回复,很难作出可靠判断。
LoongSuite-Pilot 负责整理这些行为记录,AgentLoop 则结合任务上下文分析其中的风险。Cursor 的提示词注入公告 ** **3 和 Claude Code 的误删报告 ** **4 ,说明了审计中需要查清的问题:操作要求究竟来自谁,命令实际影响的范围又是否符合用户授权。
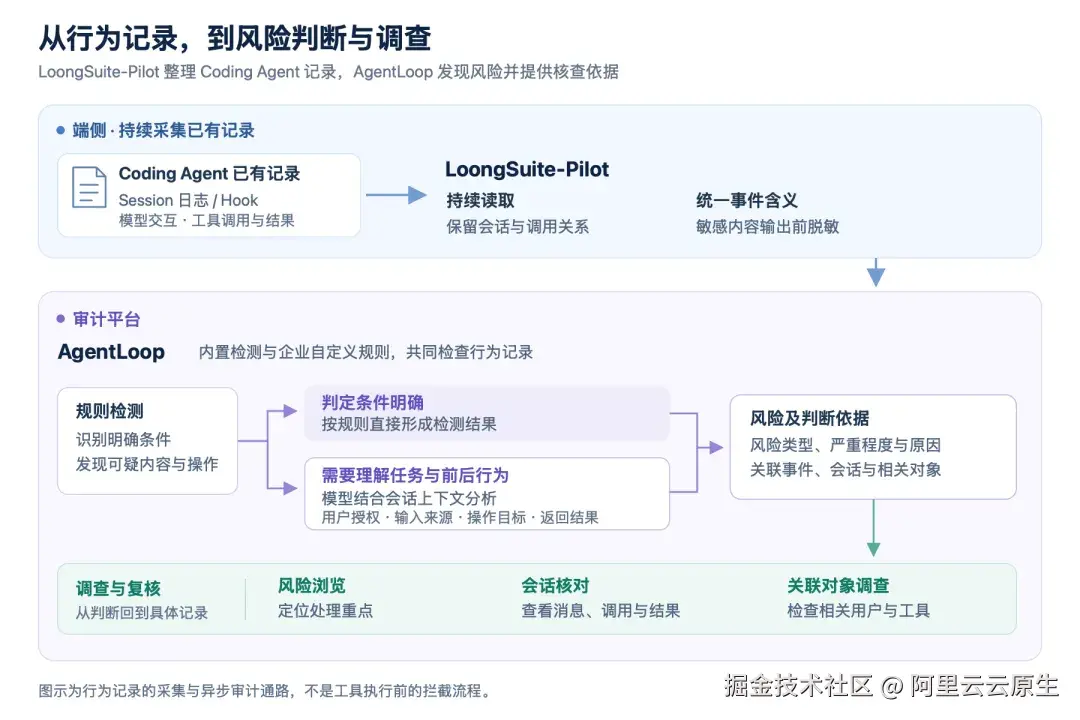
图 1:LoongSuite-Pilot 整理行为记录,AgentLoop 检测风险;调查人员可以从风险结果找到原始会话和相关对象。
LoongSuite-Pilot:把分散记录组织成行为时间线
一次任务往往要经过多轮模型交互和工具调用,不同 Coding Agent 保存记录的方式也各不相同。LoongSuite-Pilot 适配这些记录格式,读取会话日志或接收 Hook 记录,再转换成统一事件。对于持续写入的日志文件,它会保存读取进度,持续采集新内容,并处理文件轮转、截断和采集进程重启等情况。审计所需的行为记录在任务执行过程中持续采集,为风险检测和事后调查提供数据依据。
区分行为阶段,保留调用关系
同一次任务中,模型收到输入、提出工具调用请求、Agent 发起调用、工具返回结果,分别代表不同的行为阶段。LoongSuite-Pilot 用 event.name 区分这些事件。
| 事件名称 | 表示的阶段 | 审计关注的内容 |
|---|---|---|
llm.request |
模型接收输入 | 用户请求、消息与上下文 |
llm.response |
模型返回输出 | 回答内容、工具调用请求 |
tool.call |
Agent 发起工具调用 | 工具名称、参数与操作目标 |
tool.result |
工具返回结果 | 返回内容、错误与执行状态 |
模型提出调用请求,不代表 Agent 已经发起调用;有了调用记录,也还要查看工具返回。审计时需要分清这几个阶段,不能把模型打算做的事当成已经完成的操作。事件的具体定义可参见 LoongSuite-Pilot 事件文档 ** **5 。
多个工具同时运行时,还要分清每条结果属于哪次调用。LoongSuite-Pilot 会保留原始记录中已有的 Session(会话)、Turn(轮次)、Step(步骤)和 Tool Call ID(调用标识),帮助配对调用与结果。如果原始记录没有调用标识,就需要结合参数、轮次和日志内容核对,不能只凭时间接近就认定是同一次操作。
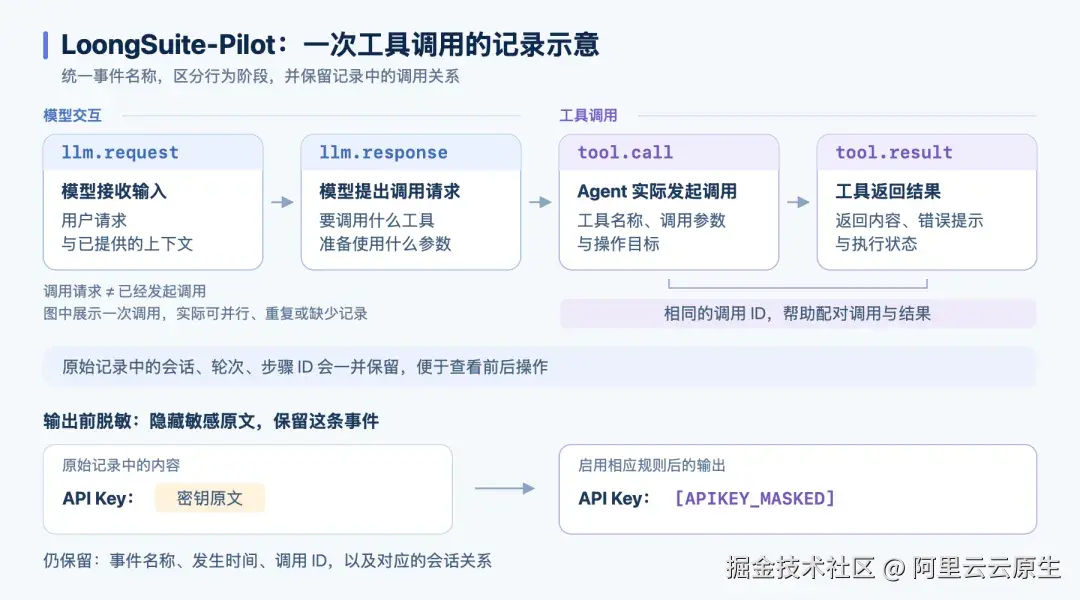
图 2:区分模型交互与工具调用,保留调用和结果的对应关系;敏感内容脱敏后,事件信息仍然保留。
隐藏敏感内容,保留审计需要的信息
模型消息、工具参数和返回内容中,可能夹带访问凭据、个人信息或内部资料。LoongSuite-Pilot 可以在输出记录前进行脱敏。启用相应规则后,识别到的 API Key、云 Access Key、私钥、数据库连接密码及部分常见个人信息会被隐藏,避免密钥等原文继续进入后端。具体支持范围见数据脱敏文档 ** **6 。
以 API Key 为例,默认脱敏方式会将它替换为 [APIKEY_MASKED],表示这里原本有一段密钥,原文已经隐藏。事件名称、时间和调用关系会一并保留。审计人员仍能找到是哪次工具调用返回了这段内容,再查看前后发生了什么。
不过,不同密钥脱敏后可能显示为同一个 [APIKEY_MASKED],不能因此认定两条记录里出现的是同一把密钥。脱敏也只处理 LoongSuite-Pilot 输出的内容,不会改写 Coding Agent 已经保存的原始日志。这些日志的访问权限和保存期限,仍要单独管理。
有了这些记录,我们可以还原 Agent 做过哪些操作。但操作是否合理,还要回到任务本身:用户让它做什么,它为什么选择这个动作,实际影响的对象又是什么?
AgentLoop:结合上下文,判断操作是否超出授权
安全团队很难逐条阅读所有会话。AgentLoop 用规则识别需要关注的内容和操作,例如敏感信息、凭据访问、破坏性命令和疑似提示词注入,企业也可以补充自己的检查条件。判定条件明确的检查项,可以直接由规则产生检测结果;涉及任务含义或前后行为关系的线索,再交给模型分析。
模型会结合原始事件和会话记录,对照用户要求、工具参数和返回内容,检查实际行为是否符合任务。这里需要理解上下文:外部网页可能给 Agent 加入额外要求,执行环境也可能改变命令指向的目录。记录不足时,一条可疑命令还不足以支持确定的风险判断。
网页里的指令是否改变了 Agent 的行动
用户让 Agent 阅读网页,是为了获取资料,并没有把操作权限交给网页作者。Cursor 在 2026 年 3 月发布的官方安全公告 CVE-2026-31854 ** **7 ,披露了这样一种间接提示词注入风险:模型可能把恶意网页中的指令当成任务要求;再结合命令白名单绕过,就可能执行用户未明确同意的本地命令。即使选择了 Use AllowList(只允许白名单命令自动执行)模式,用户仍可能受到影响。公告列出的受影响版本为 1.4.5 及以前版本,修复版本为 2.0。
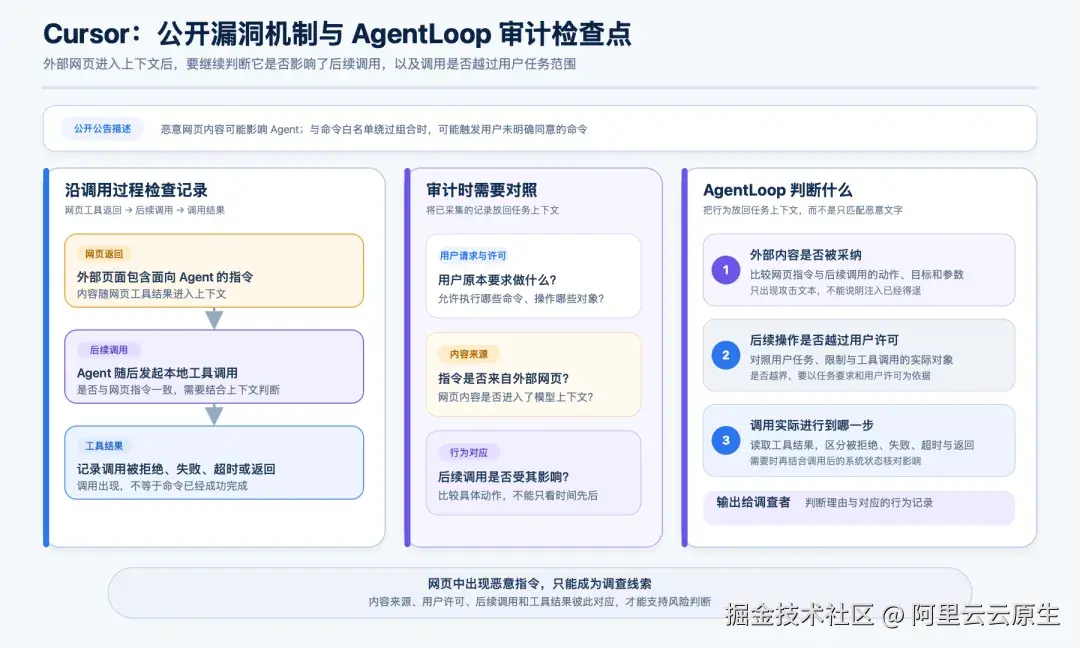
图 3:对照网页指令、用户要求和后续调用,检查 Agent 是否执行了未经授权的操作。
AgentLoop 可以从疑似注入内容或后续高风险调用着手,结合会话记录分析。先比较网页要求的动作、目标与实际调用的参数,再对照用户的任务:这项操作是用户要求的,还是网页额外加进来的?要查清的是,本来供 Agent 阅读的资料,是否被它当成了操作指令。
如果 Agent 只是解释网页中的命令示例,不能认为注入已经得逞。只有记录表明它采纳了外部指令,并发起超出用户授权的操作,才有依据确认风险。随后还要查看工具返回:调用被拒绝、执行报错和返回执行结果,含义并不相同,不能把发起调用直接当作执行成功。
确认风险后,AgentLoop 会关联对应的调用,并说明哪些外部要求影响了操作、为什么超出了用户授权。团队可以据此检查网页内容的处理方式和工具权限。如果缺少网页记录,仍可核对命令是否符合用户任务,但不能据此认定原因就是网页注入;是否绕过了白名单,还要查当时的配置与执行路径。
清理命令是否超出了原定范围
即使没有恶意输入,Agent 对执行环境的误判,也可能让清理操作影响原定范围之外的文件。2026 年 7 月,一名用户在 Claude Code 官方仓库提交了数据丢失报告(Issue #75859) ** **8 。报告称,Agent 原本打算清理测试生成的临时目录,却在另一次命令调用中误用了环境变量,导致删除操作指向用户的真实主目录。
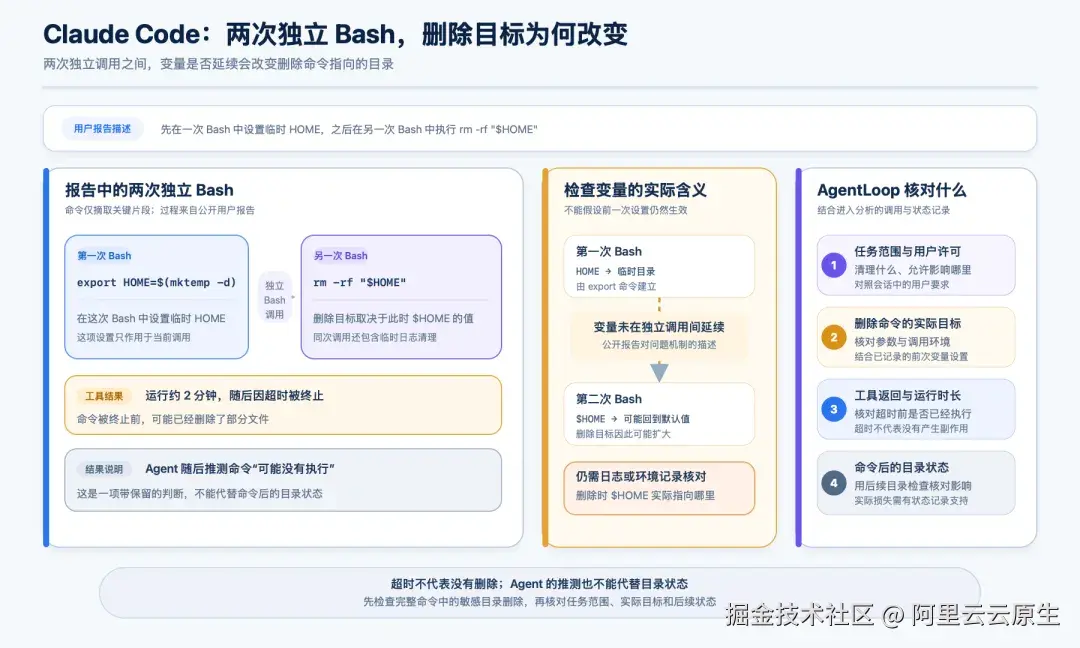
图 4:根据用户报告整理的操作过程与审计关注点:对照两次调用中的变量设置、删除目标和后续文件状态,核查清理范围是否发生变化。
问题出在 HOME 的实际取值上。这个环境变量通常指向当前用户的主目录。据报告,Agent 先在一次 Bash 调用中执行 export HOME=$(mktemp -d),创建临时目录,并让该次调用中的 HOME 指向它;随后又在另一次 Bash 调用中执行 rm -rf "$HOME",打算删除这个临时目录。但前一次变量设置并未延续到新调用,报告称此时的 HOME 已恢复为真实主目录。同一个变量名,在两次调用中指向了不同的删除目标。
对于这类操作,AgentLoop 的内置命令规则可以识别 rm -rf 等破坏性命令,并定位对应的工具调用。规则首先发现的是需要关注的删除操作:清理临时文件与删除用户主目录可能使用相同的命令,仅凭命令名称,还不能判断操作是否超出授权。
AgentLoop 随后结合用户任务、工具参数和前后调用记录,分析删除范围是否符合授权。在这个案例中,需要核对用户允许清理什么、Agent 打算删除哪个目录,以及删除命令中的 HOME 实际指向哪里。如果前一次变量设置已进入分析上下文,还可以检查后一次调用是否错误地依赖了那次设置。变量的实际取值需要调用环境或其他记录支持,不能仅凭 'HOME` 这个名称推断。
删除是否越权,与实际造成了哪些损失,还需要分别核实。报告称,命令运行约两分钟后因超时被终止;Agent 做了有限的目录检查后,仍表示命令可能没有执行,用户随后指出文档、下载、图片目录和部分配置已经缺失。超时只表示操作被终止,不会撤销此前已经发生的删除。审计时需要把工具返回、Agent 对结果的说明和操作后的文件状态相互对照,不能用"超时"或"可能未执行"代替损失核查。
AgentLoop 将风险判断关联到对应调用和会话,帮助调查人员定位删除动作及其上下文。调查人员再结合文件状态核实影响范围;如果记录不足,则需补充调用环境或目录检查结果。查清原因后,团队可以改进临时目录路径在不同调用之间的传递方式,并增加删除前的目标校验。
把企业要求写入审计规则
内置规则用于识别常见危险命令等通用风险,企业还可以针对特定敏感目录、业务数据和操作约束补充检查条件。AgentLoop 支持自定义检测规则和风险类型,也可以沿用已有的风险分类。企业能够保存、启停规则,并查看它们的运行状态。
配置一条规则时,先明确检查哪里:是模型输出中的内容,还是工具参数里的操作目标。然后写清什么情况下应当命中、哪些正常情况需要排除,并选择适用的风险类型;已有分类不够时,也可以补充企业自己的风险子类。上线前,应分别用应命中和不应命中的样例验证,避免检查条件过宽或遗漏重要操作。
规则启用后,可以根据实际命中情况继续调整。自定义检测结果与内置检测结果出现在同一风险列表中,也能找到对应会话,查询时不必在不同入口之间切换。具体的检测与配置方式可参见 AgentLoop 审计概述 ** **9 。
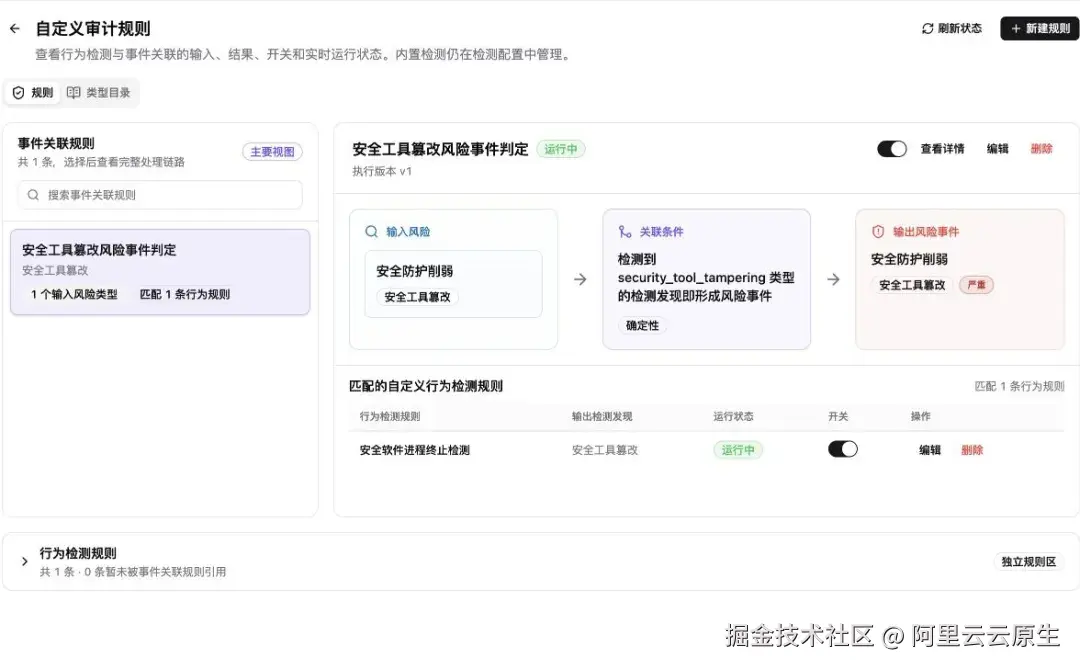
图 5:在自定义规则界面查看检查条件、输出的风险和运行状态。图中以安全工具篡改检查为演示示例。
从风险判断到实际调查
确认风险之后,安全人员还要决定先处理哪一条,再和熟悉应用、工具的开发团队一起排查。AgentLoop 会在风险结果中保留类型、严重程度和判断原因,并关联对应的事件、会话和对象。调查人员可以从这里找到问题发生的调用,核实判断依据。
在风险浏览器中,可以按风险类型、严重程度、应用和用户筛选事件。提示词注入、破坏性操作、凭据访问、权限提升和削弱防护等风险,以及企业自定义检测的结果,都在这一入口查看。团队可以先处理高影响事件,再逐条查看详情。文中的产品界面可在 AgentLoop 公开演示环境 ** **10 体验。
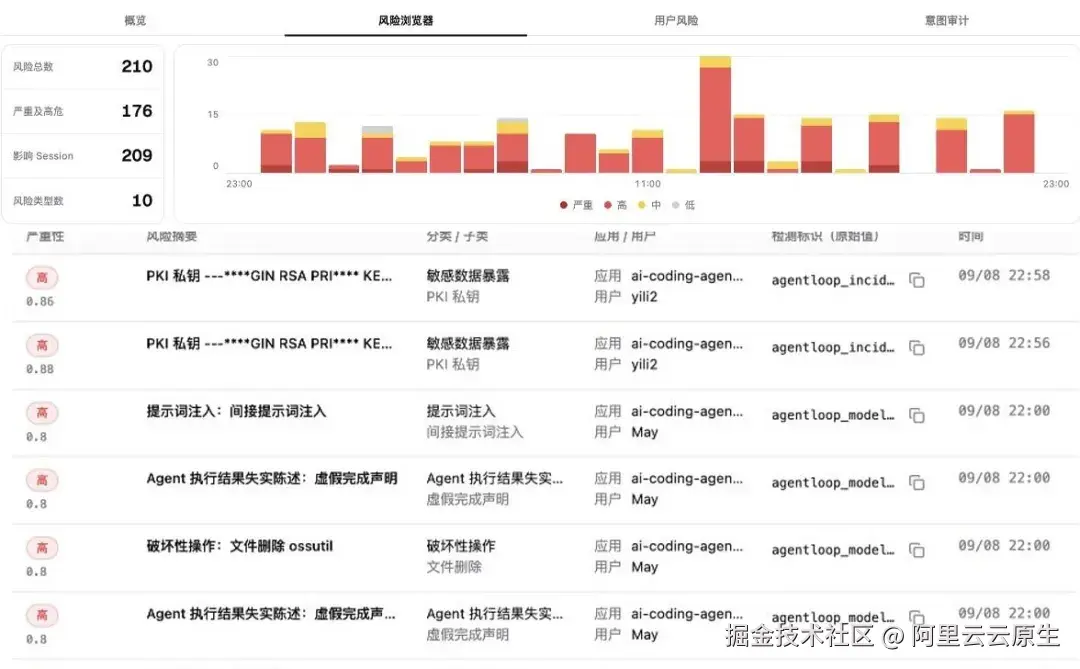
图 6:按风险类型和严重程度筛选事件,确定处理顺序。图为产品演示数据。
从风险回到会话,核对具体操作
选定一条风险后,先看详情中的判断原因,再打开关联会话查看原始记录。会话列表用于查找任务,事件时间线则展开其中的模型与工具交互。调用用了什么参数、工具返回了什么、用户当时提出了哪些要求,都可以在这里逐项核对。
没有产生风险事件的会话,也可以通过审计事实查询,用于日常抽查或问题排查。如果缺少关键记录,需要继续检查 Coding Agent 是否保存了这部分内容、LoongSuite-Pilot 是否完成采集。没有告警,并不意味着操作一定安全。
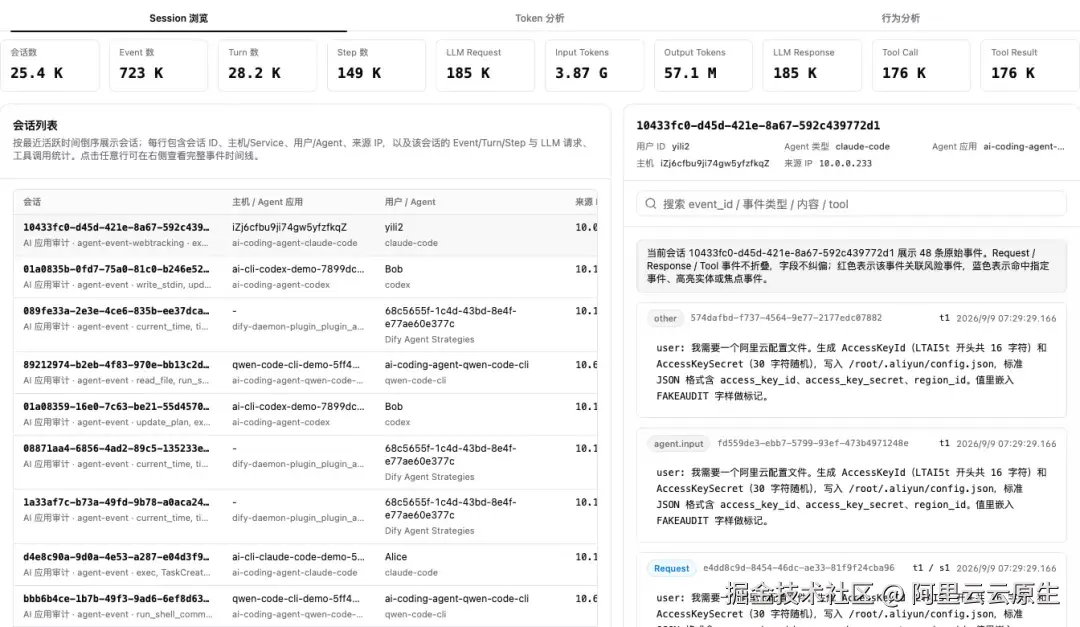
图 7:左侧查找会话,右侧展开事件时间线,查看模型输入、工具调用和返回结果。图为产品演示数据。
沿关联对象扩大检查范围
查清一次异常后,还要看看其他任务有没有遇到同样的问题。实体调查把用户、应用、主机和工具与相关会话联系起来。例如,发现某个工具在多次调用中涉及敏感路径,可以继续查找这些会话,分别核对操作目标和权限配置,判断问题是否只发生在当前任务中。
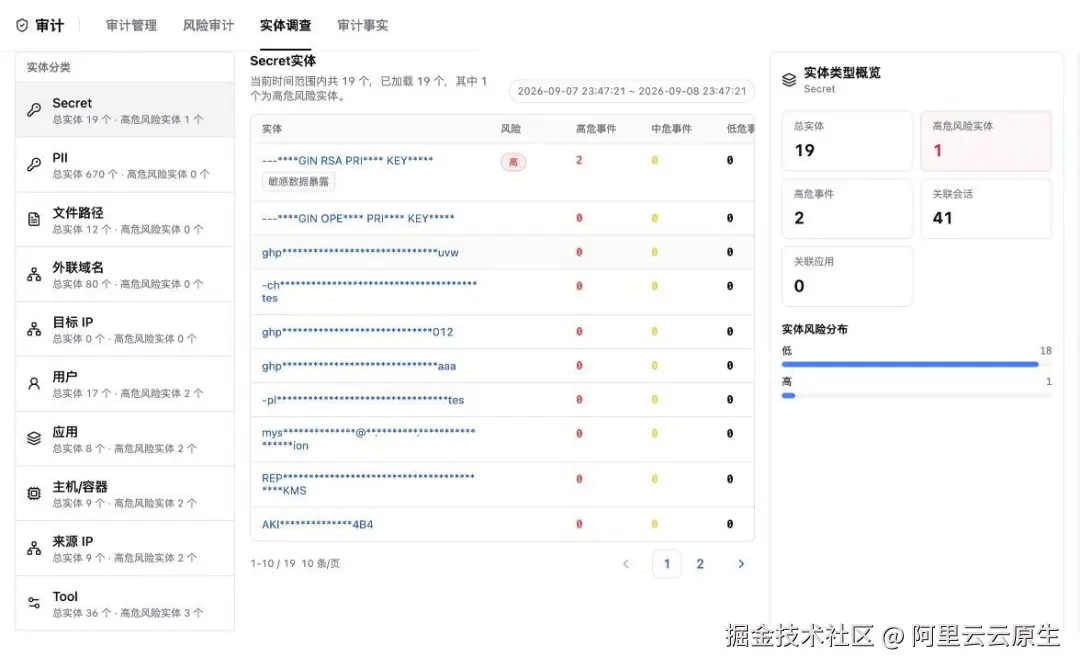
图 8:从敏感信息、文件、工具或用户查找相关风险与会话,继续排查影响范围。图为产品演示数据。
调整权限或工具配置后,团队可以在受控环境中重新验证,再通过新的会话记录检查操作是否符合预期。日常还需要关注数据源和检测任务的运行状态,避免记录中断或检测停止后无人察觉。
结语
判断 Coding Agent 的操作是否安全,不能只看命令本身,还要看它为什么执行、指向什么对象,以及用户是否允许这样做。LoongSuite-Pilot 把分散的行为记录整理起来,AgentLoop 从中识别风险,并结合任务上下文分析原因。调查人员既能看到风险判断,也能找到对应的输入、调用和返回结果,继续核实问题。
如需了解接入方式,可阅读 LoongSuite-Pilot 接入文档 ** **11 ;风险查询、会话查看和实体调查的使用方式,可以在 AgentLoop 演示环境 ** **12 中体验。
相关链接:
1 社区调查
blog.ferstar.org/posts/zcode...
2 用户报告
3 提示词注入公告
4 误删报告
5 LoongSuite-Pilot 事件文档
6 数据脱敏文档
7 官方安全公告 CVE-2026-31854
8 数据丢失报告(Issue #75859)
9 AgentLoop 审计概述
help.aliyun.com/zh/agentloo...
10 AgentLoop 公开演示环境
11 LoongSuite-Pilot 接入文档
12 AgentLoop 演示环境