摘要
AI Agent 的记忆系统是决定其智能水平的核心基础设施。本文从人类认知科学的双系统理论出发,系统性地拆解 Agent 记忆的分层架构------工作记忆、会话记忆、长期记忆三层体系。深入探讨每层的设计原理、工程实现与取舍策略:工作记忆管理当前推理上下文,受限于 LLM 上下文窗口;会话记忆实现跨轮对话状态保持,需在完整性与 token 效率之间平衡;长期记忆基于向量数据库与知识图谱,解决知识持久化与精准检索问题。文章包含完整的 Python 实现代码、Mermaid 架构图、检索策略对比分析,以及"遗忘机制"这一被多数教程忽略的关键话题。适合正在构建 AI Agent 系统的工程师与架构师阅读。
📌 版本声明:本文基于 Python 3.11 + LangChain 0.3.x + ChromaDB 0.5.x 编写,涉及向量数据库与 LLM API 的部分以 2024-2025 年的主流方案为准。记忆系统的架构设计原则不依赖具体框架版本,但代码实现会随依赖库升级而变化,请以官方文档为准。
文章目录
-
- 摘要
- 一、为什么Agent需要记忆系统:人类认知系统的启示
-
- [1.1 从人类记忆说起](#1.1 从人类记忆说起)
- [1.2 LLM 的"记忆困境"](#1.2 LLM 的"记忆困境")
- [1.3 记忆系统的设计目标](#1.3 记忆系统的设计目标)
- 二、工作记忆:当前推理上下文的管理
-
- [2.1 工作记忆的本质](#2.1 工作记忆的本质)
- [2.2 上下文窗口管理策略](#2.2 上下文窗口管理策略)
- [2.3 "中间遗忘"问题与缓解](#2.3 "中间遗忘"问题与缓解)
- 三、会话记忆:跨轮对话的状态保持
-
- [3.1 会话记忆的定位](#3.1 会话记忆的定位)
- [3.2 会话状态的结构化设计](#3.2 会话状态的结构化设计)
- [3.3 会话摘要的生成时机](#3.3 会话摘要的生成时机)
- 四、长期记忆:向量数据库+知识图谱的设计
-
- [4.1 长期记忆的核心挑战](#4.1 长期记忆的核心挑战)
- [4.2 向量数据库方案](#4.2 向量数据库方案)
- [4.3 知识图谱增强](#4.3 知识图谱增强)
- [4.4 向量+图谱的混合检索](#4.4 向量+图谱的混合检索)
- 五、记忆的写入策略:什么该记住、什么该遗忘
-
- [5.1 写入决策的必要性](#5.1 写入决策的必要性)
- [5.2 记忆重要性评估模型](#5.2 记忆重要性评估模型)
- [5.3 主动遗忘机制](#5.3 主动遗忘机制)
- 六、记忆的检索策略:什么时候检索、检索什么
-
- [6.1 检索时机决策](#6.1 检索时机决策)
- [6.2 检索查询的构造](#6.2 检索查询的构造)
- [6.3 检索结果的重排序](#6.3 检索结果的重排序)
- 七、实战:一个完整的三层记忆系统实现
-
- [7.1 系统架构总览](#7.1 系统架构总览)
- [7.2 完整系统集成](#7.2 完整系统集成)
- [7.3 使用示例与效果分析](#7.3 使用示例与效果分析)
- 八、适用边界与风险提示
-
- [8.1 适用场景](#8.1 适用场景)
- [8.2 不适用场景与局限性](#8.2 不适用场景与局限性)
- [8.3 性能与成本考量](#8.3 性能与成本考量)
- 九、总结
- 参考资料
一、为什么Agent需要记忆系统:人类认知系统的启示
1.1 从人类记忆说起
想象你在参加一场技术面试。面试官问了你上周做的一个项目细节,你能够回忆起架构设计、技术选型的理由,甚至遇到的一个棘手 bug 的排查过程。但如果面试官问你三个月前某次会议中讨论的某个接口参数,你可能只能记个大概,甚至完全忘记。
这不是 bug,这是特性。
人类的大脑经过数百万年的进化,形成了一套精妙的记忆分级系统。诺贝尔经济学奖得主 Daniel Kahneman 在《思考,快与慢》中提出了著名的双系统理论:系统1 (快思考)依赖直觉和短期记忆,毫秒级响应;系统2(慢思考)调用长期记忆和深度推理,需要意识参与。
💡 关键洞察 :人类不是"记住所有东西然后完美检索",而是分层存储、按需检索、主动遗忘。这正是 AI Agent 记忆系统应该学习的地方。
认知科学将人类记忆分为三个核心层次:
| 记忆类型 | 容量 | 持续时间 | 功能类比 |
|---|---|---|---|
| 感觉记忆 | 极大 | <1秒 | Agent 接收的原始输入流 |
| 短期记忆(工作记忆) | 7±2 个信息块 | 15-30秒 | LLM 上下文窗口 |
| 长期记忆 | 理论上无限 | 数天到终生 | 向量数据库 + 知识图谱 |
人类记忆的一个关键特征是遗忘。我们每天接收海量信息,但绝大部分被自动丢弃。只有被反复回忆或具有强烈情感关联的信息才会被固化到长期记忆中。这个机制看似缺陷,实则是认知效率的核心保障------如果什么都记住,检索就成了灾难。
1.2 LLM 的"记忆困境"
当前主流 LLM 面临的记忆困境可以概括为三个矛盾:
矛盾一:上下文窗口有限 vs 对话历史无限增长
即使 GPT-4 支持 128K token 的上下文窗口,一个持续运行一天的客服 Agent 产生的对话量也远远超过这个限制。更关键的是,上下文窗口内的信息并非"平等可访问"------研究表明,LLM 对上下文中间部分的信息存在"中间遗忘"(lost in the middle)现象,检索精度显著下降。
矛盾二:即时记忆强 vs 跨会话记忆弱
LLM 在当前对话中表现出色,能够精确引用几轮之前的信息。但一旦会话结束,所有上下文清零。下次对话时,它完全不记得你是谁、之前讨论过什么。这在 ChatGPT 早期版本中是用户最常吐槽的问题。
矛盾三:知识广 vs 个性记忆缺失
LLM 通过预训练掌握了海量世界知识,但对特定用户的偏好、历史交互、个性化信息完全没有记忆。一个真正有用的 Agent 应该知道"这个用户喜欢简洁回答""上次讨论中我们决定用方案B"这类上下文信息。
1.3 记忆系统的设计目标
基于以上分析,一个完善的 Agent 记忆系统需要实现以下目标:
#mermaid-svg-J3SK3zntHZsSDuWR{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-J3SK3zntHZsSDuWR .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-J3SK3zntHZsSDuWR .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-J3SK3zntHZsSDuWR .error-icon{fill:#552222;}#mermaid-svg-J3SK3zntHZsSDuWR .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-J3SK3zntHZsSDuWR .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-J3SK3zntHZsSDuWR .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-J3SK3zntHZsSDuWR .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-J3SK3zntHZsSDuWR .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-J3SK3zntHZsSDuWR .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-J3SK3zntHZsSDuWR .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-J3SK3zntHZsSDuWR .marker{fill:#333333;stroke:#333333;}#mermaid-svg-J3SK3zntHZsSDuWR .marker.cross{stroke:#333333;}#mermaid-svg-J3SK3zntHZsSDuWR svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-J3SK3zntHZsSDuWR p{margin:0;}#mermaid-svg-J3SK3zntHZsSDuWR .edge{stroke-width:3;}#mermaid-svg-J3SK3zntHZsSDuWR .section--1 rect,#mermaid-svg-J3SK3zntHZsSDuWR .section--1 path,#mermaid-svg-J3SK3zntHZsSDuWR .section--1 circle,#mermaid-svg-J3SK3zntHZsSDuWR .section--1 polygon,#mermaid-svg-J3SK3zntHZsSDuWR .section--1 path{fill:hsl(240, 100%, 76.2745098039%);}#mermaid-svg-J3SK3zntHZsSDuWR .section--1 text{fill:#ffffff;}#mermaid-svg-J3SK3zntHZsSDuWR .node-icon--1{font-size:40px;color:#ffffff;}#mermaid-svg-J3SK3zntHZsSDuWR .section-edge--1{stroke:hsl(240, 100%, 76.2745098039%);}#mermaid-svg-J3SK3zntHZsSDuWR .edge-depth--1{stroke-width:17;}#mermaid-svg-J3SK3zntHZsSDuWR .section--1 line{stroke:hsl(60, 100%, 86.2745098039%);stroke-width:3;}#mermaid-svg-J3SK3zntHZsSDuWR .disabled,#mermaid-svg-J3SK3zntHZsSDuWR .disabled circle,#mermaid-svg-J3SK3zntHZsSDuWR .disabled text{fill:lightgray;}#mermaid-svg-J3SK3zntHZsSDuWR .disabled text{fill:#efefef;}#mermaid-svg-J3SK3zntHZsSDuWR .section-0 rect,#mermaid-svg-J3SK3zntHZsSDuWR .section-0 path,#mermaid-svg-J3SK3zntHZsSDuWR .section-0 circle,#mermaid-svg-J3SK3zntHZsSDuWR .section-0 polygon,#mermaid-svg-J3SK3zntHZsSDuWR .section-0 path{fill:hsl(60, 100%, 73.5294117647%);}#mermaid-svg-J3SK3zntHZsSDuWR .section-0 text{fill:black;}#mermaid-svg-J3SK3zntHZsSDuWR .node-icon-0{font-size:40px;color:black;}#mermaid-svg-J3SK3zntHZsSDuWR .section-edge-0{stroke:hsl(60, 100%, 73.5294117647%);}#mermaid-svg-J3SK3zntHZsSDuWR .edge-depth-0{stroke-width:14;}#mermaid-svg-J3SK3zntHZsSDuWR .section-0 line{stroke:hsl(240, 100%, 83.5294117647%);stroke-width:3;}#mermaid-svg-J3SK3zntHZsSDuWR .disabled,#mermaid-svg-J3SK3zntHZsSDuWR .disabled circle,#mermaid-svg-J3SK3zntHZsSDuWR .disabled text{fill:lightgray;}#mermaid-svg-J3SK3zntHZsSDuWR .disabled text{fill:#efefef;}#mermaid-svg-J3SK3zntHZsSDuWR .section-1 rect,#mermaid-svg-J3SK3zntHZsSDuWR .section-1 path,#mermaid-svg-J3SK3zntHZsSDuWR .section-1 circle,#mermaid-svg-J3SK3zntHZsSDuWR .section-1 polygon,#mermaid-svg-J3SK3zntHZsSDuWR .section-1 path{fill:hsl(80, 100%, 76.2745098039%);}#mermaid-svg-J3SK3zntHZsSDuWR .section-1 text{fill:black;}#mermaid-svg-J3SK3zntHZsSDuWR .node-icon-1{font-size:40px;color:black;}#mermaid-svg-J3SK3zntHZsSDuWR .section-edge-1{stroke:hsl(80, 100%, 76.2745098039%);}#mermaid-svg-J3SK3zntHZsSDuWR .edge-depth-1{stroke-width:11;}#mermaid-svg-J3SK3zntHZsSDuWR .section-1 line{stroke:hsl(260, 100%, 86.2745098039%);stroke-width:3;}#mermaid-svg-J3SK3zntHZsSDuWR .disabled,#mermaid-svg-J3SK3zntHZsSDuWR .disabled circle,#mermaid-svg-J3SK3zntHZsSDuWR .disabled text{fill:lightgray;}#mermaid-svg-J3SK3zntHZsSDuWR .disabled text{fill:#efefef;}#mermaid-svg-J3SK3zntHZsSDuWR .section-2 rect,#mermaid-svg-J3SK3zntHZsSDuWR .section-2 path,#mermaid-svg-J3SK3zntHZsSDuWR .section-2 circle,#mermaid-svg-J3SK3zntHZsSDuWR .section-2 polygon,#mermaid-svg-J3SK3zntHZsSDuWR .section-2 path{fill:hsl(270, 100%, 76.2745098039%);}#mermaid-svg-J3SK3zntHZsSDuWR .section-2 text{fill:#ffffff;}#mermaid-svg-J3SK3zntHZsSDuWR .node-icon-2{font-size:40px;color:#ffffff;}#mermaid-svg-J3SK3zntHZsSDuWR .section-edge-2{stroke:hsl(270, 100%, 76.2745098039%);}#mermaid-svg-J3SK3zntHZsSDuWR .edge-depth-2{stroke-width:8;}#mermaid-svg-J3SK3zntHZsSDuWR .section-2 line{stroke:hsl(90, 100%, 86.2745098039%);stroke-width:3;}#mermaid-svg-J3SK3zntHZsSDuWR .disabled,#mermaid-svg-J3SK3zntHZsSDuWR .disabled circle,#mermaid-svg-J3SK3zntHZsSDuWR .disabled text{fill:lightgray;}#mermaid-svg-J3SK3zntHZsSDuWR .disabled text{fill:#efefef;}#mermaid-svg-J3SK3zntHZsSDuWR .section-3 rect,#mermaid-svg-J3SK3zntHZsSDuWR .section-3 path,#mermaid-svg-J3SK3zntHZsSDuWR .section-3 circle,#mermaid-svg-J3SK3zntHZsSDuWR .section-3 polygon,#mermaid-svg-J3SK3zntHZsSDuWR .section-3 path{fill:hsl(300, 100%, 76.2745098039%);}#mermaid-svg-J3SK3zntHZsSDuWR .section-3 text{fill:black;}#mermaid-svg-J3SK3zntHZsSDuWR .node-icon-3{font-size:40px;color:black;}#mermaid-svg-J3SK3zntHZsSDuWR .section-edge-3{stroke:hsl(300, 100%, 76.2745098039%);}#mermaid-svg-J3SK3zntHZsSDuWR .edge-depth-3{stroke-width:5;}#mermaid-svg-J3SK3zntHZsSDuWR .section-3 line{stroke:hsl(120, 100%, 86.2745098039%);stroke-width:3;}#mermaid-svg-J3SK3zntHZsSDuWR .disabled,#mermaid-svg-J3SK3zntHZsSDuWR .disabled circle,#mermaid-svg-J3SK3zntHZsSDuWR .disabled text{fill:lightgray;}#mermaid-svg-J3SK3zntHZsSDuWR .disabled text{fill:#efefef;}#mermaid-svg-J3SK3zntHZsSDuWR .section-4 rect,#mermaid-svg-J3SK3zntHZsSDuWR .section-4 path,#mermaid-svg-J3SK3zntHZsSDuWR .section-4 circle,#mermaid-svg-J3SK3zntHZsSDuWR .section-4 polygon,#mermaid-svg-J3SK3zntHZsSDuWR .section-4 path{fill:hsl(330, 100%, 76.2745098039%);}#mermaid-svg-J3SK3zntHZsSDuWR .section-4 text{fill:black;}#mermaid-svg-J3SK3zntHZsSDuWR .node-icon-4{font-size:40px;color:black;}#mermaid-svg-J3SK3zntHZsSDuWR .section-edge-4{stroke:hsl(330, 100%, 76.2745098039%);}#mermaid-svg-J3SK3zntHZsSDuWR .edge-depth-4{stroke-width:2;}#mermaid-svg-J3SK3zntHZsSDuWR .section-4 line{stroke:hsl(150, 100%, 86.2745098039%);stroke-width:3;}#mermaid-svg-J3SK3zntHZsSDuWR .disabled,#mermaid-svg-J3SK3zntHZsSDuWR .disabled circle,#mermaid-svg-J3SK3zntHZsSDuWR .disabled text{fill:lightgray;}#mermaid-svg-J3SK3zntHZsSDuWR .disabled text{fill:#efefef;}#mermaid-svg-J3SK3zntHZsSDuWR .section-5 rect,#mermaid-svg-J3SK3zntHZsSDuWR .section-5 path,#mermaid-svg-J3SK3zntHZsSDuWR .section-5 circle,#mermaid-svg-J3SK3zntHZsSDuWR .section-5 polygon,#mermaid-svg-J3SK3zntHZsSDuWR .section-5 path{fill:hsl(0, 100%, 76.2745098039%);}#mermaid-svg-J3SK3zntHZsSDuWR .section-5 text{fill:black;}#mermaid-svg-J3SK3zntHZsSDuWR .node-icon-5{font-size:40px;color:black;}#mermaid-svg-J3SK3zntHZsSDuWR .section-edge-5{stroke:hsl(0, 100%, 76.2745098039%);}#mermaid-svg-J3SK3zntHZsSDuWR .edge-depth-5{stroke-width:-1;}#mermaid-svg-J3SK3zntHZsSDuWR .section-5 line{stroke:hsl(180, 100%, 86.2745098039%);stroke-width:3;}#mermaid-svg-J3SK3zntHZsSDuWR .disabled,#mermaid-svg-J3SK3zntHZsSDuWR .disabled circle,#mermaid-svg-J3SK3zntHZsSDuWR .disabled text{fill:lightgray;}#mermaid-svg-J3SK3zntHZsSDuWR .disabled text{fill:#efefef;}#mermaid-svg-J3SK3zntHZsSDuWR .section-6 rect,#mermaid-svg-J3SK3zntHZsSDuWR .section-6 path,#mermaid-svg-J3SK3zntHZsSDuWR .section-6 circle,#mermaid-svg-J3SK3zntHZsSDuWR .section-6 polygon,#mermaid-svg-J3SK3zntHZsSDuWR .section-6 path{fill:hsl(30, 100%, 76.2745098039%);}#mermaid-svg-J3SK3zntHZsSDuWR .section-6 text{fill:black;}#mermaid-svg-J3SK3zntHZsSDuWR .node-icon-6{font-size:40px;color:black;}#mermaid-svg-J3SK3zntHZsSDuWR .section-edge-6{stroke:hsl(30, 100%, 76.2745098039%);}#mermaid-svg-J3SK3zntHZsSDuWR .edge-depth-6{stroke-width:-4;}#mermaid-svg-J3SK3zntHZsSDuWR .section-6 line{stroke:hsl(210, 100%, 86.2745098039%);stroke-width:3;}#mermaid-svg-J3SK3zntHZsSDuWR .disabled,#mermaid-svg-J3SK3zntHZsSDuWR .disabled circle,#mermaid-svg-J3SK3zntHZsSDuWR .disabled text{fill:lightgray;}#mermaid-svg-J3SK3zntHZsSDuWR .disabled text{fill:#efefef;}#mermaid-svg-J3SK3zntHZsSDuWR .section-7 rect,#mermaid-svg-J3SK3zntHZsSDuWR .section-7 path,#mermaid-svg-J3SK3zntHZsSDuWR .section-7 circle,#mermaid-svg-J3SK3zntHZsSDuWR .section-7 polygon,#mermaid-svg-J3SK3zntHZsSDuWR .section-7 path{fill:hsl(90, 100%, 76.2745098039%);}#mermaid-svg-J3SK3zntHZsSDuWR .section-7 text{fill:black;}#mermaid-svg-J3SK3zntHZsSDuWR .node-icon-7{font-size:40px;color:black;}#mermaid-svg-J3SK3zntHZsSDuWR .section-edge-7{stroke:hsl(90, 100%, 76.2745098039%);}#mermaid-svg-J3SK3zntHZsSDuWR .edge-depth-7{stroke-width:-7;}#mermaid-svg-J3SK3zntHZsSDuWR .section-7 line{stroke:hsl(270, 100%, 86.2745098039%);stroke-width:3;}#mermaid-svg-J3SK3zntHZsSDuWR .disabled,#mermaid-svg-J3SK3zntHZsSDuWR .disabled circle,#mermaid-svg-J3SK3zntHZsSDuWR .disabled text{fill:lightgray;}#mermaid-svg-J3SK3zntHZsSDuWR .disabled text{fill:#efefef;}#mermaid-svg-J3SK3zntHZsSDuWR .section-8 rect,#mermaid-svg-J3SK3zntHZsSDuWR .section-8 path,#mermaid-svg-J3SK3zntHZsSDuWR .section-8 circle,#mermaid-svg-J3SK3zntHZsSDuWR .section-8 polygon,#mermaid-svg-J3SK3zntHZsSDuWR .section-8 path{fill:hsl(150, 100%, 76.2745098039%);}#mermaid-svg-J3SK3zntHZsSDuWR .section-8 text{fill:black;}#mermaid-svg-J3SK3zntHZsSDuWR .node-icon-8{font-size:40px;color:black;}#mermaid-svg-J3SK3zntHZsSDuWR .section-edge-8{stroke:hsl(150, 100%, 76.2745098039%);}#mermaid-svg-J3SK3zntHZsSDuWR .edge-depth-8{stroke-width:-10;}#mermaid-svg-J3SK3zntHZsSDuWR .section-8 line{stroke:hsl(330, 100%, 86.2745098039%);stroke-width:3;}#mermaid-svg-J3SK3zntHZsSDuWR .disabled,#mermaid-svg-J3SK3zntHZsSDuWR .disabled circle,#mermaid-svg-J3SK3zntHZsSDuWR .disabled text{fill:lightgray;}#mermaid-svg-J3SK3zntHZsSDuWR .disabled text{fill:#efefef;}#mermaid-svg-J3SK3zntHZsSDuWR .section-9 rect,#mermaid-svg-J3SK3zntHZsSDuWR .section-9 path,#mermaid-svg-J3SK3zntHZsSDuWR .section-9 circle,#mermaid-svg-J3SK3zntHZsSDuWR .section-9 polygon,#mermaid-svg-J3SK3zntHZsSDuWR .section-9 path{fill:hsl(180, 100%, 76.2745098039%);}#mermaid-svg-J3SK3zntHZsSDuWR .section-9 text{fill:black;}#mermaid-svg-J3SK3zntHZsSDuWR .node-icon-9{font-size:40px;color:black;}#mermaid-svg-J3SK3zntHZsSDuWR .section-edge-9{stroke:hsl(180, 100%, 76.2745098039%);}#mermaid-svg-J3SK3zntHZsSDuWR .edge-depth-9{stroke-width:-13;}#mermaid-svg-J3SK3zntHZsSDuWR .section-9 line{stroke:hsl(0, 100%, 86.2745098039%);stroke-width:3;}#mermaid-svg-J3SK3zntHZsSDuWR .disabled,#mermaid-svg-J3SK3zntHZsSDuWR .disabled circle,#mermaid-svg-J3SK3zntHZsSDuWR .disabled text{fill:lightgray;}#mermaid-svg-J3SK3zntHZsSDuWR .disabled text{fill:#efefef;}#mermaid-svg-J3SK3zntHZsSDuWR .section-10 rect,#mermaid-svg-J3SK3zntHZsSDuWR .section-10 path,#mermaid-svg-J3SK3zntHZsSDuWR .section-10 circle,#mermaid-svg-J3SK3zntHZsSDuWR .section-10 polygon,#mermaid-svg-J3SK3zntHZsSDuWR .section-10 path{fill:hsl(210, 100%, 76.2745098039%);}#mermaid-svg-J3SK3zntHZsSDuWR .section-10 text{fill:black;}#mermaid-svg-J3SK3zntHZsSDuWR .node-icon-10{font-size:40px;color:black;}#mermaid-svg-J3SK3zntHZsSDuWR .section-edge-10{stroke:hsl(210, 100%, 76.2745098039%);}#mermaid-svg-J3SK3zntHZsSDuWR .edge-depth-10{stroke-width:-16;}#mermaid-svg-J3SK3zntHZsSDuWR .section-10 line{stroke:hsl(30, 100%, 86.2745098039%);stroke-width:3;}#mermaid-svg-J3SK3zntHZsSDuWR .disabled,#mermaid-svg-J3SK3zntHZsSDuWR .disabled circle,#mermaid-svg-J3SK3zntHZsSDuWR .disabled text{fill:lightgray;}#mermaid-svg-J3SK3zntHZsSDuWR .disabled text{fill:#efefef;}#mermaid-svg-J3SK3zntHZsSDuWR .section-root rect,#mermaid-svg-J3SK3zntHZsSDuWR .section-root path,#mermaid-svg-J3SK3zntHZsSDuWR .section-root circle,#mermaid-svg-J3SK3zntHZsSDuWR .section-root polygon{fill:hsl(240, 100%, 46.2745098039%);}#mermaid-svg-J3SK3zntHZsSDuWR .section-root text{fill:#ffffff;}#mermaid-svg-J3SK3zntHZsSDuWR .section-root span{color:#ffffff;}#mermaid-svg-J3SK3zntHZsSDuWR .section-2 span{color:#ffffff;}#mermaid-svg-J3SK3zntHZsSDuWR .icon-container{height:100%;display:flex;justify-content:center;align-items:center;}#mermaid-svg-J3SK3zntHZsSDuWR .edge{fill:none;}#mermaid-svg-J3SK3zntHZsSDuWR .mindmap-node-label{dy:1em;alignment-baseline:middle;text-anchor:middle;dominant-baseline:middle;text-align:center;}#mermaid-svg-J3SK3zntHZsSDuWR :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} Agent记忆系统
设计目标
上下文管理
控制token消耗
保留关键信息
滑动窗口策略
会话连续性
跨轮状态保持
指代消解
对话摘要压缩
知识持久化
长期存储
语义检索
知识图谱关联
遗忘机制
重要性评分
时间衰减
冗余去重
性能保障
检索延迟 < 200ms
写入异步化
分级存储
从这张思维导图可以看出,记忆系统远不止"把对话存到数据库"这么简单。它需要在有限资源约束下 ,做出写入什么、检索什么、遗忘什么的智能决策。接下来,我们逐层拆解这个系统的设计。
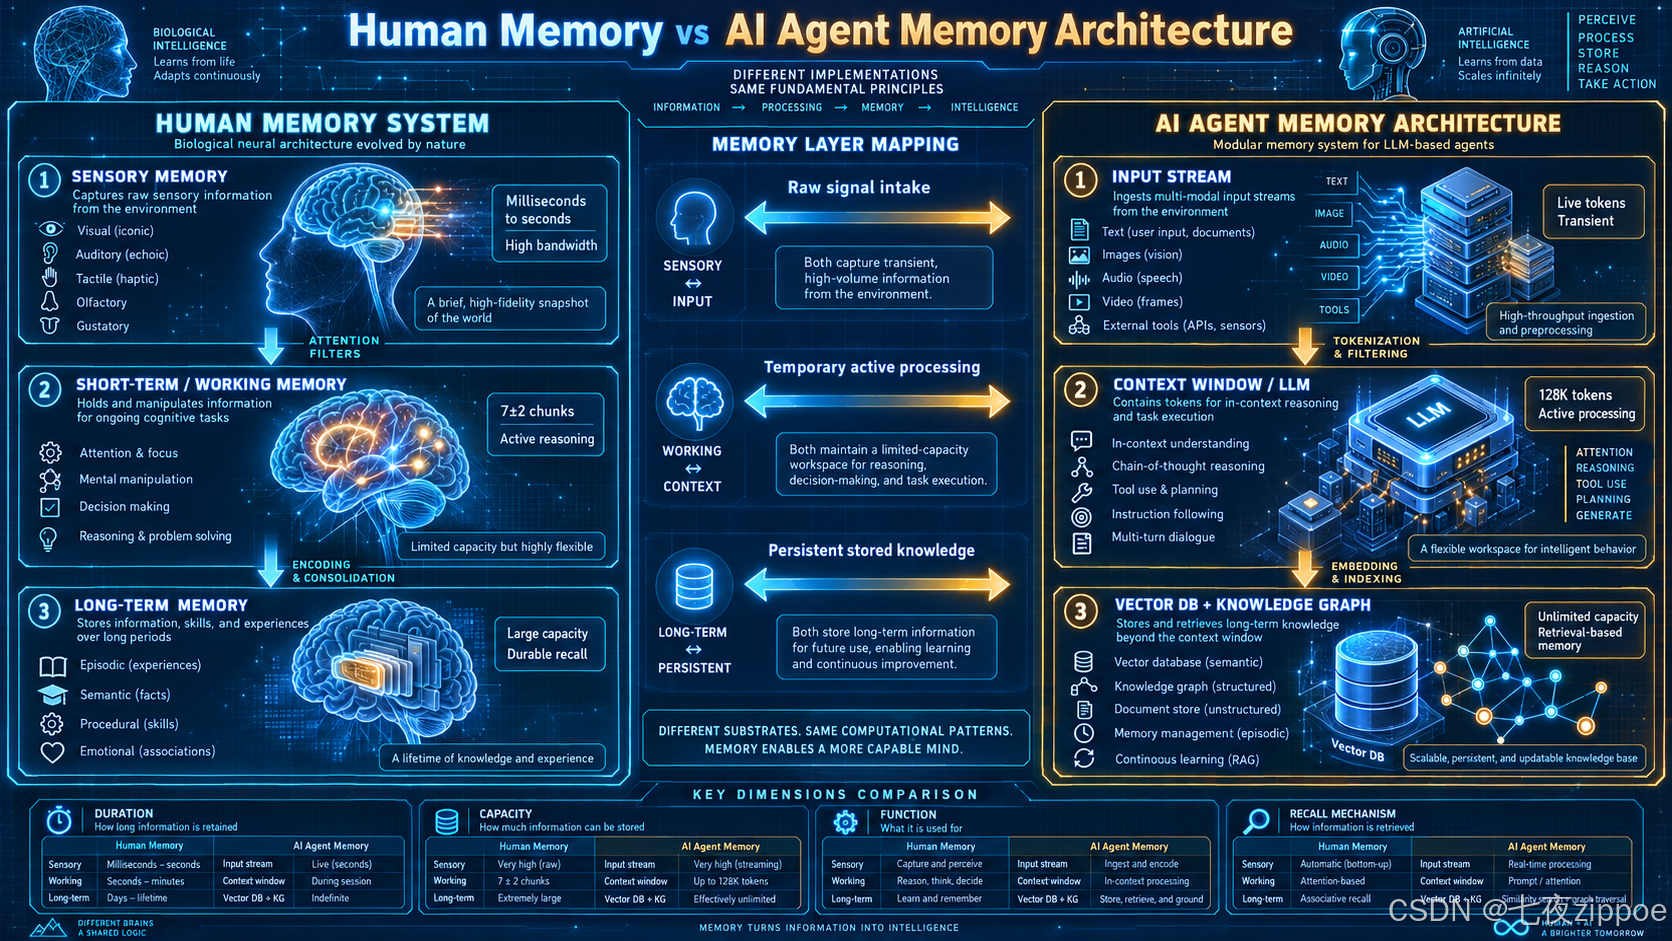
图:人类记忆三层模型与Agent记忆系统的对应关系示意图
二、工作记忆:当前推理上下文的管理
2.1 工作记忆的本质
工作记忆是 Agent 记忆系统的最外层,对应 LLM 的上下文窗口。它存储的是当前正在处理的信息------最近的对话轮次、系统提示词、工具调用结果、当前任务的中间状态。
打个比方:工作记忆就像你办公桌上的空间。你能同时看到多少文件、能同时翻阅多少资料,取决于桌面大小。LLM 的"桌面"就是它的上下文窗口。
工作记忆的核心约束是容量有限。即使 128K token 看起来很大,但实际使用中需要为以下内容预留空间:
| 组成部分 | 典型 token 消耗 | 说明 |
|---|---|---|
| 系统提示词 | 500-2000 | 角色设定、行为规范、工具定义 |
| 对话历史 | 5000-50000 | 最近 N 轮对话 |
| 工具调用结果 | 1000-10000 | 函数返回值、搜索结果 |
| RAG 检索结果 | 1000-5000 | 从长期记忆检索的上下文 |
| 推理空间 | 2000-5000 | LLM 思考和生成的 buffer |
2.2 上下文窗口管理策略
最直接的工作记忆管理策略是滑动窗口:只保留最近 N 轮对话在上下文中,更早的对话被丢弃或压缩。
python
from collections import deque
from typing import TypedDict, List, Dict, Any

class WorkingMemory:
    """
    工作记忆管理器:基于滑动窗口策略管理 LLM 上下文。

    核心策略:
    1. 维护固定大小的消息队列,超出容量时淘汰最旧消息
    2. 系统提示词始终保留,不计入滑动窗口
    3. 对被淘汰的消息生成摘要,摘要保留在上下文中
    4. 支持基于 token 数量的精细控制
    """

    def __init__(self, max_messages: int = 20, max_tokens: int = 8000):
        self.max_messages = max_messages
        self.max_tokens = max_tokens
        self.system_prompt: str = ""
        self.messages: deque = deque(maxlen=max_messages)
        self.summaries: List[str] = []  # 被淘汰消息的摘要
        self.token_counter = TokenCounter()

    def add_message(self, role: str, content: str) -> None:
        """添加新消息到工作记忆。"""
        message = {"role": role, "content": content, "tokens": self.token_counter.count(content)}
        self.messages.append(message)

        # 如果 token 超限,触发摘要压缩
        if self._total_tokens() > self.max_tokens:
            self._compress_oldest()

    def _compress_oldest(self) -> None:
        """将最旧的消息压缩为摘要,释放上下文空间。"""
        if len(self.messages) < 2:
            return

        # 取出最旧的 2 条消息,生成摘要
        old_msgs = [self.messages.popleft() for _ in range(min(2, len(self.messages)))]
        summary = self._summarize(old_msgs)
        self.summaries.append(summary)

        # 保留最近 3 条摘要即可,更早的摘要也丢弃
        if len(self.summaries) > 3:
            self.summaries.pop(0)

    def _summarize(self, messages: List[Dict]) -> str:
        """调用 LLM 生成消息摘要(简化实现)。"""
        text = " ".join(m["content"] for m in messages)
        # 实际项目中调用 LLM 生成摘要
        return f"[摘要] 之前讨论了:{text[:100]}..."

    def _total_tokens(self) -> int:
        return sum(m["tokens"] for m in self.messages)

    def get_context(self) -> List[Dict]:
        """获取完整的上下文消息列表(系统提示 + 摘要 + 最近消息)。"""
        context = [{"role": "system", "content": self.system_prompt}]
        if self.summaries:
            summary_text = "之前的对话摘要:\n" + "\n".join(self.summaries)
            context.append({"role": "system", "content": summary_text})
        context.extend({"role": m["role"], "content": m["content"]} for m in self.messages)
        return context


class TokenCounter:
    """简易 token 计数器,实际项目应使用 tiktoken 库。"""

    def count(self, text: str) -> int:
        # 粗略估计:1 个中文字约 2 token,1 个英文单词约 1.3 token
        return int(len(text) * 1.5)
上面的代码实现了一个基础的工作记忆管理器。核心设计点有四个:
第一 ,使用 deque(maxlen=N) 作为消息容器,当超过容量时自动淘汰最旧的消息,这是滑动窗口的本质。选择双端队列而非普通列表,是因为 deque 在头部删除元素的时间复杂度为 O(1),而列表为 O(n)。
第二,系统提示词独立存储,永远不被淘汰。因为系统提示词定义了 Agent 的行为规范和工具使用规则,一旦丢失会导致 Agent 行为漂移。
第三,被淘汰的消息不会被直接丢弃,而是生成摘要后保留。这些摘要构成了一条"记忆压缩链",让 Agent 能够大致了解之前讨论的主题,而不需要保留全部细节。摘要本身也有数量限制(3 条),避免摘要无限累积。
第四,同时维护消息数量和 token 数量两个限制条件。因为不同消息长度差异巨大------一句"好的"可能只有 2 个 token,而一段代码可能有 500 个 token。仅靠消息数量无法精确控制上下文消耗。
2.3 "中间遗忘"问题与缓解
2023 年斯坦福大学的研究表明,LLM 在处理长上下文时存在明显的 U 型检索曲线:对上下文开头和结尾的信息检索准确率较高,但中间部分的信息检索准确率显著下降。
渲染错误: Mermaid 渲染失败: Lexical error on line 3. Unrecognized text. ... x-axis "上下文位置" [开头, 1/4, 1/2, 3/4, 结 -----------------------^
这张图展示了一个典型的 U 型曲线。当关键信息位于上下文中间位置时,LLM 的检索准确率可能从 92% 下降到 55%------接近随机猜测。
缓解中间遗忘的策略包括:
策略一:关键信息前置。 将重要的指令、约束条件放在系统提示词中(位于上下文最前面),而不是埋在长篇对话的中间。
策略二:重复关键信息。 对于特别重要的上下文(如用户的姓名、当前任务目标),在每轮对话的末尾重复一次,利用"近因效应"提高检索率。
策略三:分块处理。 当需要处理超长文档时,不要一次性全部塞入上下文,而是分块处理,每次只加载最相关的 chunk。
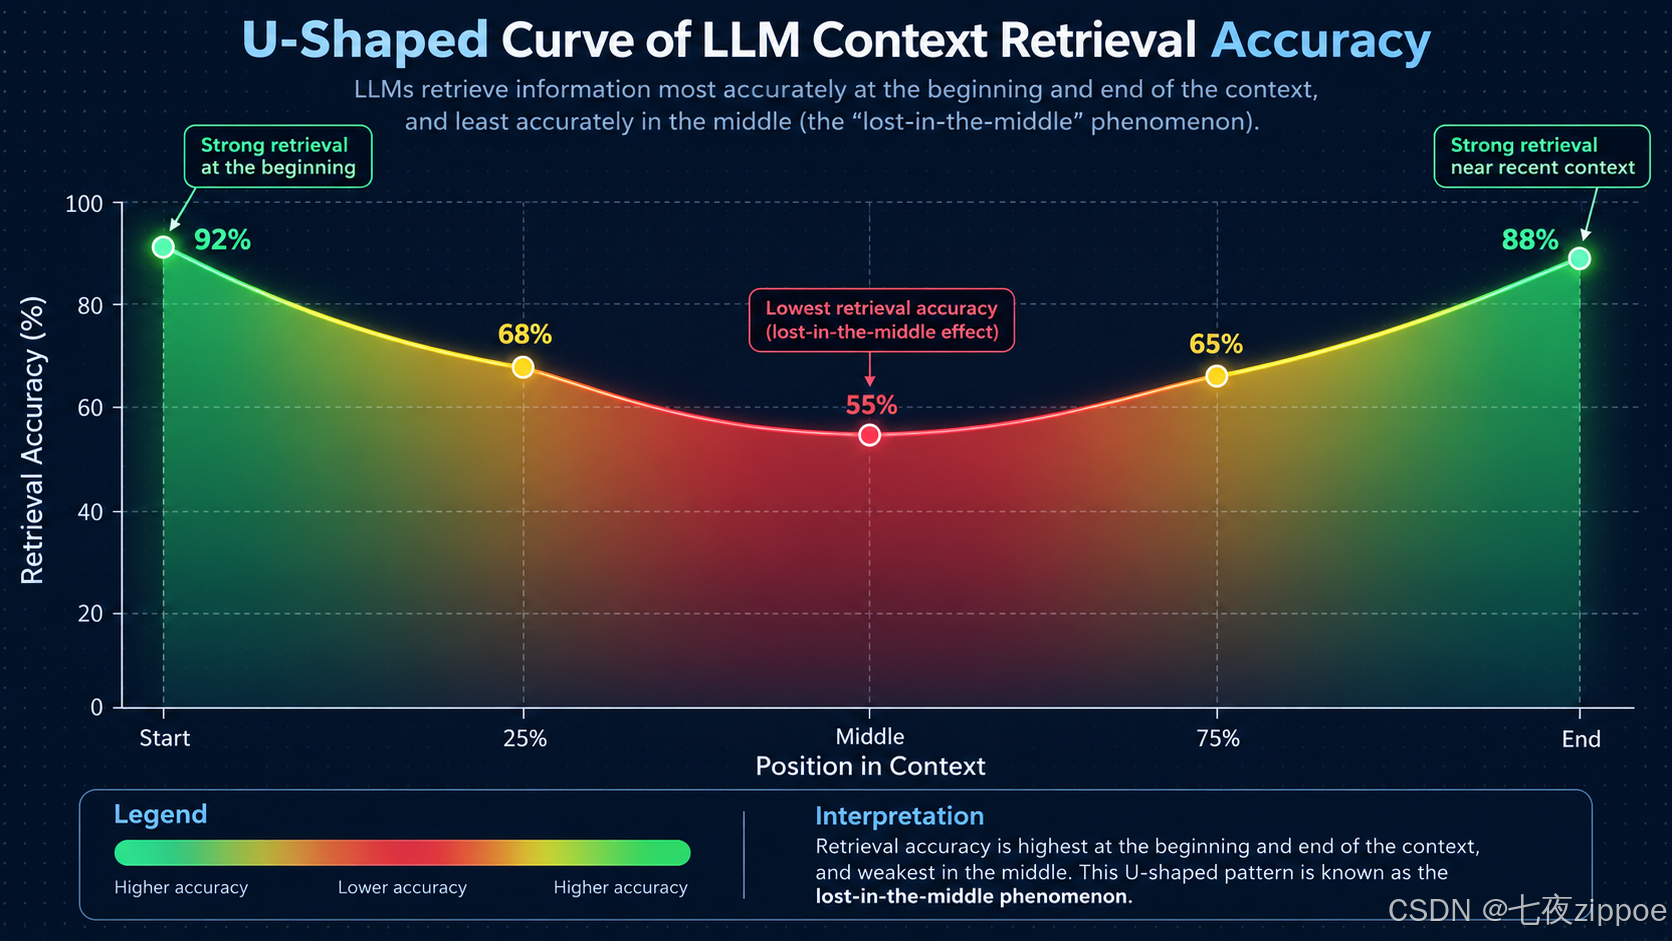
图:LLM上下文信息检索的U型准确率曲线
三、会话记忆:跨轮对话的状态保持
3.1 会话记忆的定位
会话记忆位于工作记忆和长期记忆之间,它的核心职责是在同一会话内保持对话状态的连续性。
举个具体例子:用户在第1轮说"帮我订一张明天去北京的机票",第3轮说"帮我改签一下"。这里的"改签"需要引用第1轮的上下文------目的地是北京、时间是明天、操作是机票。如果工作记忆的滑动窗口已经把第1轮淘汰了,Agent 就会一脸茫然:"改签什么?"
会话记忆的解决方案不是简单地保留所有历史消息(那会让上下文爆炸),而是提取和压缩关键状态信息,用一个独立的"状态槽"来维护。
3.2 会话状态的结构化设计
python
from dataclasses import dataclass, field
from typing import Optional, List, Dict
from datetime import datetime
import json

@dataclass
class ConversationState:
    """
    会话状态:结构化保存对话中的关键信息。

    与保留完整历史消息不同,会话状态只保存"后续对话可能需要引用"的关键信息。
    设计灵感来自任务导向对话系统(Task-Oriented Dialog Systems)的 belief state。
    """

    # 用户意图追踪
    current_intent: Optional[str] = None        # 当前用户的主要意图
    intent_history: List[Dict] = field(default_factory=list)  # 意图切换历史

    # 实体槽位(key-value 形式存储关键实体)
    slots: Dict[str, Any] = field(default_factory=dict)
    # 示例:{"destination": "北京", "date": "2024-12-25", "flight_no": "CA1234"}

    # 任务进度
    task_step: int = 0                           # 当前执行到第几步
    task_status: str = "idle"                    # idle | in_progress | waiting_input | completed | failed

    # 待确认事项
    pending_confirmations: List[str] = field(default_factory=list)

    # 关键上下文摘要(最近 N 轮的要点)
    context_summary: str = ""

    # 时间戳
    last_updated: datetime = field(default_factory=datetime.now)

    def update_slot(self, key: str, value: Any) -> None:
        """更新槽位值,如果值变化则记录到意图历史。"""
        old_value = self.slots.get(key)
        if old_value != value:
            self.slots[key] = value
            self.intent_history.append({
                "action": "slot_update",
                "key": key,
                "old": old_value,
                "new": value,
                "timestamp": datetime.now().isoformat()
            })

    def to_context_string(self) -> str:
        """将会话状态序列化为 LLM 可读的上下文字符串。"""
        parts = []
        if self.current_intent:
            parts.append(f"当前用户意图:{self.current_intent}")
        if self.slots:
            slots_str = "\n".join(f"  - {k}: {v}" for k, v in self.slots.items())
            parts.append(f"已知信息:\n{slots_str}")
        if self.task_status != "idle":
            parts.append(f"任务进度:第{self.task_step}步,状态:{self.task_status}")
        if self.pending_confirmations:
            parts.append(f"待确认:{', '.join(self.pending_confirmations)}")
        if self.context_summary:
            parts.append(f"上下文摘要:{self.context_summary}")

        return "\n".join(parts) if parts else "(无活跃会话状态)"

    def to_dict(self) -> Dict:
        """序列化为字典,用于持久化存储。"""
        return {
            "current_intent": self.current_intent,
            "intent_history": self.intent_history,
            "slots": self.slots,
            "task_step": self.task_step,
            "task_status": self.task_status,
            "pending_confirmations": self.pending_confirmations,
            "context_summary": self.context_summary,
            "last_updated": self.last_updated.isoformat()
        }


class SessionMemory:
    """
    会话记忆管理器:管理单个会话的状态和历史。

    职责:
    1. 维护结构化的对话状态(ConversationState)
    2. 保留最近 N 轮完整对话(用于指代消解)
    3. 在会话结束时,将需要持久化的信息写入长期记忆
    """

    def __init__(self, session_id: str):
        self.session_id = session_id
        self.state = ConversationState()
        self.recent_turns: List[Dict] = []  # 保留最近5轮完整对话
        self.max_recent_turns = 5

    def add_turn(self, user_input: str, assistant_response: str, tool_calls: List = None) -> None:
        """记录一轮对话。"""
        turn = {
            "user": user_input,
            "assistant": assistant_response,
            "tool_calls": tool_calls or [],
            "timestamp": datetime.now().isoformat()
        }
        self.recent_turns.append(turn)
        if len(self.recent_turns) > self.max_recent_turns:
            self.recent_turns.pop(0)  # 淘汰最旧的一轮

    def get_context_for_llm(self) -> str:
        """获取注入 LLM 上下文的会话状态信息。"""
        state_str = self.state.to_context_string()
return f"--- 会话状态 ---\n{state_str}\n--- 会话状态结束 ---"这段代码的核心设计理念是结构化状态优于完整历史。
传统的做法是保留所有历史消息,然后全部塞进 LLM 上下文。这带来的问题是:对话越长,token 消耗越大,而且 LLM 需要自己从自然语言中提取关键信息,容易遗漏。
ConversationState 采用"槽位填充"(slot filling)的方式,将对话中的关键信息提取为结构化的 key-value 对。例如 {"destination": "北京", "date": "2024-12-25"} 比保留整段对话"请帮我订一张明天也就是12月25号去北京的机票,经济舱就行..."节省了 80% 以上的 token,而且检索更精确。
SessionMemory 同时保留了最近 5 轮的完整对话(recent_turns),用于处理指代消解等需要原始上下文的场景。5 轮是一个经验值------大多数指代关系在 5 轮之内可以解析,超出范围的信息通过状态槽来传递。
3.3 会话摘要的生成时机
会话摘要不是每轮都生成。频繁摘要会增加 LLM 调用成本,也可能丢失关键细节。合理的摘要触发时机包括:
#mermaid-svg-xpn8wwDWhwUI3a8e{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-xpn8wwDWhwUI3a8e .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-xpn8wwDWhwUI3a8e .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-xpn8wwDWhwUI3a8e .error-icon{fill:#552222;}#mermaid-svg-xpn8wwDWhwUI3a8e .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-xpn8wwDWhwUI3a8e .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-xpn8wwDWhwUI3a8e .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-xpn8wwDWhwUI3a8e .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-xpn8wwDWhwUI3a8e .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-xpn8wwDWhwUI3a8e .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-xpn8wwDWhwUI3a8e .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-xpn8wwDWhwUI3a8e .marker{fill:#333333;stroke:#333333;}#mermaid-svg-xpn8wwDWhwUI3a8e .marker.cross{stroke:#333333;}#mermaid-svg-xpn8wwDWhwUI3a8e svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-xpn8wwDWhwUI3a8e p{margin:0;}#mermaid-svg-xpn8wwDWhwUI3a8e .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-xpn8wwDWhwUI3a8e .cluster-label text{fill:#333;}#mermaid-svg-xpn8wwDWhwUI3a8e .cluster-label span{color:#333;}#mermaid-svg-xpn8wwDWhwUI3a8e .cluster-label span p{background-color:transparent;}#mermaid-svg-xpn8wwDWhwUI3a8e .label text,#mermaid-svg-xpn8wwDWhwUI3a8e span{fill:#333;color:#333;}#mermaid-svg-xpn8wwDWhwUI3a8e .node rect,#mermaid-svg-xpn8wwDWhwUI3a8e .node circle,#mermaid-svg-xpn8wwDWhwUI3a8e .node ellipse,#mermaid-svg-xpn8wwDWhwUI3a8e .node polygon,#mermaid-svg-xpn8wwDWhwUI3a8e .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-xpn8wwDWhwUI3a8e .rough-node .label text,#mermaid-svg-xpn8wwDWhwUI3a8e .node .label text,#mermaid-svg-xpn8wwDWhwUI3a8e .image-shape .label,#mermaid-svg-xpn8wwDWhwUI3a8e .icon-shape .label{text-anchor:middle;}#mermaid-svg-xpn8wwDWhwUI3a8e .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-xpn8wwDWhwUI3a8e .rough-node .label,#mermaid-svg-xpn8wwDWhwUI3a8e .node .label,#mermaid-svg-xpn8wwDWhwUI3a8e .image-shape .label,#mermaid-svg-xpn8wwDWhwUI3a8e .icon-shape .label{text-align:center;}#mermaid-svg-xpn8wwDWhwUI3a8e .node.clickable{cursor:pointer;}#mermaid-svg-xpn8wwDWhwUI3a8e .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-xpn8wwDWhwUI3a8e .arrowheadPath{fill:#333333;}#mermaid-svg-xpn8wwDWhwUI3a8e .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-xpn8wwDWhwUI3a8e .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-xpn8wwDWhwUI3a8e .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-xpn8wwDWhwUI3a8e .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-xpn8wwDWhwUI3a8e .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-xpn8wwDWhwUI3a8e .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-xpn8wwDWhwUI3a8e .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-xpn8wwDWhwUI3a8e .cluster text{fill:#333;}#mermaid-svg-xpn8wwDWhwUI3a8e .cluster span{color:#333;}#mermaid-svg-xpn8wwDWhwUI3a8e div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-xpn8wwDWhwUI3a8e .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-xpn8wwDWhwUI3a8e rect.text{fill:none;stroke-width:0;}#mermaid-svg-xpn8wwDWhwUI3a8e .icon-shape,#mermaid-svg-xpn8wwDWhwUI3a8e .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-xpn8wwDWhwUI3a8e .icon-shape p,#mermaid-svg-xpn8wwDWhwUI3a8e .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-xpn8wwDWhwUI3a8e .icon-shape .label rect,#mermaid-svg-xpn8wwDWhwUI3a8e .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-xpn8wwDWhwUI3a8e .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-xpn8wwDWhwUI3a8e .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-xpn8wwDWhwUI3a8e :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 是
否
是
否
是
否
用户发送消息
消息数达到阈值?
如每10轮
触发摘要生成
话题切换检测?
token接近上限?
正常处理
LLM生成前N轮摘要
摘要写入会话状态
原始消息归档
返回响应
这张流程图展示了三种摘要触发策略的协同工作:
定期触发是最简单的策略,每 N 轮(如 10 轮)自动生成一次摘要。N 的取值取决于对话密度------客服场景对话信息密度高,N 可以设小一些(5-7轮);闲聊场景可以设大一些(15-20轮)。
话题切换触发是更智能的策略,通过检测用户意图的变化来触发摘要。例如从"订机票"切换到"查天气",前一个话题的细节不太可能被后续对话引用,适合压缩为摘要。
Token 阈值触发 是兜底策略,当上下文接近上限时强制摘要,防止上下文溢出。
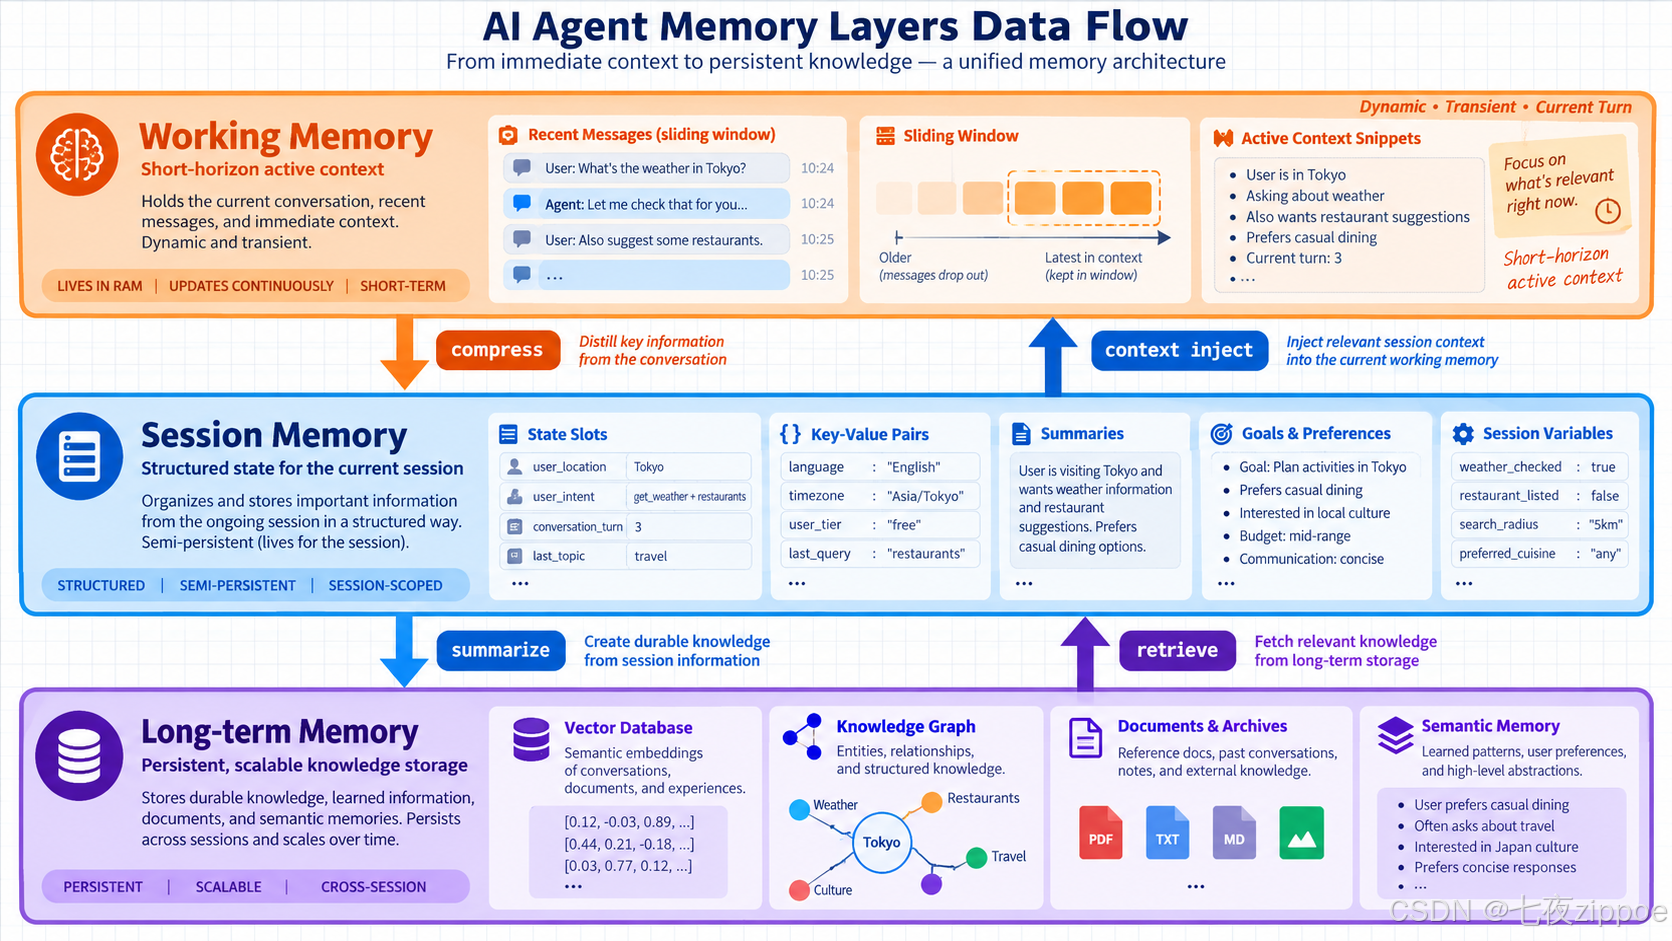
图:工作记忆、会话记忆、长期记忆之间的数据流向
四、长期记忆:向量数据库+知识图谱的设计
4.1 长期记忆的核心挑战
长期记忆要解决的问题是:在跨会话、跨时间的维度上,让 Agent 能够"记住"过去的交互、学到的知识和用户的偏好。
这听起来像是数据库的问题------把对话存进去,需要时查出来。但实际远比这复杂。核心挑战在于语义检索:用户问"上次我们讨论的那个性能优化方案",数据库怎么知道"那个性能优化方案"指的是什么?
传统关系型数据库的精确匹配查询无法处理这种模糊引用。我们需要的是基于语义的模糊检索------找到"语义最接近"的记忆条目,而不是"字符串完全匹配"的记录。
4.2 向量数据库方案
向量数据库是当前长期记忆存储的主流方案。其核心思路是:将文本通过 Embedding 模型转换为高维向量,然后通过向量相似度(如余弦相似度)来检索最相关的记忆。
python
import chromadb
from chromadb.config import Settings
from typing import List, Dict, Optional
from dataclasses import dataclass
from datetime import datetime
import uuid

@dataclass
class MemoryRecord:
    """长期记忆中的一条记录。"""
    content: str                    # 记忆内容(自然语言描述)
    memory_type: str                # 类型:episodic(事件)/ semantic(知识)/ preference(偏好)
    importance: float                # 重要性评分 0-1
    created_at: str                 # 创建时间
    last_accessed: str              # 最后访问时间
    access_count: int                # 访问次数
    related_entities: List[str]     # 关联实体
    source_session: str             # 来源会话ID
    metadata: Dict                  # 其他元数据

class LongTermMemory:
    """
    长期记忆管理器:基于 ChromaDB 的向量存储与检索。

    核心能力:
    1. 将记忆条目向量化后存储,支持语义检索
    2. 维护记忆的元数据(重要性、访问频次、时间衰减)
    3. 支持按类型过滤(事件记忆/知识记忆/偏好记忆)
    4. 实现基于时间衰减和重要性的排序
    """

    def __init__(self, collection_name: str = "agent_memories",
                 embedding_model: str = "text-embedding-3-small"):
        self.client = chromadb.PersistentClient(path="./chroma_db")
        self.collection = self.client.get_or_create_collection(
            name=collection_name,
            metadata={"hnsw:space": "cosine"}  # 使用余弦相似度
        )
        self.embedding_model = embedding_model
        self._embedding_function = self._init_embedding_function()

    def _init_embedding_function(self):
        """初始化 Embedding 函数。"""
        # 实际项目使用 OpenAI 或本地模型
        from chromadb.utils.embedding_functions import OpenAIEmbeddingFunction
        return OpenAIEmbeddingFunction(
            api_key="your-api-key",  # 请替换为实际值
            model_name=self.embedding_model
        )

    def store(self, record: MemoryRecord) -> str:
        """
        存储一条长期记忆。

        存储流程:
        1. 生成唯一ID
        2. 将内容向量化(ChromaDB 自动处理)
        3. 将元数据一同存储
        4. 返回记忆ID供后续引用
        """
        memory_id = f"mem_{uuid.uuid4().hex[:12]}"

        self.collection.add(
            ids=[memory_id],
            documents=[record.content],
            metadatas=[{
                "memory_type": record.memory_type,
                "importance": record.importance,
                "created_at": record.created_at,
                "last_accessed": record.last_accessed,
                "access_count": record.access_count,
                "related_entities": ",".join(record.related_entities),
                "source_session": record.source_session,
                **record.metadata
            }]
        )
        return memory_id

    def retrieve(self, query: str, top_k: int = 5,
                 memory_type: Optional[str] = None,
                 min_importance: float = 0.0) -> List[Dict]:
        """
        检索与查询语义最相关的记忆。

        参数说明:
        - query: 查询文本,如"上次讨论的性能优化方案"
        - top_k: 返回最相关的 K 条记忆
        - memory_type: 过滤记忆类型(episodic/semantic/preference)
        - min_importance: 最低重要性阈值,过滤低价值记忆

        排序逻辑:向量相似度 × 重要性 × 时间衰减因子
        """
        where_filter = {}
        if memory_type:
            where_filter["memory_type"] = memory_type
        if min_importance > 0:
            where_filter["importance"] = {"$gte": min_importance}

        results = self.collection.query(
            query_texts=[query],
            n_results=top_k * 2,  # 多检索一些,然后重新排序
            where=where_filter if where_filter else None
        )

        # 重新排序:综合向量相似度、重要性和时间衰减
        ranked_results = []
        for i, doc in enumerate(results["documents"][0]):
            similarity = results["metadatas"][0][i].get("distance", 0.5)
            importance = results["metadatas"][0][i].get("importance", 0.5)
            time_decay = self._time_decay(results["metadatas"][0][i].get("created_at", ""))

            # 综合得分公式
            final_score = similarity * 0.5 + importance * 0.3 + time_decay * 0.2

            ranked_results.append({
                "content": doc,
                "score": final_score,
                "metadata": results["metadatas"][0][i]
            })

        # 按综合得分排序,返回 top_k
        ranked_results.sort(key=lambda x: x["score"], reverse=True)

        # 更新访问记录
        for r in ranked_results[:top_k]:
            self._update_access(r["metadata"].get("id", ""))

        return ranked_results[:top_k]

    def _time_decay(self, created_at: str, half_life_days: int = 30) -> float:
        """
        时间衰减因子:记忆随时间推移重要性下降。

        使用指数衰减模型:score = exp(-ln(2) * days / half_life)
        含义:每过一个半衰期(默认30天),记忆得分减半。
        """
        if not created_at:
            return 0.5
        try:
            created = datetime.fromisoformat(created_at)
            days_ago = (datetime.now() - created).days
            import math
            return math.exp(-math.log(2) * days_ago / half_life_days)
        except:
            return 0.5

    def _update_access(self, memory_id: str) -> None:
        """更新记忆的访问记录(最后访问时间 + 访问次数)。"""
        if not memory_id:
            return
        # 实际项目中更新 ChromaDB 的元数据
        pass
这段代码实现了长期记忆的核心存储与检索逻辑。几个关键设计决策需要解释:
综合评分公式 similarity × 0.5 + importance × 0.3 + time_decay × 0.2 是三个因素的加权组合。向量相似度权重最高(50%),因为语义相关性是检索的首要条件。重要性占 30%,确保高价值记忆优先返回。时间衰减占 20%,让过时信息的排名自然下降。这三个权重可以根据应用场景调整------客服场景可能更看重近期记忆,可以调高时间衰减权重。
时间衰减模型 使用指数衰减而非线性衰减。指数衰减更符合人类记忆的遗忘曲线------Ebbinghaus 遗忘曲线就是指数形式。half_life_days=30 意味着 30 天前的记忆得分减半,60 天减为 1/4,90 天减为 1/8。对于快节奏的客服场景,半衰期可以设为 7 天;对于长期知识管理,可以设为 90 天。
多检索后重排序 的策略(n_results=top_k * 2)是因为 ChromaDB 的原生排序只考虑向量相似度,不考虑重要性和时间衰减。我们多检索一倍的结果,然后在应用层用综合公式重新排序,确保最终返回的是综合最优的记忆。
4.3 知识图谱增强
向量数据库擅长语义检索,但它有一个弱点:无法表达实体之间的结构化关系。
例如,用户在之前的对话中提到"我在字节跳动做后端开发,用的是 Go 语言"。如果用向量数据库存储,这段话只是一个文本块。当用户后来问"我的技术栈是什么"时,向量检索可以找到这段话。但如果用户问"我的公司用什么技术栈",向量检索可能就力不从心了------因为"公司"和"技术栈"之间的关系没有被结构化表达。
知识图谱通过实体-关系-实体三元组来解决这个问题:
#mermaid-svg-8FavMxuQ1nnG5kXT{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-8FavMxuQ1nnG5kXT .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-8FavMxuQ1nnG5kXT .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-8FavMxuQ1nnG5kXT .error-icon{fill:#552222;}#mermaid-svg-8FavMxuQ1nnG5kXT .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-8FavMxuQ1nnG5kXT .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-8FavMxuQ1nnG5kXT .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-8FavMxuQ1nnG5kXT .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-8FavMxuQ1nnG5kXT .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-8FavMxuQ1nnG5kXT .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-8FavMxuQ1nnG5kXT .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-8FavMxuQ1nnG5kXT .marker{fill:#333333;stroke:#333333;}#mermaid-svg-8FavMxuQ1nnG5kXT .marker.cross{stroke:#333333;}#mermaid-svg-8FavMxuQ1nnG5kXT svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-8FavMxuQ1nnG5kXT p{margin:0;}#mermaid-svg-8FavMxuQ1nnG5kXT .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-8FavMxuQ1nnG5kXT .cluster-label text{fill:#333;}#mermaid-svg-8FavMxuQ1nnG5kXT .cluster-label span{color:#333;}#mermaid-svg-8FavMxuQ1nnG5kXT .cluster-label span p{background-color:transparent;}#mermaid-svg-8FavMxuQ1nnG5kXT .label text,#mermaid-svg-8FavMxuQ1nnG5kXT span{fill:#333;color:#333;}#mermaid-svg-8FavMxuQ1nnG5kXT .node rect,#mermaid-svg-8FavMxuQ1nnG5kXT .node circle,#mermaid-svg-8FavMxuQ1nnG5kXT .node ellipse,#mermaid-svg-8FavMxuQ1nnG5kXT .node polygon,#mermaid-svg-8FavMxuQ1nnG5kXT .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-8FavMxuQ1nnG5kXT .rough-node .label text,#mermaid-svg-8FavMxuQ1nnG5kXT .node .label text,#mermaid-svg-8FavMxuQ1nnG5kXT .image-shape .label,#mermaid-svg-8FavMxuQ1nnG5kXT .icon-shape .label{text-anchor:middle;}#mermaid-svg-8FavMxuQ1nnG5kXT .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-8FavMxuQ1nnG5kXT .rough-node .label,#mermaid-svg-8FavMxuQ1nnG5kXT .node .label,#mermaid-svg-8FavMxuQ1nnG5kXT .image-shape .label,#mermaid-svg-8FavMxuQ1nnG5kXT .icon-shape .label{text-align:center;}#mermaid-svg-8FavMxuQ1nnG5kXT .node.clickable{cursor:pointer;}#mermaid-svg-8FavMxuQ1nnG5kXT .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-8FavMxuQ1nnG5kXT .arrowheadPath{fill:#333333;}#mermaid-svg-8FavMxuQ1nnG5kXT .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-8FavMxuQ1nnG5kXT .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-8FavMxuQ1nnG5kXT .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-8FavMxuQ1nnG5kXT .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-8FavMxuQ1nnG5kXT .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-8FavMxuQ1nnG5kXT .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-8FavMxuQ1nnG5kXT .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-8FavMxuQ1nnG5kXT .cluster text{fill:#333;}#mermaid-svg-8FavMxuQ1nnG5kXT .cluster span{color:#333;}#mermaid-svg-8FavMxuQ1nnG5kXT div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-8FavMxuQ1nnG5kXT .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-8FavMxuQ1nnG5kXT rect.text{fill:none;stroke-width:0;}#mermaid-svg-8FavMxuQ1nnG5kXT .icon-shape,#mermaid-svg-8FavMxuQ1nnG5kXT .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-8FavMxuQ1nnG5kXT .icon-shape p,#mermaid-svg-8FavMxuQ1nnG5kXT .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-8FavMxuQ1nnG5kXT .icon-shape .label rect,#mermaid-svg-8FavMxuQ1nnG5kXT .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-8FavMxuQ1nnG5kXT .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-8FavMxuQ1nnG5kXT .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-8FavMxuQ1nnG5kXT :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 就职于
技术栈包含
技术栈包含
业务领域
偏好使用
个人兴趣
居住在
用户: 张三
公司: 字节跳动
Go
Python
短视频
技术写作
北京
这个知识图谱将用户信息结构化为实体和关系。有了它,当用户问"我的公司用什么技术栈"时,Agent 可以通过图查询"用户→就职于→公司→技术栈包含→?"直接得到答案,而不需要依赖语义模糊匹配。
python
from typing import List, Tuple, Set, Dict
from collections import defaultdict

class KnowledgeGraph:
    """
    轻量级知识图谱:用三元组存储实体关系。

    生产环境推荐使用 Neo4j 或 NebulaGraph 等专业图数据库。
    本实现使用内存字典,适合原型验证和中小规模数据。
    """

    def __init__(self):
        # 邻接表存储:entity -> [(relation, target_entity)]
        self._adjacency: Dict[str, List[Tuple[str, str]]] = defaultdict(list)
        # 实体类型索引
        self._entity_types: Dict[str, str] = {}
        # 反向索引:target_entity -> [(source_entity, relation)]
        self._reverse: Dict[str, List[Tuple[str, str]]] = defaultdict(list)

    def add_entity(self, entity: str, entity_type: str) -> None:
        """添加实体及其类型。"""
        self._entity_types[entity] = entity_type

    def add_relation(self, source: str, relation: str, target: str) -> None:
        """
        添加三元组关系:source -[relation]-> target

        示例:add_relation("张三", "就职于", "字节跳动")
        """
        self._adjacency[source].append((relation, target))
        self._reverse[target].append((source, relation))

    def query(self, entity: str, relation: str = None, depth: int = 1) -> List[Dict]:
        """
        查询实体的关联信息。

        参数:
        - entity: 起始实体
        - relation: 可选,限定关系类型
        - depth: 查询深度(1=直接邻居,2=邻居的邻居)

        返回:[{relation, target, path}] 列表
        """
        results = []
        self._query_recursive(entity, relation, depth, [], results, set())
        return results

    def _query_recursive(self, entity: str, target_relation: str,
                         depth: int, path: List, results: List, visited: Set):
        if entity in visited or depth <= 0:
            return
        visited.add(entity)

        for relation, target in self._adjacency.get(entity, []):
            if target_relation is None or relation == target_relation:
                current_path = path + [(entity, relation, target)]
                results.append({
                    "relation": relation,
                    "target": target,
                    "path": current_path,
                    "entity_type": self._entity_types.get(target, "unknown")
                })

            if depth > 1:
                self._query_recursive(target, target_relation, depth - 1,
                                      path + [(entity, relation, target)], results, visited)

        visited.discard(entity)

    def extract_from_text(self, text: str, llm_extract_func) -> None:
        """
        使用 LLM 从文本中提取实体和关系,自动写入图谱。

        生产环境中,这里会调用 LLM 进行命名实体识别和关系抽取。
        llm_extract_func 接收文本,返回三元组列表。
        """
        triples = llm_extract_func(text)
        for source, relation, target, source_type, target_type in triples:
            self.add_entity(source, source_type)
            self.add_entity(target, target_type)
            self.add_relation(source, relation, target)
这个知识图谱实现使用了邻接表结构,核心操作有三个:
add_relation 添加三元组时同时更新正向索引和反向索引。正向索引用于"从某实体出发能到达哪些实体"的查询,反向索引用于"哪些实体能到达某实体"的查询。双向索引使得图查询在两个方向上都是 O(1) 的查找效率。
query 方法支持多跳查询(depth > 1),可以沿着关系链路遍历。例如查询"用户→就职于→公司→技术栈包含→?",depth=2 就能找到用户公司的技术栈。查询过程中用 visited 集合防止循环引用导致的死循环。
extract_from_text 是知识图谱的"喂入"接口,通过 LLM 进行命名实体识别和关系抽取,将非结构化文本转化为结构化三元组。这是知识图谱与 LLM 的核心协作点------LLM 负责"理解"文本,图谱负责"存储"结构化关系。
4.4 向量+图谱的混合检索
实际应用中,向量数据库和知识图谱不是二选一,而是协同工作的。一个完整的长期记忆检索流程如下:
LLM 知识图谱 向量DB 检索路由器 用户Query LLM 知识图谱 向量DB 检索路由器 用户Query #mermaid-svg-88qtuZyDNhavhvJ3{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-88qtuZyDNhavhvJ3 .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-88qtuZyDNhavhvJ3 .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-88qtuZyDNhavhvJ3 .error-icon{fill:#552222;}#mermaid-svg-88qtuZyDNhavhvJ3 .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-88qtuZyDNhavhvJ3 .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-88qtuZyDNhavhvJ3 .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-88qtuZyDNhavhvJ3 .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-88qtuZyDNhavhvJ3 .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-88qtuZyDNhavhvJ3 .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-88qtuZyDNhavhvJ3 .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-88qtuZyDNhavhvJ3 .marker{fill:#333333;stroke:#333333;}#mermaid-svg-88qtuZyDNhavhvJ3 .marker.cross{stroke:#333333;}#mermaid-svg-88qtuZyDNhavhvJ3 svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-88qtuZyDNhavhvJ3 p{margin:0;}#mermaid-svg-88qtuZyDNhavhvJ3 .actor{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;}#mermaid-svg-88qtuZyDNhavhvJ3 text.actor>tspan{fill:black;stroke:none;}#mermaid-svg-88qtuZyDNhavhvJ3 .actor-line{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);}#mermaid-svg-88qtuZyDNhavhvJ3 .innerArc{stroke-width:1.5;stroke-dasharray:none;}#mermaid-svg-88qtuZyDNhavhvJ3 .messageLine0{stroke-width:1.5;stroke-dasharray:none;stroke:#333;}#mermaid-svg-88qtuZyDNhavhvJ3 .messageLine1{stroke-width:1.5;stroke-dasharray:2,2;stroke:#333;}#mermaid-svg-88qtuZyDNhavhvJ3 #arrowhead path{fill:#333;stroke:#333;}#mermaid-svg-88qtuZyDNhavhvJ3 .sequenceNumber{fill:white;}#mermaid-svg-88qtuZyDNhavhvJ3 #sequencenumber{fill:#333;}#mermaid-svg-88qtuZyDNhavhvJ3 #crosshead path{fill:#333;stroke:#333;}#mermaid-svg-88qtuZyDNhavhvJ3 .messageText{fill:#333;stroke:none;}#mermaid-svg-88qtuZyDNhavhvJ3 .labelBox{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;}#mermaid-svg-88qtuZyDNhavhvJ3 .labelText,#mermaid-svg-88qtuZyDNhavhvJ3 .labelText>tspan{fill:black;stroke:none;}#mermaid-svg-88qtuZyDNhavhvJ3 .loopText,#mermaid-svg-88qtuZyDNhavhvJ3 .loopText>tspan{fill:black;stroke:none;}#mermaid-svg-88qtuZyDNhavhvJ3 .loopLine{stroke-width:2px;stroke-dasharray:2,2;stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);}#mermaid-svg-88qtuZyDNhavhvJ3 .note{stroke:#aaaa33;fill:#fff5ad;}#mermaid-svg-88qtuZyDNhavhvJ3 .noteText,#mermaid-svg-88qtuZyDNhavhvJ3 .noteText>tspan{fill:black;stroke:none;}#mermaid-svg-88qtuZyDNhavhvJ3 .activation0{fill:#f4f4f4;stroke:#666;}#mermaid-svg-88qtuZyDNhavhvJ3 .activation1{fill:#f4f4f4;stroke:#666;}#mermaid-svg-88qtuZyDNhavhvJ3 .activation2{fill:#f4f4f4;stroke:#666;}#mermaid-svg-88qtuZyDNhavhvJ3 .actorPopupMenu{position:absolute;}#mermaid-svg-88qtuZyDNhavhvJ3 .actorPopupMenuPanel{position:absolute;fill:#ECECFF;box-shadow:0px 8px 16px 0px rgba(0,0,0,0.2);filter:drop-shadow(3px 5px 2px rgb(0 0 0 / 0.4));}#mermaid-svg-88qtuZyDNhavhvJ3 .actor-man line{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;}#mermaid-svg-88qtuZyDNhavhvJ3 .actor-man circle,#mermaid-svg-88qtuZyDNhavhvJ3 line{stroke:hsl(259.6261682243, 59.7765363128%, 87.9019607843%);fill:#ECECFF;stroke-width:2px;}#mermaid-svg-88qtuZyDNhavhvJ3 :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} par 并行检索 "上次讨论的优化方案效果如何?" 意图分析:需要历史事件+关联实体 语义检索 "优化方案 效果" 记忆1: 讨论了缓存优化方案, 记忆2: QPS提升3倍 图查询 用户→讨论过→? →效果→? 缓存优化, Redis集群, QPS 3000→9000 结果融合与去重 注入融合上下文,生成回答 "上次我们讨论了Redis缓存集群优化方案,实施后QPS从3000提升到9000..."
这个时序图展示了混合检索的完整流程。检索路由器首先分析用户意图,判断需要哪些类型的检索。然后并行向向量数据库和知识图谱发起查询------向量库负责找到语义相关的记忆条目,知识图谱负责找到结构化的实体关系。两路结果在路由器中融合去重后,注入 LLM 上下文生成最终回答。
并行检索是关键优化------如果串行执行,总延迟 = 向量检索延迟 + 图谱查询延迟。并行后,总延迟 = max(向量检索延迟, 图谱查询延迟)。在典型场景下可以节省 30-50% 的检索时间。
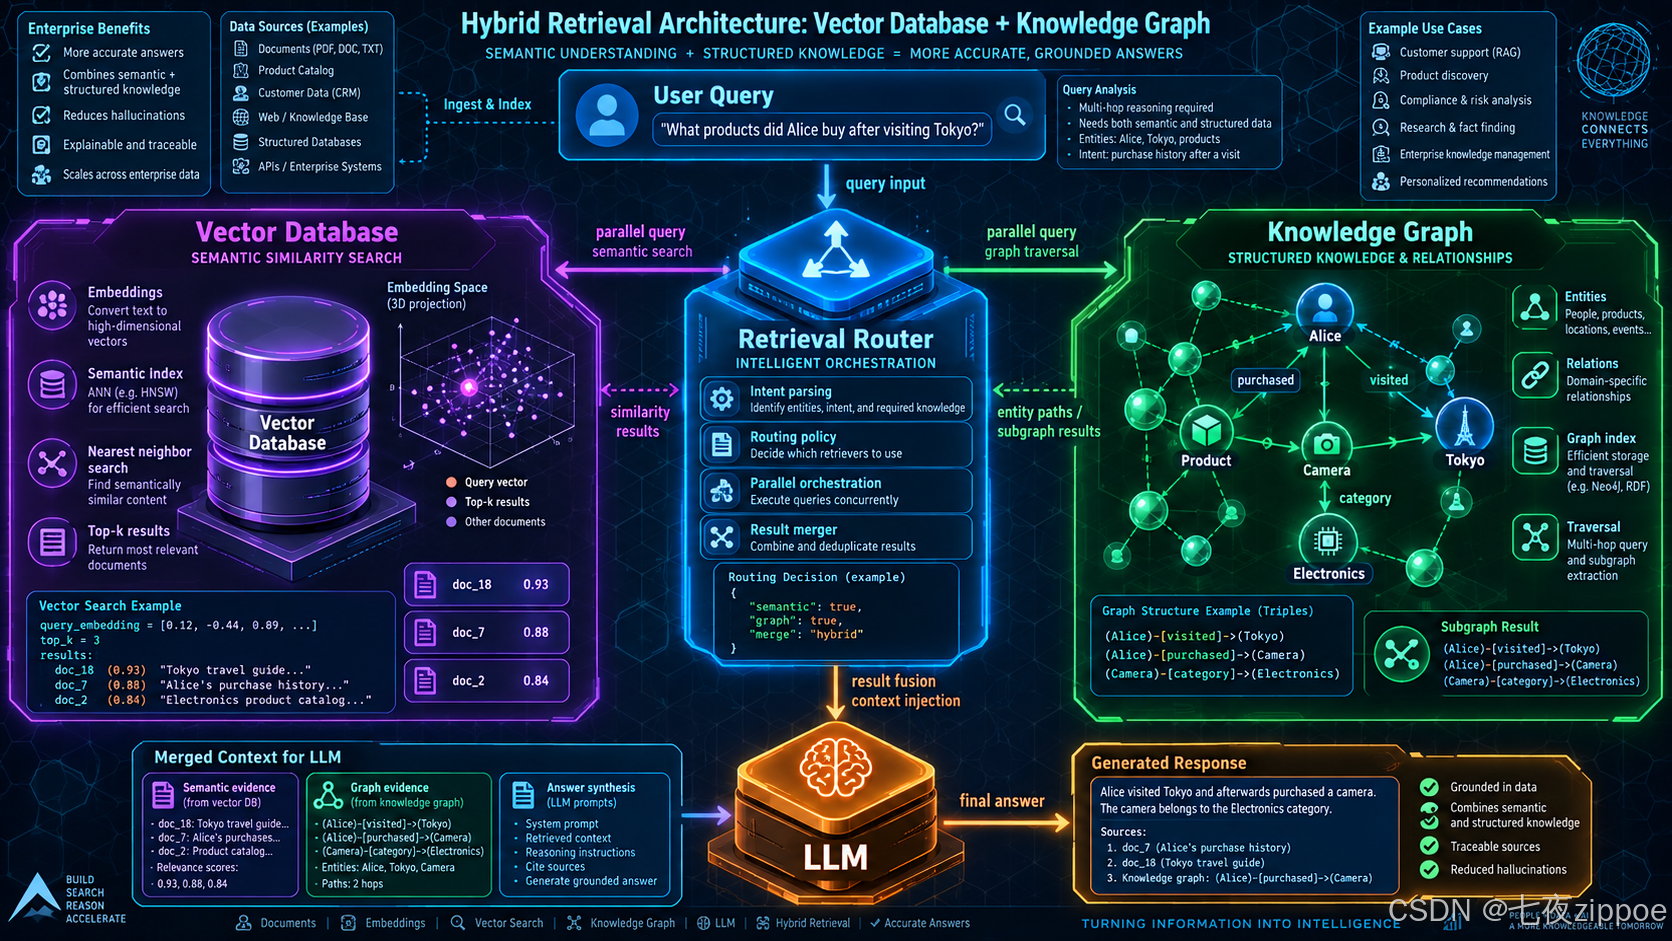
图:向量DB与知识图谱协同检索的系统架构
五、记忆的写入策略:什么该记住、什么该遗忘
5.1 写入决策的必要性
如果 Agent 把每轮对话都写入长期记忆,很快就会面临两个问题:一是存储成本无限增长,二是检索质量急剧下降------大量低价值记忆会稀释真正重要信息的检索排名。
因此,记忆系统需要一个"写入决策器":在每轮对话结束后,评估这轮对话是否值得写入长期记忆,以何种优先级写入。
5.2 记忆重要性评估模型
我们设计了一个多维度的记忆重要性评估模型:
| 评估维度 | 权重 | 评估方式 | 示例 |
|---|---|---|---|
| 信息独特性 | 0.30 | 与已有记忆的语义距离 | 全新话题 > 重复内容 |
| 用户情感强度 | 0.25 | 情感分析模型 | 强烈抱怨 > 随口一提 |
| 决策相关性 | 0.20 | 是否包含决策/选择 | "选方案B" > "看看方案A" |
| 实体密度 | 0.15 | 命名实体数量 | 多个实体 > 无实体 |
| 时效性 | 0.10 | 信息有效期 | 长期有效 > 临时信息 |
python
import numpy as np
from typing import Dict, List

class MemoryImportanceEvaluator:
    """
    记忆重要性评估器:决定一段对话是否值得写入长期记忆。

    评估维度:
    1. 信息独特性:与已有记忆的差异程度
    2. 用户情感强度:对话中表现出的情感强弱
    3. 决策相关性:是否包含决策、选择、偏好
    4. 实体密度:包含的命名实体数量
    5. 时效性:信息的有效时间跨度
    """

    def __init__(self, vector_store, embedding_model):
        self.vector_store = vector_store
        self.embedding_model = embedding_model

    def evaluate(self, content: str, existing_context: Dict = None) -> Dict:
        """
        评估一段内容的记忆价值。

        返回:
        {
            "should_store": True/False,
            "importance_score": 0.0-1.0,
            "memory_type": "episodic"/"semantic"/"preference",
            "reasons": [...]
        }
        """
        scores = {}

        # 1. 信息独特性:与已有记忆的最大相似度
        uniqueness = self._eval_uniqueness(content)
        scores["uniqueness"] = uniqueness  # 相似度越低,独特性越高

        # 2. 用户情感强度
        emotion = self._eval_emotion(content)
        scores["emotion"] = emotion

        # 3. 决策相关性
        decision = self._eval_decision(content)
        scores["decision"] = decision

        # 4. 实体密度
        entity_density = self._eval_entity_density(content)
        scores["entity_density"] = entity_density

        # 5. 时效性
        timeliness = self._eval_timeliness(content)
        scores["timeliness"] = timeliness

        # 加权综合评分
        weights = {
            "uniqueness": 0.30,
            "emotion": 0.25,
            "decision": 0.20,
            "entity_density": 0.15,
            "timeliness": 0.10
        }

        importance_score = sum(scores[k] * weights[k] for k in weights)

        # 存储阈值:0.3 以下不存储
        should_store = importance_score >= 0.3

        # 记忆类型判定
        memory_type = self._classify_type(content, scores)

        return {
            "should_store": should_store,
            "importance_score": round(importance_score, 3),
            "memory_type": memory_type,
            "scores": {k: round(v, 3) for k, v in scores.items()},
            "reasons": self._generate_reasons(scores)
        }

    def _eval_uniqueness(self, content: str) -> float:
        """
        评估信息独特性:与已有记忆的语义距离。

        如果内容与已有记忆高度相似,独特性低;反之独特性高。
        返回值:0-1,1表示完全独特(全新信息)
        """
        if self.vector_store is None:
            return 0.5

        # 检索最相似的已有记忆
        results = self.vector_store.query(query_texts=[content], n_results=1)

        if not results["documents"][0]:
            return 1.0  # 没有任何已有记忆,完全独特

        # 相似度距离(余弦距离,0=完全相同,2=完全不同)
        similarity = results["metadatas"][0][0].get("distance", 1.0)
        # 转换为独特性分数:距离越大,独特性越高
        uniqueness = min(max(similarity / 2.0, 0.0), 1.0)
        return uniqueness

    def _eval_emotion(self, content: str) -> float:
        """
        评估情感强度:使用关键词和标点模式。

        生产环境应使用专业情感分析模型。
        """
        strong_indicators = ["!", "?", "非常重要", "必须", "务必", "千万别",
                            "太好了", "太糟了", "最喜欢", "最讨厌"]
        score = sum(0.2 for ind in strong_indicators if ind in content)
        return min(score, 1.0)

    def _eval_decision(self, content: str) -> float:
        """评估是否包含决策或偏好选择。"""
        decision_indicators = ["选择", "决定", "方案", "倾向", "更喜欢",
                               "推荐", "不用", "改用", "确认"]
        score = sum(0.25 for ind in decision_indicators if ind in content)
        return min(score, 1.0)

    def _eval_entity_density(self, content: str) -> float:
        """评估命名实体密度。"""
        # 简化实现:基于大写字母和特定模式的启发式
        # 生产环境应使用 NER 模型
        words = content.split()
        entity_candidates = sum(1 for w in words if len(w) > 2 and w[0].isupper())
        density = min(entity_candidates / 10.0, 1.0)
        return density

    def _eval_timeliness(self, content: str) -> float:
        """评估信息时效性:长期有效信息得分高。"""
        temporary_indicators = ["今天", "现在", "刚才", "临时", "一会"]
        permanent_indicators = ["总是", "每次", "偏好", "习惯", "规则", "原则"]

        temp_score = sum(0.3 for ind in temporary_indicators if ind in content)
        perm_score = sum(0.3 for ind in permanent_indicators if ind in content)

        return min(max(perm_score - temp_score + 0.5, 0.0), 1.0)

    def _classify_type(self, content: str, scores: Dict) -> str:
        """分类记忆类型。"""
        if scores["decision"] > 0.5:
            return "preference"
        elif scores["entity_density"] > 0.5:
            return "semantic"
        else:
            return "episodic"

    def _generate_reasons(self, scores: Dict) -> List[str]:
        """生成评估理由(用于调试和可解释性)。"""
        reasons = []
        for dim, score in scores.items():
            if score > 0.7:
                reasons.append(f"高分维度:{dim}({score:.2f})")
            elif score < 0.2:
                reasons.append(f"低分维度:{dim}({score:.2f})")
return reasons这个评估器的核心价值在于让"什么该记住"这个决策变得可解释、可调优 。每个评估维度都是独立的,可以单独优化。比如 _eval_emotion 方法目前用的是关键词匹配,生产环境可以替换成专业的情感分析模型,而不影响其他维度的逻辑。
存储阈值 设为 0.3 是一个经验值。低于 0.3 的对话通常是一般的问答交互,不包含需要持久化的信息。例如"今天天气怎么样"的重要性评分可能只有 0.15------信息独特性低(每天都在问天气)、情感强度低、不包含决策、实体密度低、时效性也低。而"我们决定用 Redis 集群替代单机 Redis,预计QPS能提升3倍"的评分可能在 0.7 以上------独特性高、包含决策、有实体、长期有效。
5.3 主动遗忘机制
遗忘不是"删除记忆",而是降低其检索排名的优先级。完全删除可能导致信息丢失风险,主动遗忘通过以下方式实现:
方式一:重要性衰减。 随着时间推移,低重要性记忆的检索得分持续下降。如果一个记忆条目在 30 天内没有被检索命中,其重要性评分自动乘以 0.9 的衰减系数。
方式二:合并去重。 当检测到多条语义高度相似的记忆时,将它们合并为一条。例如"用户喜欢简洁回答"出现了5次,合并为一条重要性更高的记忆。
方式三:过期清理。 对于明确标注了有效期的记忆(如"用户当前在上海出差,预计周五返回"),过期后自动标记为"归档"状态,不再参与检索排序。
python
class MemoryConsolidator:
    """
    记忆固化器:定期执行遗忘与合并操作。

    灵感来源:人类睡眠期间的记忆固化过程------
    海马体在睡眠时回放白天的记忆,强化重要记忆,丢弃无关信息。
    """

    def __init__(self, vector_store, importance_threshold: float = 0.2,
                 similarity_threshold: float = 0.85, decay_factor: float = 0.95):
        self.vector_store = vector_store
        self.importance_threshold = importance_threshold
        self.similarity_threshold = similarity_threshold
        self.decay_factor = decay_factor

    def consolidate(self) -> Dict:
        """执行一轮记忆固化操作,返回统计信息。"""
        stats = {"decayed": 0, "merged": 0, "archived": 0}

        # 1. 重要性衰减
        stats["decayed"] = self._apply_decay()

        # 2. 合并相似记忆
        stats["merged"] = self._merge_similar()

        # 3. 归档过期记忆
        stats["archived"] = self._archive_expired()

        return stats

    def _apply_decay(self) -> int:
        """
        对未被访问的记忆应用衰减因子。

        规则:
        - 超过7天未被访问的记忆,重要性 *= 0.95
        - 重要性低于阈值的记忆标记为"inactive"
        - 被访问过的记忆不衰减(访问本身强化记忆)
        """
        # 遍历所有记忆,检查 last_accessed 时间
        # 实际项目中用批量更新操作
        count = 0
        # ... 实现略
        return count

    def _merge_similar(self) -> int:
        """
        合并语义高度相似的记忆条目。

        策略:
        - 对每条记忆,检索与其最相似的其他记忆
        - 如果相似度 > 0.85,合并为一条
        - 合并后的重要性 = max(两条) + 0.1(合并增强)
        - 删除被合并的冗余条目
        """
        count = 0
        # ... 实现略
        return count

    def _archive_expired(self) -> int:
        """归档过期的临时记忆。"""
        count = 0
        # ... 实现略
        return count
记忆固化器的设计灵感来自人类睡眠期间的记忆处理过程。人在睡眠时,海马体会回放白天的经历,强化重要记忆,弱化无关信息。这个过程在 Agent 系统中对应的是定期的后台批处理------可以在低峰期(如凌晨3点)执行,不影响在线服务的响应延迟。
六、记忆的检索策略:什么时候检索、检索什么
6.1 检索时机决策
不是每轮对话都需要检索长期记忆。频繁检索会增加延迟和成本,不检索又可能遗漏关键上下文。检索时机需要智能判断。
#mermaid-svg-Qpx80NIPGJ6XquM1{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-Qpx80NIPGJ6XquM1 .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-Qpx80NIPGJ6XquM1 .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-Qpx80NIPGJ6XquM1 .error-icon{fill:#552222;}#mermaid-svg-Qpx80NIPGJ6XquM1 .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-Qpx80NIPGJ6XquM1 .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-Qpx80NIPGJ6XquM1 .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-Qpx80NIPGJ6XquM1 .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-Qpx80NIPGJ6XquM1 .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-Qpx80NIPGJ6XquM1 .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-Qpx80NIPGJ6XquM1 .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-Qpx80NIPGJ6XquM1 .marker{fill:#333333;stroke:#333333;}#mermaid-svg-Qpx80NIPGJ6XquM1 .marker.cross{stroke:#333333;}#mermaid-svg-Qpx80NIPGJ6XquM1 svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-Qpx80NIPGJ6XquM1 p{margin:0;}#mermaid-svg-Qpx80NIPGJ6XquM1 defs #statediagram-barbEnd{fill:#333333;stroke:#333333;}#mermaid-svg-Qpx80NIPGJ6XquM1 g.stateGroup text{fill:#9370DB;stroke:none;font-size:10px;}#mermaid-svg-Qpx80NIPGJ6XquM1 g.stateGroup text{fill:#333;stroke:none;font-size:10px;}#mermaid-svg-Qpx80NIPGJ6XquM1 g.stateGroup .state-title{font-weight:bolder;fill:#131300;}#mermaid-svg-Qpx80NIPGJ6XquM1 g.stateGroup rect{fill:#ECECFF;stroke:#9370DB;}#mermaid-svg-Qpx80NIPGJ6XquM1 g.stateGroup line{stroke:#333333;stroke-width:1;}#mermaid-svg-Qpx80NIPGJ6XquM1 .transition{stroke:#333333;stroke-width:1;fill:none;}#mermaid-svg-Qpx80NIPGJ6XquM1 .stateGroup .composit{fill:white;border-bottom:1px;}#mermaid-svg-Qpx80NIPGJ6XquM1 .stateGroup .alt-composit{fill:#e0e0e0;border-bottom:1px;}#mermaid-svg-Qpx80NIPGJ6XquM1 .state-note{stroke:#aaaa33;fill:#fff5ad;}#mermaid-svg-Qpx80NIPGJ6XquM1 .state-note text{fill:black;stroke:none;font-size:10px;}#mermaid-svg-Qpx80NIPGJ6XquM1 .stateLabel .box{stroke:none;stroke-width:0;fill:#ECECFF;opacity:0.5;}#mermaid-svg-Qpx80NIPGJ6XquM1 .edgeLabel .label rect{fill:#ECECFF;opacity:0.5;}#mermaid-svg-Qpx80NIPGJ6XquM1 .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-Qpx80NIPGJ6XquM1 .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-Qpx80NIPGJ6XquM1 .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-Qpx80NIPGJ6XquM1 .edgeLabel .label text{fill:#333;}#mermaid-svg-Qpx80NIPGJ6XquM1 .label div .edgeLabel{color:#333;}#mermaid-svg-Qpx80NIPGJ6XquM1 .stateLabel text{fill:#131300;font-size:10px;font-weight:bold;}#mermaid-svg-Qpx80NIPGJ6XquM1 .node circle.state-start{fill:#333333;stroke:#333333;}#mermaid-svg-Qpx80NIPGJ6XquM1 .node .fork-join{fill:#333333;stroke:#333333;}#mermaid-svg-Qpx80NIPGJ6XquM1 .node circle.state-end{fill:#9370DB;stroke:white;stroke-width:1.5;}#mermaid-svg-Qpx80NIPGJ6XquM1 .end-state-inner{fill:white;stroke-width:1.5;}#mermaid-svg-Qpx80NIPGJ6XquM1 .node rect{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-Qpx80NIPGJ6XquM1 .node polygon{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-Qpx80NIPGJ6XquM1 #statediagram-barbEnd{fill:#333333;}#mermaid-svg-Qpx80NIPGJ6XquM1 .statediagram-cluster rect{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-Qpx80NIPGJ6XquM1 .cluster-label,#mermaid-svg-Qpx80NIPGJ6XquM1 .nodeLabel{color:#131300;}#mermaid-svg-Qpx80NIPGJ6XquM1 .statediagram-cluster rect.outer{rx:5px;ry:5px;}#mermaid-svg-Qpx80NIPGJ6XquM1 .statediagram-state .divider{stroke:#9370DB;}#mermaid-svg-Qpx80NIPGJ6XquM1 .statediagram-state .title-state{rx:5px;ry:5px;}#mermaid-svg-Qpx80NIPGJ6XquM1 .statediagram-cluster.statediagram-cluster .inner{fill:white;}#mermaid-svg-Qpx80NIPGJ6XquM1 .statediagram-cluster.statediagram-cluster-alt .inner{fill:#f0f0f0;}#mermaid-svg-Qpx80NIPGJ6XquM1 .statediagram-cluster .inner{rx:0;ry:0;}#mermaid-svg-Qpx80NIPGJ6XquM1 .statediagram-state rect.basic{rx:5px;ry:5px;}#mermaid-svg-Qpx80NIPGJ6XquM1 .statediagram-state rect.divider{stroke-dasharray:10,10;fill:#f0f0f0;}#mermaid-svg-Qpx80NIPGJ6XquM1 .note-edge{stroke-dasharray:5;}#mermaid-svg-Qpx80NIPGJ6XquM1 .statediagram-note rect{fill:#fff5ad;stroke:#aaaa33;stroke-width:1px;rx:0;ry:0;}#mermaid-svg-Qpx80NIPGJ6XquM1 .statediagram-note rect{fill:#fff5ad;stroke:#aaaa33;stroke-width:1px;rx:0;ry:0;}#mermaid-svg-Qpx80NIPGJ6XquM1 .statediagram-note text{fill:black;}#mermaid-svg-Qpx80NIPGJ6XquM1 .statediagram-note .nodeLabel{color:black;}#mermaid-svg-Qpx80NIPGJ6XquM1 .statediagram .edgeLabel{color:red;}#mermaid-svg-Qpx80NIPGJ6XquM1 #dependencyStart,#mermaid-svg-Qpx80NIPGJ6XquM1 #dependencyEnd{fill:#333333;stroke:#333333;stroke-width:1;}#mermaid-svg-Qpx80NIPGJ6XquM1 .statediagramTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-Qpx80NIPGJ6XquM1 :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} Agent启动
收到用户消息
简单问答/闲聊
需要历史上下文
检测到用户引用过去
直接生成回答
检索长期记忆
主动检索相关记忆
重排序后注入上下文
回复完成
Idle
Evaluating
Direct
Retrieving
Proactive
Responding
Ranking
判断依据:
-
用户是否引用了过去信息
-
当前话题是否需要历史背景
-
是否是首次提及的新话题
这个状态图描述了 Agent 在处理每条用户消息时的检索决策流程。三种状态转换路径分别对应不同的检索策略:
Direct 路径:对于简单的问答和闲聊,如"1+1等于几"或"今天天气不错",直接生成回答,不需要检索长期记忆。这避免了不必要的延迟和成本。
Retrieving 路径:当检测到当前话题需要历史背景时,触发检索。例如用户说"继续讨论上次的方案","继续"这个词明确引用了过去的信息。
Proactive 路径:即使用户没有明确引用过去,但如果检测到用户消息中包含可能需要历史上下文的关键词(如"我的""之前""那个"),也主动触发检索。
6.2 检索查询的构造
直接用用户原始消息作为检索查询往往效果不佳。用户消息可能包含指代词("那个方案")、省略语("效果如何")或口语化表达,这些都不利于向量检索。
python
class RetrievalQueryRewriter:
    """
    检索查询重写器:将用户原始消息重写为更适合向量检索的查询。

    重写策略:
    1. 指代消解:将"那个""上次"等替换为具体实体
    2. 上下文补充:补充省略的主语和宾语
    3. 关键词提取:提取核心语义关键词
    4. 多查询生成:从不同角度生成多个查询,提升召回率
    """

    def __init__(self, llm_client):
        self.llm = llm_client

    def rewrite(self, user_message: str, session_state: dict) -> List[str]:
        """
        将用户消息重写为检索查询列表。

        参数:
        - user_message: 用户原始消息
        - session_state: 当前会话状态(用于指代消解)

        返回:多个重写查询列表(用于多路检索)
        """
        prompt = f"""你是一个检索查询重写器。将用户消息重写为适合向量检索的查询。

用户消息:{user_message}
会话状态:{session_state}

重写规则:
1. 将指代词(那个、上次、之前讨论的)替换为具体实体
2. 补充省略的主语和宾语
3. 生成3个不同角度的查询变体,用换行分隔

输出格式(仅输出查询,不要解释):
查询1
查询2
查询3"""

        response = self.llm.invoke(prompt)
        queries = [q.strip() for q in response.split("\n") if q.strip()]
        return queries[:3]  # 最多3个查询

    def simple_rewrite(self, user_message: str, session_state: dict) -> str:
        """
        简单重写(不调用LLM,用于低成本场景)。

        基于规则替换指代词:
        - "那个" → session_state 中的最近实体
        - "上次" → session_state 中的最近话题
        """
        query = user_message
        slots = session_state.get("slots", {})

        # 简单的指代消解
        if "那个" in query and "last_topic" in slots:
            query = query.replace("那个", slots["last_topic"])
        if "上次" in query and "last_session_topic" in slots:
            query = query.replace("上次", slots["last_session_topic"])

        # 拼接当前话题上下文
        current_intent = session_state.get("current_intent", "")
        if current_intent and current_intent not in query:
            query = f"{current_intent} {query}"

return query查询重写器的核心价值在于提升检索召回率。用户说"那个方案效果怎么样"时,直接用这句话去向量库检索,可能检索到各种"方案"和"效果"相关的记忆,但未必是用户想问的那个。通过指代消解,将"那个方案"替换为会话状态中记录的具体方案名称(如"Redis缓存优化方案"),检索精度会大幅提升。
simple_rewrite 方法提供了不调用 LLM 的低成本替代方案,适用于对延迟敏感的场景。它基于简单的规则替换,效果不如 LLM 重写,但延迟从数百毫秒降到接近零。
6.3 检索结果的重排序
向量检索返回的结果需要进一步重排序,这是因为向量相似度不等于语义相关性------两段文本在向量空间中接近,但可能讲的是不同的事情。
python
from typing import List, Dict

class MemoryReranker:
    """
    记忆重排序器:对检索结果进行二次排序。

    重排序因子:
    1. 向量相似度(原始分数)
    2. 重要性权重
    3. 时间衰减因子
    4. 类型匹配度(用户意图与记忆类型的匹配)
    5. 多查询共识(多个查询都命中的记忆排名提升)
    """

    def rerank(self, query_results: List[List[Dict]],
               user_intent: str = None) -> List[Dict]:
        """
        对多路检索结果进行融合重排序。

        参数:
        - query_results: 多个查询的检索结果列表
        - user_intent: 当前用户意图(用于类型匹配)

        返回:重排序后的记忆列表
        """
        # 1. 合并去重
        merged = self._merge_and_deduplicate(query_results)

        # 2. 计算综合得分
        for item in merged:
            score = self._compute_final_score(item, user_intent)
            item["final_score"] = score

        # 3. 排序
        merged.sort(key=lambda x: x["final_score"], reverse=True)

        return merged

    def _merge_and_deduplicate(self, query_results: List[List[Dict]]) -> List[Dict]:
        """合并多路检索结果,去重并计算共识分数。"""
        memory_map = {}  # id -> item

        for results in query_results:
            for item in results:
                mem_id = item.get("metadata", {}).get("id", item.get("content", ""))
                if mem_id in memory_map:
                    # 多查询命中:提升共识分数
                    memory_map[mem_id]["consensus_score"] = memory_map[mem_id].get("consensus_score", 0) + 0.1
                else:
                    item["consensus_score"] = 0.0
                    memory_map[mem_id] = item

        return list(memory_map.values())

    def _compute_final_score(self, item: Dict, user_intent: str) -> float:
        """计算综合得分。"""
        similarity = item.get("score", 0.5)
        importance = item.get("metadata", {}).get("importance", 0.5)
        consensus = item.get("consensus_score", 0.0)

        # 时间衰减
        from datetime import datetime
        import math
        created_at = item.get("metadata", {}).get("created_at", "")
        time_decay = 0.5
        if created_at:
            try:
                created = datetime.fromisoformat(created_at)
                days_ago = (datetime.now() - created).days
                time_decay = math.exp(-math.log(2) * days_ago / 30)
            except:
                pass

        # 类型匹配度
        type_match = 1.0
        if user_intent and "memory_type" in item.get("metadata", {}):
            type_match = self._type_similarity(user_intent, item["metadata"]["memory_type"])

        # 加权求和
        final = (similarity * 0.35 +
                 importance * 0.25 +
                 time_decay * 0.15 +
                 consensus * 0.15 +
                 type_match * 0.10)

        return final

    def _type_similarity(self, intent: str, memory_type: str) -> float:
        """用户意图与记忆类型的匹配度。"""
        mapping = {
            "recall": {"episodic": 1.0, "semantic": 0.7, "preference": 0.3},
            "learn": {"semantic": 1.0, "episodic": 0.5, "preference": 0.3},
            "preference": {"preference": 1.0, "episodic": 0.4, "semantic": 0.6},
            "default": {"episodic": 0.7, "semantic": 0.7, "preference": 0.7}
        }
        return mapping.get(intent, mapping["default"]).get(memory_type, 0.5)
重排序器的 _compute_final_score 方法实现了一个五因子加权评分模型。每个因子的设计意图如下:
向量相似度(35%) 是基础分------如果查询和记忆在语义空间中都不接近,其他因素再高也没有意义。但这不应该是唯一因素,否则就退化为纯粹的向量检索。
重要性(25%) 让高价值记忆在同等相似度下排名更靠前。一次重要的架构决策比一次随意的闲聊更值得被检索到。
时间衰减(15%) 确保近期记忆有适度的排名优势。用户问"上次讨论的方案",大概率指的是最近的讨论而不是三个月前的。
多查询共识(15%) 是一个强有力的信号------如果多个不同角度的查询都命中了同一条记忆,说明这条记忆与用户意图高度相关。这个因子在多路检索中尤其有价值。
类型匹配(10%) 让记忆类型与用户意图匹配的记忆获得加分。用户回忆过去事件时,事件型记忆(episodic)比知识型记忆(semantic)更相关。
七、实战:一个完整的三层记忆系统实现
7.1 系统架构总览
将前面各节的组件整合起来,我们构建一个完整的三层记忆系统:
#mermaid-svg-nAiXX5WYq6hvLeG9{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;fill:#333;}@keyframes edge-animation-frame{from{stroke-dashoffset:0;}}@keyframes dash{to{stroke-dashoffset:0;}}#mermaid-svg-nAiXX5WYq6hvLeG9 .edge-animation-slow{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 50s linear infinite;stroke-linecap:round;}#mermaid-svg-nAiXX5WYq6hvLeG9 .edge-animation-fast{stroke-dasharray:9,5!important;stroke-dashoffset:900;animation:dash 20s linear infinite;stroke-linecap:round;}#mermaid-svg-nAiXX5WYq6hvLeG9 .error-icon{fill:#552222;}#mermaid-svg-nAiXX5WYq6hvLeG9 .error-text{fill:#552222;stroke:#552222;}#mermaid-svg-nAiXX5WYq6hvLeG9 .edge-thickness-normal{stroke-width:1px;}#mermaid-svg-nAiXX5WYq6hvLeG9 .edge-thickness-thick{stroke-width:3.5px;}#mermaid-svg-nAiXX5WYq6hvLeG9 .edge-pattern-solid{stroke-dasharray:0;}#mermaid-svg-nAiXX5WYq6hvLeG9 .edge-thickness-invisible{stroke-width:0;fill:none;}#mermaid-svg-nAiXX5WYq6hvLeG9 .edge-pattern-dashed{stroke-dasharray:3;}#mermaid-svg-nAiXX5WYq6hvLeG9 .edge-pattern-dotted{stroke-dasharray:2;}#mermaid-svg-nAiXX5WYq6hvLeG9 .marker{fill:#333333;stroke:#333333;}#mermaid-svg-nAiXX5WYq6hvLeG9 .marker.cross{stroke:#333333;}#mermaid-svg-nAiXX5WYq6hvLeG9 svg{font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:16px;}#mermaid-svg-nAiXX5WYq6hvLeG9 p{margin:0;}#mermaid-svg-nAiXX5WYq6hvLeG9 .label{font-family:"trebuchet ms",verdana,arial,sans-serif;color:#333;}#mermaid-svg-nAiXX5WYq6hvLeG9 .cluster-label text{fill:#333;}#mermaid-svg-nAiXX5WYq6hvLeG9 .cluster-label span{color:#333;}#mermaid-svg-nAiXX5WYq6hvLeG9 .cluster-label span p{background-color:transparent;}#mermaid-svg-nAiXX5WYq6hvLeG9 .label text,#mermaid-svg-nAiXX5WYq6hvLeG9 span{fill:#333;color:#333;}#mermaid-svg-nAiXX5WYq6hvLeG9 .node rect,#mermaid-svg-nAiXX5WYq6hvLeG9 .node circle,#mermaid-svg-nAiXX5WYq6hvLeG9 .node ellipse,#mermaid-svg-nAiXX5WYq6hvLeG9 .node polygon,#mermaid-svg-nAiXX5WYq6hvLeG9 .node path{fill:#ECECFF;stroke:#9370DB;stroke-width:1px;}#mermaid-svg-nAiXX5WYq6hvLeG9 .rough-node .label text,#mermaid-svg-nAiXX5WYq6hvLeG9 .node .label text,#mermaid-svg-nAiXX5WYq6hvLeG9 .image-shape .label,#mermaid-svg-nAiXX5WYq6hvLeG9 .icon-shape .label{text-anchor:middle;}#mermaid-svg-nAiXX5WYq6hvLeG9 .node .katex path{fill:#000;stroke:#000;stroke-width:1px;}#mermaid-svg-nAiXX5WYq6hvLeG9 .rough-node .label,#mermaid-svg-nAiXX5WYq6hvLeG9 .node .label,#mermaid-svg-nAiXX5WYq6hvLeG9 .image-shape .label,#mermaid-svg-nAiXX5WYq6hvLeG9 .icon-shape .label{text-align:center;}#mermaid-svg-nAiXX5WYq6hvLeG9 .node.clickable{cursor:pointer;}#mermaid-svg-nAiXX5WYq6hvLeG9 .root .anchor path{fill:#333333!important;stroke-width:0;stroke:#333333;}#mermaid-svg-nAiXX5WYq6hvLeG9 .arrowheadPath{fill:#333333;}#mermaid-svg-nAiXX5WYq6hvLeG9 .edgePath .path{stroke:#333333;stroke-width:2.0px;}#mermaid-svg-nAiXX5WYq6hvLeG9 .flowchart-link{stroke:#333333;fill:none;}#mermaid-svg-nAiXX5WYq6hvLeG9 .edgeLabel{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-nAiXX5WYq6hvLeG9 .edgeLabel p{background-color:rgba(232,232,232, 0.8);}#mermaid-svg-nAiXX5WYq6hvLeG9 .edgeLabel rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-nAiXX5WYq6hvLeG9 .labelBkg{background-color:rgba(232, 232, 232, 0.5);}#mermaid-svg-nAiXX5WYq6hvLeG9 .cluster rect{fill:#ffffde;stroke:#aaaa33;stroke-width:1px;}#mermaid-svg-nAiXX5WYq6hvLeG9 .cluster text{fill:#333;}#mermaid-svg-nAiXX5WYq6hvLeG9 .cluster span{color:#333;}#mermaid-svg-nAiXX5WYq6hvLeG9 div.mermaidTooltip{position:absolute;text-align:center;max-width:200px;padding:2px;font-family:"trebuchet ms",verdana,arial,sans-serif;font-size:12px;background:hsl(80, 100%, 96.2745098039%);border:1px solid #aaaa33;border-radius:2px;pointer-events:none;z-index:100;}#mermaid-svg-nAiXX5WYq6hvLeG9 .flowchartTitleText{text-anchor:middle;font-size:18px;fill:#333;}#mermaid-svg-nAiXX5WYq6hvLeG9 rect.text{fill:none;stroke-width:0;}#mermaid-svg-nAiXX5WYq6hvLeG9 .icon-shape,#mermaid-svg-nAiXX5WYq6hvLeG9 .image-shape{background-color:rgba(232,232,232, 0.8);text-align:center;}#mermaid-svg-nAiXX5WYq6hvLeG9 .icon-shape p,#mermaid-svg-nAiXX5WYq6hvLeG9 .image-shape p{background-color:rgba(232,232,232, 0.8);padding:2px;}#mermaid-svg-nAiXX5WYq6hvLeG9 .icon-shape .label rect,#mermaid-svg-nAiXX5WYq6hvLeG9 .image-shape .label rect{opacity:0.5;background-color:rgba(232,232,232, 0.8);fill:rgba(232,232,232, 0.8);}#mermaid-svg-nAiXX5WYq6hvLeG9 .label-icon{display:inline-block;height:1em;overflow:visible;vertical-align:-0.125em;}#mermaid-svg-nAiXX5WYq6hvLeG9 .node .label-icon path{fill:currentColor;stroke:revert;stroke-width:revert;}#mermaid-svg-nAiXX5WYq6hvLeG9 :root{--mermaid-font-family:"trebuchet ms",verdana,arial,sans-serif;} 第三层:长期记忆
第二层:会话记忆
第一层:工作记忆
维护
维护
维护
超出窗口
会话结束/重要信息
should_store=true
实体关系
检索结果
图查询结果
重排序后
状态上下文
WorkingMemory
滑动窗口管理器
当前LLM上下文
SessionMemory
会话状态管理器
ConversationState
结构化状态槽
RecentTurns
最近5轮对话
LongTermMemory
向量存储
KnowledgeGraph
知识图谱
ImportanceEvaluator
写入评估器
MemoryReranker
重排序器
用户输入
这张架构图展示了三层记忆的数据流。工作记忆是最外层,直接与 LLM 交互。会话记忆在工作记忆之下,接收被工作记忆淘汰的消息并维护结构化状态。长期记忆是最底层,通过写入评估器决定哪些信息需要持久化,通过重排序器将检索结果注入回工作记忆。
7.2 完整系统集成
python
from typing import Optional, Dict, List, Any
from dataclasses import dataclass, field
from datetime import datetime
import logging

logger = logging.getLogger(__name__)

@dataclass
class MemoryConfig:
    """记忆系统配置。"""
    # 工作记忆
    working_memory_max_messages: int = 20
    working_memory_max_tokens: int = 8000

    # 会话记忆
    session_max_recent_turns: int = 5
    session_summary_interval: int = 10  # 每10轮生成一次摘要

    # 长期记忆
    long_term_top_k: int = 5
    importance_threshold: float = 0.3
    similarity_threshold: float = 0.85
    decay_half_life_days: int = 30

    # 检索
    enable_query_rewrite: bool = True
    enable_reranking: bool = True
    enable_proactive_retrieval: bool = True


class MemorySystem:
    """
    完整的三层记忆系统。

    整合工作记忆、会话记忆和长期记忆,提供统一的记忆管理接口。

    使用方式:
        memory = MemorySystem(config)
        memory.start_session("session_001")

        # 每轮对话
        memory.add_user_message("帮我订一张明天去北京的机票")
        context = memory.get_llm_context()  # 获取注入LLM的上下文
        # ... 调用LLM生成回复 ...
        memory.add_assistant_message("已为您查询到...")

        # 会话结束
        memory.end_session()
    """

    def __init__(self, config: MemoryConfig = None, llm_client=None):
        self.config = config or MemoryConfig()
        self.llm = llm_client

        # 初始化三层记忆
        self.working_memory = WorkingMemory(
            max_messages=self.config.working_memory_max_messages,
            max_tokens=self.config.working_memory_max_tokens
        )

        self.session_memory: Optional[SessionMemory] = None

        # 长期记忆组件(延迟初始化,需要时才连接向量库)
        self._long_term_memory = None
        self._knowledge_graph = None
        self._importance_evaluator = None
        self._reranker = MemoryReranker()
        self._query_rewriter = RetrievalQueryRewriter(llm_client) if llm_client else None

    def start_session(self, session_id: str) -> None:
        """开始新的会话。"""
        self.session_memory = SessionMemory(session_id)
        logger.info(f"Session started: {session_id}")

    def add_user_message(self, content: str) -> None:
        """添加用户消息到记忆系统。"""
        # 1. 写入工作记忆
        self.working_memory.add_message("user", content)

        # 2. 写入会话记忆
        if self.session_memory:
            self.session_memory.state.last_updated = datetime.now()
            # 更新会话状态(实际项目中由 LLM 或规则引擎更新)

        # 3. 主动检索长期记忆(如果启用)
        if self.config.enable_proactive_retrieval and self._should_retrieve(content):
            self._proactive_retrieve(content)

    def add_assistant_message(self, content: str, tool_calls: List = None) -> None:
        """添加助手回复到记忆系统。"""
        self.working_memory.add_message("assistant", content)
        if self.session_memory:
            self.session_memory.add_turn(
                user_input="",  # 实际使用时传入
                assistant_response=content,
                tool_calls=tool_calls
            )

    def get_llm_context(self) -> List[Dict]:
        """
        获取完整的 LLM 上下文。

        包含:
        - 系统提示词
        - 会话状态摘要
        - 长期记忆检索结果(如有)
        - 工作记忆中的最近对话
        """
        context = self.working_memory.get_context()

        # 注入会话状态
        if self.session_memory:
            session_ctx = self.session_memory.get_context_for_llm()
            # 插入到系统提示之后、对话之前
            context.insert(1, {"role": "system", "content": session_ctx})

        return context

    def _should_retrieve(self, user_message: str) -> bool:
        """判断是否需要主动检索长期记忆。"""
        # 指示词检测
        retrieve_indicators = ["上次", "之前", "那个", "我的", "记得", "我们讨论过", "你之前"]
        return any(ind in user_message for ind in retrieve_indicators)

    def _proactive_retrieve(self, user_message: str) -> None:
        """主动检索长期记忆并注入工作记忆。"""
        if not self._long_term_memory:
            return

        try:
            # 查询重写
            if self._query_rewriter and self.config.enable_query_rewrite:
                queries = self._query_rewriter.rewrite(
                    user_message,
                    self.session_memory.state.to_dict() if self.session_memory else {}
                )
            else:
                queries = [user_message]

            # 多路检索
            all_results = []
            for query in queries:
                results = self._long_term_memory.retrieve(
                    query=query,
                    top_k=self.config.long_term_top_k
                )
                all_results.append(results)

            # 重排序
            if self.config.enable_reranking and len(all_results) > 1:
                merged = self._reranker.rerank(all_results)
            else:
                merged = all_results[0] if all_results else []

            # 注入工作记忆
            if merged:
                memory_context = "相关历史记忆:\n" + "\n".join(
                    f"- {m['content']}" for m in merged[:3]
                )
                self.working_memory.add_message("system", memory_context)
                logger.info(f"Retrieved {len(merged)} memories for context")

        except Exception as e:
            logger.warning(f"Proactive retrieval failed: {e}")

    def end_session(self) -> None:
        """结束会话,将重要信息写入长期记忆。"""
        if not self.session_memory:
            return

        # 评估并写入长期记忆
        if self._long_term_memory and self._importance_evaluator:
            self._consolidate_session_to_long_term()

        logger.info(f"Session ended: {self.session_memory.session_id}")

    def _consolidate_session_to_long_term(self) -> None:
        """将会话中的重要信息固化到长期记忆。"""
        turns = self.session_memory.recent_turns

        for turn in turns:
            content = f"用户: {turn.get('user', '')}\n助手: {turn.get('assistant', '')}"

            # 重要性评估
            evaluation = self._importance_evaluator.evaluate(content)

            if evaluation["should_store"]:
                record = MemoryRecord(
                    content=content,
                    memory_type=evaluation["memory_type"],
                    importance=evaluation["importance_score"],
                    created_at=datetime.now().isoformat(),
                    last_accessed=datetime.now().isoformat(),
                    access_count=0,
                    related_entities=[],  # 实际项目中由 NER 提取
                    source_session=self.session_memory.session_id,
                    metadata={"evaluation": evaluation["scores"]}
                )
                self._long_term_memory.store(record)
                logger.info(f"Stored memory: type={evaluation['memory_type']}, "
                           f"importance={evaluation['importance_score']:.2f}")

    def get_memory_stats(self) -> Dict:
        """获取记忆系统的统计信息。"""
        return {
            "working_memory": {
                "message_count": len(self.working_memory.messages),
                "total_tokens": self.working_memory._total_tokens(),
                "summary_count": len(self.working_memory.summaries)
            },
            "session_memory": {
                "session_id": self.session_memory.session_id if self.session_memory else None,
                "turn_count": len(self.session_memory.recent_turns) if self.session_memory else 0,
                "current_intent": self.session_memory.state.current_intent if self.session_memory else None,
                "slot_count": len(self.session_memory.state.slots) if self.session_memory else 0
            },
            "long_term_memory": {
                "available": self._long_term_memory is not None,
                "collection_name": "agent_memories" if self._long_term_memory else None
            }
        }
这个 MemorySystem 类是三层记忆系统的统一入口。设计上有几个值得注意的点:
延迟初始化长期记忆 :向量数据库和知识图谱的连接是重量级操作,_long_term_memory 和 _knowledge_graph 采用延迟初始化策略,只在第一次需要时才建立连接。这对于短会话或不需要长期记忆的简单任务来说,避免了不必要的资源开销。开发者可以通过 get_memory_stats() 方法检查各层记忆的状态。
主动检索的指示词检测 :_should_retrieve 方法用一组中文关键词("上次""之前""那个"等)来判断是否需要触发长期记忆检索。这是一种低成本的启发式策略------不需要调用 LLM,纯字符串匹配,延迟几乎为零。虽然会有误判(如"那个东西不错"可能不涉及历史记忆),但宁可多检索也不漏检索,因为漏检索的代价远大于多检索的成本。
异常容错设计 :_proactive_retrieve 方法用 try-except 包裹了整个检索流程。如果向量数据库不可用或查询失败,Agent 不会崩溃,而是降级为"无长期记忆"模式继续工作。这在生产环境中至关重要------记忆系统是增强组件,不应成为系统的单点故障。
会话结束时的记忆固化 :end_session 方法触发 _consolidate_session_to_long_term,遍历会话中的每轮对话,用重要性评估器决定是否写入长期记忆。这确保了有价值的信息不会随会话结束而丢失。
7.3 使用示例与效果分析
让我们通过一个完整的使用场景来验证系统的运作效果:
python
# 场景:一个技术助手Agent,跨多个会话服务同一用户

# 第一次会话:用户讨论架构决策
memory = MemorySystem(MemoryConfig(), llm_client=llm)
memory.start_session("session_001")

memory.add_user_message("我们决定用Redis集群替代单机Redis,预计QPS能从3000提升到9000")
# 主动检索:未检测到历史引用词,跳过长期记忆检索
# 工作记忆:[user: 我们决定用Redis集群...]

memory.add_assistant_message("这是一个很好的架构决策。Redis集群方案需要考虑数据分片策略...")
# 工作记忆:[user: ..., assistant: ...]

memory.end_session()
# 会话固化:重要性评估
# - 决策相关性:包含"决定" → 高分
# - 实体密度:Redis, QPS → 高分
# - 时效性:长期有效 → 高分
# 综合评分 > 0.7,写入长期记忆 ✓

# ===== 第二次会话:用户引用过去信息 =====
memory.start_session("session_002")

memory.add_user_message("上次讨论的那个Redis方案,效果怎么样了?")
# 主动检索:检测到"上次"和"那个" → 触发检索
# 查询重写:将"那个Redis方案"消解为"Redis集群替代单机Redis方案"
# 向量检索:命中session_001中存储的记忆
# 注入工作记忆:[system: 相关历史记忆:我们决定用Redis集群替代单机Redis...]

# 此时LLM上下文包含:
# 1. 系统提示词
# 2. 会话状态(空,新会话)
# 3. 检索到的历史记忆(Redis集群方案)
# 4. 当前用户消息
# LLM能够生成有上下文的回答

memory.add_assistant_message("上次我们讨论了用Redis集群替代单机Redis的方案,预计QPS从3000提升到9000。需要我帮您检查当前的实施进度吗?")

stats = memory.get_memory_stats()
print(stats)
# 输出示例:
# {
#   "working_memory": {"message_count": 3, "total_tokens": 450, "summary_count": 0},
#   "session_memory": {"session_id": "session_002", "turn_count": 1, "current_intent": None, "slot_count": 0},
#   "long_term_memory": {"available": true, "collection_name": "agent_memories"}
# }
这段使用示例展示了记忆系统的完整生命周期。第一次会话中,用户做了一个架构决策,系统在会话结束时评估其重要性并写入长期记忆。第二次会话中,用户引用了"上次"和"那个",触发了主动检索,系统从长期记忆中找到相关信息并注入上下文,使 LLM 能够生成有针对性的回答。
整个过程对用户是透明的------用户不需要手动提供上下文,系统自动完成了"记住→检索→注入"的全流程。
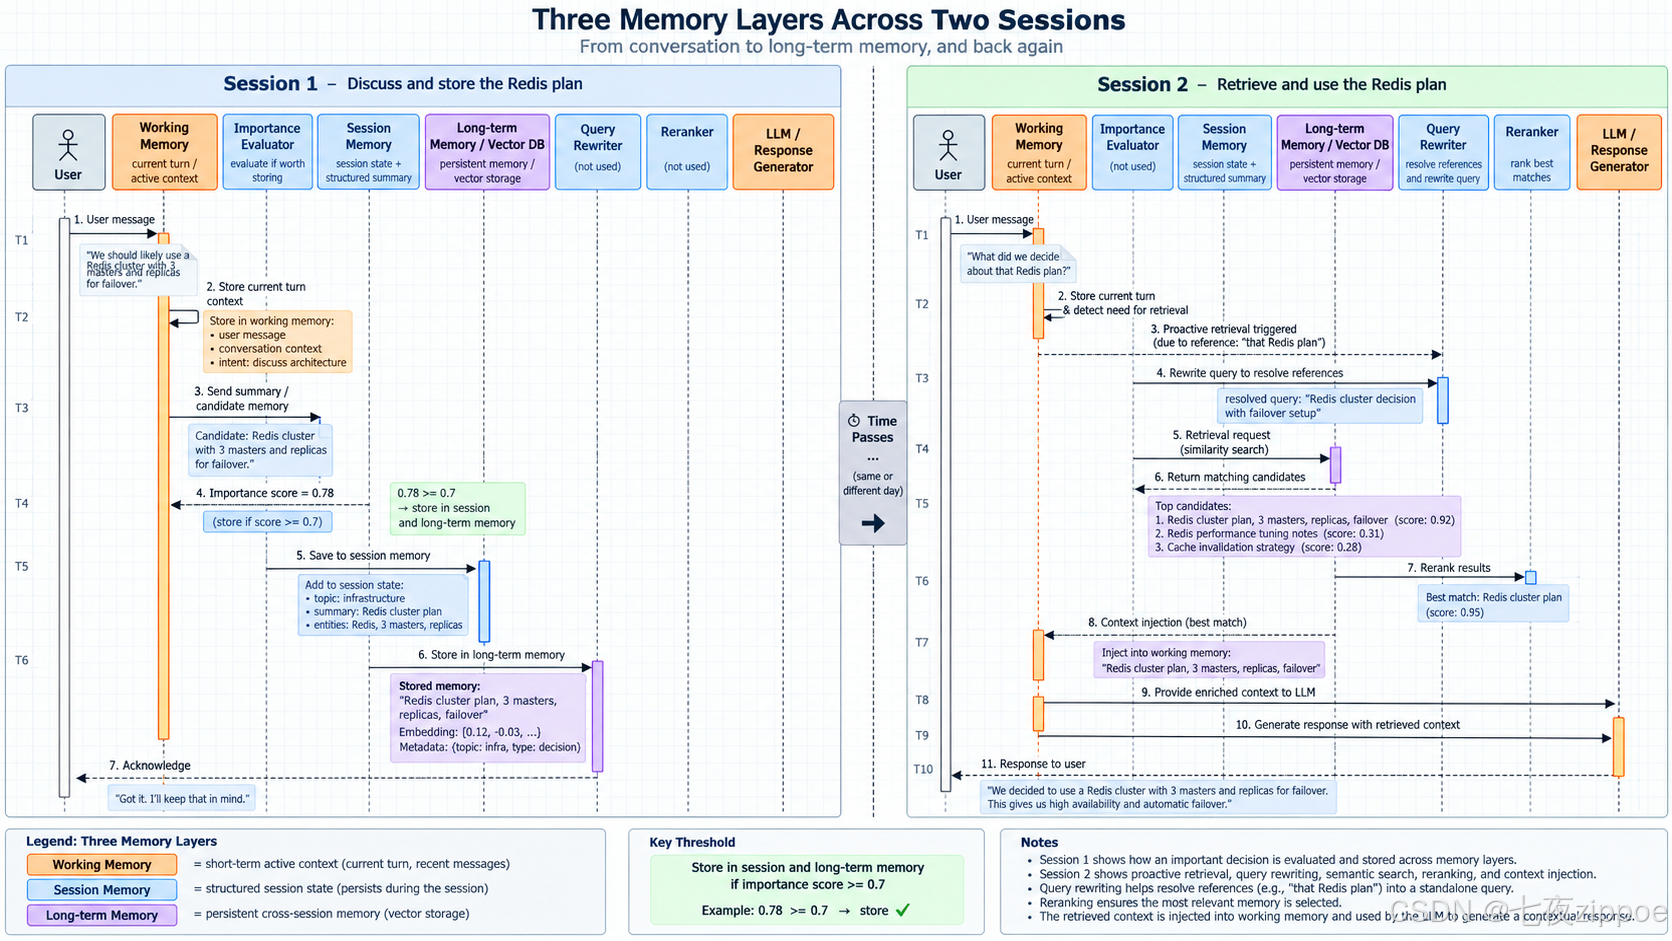
图:三层记忆系统在跨会话场景下的完整数据流
八、适用边界与风险提示
8.1 适用场景
本文设计的分层记忆系统适用于以下场景:
场景一:长期运行的对话助手。 如个人助理、技术顾问等需要持续服务同一用户的 Agent。记忆系统让 Agent 能够记住用户偏好、历史决策和上下文,提供个性化服务。
场景二:任务导向的 Agent 系统。 如客服机器人、工单处理 Agent 等。这类系统需要跨会话追踪任务状态、记住用户的诉求历史。会话记忆的状态槽设计特别适合这类场景。
场景三:知识积累型 Agent。 如研发助手、代码审查 Agent 等。这类系统需要从交互中积累知识------哪些方案被采纳了、哪些问题反复出现、用户的技术栈偏好等。长期记忆的向量+图谱混合检索能很好地支持这类需求。
8.2 不适用场景与局限性
⚠️ 以下场景不适合直接使用本文的系统设计:
超低延迟场景(<100ms响应时间)。 记忆系统的检索流程(查询重写+向量检索+重排序)会增加 200-500ms 的延迟。对于需要毫秒级响应的场景(如实时翻译、高频交易),应简化或跳过记忆检索。
数据安全敏感场景。 向量数据库中的记忆条目以明文形式存储(即使向量化了,原始文本也需要保存)。如果涉及个人隐私数据(医疗、金融),需要额外的加密和脱敏处理,本文未覆盖这部分设计。
多用户共享场景。 本文的设计假设单一用户。如果是多用户共享的 Agent,需要增加用户隔离层------每个用户的长期记忆应该独立存储和检索,避免跨用户的记忆泄露。
⚠️ 技术局限性:
| 局限性 | 影响 | 缓解方向 |
|---|---|---|
| Embedding 模型的语义理解有限 | 检索可能返回语义相近但含义不同的记忆 | 使用更高质量的 Embedding 模型;增加重排序精度 |
| 知识图谱的实体抽取依赖 LLM | 抽取质量受 LLM 能力限制,可能产生错误三元组 | 人工审核+定期清洗;使用专门的 NER 模型 |
| 时间衰减模型过于简化 | 30天半衰期不一定适合所有类型的信息 | 按记忆类型设置不同的半衰期 |
| 重要性评估的阈值是静态的 | 0.3 的存储阈值不一定适合所有场景 | 引入动态阈值调整机制 |
8.3 性能与成本考量
记忆系统的运行成本主要来自三个方面:
Embedding 调用成本: 每次存储和检索记忆都需要调用 Embedding 模型。使用 OpenAI 的 text-embedding-3-small 模型,1000 条记忆的存储成本约 0.02,1000 次检索约 0.01。对于高频使用的 Agent,这是可控但需要关注的成本项。
LLM 调用成本: 查询重写、会话摘要、重要性评估都需要调用 LLM。这些调用的频率应该被控制------不是每轮对话都需要查询重写和重要性评估。可以通过规则过滤减少不必要的 LLM 调用。
存储成本: 向量数据库的存储成本取决于记忆条目数量和向量维度。使用 1536 维的 text-embedding-3-small,10000 条记忆约占 60MB 磁盘空间。对于中小规模应用,本地持久化即可;大规模应用需要考虑分布式向量数据库方案。
九、总结
回到文章开头提出的问题:AI Agent 如何实现像人类一样的记忆能力?
答案是分层架构 + 智能决策。
工作记忆对应 LLM 的上下文窗口,通过滑动窗口策略管理当前推理上下文。它的核心挑战是容量有限,解决方案是消息淘汰+摘要压缩。关键设计决策包括:使用双端队列实现 O(1) 淘汰、系统提示词永不淘汰、同时控制消息数量和 token 数量。
会话记忆负责跨轮对话的状态保持,通过结构化状态槽替代完整历史消息。它的核心价值是"结构化状态优于完整历史"------用 key-value 对存储关键信息,比保留全部对话节省 80% 以上的 token,且检索更精确。会话摘要的触发采用定期+话题切换+token阈值三重策略。
长期记忆 基于向量数据库+知识图谱的混合架构,实现跨会话的知识持久化。向量数据库擅长语义模糊检索,知识图谱擅长结构化关系查询,两者并行检索、融合排序。综合评分公式 similarity×0.5 + importance×0.3 + time_decay×0.2 平衡了相关性、重要性和时效性。
但记忆系统的核心不只是"存储",更是智能决策------什么该记住(重要性评估)、什么时候检索(检索时机决策)、检索什么(查询重写)、如何排序(五因子重排序)、什么该遗忘(主动遗忘机制)。这些决策机制让记忆系统从"被动的数据仓库"升级为"主动的认知引擎"。
需要强调的是,本文的实现是教学性质的,适合理解原理和原型验证。生产环境部署时,还需要考虑以下工程化问题:向量数据库的高可用部署、并发写入的锁竞争、Embedding 模型的版本兼容、记忆数据的备份与恢复、用户隐私数据的加密存储等。这些内容超出了本文的范畴,但同样是记忆系统成功落地的关键。
记忆系统是 AI Agent 从"能聊天的玩具"走向"可信赖的助手"的核心基础设施。希望本文的分层架构设计和工程实现,能为你构建 Agent 系统提供有价值的参考。
参考资料
- Kahneman, D. (2011). Thinking, Fast and Slow. Farrar, Straus and Giroux. --- 双系统理论的经典著作
- Liu, N.F. et al. (2023). Lost in the Middle: How Language Models Use Long Contexts. arXiv:2307.03172 --- LLM 上下文中间遗忘现象的研究
- Ebbinghaus, H. (1885). Memory: A Contribution to Experimental Psychology --- 遗忘曲线的经典实验
- ChromaDB 官方文档:https://docs.trychroma.com/ --- 向量数据库的实现与使用
- LangChain Memory 模块文档:https://python.langchain.com/docs/modules/memory/ --- Agent 记忆系统的框架实现
- Neo4j 图数据库文档:https://neo4j.com/docs/ --- 生产级知识图谱方案
- Park, J.S. et al. (2023). Generative Agents: Interactive Simulacra of Human Behavior. arXiv:2304.03442 --- Stanford 团队的 Agent 记忆系统设计,本文的很多灵感来源于此
- OpenAI Embedding 模型文档:https://platform.openai.com/docs/guides/embeddings --- Embedding 模型的使用与性能对比