Cosmos Curator 清洗视频时,哪些片段应该留下?
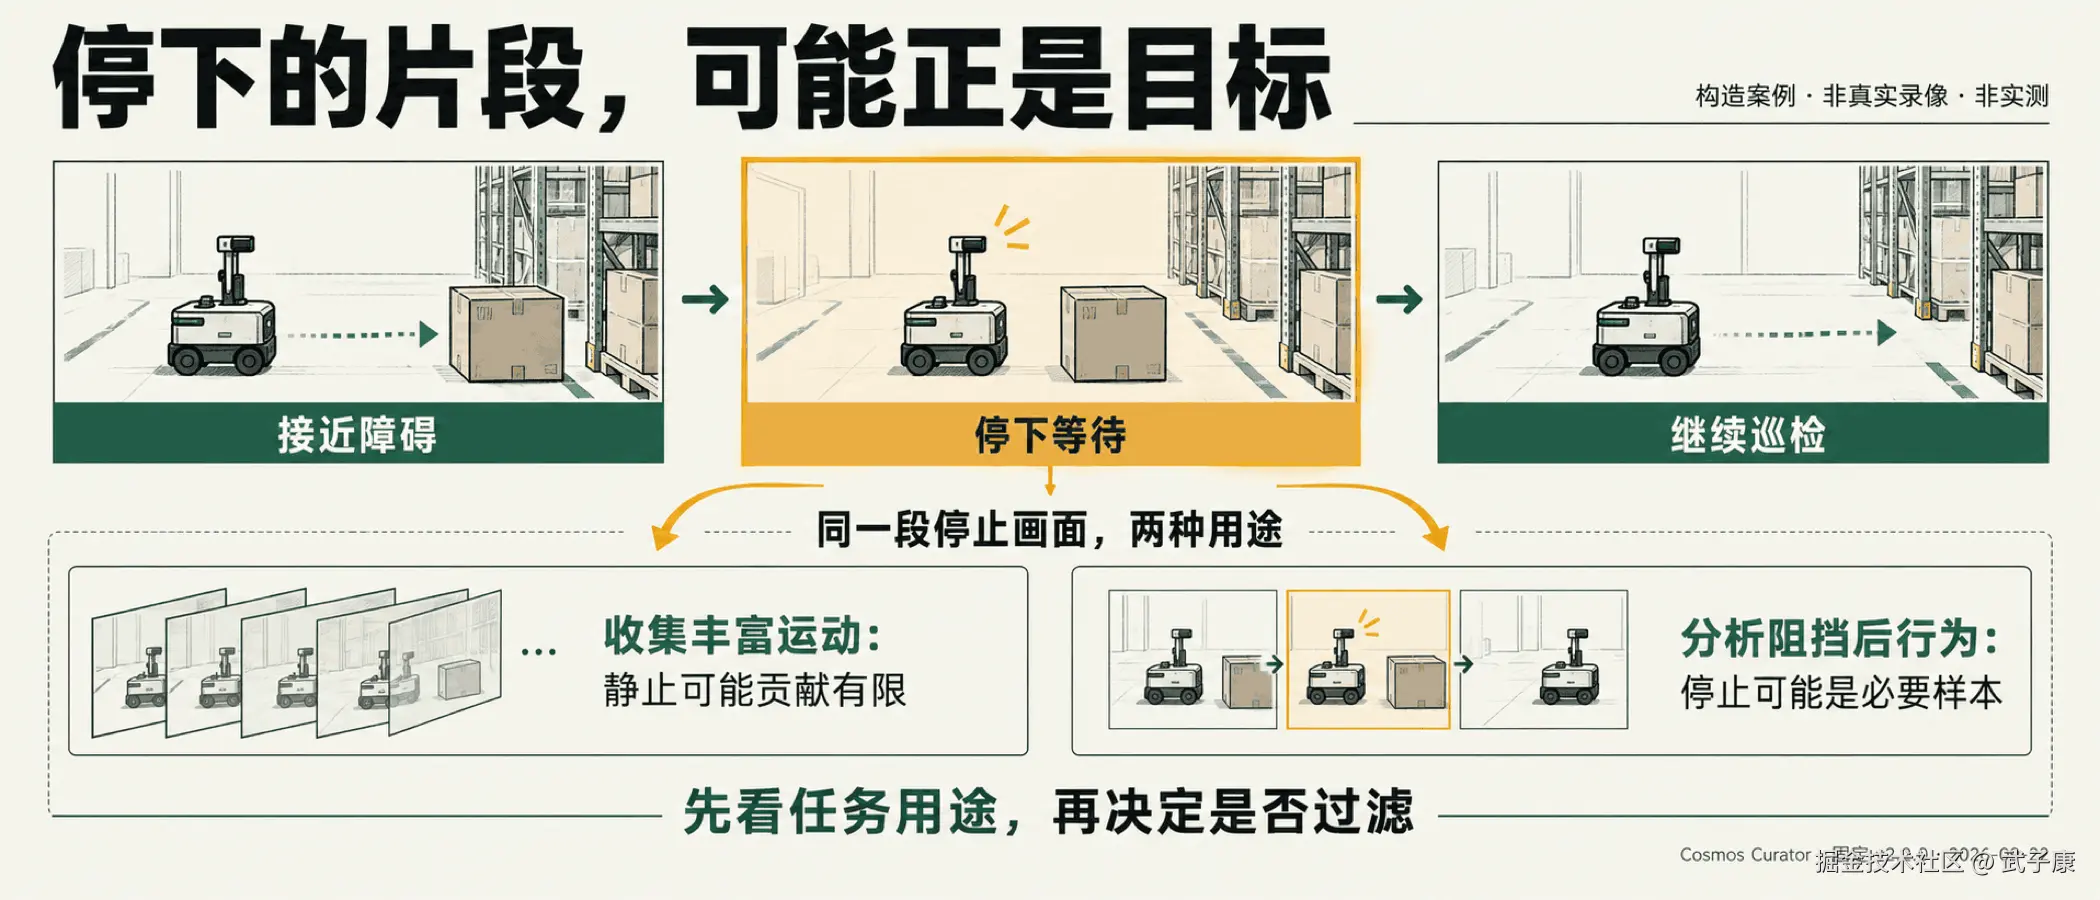
假设一个机器人团队准备整理仓库里的巡检录像。画面中大量时间只有货架和地面,真正值得研究的瞬间却很短:机器人停在障碍物前、夹爪接触后没有移动,或者门已经打开,机器人仍然等待。团队想先过滤"几乎没有运动"的片段,再让视觉语言模型生成描述,以节省后面的处理开销。
这个顺序很合理,也藏着一个问题:停止和等待可能正是任务要解释的行为。如果片段在前面被筛掉,后面的模型就没有机会替它说明"为什么没动"。留下的视频更活跃,不能直接说明数据更适合训练。
NVIDIA Cosmos Curator 的固定实现把这个取舍摆得很清楚:运动过滤排在 Embedding 和 Captioning 之前;同一个低运动判断,在 score-only 模式下保留片段,在过滤模式下则把它移入另一组。还有一种更容易混淆的情况:没有得到运动解码数据时,代码会使用占位分数参与判断。本文沿这些路径讨论第一次清洗应该怎样验收,而不是把所有模型和过滤器都打开。
下文核对的是官方 cosmos-curate 仓库 v2.2.0,提交 de89c5e4,资料访问日期为 2026-09-22。它是一个固定版本分析,不表示最新版本。巡检录像是构造案例,本文没有运行流水线、测试 GPU 吞吐或验证模型训练收益。
先看片段在哪一步离开流水线
Cosmos Curator 面向视频处理与整理,底层使用 Cosmos-Xenna 和 Ray。它可以把原始视频加工成片段、元数据和模型派生产物;语义去重、训练数据打包则还有相应的后续流水线。本文只讨论最前面的片段筛选,暂不把"能生成训练文件"视为"已经得到有效训练集"。^1^
官方阶段文档给出的顺序是先 Ingest、Split、Transcode,再按配置加入运动、美学、文字和语义等过滤,随后生成向量与描述,最后写出结果。它列出的是逻辑块,某一块可能由多个 CPU、GPU 阶段组成,并不表示每次运行都执行相同数量的 Worker。^2^
其中 Split 和 Transcode 也有不同职责。前者确定片段在源视频里的时间范围;后者才把片段编码成后续阶段使用的独立视频载荷。这意味着验收不能只数"切出了多少个片段":有了时间范围,和确实产生了可以打开的片段文件,是两个需要分别检查的事实。^2^
把与本次问题有关的节点抽出来,可以得到下面的关系:
| 位置 | 这一步得到什么 | 对筛选验收的意义 |
|---|---|---|
| 切分与转码 | 片段范围及编码后的视频载荷 | 先能追溯、能观看,才有人工核对基础 |
| 运动过滤 | 运动分数,以及继续处理或转入过滤集合的决定 | 低分的业务含义必须由数据用途解释 |
| 向量与描述 | 后续模型对继续处理片段的派生信息 | 不能指望它们补回已经被上游移走的片段 |
| 结果写出 | 保留片段、过滤片段及相应记录 | 验收要检查实际产物,不能只看阶段完成 |
这不是建议固定采用某一种处理顺序,而是要求理解当前配置的后果。过滤提前,可以少处理一部分片段;代价是后续信息不再覆盖全部原始候选。只有先说明哪些内容允许提前排除,省下来的计算才有明确意义。
score-only 保留的是一次比较机会
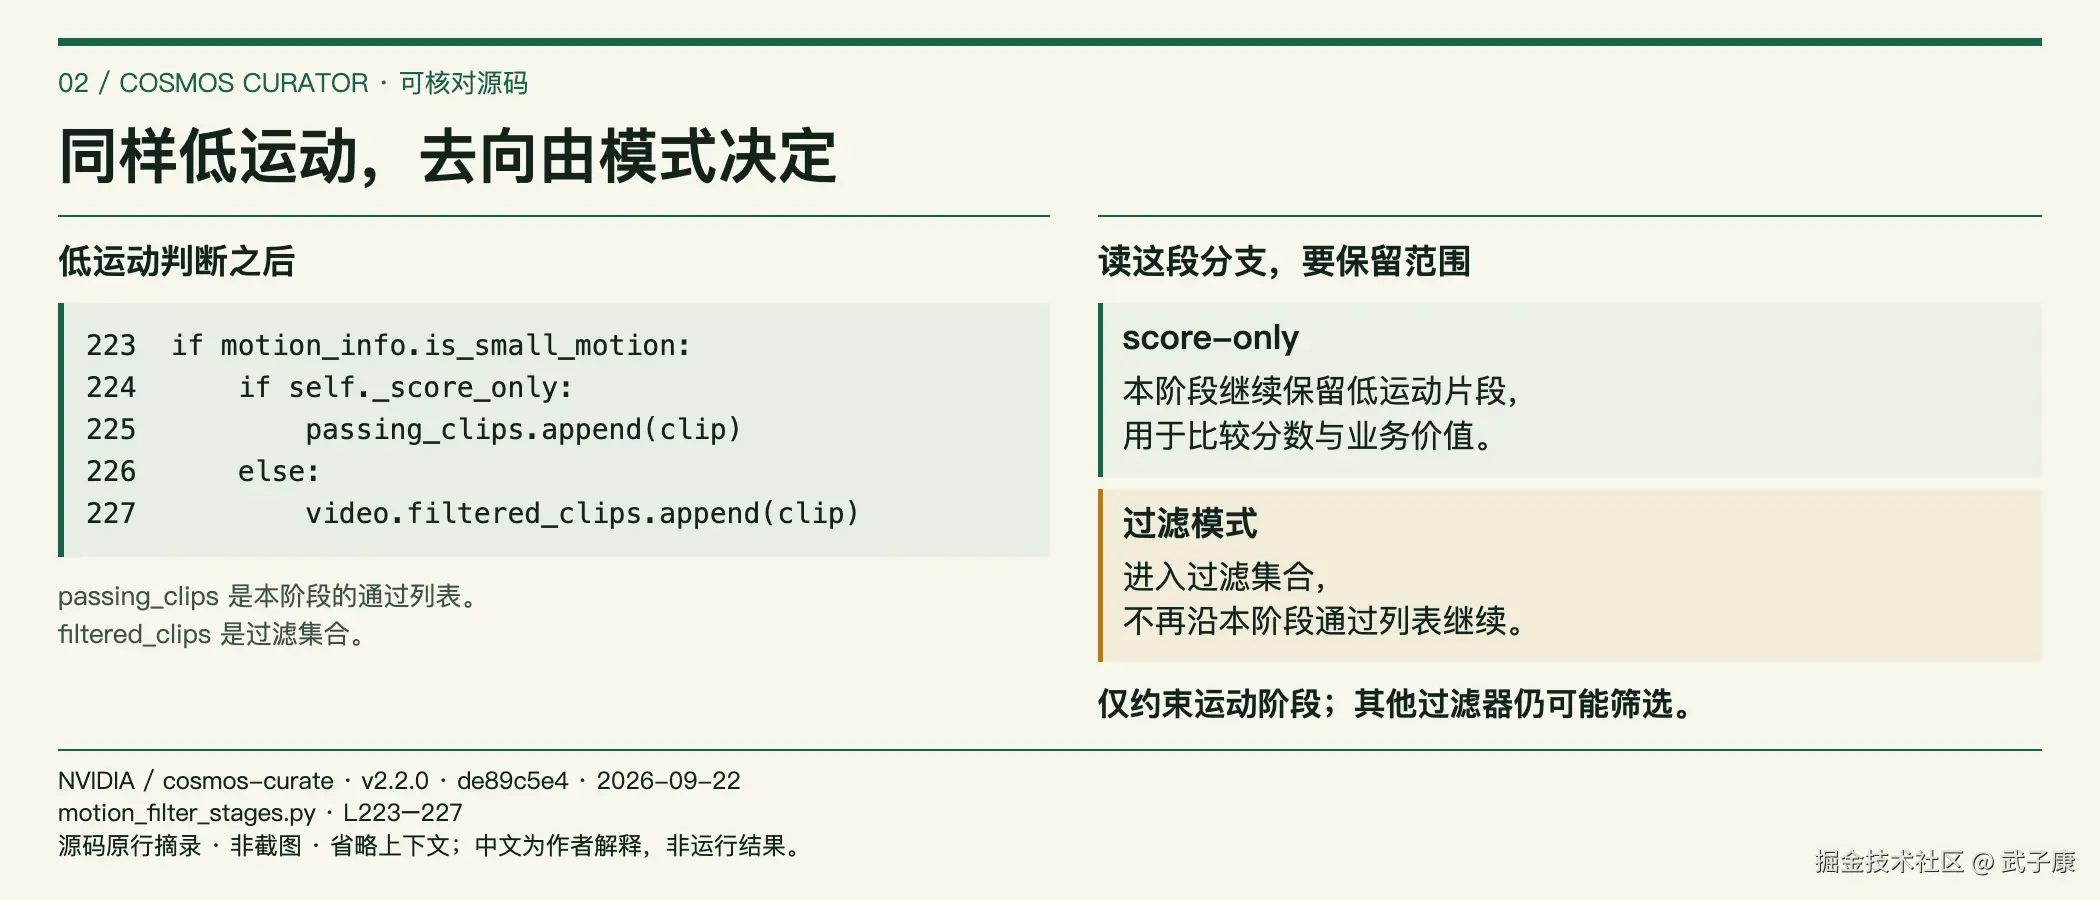
运动过滤实现会先为片段设置两类运动分数字段,再根据低运动判断决定去向。关键分支可以缩写为下面这段原样摘录,外围上下文已省略:^3^
python
if motion_info.is_small_motion:
    if self._score_only:
        passing_clips.append(clip)
    else:
        video.filtered_clips.append(clip)
这里最重要的区别不是有没有得到分数,而是低运动片段是否仍在后续处理集合里。函数最后把 passing_clips 赋回当前视频的片段列表。先打分而不在这一阶段排除,可以保留观察分数与业务价值关系的机会。
但 score-only 不是整个任务的"安全开关"。它约束的是这个运动过滤分支;如果同时启用了其他过滤器,那些阶段仍然可能改变留下的片段。官方也分别定义不同过滤器的控制方式,不能假定一个参数会把整条流水线变成只观察、不筛选。^4^
因此,第一次比较需要固定配置。假如第一次只计算运动分数,第二次除了启用运动过滤,又增加了美学和文字筛选,那么输出变化已经无法单独归因于运动阈值。即便片段少了一半,也不知道是哪一个阶段移走了哪些内容。
一个更小的实验是先选择明确的一组源视频,固定切分方式和模型设置,记录所有片段的来源范围与分数。人工看过相应样本后,再仅改变运动过滤的一个决定。这个步骤是作者建议的验证设计,并非本文已经完成的对照实验;它的价值在于让"为什么少了这段"成为可回答的问题。
这种比较也有成本。暂时保留低运动片段,会增加后续处理和人工查看的投入。数据规模特别大时,不需要先对所有录像运行昂贵的描述模型;可以从覆盖主要场景的小样本开始,只保留回答当前筛选问题所需的产物。观察模式服务于决策,而不是永久把所有计算重复一遍。
一个负分,可能是没有测到运动
看分数分布时,还有一个比调阈值更早的问题:这些数字是否都来自有效测量?
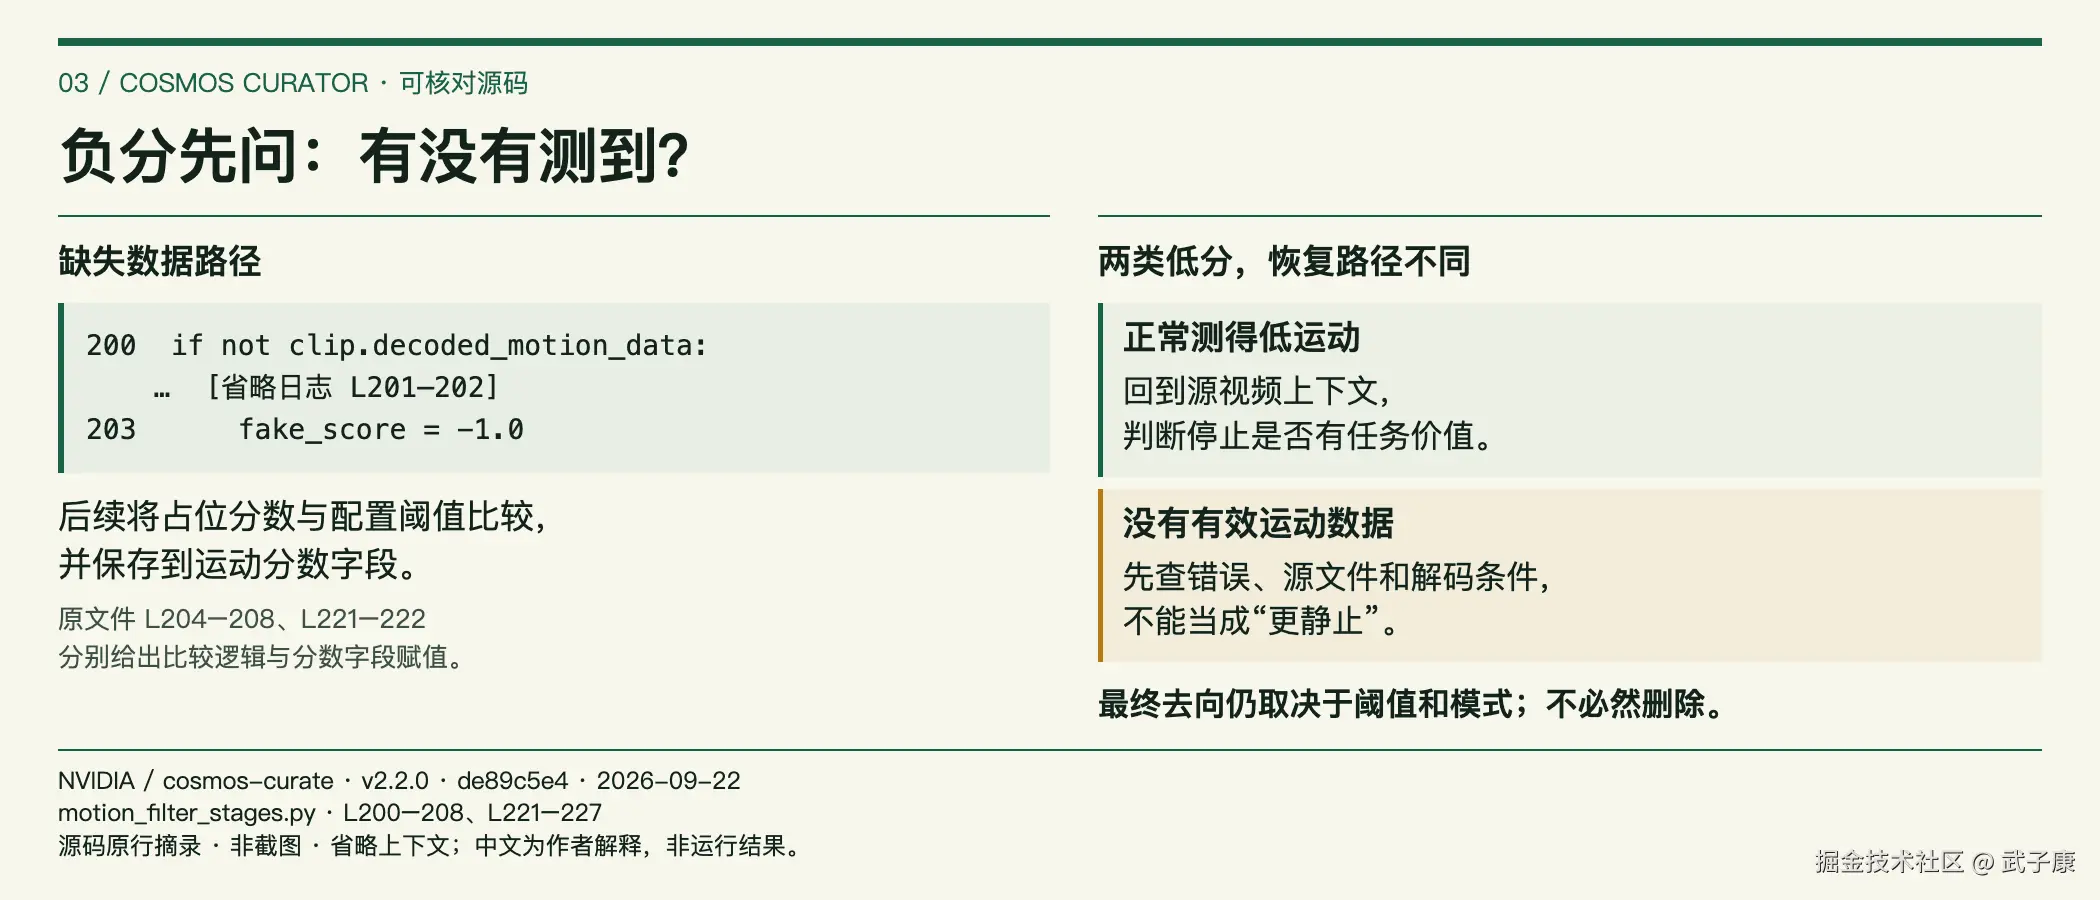
在所核对的 MotionFilterStage 中,如果片段没有 decoded_motion_data,代码不会沿正常运动计算路径继续,而是构造 fake_score = -1.0,用它与配置阈值比较。之后,这两个运动分数字段仍会被写到片段上。前置解码阶段对没有运动帧等情况还会记录错误信息。^3^
因此,看到一个很低的数,至少存在两种不同解释:片段确实被测为低运动,或者没有拿到用于测量的运动数据。后一种不是"更静止",而是测量路径有缺口。若把它们放进同一个直方图,再选一个看似自然的分界,配置就可能在替处理失败作业务决定。
具体会不会被移走,仍取决于阈值与运行模式。代码用占位分数同阈值比较,不能把这个分支概括成"任何解码失败都必然删除";在 score-only 路径下,触发低运动判断的片段仍会保留在通过列表。配置类提供了默认值,但这些默认值同样不是针对你的录像校准过的阈值。^5^
对巡检案例,假设某类摄像头的录像集中落入这个缺失数据分支。此时先调宽运动阈值,可能让更多片段留下,却没有解释为何这一来源的测量不完整。更应该先检查相关错误记录、源文件是否可播放,以及解码配置与输入是否匹配。本文没有观测到这样的实际故障;这个推演说明为什么异常来源应该单独看。
验收记录中可以把"正常测得低分""没有有效运动数据""还未人工判断"分开保存。它们都可能暂时不进入默认训练集,但原因不同,恢复路径也不同:第一类需要讨论筛选目标,第二类先处理数据或运行问题,第三类需要补充审阅。不要让一个数值替这三种状态作最终裁决。
用一次停车事件检查筛选目标
回到那段构造的巡检录像:机器人接近货架拐角,前方出现障碍物,随后停下等待。这里没有真实时长、分数和训练效果,只有一个用于讨论筛选策略的场景。
如果任务是收集丰富的视觉运动,长时间不变化的画面可能贡献有限;如果任务是分析机器人遇到阻挡后的行为,停车片段可能恰好承载重要信息。这不是两套工具谁更聪明,而是同一片段对应不同的数据用途。运动分数描述某个可计算特征,数据价值则还取决于目标任务。
切分方式会进一步改变看到的东西。按固定时间切分,可能把接近、停止和恢复分到不同片段;按场景边界切分,也不保证边界正好等于机器人行为的起止。官方支持不同切分路径,但并没有因此承诺切分结果就是业务事件。^2^
所以人工审核时,不应只播放孤立的低分片段。可以从记录的源视频和时间范围返回前后上下文,确认这次停止是在等待障碍消失、完成动作后的稳定停留,还是没有相关行为的静态镜头。若只看一个静止画面,审核者也可能和过滤器一样看不到动作关系。
这个核对不需要一开始就接入完整机器人状态系统。第一轮可以依赖可追溯的视频片段,承认单看画面无法解释的部分。若结论确实需要动作命令、传感器或任务状态,再补充对应时间对齐材料;不能让自动描述为视频中不可见的原因编一个解释。
例如,描述模型生成"机器人等待行人通过",并不证明画面外确有行人,也不证明控制器采用了某一种让行策略。更合适的记录是区分可见现象与待核对原因:画面中机器人停止、前方存在可见障碍,以及是否有人为指令等尚未确认的条件。描述便于检索,但业务标签仍需要其对应的证据。
沿这个案例,读者最终需要作出的决定应当足够具体:这类停止片段是否属于目标任务的必要样本;如果属于,现有筛选设置是否会把它们排除;为了回答这个问题,还缺哪些上下文。只有这三个问题得到解释,才值得讨论把规则推广到更多录像。
过滤集合不是已经完成的回收站
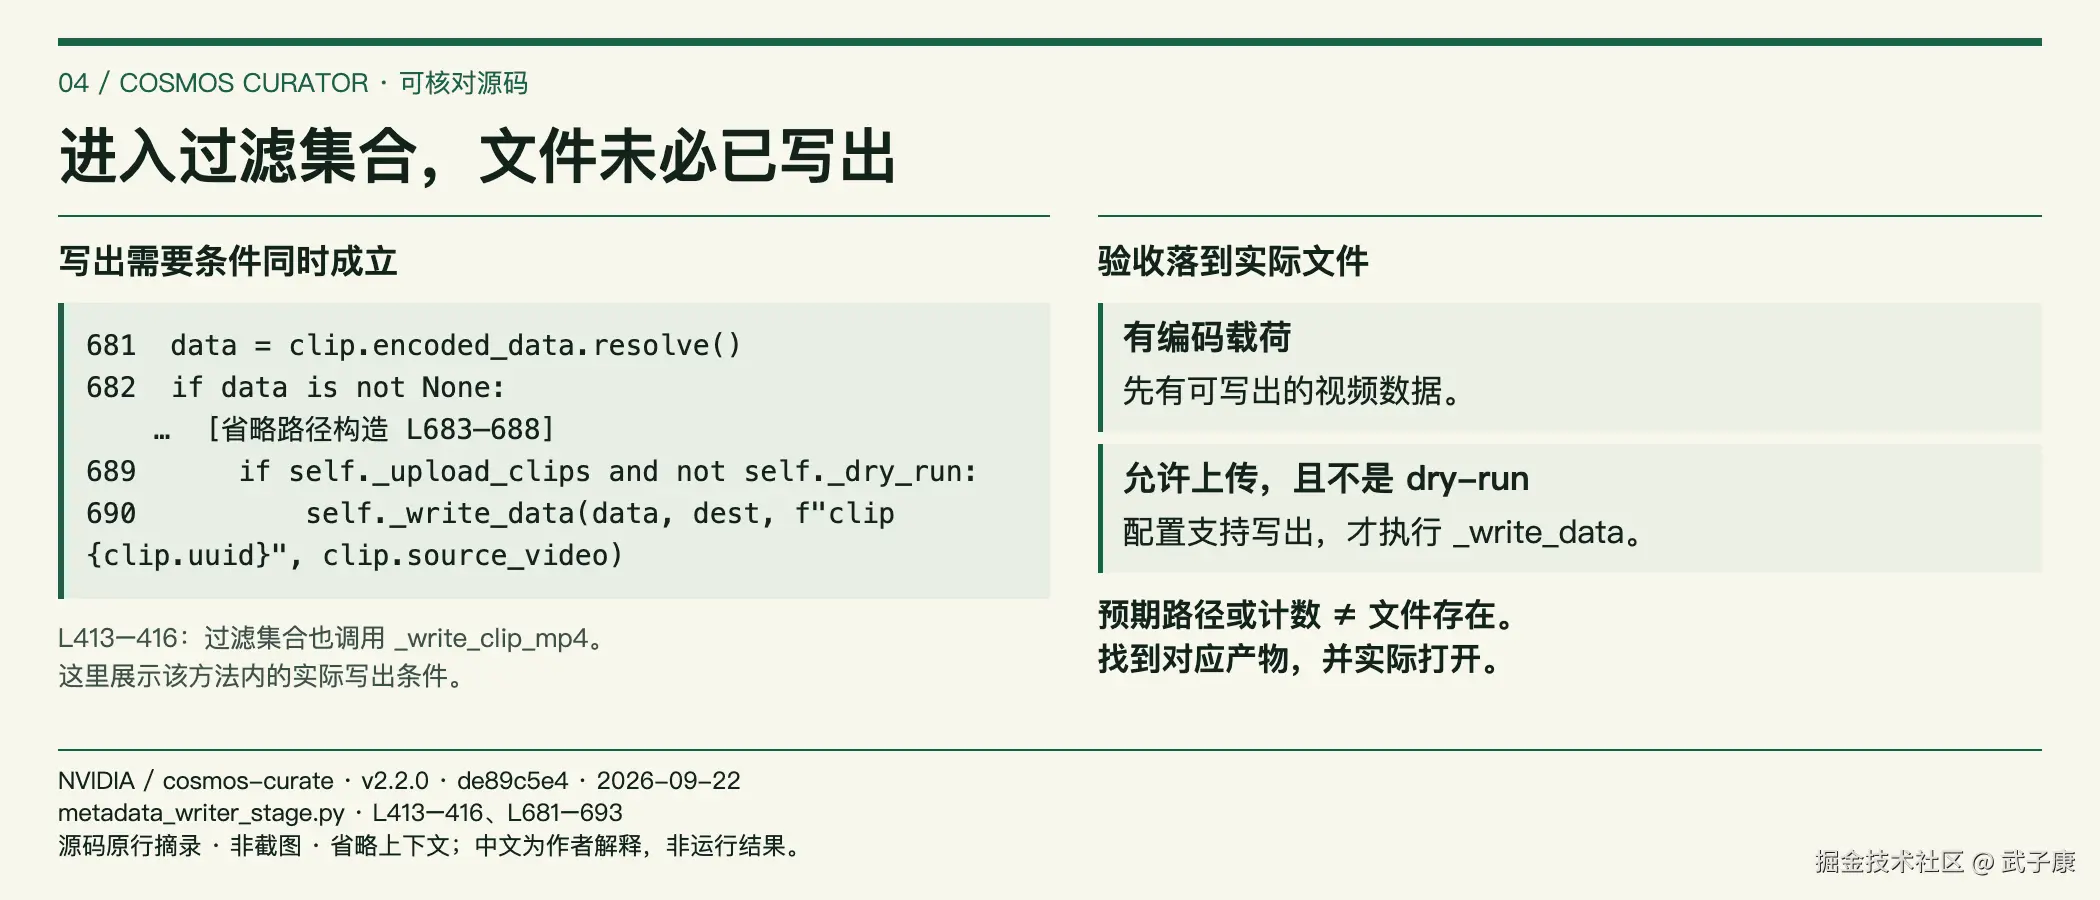
代码把片段放进 filtered_clips,并不等同于立刻销毁源文件。固定版本的 Writer 同时遍历保留集合和过滤集合,为过滤片段安排相应写出路径;它也能够写出运动分数等元数据。^6^
这为检查误筛提供了基础,但不能把"实现有分支"当成"这次运行已经完整保留"。视频写出还依赖编码载荷存在、上传选项与 dry-run 等条件。也就是说,看见目录设计或统计计数,仍不足以证明每个被过滤片段都能重新打开。^6^
对第一次清洗,我更关心一条片段记录能否走通:从结果找到它的来源视频与时间范围,知道它在哪一轮配置下被如何处理,然后实际打开需要复核的内容。记录里可以留实际产物位置,也可以明确某个产物未生成;不能把预期路径当成已经存在的证据。
如果原始录像仍然保留,某些缺少派生产物的片段可以从来源重做。但重做也不是无条件可逆:输入可能被替换,切分参数可能变化,模型版本可能更新。因此需要冻结或标识用于这次比较的源文件与关键配置,避免两轮恰好同名的输出其实指向不同输入。
这不意味着第一轮就要搭建完整的数据治理平台。少量样本可以先用一个清楚的目录和记录文件,只要能够区分来源、运行和产物。复杂的对象存储生命周期、权限审批和长期保留策略,应在规模与业务需要出现时再展开。当前要解决的是能否解释一次筛选,而不是先补齐所有基础设施。
被过滤片段的保留也要有边界。全部副本永久留下,会增加存储、访问管理和隐私成本。可以在合法持有并允许处理的数据上,为待核对样本设置明确的保存范围与期限;已确认不需要保留的派生产物,再按团队既有规则处理。这里的建议不是额外的数据采集或公开分享许可。
一份片段复核记录,比删除比例更有用
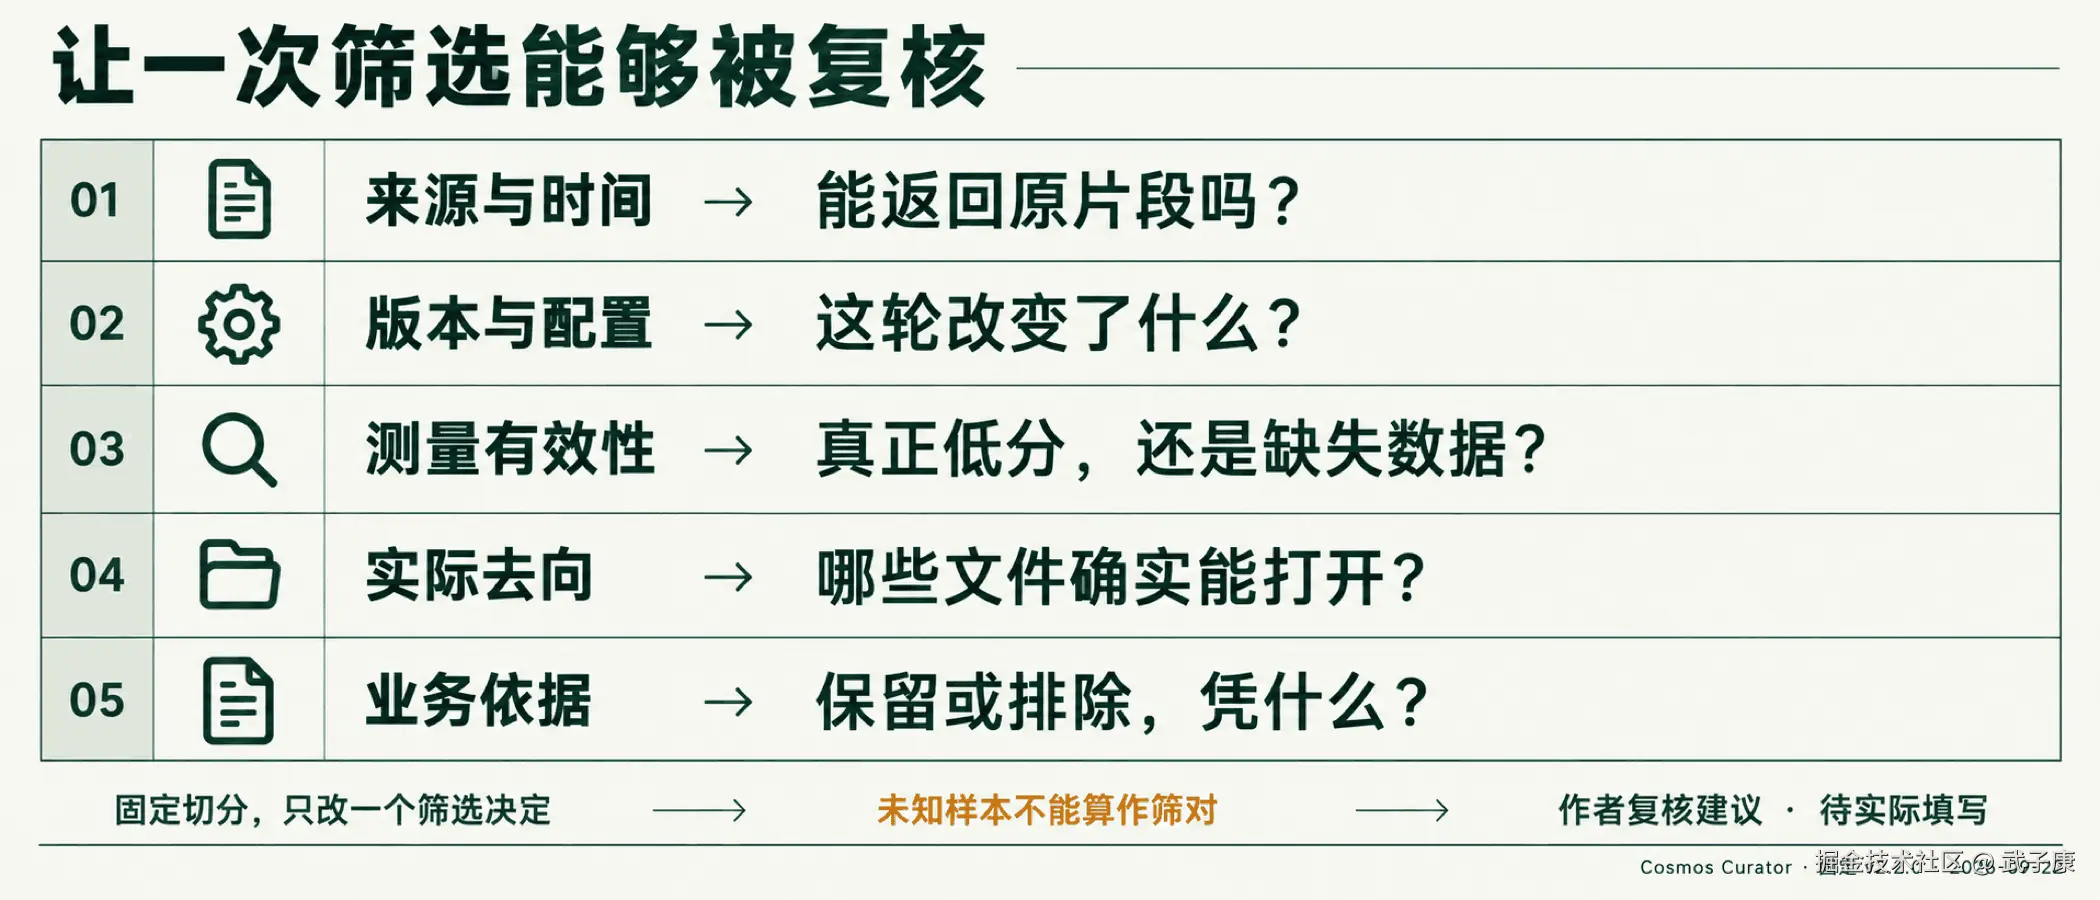
第一次验收可以围绕一份记录开展。下面的字段是作者提出的最小工作表,不是声称官方直接生成了相同格式,也不是已经填好的测试结果:
| 记录内容 | 需要回答的问题 |
|---|---|
| 源视频、时间范围与片段标识 | 人工看到的是否就是被筛选的那段内容? |
| 固定版本与本轮关键配置 | 这次决定发生在什么条件下,和上一轮改变了什么? |
| 分数、有效性与错误记录 | 数值来自正常测量,还是存在缺失数据等异常? |
| 当前去向及实际产物位置 | 片段继续处理还是进入过滤集合,哪些文件确实可打开? |
| 业务判断与核对依据 | 保留或排除的理由是什么,是否仍缺上下文? |
这张表不是为了把每个片段都交给人逐条审核。它让抽样有一个明确的观察单位,也让问题能够被重新找到。样本很多时,应同时看接近阈值的片段、明显高低分片段、不同摄像头和场景,以及处理异常的输入。只看最终留下的漂亮片段,无法发现被筛掉的有效样本。
如果人工已有一组标识为应保留的片段,可以计算其中有多少被当前规则排除;同时观察留下的样本里仍有哪些明显无用内容。二者回答的是不同问题。分母必须说明是已审阅样本还是全部数据,未知样本不能悄悄算作正确判断。样本若专门挑了难例,也不能把其比例直接推广到整库。
比较两轮时,还需要保证观察单位可对齐。切分改变会让一个旧片段对应几个新片段,此时逐行比较输出数可能失去含义。要么固定切分只比较筛选设置,要么回到同一源视频时间范围审阅,并明确这是另一类实验。这个限制比"总共少了多少文件"更接近实际决策。
也不必预先承诺一个通用通过率。团队可以先定义不能轻易丢失的场景,说明允许的人工返工量,再根据样本结果决定是否收紧规则。如果关键场景仍被误筛,继续保留人工复核或按场景区分策略,可能比统一调整一个全局阈值更稳妥。
工具能提供分数、处理路径和派生数据;它不能替团队决定哪种错误更不可接受。对巡检团队,漏掉停止异常可能比多保留静态画面更糟;对另一个用途,判断可能相反。这种取舍需要被写在验收依据里,才能让后来维护配置的人理解为什么没有采用默认值。
先让一条筛选决定说得清,再扩大处理规模
Cosmos Curator 的价值,是把切分、筛选、模型处理和结果写出组织成可组合的流水线。固定源码同时提醒我们:阶段越多,越需要知道一个片段在哪里改变了去向,而不是把所有输出变化都归结为"质量提升"。
最小起点可以只是少量合法可用的录像、可追溯的片段,以及运动阶段的观察模式。把正常低分和测量异常区分开,检查具有业务意义的停止片段,再决定是否启用过滤。必要时,一个简单的切片脚本加人工审核就足以完成第一轮验证,不需要立即采用分布式运行。
只有当前样本能支持筛选目标,记录能够解释误筛与恢复,才考虑增加数据量或更多模型阶段。即便这些工程检查都成立,也只证明这条整理流程更可解释;训练质量是否改善,还要由后续独立的模型与任务评估回答。
真正值得带走的不是某个默认阈值,而是一份能返回原片段、说明测量是否有效、解释最终去向的复核记录。下一次有人问"这段为什么没留下",团队应该能找到当时的输入、决定和证据。
Footnotes
-
NVIDIA,Cosmos-Curate README,固定 v2.2.0 提交
de89c5e4f76219c3f2985dc8fda790a74ab8bab0,2026-09-22核对,github.com/nvidia-cosm... ↩ -
NVIDIA,Split Pipeline Stage Overview,同一固定提交,github.com/nvidia-cosm... ↩ ↩2 ↩3
-
NVIDIA,motion_filter_stages.py,同一固定提交,运动解码、缺失数据分支与保留/过滤集合更新,github.com/nvidia-cosm... ↩ ↩2
-
NVIDIA,Reference Video Pipelines,同一固定提交,github.com/nvidia-cosm... ↩
-
NVIDIA,motion_builders.py,同一固定提交,MotionFilterConfig及阶段构建,github.com/nvidia-cosm... ↩
-
NVIDIA,metadata_writer_stage.py,同一固定提交,过滤片段写出、上传条件及分数字段保存,github.com/nvidia-cosm... ↩ ↩2