开篇介绍:
hello 大家,那么在我们之前编写我们的自定义协议时,就提到了序列化和反序列化的概念,大家要是有忘记的可以看一下这篇博客
那么在那个时候,我们是使用Json来进行序列化和反序列化,还是挺好使的,Json也确实算是目前主流的一个序列化反序列化工具,但是呢,它也有一定的局限性,就是它是以字符串形式进行运输,而我们又知道,计算机只让二进制,所以,聪明的你很快就能想到,那肯定也有能序列化反序列化为二进制的工具,不错,那这就是我们接下来要学习的ProtoBuffer。
在分布式系统、跨平台开发、网络通信的技术领域中,"数据如何高效传输与持久化存储" 是每一位开发者都绕不开的核心问题。我们日常开发中频繁使用的 JSON、XML 格式,虽然具备 "可读性强、上手简单" 的优点,但在数据体积、解析速度、版本兼容性这三个关键维度上,却存在着难以忽视的天然短板。
而由 Google 开源的Protocol Buffers(简称 ProtoBuf),凭借 "更小、更快、更灵活" 的特性,一跃成为工业级序列化方案的首选。无论是高并发的微服务通信、低延迟的游戏数据同步,还是大规模的物联网设备数据上报,ProtoBuf 都展现出了碾压式的优势。
一、序列化与反序列化:数据交互的底层逻辑
在正式讲解 ProtoBuf 之前,我们必须先吃透 "序列化" 这个基础概念 ------ 它是 ProtoBuf 存在的前提,也是所有跨介质数据交互的底层逻辑。如果把数据交互比作 "快递运输",那么序列化就是 "打包",反序列化就是 "拆包",没有这两步,数据就无法跨越 "内存 - 文件 - 网络" 的边界。
1.1 什么是序列化与反序列化?
我们先给出最通俗的定义,再用生活化的例子强化理解:
- 序列化 :把内存中可操作的对象 (比如一个包含姓名、年龄、手机号的用户信息对象),转换成一串二进制字节序列的过程。
- 反序列化 :序列化的逆操作,把二进制字节序列 重新恢复成内存中可操作的对象的过程。
生活化类比:乐高积木的打包与拆包
你可以把内存中的对象想象成一套拼好的乐高积木房子:
- 序列化 = 把拼好的房子拆成一个个独立的积木块,再按特定顺序装进快递箱。这个过程中,"房子" 变成了 "有序的积木堆",体积变小、方便运输;
- 反序列化 = 收到快递箱后,按照打包时的说明书,把积木块重新拼成原来的房子。这个过程中,"有序的积木堆" 变回了 "可把玩的房子"。
技术层面的本质
内存中的对象是 "动态" 的 ------ 它依赖于程序的运行进程,进程结束,对象就会消失。而文件、网络传输的载体是 "静态" 的字节流,只能存储 0 和 1 组成的二进制数据。序列化的本质,就是搭建动态对象与静态字节流之间的桥梁。
1.2 为什么一定要做序列化?
序列化不是 "多此一举" 的操作,而是解决两大核心场景问题的必经之路:
场景 1:数据持久化存储
当你需要把程序运行时的对象状态保存到文件、数据库、缓存等持久化介质中时,必须先序列化。
举个例子:你开发了一款本地单机游戏,玩家通关后需要保存 "角色等级、装备、金币数量" 这些信息。这些信息在内存中是一个Player对象,但文件系统只能存储字节数据 ------ 你必须先把Player对象序列化成字节序列,再写入save.dat文件;下次玩家打开游戏时,读取save.dat中的字节序列,反序列化成Player对象,才能还原玩家的游戏进度。
如果不序列化,你只能手动把每个字段转换成字符串写入文件,不仅代码冗余,还容易出现字段遗漏、格式错误的问题。
场景 2:跨网络 / 跨进程数据传输
网络通信、进程间通信的本质是传输字节流------ 无论是 TCP/UDP 的 Socket 通信,还是微服务之间的 HTTP 接口调用,都无法直接把内存中的对象从 A 机器 "扔" 到 B 机器。
再举个例子:你用 Java 写了一个电商后端服务,用 Python 写了一个数据分析前端服务。后端的Order订单对象要传给前端,就必须先把 Java 的Order对象序列化成字节序列,通过网络发送到前端;前端收到字节序列后,反序列化成 Python 能识别的Order对象,才能进行数据分析。
如果不序列化,不同语言、不同平台对 "对象" 的定义完全不同 ------Java 的int是 4 字节,Python 的int是动态长度,直接传输会导致数据错乱。
这个我之前有专门写一篇博客来进行讲解,大家可以去看看对于Linux:序列化、反序列化、Jsoncpp的解析-CSDN博客 https://blog.csdn.net/2503_92929084/article/details/156240443?spm=1011.2415.3001.5331
1.3 常见序列化方案对比:为什么选 ProtoBuf?
目前主流的序列化方案有三种:XML、JSON、ProtoBuf 。我们从数据体积、解析速度、语言无关性、版本兼容性、易用性五个核心维度做对比,让你一眼看出 ProtoBuf 的优势:
| 特性 | XML | JSON | ProtoBuf |
|---|---|---|---|
| 数据体积 | 大(冗余标签多) | 中等(键值对冗余) | 极小(二进制压缩) |
| 解析速度 | 慢(解析 XML 树结构) | 中(解析字符串键值对) | 极快(二进制直接解析) |
| 语言无关性 | 支持(需手动解析) | 支持(需第三方库) | 原生支持(自动生成多语言代码) |
| 版本兼容性 | 差(修改结构易出错) | 中(需手动兼容字段) | 极好(字段编号解耦,无缝升级) |
| 易用性 | 低(标签嵌套复杂) | 高(语法简洁,可读性强) | 中(需定义.proto 文件) |
关键结论
- XML:几乎被淘汰,仅在一些老旧的企业级系统中使用;
- JSON:适合人机交互的场景(比如前后端接口),优点是可读性强,缺点是性能差、体积大;
- ProtoBuf :适合高性能、跨语言、跨平台的工业级场景(比如微服务通信、游戏数据同步),优点是体积小、速度快、兼容性好,缺点是可读性差(二进制无法直接查看)。
简单来说:如果追求性能和兼容性,选 ProtoBuf;如果追求可读性和易用性,选 JSON。
二、ProtoBuf 核心认知:Google 的高效序列化神器
理解了序列化的基础,我们正式进入 ProtoBuf 的核心讲解。ProtoBuf 不是一个简单的 "工具库",而是一套结构化数据序列化的完整解决方案------ 它定义了数据结构的描述语法,提供了编译器自动生成代码,封装了序列化与反序列化的底层实现。
2.1 ProtoBuf 的官方定义与核心定位
Google 对 ProtoBuf 的官方定义是:
Protocol buffers are Google's language-neutral, platform-neutral, extensible mechanism for serializing structured data -- think XML, but smaller, faster, and simpler.
我们把这句话翻译成大白话:
ProtoBuf 是 Google 推出的、不依赖具体编程语言、不依赖具体操作系统的、可以灵活扩展的结构化数据序列化方案。你可以把它理解成 "升级版的 XML",但它比 XML 体积更小、速度更快、使用更简单。
核心定位
ProtoBuf 的定位不是 "替代 JSON/XML",而是在高性能场景下补充 JSON/XML 的不足。以下是 ProtoBuf 的典型应用场景:
- 微服务高频通信:比如电商系统的 "订单服务" 和 "支付服务" 之间的交互,每秒可能有上万次请求,ProtoBuf 的小体积能大幅降低带宽消耗;
- 游戏数据同步:比如手游的角色移动、战斗技能释放,ProtoBuf 的快解析速度能降低延迟,提升玩家体验;
- 物联网设备数据上报:比如智能电表、摄像头的传感器数据,ProtoBuf 的小体积能节省设备的流量成本;
- 大数据存储:比如 Hadoop、Spark 的结构化数据存储,ProtoBuf 的快读写速度能提升数据处理效率。
2.2 ProtoBuf 的四大核心特性
ProtoBuf 的所有优势都源于它的四大核心特性:
特性 1:语言无关、平台无关(跨语言跨平台的基石)
ProtoBuf 支持几乎所有主流编程语言和操作系统:
- 支持的语言:C++、Java、Python、Go、PHP、C#、JavaScript、Ruby 等;
- 支持的平台:Windows、Linux、macOS、Android、iOS 等。
这意味着什么?举个例子:
- 你用 **C++** 写的服务端,把
User对象序列化成字节序列; - Java 写的安卓客户端,能直接反序列化这个字节序列,得到
User对象; - Python写的数据分析服务,也能反序列化这个字节序列,进行数据统计。
核心原理 :ProtoBuf 的序列化结果是纯二进制字节序列 ,不包含任何语言相关的语法。而不同语言的支持,是通过编译器生成对应语言的代码实现的 ------ 你不需要手动编写跨语言的解析代码。
特性 2:极致高效(体积小、速度快的秘密)
ProtoBuf 的 "高效" 是它最核心的竞争力,主要体现在两个维度:
维度 1:数据体积极小
ProtoBuf 采用二进制编码 ,没有 XML/JSON 的冗余标签和键值对。我们用一个具体的例子对比:假设我们有一个用户信息:姓名=张三,年龄=25,手机号=13800138000。
- JSON 序列化后的大小:约56 字节 (包含键名
"name"、"age"、"phone"和引号、冒号等冗余字符); - ProtoBuf 序列化后的大小:约24 字节(仅存储字段值和字段编号,无冗余信息)。
体积缩小了 57% !在大规模数据传输场景下,这意味着带宽成本直接减半。
核心原理 :ProtoBuf 用字段编号替代字段名 ------ 比如用1代表name,2代表age,3代表phone。序列化时只存储 "编号 + 值",不存储字段名,大幅节省空间。
维度 2:解析速度极快
ProtoBuf 的序列化和反序列化速度,是 JSON 的3-10 倍。Google 官方给出的测试数据显示:
- 序列化速度:ProtoBuf 是 JSON 的2-5 倍;
- 反序列化速度:ProtoBuf 是 JSON 的3-10 倍。
核心原理:
- JSON 是文本格式,解析时需要先把字符串转换成内存对象,还要处理键值对的匹配,耗时较长;
- ProtoBuf 是二进制格式,解析时直接按固定的编码规则读取字节,无需字符串处理,耗时极短。
特性 3:极强的扩展性与兼容性(版本迭代的福音)
这是 ProtoBuf 最被开发者推崇的特性 ------你可以随意修改数据结构,旧版本的程序依然能正常工作。
举个例子:
- V1 版本 的
User对象,只包含name(编号 1)、age(编号 2)两个字段; - V2 版本 的
User对象,新增了phone(编号 3)、email(编号 4)两个字段; - 用 V1 版本代码编译的程序,读取 V2 版本序列化的数据时,会自动忽略新增的字段,不会报错;
- 用 V2 版本代码编译的程序,读取 V1 版本序列化的数据时,会自动给新增字段设默认值,不会报错。
核心原理 :ProtoBuf 的解析逻辑是基于字段编号,而非字段名。只要字段编号不变,即使修改字段名、新增字段、删除字段,新旧版本的程序都能兼容。
重要规则 :字段编号一旦定义,永远不要修改!这是保证兼容性的关键。
特性 4:自动化代码生成(解放双手的利器)
使用 ProtoBuf,你不需要手动编写任何序列化 / 反序列化的代码------ 所有代码都由编译器自动生成。
具体流程是:
- 你用 ProtoBuf 的专用语法,写一个
.proto文件,描述数据结构; - 用 ProtoBuf 编译器
protoc,编译这个.proto文件; - 编译器会自动生成对应语言的代码文件,包含:
- 数据结构的类定义(比如 C++ 的
class UserInfo); - 字段的
setter/getter方法(比如set_name()、name()); - 序列化方法(比如
SerializeToString()); - 反序列化方法(比如
ParseFromString())。
- 数据结构的类定义(比如 C++ 的
这意味着什么?你只需要关注数据结构的定义 ,不需要关注底层的序列化实现------ 避免了手写代码的 bug 和冗余,大幅提升开发效率。
2.3 ProtoBuf 的工作流程
ProtoBuf 的使用流程可以总结为 **"定义→编译→使用" 三步曲 **,这是后续所有实战的基础。我们用一张流程图直观展示:
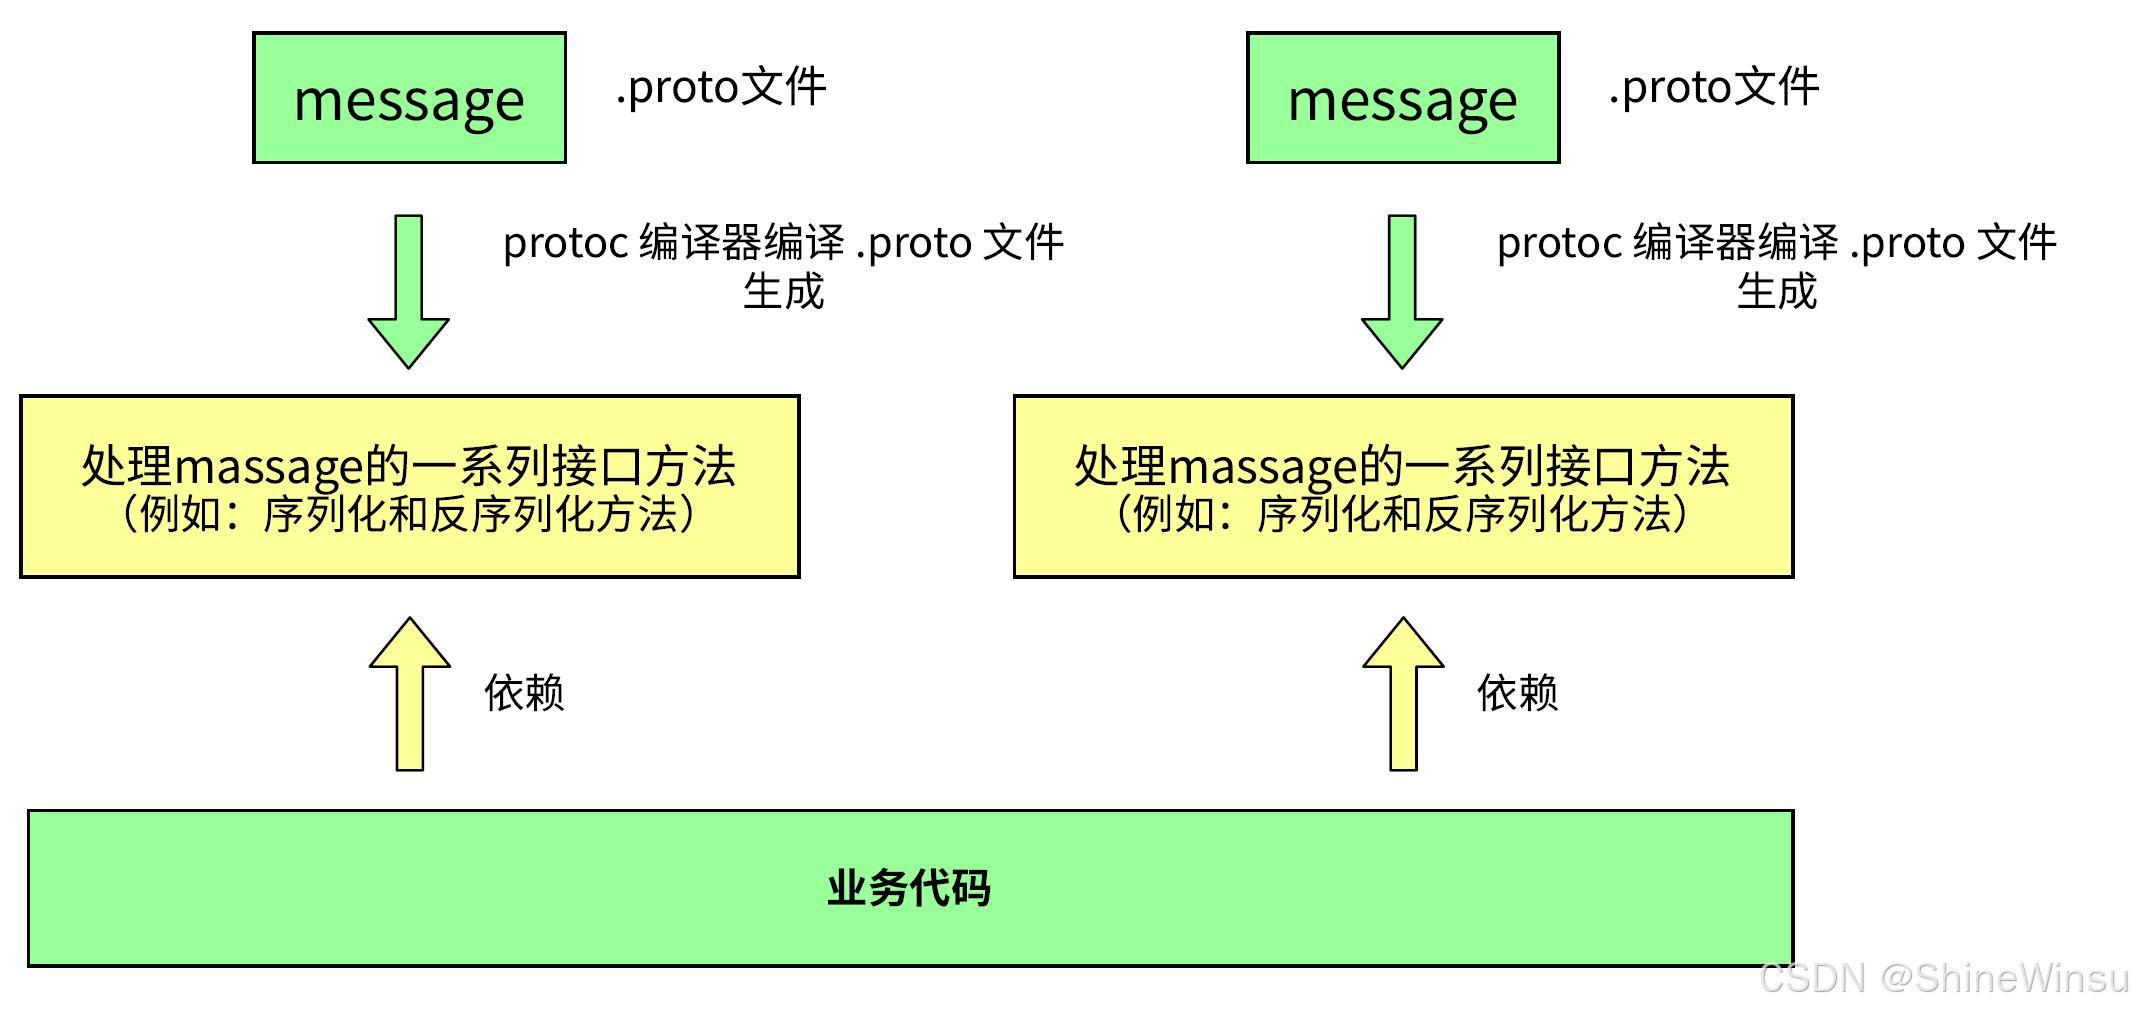
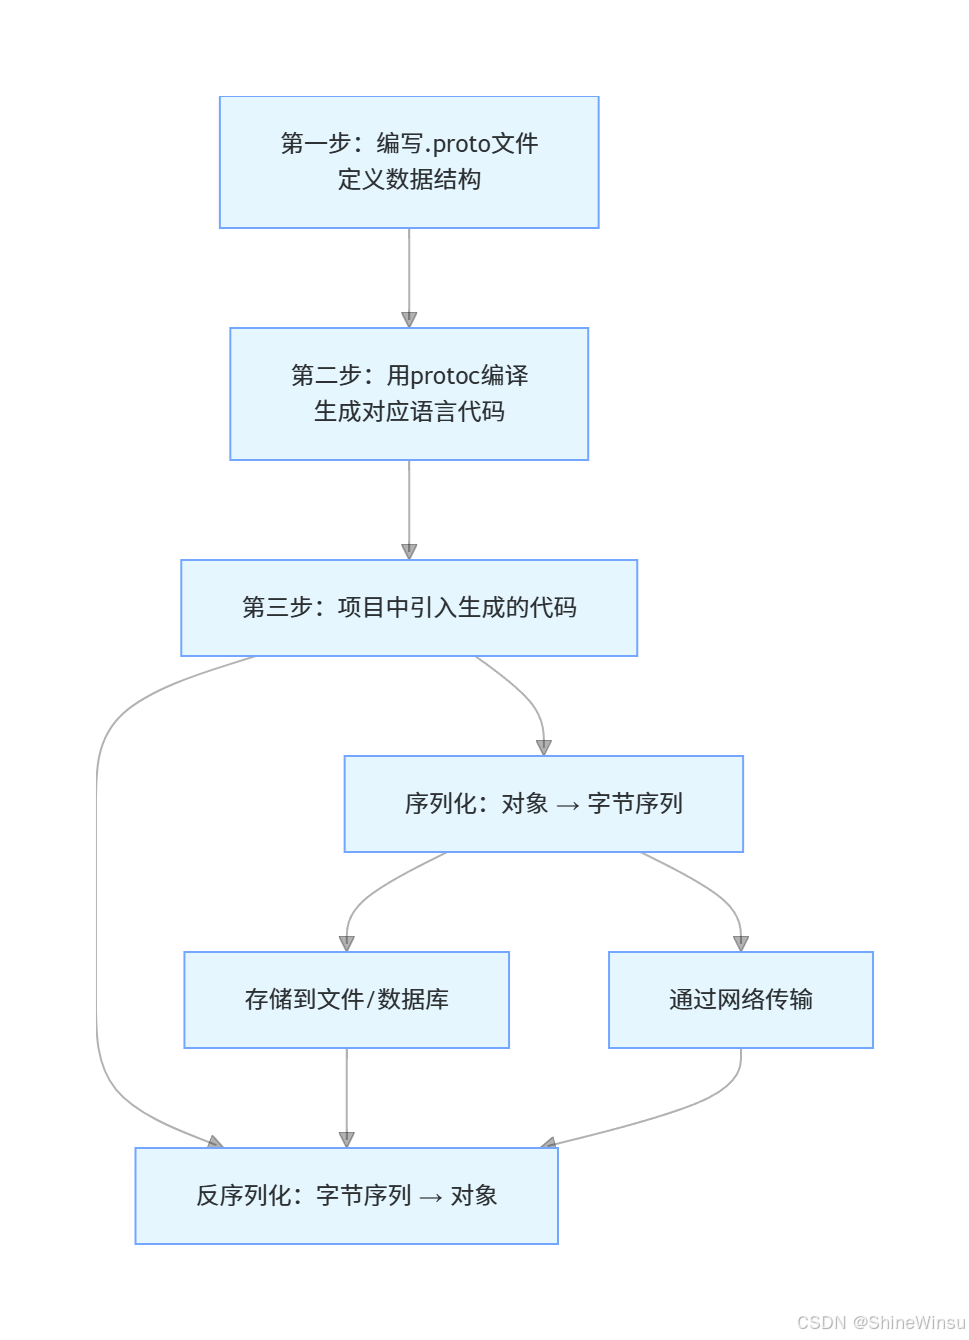
我们逐一步骤解释:
- 定义.proto 文件:这是整个流程的核心,你需要用 ProtoBuf 的语法,描述你要序列化的数据结构(比如用户信息、订单信息);
- 编译.proto 文件 :用
protoc编译器,将.proto文件转换成你所用语言的代码文件(比如 C++ 的.h/.cc文件,Java 的.java文件); - 集成代码并使用:在你的项目中引入生成的代码,调用其中的方法,完成序列化和反序列化操作。
三、ProtoBuf 环境搭建:Windows 系统
环境搭建是使用 ProtoBuf 的第一步。Windows 系统的安装流程相对简单,核心是下载预编译的编译器→配置环境变量→验证安装。
3.1 前置准备:确认系统架构
在下载编译器之前,你需要先确认自己的 Windows 系统是32 位还是 64 位------ 这决定了你要下载的编译器版本。
确认方法:
- 右键点击桌面上的 "此电脑"(或 "我的电脑");
- 选择 "属性";
- 在 "系统类型" 一栏,查看是 "64 位操作系统" 还是 "32 位操作系统"。
3.2 步骤 1:下载 ProtoBuf 编译器(protoc)
ProtoBuf 的编译器protoc是预编译好的可执行文件,无需手动编译,直接下载即可。
下载步骤:
- 打开 ProtoBuf 的官方 GitHub Release 页面:https://github.com/protocolbuffers/protobuf/releases;
- 找到稳定版本(推荐选择 v21.11,避免最新版的兼容性问题);
- 根据系统架构选择压缩包:
- 64 位 Windows:下载
protoc-21.11-win64.zip; - 32 位 Windows:下载
protoc-21.11-win32.zip。
- 64 位 Windows:下载
坑点提醒 1 :不要下载 "Source code"(源码包)!源码包需要手动编译,新手容易出错。我们要下载的是带 "win32"/"win64" 字样的预编译包。
3.3 步骤 2:解压编译器(路径选择的关键)
下载完成后,我们需要把压缩包解压到一个合适的目录。路径选择有两个核心原则:
- 路径中不要包含中文、空格、特殊字符 (比如
D:\软件\protobuf不行,D:\protobuf-21.11可以); - 路径最好简短,方便后续配置环境变量。
解压步骤:
-
右键点击下载的压缩包,选择 "解压到当前文件夹" 或 "解压到 protobuf-21.11\";
-
解压完成后,进入解压后的文件夹,你会看到以下目录结构:
protobuf-21.11/
├─ bin/ # 核心目录:包含protoc.exe编译器
├─ include/ # 头文件目录:C++开发时需要引入
└─ readme.txt # 说明文档
核心文件说明 :
bin目录下的protoc.exe是我们后续编译.proto文件的关键工具,一定要确认这个文件存在。
3.4 步骤 3:配置环境变量(让系统找到 protoc)
为了在任意目录下 都能调用protoc命令,我们需要把bin目录的路径添加到系统的环境变量Path中。这是 Windows 安装的关键步骤,也是新手最容易出错的地方。
配置步骤:
- 右键点击 "此电脑"→选择 "属性";
- 在弹出的窗口中,点击左侧的 "高级系统设置";
- 在弹出的 "系统属性" 窗口中,点击 "环境变量" 按钮;
- 在 "环境变量" 窗口中,找到 "系统变量" 区域的
Path变量,点击 "编辑"; - 在弹出的 "编辑环境变量" 窗口中,点击 "新建";
- 粘贴你解压后的
bin目录路径(比如D:\protobuf-21.11\bin); - 点击 "确定" 保存(所有打开的窗口都要点击确定,否则配置不生效)。
坑点提醒 2 :配置完成后,必须关闭所有已打开的 cmd 窗口,重新打开 ------ 环境变量的修改需要新的终端窗口才能生效。坑点提醒 3 :路径一定要准确!如果路径写错了,后续执行
protoc命令会提示 "找不到命令"。
3.5 步骤 4:验证安装是否成功
配置完成后,我们需要验证protoc是否能正常使用。
验证步骤:
-
按下
Win+R键,输入cmd,打开命令提示符; -
在 cmd 中输入以下命令:
protoc --version
-
如果输出类似
libprotoc 21.11的版本信息,说明安装成功!
常见问题排查:如果提示 "'protoc' 不是内部或外部命令",请按以下步骤排查:
- 检查
Path环境变量中是否正确添加了bin目录路径;- 检查路径中是否包含中文、空格或特殊字符;
- 关闭所有 cmd 窗口,重新打开后再测试;
- 手动进入
bin目录,执行protoc --version------ 如果能正常输出,说明路径配置错误,重新配置环境变量。
3.6 Windows 安装常见问题与解决方案汇总
我们把 Windows 安装过程中新手最容易遇到的问题和解决方案整理成表格,方便你快速排查:
| 问题现象 | 原因分析 | 解决方案 |
|---|---|---|
执行protoc --version提示 "找不到命令" |
环境变量配置错误或未生效 | 1. 检查 Path 中是否添加了 bin 目录;2. 关闭所有 cmd 窗口,重新打开;3. 确认路径无中文 / 空格 |
解压后找不到protoc.exe |
下载了错误的压缩包(源码包) | 回到 Release 页面,下载带 "win32"/"win64" 的预编译包 |
| 执行编译命令时提示 "找不到头文件" | C++ 开发时未引入include目录 |
编译时添加-I参数,指定 include 目录路径(比如-I D:\protobuf-21.11\include) |
四、ProtoBuf 环境搭建:Ubuntu 系统(APT 一键安装教程)
其实在此之前,我尝试了源码、官网编译包等等方法,都是不行,无法识别头文件,所以最后尝试来尝试去,选择了apt一键安装嘿嘿,版本也不算旧,操作也简单多了
4.1 安装前准备
4.1.1 打开终端
- 快捷键:
Ctrl + Alt + T(推荐); - 桌面搜索:点击 "显示应用程序",搜索 "终端" 打开;
- 右键菜单:在桌面 / 文件夹空白处右键选择 "打开终端"。
4.1.2 提权说明
带sudo的命令需输入当前用户登录密码(输入时终端不显示字符),输入后回车即可执行。
4.2 安装步骤
4.2.1 可选:更新软件源
sudo apt update -y成功标志:终端无红色报错,最后提示 "所有软件包均为最新版本"。
4.2.2 必选:一键安装 ProtoBuf 组件
sudo apt install protobuf-compiler libprotobuf-dev -y成功标志:终端无红色报错,最后提示 "处理完毕"。
4.3 安装组件说明
| 组件名 | 核心作用 | 系统默认安装路径 | 关键文件 / 内容 |
|---|---|---|---|
| protobuf-compiler | 提供protoc编译器,用于编译.proto文件为目标语言代码 |
/usr/bin/ | /usr/bin/protoc(编译器可执行文件) |
| libprotobuf-dev | 提供 C/C++ 开发所需头文件和运行时库,编译 ProtoBuf 项目的基础 | 头文件:/usr/include/google/protobuf/ 库文件:/usr/lib/x86_64-linux-gnu/ | 头文件:*.h(如 message.h) 库文件:libprotobuf.so(核心库) |
4.4 安装验证(三步全量确认)
4.4.1 验证编译器可用
protoc --version成功输出:libprotoc X.X.XX(版本号依系统适配而定)。

4.4.2 验证头文件存在
ls /usr/include/google/protobuf/成功输出:显示大量.h头文件(如arena.h、message.h)。
4.4.3 验证库文件存在
ls /usr/lib/x86_64-linux-gnu/ | grep libprotobuf.so成功输出:显示libprotobuf.so及后缀版本文件(如libprotobuf.so.32)。

由此我们就安装成功了,然后我们可以开始我们的protobuffer之旅啦。
protobuffer插件推荐:
OK大家,那么在我们安装好了之后,就要开始在vscode中写代码了,那么这里我推荐大家下载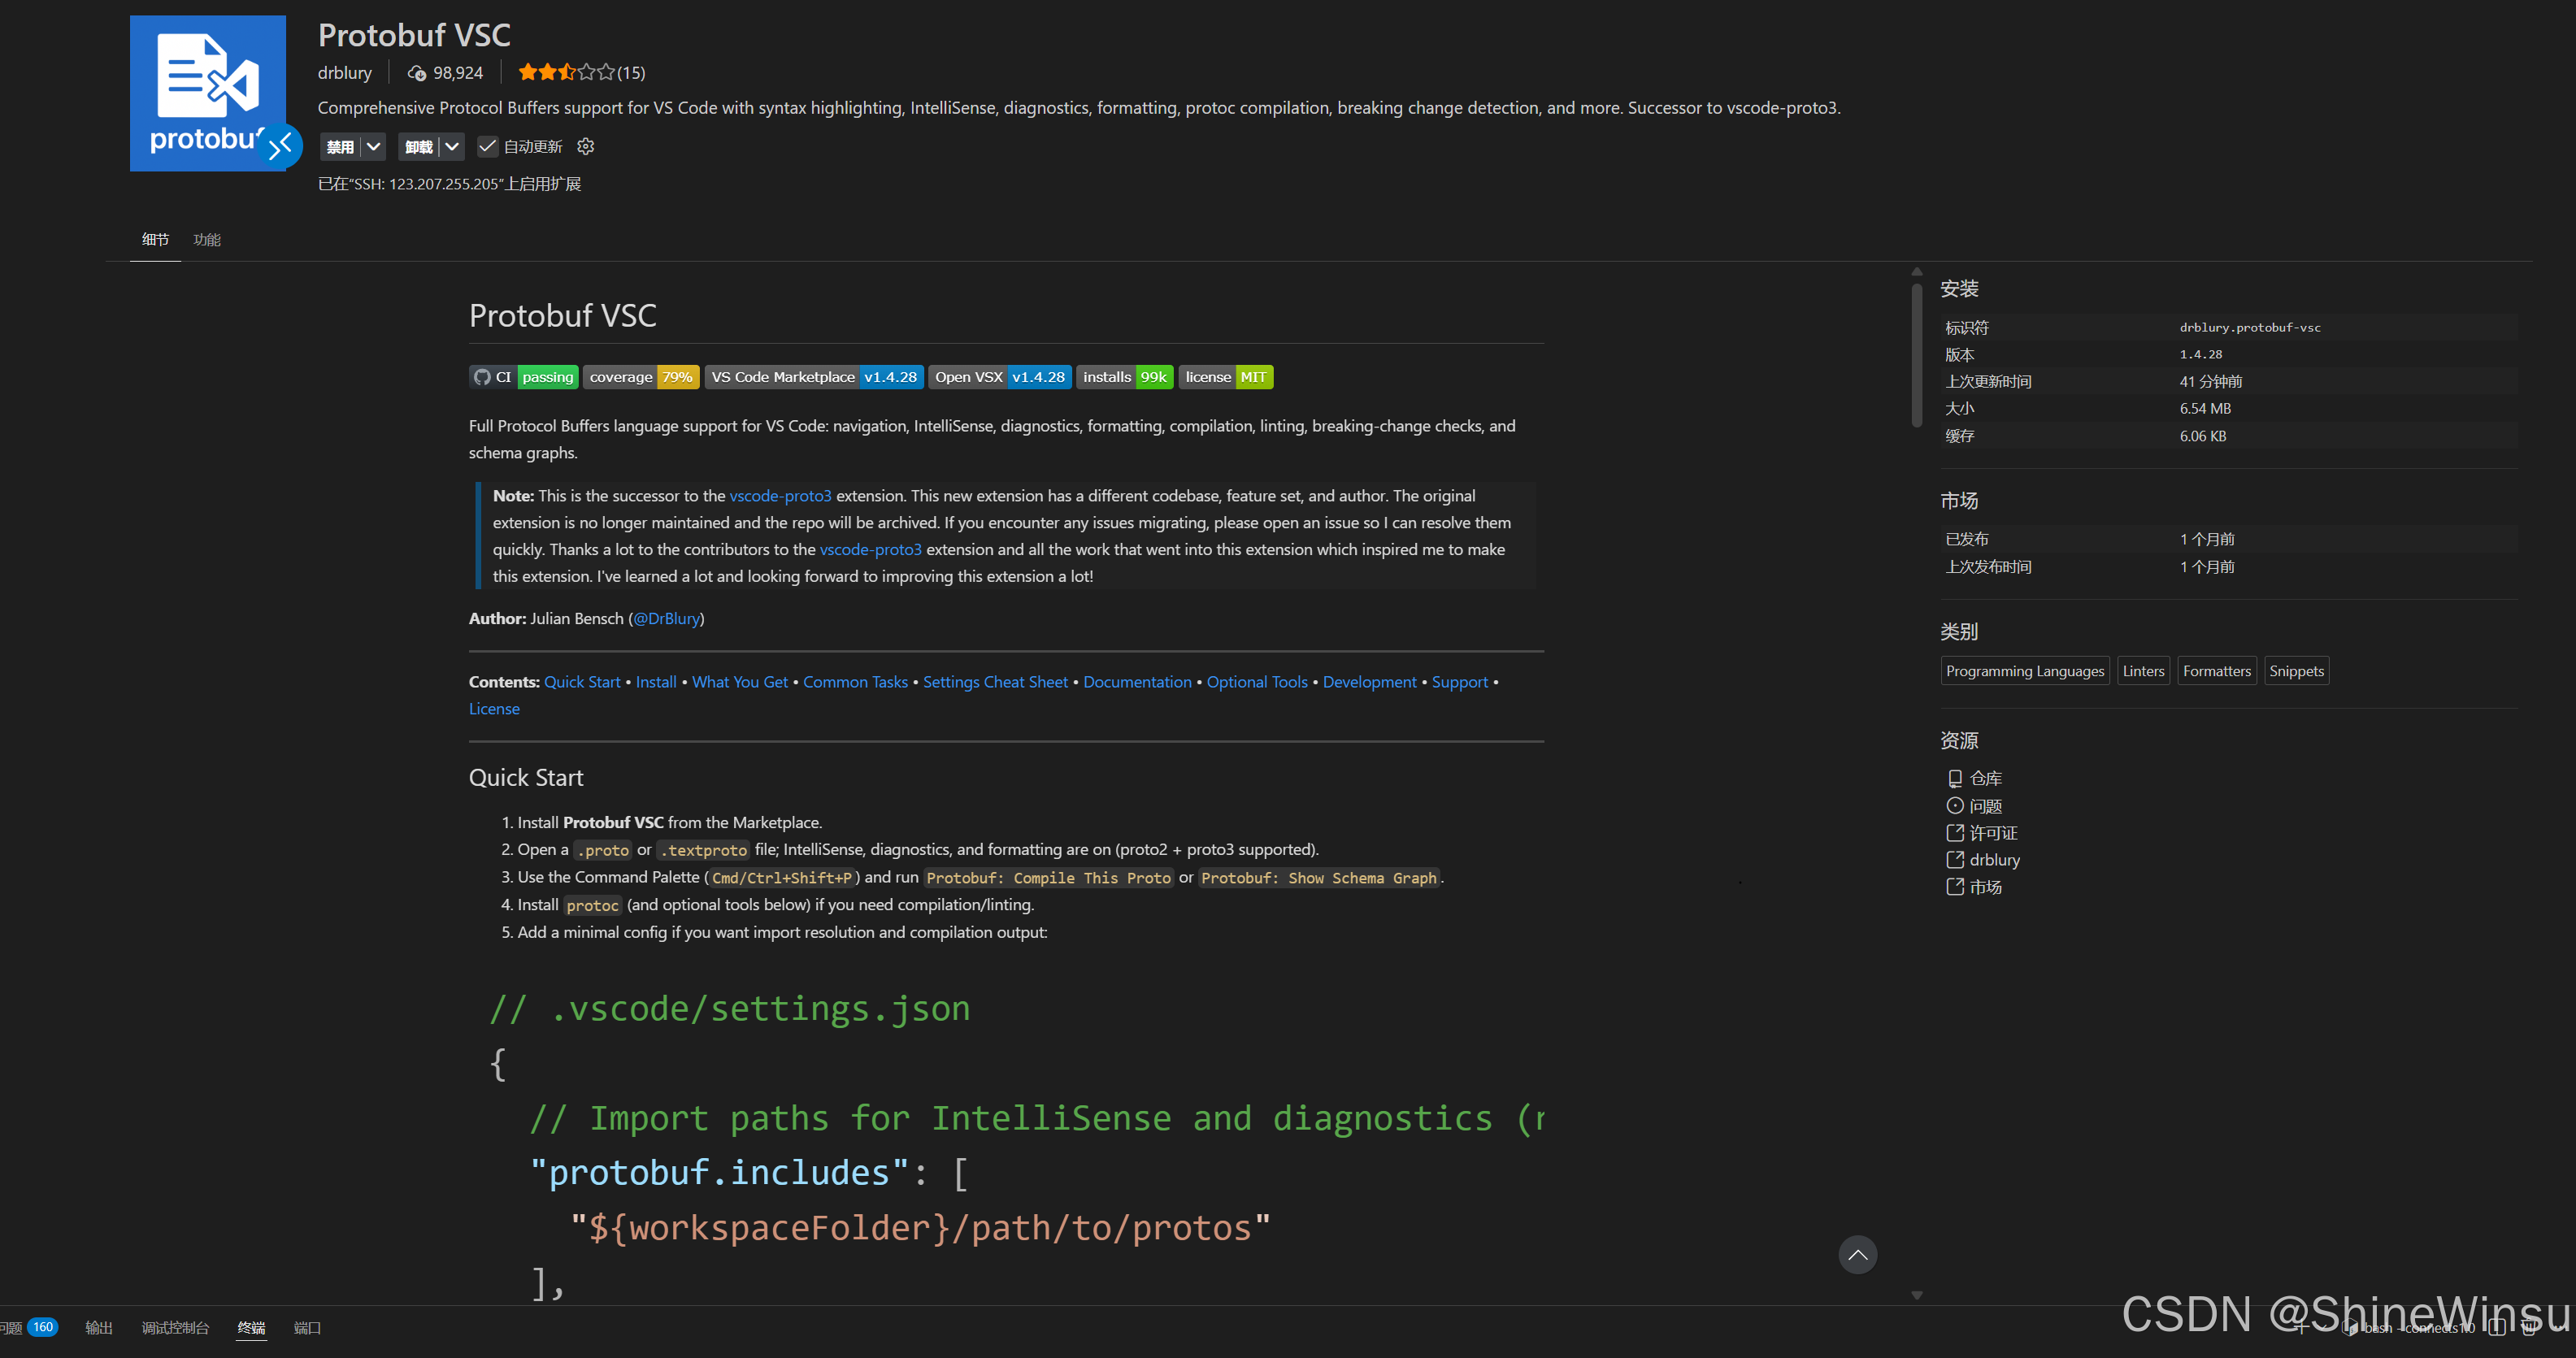 这个插件进行使用~~~
结语:以高效之名,解锁序列化的进阶之路
写到这里,这篇万字长文的 ProtoBuf 教程也即将画上句号。回顾整篇内容,我们从序列化的底层逻辑讲起,拆解了 JSON、XML 与 ProtoBuf 的核心差异,又手把手带你完成了 Windows 和 Linux 双系统的环境搭建,最后通过实战案例让你直观感受到了 ProtoBuf 的高效与便捷。此刻的你,或许已经完成了 protoc 的安装验证,或许正在对着编译后的user.pb.h文件琢磨下一步的代码编写,又或许还在为make check时的 swap 分区问题而头疼 ------ 但请相信,这些过程中遇到的小波折,都是你掌握这项技术的必经之路。
我们为什么要花这么多时间去学习一个 "新" 的序列化工具?答案其实藏在我们开篇的讨论里。在日常开发中,我们习惯了用 JSON 来处理前后端的数据交互,它的可读性和易用性确实能帮我们快速完成需求,但当你面对高并发的微服务通信、低延迟的游戏数据同步、大规模的物联网设备数据上报时,JSON 的 "短板" 就会被无限放大 ------ 冗余的键值对占用了过多带宽,字符串解析的耗时拖慢了系统响应速度,版本迭代时的字段兼容问题更是让开发者苦不堪言。而 ProtoBuf 的出现,正是为了解决这些痛点:它用二进制编码压缩了数据体积,用字段编号实现了无缝的版本兼容,用自动化代码生成解放了开发者的双手。从 "能用" 到 "好用",从 "满足需求" 到 "优化性能",这正是我们学习新技术的核心意义。
在整个学习过程中,我相信你一定也感受到了技术学习的 "循序渐进"。从理解序列化的本质,到掌握 ProtoBuf 的 "定义 - 编译 - 使用" 三步流程,再到解决环境搭建时的各种问题 ------ 比如 Windows 系统下的环境变量配置、Linux 系统下的编译依赖安装、make check时的 swap 分区扩容 ------ 这些看似琐碎的细节,恰恰是区分 "理论派" 和 "实战派" 的关键。我还记得自己第一次安装 ProtoBuf 时,因为路径中包含中文导致protoc命令无法识别,折腾了整整一个下午才找到问题所在;也记得第一次尝试跨语言序列化时,因为 Java 和 C++ 的字段类型不匹配而踩了不少坑。但正是这些踩坑的经历,让我对 ProtoBuf 的理解更加深刻。所以,如果你在实践过程中遇到了报错,请不要气馁 ------ 打开终端,仔细查看错误日志,对照着文中的解决方案逐一排查,你会发现,那些曾经让你头疼的问题,最终都会成为你技术成长路上的垫脚石。
ProtoBuf 的价值,绝不仅仅是 "比 JSON 更快更小" 这么简单。它更像是一个 "桥梁",连接起了不同的编程语言和操作系统。当你用 C++ 写的服务端能和 Java 写的安卓客户端无缝通信,当你用 Python 写的数据分析程序能直接解析来自 Go 语言服务的二进制数据时,你会真正感受到跨语言开发的魅力。而这一切的背后,是 ProtoBuf"语言无关、平台无关" 的设计哲学在支撑。这种设计哲学,恰恰也是现代分布式系统的核心要求 ------ 在一个复杂的系统中,不同的模块可能用不同的语言开发,部署在不同的平台上,而 ProtoBuf 的存在,让这些模块之间的通信变得简单而高效。
当然,掌握了基础的 ProtoBuf 使用方法,只是你进阶之路的开始。在未来的开发中,你还可以尝试将 ProtoBuf 与 gRPC 框架结合,实现高性能的 RPC 通信;你可以深入研究 ProtoBuf 的编码原理,比如 varint 编码、zigzag 编码,理解它是如何做到极致压缩的;你还可以探索 ProtoBuf 的高级语法,比如oneof、map、自定义选项,用它来描述更复杂的数据结构。技术的学习永远没有终点,今天你为 ProtoBuf 付出的时间,终会在未来的某个项目中给你带来回报。
我还记得自己第一次在项目中使用 ProtoBuf 的场景:当时我们的物联网平台需要处理数百万台设备的上报数据,用 JSON 时服务器的带宽和 CPU 都濒临过载,而换成 ProtoBuf 后,数据体积缩小了一半,解析速度提升了三倍,系统的性能瓶颈瞬间得到了缓解。那种 "柳暗花明又一村" 的喜悦,我至今记忆犹新。我希望你也能在自己的项目中体验到这种喜悦 ------ 当你看到序列化后的字节序列长度从 56 字节缩减到 24 字节,当你看到系统的响应时间从几百毫秒缩短到几十毫秒,当你看到版本迭代时旧程序无需修改就能兼容新数据时,你会明白,我们今天付出的努力,都是值得的。
最后,我想对每一位读者说:技术的学习从来不是一蹴而就的,它需要我们保持耐心,勤于实践,勇于探索。ProtoBuf 作为 Google 开源的工业级工具,已经在无数的大型项目中得到了验证,它的稳定性和可靠性毋庸置疑。希望这篇教程能成为你学习 ProtoBuf 的 "敲门砖",帮助你打开高效序列化的大门。也希望你能把学到的知识运用到实际项目中,用技术的力量去解决实际的问题。
未来的开发之路还很长,愿我们都能保持对技术的热爱,不断学习,不断进步。当你下次再遇到数据序列化的需求时,希望你能想起 ProtoBuf------ 这个小巧而强大的工具,它会用 "更小、更快、更灵活" 的特性,为你的项目保驾护航。
最后,感谢你的阅读。愿你在技术的海洋中乘风破浪,收获满满!