如果你关注近两年的地学SCI论文,一定会发现一个现象:XGBoost几乎成了"标配" 。不管是水文模拟、滑坡易发性、野火风险,还是生态服务价值评估,越来越多的研究把XGBoost作为主模型,再搭配SHAP做可解释分析,形成了一套近乎标准化的"论文模板"。
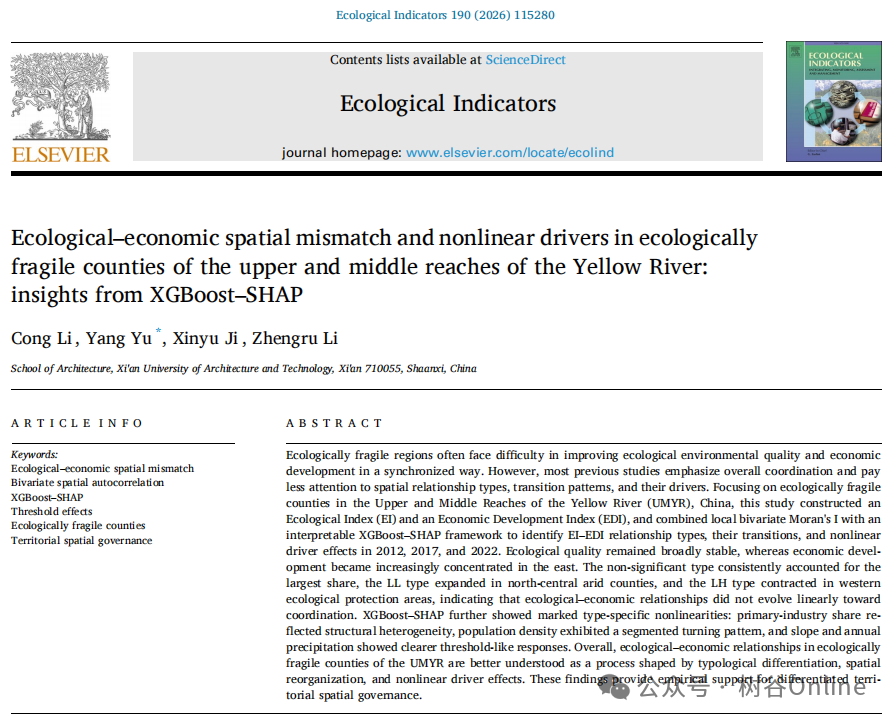
这背后不是跟风,而是地学数据的天然属性与XGBoost技术特性之间的高度契合。今天我们就从原理出发,聊清楚XGBoost在地学中为什么这么强,以及------如果你想在自己的课题里快速上手这套方法,该怎么走捷径。
一、地学数据长什么样?XGBoost为什么刚好"吃"得住?
地学研究面对的数据,绝大多数是表格型结构化数据:样本来自观测站、遥感反演、野外采样,特征是地形、气候、植被、土壤、土地利用等一系列混合变量,目标是预测某个连续值(如温度、浓度)或分类(如滑坡发生与否)。
这类数据有几个共性痛点:
-
样本量不大不小
:几百到几万个样本,既不是大数据也不属于小样本;
-
特征高维且异构
:数值型(海拔、坡度)和分类型(岩性、土地覆盖)混在一起;
-
强非线性
:例如NDVI对生态系统服务的影响存在饱和效应;
-
缺失值和离群值常见
:传感器故障、极端天气导致数据不完整。
而XGBoost恰好为这类数据而生:
✅ 原生处理缺失值:自动学习缺失值的最佳分裂方向,无需手动插补
✅ 内置L1/L2正则化:有效抑制过拟合,尤其适合中等规模数据
✅ 二阶优化+并行计算:精度高、速度快,笔记本也能跑
✅ 与SHAP无缝对接:不仅能预测,还能解释"为什么"
这正是它成为地学SCI"默认基线"的根本原因。
二、实证说话:XGBoost在地学任务中到底有多能打?
我们来看几个真实对比:
🌡️ 农业碳排放建模:7个模型对比,XGBoost的MSE=0.27、R²≈0.73,显著优于随机森林(0.33/0.66)和普通MLP(0.49/0.51)。论文明确指出:"对于中等规模、混合数值与分类变量的环境数据,树集成(尤其是Boosting)远优于大型参数网络。"
🌧️ 降水降尺度:GPM卫星降水1km降尺度任务,XGBoost综合表现 > BP神经网络 > 随机森林。尤其在降水分布不均匀的区域,XGBoost的空间过渡更平滑、估值更精准。
🔥 野火易感性制图:空间块交叉验证下,XGBoost与随机森林的ROC-AUC均达0.84,而深度学习集成(DNN+ANN+ResNet+LSTM)训练耗时102分钟、占用6.1GB内存,准确率反而更低(77.3%)。研究推荐:"RF或XGBoost用于业务化野火易发性制图。"
⛰️ 滑坡易发性 :海南琼中对比6种模型,XGBoost AUC=0.847,误差控制最优。结合SHAP还能揭示各因子的空间异质性------这是地学论文最看重的科学发现。
三、为什么"XGBoost + SHAP"成了地学论文的黄金搭档?
因为地学研究的终极目标从来不只是"预测得准",更是揭示机制:哪些因子在驱动?它们之间怎么交互?在不同空间位置上影响是否相同?
SHAP(Shapley Additive Explanations)完美解决了这个问题:
-
全局解释
:特征重要性排序 + 蜂巢图,一眼看出主导因子及其正负影响方向
-
局部解释
:瀑布图展示单个样本的预测分解,从基准值到最终预测一目了然
-
依赖关系
:LOWESS拟合曲线揭示非线性响应,比如"当海拔超过2000米后,温度对某生态指标的影响趋于平缓"
-
交互作用
:SHAP交互热力图帮助筛选重点变量组合
这就是为什么现在地学SCI里,"XGBoost建模 → SHAP解释 → 论文级图表"已经成为一个标准流水线。它既保证了方法先进性,又满足了审稿人对可解释性的要求。
说了这么多,你可能已经在自己的课题里跃跃欲试了。但真正动手时,往往会遇到这些拦路虎:
-
❓ 环境配置总出错,依赖包冲突
-
❓ 不知道如何调参才能达到论文级效果
-
❓ SHAP默认图太丑,不知道怎么改成论文要求的排版
-
❓ 多分类任务怎么做类别级SHAP解释?
-
❓ 代码跑不通,没人帮忙debug
专门解决这些问题的实战
前沿
XGBoost结合SHAP的可解释机器学习框架,能够在保持模型预测能力的同时,量化不同特征对模型输出的贡献,支撑资源环境研究中的关键因子识别、非线性响应分析、交互关系筛选、局部样本解释和论文图表表达。
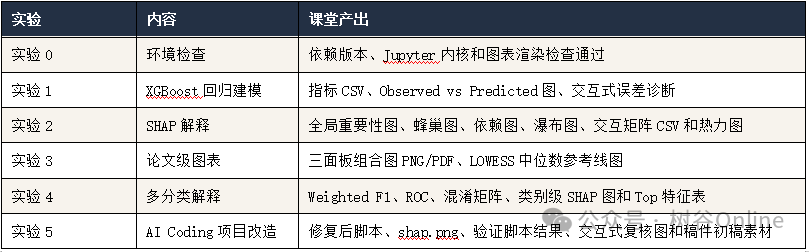
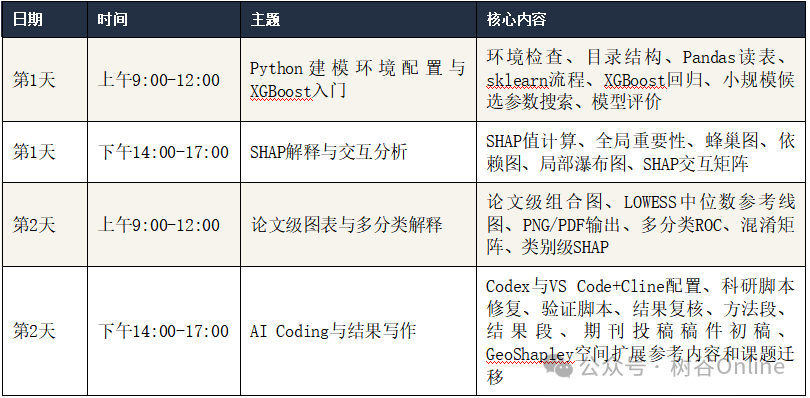
本次围绕环境配置与数据读取、XGBoost建模、SHAP解释、论文级图表、多分类解释和AI Coding科研代码改造展开。课程使用统一实验包完成脚本运行、Notebook交互讲解、图表导出和验证检查,并结合Codex辅助完成实验整理与写作初稿,帮助学员形成一套可以迁移到自有课题的XGBoost-SHAP分析流程。
01
安排
目标
1、掌握课程统一环境下Python、Jupyter、VS Code与依赖包的基本配置方法。
2、掌握Pandas读表、列选择、目标变量拆分、训练集测试集划分和模型评价的最小闭环。
3、掌握XGBoost回归模型训练、小规模候选参数搜索、R2、RMSE和MAE评价方法。
4、掌握SHAP全局重要性、蜂巢图、依赖图、瀑布图和交互矩阵的计算与解读。
5、掌握论文级SHAP组合图、LOWESS拟合图和中位数参考线图的输出方法。
6、掌握XGBoost多分类建模、Weighted F1、ROC、混淆矩阵和类别级SHAP解释方法。
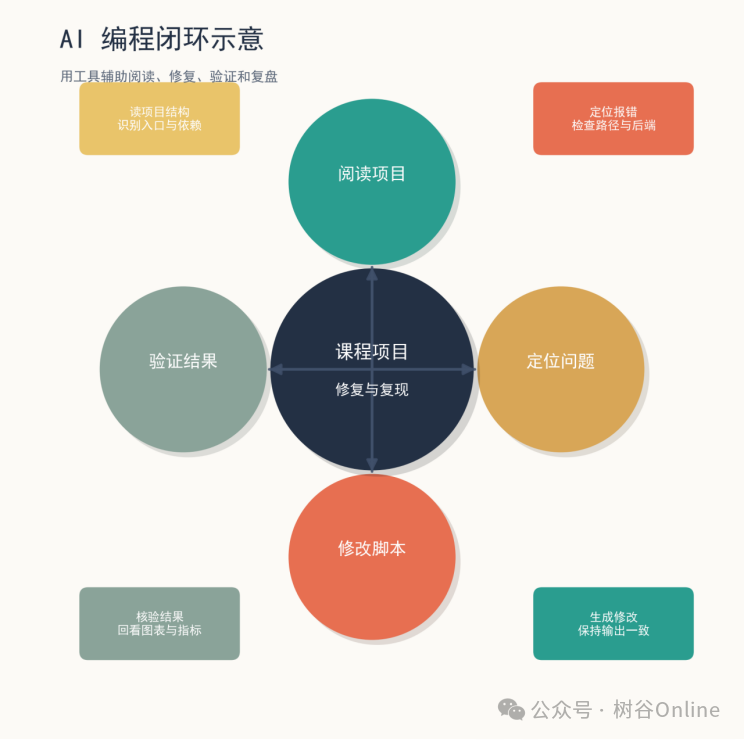
7、掌握Codex与Cline在路径修复、绘图后端修复、并行参数修复、结果验证和写作初稿整理中的应用。
8、能够将课程实验改造成自有课题的XGBoost-SHAP分析模板。
成果
-
完成一套XGBoost回归建模与评价流程。
-
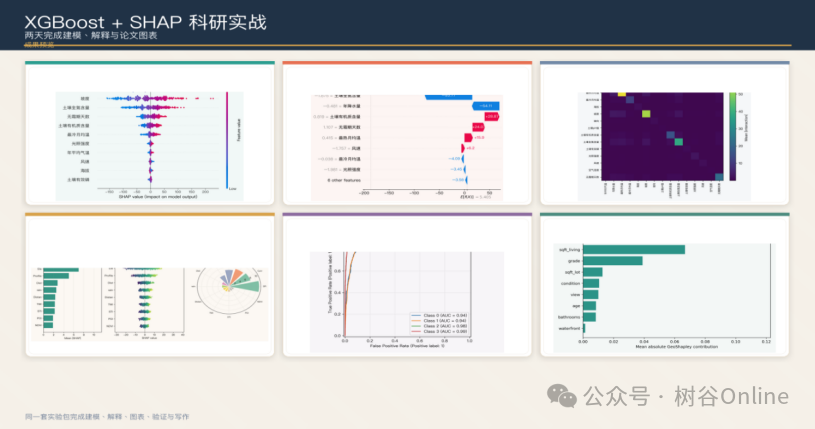
完成一套SHAP全局、局部、依赖和交互解释流程。
-
输出可用于论文表达的SHAP组合图和LOWESS中位数参考线图。
-
完成一套XGBoost多分类评价与类别级SHAP解释流程。
-
掌握Codex与Cline辅助科研代码修复、结果验证和稿件初稿整理流程。
-
形成可迁移到自有课题的XGBoost-SHAP分析模板。
成果预览
05
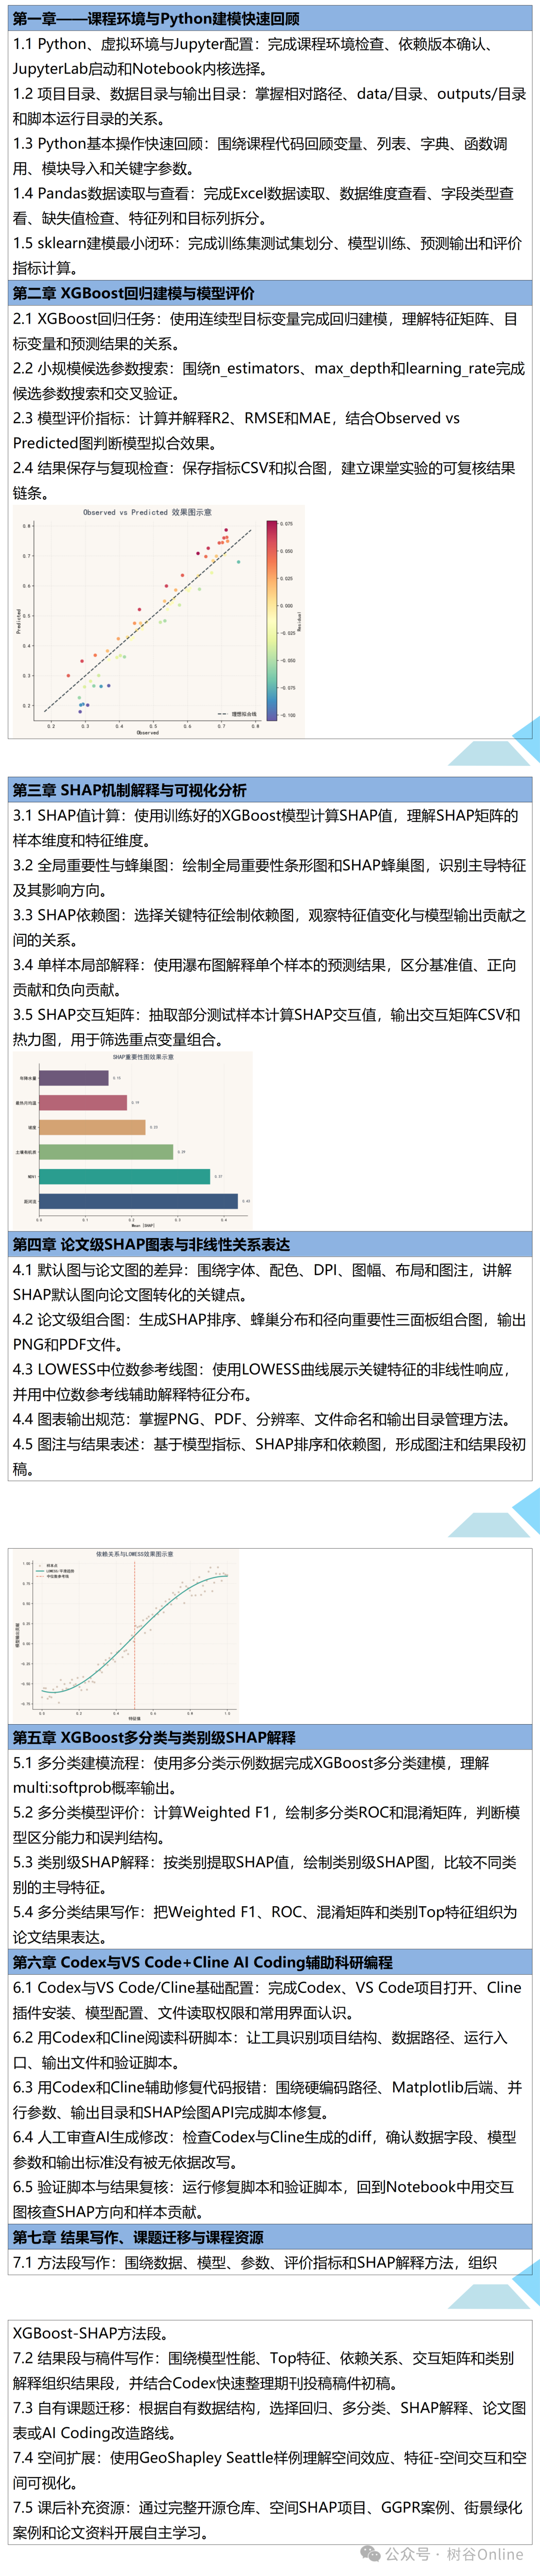
详细内容