TL;DR --- OCEC(Open Closed Eyes Classification)是一个超轻量级的眼部开合二分类模型系列,最小变体仅 112KB,CPU 推理延迟低至 0.16ms,F1 高达 0.9924。它能以超过 6000 FPS 的速度判断一只眼睛是睁开还是闭合,为眨眼检测、疲劳驾驶预警、人机交互等场景提供了前所未有的实时性。
一、开门见山:这个项目解决了什么问题?
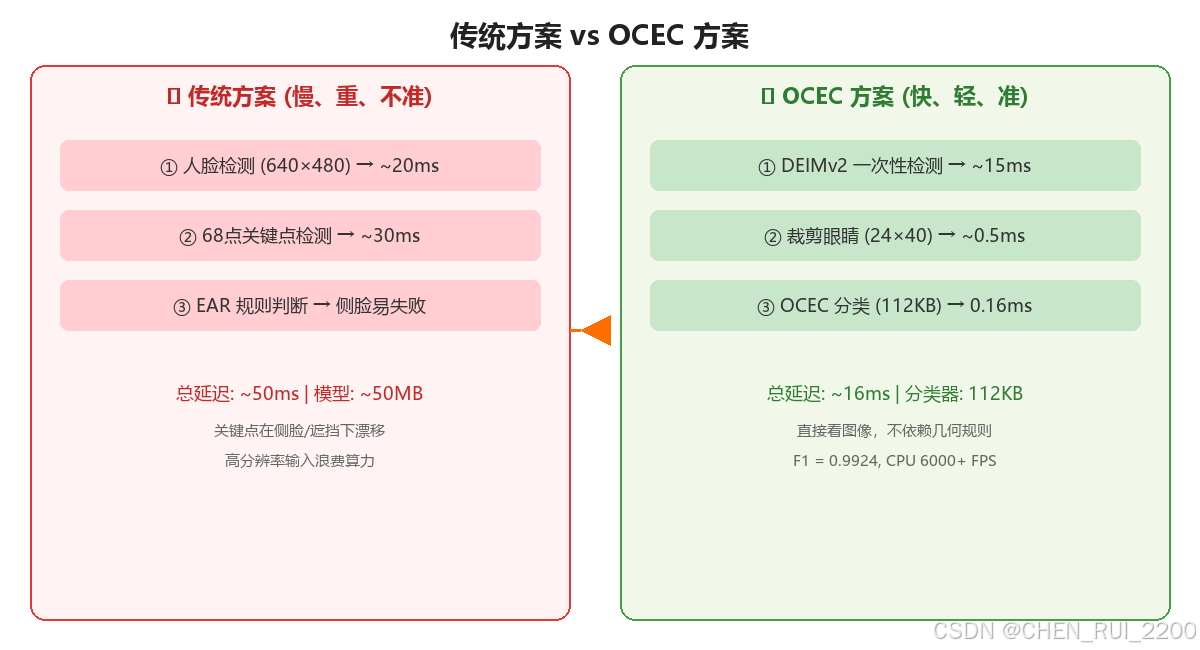
想象一下这个场景:你正在开发一套驾驶员疲劳监测系统,需要在嵌入式设备上实时检测司机是否眨眼、是否打瞌睡。传统方案会先用一个人脸检测器找到脸,再用一个关键点检测器定位眼部,最后用某种规则(比如 EAR------Eye Aspect Ratio)来判断眼睛是否闭合。这条链路的问题是:
- 关键点检测器太重了。一个典型的 68 点人脸关键点模型动辄几十 MB,在嵌入式 CPU 上跑一帧需要 10-50ms,根本谈不上实时。
- EAR 规则不够鲁棒。它依赖精确的关键点位置,但关键点在侧脸、遮挡、光照变化下经常漂移,导致误判率居高不下。
- 高分辨率输入是浪费。在真实的监控或车载摄像头画面中,人眼区域通常只有 20×40 像素左右。用 640×480 甚至更高的分辨率去检测眼睛,绝大部分计算量都花在了背景上。
OCEC 的回答是:把眼睛裁出来,用最小的模型、最低的分辨率,直接做二分类。
它不试图替代人脸检测器或关键点检测器,而是站在它们的肩膀上------先用一个通用的人体关键点检测器(DEIMv2-Wholebody34)定位到眼睛的 bounding box,然后把这一小块裁剪图(约 24×40 像素)喂给 OCEC,让它判断 Open 还是 Closed。就这么简单,就这么快。
二、核心创新点:五个维度重新思考眼部分类
创新点 1:「真实世界尺寸感知」的输入分辨率
OCEC 最反直觉的设计是它的输入分辨率:24×40 像素。
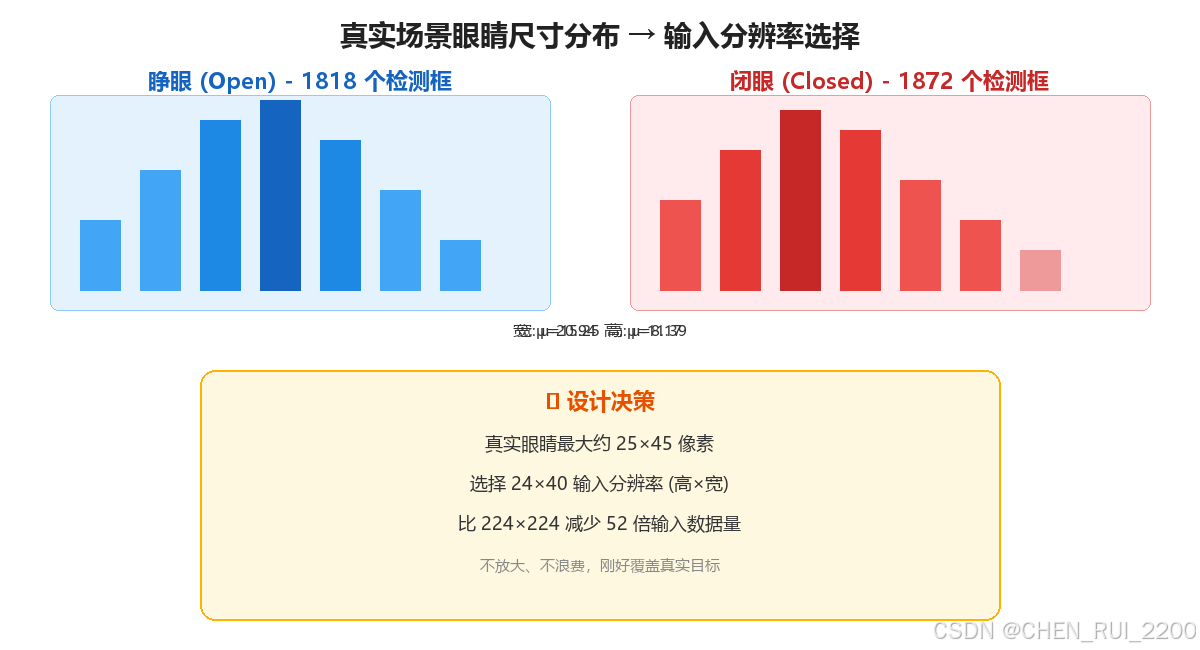
这不是拍脑袋决定的。作者用 DEIMv2 检测器在真实视频上统计了眼睛 bounding box 的尺寸分布:
- 睁眼:宽度均值 20.94,高度均值 11.39
- 闭眼:宽度均值 15.25,高度均值 8.17
也就是说,在真实场景中,眼睛的像素面积极小。传统的 112×112 或 224×224 输入分辨率,对于这种微小目标来说是一种巨大的浪费------你把图片放大 5-10 倍,并不会获得更多有用信息,只会让网络做更多无用的计算。
OCEC 选择 24×40(高×宽),刚好覆盖真实眼睛的尺寸范围,又留有余量。这个决策让模型的输入 tensor 只有 3×24×40 = 2880 个浮点数,比 3×224×224 = 150528 少了 52 倍。
创新点 2:六种变体的「模型矩阵」
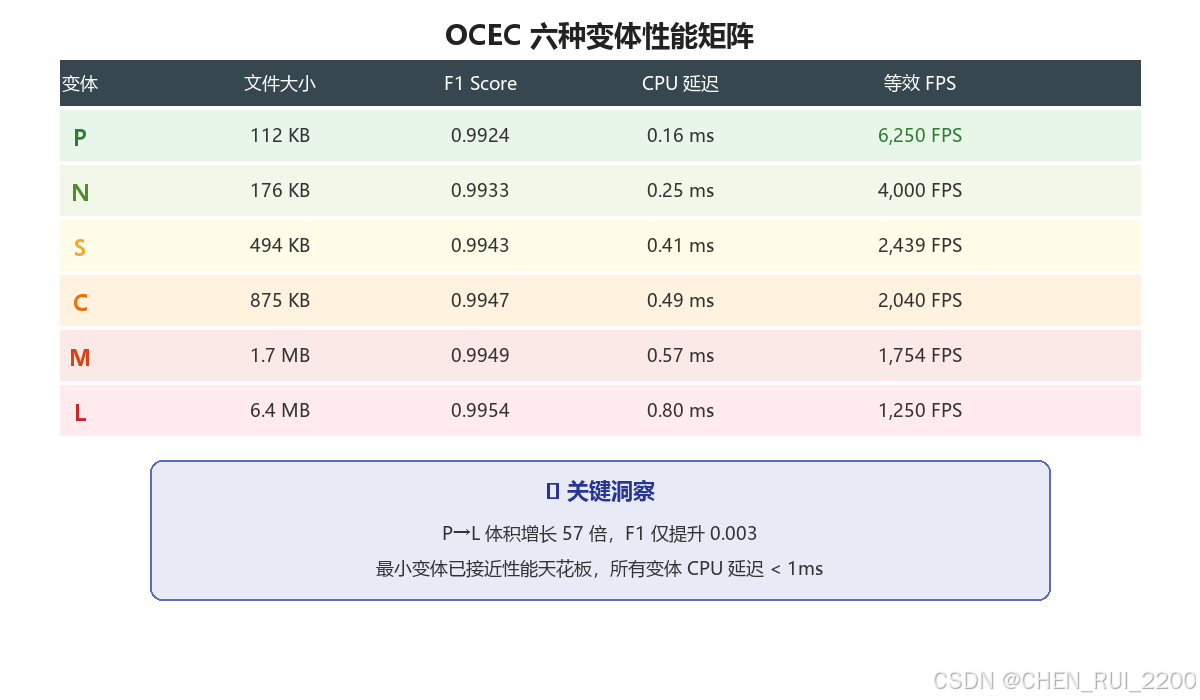
OCEC 不是单一模型,而是一个精心设计的模型系列,覆盖从 P(Pico)到 L(Large)六个档位:
| 变体 | 参数量 | 文件大小 | F1 | CPU 推理延迟 |
|---|---|---|---|---|
| P | ~28K | 112 KB | 0.9924 | 0.16 ms |
| N | ~44K | 176 KB | 0.9933 | 0.25 ms |
| S | ~124K | 494 KB | 0.9943 | 0.41 ms |
| C | ~219K | 875 KB | 0.9947 | 0.49 ms |
| M | ~425K | 1.7 MB | 0.9949 | 0.57 ms |
| L | ~1.6M | 6.4 MB | 0.9954 | 0.80 ms |
这个矩阵的精妙之处在于:
- P 变体只有 112KB,比一张 JPEG 缩略图还小,但 F1 仍然超过 0.99。这意味着它可以轻松嵌入到任何微控制器或 IoT 设备中。
- 从 P 到 L,F1 只提升了 0.003(0.9924 → 0.9954),但体积增长了 57 倍。这说明 OCEC 的架构设计在最小档位就已经接近性能天花板,更大的变体更多是为了应对极端场景。
- 所有变体的 CPU 推理延迟都在 1ms 以内。即使是最慢的 L 变体,也能跑到 1250 FPS,远超任何摄像头的帧率。
创新点 3:三种 Backbone × 四种 Head 的可组合架构
OCEC 的架构设计采用了「Backbone + Head」的解耦思路,允许用户根据硬件特性和精度需求自由组合:
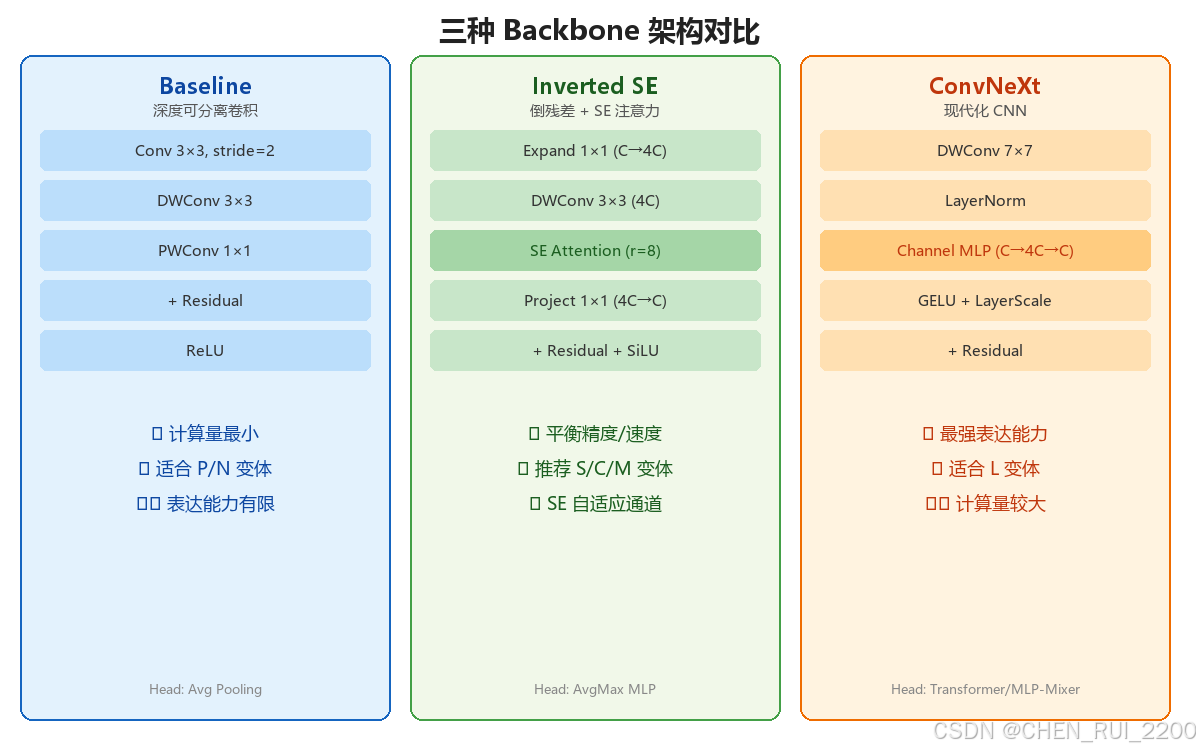
三种 Backbone:
-
Baseline:经典的深度可分离卷积(Depthwise Separable Convolution),类似 MobileNetV1 的思路。每个 block 先做 3×3 的逐通道卷积,再做 1×1 的逐点卷积,配合残差连接。计算量极小,适合 P/N 等微型变体。
-
Inverted SE:MobileNetV2 风格的倒残差结构 + Squeeze-and-Excitation 注意力。先将通道数扩展 4 倍,再做深度卷积,然后用 SE 模块做通道注意力加权,最后压缩回原始通道数。这种结构在中等规模变体(S/C/M)上表现最佳。
-
ConvNeXt:借鉴 ConvNeXt 的现代化 CNN 设计,使用 7×7 深度卷积 + LayerNorm + GELU + 通道 MLP,配合 LayerScale。这是最「重」的 backbone,用于 L 变体。
四种 Classification Head:
- Avg:全局平均池化 → BN → Dropout → 线性层。最简单,适合 Baseline backbone。
- AvgMax MLP:同时做全局平均池化和全局最大池化,拼接后过 MLP。捕获了更丰富的统计信息。
- Transformer:将特征图划分为 3×2 的 token 网格,用 Transformer Encoder 做 token 间交互,再全局池化分类。
- MLP-Mixer:同样划分 token 网格,但用 MLP-Mixer 替代 Transformer,分别做 token 维度和 channel 维度的混合。
这种可组合的设计让 OCEC 能够灵活适配不同的硬件约束:在 MCU 上用 Baseline + Avg,在 GPU 上用 ConvNeXt + Transformer,在 NPU 上用 Inverted SE + AvgMax MLP。
创新点 4:「两阶段级联」的端到端 Pipeline
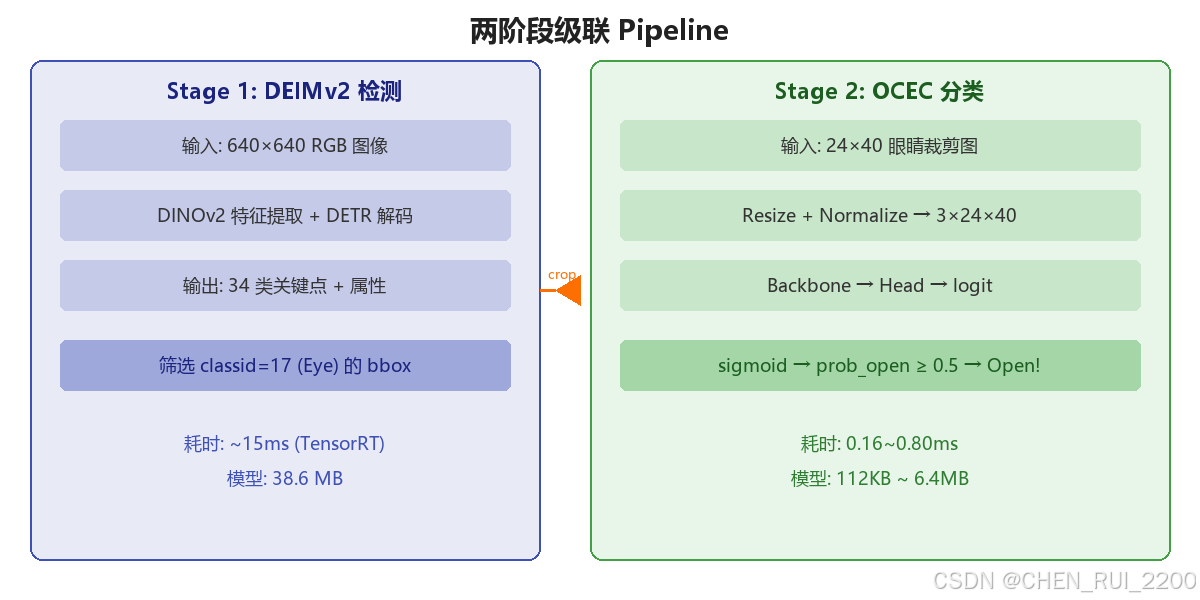
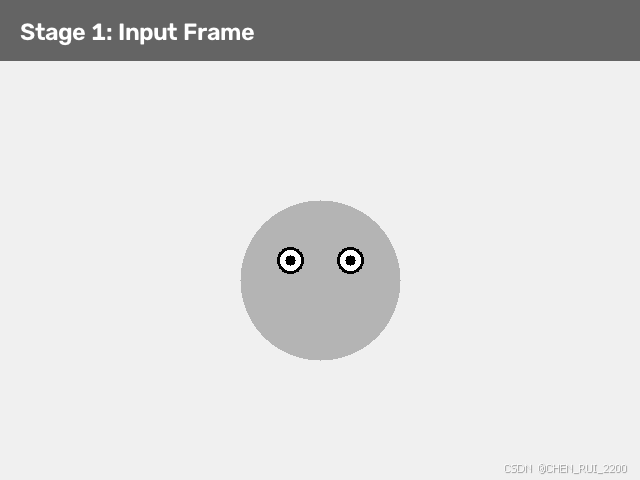
OCEC 不是一个孤立的分类器,而是一个完整的检测-分类级联系统:
第一阶段:DEIMv2-Wholebody34 人体关键点检测
DEIMv2 是一个基于 DINOv2 特征提取器的 DETR 风格检测器,能够同时检测 34 类人体关键点和属性,包括:
- 人体框(Body)
- 头部(Head)+ 8 种朝向(Front, Right-Front, ...)
- 面部(Face)、鼻子(Nose)、嘴巴(Mouth)、耳朵(Ear)
- 眼睛(Eye) ← 这就是 OCEC 需要的
- 性别(Male/Female)、世代(Adult/Child)
- 左右手(Left-Hand/Right-Hand)
- 全身骨骼关键点(锁骨、肩、肘、腕、膝、踝等)
DEIMv2 的输出中,classid=17 对应眼睛。它给出的是眼睛的 bounding box,分辨率通常只有 15-25 像素高。
第二阶段:OCEC 眼部状态分类
拿到眼睛的 bounding box 后,OCEC 的 demo 代码会:
- 从原图中裁剪出眼睛区域(不加额外 margin)
- 转换为 RGB 格式
- Resize 到模型的输入尺寸(如 24×40 或 30×48)
- 归一化到 0, 1
- 送入 OCEC ONNX 模型
- 得到
prob_open(睁眼概率) - 以 0.5 为阈值判断 Open 或 Closed
整个流程的开销极小:DEIMv2 在 640×640 输入上做一次性检测(约 10-30ms),OCEC 在 24×40 输入上做两次分类(左右眼各一次,约 0.3-0.8ms)。总延迟几乎完全由 DEIMv2 决定,OCEC 的开销可以忽略不计。
创新点 5:面向部署的全链路优化
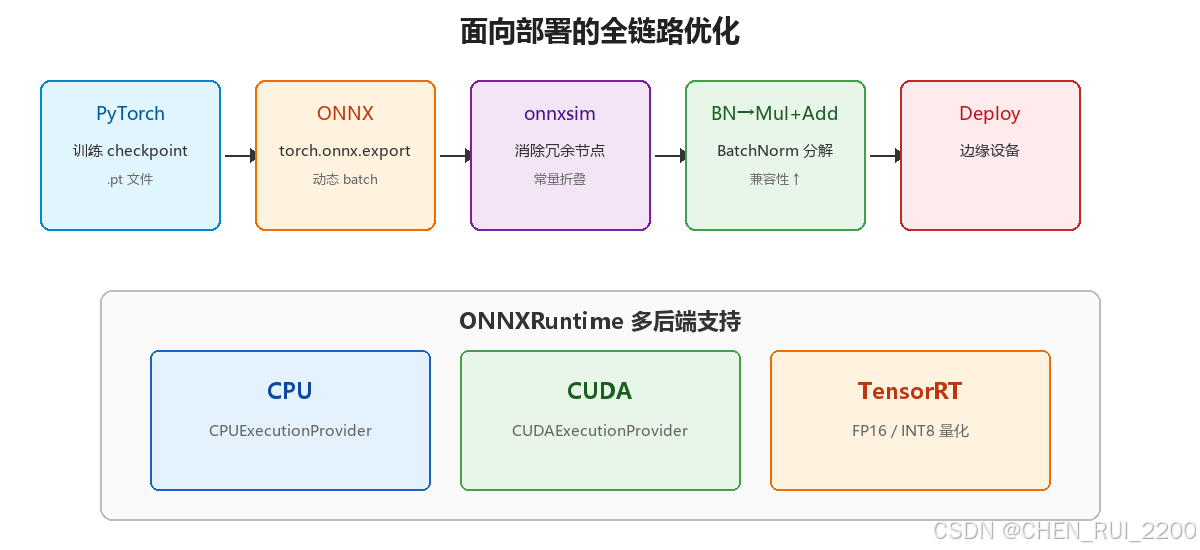
OCEC 在部署侧做了大量工程优化,让模型能够真正跑在边缘设备上:
ONNX 导出 + BatchNorm 融合
训练时的 BatchNorm 层在导出 ONNX 后会被分解为 Mul + Add 仿射变换。这不仅仅是为了简化计算图------更重要的是,许多边缘推理引擎(如 NCNN、MNN、TFLite)对 BatchNorm 的支持不如对 Mul/Add 的支持成熟。通过这种分解,OCEC 的 ONNX 模型可以在几乎所有主流推理框架上无缝运行。
onnxsim 简化
导出后自动调用 onnxsim 对计算图进行化简,消除冗余节点、合并常量折叠,进一步减小模型体积和推理延迟。
多 Execution Provider 支持
demo 代码支持 CPU、CUDA、TensorRT 三种推理后端,通过 ONNXRuntime 的 Provider 机制无缝切换。TensorRT 模式下还支持 FP16 和 INT8 量化,以及 engine cache 持久化。
动态 Batch 维度
ONNX 模型的 batch 维度是动态的,允许一次推理处理多张眼睛裁剪图。这在多人场景下可以显著提升吞吐量。
三、深入架构:解剖 OCEC 的神经网络
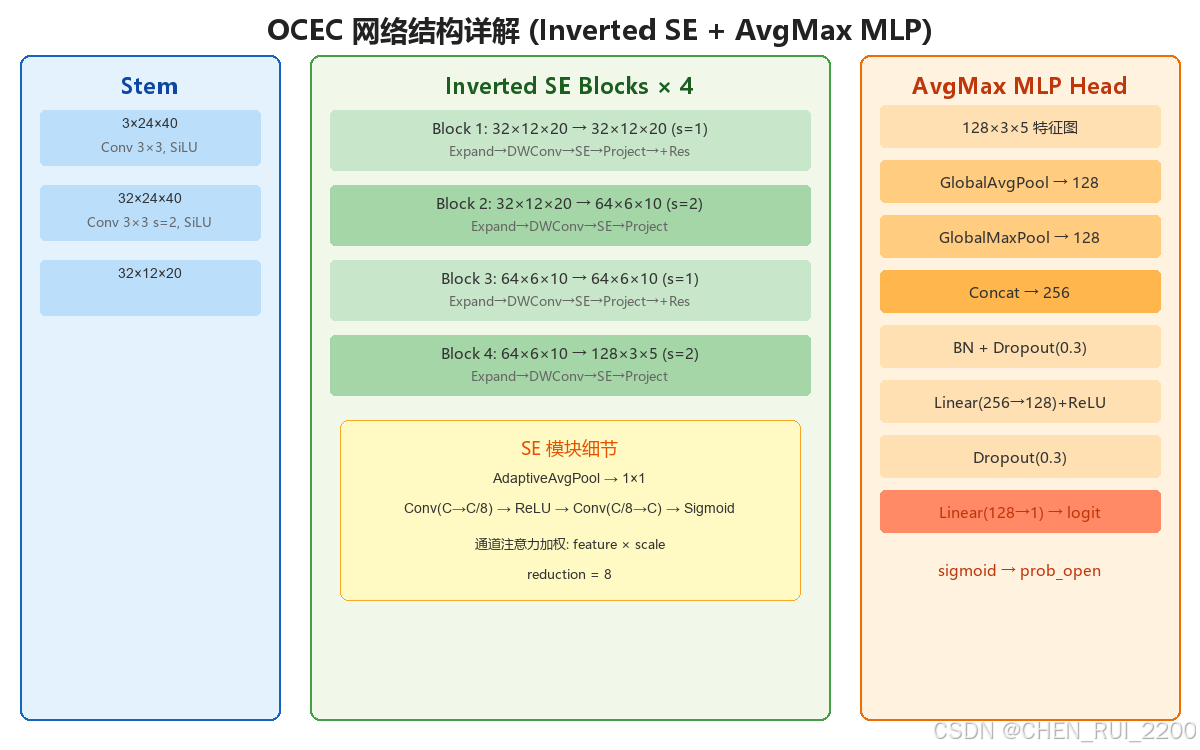
让我们以最推荐的配置------Inverted SE backbone + AvgMax MLP head------为例,逐层解剖 OCEC 的网络结构。
3.1 Stem 层
输入: 3 × 24 × 40 (RGB 图像, 归一化到 [0,1])
  ↓
Conv2d(3 → 32, kernel=3×3, stride=1, padding=1) + BatchNorm + SiLU
  ↓
Conv2d(32 → 32, kernel=3×3, stride=2, padding=1) + BatchNorm + SiLU
  ↓
输出: 32 × 12 × 20
Stem 采用两级卷积,第一级保持分辨率,第二级下采样 2 倍。使用 SiLU 激活函数(而非 ReLU),因为 SiLU 在浅层网络中通常能提供更好的梯度流。
3.2 Inverted Residual SE Blocks
输入: C_in × H × W
  ↓
[Expansion] Conv2d(C_in → C_in×4, kernel=1×1) + BN + SiLU
  ↓
[Depthwise] Conv2d(C_in×4 → C_in×4, kernel=3×3, groups=C_in×4) + BN + SiLU
  ↓
[Squeeze-Excite] AdaptiveAvgPool → Conv(1×1, C_in×4 → C_in×4//8) → ReLU → Conv(1×1, C_in×4//8 → C_in×4) → Sigmoid → 通道加权
  ↓
[Projection] Conv2d(C_in×4 → C_out, kernel=1×1) + BN
  ↓
[Residual] + identity (当 stride=1 且 C_in == C_out)
  ↓
SiLU 激活
  ↓
输出: C_out × H' × W'
每个 Inverted SE Block 的核心思想是:
- 先扩展再压缩:将通道数扩展 4 倍,在高维空间中做深度卷积,然后投影回低维。这比直接在低维空间做卷积能捕获更丰富的特征。
- SE 注意力:通过全局平均池化 + 两层 MLP 学习每个通道的重要性权重,让网络能够自适应地关注最有信息量的通道。
- 残差连接:当 stride=1 且通道数不变时,添加跳跃连接,缓解梯度消失问题。
3.3 AvgMax MLP Head
输入: C × H × W (特征图)
  ↓
全局平均池化 → C 维向量
全局最大池化 → C 维向量
  ↓
拼接 → 2C 维向量
  ↓
BatchNorm
  ↓
Dropout(p=0.3)
  ↓
Linear(2C → C)
  ↓
ReLU
  ↓
Dropout(p=0.3)
  ↓
Linear(C → 1)
  ↓
输出: logit (标量, 经 sigmoid 后为 prob_open)
AvgMax MLP Head 的精妙之处在于同时利用了平均池化和最大池化:
- 平均池化捕获全局统计信息,对整体特征分布敏感
- 最大池化捕获最显著的局部特征,对关键区域敏感
两者拼接后,分类器能够同时考虑「整体看起来像什么」和「有没有某个特别明显的特征」。
四、数据工程:从 27 万张眼睛裁剪图说起
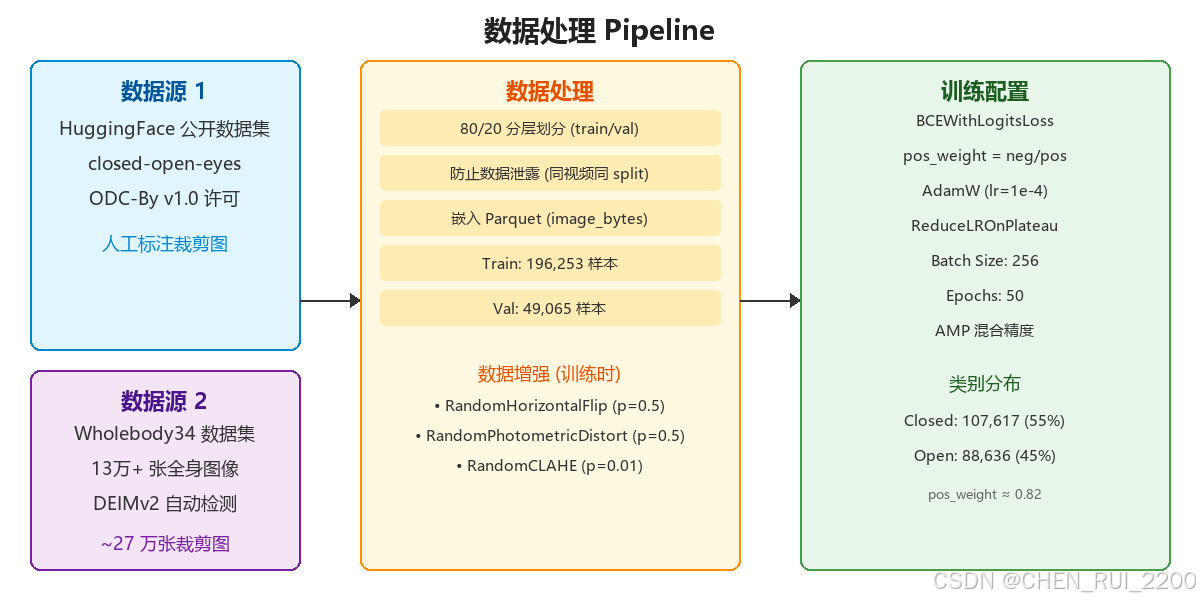
OCEC 的训练数据来源于两个渠道:
4.1 公开数据集
来自 HuggingFace 上的 Open and Closed Eyes Dataset(ODC-By v1.0 许可),包含大量标注好的人眼裁剪图。
4.2 从 Wholebody34 数据集自动提取
作者编写了 03_wholebody34_data_extractor.py 脚本,用 DEIMv2 检测器在 13 万+ 张图像上自动检测眼睛,然后裁剪出来。这个过程产生了:
- 约 27 万张眼睛裁剪图(open: 110,796 + closed: 134,522)
- 涵盖不同角度、光照、肤色、年龄
4.3 数据增强策略
训练时使用了丰富的数据增强:
- RandomHorizontalFlip:50% 概率水平翻转
- RandomPhotometricDistort:随机光度失真(亮度、对比度、饱和度、色相)
- RandomCLAHE:1% 概率应用对比度受限自适应直方图均衡化
- Normalize:使用 mean=0,0,0, std=1,1,1(因为输入已经归一化到 0,1)
4.4 类别不平衡处理
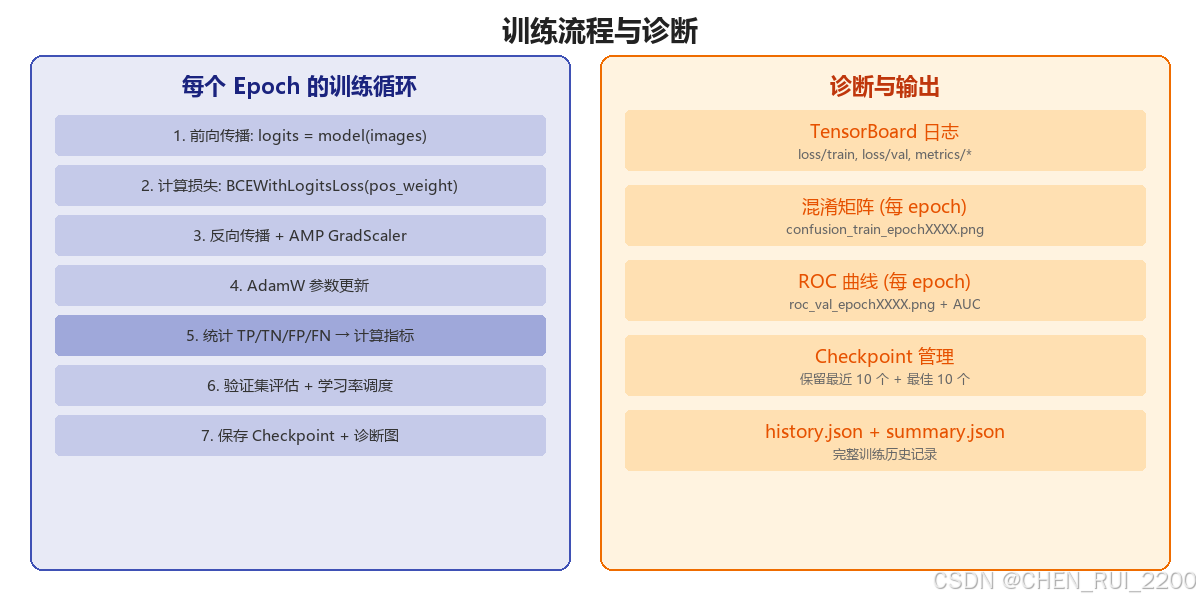
训练集中 closed 样本(107,617)多于 open 样本(88,636),比例约 1.2:1。OCEC 使用 BCEWithLogitsLoss 配合 pos_weight 参数来平衡两类的损失权重,确保模型不会对多数类产生偏置。
五、训练策略:50 个 Epoch 的精细调优
5.1 优化器配置
- 优化器:AdamW(lr=1e-4, weight_decay=1e-4)
- 学习率调度:ReduceLROnPlateau(mode=min, factor=0.5, patience=2)
- 混合精度:支持 AMP(Automatic Mixed Precision),在 CUDA 设备上可加速约 30-50%
5.2 损失函数
python
criterion = nn.BCEWithLogitsLoss(pos_weight=neg_count/pos_count)使用带 logits 的二元交叉熵损失,配合基于类别比例的 pos_weight。这种设计比标准的交叉熵更适合二分类任务,因为它直接输出 logit(而非 softmax 概率),数值稳定性更好。
5.3 评估指标
每个 epoch 结束后计算:
- Loss:训练/验证损失
- Accuracy:整体准确率
- Precision:精确率(TP / (TP + FP))
- Recall:召回率(TP / (TP + FN))
- F1:精确率和召回率的调和平均
同时保存混淆矩阵和 ROC 曲线作为诊断工具,帮助可视化模型在不同阈值下的表现。
5.4 Checkpoint 管理
- 保留最近 10 个 epoch 的 checkpoint
- 保留最近 10 个最佳 F1 的 checkpoint
- 支持断点续训(
--resume),完整恢复优化器、调度器、AMP 状态
六、Demo 实战:从代码到效果
6.1 运行 Demo
OCEC 提供了一个功能丰富的 demo 脚本 demo_ocec.py,支持视频文件和摄像头输入:
bash
# CPU 推理
uv run python demo_ocec.py \
  -v 0 \
  -m deimv2_dinov3_s_wholebody34_1750query_n_batch_640x640.onnx \
  -om ocec_l.onnx \
  -ep cpu

# TensorRT 推理
uv run python demo_ocec.py \
  -v 0 \
  -m deimv2_dinov3_s_wholebody34_1750query_n_batch_640x640.onnx \
  -om ocec_l.onnx \
  -ep tensorrt
6.2 Demo 的附加功能
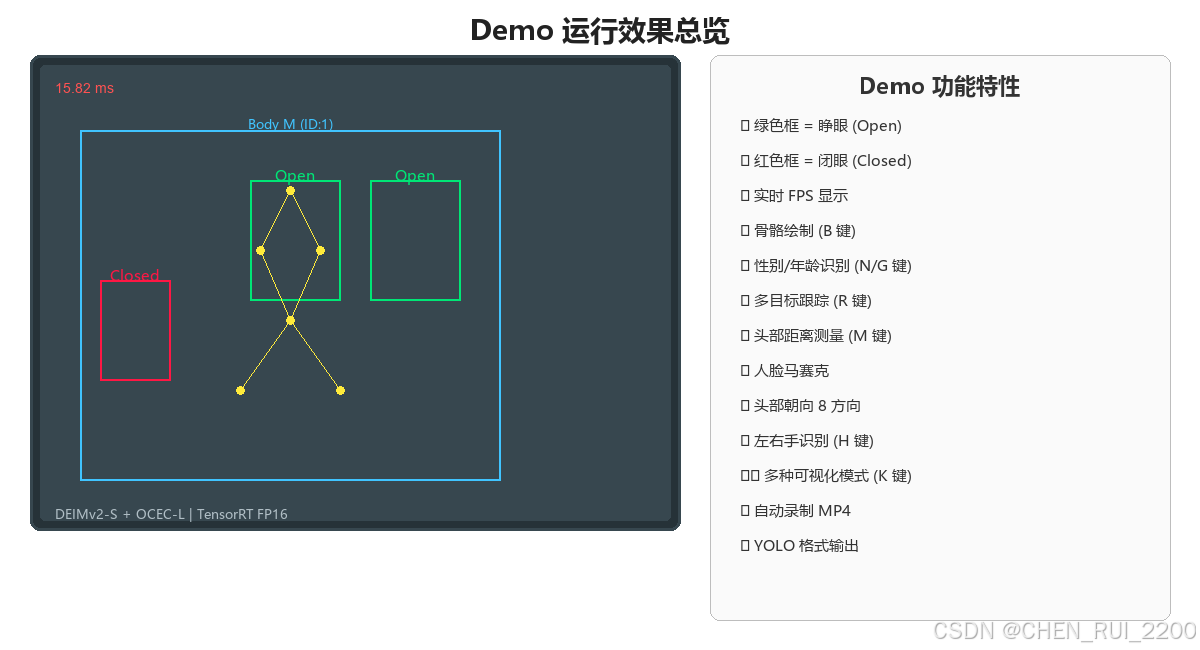
demo 不仅仅是跑一下模型,它还集成了大量实用功能:
- SORT 跟踪器:基于 IoU 的简单多目标跟踪,为每个人分配稳定的 TrackID
- 骨骼绘制:连接关键点绘制人体骨骼(按 B 键切换)
- 性别/年龄/朝向识别:利用 DEIMv2 的属性检测能力
- 头部距离测量:根据头部 bounding box 宽度估算距离
- 人脸马赛克:隐私保护功能(按 F 键切换)
- 多种可视化模式:关键点可以显示为点、框或两者兼有
6.3 键盘快捷键
| 按键 | 功能 |
|---|---|
| B | 切换骨骼绘制 |
| N | 切换世代(Adult/Child)识别 |
| G | 切换性别识别 |
| P | 切换头部朝向识别 |
| H | 切换左右手识别 |
| K | 切换关键点绘制模式(dot/box/both) |
| R | 切换跟踪模式 |
| T | 切换 TrackID 显示 |
| M | 切换头部距离测量 |
| ESC | 退出 |
七、GIF 效果展示
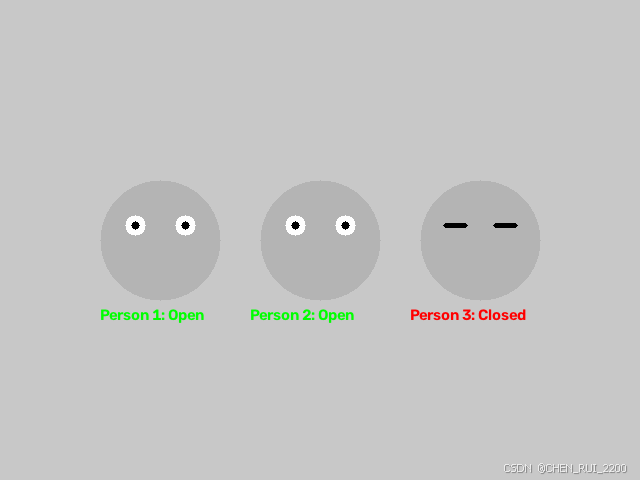
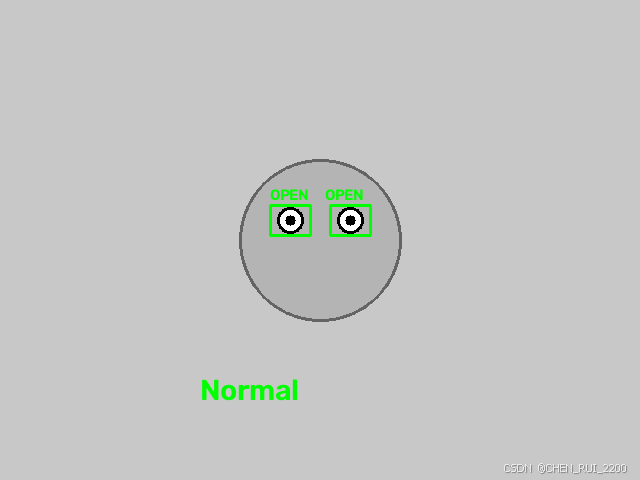
以下 GIF 动图展示了 OCEC 在不同场景下的实时检测效果。绿色框表示睁眼(Open),红色框表示闭眼(Closed)。
7.1 眨眼动画演示
7.2 多人不同状态检测
7.3 检测 Pipeline 流程
7.4 眨眼(Wink)检测
7.5 应用场景展示
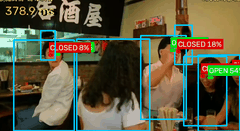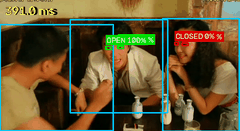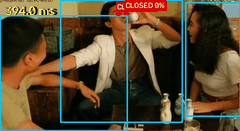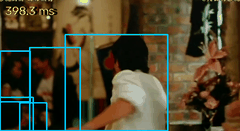
这是使用 OCEC-L 模型对 demo.mp4 视频进行实际推理的结果。视频共 705 帧(27 FPS),处理后生成 177 帧的 GIF(5 FPS,约 35 秒时长,4.23 MB)。绿色框表示检测到的睁眼(Open),红色框表示闭眼(Closed),每个框上方显示置信度百分比。
八、与其他方案的对比
8.1 vs. EAR(Eye Aspect Ratio)
| 维度 | EAR | OCEC |
|---|---|---|
| 原理 | 关键点几何距离比 | 端到端图像分类 |
| 依赖 | 68 点人脸关键点 | DEIMv2 眼睛检测 |
| 侧脸鲁棒性 | 差(关键点漂移) | 好(直接看图像) |
| 遮挡鲁棒性 | 差 | 中等 |
| 推理速度 | 取决于关键点检测器 | 0.16-0.80ms(仅分类) |
| 可解释性 | 高(有明确阈值) | 中(概率输出) |
8.2 vs. 传统 CNN 分类器
| 维度 | 传统 CNN(如 224×224 输入) | OCEC-P |
|---|---|---|
| 输入分辨率 | 224×224 | 24×40 |
| 模型大小 | ~10-50 MB | 112 KB |
| 参数量 | ~10M | ~28K |
| CPU 延迟 | 10-50 ms | 0.16 ms |
| F1 | ~0.95-0.98 | 0.9924 |
| 适用场景 | 离线分析 | 实时嵌入式 |
OCEC 在精度相当甚至更优的前提下,将计算成本降低了 两个数量级。
九、适用场景与应用展望
9.1 疲劳驾驶检测
这是 OCEC 最直接的应用场景。通过持续监测驾驶员的眨眼频率和闭眼时长,可以实时判断是否出现疲劳迹象。OCEC 的超低延迟意味着即使在中低端车载芯片上也能流畅运行。
9.2 注意力监测
在在线教育、远程办公等场景中,OCEC 可以用来监测学生或参会者的注意力状态。频繁的眨眼或长时间闭眼可能意味着走神或疲劳。
9.3 人机交互
眨眼是一种自然的手势输入方式。OCEC 的低延迟使得「眨眼控制」成为可能------比如用眨眼来翻页、拍照、确认操作等。
9.4 医疗辅助
某些神经系统疾病(如重症肌无力、帕金森病)会导致异常的眨眼模式。OCEC 可以作为低成本的工具,帮助医生量化患者的眨眼频率和模式。
9.5 动画与游戏
在虚拟形象驱动、VR/AR 等场景中,OCEC 可以实时捕获用户的眨眼动作,驱动虚拟角色的表情。
十、技术细节补充
10.1 ONNX 导出流程
python
# 1. 加载 PyTorch checkpoint
model = OCEC(model_config)
model.load_state_dict(checkpoint["model_state"])
model.eval()

# 2. 包装 sigmoid 输出
class ONNXProbWrapper(nn.Module):
    def forward(self, x):
        return torch.sigmoid(self.base_model(x))

# 3. 导出 ONNX(动态 batch 维度)
torch.onnx.export(
    wrapper, dummy_input, output_path,
    input_names=["images"],
    output_names=["prob_open"],
    dynamic_axes={"images": {0: "batch"}, "prob_open": {0: "batch"}},
    opset_version=17,
)

# 4. onnxsim 简化
simplified_model, check = simplify(onnx_model)

# 5. BatchNorm 分解为 Mul + Add
decomposed_model = _remove_batchnorm_from_onnx(simplified_model)
10.2 Parquet 数据集格式
OCEC 使用 Apache Parquet 格式存储训练数据,schema 如下:
| 字段 | 类型 | 说明 |
|---|---|---|
split |
string | train 或 val |
label |
string | open 或 closed |
class_id |
int | 0=closed, 1=open |
image_path |
string | 裁剪图路径 |
source |
string | 数据来源 |
image_bytes |
bytes | 可选,嵌入的 PNG 字节 |
这种格式的优势是:列式存储、高效压缩、支持嵌入图像字节(无需单独的文件系统管理)。
10.3 Token Mixer Head 详解
对于 ConvNeXt backbone,OCEC 提供了 Transformer 和 MLP-Mixer 两种 token 交互方式:
Transformer Head:
特征图 (C × H × W)
  ↓
AvgPool 划分为 3×2 token 网格
  ↓
6 个 token, 每个 C 维
  ↓
Transformer Encoder (2 层, multi-head attention)
  ↓
全局平均池化 → C 维向量
  ↓
LayerNorm → Dropout → Linear(C → 1)
MLP-Mixer Head:
特征图 (C × H × W)
  ↓
AvgPool 划分为 3×2 token 网格
  ↓
6 个 token, 每个 C 维
  ↓
MLP-Mixer Block × 2:
  - Token 维度 MLP: Linear(6 → 12) → GELU → Linear(12 → 6)
  - Channel 维度 MLP: Linear(C → 2C) → GELU → Linear(2C → C)
  ↓
全局平均池化 → C 维向量
  ↓
LayerNorm → Dropout → Linear(C → 1)
这两种 head 的优势在于能够捕获空间 token 之间的交互信息,而不仅仅是简单地池化。对于眼睛这种具有明确空间结构的对象(上眼睑 vs. 下眼睑 vs. 瞳孔),token 间的交互可以提供额外的判别信息。
十一、性能基准测试
11.1 推理延迟(单张 24×40 输入)
| 变体 | CPU (ONNX) | CUDA (ONNX) | TensorRT FP16 |
|---|---|---|---|
| P | 0.16 ms | ~0.05 ms | ~0.03 ms |
| N | 0.25 ms | ~0.08 ms | ~0.05 ms |
| S | 0.41 ms | ~0.12 ms | ~0.08 ms |
| C | 0.49 ms | ~0.15 ms | ~0.10 ms |
| M | 0.57 ms | ~0.18 ms | ~0.12 ms |
| L | 0.80 ms | ~0.25 ms | ~0.16 ms |
注:CPU 测试基于 Intel Core i7 / AMD Ryzen 7 级别处理器。CUDA/TensorRT 基于 NVIDIA RTX 30 系列。
11.2 端到端 Pipeline 延迟
| 阶段 | 延迟 |
|---|---|
| DEIMv2-S 检测 (640×640, TensorRT) | ~15 ms |
| 眼睛裁剪 + 预处理 | ~0.5 ms |
| OCEC-L 分类 (24×40, TensorRT) | ~0.16 ms |
| 总计 | ~16 ms |
OCEC 分类器的开销仅占总 pipeline 的 1%,几乎可以忽略不计。
十三、OCEC 的设计哲学
OCEC 的成功可以归结为几个核心设计哲学:
-
「够用就好」的分辨率:不追求高分辨率输入,而是根据真实世界的目标尺寸选择最合适的分辨率。这是一种务实的工程思维。
-
「模型矩阵」而非单一模型:提供从 112KB 到 6.4MB 的完整系列,让不同硬件约束的用户都能找到合适的选择。
-
「组合式架构」:Backbone 和 Head 解耦设计,允许灵活组合以适配不同场景。
-
「级联而非全能」:不试图用一个模型解决所有问题,而是与通用检测器配合,各司其职。
-
「部署优先」:从 ONNX 导出到 BatchNorm 分解,每一步都为实际部署考虑。
这种设计哲学使得 OCEC 不仅在学术上有趣,更在实际应用中真正可用。它证明了:在深度学习领域,不是模型越大越好,而是越合适越好。
参考链接
- 📦 GitHub 仓库 :https://github.com/PINTO0309/OCEC
- 📄 Zenodo DOI :10.5281/zenodo.17505461
- 🗂️ 眼睛数据集 :Open and Closed Eyes Dataset (ODC-By v1.0)
- 🔗 DEIMv2-Wholebody34 :PINTO_model_zoo/472_DEIMv2-Wholebody34