📚 本文收录于「流浪」的系列专栏
| 🐧 Linux系统 | ⚙️ C++ |
| 📊 数据结构与算法 | 🐍 Python |
| 🔗 LangChain & LangGraph | 🗄️ MySQL 数据库 |
| 🌿 Git 工具 | 🌐 计算机网络 |
| 🤖 LLM | 💯 大厂面试、八股 |
| 📚 学习筑基专栏 |
🏠 博客主页:流浪 | 📝 原创首发于 CSDN
上篇文章把 Agent 之间「怎么说话、怎么传话」讲透了------但光会通信还不够。
Agent 一旦自主跑起来,遇到高风险操作、低置信度判断、或者踩到红线,必须能「踩刹车、等人类点头」再继续。否则一个删除指令、一笔转账、一封发给全公司的邮件,模型一自信就全发出去了,后果没法撤回。这一篇讲人工介入(Human-in-the-Loop),以及它的两个近亲 HOTL、HOOTL,把「人该在哪儿、管什么」一次说清。
一、什么是人工介入
人工介入(Human-in-the-Loop,HITL)是指在 AI Agent 或自动化系统里引入人类的监督、干预或审批环节。当 Agent 遇到不确定、高风险、或需要价值判断的任务时,会主动暂停、向人类请求输入或确认,人类完成干预后系统再继续运行。它的核心作用是提升安全性、降低错误风险,并把人的知识与直觉融进自动化流程。
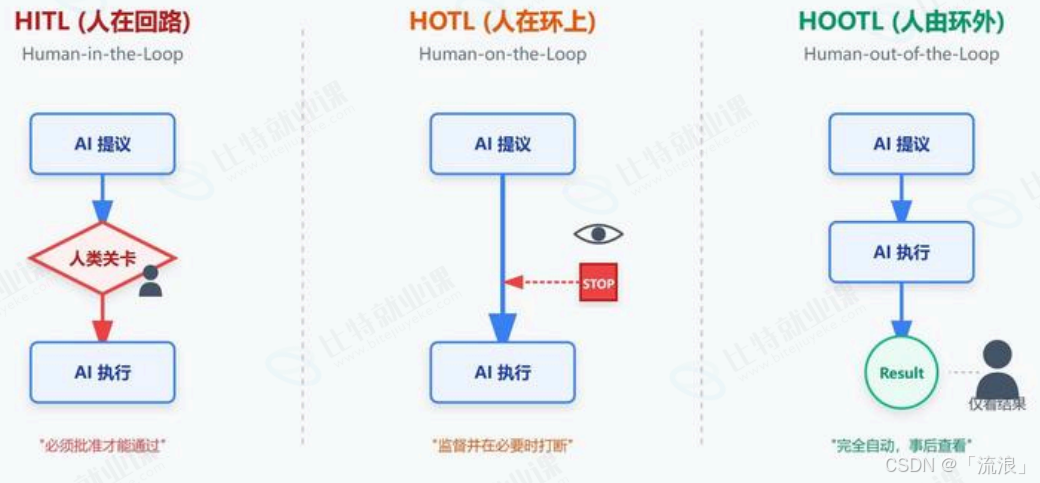
按「人参与的程度」,可以排成一条连续谱,从「人在回路」到「人在环上」再到「人在环外」:
HITL(人在回路·人必审批)
AI 提供预判,在预先设定的关键节点阻塞,停下来,强制等待人审批确认,才能继续往下走。核心逻辑是:系统是「助理」,人是「审批流」的必经节点------阻塞式。
例子:你买完单手机自动识别你的脸,识别清晰、金额小就直接支付(Agent 自动);可一旦金额超过 500 元,手机会弹窗让你输密码或按指纹------这就是「把人拉进来决策」,防止误刷。
HOTL(人在环上·监督与叫停)
AI 先全自动执行,人类不参与每一个决策,但保留「紧急制动」和「宏观调参」的权限。系统持续运行,人类在旁边实时监控仪表盘,只有当 AI 置信度跌破阈值、或检测到异常指标时才「拍下暂停键」接管。非阻塞式。
核心逻辑:AI 负责 99% 的常规操作,人负责监控长尾风险和策略调参。人是「空中交通管制员」,不指挥每一次起降,但管航路和应急处置。
例子:自动驾驶 L3 级别,车辆正常时自己开、驾驶员不碰方向盘(人在环上监控路况);一旦系统检测到前方施工、路径模糊,立刻报警要求驾驶员接管。
HOOTL(人在环外·完全自治)
人类彻底退出运行链路。系统不向人类请求实时输入,也不接受实时覆盖,人只在系统设计、训练、部署前设定好终极目标和约束。上线后一切决策由 AI 自主完成,且没有(或极长延迟的)暂停键。
核心逻辑:人是「立法者」,AI 是「执法者」。系统上线后不依赖任何实时人类输入,一切靠预设的奖励函数和约束边界。
例子:高频量化交易,算法以微秒级执行买卖,人类根本来不及反应,一旦启动就全自动运行------但事先设好了最大亏损熔断线。
三者核心区别一句话:HITL 是「必须等你点头才能继续」(阻塞式);HOTL 是「你先干着,我盯着,出大事我叫停」(非阻塞式);HOOTL 是「人已离场,系统靠预设规则与自学习自跑」。从人在回路到人在环外,本质是按风险等级分配人类参与度。
人工介入不是给 AI 降智,而是按「风险等级」分配人类参与度------风险越高、越不可逆,人越要卡在决策链路上。
二、为什么需要人工介入
AI 不是万能的,它在若干结构性短板上必须靠人兜底。下面用「问题场景 / AI 局限性 / 人工介入方案 / 示例」对照来看:
| 问题场景 | AI 局限性 | 人工介入方案 | 示例 |
|---|---|---|---|
| 高风险决策(医疗/金融/法律) | 错误后果严重,不可挽回 | 人类保留最终决策权 | AI 影像助手发现病人 CT 疑似肿瘤,并建议立即化疗 |
| 伦理与道德推理 | 缺乏价值观与常识推理 | 人类提供道德判断 | 某公司用 AI 筛简历,从历史数据学到「过去入职的都是男性」,于是自动淘汰女性简历 |
| 创造性任务 | 生成内容常平庸、需优化 | 人类编辑确保质量 | 让 AI 写运动鞋广告词,出来「穿上这双鞋,跑得更快走得更远」------挑不出错但很平;资深文案改成更有梗、更口语的版本 |
| 责任归属与法律合规 | AI 不是法律主体,无法担责 | 人类审核确认 | AI 自动生成内容若涉诽谤、侵权或造成损失,必须有一个「人类在环」来确认并担责,保证可追溯与问责 |
| 「表面通顺底层破绽」 | LLM 难可靠处理边界情况 | 人工审查复杂案例 | AI 审租赁合同时见「租金随市场波动动态调整」认为语法没问题;法务介入发现「动态调整」没设比例上限,是巨大法律漏洞 |
收尾一句话:人工介入不是要取代 AI,而是构建一种「人机协同」的伙伴关系------AI 负责广度与效率,人类负责深度与良知。在未来,好的设计不是追求「零介入」,而是追求「精准介入」:在关键决策点引入最高质量的人类判断,用最小干预成本换最大系统安全性与社会信任度。
人工介入的本质价值是「责任可追溯 + 边界兜底」,它补的是 AI 在价值观、法律责任、长尾风险上的结构性短板。
三、人工介入的基本工作流程
人类审核时往往有三种选择,每种对应不同的 Agent 行为:
- 批准(Approve):直接执行。
- 拒绝(Reject):停止执行。
- 修正(Edit):用人类修改完善后的参数继续运行。
这三类决策在现代 Agent 框架里是标配。以 LangChain 的 HITL 实现为例,一次待审动作可以携带 allowedDecisions: ["approve", "reject", "edit", "respond"],人类不只是「放行/拦截」,还能直接改掉 Agent 要调的工具参数(比如把发错地址的邮件改对再发)------这比单纯拦截更有工程价值。
把「人」建模成一个有「批准/拒绝/修正」三态输出的节点,Agent 工作流就能在任意关键步插入人为 gate。
四、HITL 的核心步骤(中断---保存---恢复)
HITL 模式在工程上主要有三步:
- 中断:流程在重要节点先暂停,不继续执行。
- 保存:把现场所有状态都记住,方便后续恢复。
- 恢复 :等人类审核确认后,流程再接着走。
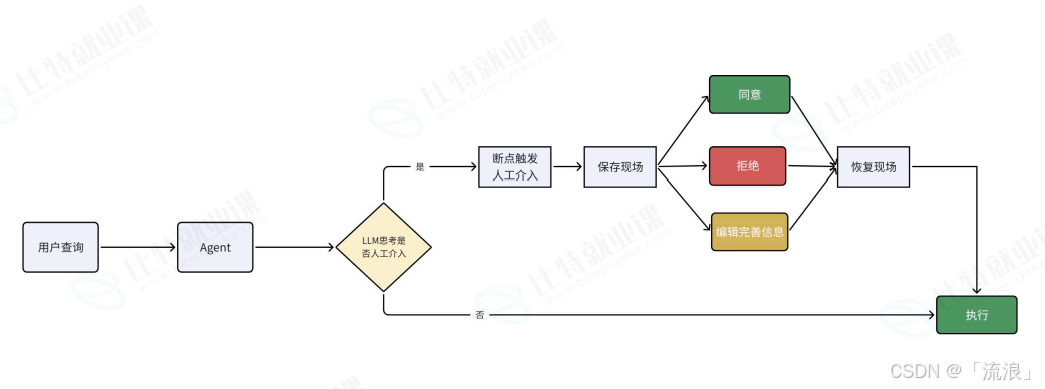
这套三步看着简单,关键是「保存」不能省。没有状态保存,恢复时就只能从头重跑------而重跑一遍意味着重新消耗 token、重新触发副作用,甚至可能重复执行那个危险操作。所以 HITL 的工程骨架本质是给运行中的 Agent 做检查点(checkpoint) :把图状态(上下文、中间结果、待执行动作)持久化到存储,中断时落盘,恢复时按 thread_id 精准续跑。业界框架(如 LangGraph)正是靠「持久化检查点」而非内存变量,才做到中断几小时、几天甚至换台机器都能接着跑。
中断---保存---恢复三步是 HITL 的工程骨架,本质是「给运行中的 Agent 做检查点」,没有状态保存就没有安全恢复。
五、HITL 的触发机制(四种逻辑)
触发机制是 HITL 的「门禁」,常见的有四种判断逻辑:
- 敏感动作触发(High-Stakes Actions):涉及转账、删除数据、法律协议签署等不可逆的「红线」操作。这对应面试里常被强调的「执行层拦截」------闸门要装在工具调用层,而不是规划层。
- 业务逻辑触发(Guardrails):违反了预设的硬规则,如预算超标、字数超限、命中敏感词。
- 异常死循环触发(Loop Detection):AI 连续多次尝试同一错误操作无法跳出时,强制请求人工接管------这也是防 Agent 自杀式重试的手段。
- 低置信度触发(Low Confidence):AI 对当前决策的概率评分低于设定阈值(例如 P < 0.8,也可按业务调成 0.85)就暂停让人判断。前提是模型「知道自己不知道」,一个过度自信的模型即使该触发也不触发。
四类触发分别卡「不可逆动作 / 硬规则 / 行为异常 / 模型不确定」四类风险。设计时的经验法则:触发条件要可配、可观测,且只在少数高风险写操作上设最小检查点------「过度设卡」(每步都审批)是公认的反模式,会拖垮自动化的价值。
六、与篇十一协议的衔接
HITL 的人为 gate 常落在 Agent 工作流的关键节点上:它可以表现为一个「人类审批」工具/节点,也可以由上层编排器(见篇十的层级主管 / 中心化协调模式)在调用工具(MCP)或委派任务(A2A)之前插入人工确认。也就是说,篇十一讲的通信协议负责「Agent 之间怎么对话」,而人工介入负责「对话里哪些动作必须等人点头」------两者正交、互补。
七、面试题
7.1 推导题
【推导】从「LLM 在边界情况/低置信度下易出错 + 法律责任必须由人类主体承担」出发,推导为什么生产级 Agent 必须内置 HITL;并进一步推导:为什么 HITL 的工程实现必须包含「状态保存(checkpoint)」而非简单阻塞?
推导链:
- LLM 在分布外、低置信度、或含价值的边界情形下会稳定出错(见篇六自回归生成的幻觉与不确定性、篇九 Agent 的反思/自我修正机制),而高风险动作(删库、转账、发公开内容)一旦错付就不可逆。
- 现行法律框架下 AI 不是法律主体,无法为诽谤、侵权、资损担责------必须有一个「人类在环」来确认并担责,否则系统不可合规运营。
- 因此生产级 Agent 不能只靠「模型自己说 finish」,必须在高风险写操作前设人为 gate,即内置 HITL。
- 但 HITL 若只是「同步阻塞等回复」,恢复时就只能从头重跑------重跑会再烧 token、再触发副作用,甚至重复执行危险动作。要安全恢复,必须能把中断那一刻的完整现场(上下文、中间状态、待执行动作)持久化下来,按
thread_id精准续跑。所以状态保存(checkpoint)是 HITL 的工程前提,而非可选项;这也呼应了篇十一「Agent 协议建在成熟网络栈之上」的工程取舍------持久化检查点常落在数据库(如 Postgres),与 Agent 的通信协议分层解耦。
7.2 真题
【真题·转述自《Agent面试题满分回答:Agent 的核心组件有哪些?》】 HITL 的插入点怎么设计?低风险和高风险任务分别怎么处理?
思路:三种插入范式------条件边中断、Tool 节点拦截、状态机断点。设计原则:低风险任务(信息检索、摘要)失效率低、全自动;高风险操作(取消订单、改配置、发通知、删库)在执行前插入人工审核节点。人做决策、Agent 做执行;HITL 应是异步的,不阻塞 Agent 主流程(引 GitCode 面试实战 30 题 Q26、牛客阿里面经)。
【真题·转述自prepgenaicerts · Human-in-the-Loop 词条 / 牛客:阿里淘宝闪购 Agent 实习一面】 HITL 的触发机制一般有哪些?低置信度怎么定义、阈值怎么定?
思路:检查点该插在「动作不可逆 / 高波及半径 / 置信度低于阈值 / 监管需签字 / 成本超阈值」之处。低置信度即模型对当前决策的自评概率低于阈值,常见取值 0.8~0.85 可调(示例阈值 P<0.8)。注意「过度设卡」是 anti-pattern------只在少数高风险写操作上设最小检查点,而非每步审批。
【真题·转述自LangChain 官方 Human-in-the-Loop 文档 / LangGraph HITL 实战】 HITL 的「中断---保存---恢复」在工程上怎么实现?状态保存在哪、怎么恢复?
思路:以 LangGraph 为例,节点内调用
interrupt()暂停,checkpointer(开发用 InMemorySaver,生产用 PostgresSaver)把图状态持久化到库;恢复时带thread_id+Command(resume=...)从精确断点续跑,决策支持 approve/reject/edit。状态不丢失的关键是「持久化检查点」而非内存变量------这也解释了为什么异步等待人工审批几小时,上下文也不会丢(GitCode Q27)。
💬 结语:Agent 会通信、能组队,但不能放手乱跑------高风险动作错付就不可逆,而 AI 不是法律主体、没法替你担责。人工介入把「人」放回决策链路:HITL 阻塞式「等你点头」、HOTL 非阻塞式「你干我盯」、HOOTL「人已离场靠规则自跑」,归根到底就是「中断---保存---恢复」三步,checkpoint 是安全恢复的前提。你最该先给哪类操作加审批闸?评论区聊聊。觉得有收获,点个赞再走,关注流浪,大模型技术全景持续更新。