你有没有试过用 AI 做视频?点开那些工具,输一句话,它确实能吐出几秒画面------然后就没了。想接着讲个故事?角色换一帧就变张脸,场景跳来跳去,跟没睡醒似的。
我前阵子被这事儿烦到了,就去翻了一圈开源社区,撞见一个叫 ViMax 的项目(HKUDS 团队做的,已经开源)。它想干的事挺野:把导演、编剧、制片人、视频生成器全塞进一个系统里,让你丢一个想法进去,它自己把脚本、分镜、角色、成片一步步做出来。
我花了一晚上把它跑起来试了试。这篇文章就聊聊:它到底解决了什么痛点、怎么用、和我之前用过的工具有啥不一样。不吹不黑,都是我自己踩出来的体会。
一句话先说清:它是个啥
ViMax 是个多智能体框架 多个 AI 角色各管一摊,像剧组里导演管调度、编剧管台词,互相配合而不是一个人全干。你给它一个输入(一句话、一个剧本、甚至一整章小说),它自动走完「写脚本 → 画分镜 → 生成画面 → 拼成视频」全流程,中间基本不用你上手。
用人话讲:以前你用 AI 做视频,得像包工头一样,自己写提示词、自己盯角色别跑偏、自己把片段剪一起。ViMax 想做的是把这套「剧组班底」自动化------你当个丢需求的投资人就行。
它有两个模式,对应两种人:
- Idea2Video:你只有个模糊念头("猫和狗是朋友,遇到新猫会怎样?"),它连脚本带视频一起给你。
- Script2Video:你已经写好剧本了,它照着拍。
一个想法,是怎么变成视频的
我翻了下它的设计,整体是一条流水线。别被"架构"俩字吓到,其实就是一道道工序:
- 理解输入:它先读你的想法/剧本,把角色、场景、你想要啥风格扒出来。
- 写脚本:长文本(比如小说章节)会用 RAG 检索增强生成,简单说就是让 AI 先去翻资料再动笔,避免瞎编和遗漏关键情节 切成一段段能拍的戏。
- 画分镜:用电影语言把每个镜头规划好(近景还是全景、谁在哪儿)。
- 选参考图:这是关键一步,后面单独讲。
- 生成画面 + 拼视频 :先出图,再用图去生成视频片段,最后切到一起。
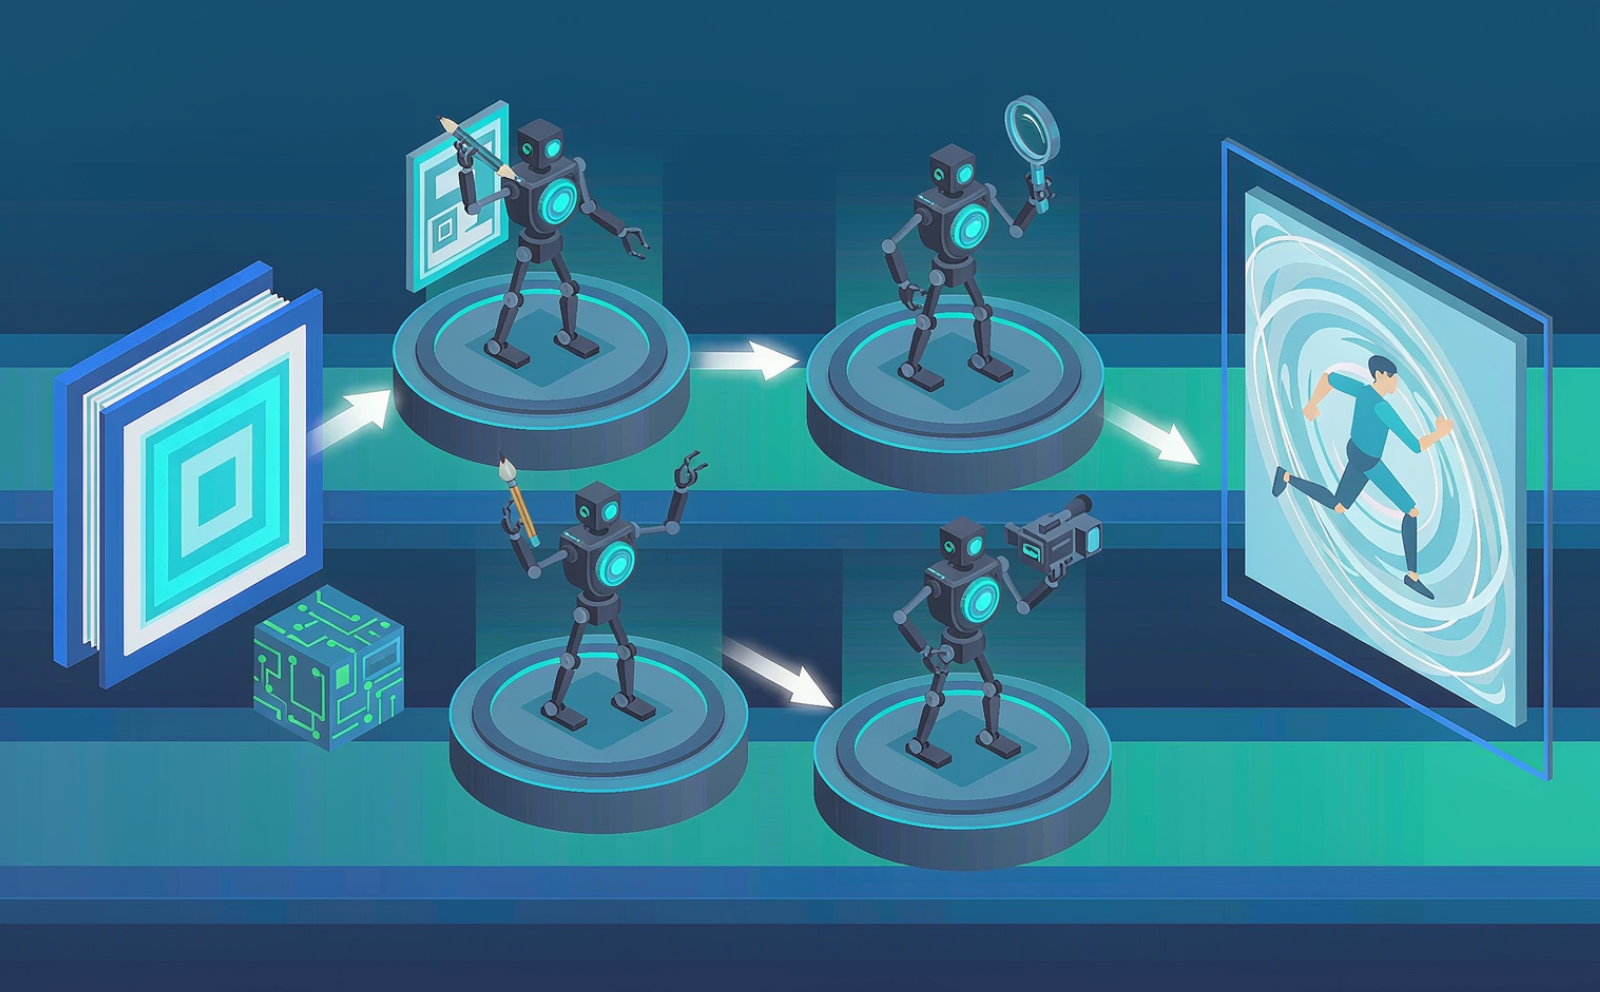
打个比方:它就像个自动化的小剧组。你递个故事梗概,编剧立刻出剧本,导演拿着剧本画分镜,制片人去挑演员定妆照,最后摄像开机。全程没人喊你补材料。
两种玩法,代码都在这
玩法一:Idea2Video(想到啥就拍)
这个适合"我有个点子但懒得写剧本"的情况。你给一段想法 + 几句要求 + 一个风格,剩下的它包了。
Pythonidea = """
如果一只猫和一只狗是好朋友,当它们遇到一只新猫时会发生什么?
"""

user_requirement = """
面向儿童,不超过 3 个场景。
"""

style = "Cartoon"

# 直接跑:python main_idea2video.py
我拿这个例子试了,它真能憋出一个有头有尾的儿童小故事,角色从头到尾长一样,不是每帧换个脸。
玩法二:Script2Video(拿着剧本拍)
如果你本来就会写剧本(或者想精确控制剧情),用这个。它支持专业剧本格式,就是电影里那种 EXT. 学校体育馆 - 日 的写法。
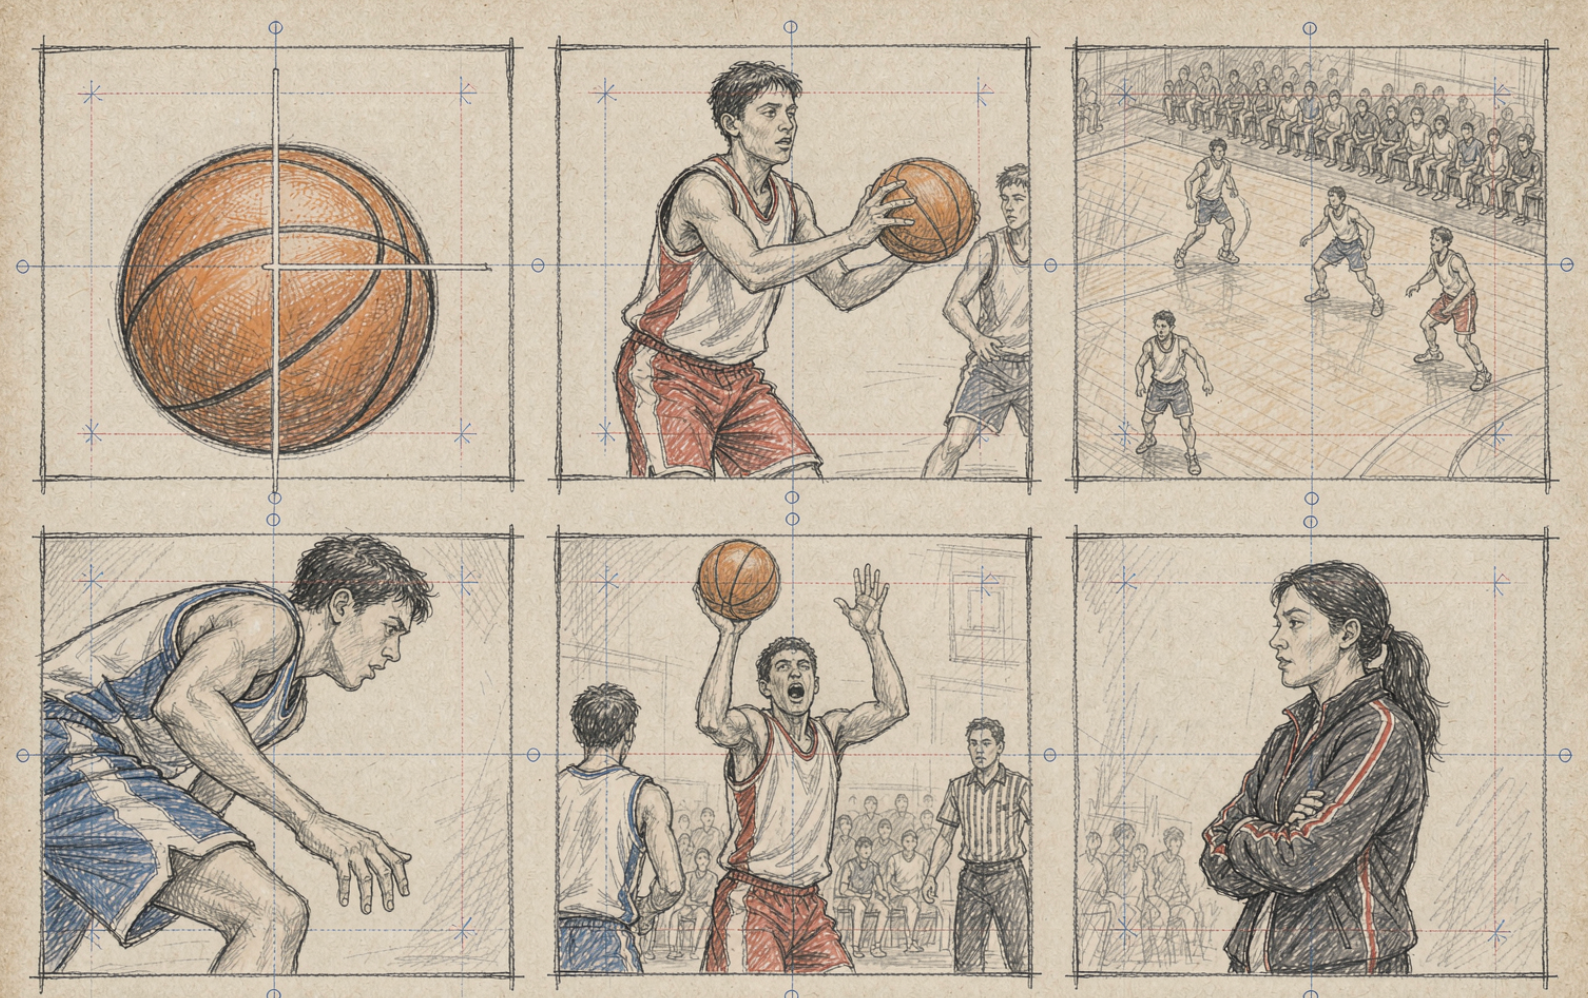
▲ 配图(示意):一页分镜,每个格子是一个镜头,标了景别和机位。
这正好是 ViMax「画分镜」那一步干的事------它先用电影语言把镜头规划好,再开拍。
它真正解决的痛点:角色不再"变脸"
说实话,AI 视频最劝退我的就是一致性。你生成一个蓝眼睛卷发女主,下一帧变成黑眼睛直发,故事根本讲不下去。
ViMax 在这块下了功夫,核心是两招:
1. 智能选参考图。 要生成新的一帧,它不光看当前这句台词,还会去翻"之前时间线里出现过的相关画面"------同一角色的定妆照、同一个场景的图,挑最贴的当参考。相当于每次拍新镜头,都先把演员的定妆照递给摄像。
2. 自动一致性检查。 它同一个镜头会并行生成好几张候选图,再用 MLLM/VLM 能"看懂"图片的多模态大模型,相当于请了个美术指导帮你看哪张最对味 打分,挑"角色最像、场景最稳"的那张当第一帧。这其实是在模仿真人导演的工作流:多拍几条,选最好的用。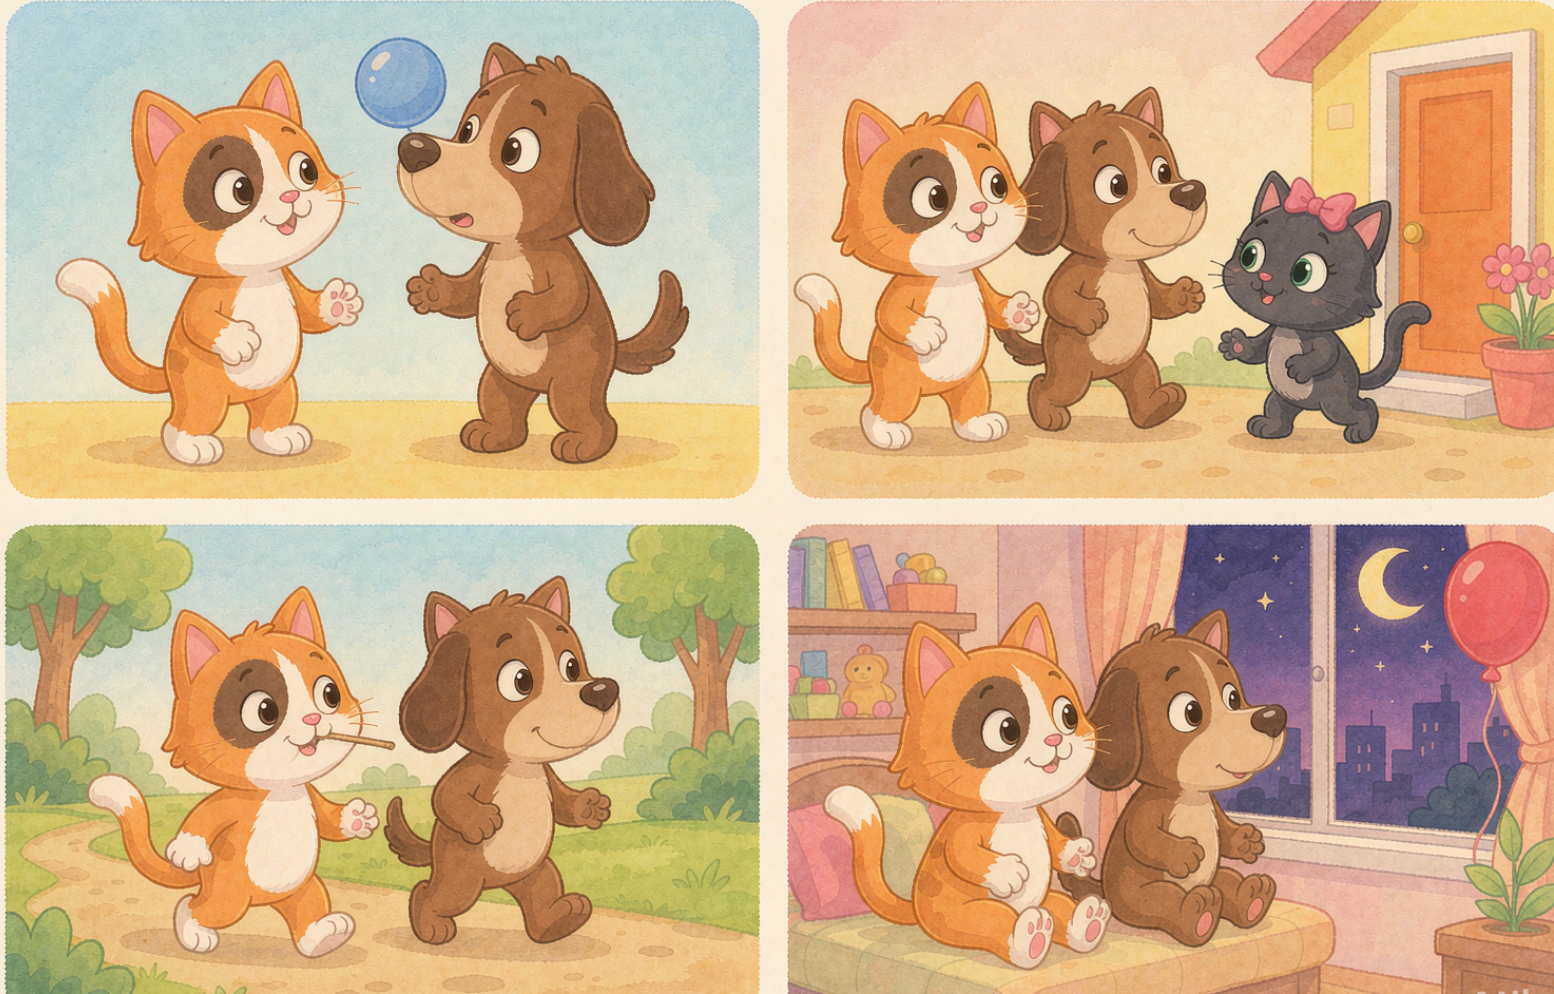
▲ 配图(示意):四个格子里是同一只橘猫和棕狗,跨场景长一个样。
这正是 ViMax 想保证的"跨帧一致性"------也是它和传统短片段工具最大的区别。
我翻源码看下来,它还有个多机位模拟:同一个场景能同时出好几个角度的镜头,而且角色位置、背景都对得上,看片时更有"电影感"而不是"PPT 翻页"。
我实际试了几个场景
| 场景 | 我的输入 | 出来的效果 | 合不合适 |
|---|---|---|---|
| 儿童故事 | 猫狗做朋友的点子 + Cartoon 风格 | 有完整叙事、角色稳定、场景连贯 | ✅ 很合适 |
| 小说章节 | 贴一段几千字文本 + Cinematic 风格 | RAG 自动分段成多场戏,保留原作情节 | ✅ 它的强项 |
| 专业剧本 | 篮球馆剧本 + Animate 风格 | 镜头设计、角色一致,成片接近电影质感 | ✅ 合适 |
| 产品营销 | 智能手表卖点 + Modern Tech 风格 | 快速出展示视频,带功能解说 | ⚠️ 能用但别指望精细 |
💡 我的体会:它最适合"有叙事、要连贯"的内容(故事、小说、教育、营销短片)。纯炫技的 3 秒特效,反而用它有点重。
上手要踩的坑:装和配
装本身不难,它用 uv 管环境(一个比 pip 快很多的 Python 包管理器):
Bash# 1. 装 uv(没有的话):参考 https://docs.astral.sh/uv/getting-started/installation/
# 2. 克隆项目
git clone https://github.com/HKUDS/ViMax.git
cd ViMax
# 3. 装依赖
uv sync真正要花心思的是配三个 API Key。它把活拆给了三个模型:
-
聊天模型:负责写脚本、做决策(它默认用 Gemini 的某个版本,走 OpenRouter)。
-
图像生成器:出每一帧的画面。
-
视频生成器:把图变成动态视频。
YAML · configs/idea2video.yamlchat_model:
init_args:
model: google/gemini-2.5-flash-lite-preview-09-2025
model_provider: openai
api_key: <YOUR_API_KEY>
base_url: https://openrouter.ai/api/v1image_generator:
class_path: tools.ImageGeneratorNanobananaGoogleAPI
init_args:
api_key: <YOUR_API_KEY>video_generator:
class_path: tools.VideoGeneratorVeoGoogleAPI
init_args:
api_key: <YOUR_API_KEY>working_dir: .working_dir/idea2video
踩坑提醒:生成结果都丢在
.working_dir/下(分 scripts / storyboards / images / videos / logs)。跑挂了先看 logs 里哪一步的 API 报错,多半是 key 没配对或者额度不够。想重来就rm -rf .working_dir/idea2video/*清掉再跑。
另外你可以调不少参数:比如聊天模型的 temperature(控制脑洞大小)、图像 quality、视频 resolution 和 fps,还有一致性检查的相似度阈值、并行生成的worker数。这些都在 yaml 里,照着注释改就行。
它和别的工具,差在哪
我把常用的几类放一起比了比:
| 对比项 | ViMax | 传统文生视频 (Runway/Pika 等) | 手动做视频 (PR/AE) |
|---|---|---|---|
| 能生成多长 | 支持长视频 | 就几秒片段 | 无限制但累 |
| 角色/场景一致 | 高(智能选参考图) | 低(帧间乱跳) | 高(人控) |
| 有没有叙事结构 | 完整(脚本+分镜) | 基本没有 | 完整但费时 |
| 自动化程度 | 高(端到端) | 中(只管生成) | 低(全手动) |
| 吃不吃长文本 | 吃(RAG 引擎) | 不吃 | 吃但慢 |
| 出片质量 | 电影级 | 一般 | 最高 |
| 速度 / 成本 | 快但 API 要钱 | 快也要钱 | 慢且人力贵 |
跟 Code2Video(专门做教学/数学可视化视频的)比,ViMax 是通用叙事向的------数学公式动画它不擅长,但小说转视频、营销短片它强得多。
谁适合用,谁先别碰
适合:
- 内容创作者、视频号玩家,想快速把文字变视频;
- 要批量产视频的团队(教育、营销);
- 想把小说/故事做成视频的人;
- 对多智能体系统本身感兴趣、想读源码的研究者。
先别碰(或降低预期):
- 你只想要 3 秒炫酷特效------杀鸡用牛刀;
- 你不想折腾三个 API Key、不想看账单------它有调用成本;
- 你要电影级精修、复杂特效------手动做还是更稳。
项目地址 & 小结
项目已经开源(MIT 协议,能随便用),地址在这:github.com/HKUDS/ViMax。
总结一句我的真实感受:它不一定是最强的"单帧画质"工具,但在**「把一个想法变成一段讲得通、角色不崩的视频」**这件事上,是我试过最省心的开源方案。如果你也受够了 AI 视频"几秒就断片、角色天天变脸",值得拉下来跑一晚试试。