SSE 接口设计 vs Agent UI:四个开源项目,把「模型吐词」和「界面更新」拆开后,我看懂了差距
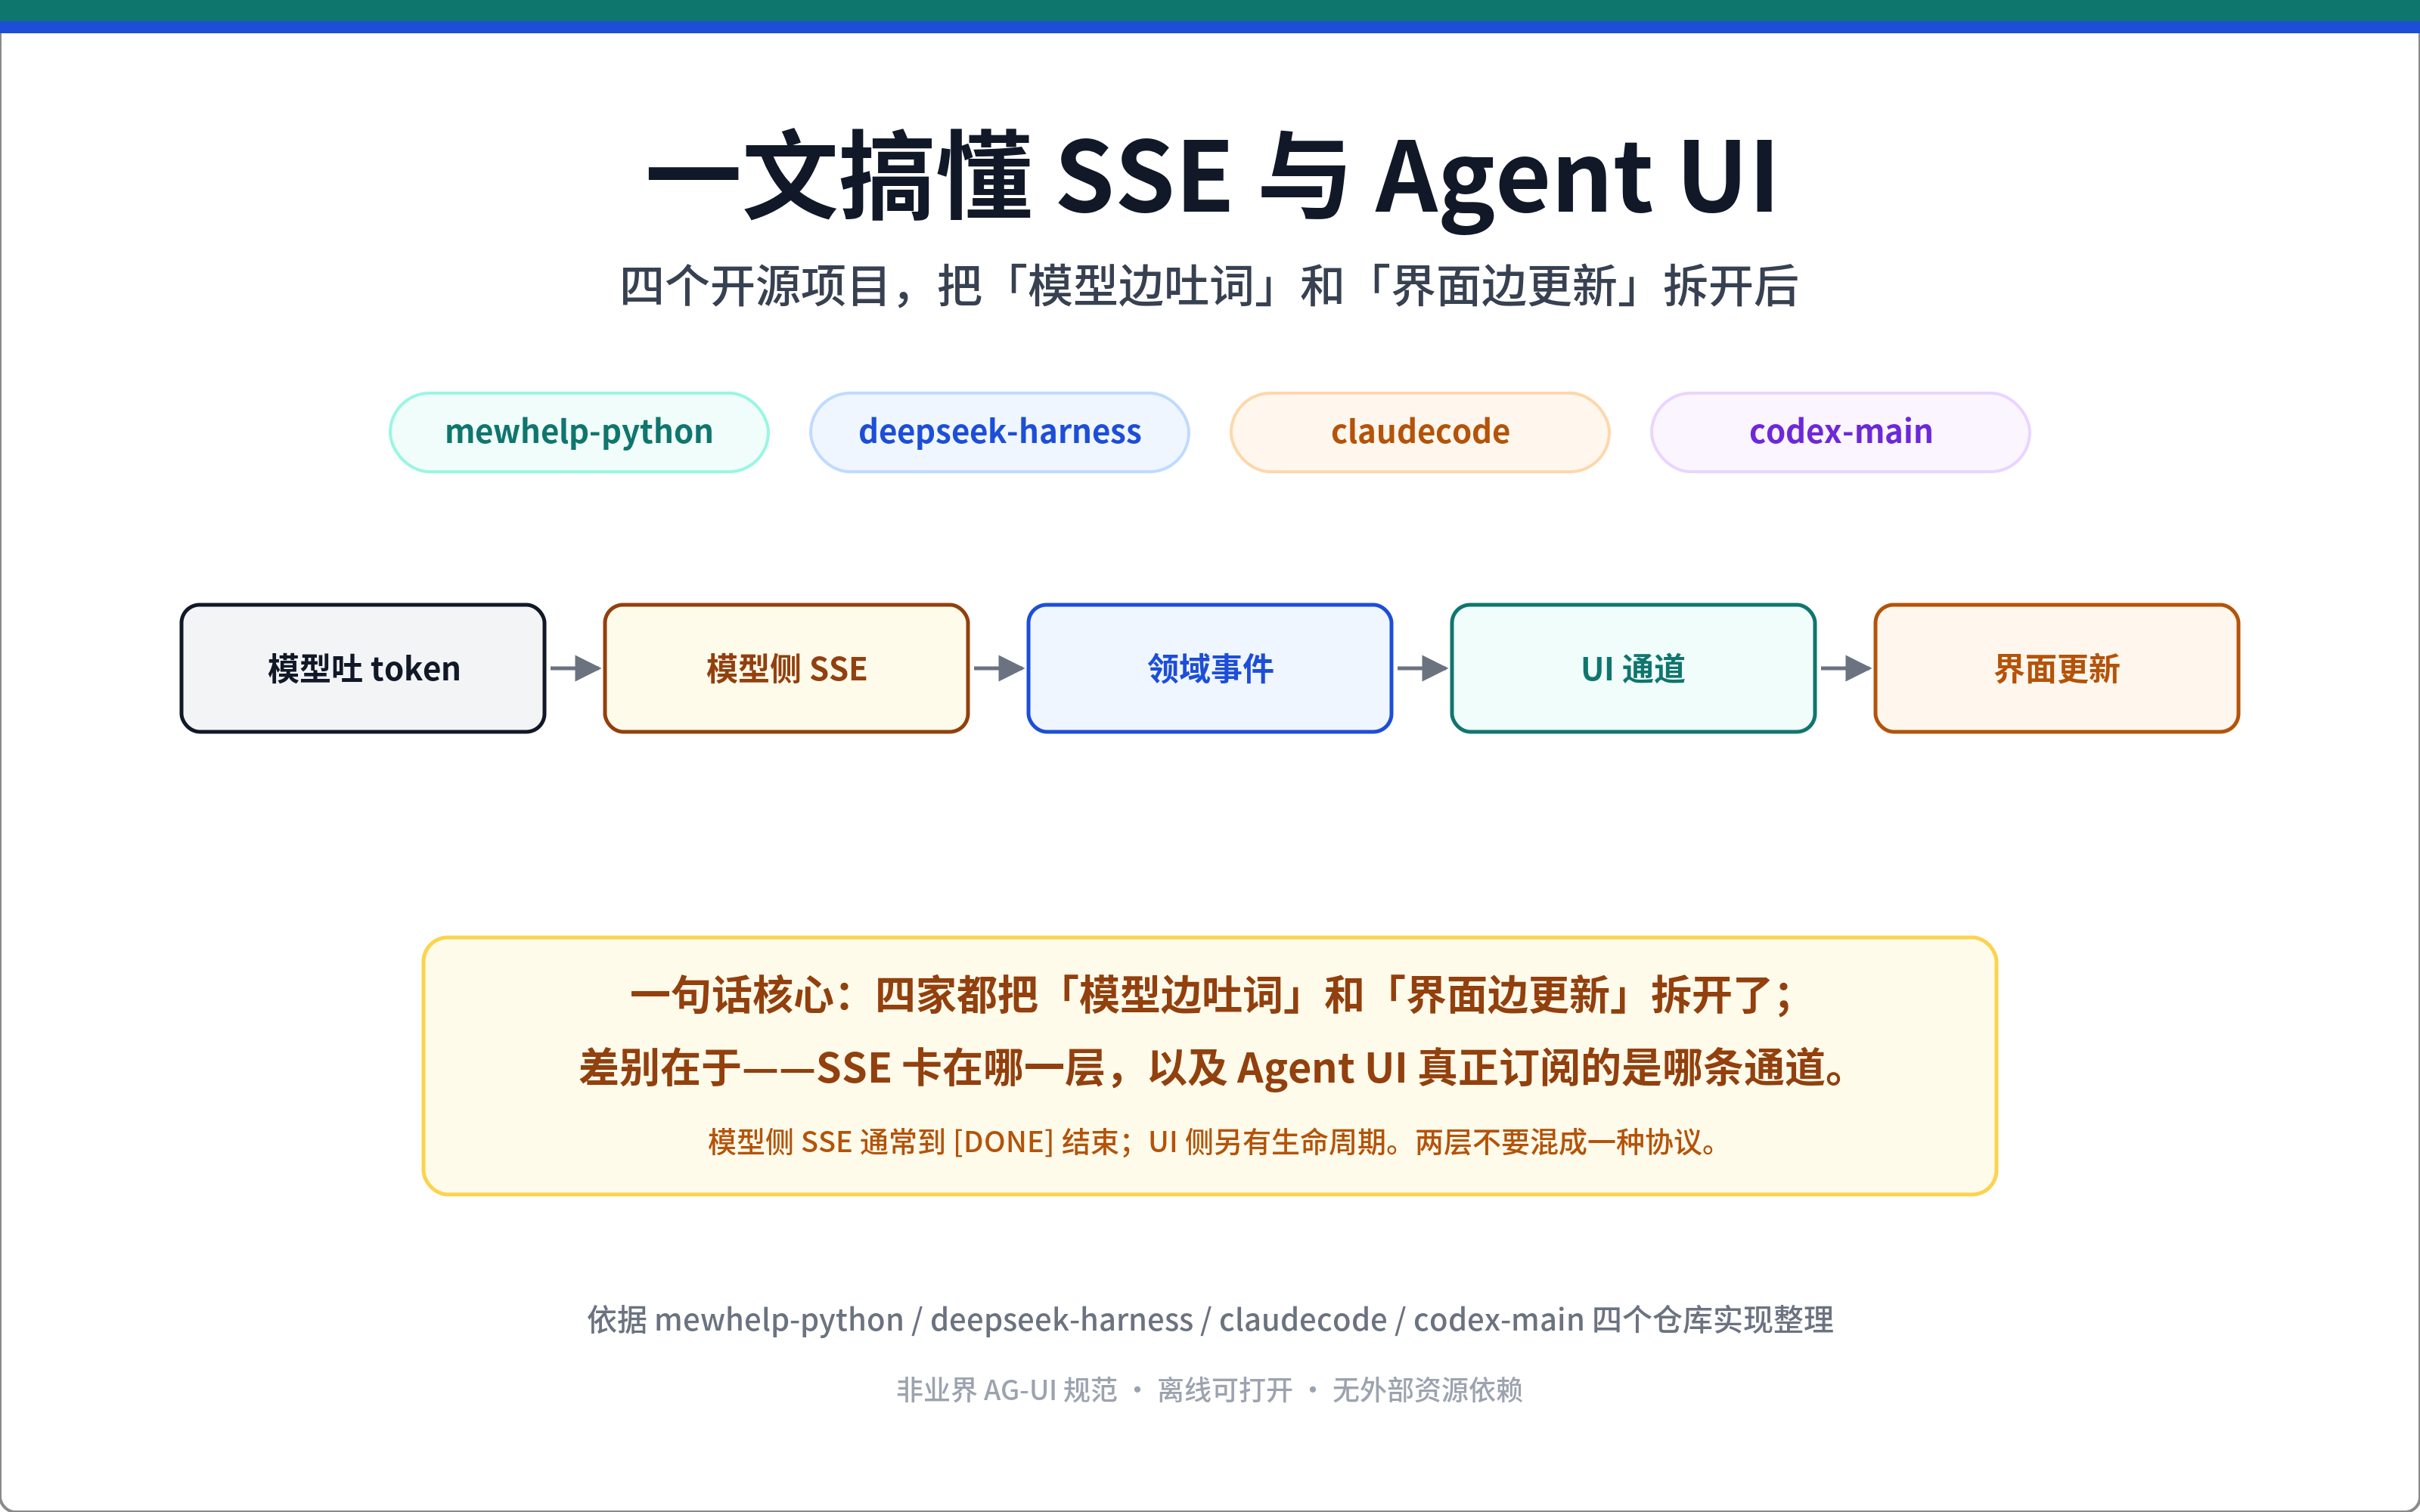
一句话先给结论:mewhelp、deepseek-harness、claudecode、codex-main 这四个开源项目,都把「模型边吐词」和「界面边更新」这两件事拆开了;真正的差别只在于两点------SSE 卡在哪一层 ,以及 Agent UI 真正订阅的是哪条通道。
如果你是一个正在给 Agent 应用写聊天界面的后端工程师,或者是一个正在纠结「要不要上 SSE、要不要对接 AG-UI 协议」的前端工程师,这篇文章值得你花十五分钟读完。我会从四个真实开源仓库的实现出发,把「模型流式输出」和「界面增量更新」这条链路一层一层拆开给你看。
引言:为什么我要盯着四个仓库的 SSE 看三天
先说背景。最近我在做智能核稿与文档审核相关的 Agent 产品,业务上需要把大模型的流式输出实时渲染到网页聊天界面里,同时还要支持「工具调用审批」「订单卡片预览」「人机打断续流」这类交互。刚开始我的方案很朴素:前端开一个 EventSource 连模型的流式接口,把 token 一帧一帧贴到气泡里,完事。
但做着做着问题就来了。
第一个问题是:模型接口的 SSE 流里,除了文本 token,还有工具调用参数、引用来源、思考过程、中断信号。这些事件如果原样透传给前端,前端得自己维护一套「解析模型协议」的逻辑,一旦换模型供应商,前端代码就要跟着改。
第二个问题是:人机协作。当 Agent 卡住需要用户确认订单信息时,模型流可能已经结束了,但业务状态还挂着。这时候前端该怎么知道「该弹出确认卡片了」?靠 SSE 里的一个自定义事件?那这个事件和模型协议的耦合度就太高了。
第三个问题是:多端复用。同一个 Agent 核心,今天要接网页聊天,明天要接 IDE 插件,后天要接 TUI 终端。如果界面层直接吃模型的 SSE,那每个端都要各自实现一遍协议适配,维护成本爆炸。
带着这三个问题,我去翻了四个开源仓库:mewhelp-python(电商客服 Web 聊天)、deepseek-harness(DeepSeek Agent 浏览器 GUI)、claudecode(终端 TUI)、codex-main(TUI / Desktop / SDK)。四个项目都号称「支持 SSE」,但把代码翻到底之后我发现,它们的 SSE 用法完全不是一回事。
这篇文章就是这三天翻仓库的完整笔记。我不讲 AG-UI 规范原文(那是另一套体系),我只讲这四个真实项目里,SSE 到底被用在了哪里、Agent UI 到底订阅了什么,以及你该抄谁。
文章目录
- [SSE 接口设计 vs Agent UI:四个开源项目,把「模型吐词」和「界面更新」拆开后,我看懂了差距](#SSE 接口设计 vs Agent UI:四个开源项目,把「模型吐词」和「界面更新」拆开后,我看懂了差距)
-
- [引言:为什么我要盯着四个仓库的 SSE 看三天](#引言:为什么我要盯着四个仓库的 SSE 看三天)
- 一、痛点场景:四个仓库,同一个问题
- [二、先抓住大图:SSE 到底卡在哪一层](#二、先抓住大图:SSE 到底卡在哪一层)
-
- [2.1 mewhelp:浏览器直接吃 SSE](#2.1 mewhelp:浏览器直接吃 SSE)
- [2.2 DSH / Claude Code / Codex:UI 不直接吃模型 SSE](#2.2 DSH / Claude Code / Codex:UI 不直接吃模型 SSE)
- [2.3 一个类比帮你记住](#2.3 一个类比帮你记住)
- [2.4 为什么不能直接把模型的 SSE 透传给界面](#2.4 为什么不能直接把模型的 SSE 透传给界面)
- 三、同一轮回复,四条路上的「包」长什么样
-
- [3.1 mewhelp 的包流:SSE 直达浏览器](#3.1 mewhelp 的包流:SSE 直达浏览器)
- [3.2 deepseek-harness 的包流:SSE 止步于 Host 边界](#3.2 deepseek-harness 的包流:SSE 止步于 Host 边界)
- [3.3 claudecode 的包流:同一套契约,多种传输](#3.3 claudecode 的包流:同一套契约,多种传输)
- [3.4 codex-main 的包流:双层投影](#3.4 codex-main 的包流:双层投影)
- [3.5 从包流里读出的第一层结论](#3.5 从包流里读出的第一层结论)
- [3.6 两个容易被忽略的细节](#3.6 两个容易被忽略的细节)
- [四、四维对照表:UI 真正订阅的是什么](#四、四维对照表:UI 真正订阅的是什么)
-
- [4.1 产品形态](#4.1 产品形态)
- [4.2 模型侧流](#4.2 模型侧流)
- [4.3 Agent UI 通道(最关键的差异)](#4.3 Agent UI 通道(最关键的差异))
- [4.4 UI 事件粒度](#4.4 UI 事件粒度)
- [4.5 真相来源](#4.5 真相来源)
- [4.6 人机协作与 AG-UI](#4.6 人机协作与 AG-UI)
- [4.7 从对照表读出的两条主线](#4.7 从对照表读出的两条主线)
- 五、人机打断:同一需求,四种握手
-
- [5.1 mewhelp:图暂停 + 同构续流](#5.1 mewhelp:图暂停 + 同构续流)
- [5.2 DSH:Waterfall 问答](#5.2 DSH:Waterfall 问答)
- [5.3 Claude Code:控制面往返](#5.3 Claude Code:控制面往返)
- [5.4 Codex:RPC 审批请求](#5.4 Codex:RPC 审批请求)
- [5.5 这节的结论](#5.5 这节的结论)
- [5.6 四个容易被忽视的 HITL 工程细节](#5.6 四个容易被忽视的 HITL 工程细节)
- [六、「AG UI」到底在说什么:先消歧义](#六、「AG UI」到底在说什么:先消歧义)
-
- [6.1 那 CopilotKit 的 AG-UI 协议又是什么](#6.1 那 CopilotKit 的 AG-UI 协议又是什么)
- [6.2 AG UI 层的通用设计清单](#6.2 AG UI 层的通用设计清单)
- 七、什么时候有用:抄谁的形状
-
- [7.1 学 mewhelp:SSE 直达](#7.1 学 mewhelp:SSE 直达)
- [7.2 学 DSH:日志 + WS](#7.2 学 DSH:日志 + WS)
- [7.3 学 Claude Code:SDK 契约](#7.3 学 Claude Code:SDK 契约)
- [7.4 学 Codex:双层投影](#7.4 学 Codex:双层投影)
- [7.5 共同限制:SSE 的单向性](#7.5 共同限制:SSE 的单向性)
- 八、收束:一条因果链
- 九、总结:给你四个可落地的动作
- 参考仓库与实现文件
- 写在最后
一、痛点场景:四个仓库,同一个问题
先描述一个几乎每个 Agent 应用都会遇到的真实场景,后面所有讨论都围绕它展开。
假设你正在做一个电商客服机器人。用户在聊天框里输入:「我要退掉昨天买的那个蓝牙耳机,帮我看看订单」。你的 Agent 核心会这样工作:
- 模型开始生成回复,一个词一个词地往外吐:「好的,我帮您查询订单......」;
- 中途模型决定调用一个工具:查询用户订单列表;
- 工具返回结果后,模型发现订单里有多笔交易,需要用户确认「您要退的是哪一笔」;
- 用户在界面里点击了某个订单卡片;
- Agent 继续生成回复,最终输出一段完整的退款指引,并附带引用来源。
注意,这短短五步里,界面需要呈现的东西至少包括:流式文本、工具调用状态(「正在查询订单...」)、订单卡片(可点击)、确认交互(点击后恢复生成)、最终结果与引用。而这一整套交互,在四个项目里分别走了四条完全不同的技术路径。
我把这个场景再拆细一点,你会发现它背后其实是三个独立的问题在打架:
第一个问题,是粒度的错配。 模型输出的最小单位是 token,一次增量可能只是半个词;而界面需要的最小单位是「事件」,一个事件可能对应一整张订单卡片、一次工具调用、或者一段引用。把 token 级的流直接喂给界面,界面就得自己判断「这一帧是文本、还是工具参数、还是状态变更」------这种判断做一两次没问题,做成通用逻辑就是灾难。
第二个问题,是生命周期的错配。 模型流以 [DONE] 结束,但业务对话没有结束。用户确认订单之后,Agent 还要继续干活、继续吐词。如果界面的状态机是跟着模型流走的,那「中断-确认-续流」这个循环会让状态机瞬间爆炸。
第三个问题,是消费者的多样性。 同一个 Agent 核心,今天接网页,明天接 IDE,后天接 TUI。每个消费者的渲染能力不同、交互能力不同、甚至网络环境都不同。让所有消费者都去解析同一个模型的 SSE 协议,等于把模型供应商的协议变更风险,复制粘贴到了每一个端上。
这三个问题,就是「模型边吐词」和「界面边更新」必须被拆开的根本原因:模型输出的是一串 token 流,而界面需要的是一个结构化的事件序列------文本增量、工具事件、审批请求、完成信号。两者的粒度不同、生命周期不同、消费者不同,硬把模型流当界面协议用,短期能跑,长期必崩。
带着这个场景,我们开始拆第一层:SSE 到底卡在哪一层。
二、先抓住大图:SSE 到底卡在哪一层
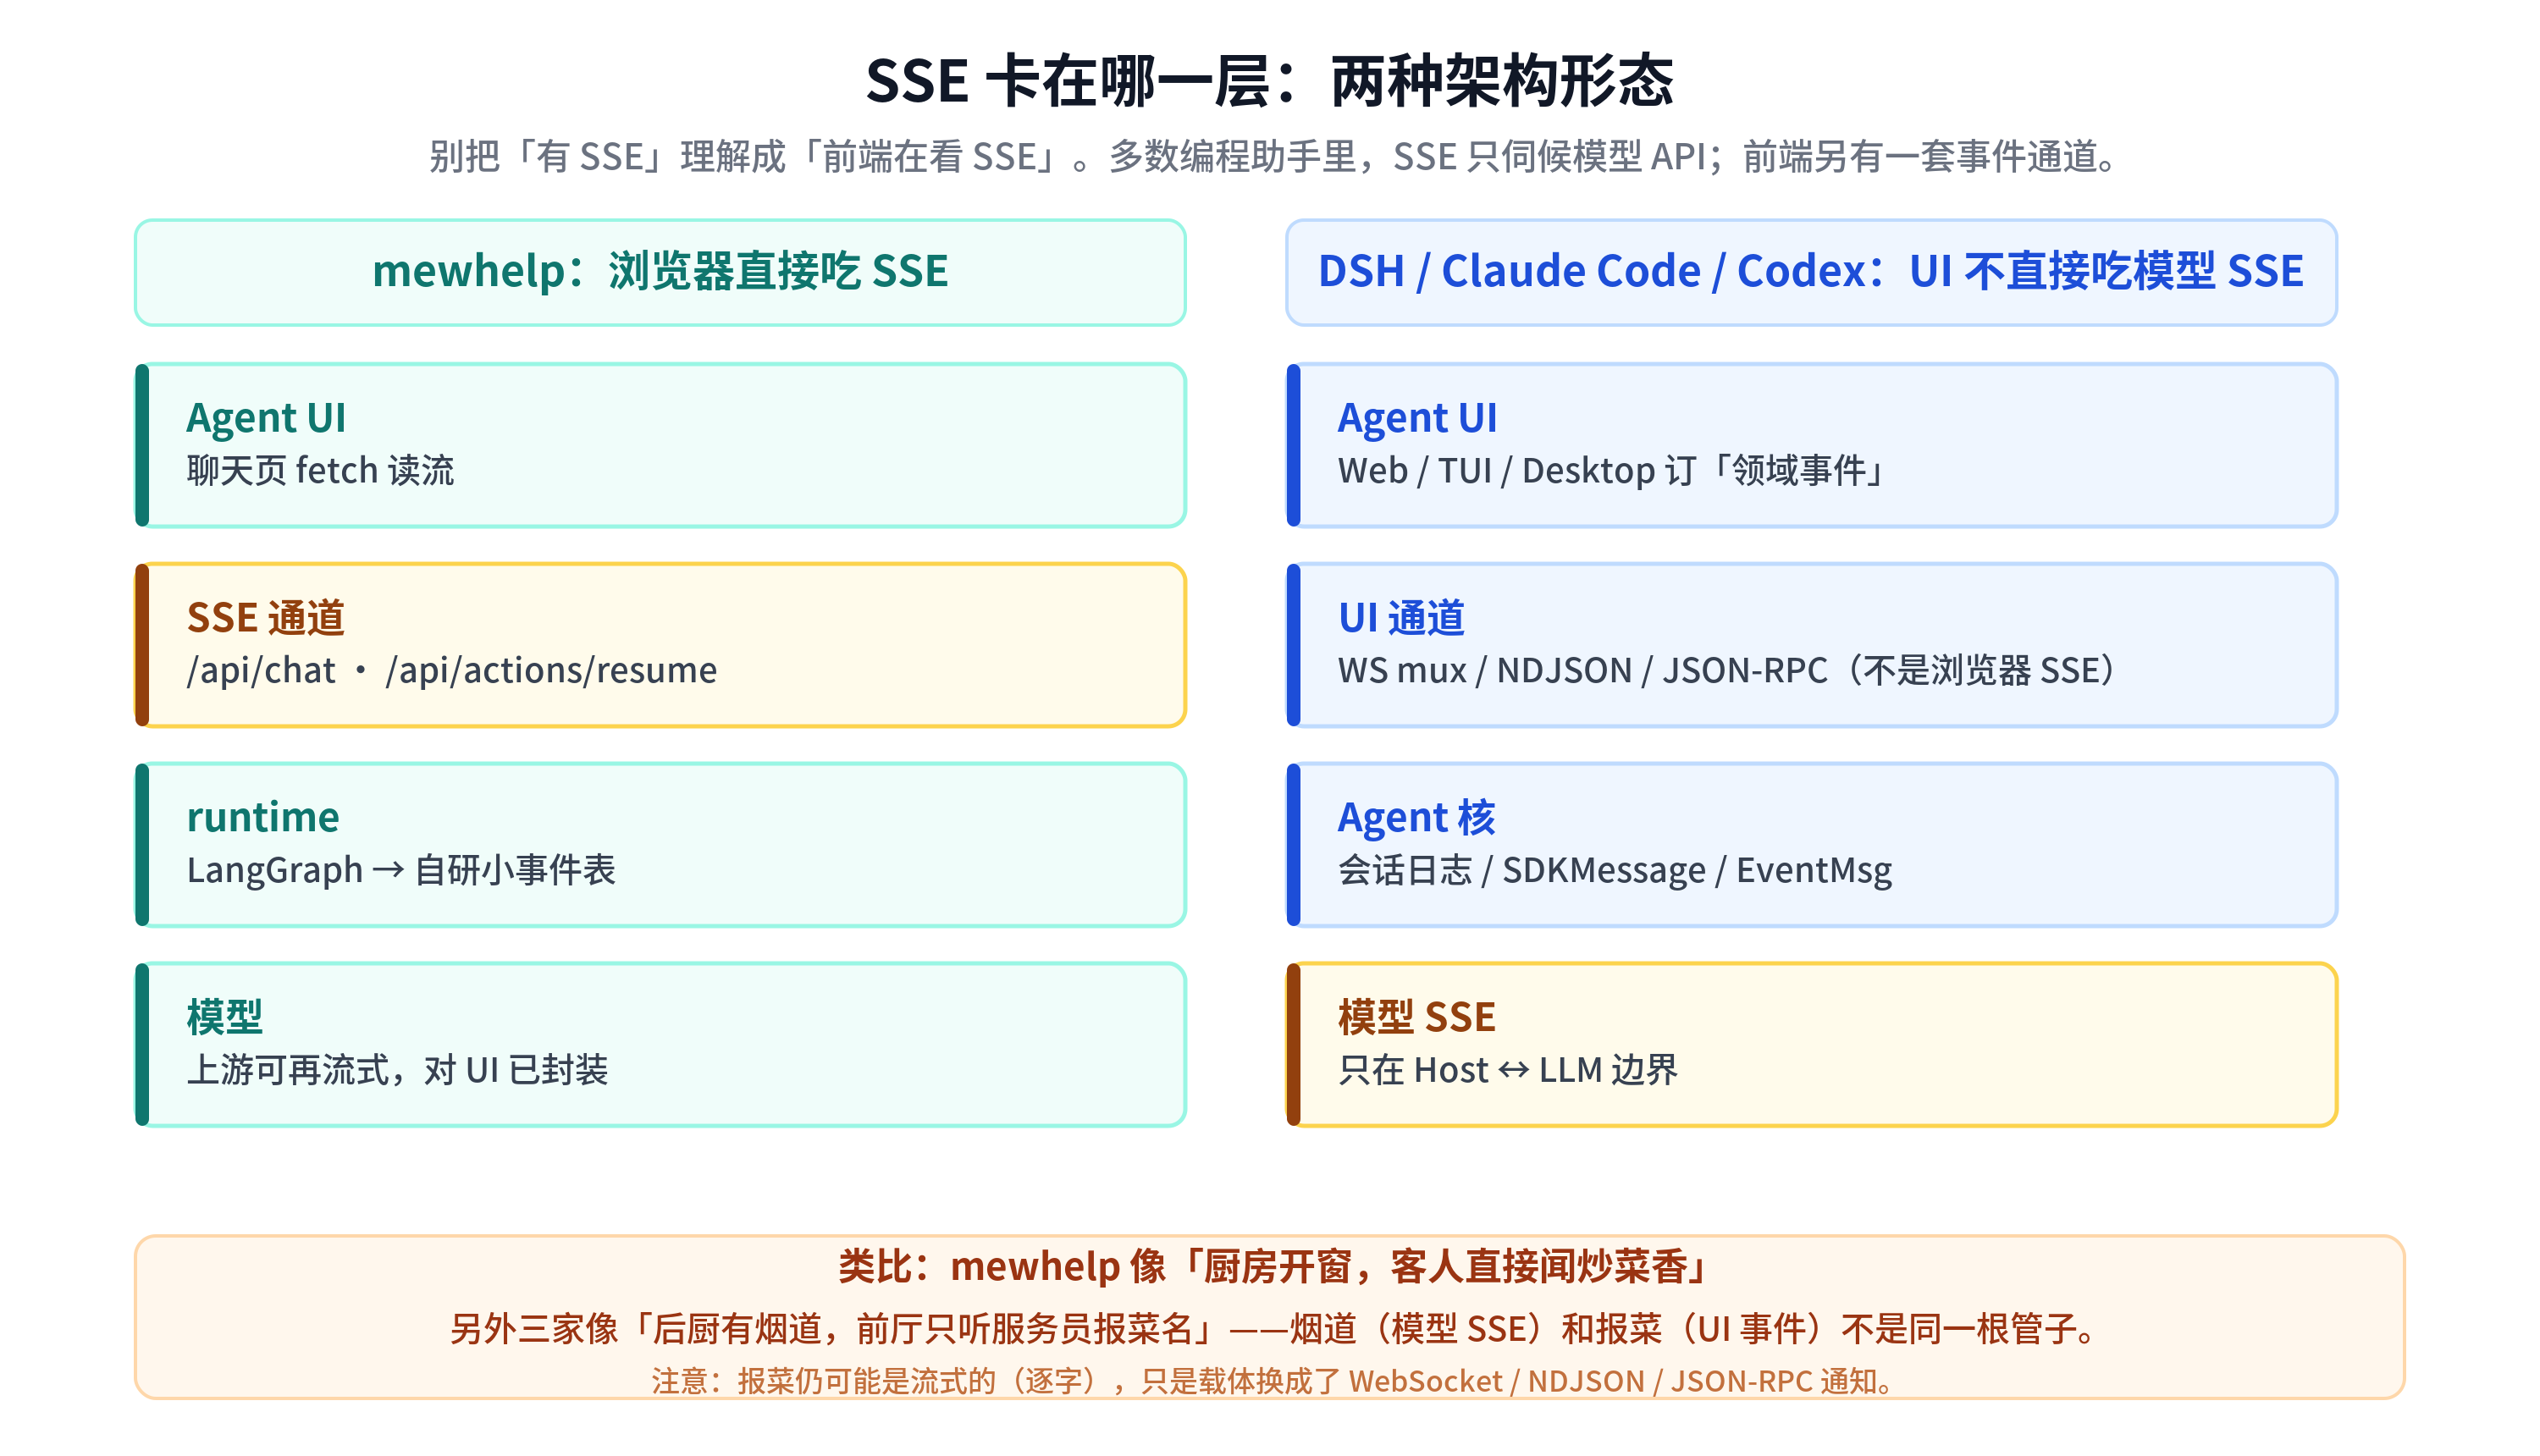
打开四个仓库的第一件事,是搞清楚 SSE 出现在哪一层。这是最容易产生误解的地方:别把「有 SSE」理解成「前端在看 SSE」。在多数编程助手里,SSE 只伺候模型 API;前端另有自己的一套事件通道。
我画了一张架构对比图,左边是 mewhelp,右边是另外三家的共性结构:
2.1 mewhelp:浏览器直接吃 SSE
mewhelp 的链路非常直接。它的 Agent UI 层就是一个网页聊天页,前端用 fetch 直接读取 /api/chat 的流式响应;SSE 通道贯穿始终------/api/chat 负责主对话流,/api/actions/resume 负责中断后的续流。runtime 层基于 LangGraph,模型上游的输出会被翻译成一张自研的小事件表,然后以 SSE 帧的形式推给浏览器。
这条链路的特点是:SSE 是浏览器和 Agent 核心之间的唯一协议。模型能不能再流式输出,对 UI 来说不重要,因为 runtime 已经把模型输出封装成了统一的事件格式。换句话说,mewhelp 把「模型协议」和「界面协议」合并成了同一条 SSE 通道,只是中间加了一层事件翻译。
2.2 DSH / Claude Code / Codex:UI 不直接吃模型 SSE
另外三家是另一种形态。它们的 Agent UI 层(Web / TUI / Desktop)订阅的是「领域事件」,而不是模型的 SSE 流。中间的通道各不相同:DSH 走 HTTP RPC 加 WebSocket mux(/api/remote.mux),Claude Code 本地用进程内生成器、远程走 WebSocket / NDJSON / SSE+POST,Codex 走 JSON-RPC(stdio / unix socket / WebSocket)。
而模型的 SSE 流,在三家架构里都严格止步于 Host 和 LLM 之间的边界 :DSH 的 llm-deepseek/sse.ts 把 DeepSeek 的 SSE 流翻译成 StreamChunk 后进入会话日志;Codex 的 codex-api/sse/responses.rs 把 Responses API 的流翻译成 ResponseEvent 后再进 core;Claude Code 的 Anthropic 流被翻译成内部 Message 后走 SDK 消息契约。浏览器、TUI、桌面端,全都看不到模型的原生 SSE。
2.3 一个类比帮你记住
mewhelp 像「厨房开窗,客人直接闻炒菜香」------模型一吐词,浏览器立刻能感知。另外三家像「后厨有烟道,前厅只听服务员报菜名」------后厨(模型)炒菜的火候走烟道排走,前厅(UI)只通过服务员(Agent 核)得知「这桌上了什么菜」。
烟道(模型 SSE)和报菜(UI 事件)不是同一根管子。 这里有一个需要特别强调的边界:报菜仍然是流式的,可以逐字上,只是载体换成了 WebSocket / NDJSON / JSON-RPC 通知,而不是浏览器去连模型的 text/event-stream。
记住这张图,后面所有的细节都只是这两条架构路径的具体展开。
2.4 为什么不能直接把模型的 SSE 透传给界面
讲到这里,值得把「为什么四家都不透传」这件事展开说透,因为它背后是三个实打实的技术理由:
理由一:模型协议不承诺稳定。 各家模型的流式协议都在快速演进:有的在流里加 reasoning 字段,有的把工具调用改成流式参数,有的新增了思考令牌(thinking token)。如果你的界面直接解析模型协议,每次供应商升级协议,你都要发版。而 Agent 核翻译一层之后,协议变更被吸收在核内,UI 契约纹丝不动。
理由二:模型事件语义太粗。 模型的 SSE 流里只有「生成了什么」,没有「业务上发生了什么」。订单卡片的展示、审批请求的弹出、任务完成的通知,这些业务语义模型根本不知道,是 Agent 核根据工具执行结果和状态机推导出来的。这些领域事件必须由核来产生,UI 才能拿到有意义的信号。
理由三:连接形态不匹配。 模型的 SSE 是服务端到 Agent 宿主的长连接,它假设链路是可信的、独占的。而 UI 的场景千奇百怪:网页可能断线重连、IDE 插件可能跨进程、桌面端可能离线工作。把模型连接的生命周期暴露给 UI,等于让最不稳定的一环决定整个系统的稳定性。
这三点,就是「Agent 核译成领域事件」这个动作存在的全部理由。它不是设计洁癖,而是工程必然。
三、同一轮回复,四条路上的「包」长什么样
架构形态看完了,接下来看最直观的东西:同一轮回复里,四个项目的「包」分别长什么样。我按事件在链路中流动的顺序,把四个项目各拉了一条五段的包流:
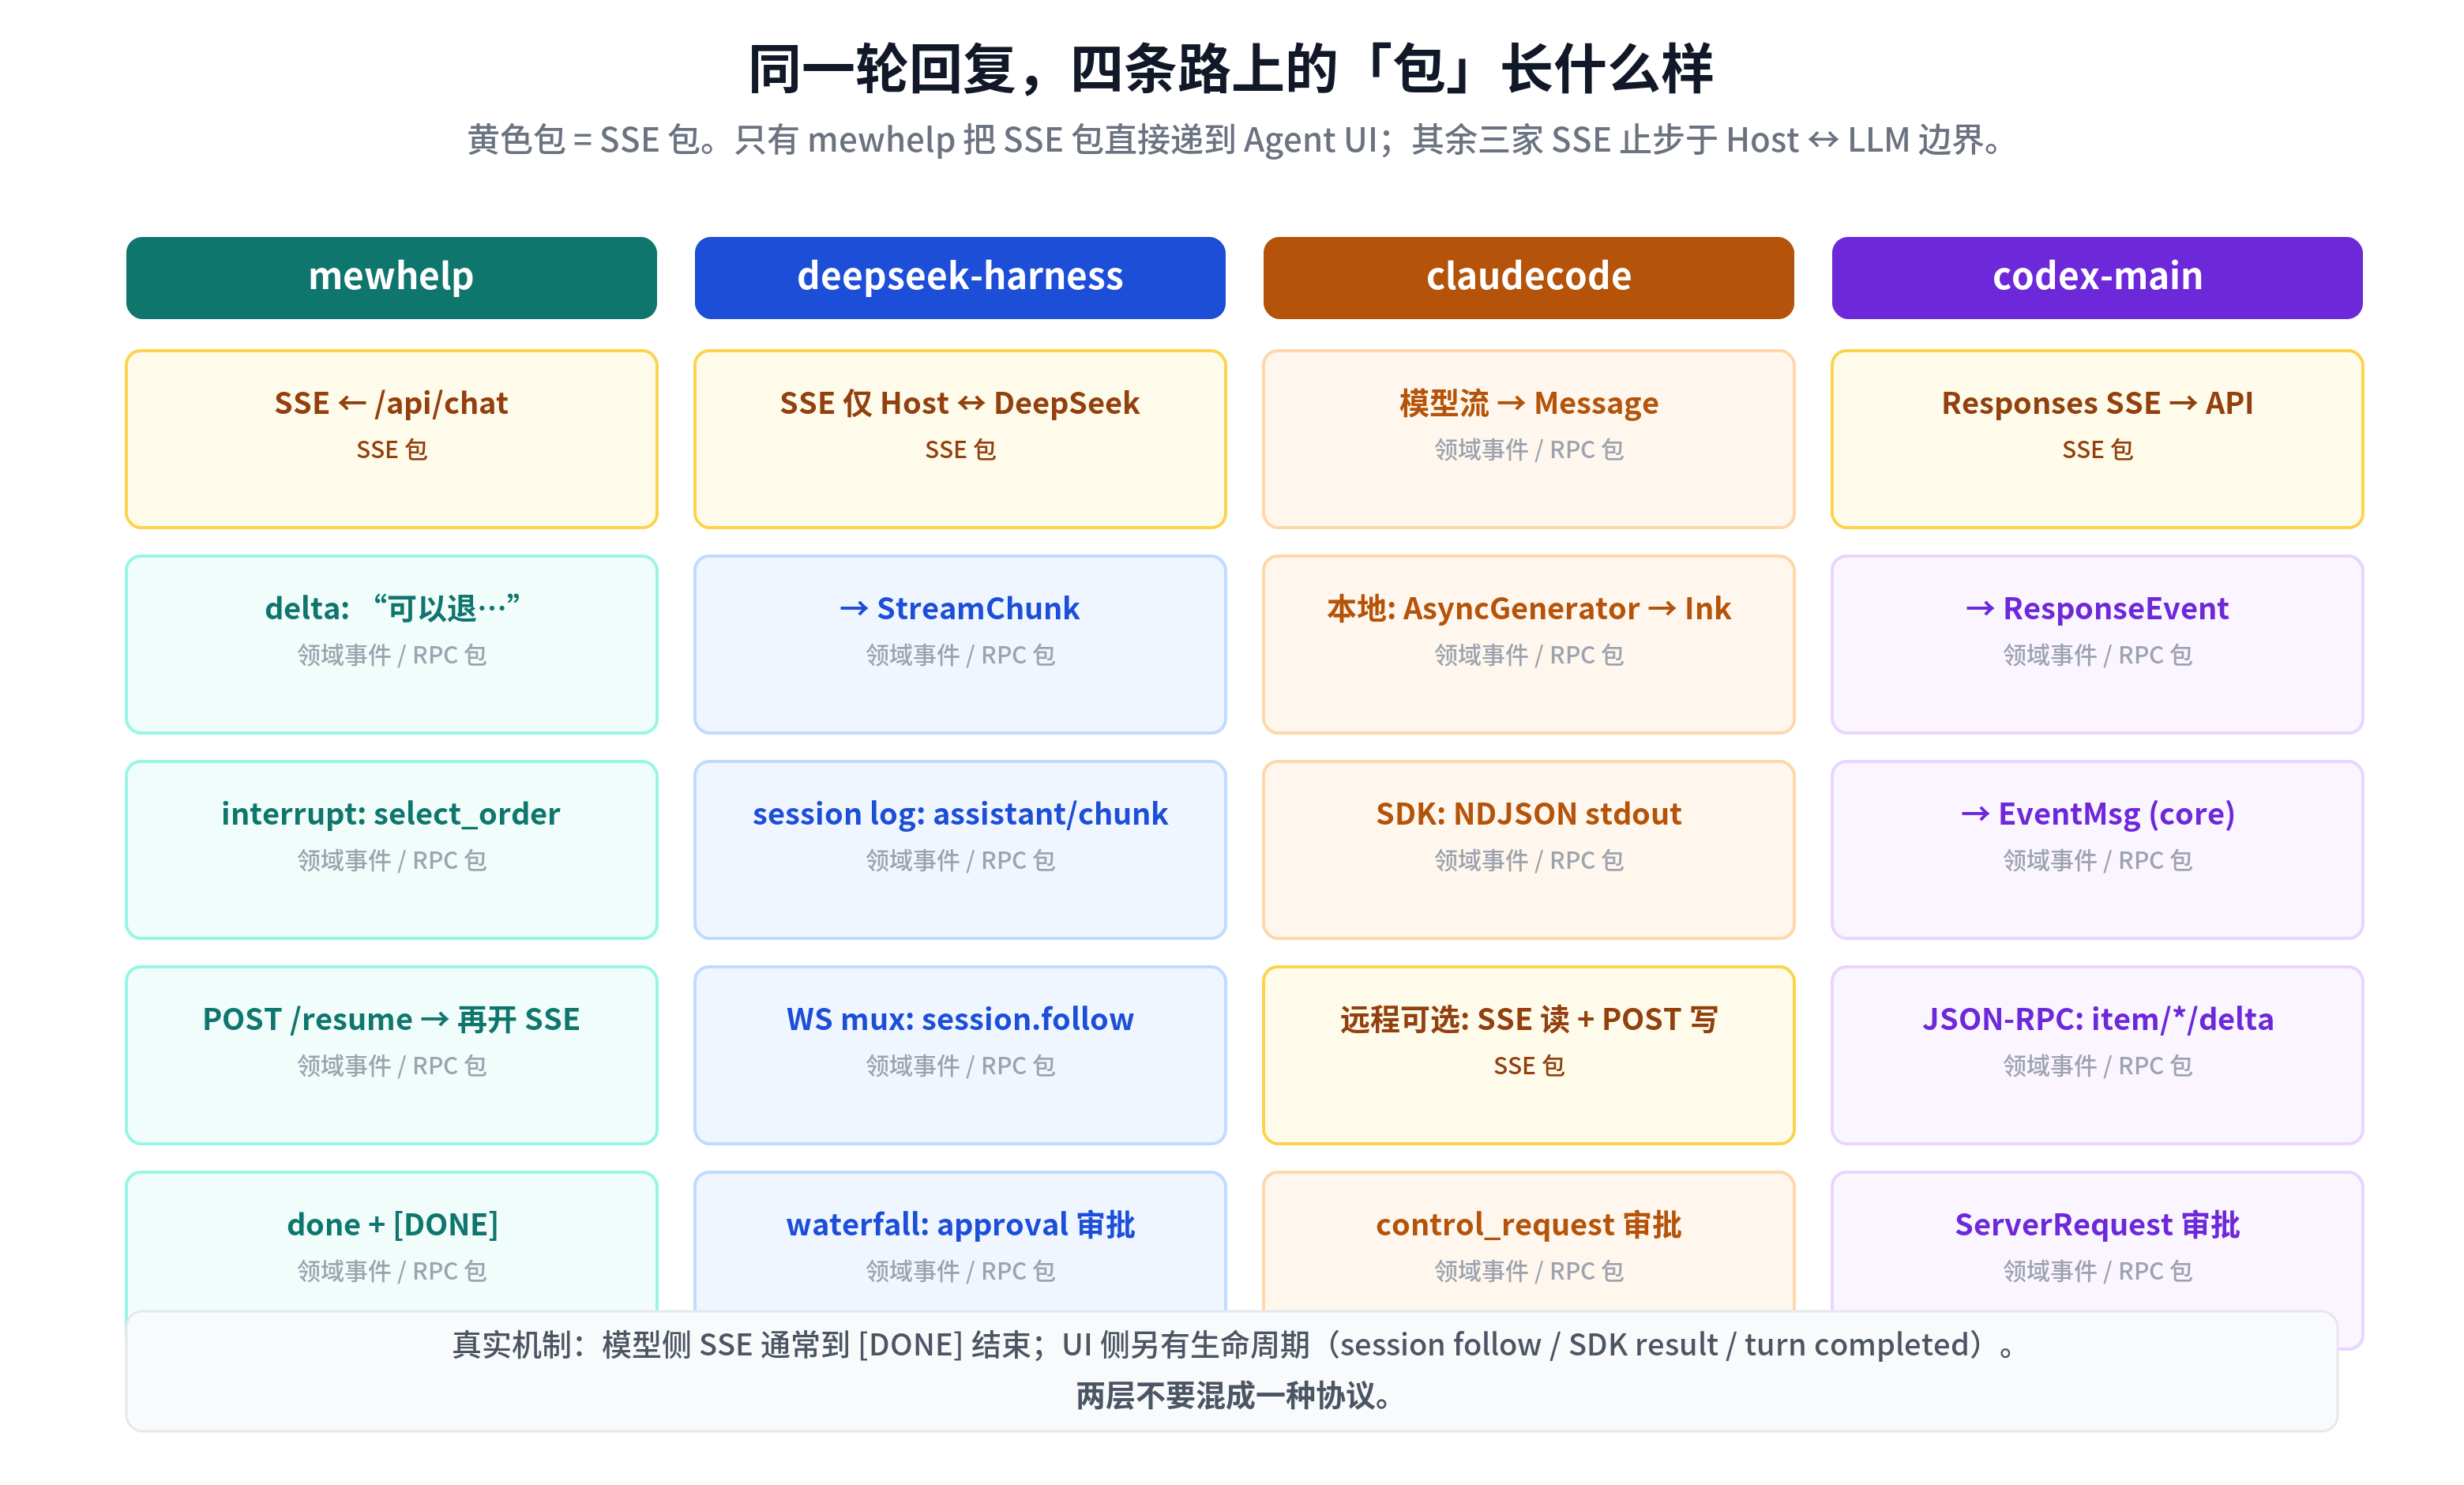
黄色的是 SSE 包。注意看它们出现在哪一列、哪一层。
3.1 mewhelp 的包流:SSE 直达浏览器
mewhelp 的链路是:SSE ← /api/chat 建立流 → 模型增量以 delta 帧推送(例如「可以退...」)→ 需要用户确认时推送 interrupt 事件(select_order,注意此时没有 done)→ 用户操作后前端 POST /resume,服务端再开一条同构的 SSE 流 → 最后以 done + [DONE] 收尾。
这条链路里,SSE 既是下行推送,也是上行续流的载体(resume 后重开流)。所有事件------文本、工具、中断、完成------都在同一条通道上按序流动,事件顺序即业务顺序。
3.2 deepseek-harness 的包流:SSE 止步于 Host 边界
DSH 的链路是:SSE 仅存在于 Host 和 DeepSeek 之间 → llm-deepseek/sse.ts 把流翻译成 StreamChunk → 写入会话日志(assistant/chunk)→ UI 通过 WS mux 订阅 session.follow 流 → 审批类交互走 waterfall(approval)。
注意,黄色 SSE 包只出现在第一段。UI 看到的全部是会话日志投影出来的领域事件,载体是 WebSocket。
3.3 claudecode 的包流:同一套契约,多种传输
Claude Code 的链路是:模型流被翻译成内部 Message → 本地通过 AsyncGenerator 直接喂给 Ink 渲染 → SDK 模式下走 NDJSON stdout → 远程模式可选「SSE 读 + POST 写」→ 审批交互走 control_request。
它最特别的地方在于:同一套 SDK 消息契约,传输层是可插拔的。本地进程内用生成器,跨进程用 NDJSON,远程用 WebSocket 或 SSE。黄色 SSE 包只在远程传输段出现,且永远是「读」方向。
3.4 codex-main 的包流:双层投影
Codex 的链路是:Responses API 的 SSE 流在 codex-api 客户端内被翻译成 ResponseEvent → core 层统一成 EventMsg → app-server 再投影成 JSON-RPC 推给 UI(item//delta、turn/)→ 审批交互走 ServerRequest。
它是最典型的「模型 SSE 严守在 API 客户端、core 发领域事件、UI 层再投影」的三段式。黄色 SSE 包同样只出现在最左侧。
3.5 从包流里读出的第一层结论
把四条链路并排看,结论非常清晰:模型侧的 SSE 通常到 [DONE] 就结束了;UI 侧另有自己的生命周期------DSH 有 session follow、Claude Code 有 SDK result、Codex 有 turn completed。这两层有各自的起始、推进和终止语义,把它们混成一种协议,是 Agent 界面架构里最隐蔽也最昂贵的错误。
3.6 两个容易被忽略的细节
细节一:[DONE] 不是业务终点。 模型流发完 [DONE],只代表「这一轮模型生成完毕」,不代表「任务完成」。mewhelp 的 done 事件和 [DONE] 是两码事:前者是业务层的完成信号,后者是传输层的结束标记。如果前端拿 [DONE] 当业务完成来用,遇到 interrupt 续流(模型流被业务打断)就会误判。
细节二:同构续流依赖可恢复的执行上下文。 mewhelp 之所以能在 POST /resume 之后再开一条同构 SSE,是因为它的 runtime 基于 LangGraph,图的执行状态(哪个节点执行到哪、工具结果缓存)是可持久化、可恢复的。续流接口的本质是「把图状态恢复,然后继续推进」------没有这一层可恢复性,任何续流设计都是空中楼阁。
顺带说一句,很多团队在做 SSE 方案时只盯着「下行怎么推」,却忽略了「上行怎么续」。等到要做人机协作时才发现,模型流已经断了,业务状态也丢了,只能让用户重新问一遍。这种体验,用过一次就再也不想用第二次。
四、四维对照表:UI 真正订阅的是什么
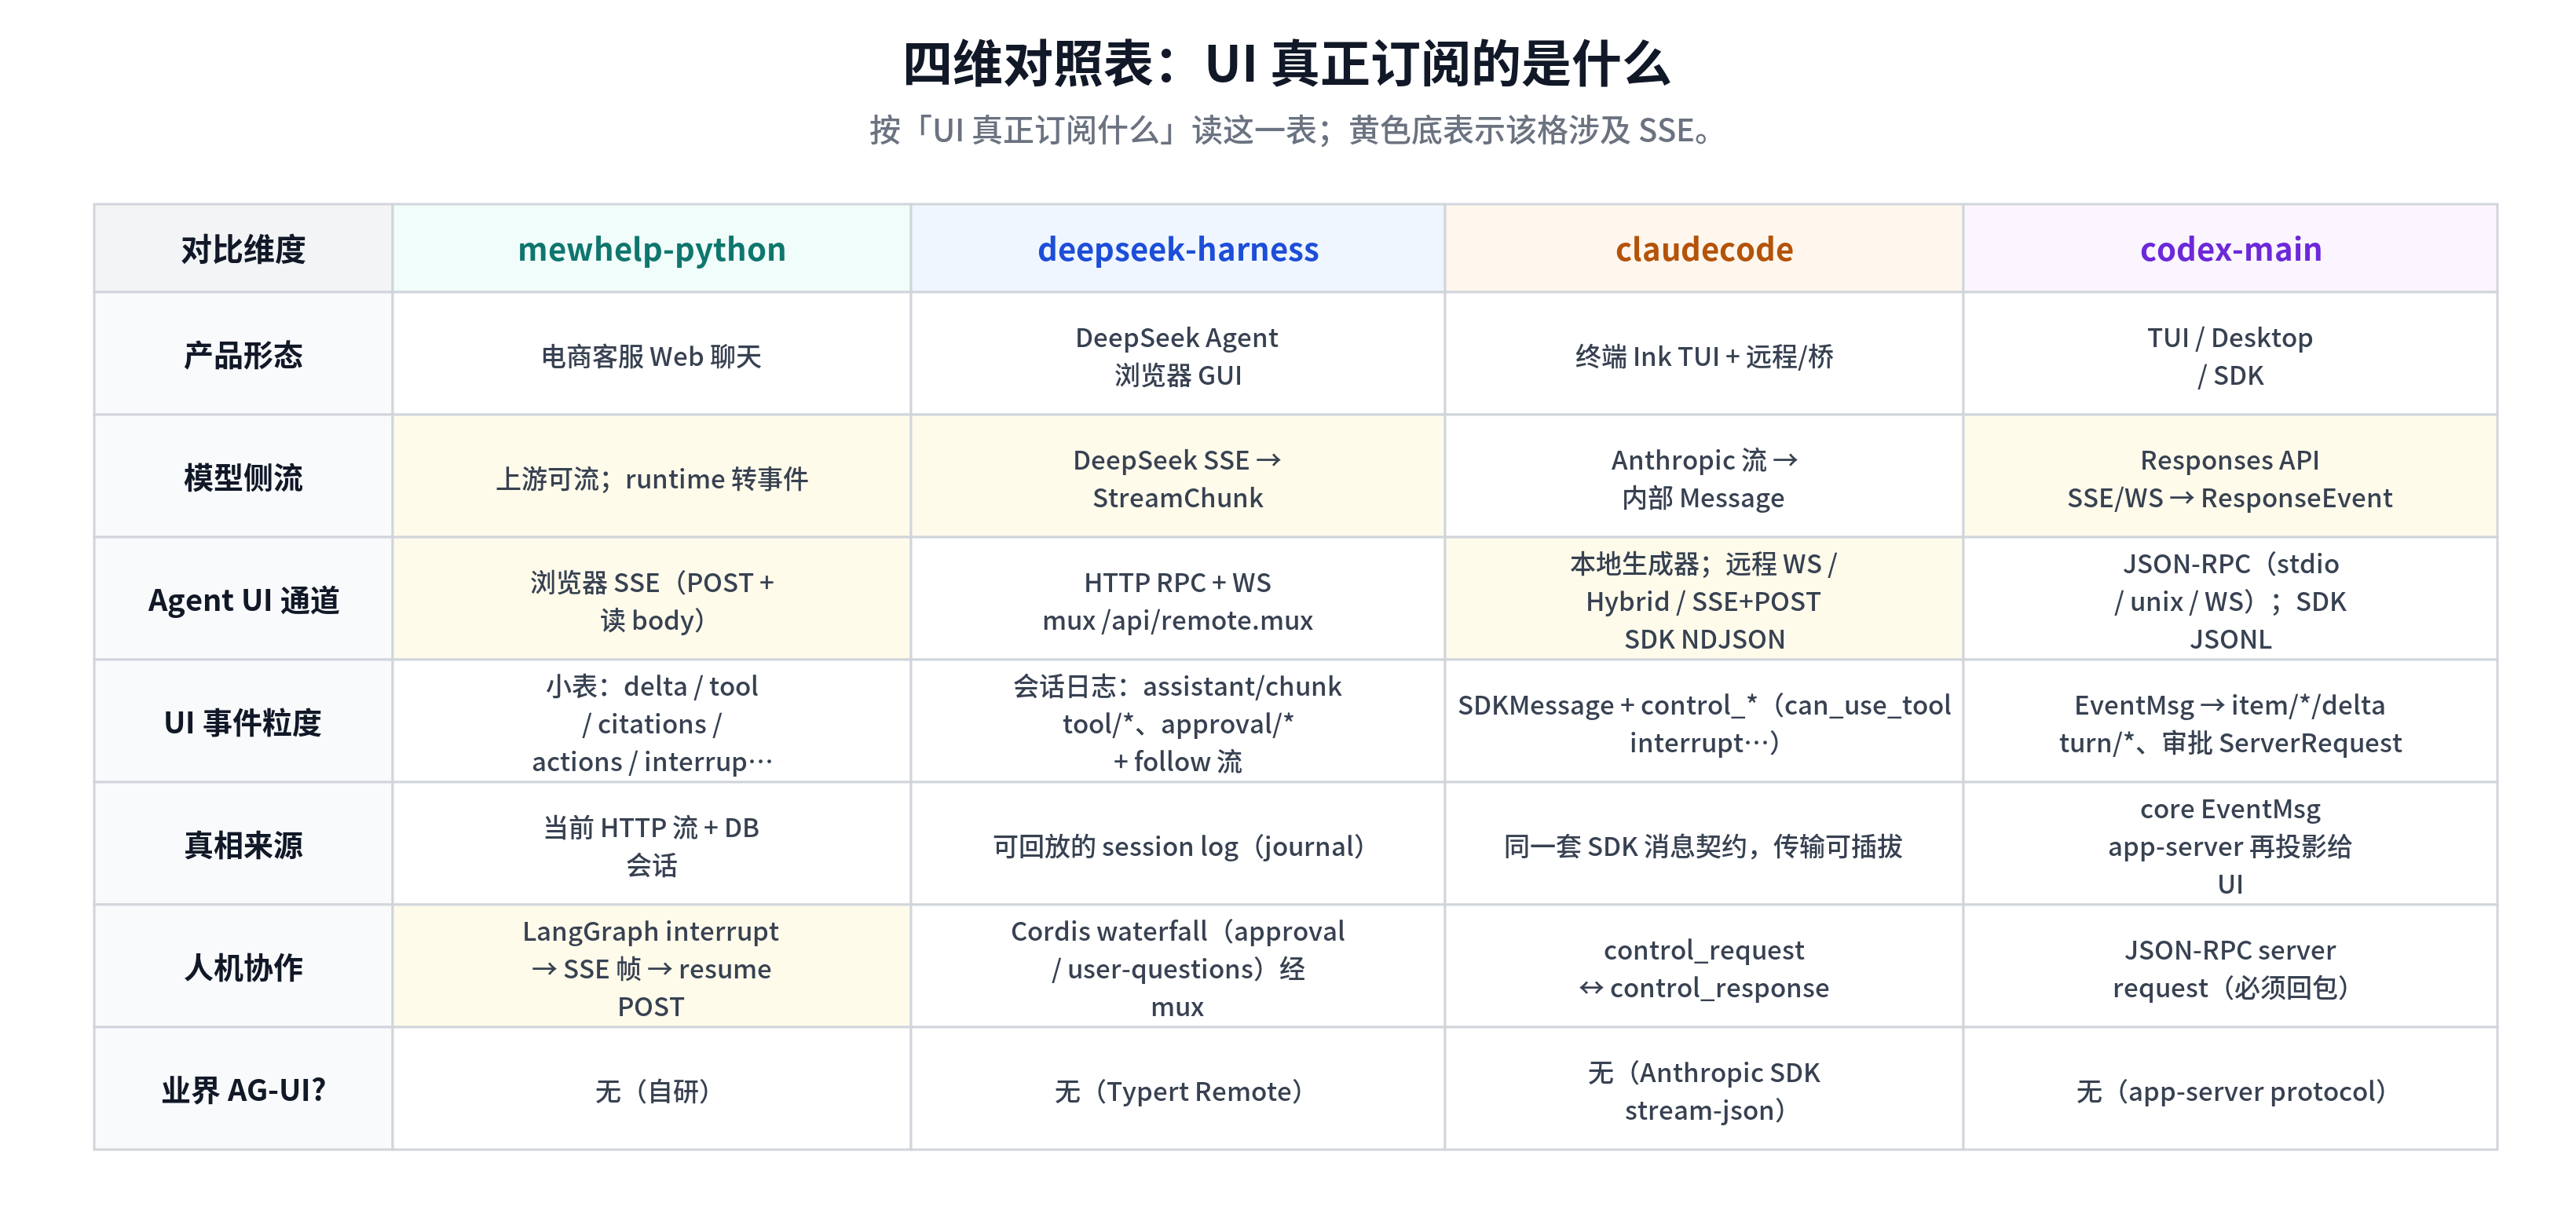
包流看完,我们用一张四维对照表把所有关键差异固化下来。这张表的读法只有一个:看 UI 真正订阅的是什么。表格里黄色底色的格子表示该格涉及 SSE:
4.1 产品形态
mewhelp 是电商客服 Web 聊天;DSH 是 DeepSeek Agent 的浏览器 GUI;Claude Code 是终端 Ink TUI 加远程/桥接模式;Codex 是 TUI / Desktop / SDK 三端并存。产品形态决定了它们对「界面通道」的需求强度:单页聊天的通道可以极简,三端共用的通道必须能承载多种宿主。
4.2 模型侧流
mewhelp 的上游模型可流式输出,但 runtime 会把它转成事件,UI 不感知;DSH 把 DeepSeek SSE 翻译成 StreamChunk;Claude Code 把 Anthropic 流翻译成内部 Message;Codex 把 Responses API 的 SSE/WS 翻译成 ResponseEvent。四家全部在模型边界做了翻译,没有一家把模型原始流直接扔给 UI。
4.3 Agent UI 通道(最关键的差异)
这是四家分道扬镳的地方:
- mewhelp:浏览器 SSE(POST 请求 + 读 body),这是四家里唯一把 SSE 直接接到 UI 的;
- DSH:HTTP RPC + WS mux(
/api/remote.mux),走 WebSocket 复用连接; - Claude Code:本地是进程内生成器,远程是 WS / Hybrid / SSE+POST,SDK 是 NDJSON;
- Codex:JSON-RPC(stdio / unix socket / WebSocket),SDK 是 JSONL。
4.4 UI 事件粒度
mewhelp 的事件粒度最小,是一张小表:delta / tool / citations / actions / interrupt / done;DSH 是会话日志流:assistant/chunk、tool/、approval/ 加 follow 流;Claude Code 是 SDKMessage 加 control_(can_use_tool、interrupt);Codex 是 EventMsg 投影出的 item//delta、turn/* 和审批 ServerRequest。
事件粒度直接决定前端逻辑的复杂度。mewhelp 的小表事件前端要自己拼状态;Codex 的 item/turn 两级事件则把「生成项」和「回合」的边界在协议层就定义好了。
4.5 真相来源
mewhelp 的真相来源是「当前 HTTP 流 + DB 会话」,断流重连后状态需要前端自己恢复;DSH 是可回放的 session log(journal),任何时刻都能从日志重建 UI 状态;Claude Code 是同一套 SDK 消息契约,传输可插拔但契约唯一;Codex 是 core 的 EventMsg,app-server 再投影给 UI。
「真相来源」这一行值得单独划重点:DSH 的可回放日志和 Codex 的单一 EventMsg 源,都是把「真相」和「传输」解耦的典型做法。一旦 UI 出问题要排查,你不需要重放模型流,只需要重放事件日志。
4.6 人机协作与 AG-UI
人机协作这一行放到下一节专门讲。这里先剧透一个结论:四家都没有采用业界 AG-UI 协议------mewhelp 是自研,DSH 是 Typert Remote,Claude Code 是 Anthropic SDK stream-json,Codex 是 app-server protocol。
4.7 从对照表读出的两条主线
整张表看完,其实就两条主线贯穿始终:
主线一:谁离模型更近,谁的事件就越原始。 mewhelp 的事件表最小也最贴近模型输出(delta 直接对应 token),因为它的界面离模型只隔了一层翻译;Codex 的 item/turn 两级事件离模型最远,因为中间还隔了 ResponseEvent 和 EventMsg 两层投影。事件粒度不是越高越好,而是要和你的界面复杂度匹配:界面交互越丰富,越需要语义完整、粒度合适的领域事件。
主线二:真相来源决定了系统的可调试性。 mewhelp 靠「当前流 + DB 会话」兜底,出问题只能看数据库;DSH 的 session log 和 Codex 的 EventMsg 都是单一事件源,出问题可以精确重放「这个用户、这个会话、第几步发生了什么」。如果你的 Agent 产品要支持问题排查、A/B 实验、行为回放,请直接采用「可回放事件日志」作为真相来源,不要事后补课。
这两条主线,一个是向外(UI 看到的粒度),一个是向内(系统怎么被审计),把表里七个维度串成了一个整体。
五、人机打断:同一需求,四种握手
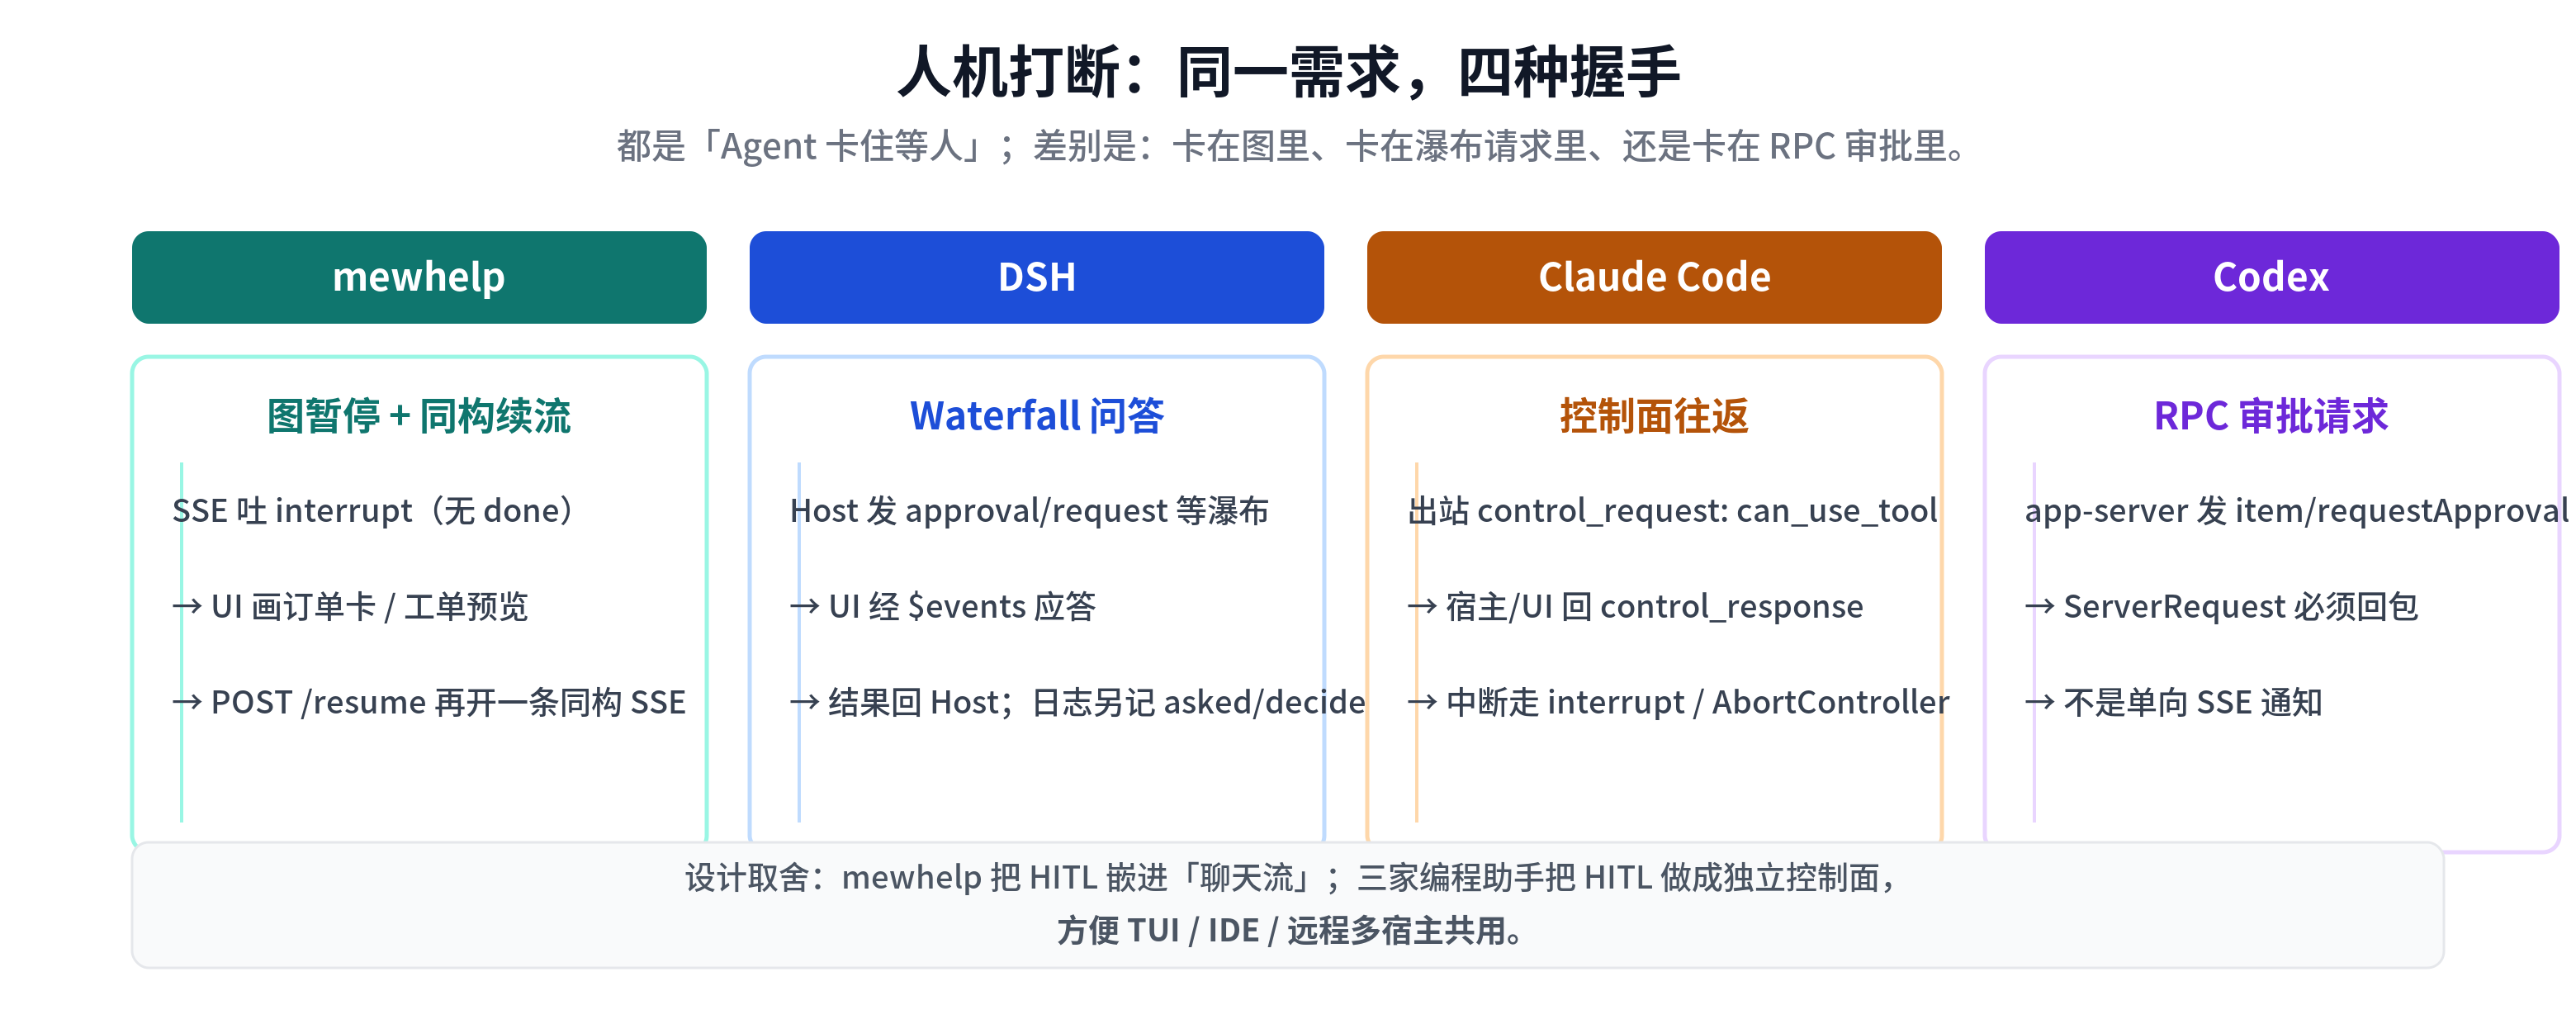
「人机打断」(HITL, Human-in-the-Loop)是我认为这篇文章最值得细看的部分,因为它最能暴露架构设计的分歧。四个项目都要实现「Agent 卡住等人确认」这件事,但四种握手的形态完全不同:
5.1 mewhelp:图暂停 + 同构续流
mewhelp 的做法是把 HITL 嵌进聊天流。SSE 流里吐出一个 interrupt 事件(不带 done),前端据此渲染订单卡片或工单预览;用户点击后,前端 POST /resume,服务端基于同一个图(LangGraph)再开一条同构的 SSE 流继续跑。
这个设计的优雅之处在于:中断和续流用的是同一条通道、同一套事件格式,前端只需要处理「流没结束但来了 interrupt」和「resume 后来了新流」两种状态。代价是:中断状态天然绑定在当前的 HTTP 连接上,多端共用时状态恢复要靠 DB 会话兜底。
5.2 DSH:Waterfall 问答
DSH 的做法是独立出一个「瀑布」通道。Host 发出 approval/request 等待瀑布应答,UI 通过 $events 订阅并应答,结果再回传给 Host;会话日志里另记 asked/decided 两个状态。
它和 mewhelp 最大的不同是:审批流和聊天流在协议层面就分开了。聊天继续聊天,审批走审批,两者各自有独立的生命周期。这给多窗口、插件投影(比如 IDE 里弹审批框)留出了空间。
5.3 Claude Code:控制面往返
Claude Code 的做法最接近「远程调用」:出站 control_request: can_use_tool,宿主或 UI 回 control_response;需要中断时走 interrupt 或 AbortController。
它把「是否允许调用工具」这类决策做成了一对往返的请求-响应,语义非常干净:Agent 核不假设 UI 一定会同意,每个敏感动作都显式请求授权。
5.4 Codex:RPC 审批请求
Codex 的做法最「硬」:app-server 向客户端发出 item/.../requestApproval 等 ServerRequest ------注意,这是请求,不是单向通知,客户端必须回包。不回包,Agent 就一直等。
它把「审批」和「通知」在协议语义上彻底区分开:通知是 fire-and-forget,审批是 request-response。这让 Codex 的宿主(TUI、Desktop、IDE 插件)能统一处理「必须响应」的交互。
5.5 这节的结论
四种握手的本质差异只有一句话:mewhelp 把 HITL 嵌进了「聊天流」,另外三家把 HITL 做成了独立控制面。独立控制面的代价是协议面更大(要单独定义审批事件、回包语义、超时处理),收益是 TUI / IDE / 远程多宿主可以共用同一套审批逻辑,且不会被聊天流的推进节奏绑架。
如果你的产品未来大概率只有一个网页端,mewhelp 的方案足够;如果你知道会做 IDE 插件或桌面端,请直接按「独立控制面」设计,别回头改。
5.6 四个容易被忽视的 HITL 工程细节
把四种握手看完,我还想提醒四个工程细节,它们是 HITL 能不能真正落地的关键,四个仓库里也都体现得很具体:
超时与超时后的行为。 审批请求发出后,用户可能一直不点。Codex 的 ServerRequest 语义里隐含着「宿主负责响应」,但超时之后怎么办------重试、降级为默认值、还是挂起等用户回来------必须由业务层显式定义。四个项目里,这一层语义都落在各自的宿主实现里,而不是协议层。
打断的幂等性。 用户可能连点两次确认卡片,或者点完确认又立刻撤回。mewhelp 的 resume 如果被重复调用,图的执行必须幂等;Claude Code 的 control_response 重复回包,宿主必须能识别。HITL 通道越独立,越要在接入端做幂等去重。
状态可见性。 用户等待审批时,界面应该显示「Agent 正在等待确认」而不是「卡住了」。DSH 的 approval 状态写进会话日志、Codex 的审批是显式 ServerRequest,都让「等待中」成为一个可查询的状态;mewhelp 则依赖 interrupt 帧的语义让前端渲染等待态。
多端协同时的审批归属。 如果同一个会话同时在网页和 IDE 打开,审批弹窗应该出在哪一端?DSH 的插件投影和 Codex 的 JSON-RPC 多宿主设计,本质都是在回答这个问题:审批请求广播给所有宿主,谁先响应谁生效,或者指定优先级。这个问题现在不做,多端上线那天一定会来找你。
这四个细节,决定了你的 HITL 是从「演示能跑」到「生产可用」之间的距离。
六、「AG UI」到底在说什么:先消歧义
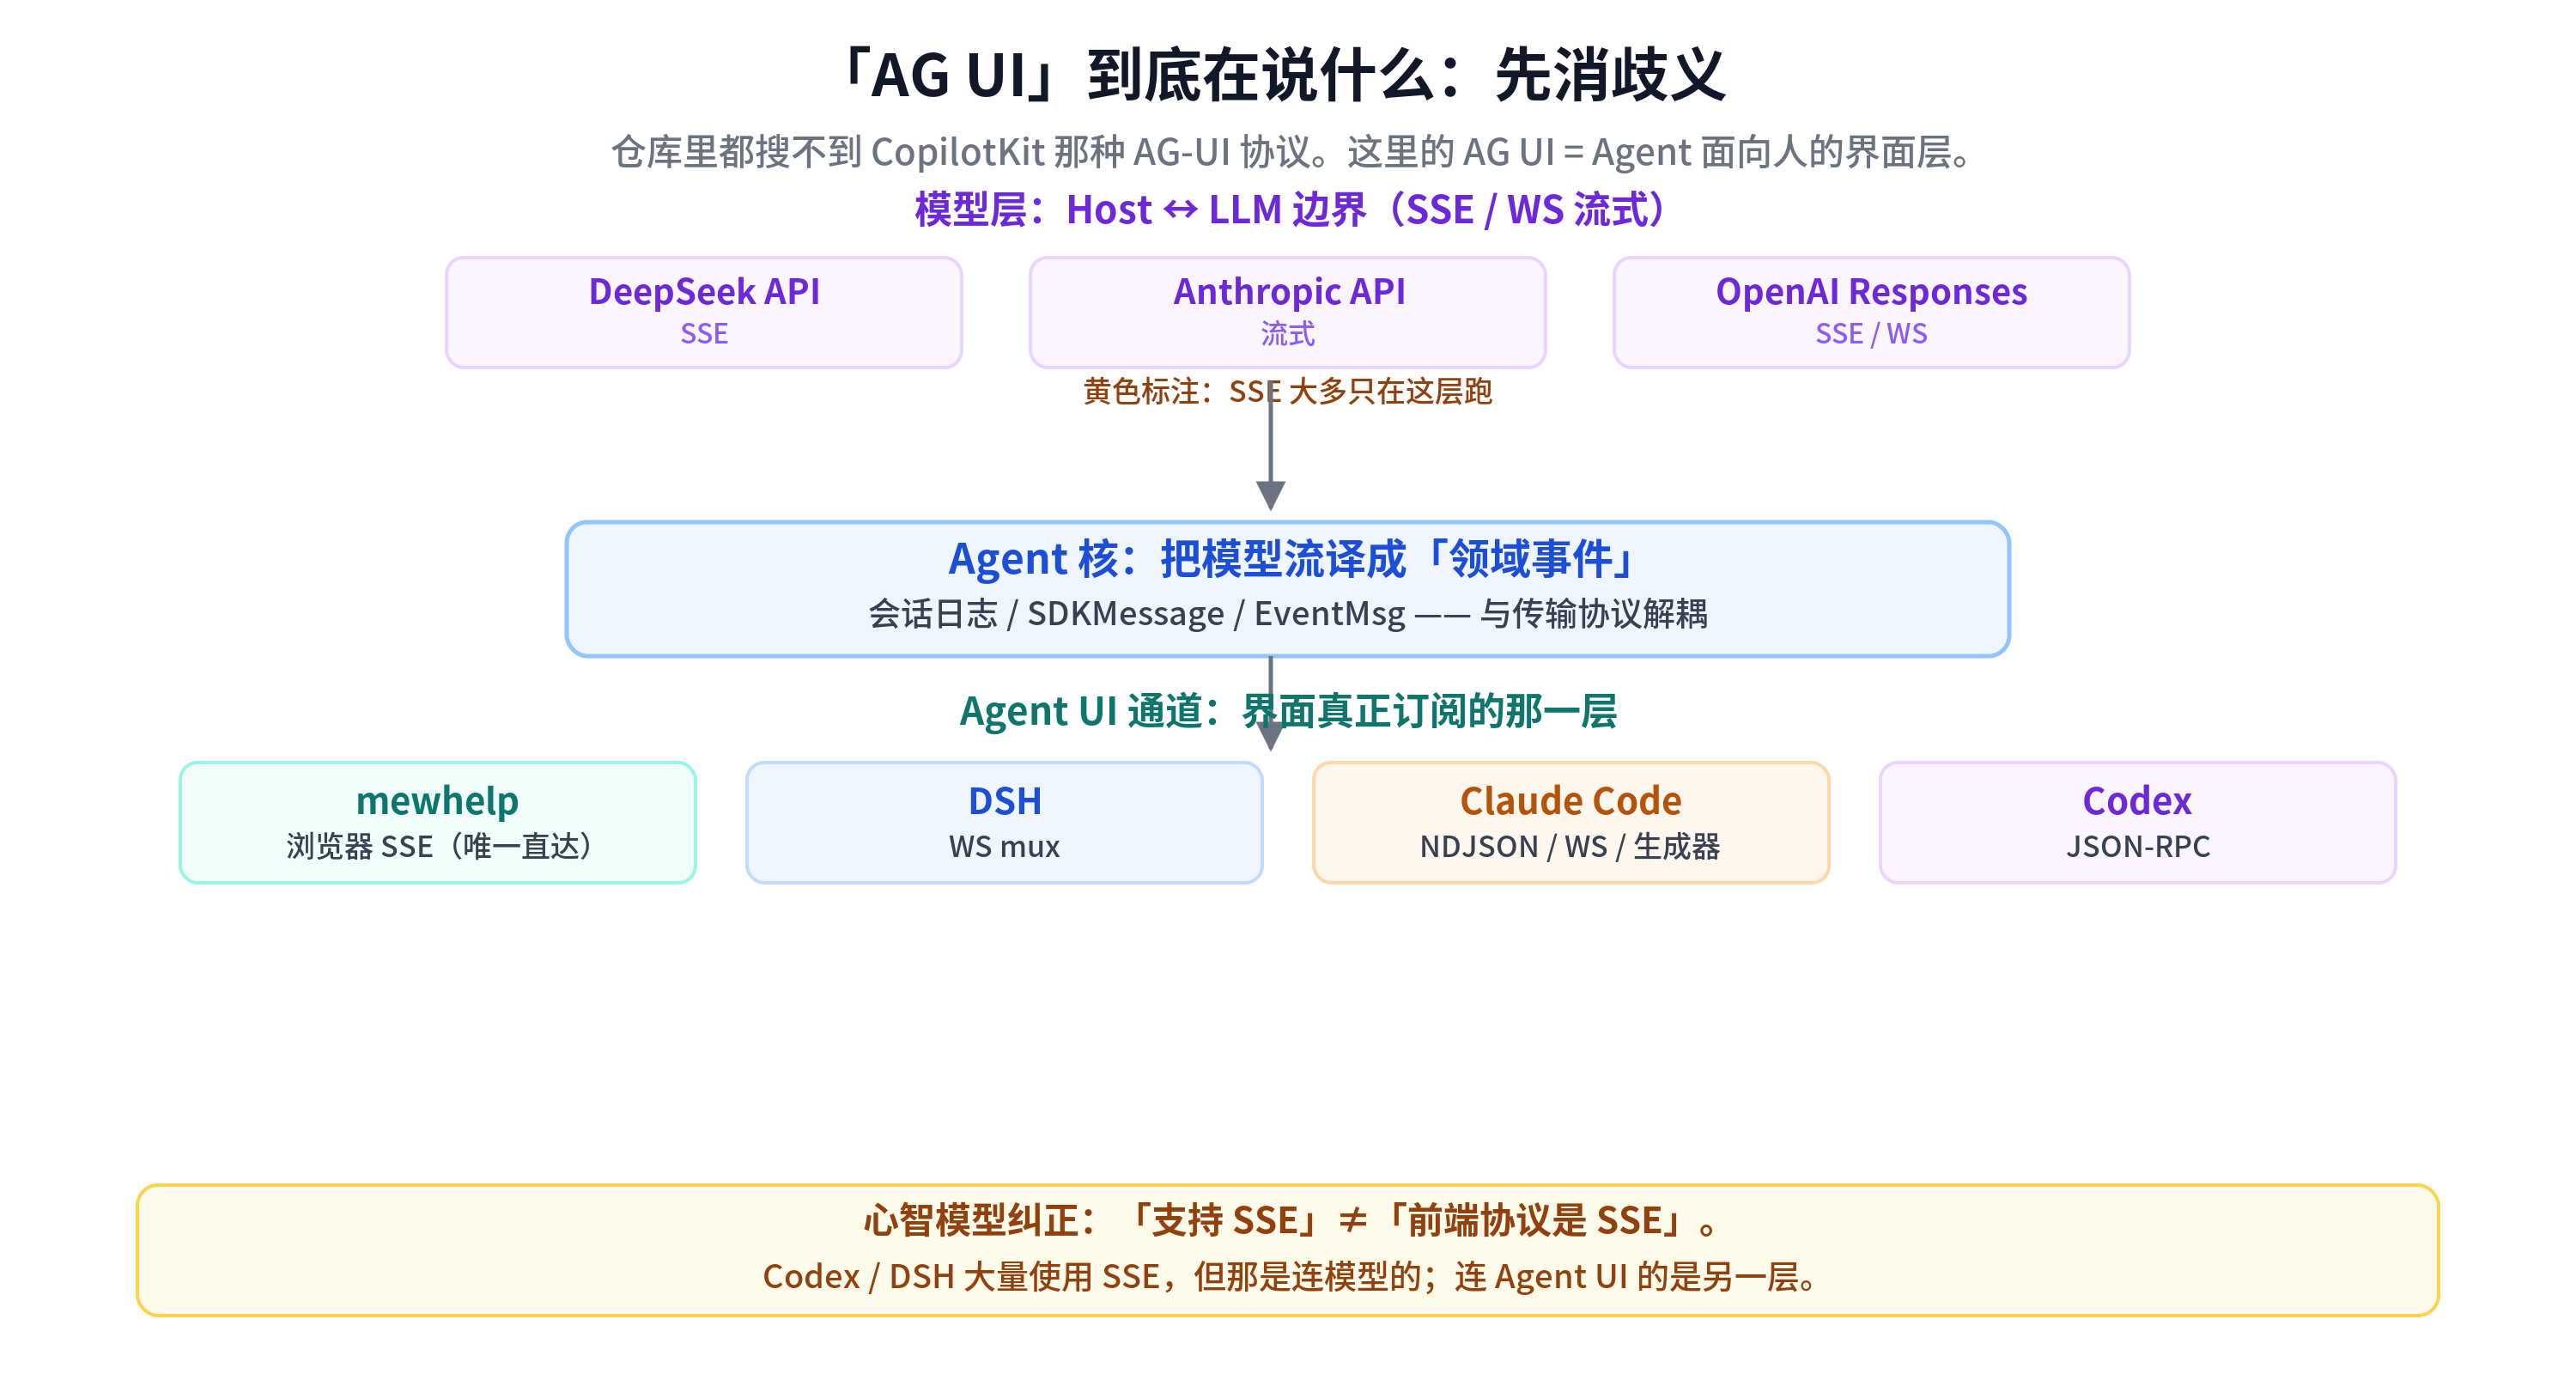
聊到 Agent 界面,很多人会想到「AG-UI 协议」(比如 CopilotKit 那套)。这里必须先做一次消歧义:四个仓库里都搜不到 CopilotKit 那种 AG-UI 协议。这里的 AG UI,指的是 Agent 面向人的界面层,是一个架构概念,不是一个协议规范。
这层理解很重要。因为「AG UI」在讨论里经常被当成一个技术标准来用,而真实世界的开源项目各有各的私有实现。我们看四个项目各自的「AG UI 层」长什么样:
- mewhelp :
app/static/index.html里的readSSEStream函数按帧更新气泡、徽章、卡片,整个 UI 就是「读流改 DOM」; - DSH :
ui-chat/ui-conversation/ui-approval三个组件分别订阅 session.follow 日志流和 waterfall 审批流; - Claude Code :Ink 的
REPL组件加handleMessageFromStream,远程模式下用sdkMessageAdapter把同一套消息灌进同一个状态机; - Codex:TUI 和 Desktop 吃 app-server 的通知与审批 RPC,TS SDK 吃更粗粒度的 JSONL item/turn 事件。
四个项目的 AG UI 层差异很大,但底层心智模型是一致的:模型流先被翻译成领域事件,UI 再订阅领域事件。
这里必须纠正一个高频误解,我单独拿出来讲,因为它坑过很多人:
「支持 SSE」不等于「前端协议是 SSE」。
Codex 和 DSH 都在大量使用 SSE,但那是连模型 的;连 Agent UI 的是另一层。你去翻 codex-api/sse/responses.rs,会看到 SSE 处理被严格封装在 API 客户端内部;你去翻 DSH 的 llm-deepseek/sse.ts,同样如此。所以下次有人在技术评审会上说「我们支持 SSE,前端直接连就行」,请先问一句:你的 SSE 连的是模型,还是连的是 UI? 这两个问题的答案是两种完全不同的架构。
6.1 那 CopilotKit 的 AG-UI 协议又是什么
既然提到了 AG-UI 协议,就顺带把它和这四个仓库的关系说清楚,避免大家混淆。
CopilotKit 等社区推动的 AG-UI,是一套面向 Agent 应用的标准协议提案,目标是让「任何 Agent 后端」和「任何前端框架」之间能通过统一的事件格式互通------你可以把它理解成 Agent 界的 REST 或 MCP。它规定了事件怎么命名、流怎么分片、审批怎么表达,属于「协议层」的规范。
而本文这四个仓库,全部是各自实现的私有协议 :mewhelp 的小事件表、DSH 的 Typert Remote、Claude Code 的 SDK stream-json、Codex 的 app-server protocol,没有一个是照着 AG-UI 规范实现的。这不代表它们落后,而是说明:在标准化协议成熟之前,每个产品都在用最贴合自己场景的方式解决同一个问题。
这给我们的启示是:如果你在 2026 年从零设计 Agent 界面架构,不必死等 AG-UI 标准落地,也不必完全自研------更好的姿势是按标准协议的思想设计自己的领域事件层(事件命名规范、审批语义、流生命周期),同时在接入层预留一个「协议适配器」,将来 AG-UI 标准成熟时,只换适配器,不动内核。
6.2 AG UI 层的通用设计清单
最后给一份可落地的清单。无论你参考哪个项目,AG UI 层至少要回答这五个问题:
- 界面订阅的事件从哪来:是模型流直通,还是 Agent 核翻译后的领域事件?(本文结论:必须是后者)
- 事件的粒度怎么定:细到 delta 逐字,还是粗到 item/turn 整块?(取决于界面交互复杂度)
- 审批/打断走哪条通道:聊天流内嵌,还是独立控制面?(取决于端是否多样)
- 断线重连后状态从哪恢复:DB 会话兜底,还是可回放事件日志?(取决于是否需要审计与回放)
- 上行请求怎么发:resume POST、WS 消息,还是 JSON-RPC request?(取决于下行通道的单向性)
把这份清单当成评审清单用,一份 Agent 界面架构方案拿出来,五分钟就能判断它靠不靠谱。
七、什么时候有用:抄谁的形状
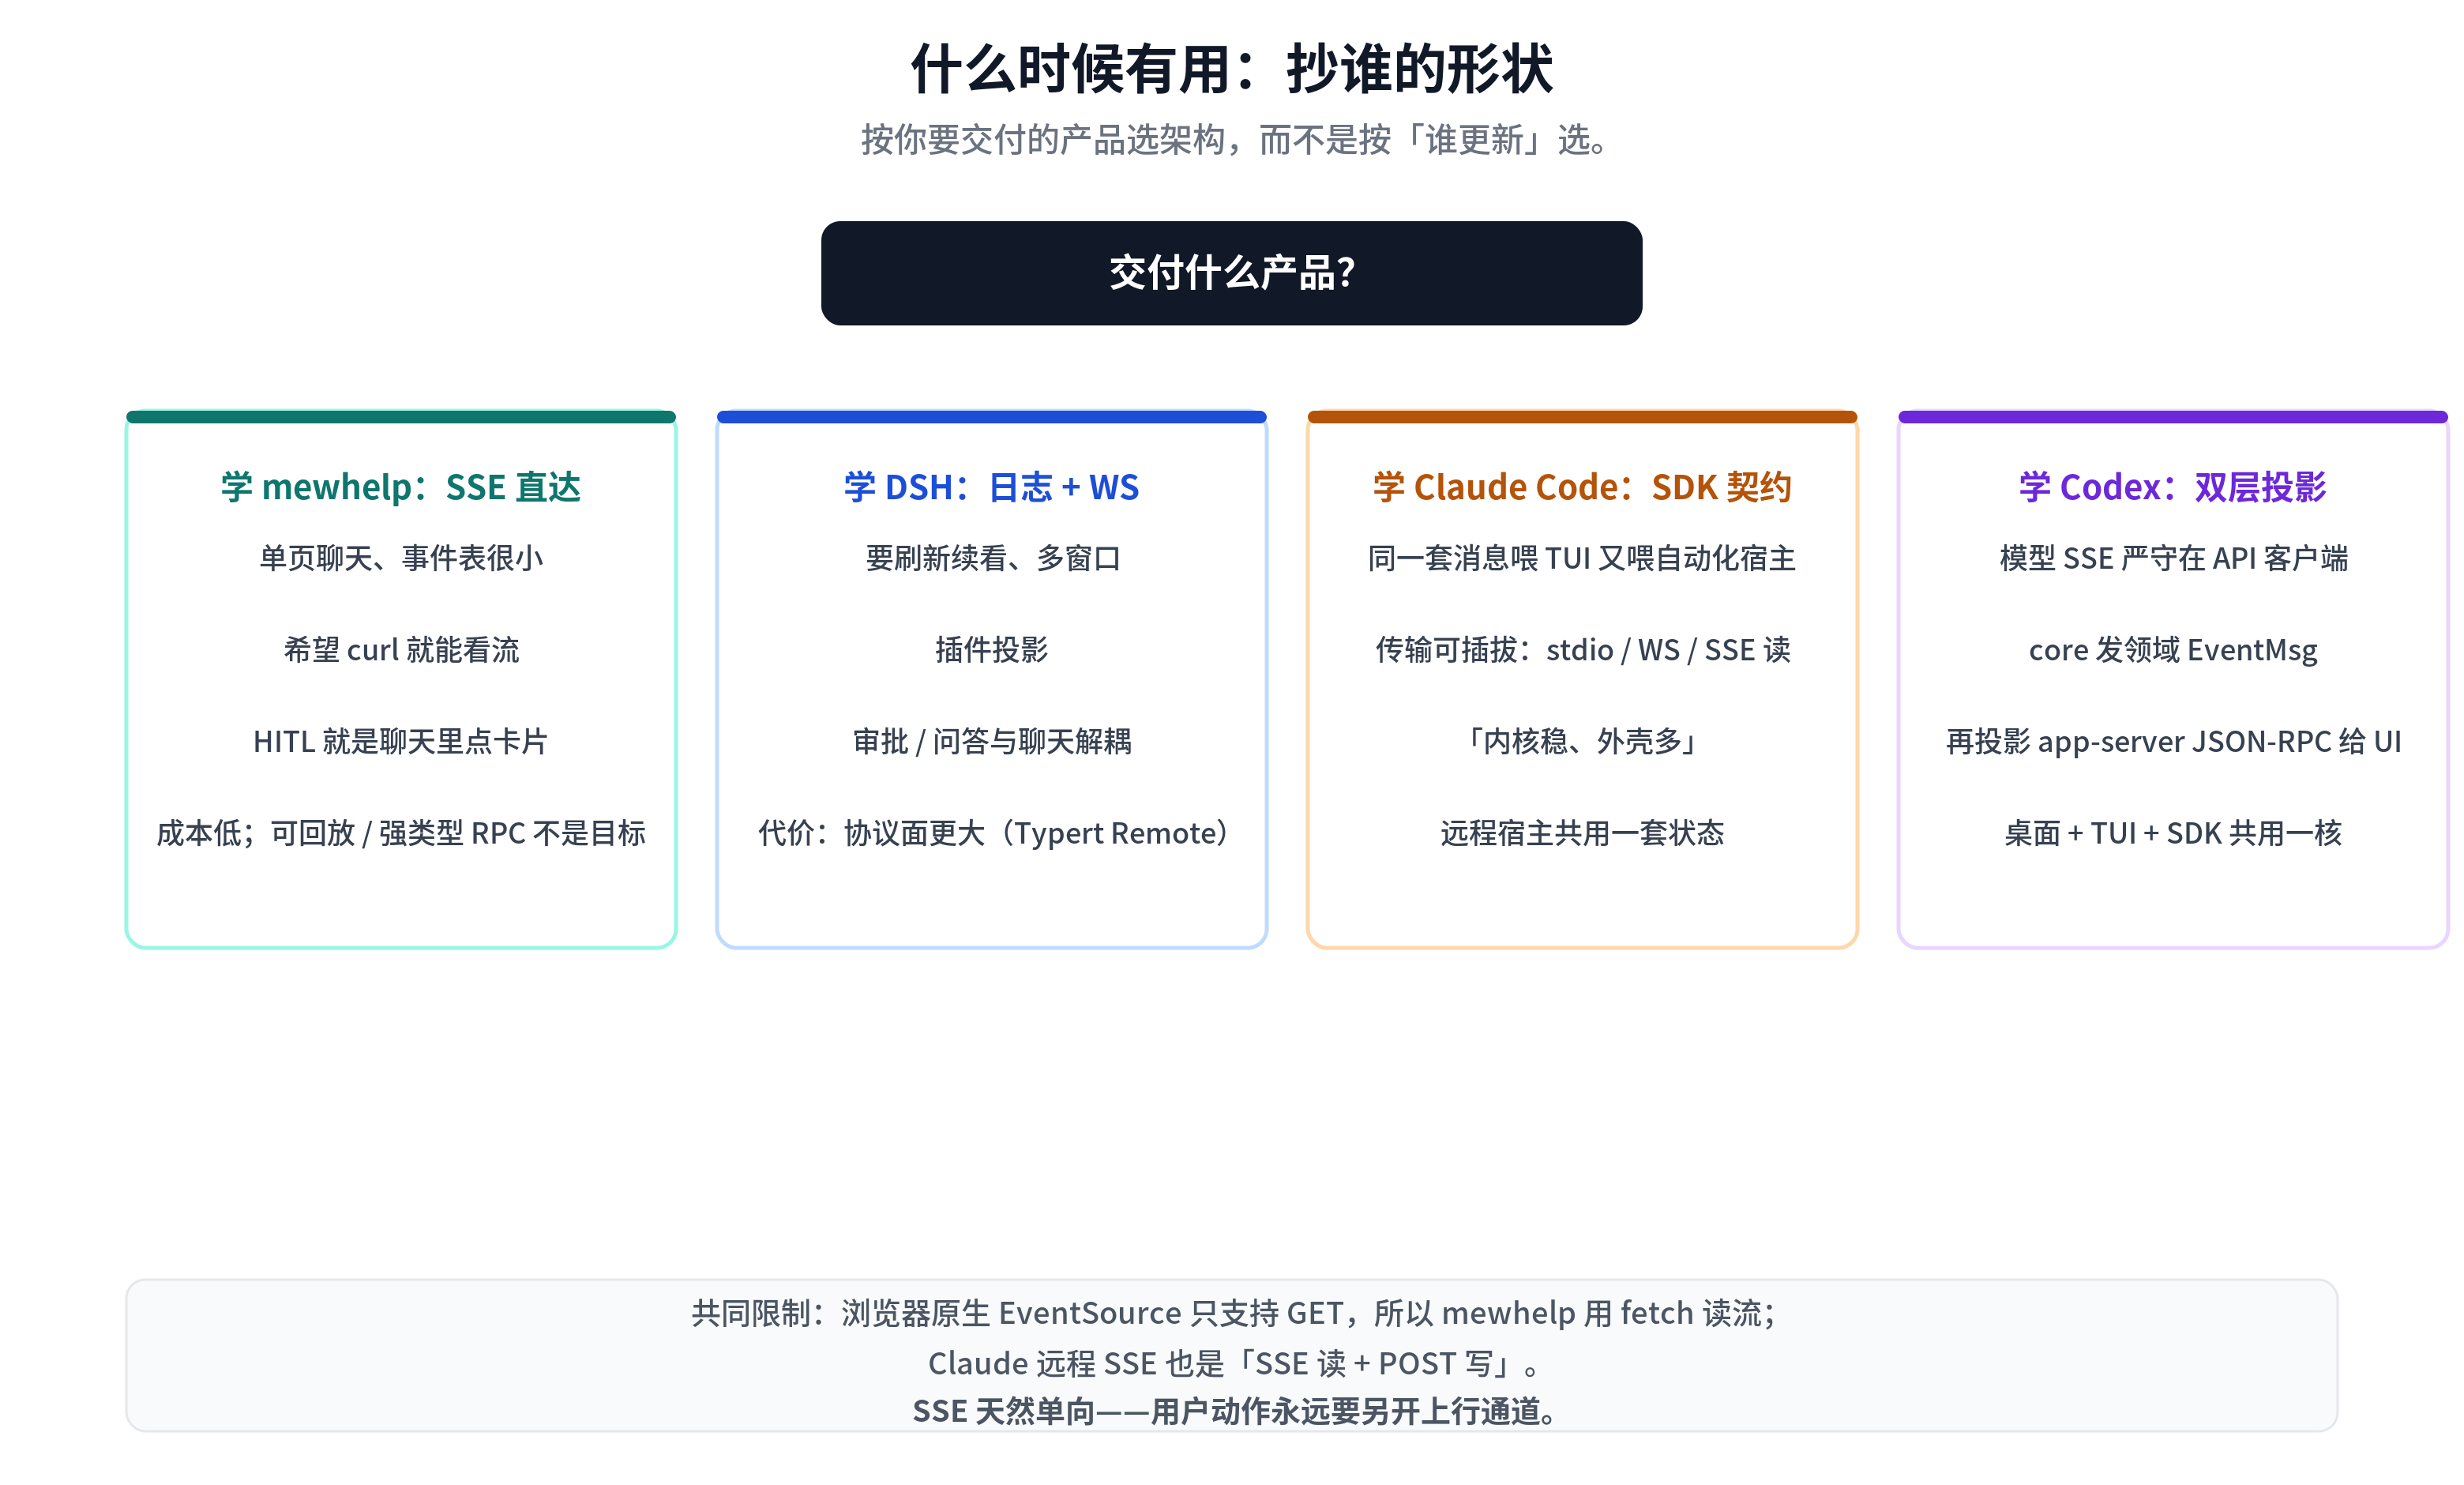
技术方案没有银弹,只有「在什么约束下最合理」。这一节给出选型建议,原则只有一个:按你要交付的产品选架构,而不是按「谁在更新界面」选。
7.1 学 mewhelp:SSE 直达
适合你的情况:单页聊天、事件表很小(delta / tool / interrupt / done 就够)、希望 curl 就能看到流、HITL 就是聊天里点个卡片。
这是四条路里成本最低的。但你要清楚它的边界:多客户端、可回放、强类型 RPC 都不是它的目标。如果你确定产品永远只有一个网页端,mewhelp 是最优解------它把「能跑」做到了极致。
7.2 学 DSH:日志 + WS
适合你的情况:需要刷新续看(页面关了再打开,聊天记录和状态还在)、多窗口、插件投影、审批与问答和聊天解耦。
DSH 的核心资产是可回放的 session log。一切状态都从日志推导,UI 只是日志的投影。代价是协议面更大:你要维护 Typert Remote 加 session event map 这一整套东西。如果你的产品要做「历史会话可回放」或者「多端同步」,这条路的投入是值得的。
7.3 学 Claude Code:SDK 契约
适合你的情况:同一套消息既喂 TUI 又喂自动化宿主(比如 CI 里跑 headless)、传输可插拔(stdio / WS / SSE 读随时换)。
它的核心思想是「内核稳、外壳多」:消息契约是唯一的、稳定的,传输层是策略化的、可替换的。如果你在做 SDK 型产品(别人基于你的 SDK 开发自己的界面),Claude Code 的形态就是范本。
7.4 学 Codex:双层投影
适合你的情况:桌面 + TUI + SDK 共用同一个核心、模型 SSE 必须严守在 API 客户端、UI 层需要多粒度的订阅(粗粒度 item/turn 给 SDK,细粒度 delta 给界面)。
它是四家里分层最彻底的:模型 SSE → ResponseEvent → core EventMsg → app-server JSON-RPC 投影。每一层职责单一,换模型供应商只动最外层,换 UI 只动最内层。代价是链路长、概念多,小团队要掂量一下维护成本。
7.5 共同限制:SSE 的单向性
无论抄谁,有一个限制逃不掉:浏览器原生 EventSource 只支持 GET ,所以 mewhelp 用 fetch 读流;Claude 的远程 SSE 也是「SSE 读 + POST 写」的组合。SSE 天然是单向的------服务端推给客户端没问题,客户端要发消息,永远要另开一条上行通道。
这一条决定了所有 SSE 方案的上行设计:要么用 fetch POST 新开请求(mewhelp 的 resume),要么用 WebSocket 做双向(DSH 的 mux),要么用 JSON-RPC 的 request(Codex 的审批)。下行是推送,上行是请求-应答,这两件事从一开始就要分开设计。
八、收束:一条因果链
把全文压缩成一条因果链,就是下面这张图:
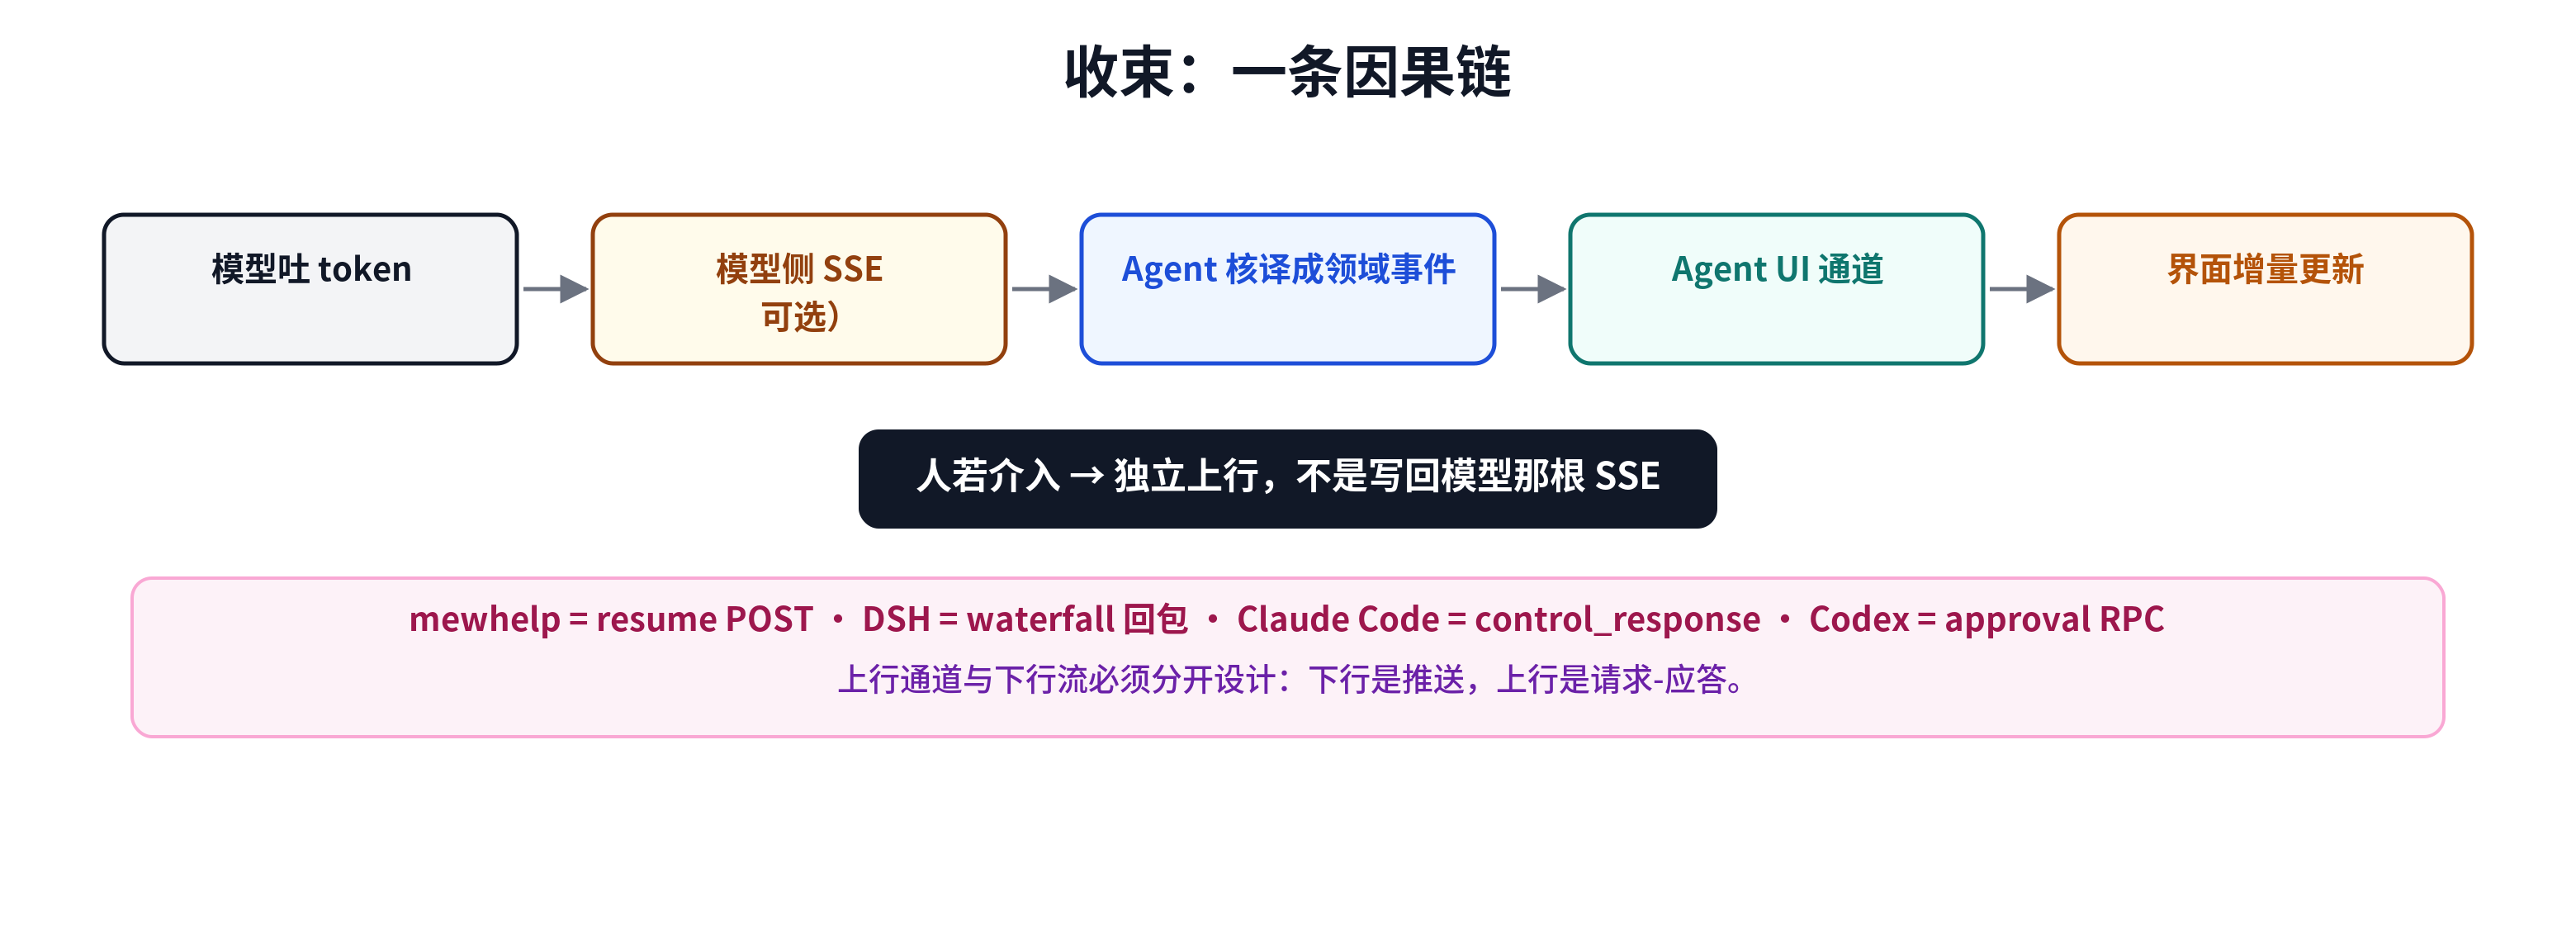
模型吐 token →(可选)模型侧 SSE → Agent 核译成领域事件 → Agent UI 通道 → 界面增量更新 ;人若介入,走独立上行------resume POST / waterfall 回包 / control_response / approval RPC------而不是写回模型那根 SSE。
这条链上每一环的选择,都对应前面七节的结论:
- 模型侧 SSE 是「可选」的------有些供应商不流式,你要在 Agent 核层把它兜住;
- Agent 核译成领域事件是必须的------这是让 UI 不依赖模型供应商的唯一手段;
- Agent UI 通道是多元的------mewhelp 选浏览器 SSE,DSH 选 WS,Claude Code 选生成器/NDJSON/WS,Codex 选 JSON-RPC;
- 独立上行是刚需------SSE 单向决定了用户的动作永远走另一条路。
如果你在评审一份 Agent 界面架构方案,把这四行摆出来逐条对照,方案的质量立判高下。
九、总结:给你四个可落地的动作
文章写到这里,把结论收敛成四条可执行的动作,直接拿走用:
第一,先画分层图再写代码。 无论你选哪条路,先在纸上画清楚四层:模型层、Agent 核、UI 通道、界面层,然后明确标注「SSE 出现在哪一层」。这一步能拦下 80% 的架构返工。
第二,模型流永远不要直接透传给 UI。 在 Agent 核里做一次事件翻译,让 UI 只消费领域事件。换模型供应商的成本,就藏在这层翻译里。
第三,HITL 走独立控制面。 只要你的产品有超过一个端(网页 + 插件 + 桌面),就把审批做成 request-response 的独立通道,不要塞进聊天流里。
第四,上行和下行分开设计。 SSE / WS 管下行推送,resume / RPC 管上行请求。不要试图在一条单向通道里实现双向语义。
这四个动作做完,你的 Agent 界面架构至少不会在「SSE 到底连谁」这个最基础的坑里翻车。
参考仓库与实现文件
本文全部技术结论均依据以下四个开源仓库的实际实现整理(非业界 AG-UI 规范):
- mewhelp:
app/api/chat.py、app/static/index.html - deepseek-harness:
packages/api/gateway、session-controller、llm-deepseek/sse.ts - claudecode:
cli/transports/SSETransport.ts、entrypoints/sdk/*Schemas.ts - codex-main:
codex-api/sse/responses.rs、app-server-protocol
如果你只想验证本文的某个结论,直接去对应文件里搜索关键词即可:mewhelp 搜 readSSEStream,DSH 搜 session.follow,Claude Code 搜 control_request,Codex 搜 requestApproval。源码不会骗人。
写在最后
SSE 和 Agent UI 的关系,本质上是一个「职责边界」问题:模型负责吐词,Agent 核负责翻译,界面负责呈现,三者各司其职。四个开源项目用四种不同的通道组合回答了同一个问题,而它们的共同点比差异点更重要------没有一家把模型的原始流直接扔给界面。
希望这篇文章能帮你少踩一个坑。如果你正在做 Agent 界面架构,或者对文中某个仓库的实现有不同理解,欢迎在评论区交流。
转载声明:本文为原创文章,如需转载,请联系作者获得授权,并注明出处。