买了 8 块 16TB 的盘,128TB 裸容量,装出来的桶能用多少?大多数人拿 128 × 0.75 估一个大概就往下走了。但这个 0.75 从哪来、什么时候不成立、坏几块盘真的没事吗,才是决定数据会不会丢的那几件事。
对象存储的可靠性不走"多存几份"那条路,它用 Reed-Solomon 纠删码:一个对象被切成若干数据片,再算出若干校验片,一起散到不同盘上。坏了几片,靠剩下的还能反推回去。整盘买卖里最容易算错的就是下面这几个数字。
N、M、K 这三个字母分别在说哪件事
文档里写的 EC:4、EC:8,说的是 M,也就是校验片(parity shard)的数量。它必须和另外两个字母放在一起才有意义:
N:一个纠删集里有几块盘。纠删集是把一堆盘横向划出来的小组,写对象时按组为单位落盘M:校验片数量,也就是EC:后面那个数K:数据片数量,K = N - M
RustFS 官方文档把这套关系写得很直接:一个含 N 块盘、M 个校验片的纠删集,数据片是 N - M,最多能重建的不可用分片数是 M,近似容量利用率是 (N - M) / N。文档给的算例是 16 盘纠删集配 EC:4,存 12 个数据片加 4 个校验片,在扣除文件系统、元数据与运行开销之前的近似利用率是 75%。
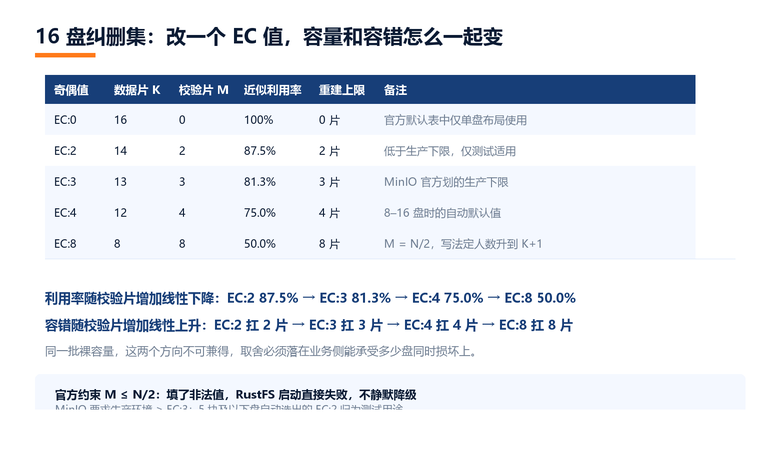
所以 0.75 的来路是 12 / 16。它跟默认配置无关,也不是什么行业惯例,只代表"恰好 16 盘一组、恰好 4 个校验片"这一种情况。换成 EC:2(14/16)是 87.5%;EC:8 那档掉的就狠了:16 盘配 EC:8 时 N=16、M=8、K=8,K 顶到 N/2,利用率同样 50%,但两者的写入门槛已经完全不一样,后面的法定人数会展开讲。
同一个 16 盘集群,只改这一个参数,可用容量就在 50% 到 87.5% 之间来回摆。
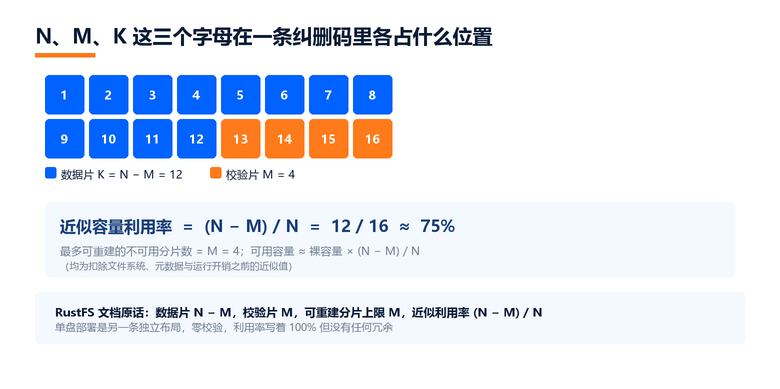
这里还有一个容易被忽略的边界:单盘部署是另一种独立布局,零校验。RustFS 文档明确写到多盘纠删集的盘数范围是 2 到 16,而单盘部署是一条单独的布局路径, parity 为 0。也就是说开发机上拿一块盘跑起来的实例,利用率写的是 100%,但它没有任何冗余,盘坏了数据就没了。看到 100% 这个数字先高兴起来的话,多半是踩在这个坑里。
默认不用你配,因为它是从盘数倒推出来的
多数人装完集群从不设置 EC 相关变量,存储自己挑了一个。这个"自己挑"是有明确规则的:RustFS 会为每个存储池,按它的纠删集大小独立推导 STANDARD 存储级别的奇偶值。
官方给出的默认奇偶表:
| 每纠删集盘数 | 自动采用的奇偶 | 数据片 | 近似利用率 |
|---|---|---|---|
| 1 | EC:0 |
1 | 100% |
| 2--3 | EC:1 |
1--2 | 50%--67% |
| 4--5 | EC:2 |
2--3 | 50%--60% |
| 6--7 | EC:3 |
3--4 | 43%--50% |
| 8--16 | EC:4 |
4--12 | 50%--75% |
MinIO 官方文档里列的表与这张完全一致:同样是 1 对应 EC:0、2--3 对应 EC:1、4--5 对应 EC:2、6--7 对应 EC:3、8--16 对应 EC:4。两家收敛到同一套推导,背后是同一个约束:校验片不能超过总盘数的一半。
RustFS 文档把这条约束写成了启动时的校验条件 M <= N / 2。填进去的非法值不会让服务悄悄降一档继续跑,而是启动直接失败。这个设计比自动降级更诚实:它不会让集群带着一个你没意识到的低可靠性一直运行下去。
顺着这条边界往另一头看,是零校验。EC:0 同样能通过校验、给出 100% 的利用率,代价官方写得很直白:换掉或清空一块盘,那块盘上的零校验对象永久丢失,heal 对它们只会回一句 no-parity object is unrecoverable。官方给出的下限是生产部署至少 EC:1,而一旦这个纠删集跨了节点,通常按 EC:2 起步。利用率表里的 100% 不是"赚到",它只是没有冗余兜底而已。
拿自己那批盘算一遍
官方给出的口径是:
可用容量 ≈ 裸容量 × (N − M) / N它自己举的例子是 160 TiB 裸容量、16 盘纠删集配 EC:4:160 × (16 − 4) / 16 = 120 TiB。
这条公式有三个容易踩的地方。
第一,N 是纠删集大小,不是集群总盘数。 一个 64 盘的集群通常会被划成多个纠删集,比如 4 组每组 16 块,算的时候用的是 16 而不是 64。纠删集宽度默认由存储从卷拓扑里自动挑一个合法值,需要钉死时可以用 RUSTFS_ERASURE_SET_DRIVE_COUNT 指定,前提是这个值能把已配置的端点整除,否则会被拒绝。
对比之下,MinIO 在 RELEASE.2026-02-02T23-40-11Z 及之后的版本允许通过 MINIO_ERASURE_SET_DRIVE_COUNT 把纠删集放宽到 17 到 32 块盘,默认值仍是 16。同一批 128 块盘,配 32 是 4 个纠删集,不配是 8 个纠删集。而这个数字一旦集群初始化就再也改不动了,官方文档写得很明白:selected stripe size is immutable after the cluster has been initialized。这笔账必须在装机前算,容量不够了再回头调是调不了的。
第二,公式给的是近似值,文档特意加了"之前"这个限定。 RustFS 原文的表述是 "before file-system, metadata, and operational overhead",也就是扣掉文件系统、元数据和运行开销之前。实际可用一定比公式结果少一截,做容量规划时要给这部分留余量。
第三,混合存储级别的场景会让账不准。RustFS 支持 STANDARD 和 REDUCED_REDUNDANCY 两个存储级别,各自有独立的奇偶设置:RUSTFS_STORAGE_CLASS_STANDARD 管前者,RUSTFS_STORAGE_CLASS_RRS 管后者,后者在多盘纠删集上默认是 EC:1。两者都存在时,STANDARD 的奇偶值必须大于等于 REDUCED_REDUNDANCY 的值,这条同样进了校验条件。同一个集群里两种级别混用,整体利用率会落在两者之间的某个位置,不能简单套一个 (N-M)/N 了事。另外还有一个 RUSTFS_STORAGE_CLASS_OPTIMIZE 变量控制选奇偶时的优化目标,默认值是 availability,也就是说默认倾向可用性而不是空间利用率。
"EC:4 能扛 4 块盘"这句话差一个条件
这是最容易被话术带偏的一处。单看重建能力,M 确实等于"最多可重建的不可用分片数",所以 EC:4 能从任意 12 个存活分片里把数据算回来。但这个推论挂着两个前提,官方都做了提示。
不可用的是"分片",不是"节点"。 RustFS 文档在原话后面跟了一句警告:不要假设 EC:4 总能容忍四个完整节点故障,因为一个节点可能同时承载同一个纠删集里的多块盘。4 节点 × 4 盘的部署中,一台下线意味着它上面的 4 个分片同时不可用;两台同时下线,同一个 16 盘纠删集上可能直接少了 8 片,超过 M=4 的重建上限。要在主机或机架维度谈容错,就得让同一个纠删集的盘尽量分散到不同节点,除了 RUSTFS_ERASURE_SET_DRIVE_COUNT,部署时的端点排列顺序也得看。
写入时允许的失败次数会被压缩。 读的门槛好算,写的门槛常被忘掉。RustFS 官方把这两个数字直接列出来了:读法定人数等于 K,写法定人数等于 K,但当 K == M 时写法定人数抬到 K + 1。落到具体盘数上:
- 16 盘
EC:4(K=12、M=4):读要凑齐 12 个有效分片;写则尝试写满 16 片,允许其中 4 片失败,凑够 12 片就向客户端返回成功 - 16 盘
EC:8(K=8、M=8):读要凑齐 8 个分片;写却必须至少 9 片应答,能容忍的写失败只剩 7 片
EC:8 那一行是分界线。它的读恢复能力不差,任意 8 个分片就能把数据算回来,但写入路径的容错反而比 EC:4 少一片。这个不对称全部来自 K == M 时那道 K+1 门槛,官方给的理由是防止 split-brain 那类场景:两半各握着足够多的分片,各自都觉得自己还能继续写。落到部署上,M 顶到 N/2 就再没有加校验的空间了,生产环境里这一档用得很少,属于"利用率和写入可用性都压到极限"的取舍。RustFS 官方对这条没有额外的禁用标注,上面这句是经验判断。
官方还有一句边界值得记住:低于法定人数的写入不会被报成成功,服务端不会给客户端一个假的成功响应。这比争"到底允许失败几次"更重要,因为失败会明确暴露出来,不会攒到坏盘那天才发现。
再补一个同样容易误判的门槛:删除标记走的是多数派,N/2 + 1,16 盘集上是 9。所以一个正在降级、读写都在失败的纠删集,删除仍可能成功。删除成功不代表这个集是健康的,判断健康还是要看分片状态和读写是否达标。
RustFS 不会按离线盘数临时抬高奇偶。MinIO 有一个动态行为:发现纠删集里有盘离线但写法定人数仍满足时,会给正在写的对象逐级提升奇偶值,每离线一块盘加一,升级后的值写进对象元数据。RustFS 没有这套东西,原因是它的几何按对象写死在 xl.meta 里,官方原话是 The geometry is stored per object in xl.meta, so changing the default later rewrites nothing。运行期不会因为某块盘离线就临时抬高校验,改默认值也不会回头重写任何存量对象,想提奇偶只对之后新写入的对象生效,旧的要重新上传或走服务端复制。好处是行为可预期,代价是进入退化状态后没有额外的余量补偿,那一刻的容错就是配置值给的那个数。
回到那 8 块盘,以及一个外部校验值
8 块 16TB 构成一个纠删集时,自动奇偶取 EC:4,可用容量约 128 × (8-4)/8 = 64TB。注意 8 盘这一档的 K 和 M 都是 4,正好落在 K == M 的边界上:读要凑齐 4 个分片,写法定人数却是 K+1,也就是 5。坏任意 4 个分片仍能重建,此时读刚好达标、写已经差一个。配成 EC:2(K=6、M=2),容量涨到 96TB,读写法定人数都是 6,重建上限 2 片。
问题就出在这个"2 片"是分片口径,换成节点口径结论会翻。两台机器各插 4 块盘、同属一个 8 盘纠删集时,一台整机掉电等于同一纠删集上 4 个分片同时没了:EC:2 超出上限,EC:4 剩下 4 片也刚好压在读写门槛上,一点余量都不剩。要让整机掉电也扛得住,得换打法:同一纠删集的分片摊到 4 个节点、每节点 2 块盘,同样 EC:2,整机掉电只掉 2 片,读写都还能达标,代价是再坏一片就没有任何余量了。同样的 EC 值,打散得好能扛整机故障,打散得差连一半都算不上。这也是为什么 EC 参数只是纸面数字的一部分。
纠删集宽度本身还有反向约束。这个数不是越大越好:宽度越大,坏一片之后重建要读回的分片成比例变多,而同一个纠删集内的重建是串行的,一次 rebuild 拖长,下一次故障的窗口就跟着变宽。宽度太小也不行,利用率低、容错档位少。RustFS 的硬范围是每纠删集 2 到 16 块盘,且每个存储池必须能被这个宽度整除;12 到 16 这个常见区间属于业界经验,官方页面上并没有推荐值,别把它当硬性建议用。
MinIO 官方给了一条生产下限:生产部署必须使用 EC:3 或更高的奇偶值 ,低于这个值的配置(包括 5 块及以下盘那几档自动选出来的默认值)容错不足,只适合开发和测试环境。这条可以当作外部校验用:拿到任何一套默认配置之后,先核它的 EC 值是否 ≥3。
规划阶段的拓扑也该单独标一笔。盘数选对了不等于打散对了。RustFS 官方在集群规划第一步就要求按节点、机架、供电、网络这四类故障域安排端点顺序,并且给了一句很实在的提醒:声明拓扑不等于已经具备高可用,单节点的存储池会随主机一起丢掉全部分片,多盘的存储池在启动时都会打一条 host_failure_data_unavailable 警告。这条警告不用当成启动失败去紧张,它出现在每一次多盘池的启动里,提醒的是同一件事:同一个纠删集的分片如果落在同一台机器上,那台机器就是这部分数据的单点。
落到 RustFS 上,这笔账最后收敛到三个环境变量加一组校验条件:
bash
export RUSTFS_STORAGE_CLASS_STANDARD="EC:4"
export RUSTFS_STORAGE_CLASS_RRS="EC:1"
export RUSTFS_ERASURE_SET_DRIVE_COUNT=16三条要同时成立:M <= N/2;STANDARD 的 M 不小于 REDUCED_REDUNDANCY 的 M;指定的纠删集宽度能整除端点数。任何一条不满足,服务会拒绝启动而不是降级运行。改完这三行先别急着庆祝,看一眼启动日志,把"没起来"当成预期内的反馈处理。
RustFS 在 Apache 2.0 许可下开源,二进制、容器镜像与 Kubernetes 部署路径都能直接取用,上面提到的 EC Configuration 与环境变量参考两页都公开在 docs.rustfs.com。装集群之前花十分钟把 (N-M)/N 算一遍,成本远低于上线后发现可用容量少了一半。