上周有个同事来问我:导出按钮点下去,文件小的时候秒下,文件一大(两三百兆)就像按钮坏了,十几秒没任何反应,然后突然弹出保存框。用户以为没点上,又点了三次,于是后台同时在跑四份导出。
我翻了下代码,就是这段几乎所有项目里都有的写法:
js
async function download(url, filename) {
  const res = await fetch(url, { headers: { Authorization: `Bearer ${token}` } });
  const blob = await res.blob();
  const a = document.createElement('a');
  a.href = URL.createObjectURL(blob);
  a.download = filename;
  a.click();
  URL.revokeObjectURL(a.href);
}
小文件完全没毛病。问题都出在「大」和「慢」叠在一起的时候。这篇把这段代码的三个问题拆开说,再给三种替代写法,每种都附上能直接跑的代码,最后说清楚各自的边界。
先量一下:300MB 的文件,内存里到底发生了什么
我在本机起了个静态服务,放了一个 300MB 的随机文件,在 Chrome 153 里分别用三种方式取它(本地回环,网络几乎不耗时,所以这里只看内存和"第一个字节什么时候能用"):
| 读法 | 总耗时 | 第一块数据可用 | JS 堆增量 |
|---|---|---|---|
res.blob() |
382 ms | 等全部下完 | 不进 JS 堆(Blob 由浏览器单独管理) |
res.arrayBuffer() |
306 ms | 等全部下完 | +300 MB |
res.body 流式读 |
209 ms | 6 ms | 基本为 0(每块用完即弃,共 3225 块) |
测量代码很短,贴出来你可以自己换个文件跑:
js
async function measure(url) {
  const out = {};
  let t0 = performance.now();
  let b = await (await fetch(url)).blob();
  out.blob = { ms: performance.now() - t0, size: b.size };
  b = null;

  t0 = performance.now();
  const h0 = performance.memory.usedJSHeapSize;   // 只有 Chromium 有这个字段
  let ab = await (await fetch(url)).arrayBuffer();
  out.arrayBuffer = {
    ms: performance.now() - t0,
    heapDeltaMB: (performance.memory.usedJSHeapSize - h0) / 1048576,
  };
  ab = null;

  t0 = performance.now();
  const res = await fetch(url);
  let got = 0, first = null;
  await res.body.pipeTo(new WritableStream({
    write(chunk) {
      if (first === null) first = performance.now() - t0;
      got += chunk.byteLength;
    },
  }));
  out.stream = { ms: performance.now() - t0, firstChunkMs: first, got };
  return out;
}有一点要说清楚:blob() 并不是"把 300MB 全塞进 JS 内存"。Chrome 的 Blob 存储在超过一定体积后会分页落到磁盘,所以它不像 arrayBuffer() 那样直接把堆顶上去。网上很多文章说「blob 下载大文件会 OOM」,在 Chromium 上这个说法不准确,真正的问题在别处。
问题一:保存框要等整个文件下完才弹
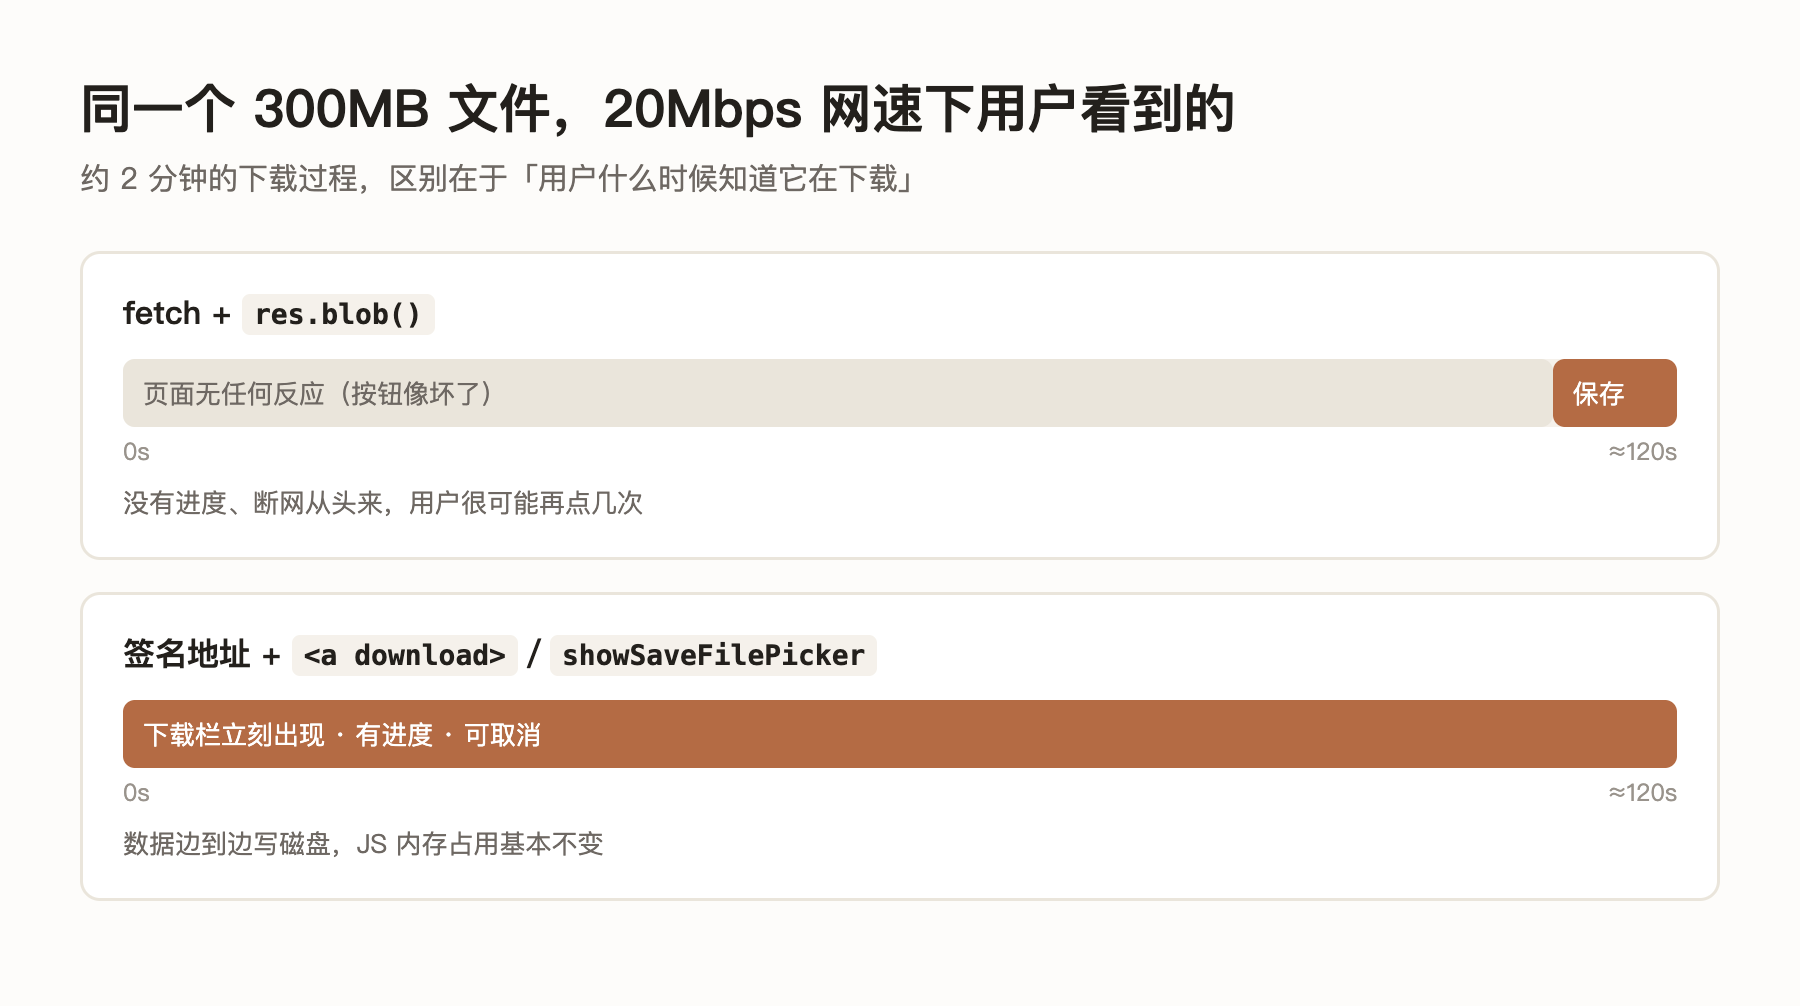
await res.blob() 这一行会一直等到最后一个字节到达。在这之前,页面上什么都没发生,浏览器底部的下载栏也不会出现,因为对浏览器来说这根本不是一次"下载",只是一个普通的 fetch。
本地回环 300MB 只要几百毫秒,所以开发的时候永远发现不了。换成用户家里 20Mbps 的宽带,300MB 大约要两分钟,这两分钟里按钮看起来就是坏的。
问题二:没有进度,也没法取消
blob() 是一个黑盒 Promise,中间状态拿不到。想做进度条就得自己读流。取消倒是可以靠 AbortController,但用户根本不知道有东西在下载,也就无从取消。
问题三:断了就是从头来
浏览器自带的下载管理器遇到网络抖动可以"恢复",fetch 不行。两分钟下到 90% 断了,blob() 直接 reject,前面白下。
这三个问题的根子是同一个:我们把本该交给浏览器下载管理器的事,揽到了 JS 里自己做。所以思路也就两类:要么想办法还给浏览器,要么在 JS 里把流式、进度、取消补齐。
写法一:能用 <a download> 就用它(最推荐)
大多数人走 fetch + blob,只有一个原因:接口要带 Authorization 头,而 <a href> 带不了自定义头。
那就别让下载接口依赖请求头。常见做法是先用带鉴权的接口换一个短时效的下载地址,再把这个地址交给浏览器:
js
async function download(fileId) {
  // 1. 带 token 请求一个一次性的下载地址,服务端返回形如 /dl/xxxx?exp=...&sig=...
  const res = await fetch(`/api/files/${fileId}/download-url`, {
    headers: { Authorization: `Bearer ${token}` },
  });
  const { url } = await res.json();

  // 2. 交给浏览器自己下,下载栏立刻出现,自带进度、暂停和恢复
  const a = document.createElement('a');
  a.href = url;
  a.rel = 'noopener';
  document.body.appendChild(a);
  a.click();
  a.remove();
}
服务端这一侧,给地址签个名、设个很短的有效期就行。下面用 Node 写个示意版,不依赖任何框架:
js
// server.js  ------ node server.js,然后访问 http://127.0.0.1:3000/api/sign?name=big.bin
const http = require('http');
const fs = require('fs');
const crypto = require('crypto');
const path = require('path');

const SECRET = crypto.randomBytes(32);
const DIR = path.join(__dirname, 'files');

function sign(name, exp) {
  return crypto.createHmac('sha256', SECRET).update(`${name}:${exp}`).digest('hex');
}

http.createServer((req, res) => {
  const u = new URL(req.url, 'http://x');

  if (u.pathname === '/api/sign') {
    // 真实项目里这里要先校验登录态
    const name = path.basename(u.searchParams.get('name') || '');
    const exp = Date.now() + 60_000;
    const url = `/dl/${encodeURIComponent(name)}?exp=${exp}&sig=${sign(name, exp)}`;
    res.setHeader('Content-Type', 'application/json');
    return res.end(JSON.stringify({ url }));
  }

  if (u.pathname.startsWith('/dl/')) {
    const name = path.basename(decodeURIComponent(u.pathname.slice(4)));
    const exp = Number(u.searchParams.get('exp'));
    const sig = u.searchParams.get('sig') || '';
    const expect = sign(name, exp);
    const ok = exp > Date.now() && sig.length === expect.length &&
      crypto.timingSafeEqual(Buffer.from(sig), Buffer.from(expect));
    if (!ok) { res.statusCode = 403; return res.end('expired'); }

    const file = path.join(DIR, name);
    const stat = fs.statSync(file);
    res.setHeader('Content-Length', stat.size);
    res.setHeader('Content-Type', 'application/octet-stream');
    res.setHeader('Content-Disposition',
      `attachment; filename*=UTF-8''${encodeURIComponent(name)}`);
    res.setHeader('Accept-Ranges', 'bytes');   // 想支持断点续传还要处理 Range,这里省略
    return fs.createReadStream(file).pipe(res);
  }

  res.statusCode = 404;
  res.end();
}).listen(3000);
几个容易漏的点:
Content-Disposition里的中文文件名要用filename*=UTF-8''这种写法,直接塞中文会在部分浏览器里乱码。Content-Length一定要给,不给的话浏览器下载栏显示不出总大小和剩余时间。- 想让浏览器的「恢复」按钮真正生效,服务端要支持
Range请求。只写Accept-Ranges不处理 Range 是骗人的。 - 签名地址的有效期设短一点,它等于一张临时门票,被转发出去在有效期内谁都能下。
如果是同域、靠 Cookie 做鉴权的系统,连签名都不用,<a href="/api/files/1/raw" download> 直接就能带上 Cookie。
写法二:File System Access API,边下边写进磁盘
有些场景确实绕不开 JS:比如文件要在前端解密、要拼接多段、要一边下一边转格式。这时候 Chromium 系浏览器有一条正路:showSaveFilePicker。
js
async function streamToDisk(url, suggestedName, onProgress) {
  // 必须在用户点击的回调里同步调用,否则会被拒
  const handle = await window.showSaveFilePicker({ suggestedName });
  const writable = await handle.createWritable();

  const controller = new AbortController();
  const res = await fetch(url, {
    headers: { Authorization: `Bearer ${token}` },
    signal: controller.signal,
  });
  if (!res.ok) throw new Error(`HTTP ${res.status}`);

  const total = Number(res.headers.get('Content-Length')) || 0;
  let loaded = 0;

  const progress = new TransformStream({
    transform(chunk, ctrl) {
      loaded += chunk.byteLength;
      onProgress?.(loaded, total);
      ctrl.enqueue(chunk);
    },
  });

  // pipeTo 结束时会自动 close writable;出错时会 abort,磁盘上不会留下半截文件
  await res.body.pipeThrough(progress).pipeTo(writable);
  return controller;
}

button.addEventListener('click', () => {
  streamToDisk('/api/export/big', '导出数据.csv', (l, t) => {
    bar.style.width = t ? `${(l / t) * 100}%` : '';
    label.textContent = `${(l / 1048576).toFixed(1)} MB`;
  }).catch(err => {
    if (err.name !== 'AbortError') alert('下载失败:' + err.message);
  });
});
优点很明显:保存框先弹,用户选好位置后数据边到边写,内存占用基本恒定,进度条是真的。
局限也很明显:
- 只有 Chromium 系有 。Firefox 和 Safari 至今没实现
showSaveFilePicker,得准备降级。 - 必须在用户手势里调用。你要是先
await fetch再弹框,会直接报SecurityError。 - 跨域的
Content-Length默认读不到,要服务端在Access-Control-Expose-Headers里暴露出来,否则进度条只能显示已下载量,没有百分比。
写法三:Service Worker 伪造一个流式响应
这是 StreamSaver.js 那一派的原理:页面里拿到数据流,通过 postMessage 交给 Service Worker,Service Worker 拦截一个假的下载地址,返回一个 new Response(stream, { headers: { 'Content-Disposition': 'attachment' } }),浏览器就会当成真实下载来处理,下载栏立刻出现。
核心就是 Service Worker 里这几行:
js
// sw.js
const pending = new Map();

self.addEventListener('message', e => {
  const { id, filename, port } = e.data;
  const stream = new ReadableStream({
    start(ctrl) {
      port.onmessage = ({ data }) => {
        if (data === 'end') return ctrl.close();
        ctrl.enqueue(new Uint8Array(data));
      };
    },
  });
  pending.set(id, { stream, filename });
});

self.addEventListener('fetch', e => {
  const m = new URL(e.request.url).pathname.match(/^\/__dl__\/(.+)$/);
  if (!m || !pending.has(m[1])) return;
  const { stream, filename } = pending.get(m[1]);
  pending.delete(m[1]);
  e.respondWith(new Response(stream, {
    headers: {
      'Content-Type': 'application/octet-stream',
      'Content-Disposition': `attachment; filename*=UTF-8''${encodeURIComponent(filename)}`,
    },
  }));
});
页面侧把 fetch 回来的流一块块转发过去:
js
async function swDownload(url, filename) {
  const id = crypto.randomUUID();
  const { port1, port2 } = new MessageChannel();
  navigator.serviceWorker.controller.postMessage({ id, filename, port: port2 }, [port2]);

  const iframe = document.createElement('iframe');
  iframe.hidden = true;
  iframe.src = `/__dl__/${id}`;          // 触发 Service Worker 的 fetch
  document.body.appendChild(iframe);

  const res = await fetch(url, { headers: { Authorization: `Bearer ${token}` } });
  const reader = res.body.getReader();
  for (;;) {
    const { done, value } = await reader.read();
    if (done) break;
    port1.postMessage(value.buffer, [value.buffer]);   // 转移所有权,不复制
  }
  port1.postMessage('end');
  setTimeout(() => iframe.remove(), 1000);
}
它的好处是 Firefox 也能用。但我自己不太推荐在新项目里用:
- 要求页面已经被 Service Worker 控制,首次访问、强刷之后
controller是 null。 - Service Worker 空闲会被浏览器回收,超长时间的下载中途可能断掉,需要额外做心跳。
- 这里没做背压,网络比磁盘快的时候消息会在 Service Worker 里堆积。要做严谨得自己加 ack。
- 调试起来很痛苦,出了问题往往是「下载栏里显示失败」,没有任何报错信息。
能走写法一的,就别上这套。
三种写法怎么选
| 场景 | 选哪个 |
|---|---|
| 文件在服务端现成,只是要鉴权 | 写法一:签名地址 + <a download> |
| 前端要对数据做处理(解密、拼接、转码),用户多是 Chrome/Edge | 写法二:showSaveFilePicker |
| 同上,但必须兼容 Firefox | 写法三,或者老老实实限制文件大小 |
| 文件几 MB 以内 | 原来的 fetch + blob 就够了,别过度设计 |
最后一行是真心话。上面那段「有问题」的代码,在 90% 的业务里都没问题,它只在「文件大 + 网络慢」同时出现的时候才露馅。我自己在 forxi.cn 上做 PDF、图片这些文件工具时,大部分结果文件也就几 MB,直接 blob 下载完全够用,只有少数导出场景才值得换成上面的写法。
顺手说两个排查技巧
一是在 DevTools 的 Network 面板里把网速限到 Slow 4G 再点下载,问题一眼就能复现,比在本地回环上干等强得多。
二是看 performance.memory.usedJSHeapSize(只有 Chromium 有)。如果你发现下载过程中它涨了几百兆,基本就是某处用了 arrayBuffer() 或者把 chunk 攒进了数组,这比 blob() 危险得多。
局限说在前面
这篇的测量是本机回环、单次运行,只能说明量级,不是严谨的基准测试。Blob 什么时候落盘、落多少,各浏览器版本的策略不一样,我只在 Chrome 153 上看过。写法三的背压和 Service Worker 保活我没在生产环境验证过,示意代码拿去用之前请自己补上。