前言:本篇是 C++ 类与对象之后非常核心的底层内容,很多考研 408、C++ 面试都会高频考察,结合汇编、内存示意图帮你一次性吃透。 阅读对象:正在学习 C++,准备考研 / 面试,想要理解底层原理的同学
一、函数模板(模板实例化)
1. 什么是函数模板
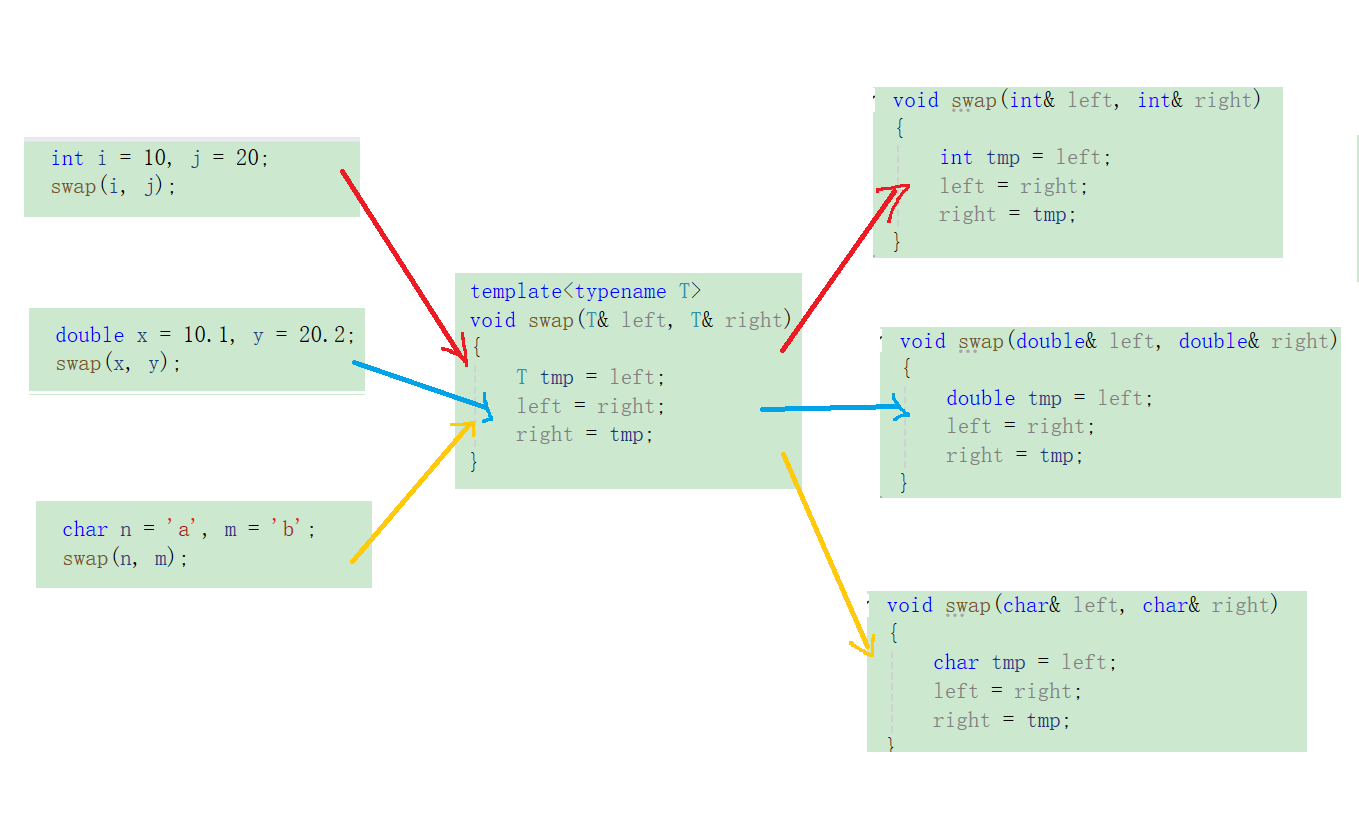
函数模板是通用函数蓝图 ,不是真实函数。编译器根据你调用时传入的类型,自动实例化生成对应类型的函数。
cpp
template<typename T>
void Swap(T& left, T& right)
{
    T tmp = left;
    left = right;
    right = tmp;
}
template<typename T:告诉编译器,T 是一个类型参数,代表任意类型。
2. 模板实例化(重点!结合汇编代码)
cpp
int i = 10, j = 20;
Swap(i, j);   // 推导T=int,编译器生成 Swap<int>版本

double x = 10.1, y = 20.2;
Swap(x, y);   // 推导T=double,编译器生成 Swap<double>版本
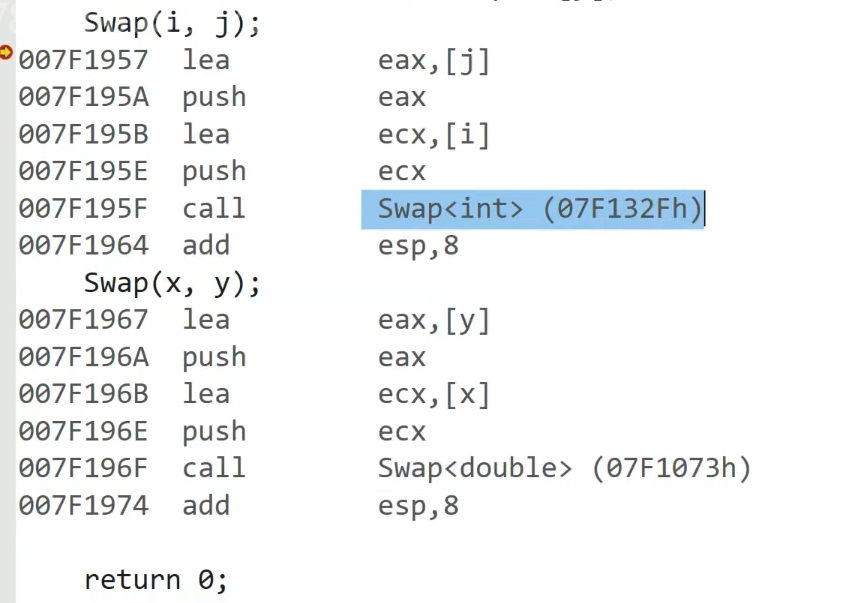
看汇编截图:
✅ 核心结论:
- 模板本身不生成代码;调用不同类型,编译器才会生成多份重载函数,这个过程叫模板实例化。
- 不同类型,实例化出独立函数,地址不同。
- 模板支持类型推导,不用手动写
Swap<int>(i,j),编译器自动识别。
坑点: 问:模板会在编译期生成几份代码? 答:每一种不同的类型,就实例化一份函数 ;相同类型多次调用,只生成一份。
来这里提问一个问题,我可不可以先写一个自己的函数然后再写一个模板,那么编译器优先调用自己写的还是模板呀?
cpp
void swap(int& a,int& b)
{
    int c = a;
    a = b;
    b = c;
}

template<class T>

void swap(T& a,T& b)
{
    T c = a;
    a = b;
    b = c;
}


int main()
{

    int a = 10;
    int b = 20;
    swap(a,b);
    return 0;
}
注意:C++ 重载决议规则:优先匹配非模板的普通函数;只有找不到合适普通函数时,才会去实例化函数模板。
调用
swap(a,b),实参是int&,正好和上面普通函数的形参完全匹配,直接选普通函数,模板不会被实例化
举个例子:你着急去买酱油,一家是楼下的超市,另一家是市里面的大超市,楼下的超市本来就有,直接买上用就好,不会直接去跑上几十公里去市里买,道理是一样的。
二、C/C++ 程序内存分区(对应内存分布图)
内存五大区域
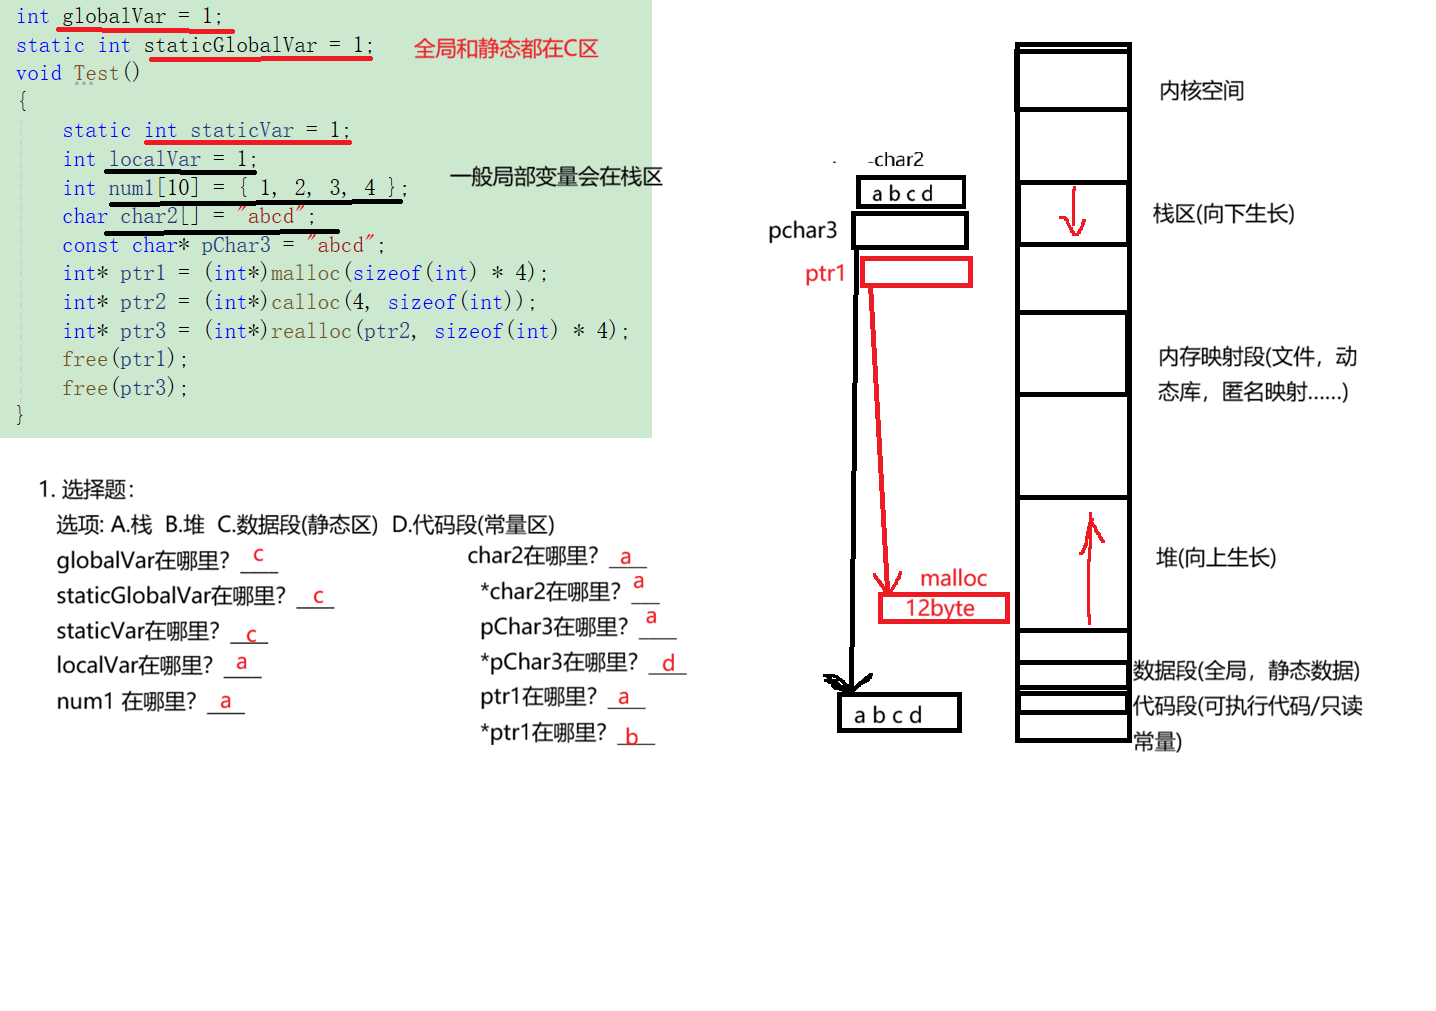
- 栈区(A) :stack 存储:局部变量、函数参数、数组、临时对象。 特点:向下生长,自动申请自动释放,函数出作用域自动销毁。
- 堆区(B) :heap 存储:
malloc / calloc / realloc / new手动开辟的空间。 特点:向上生长,手动申请、手动释放,忘记释放会内存泄漏。- 数据段(静态区 C) 存储:全局变量、static 静态变量(全局静态、局部 static),程序启动就存在,程序结束才销毁。
- 代码段(常量区 D) 存储:可执行代码、只读常量字符串,只读,不能修改。
- 内核空间:操作系统使用,用户代码无法访问。
代码逐行解析
cpp
int globalVar = 1;                // 全局变量 → C 数据段
static int staticGlobalVar = 1;   // 全局静态 → C 数据段
void Test()
{
    static int staticVar = 1;      // 局部static静态变量 → C 数据段,只初始化一次
    int localVar = 1;              // 局部变量 → A 栈区
    int num1[10] = { 1,2,3,4 };    // 局部数组 → A 栈区
    char char2[] = "abcd";         // 数组:栈开辟空间,把常量字符串拷贝进栈 → char2在A栈;
    const char* pChar3 = "abcd";   // pChar3指针变量本身在A栈;"abcd"字符串字面量在D常量区

    int* ptr1 = (int*)malloc(sizeof(int)*4); // ptr1指针变量A栈;*ptr1指向B堆
    int* ptr2 = (int*)calloc(4, sizeof(int));
    int* ptr3 = (int*)realloc(ptr2, sizeof(int)*4);
    free(ptr1);
    free(ptr3);
}
✅ 高频考点区分:char char2[] 和 const char* pChar3
char char2[] = "abcd":在栈上创建数组,把常量区的 abcd 拷贝一份到栈数组,可以修改数组内容。const char* pChar3 = "abcd":指针存栈,字符串在只读常量区,不能修改*pChar3。
三、C++ new 和 delete(底层执行流程)
我们之前的在类的那一部分已经详细学习过了,这里就是简简单单的的复习一遍
1. 单个对象 new /delete
cpp
Date* p1 = new Date;
delete p1;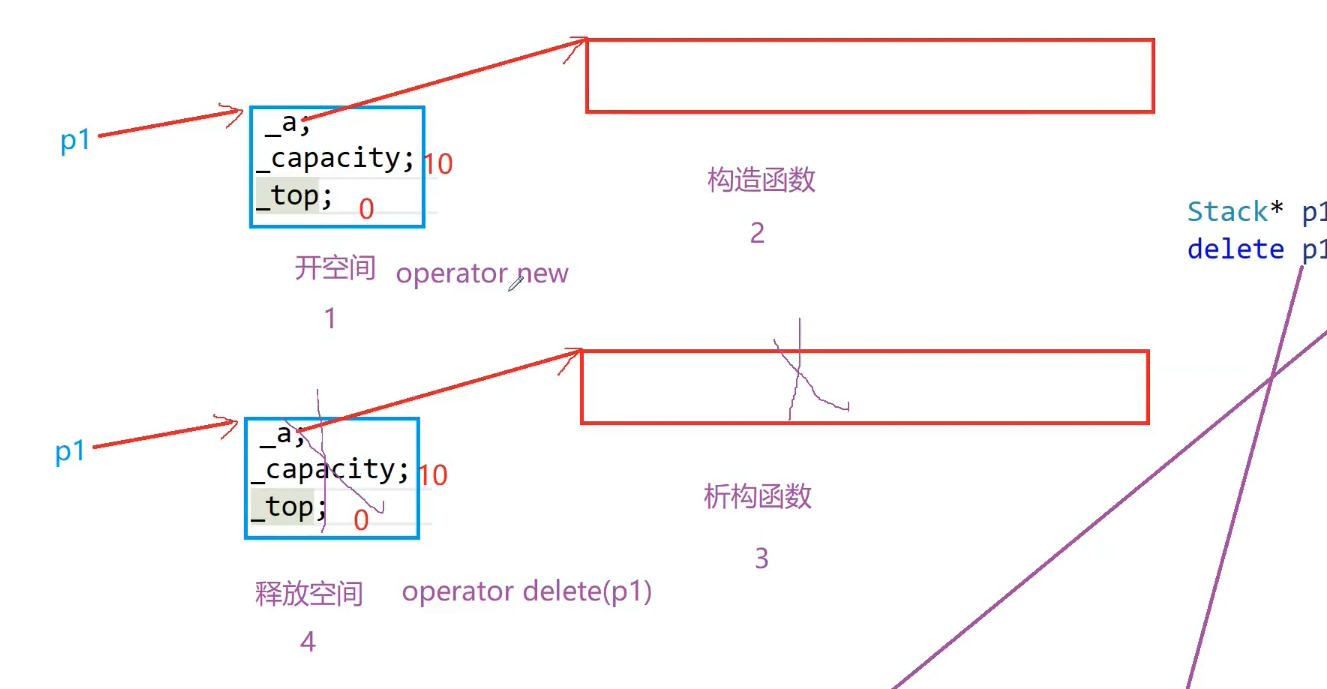
执行顺序:
operator new:底层调用 malloc,在堆上开辟原始内存空间(只开空间,不初始化)- 调用构造函数:在刚才开辟的内存上,初始化成员变量
new = 开堆内存 + 调用构造函数
delete 执行顺序:
- 调用析构函数:清理对象内部资源
operator delete:底层调用 free,释放堆内存
delete = 调用析构函数 + 释放堆空间
对比 C 语言 malloc/free:malloc 只开辟原始内存,不会调用构造、析构!这是 C++ new 最大区别。
2. 数组 new \[\] /delete \[\] 重点(容易踩坑)
Stack* p = new Stack[10];
delete[] p;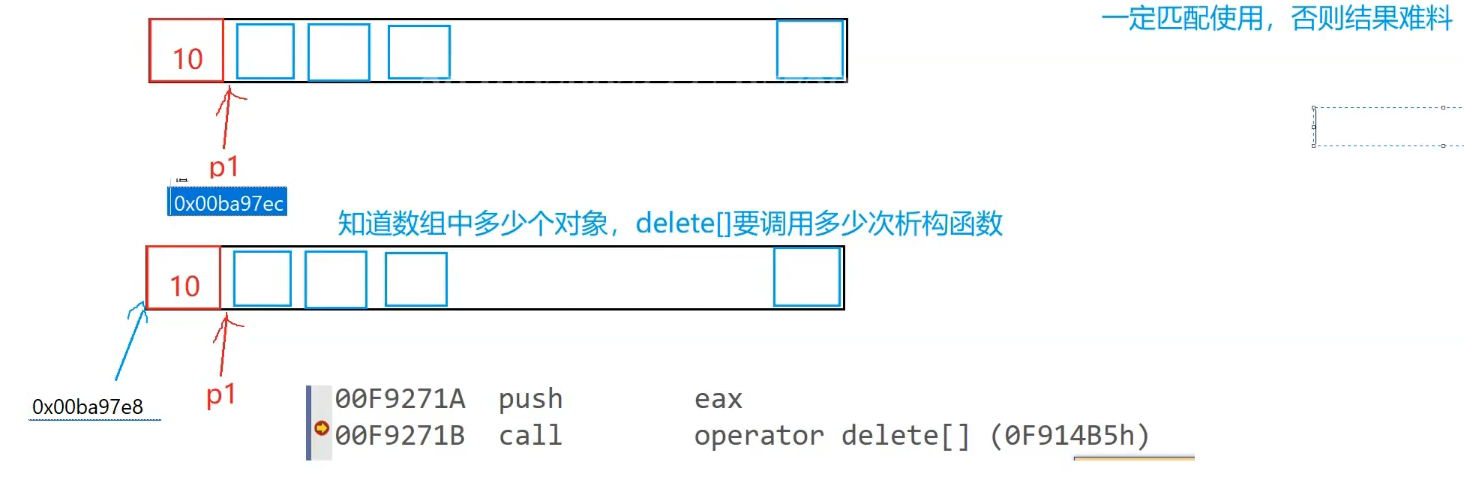
底层机制: new[]开辟空间时,会多开辟一块空间,保存数组对象的个数(图里的数字 10)
- 作用:
delete[]读取这个数字,知道要调用多少次析构函数!
⚠️ 硬性规则:new \[\] 必须搭配 delete \[\],new 单个对象搭配 delete,不能混用。 如果混用,程序行为未定义,大概率崩溃。
示意图解释: p 指针指向第一个对象,但是往前偏移 4/8 字节,存放数组元素计数。delete \[\] 读取这个数字,循环调用 10 次析构,再整体释放整块堆内存。
面试题:为什么 new \[\] 和 delete \[\] 不能和普通 delete 混用? 答:普通 delete 不会读取前面计数,只会调用一次析构,数组多个对象没有全部析构,资源泄漏,释放内存时地址错误,程序崩溃。
四、池化技术:内存池(你的项目核心!复试重点)
1. 为什么要有内存池?
直接频繁调用new/malloc向操作系统申请堆内存,有缺点:
- 系统调用开销大,频繁申请释放速度慢
- 频繁小块内存申请,造成内存碎片,内存利用率下降
池化思想:一次性向操作系统申请一大块连续内存,放到池子里面。 后续程序需要小块内存,直接从池子里面拿,不频繁向操作系统申请;释放的时候归还到池子,而不是直接还给操作系统。
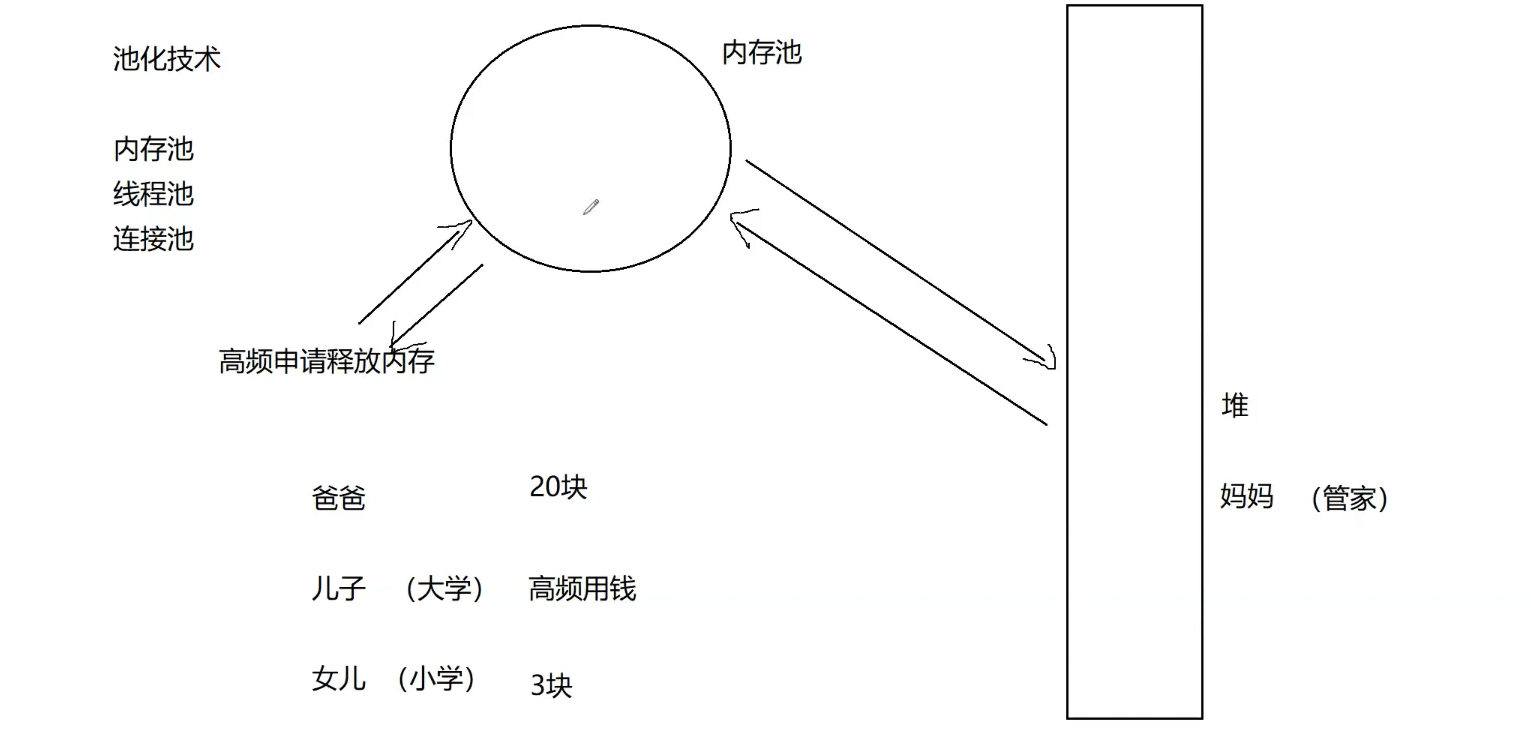
通俗比喻:
妈妈 = 操作系统,取钱就是 malloc。 儿子频繁用钱(高频申请内存),每次都找妈妈取钱很麻烦。 爸爸一次性向妈妈拿 20 块钱,交给儿子,儿子用钱直接从这 20 块里面拿,用完放回,不用反复找妈妈。这就是内存池。
同类池化技术:
- 内存池:管理内存分配释放
- 线程池:预先创建一批线程,复用线程,避免频繁创建销毁线程
- 连接池:数据库连接复用
2. 内存池优缺点
✅ 优点:
- 减少系统调用,分配内存速度更快
- 减少内存碎片,提升内存利用率
❌ 缺点:
1.一次性预先开辟大块内存,程序启动就占用内存,哪怕暂时不用。
全文知识点汇总:
- 函数模板 模板是蓝图,编译期根据调用类型,实例化生成对应类型函数 ;不同类型生成不同函数。汇编可以看到实例化后的函数符号
Swap<int> Swap<double>。 - 内存分区
- 栈:局部变量,自动销毁,向下生长
- 堆:new/malloc 手动开辟,手动释放
- 静态区:全局、static 变量,程序全程存在
- 常量区:字符串字面量,只读
- new/delete new = operator new(malloc 开空间) + 构造函数 delete = 析构函数 + operator delete(free 释放) new \[\] 会额外保存对象数量,用来 delete \[\] 调用多次析构;new \[\] 和 delete \[\] 必须配对。
- 内存池(池化技术) 一次性向 OS 申请大块内存,程序从池子取小块内存,减少系统调用,减少内存碎片;适合高频申请释放内存场景。同类:线程池、连接池