CLM-8B:用对比学习替代 Agent 中大量生成式决策
发布时间(北京时间) :2026 年 9 月 24 日 14:54
机构 :Stanford 等
状态 :开源模型 + 代码 + 技术博客,当前不是同行评审论文
时间说明 :按研究者集中发布公告时间 2026-09-24 06:54 UTC 换算。
核心进展
Stanford 团队提出 Contrastive Language Model(CLM),核心思路是:
不要让大模型每一步都"生成"动作,而是直接在候选动作里做匹配和选择。
传统 Agent:
state → LLM → 生成 "call_search_tool"
CLM:
state embedding ↔ candidate action embeddings → 相似度打分 → 选择动作
CLM-8B 基于冻结的 Qwen3-8B encoder ,只训练两个约 20M 参数 的 projection head,分别编码 state 和 action,并使用双向 InfoNCE contrastive loss 训练。
训练数据约包括:
- 6000 万条 Nemotron Q&A;
- 3000 万 synthetic hard negatives;
- 100 万条 agent trajectories。
为什么重要
CLM 最关键的优势是:action embedding 可以提前缓存。
例如一个 Agent 有固定的 100 个工具,就不需要每一步都让大模型重新阅读全部工具描述并生成工具名,只需要:
编码当前 state → 与缓存好的 action vectors 做 dot product
团队报告,在部分 tool-calling、computer-use 和 gaming 任务中,CLM-8B 相比 Jev 可实现最高约 9× 更低 latency ;候选动作约 1000 个时,最高约 13× 加速。
这些结果来自作者实验,应等待更多独立复现。
技术意义
这代表一种新的 Agent 分层推理方式:
大型 reasoning model → 负责规划 / 产生候选
小型 contrastive model → 负责 select / rank / verify
也就是把昂贵的"生成式推理"和廉价的"动作选择"拆开。
未来 Agent 不一定每一步都调用一个大模型,而可能是:
少量高成本 reasoning + 大量低成本 decision
与此前工作的关系
CLM 与 TypeSafe 的 Jev 都属于近期的 System One decision model 路线。
CLM 更进一步把 state 和 action 解耦成可独立缓存的表示,并把训练明确建立在 contrastive learning 上。
它的边界也很清楚:
CLM 不会生成新方案,只能从已有候选中选择。
因此它更适合作为 reasoning model 的补充,而不是替代通用 LLM。
CLM 工作流程
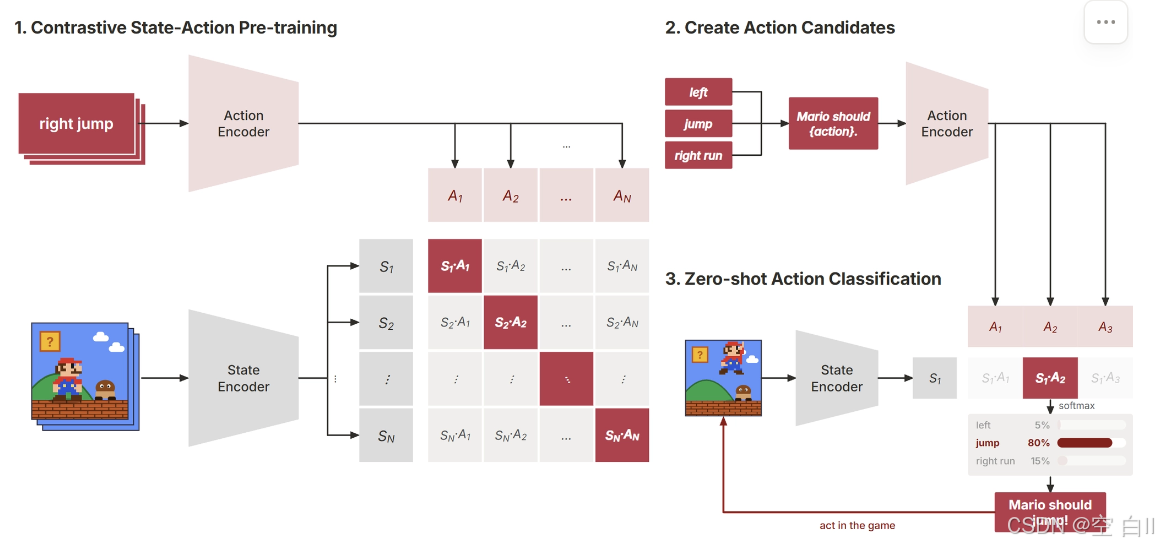
CLM 的工作流程是:把 Agent 的"下一步做什么"从生成问题,改造成状态---动作匹配问题。
整体可以分成三步。
第一步是 Contrastive State-Action Pre-training。
CLM 分别用 State Encoder 和 Action Encoder,把当前状态 S S S 和候选动作 A A A 编码到同一个向量空间里。训练时,正确的 state-action pair 被拉近,错误组合被推远:
当前状态 S i S_i Si 应该和正确动作 A i A_i Ai 相似,而和其他动作不相似。
所以模型最终学到的是一个打分函数:
s c o r e ( S , A ) = s i m ( E s ( S ) , E a ( A ) ) score(S,A)=sim(E_s(S),E_a(A)) score(S,A)=sim(Es(S),Ea(A))
本质上不是"生成动作",而是学习"这个状态和这个动作匹不匹配"。
第二步是 Create Action Candidates
系统先明确当前有哪些可选动作,例如图里的:
left / jump / right run
这些动作通过模板改写成自然语言候选,例如:
Mario should jump.
然后统一经过 Action Encoder 得到 action embeddings。
这里有一个非常重要的工程优势:如果动作集合固定,这些 action embeddings 可以提前算好并缓存,不需要每一步都重新编码。
第三步是 Zero-shot Action Classification
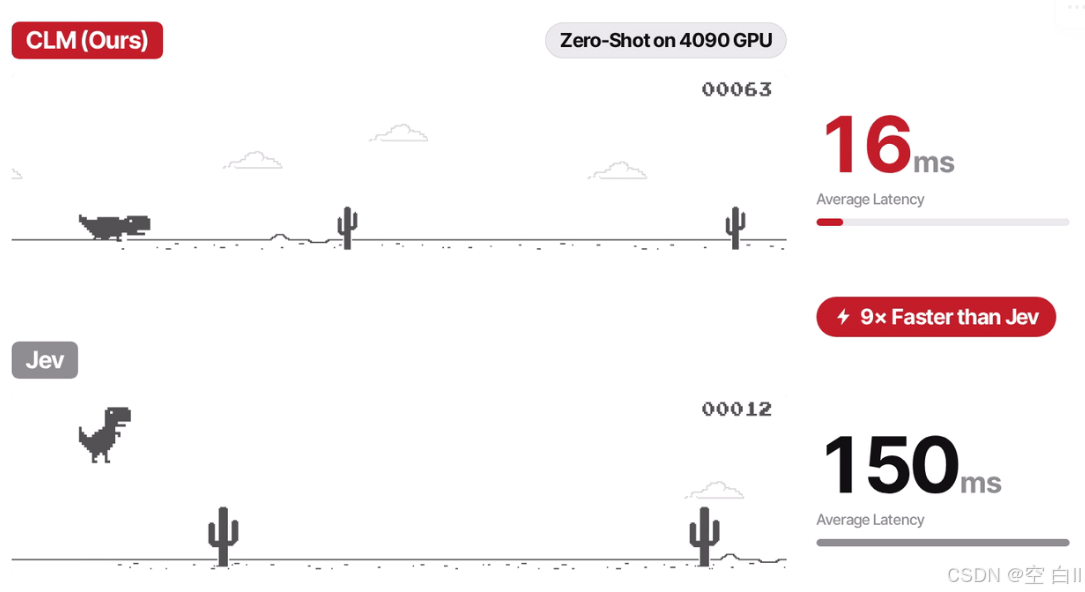
运行时只需要把当前游戏画面编码成 state embedding,然后分别和所有候选 action embedding 计算相似度:
S ↔ A 1 , A 2 , A 3 , ... S \leftrightarrow A_1,A_2,A_3,\dots S↔A1,A2,A3,...
经过 softmax 后得到每个动作的概率,例如:
- left:5%
- jump:80%
- right run:15%
于是系统直接选择 jump
所以整个 workflow 可以压缩成:
状态编码 → 候选动作编码 → 向量相似度打分 → 选择最高分动作 → 执行
相比传统 LLM Agent:
state → LLM autoregressive decoding → 生成动作文本
CLM 变成:
state embedding × cached action embeddings → similarity → select
这就是它最大的思想变化。
更抽象地看,CLM 把 Agent 决策拆成两类问题:
生成式模型负责"想出有哪些可能动作",
对比模型负责"从这些动作里选哪个"。
所以它特别适合 tool selection、UI action selection、游戏动作、verifier/ranker 这类"候选集合已知"的任务。
一句话总结:
CLM的核心是用对比学习把Agent的动作决策转化为state-action retrieval/classification:先把状态和动作映射到同一表示空间,再通过相似度快速选择最合适的动作,从而替代大量昂贵的生成式推理。
动作向量缓存:Action Embedding Cache
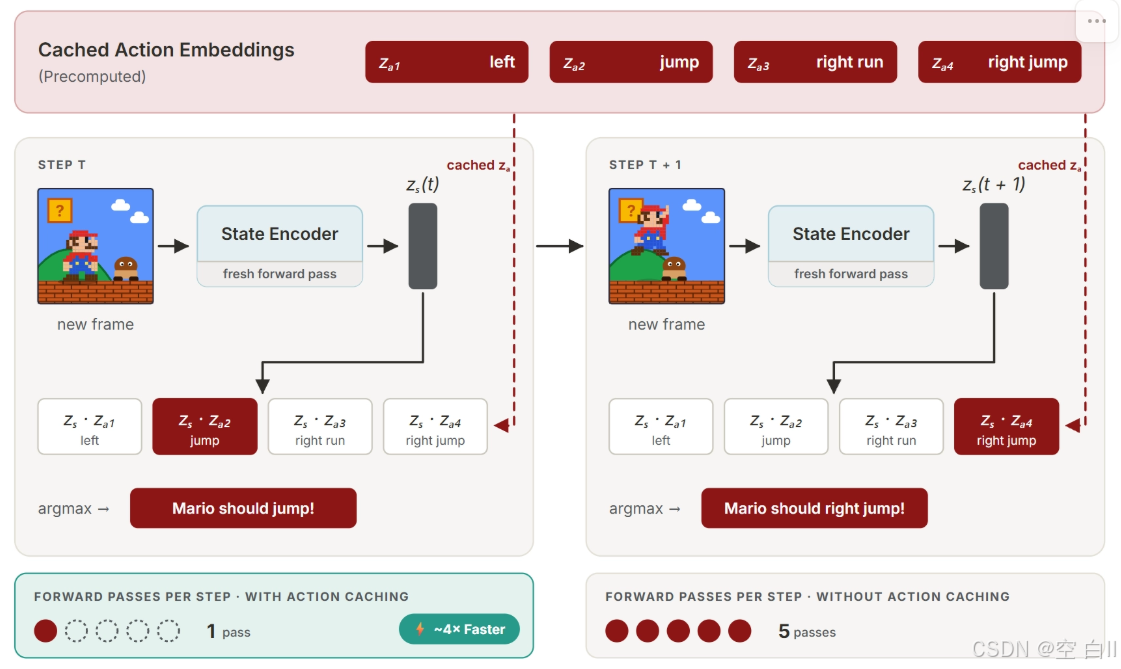
这张图讲的是 CLM 最核心的工程机制:Action Embedding Cache(动作向量缓存)。它建立在 CLM 的双编码器(bi-encoder / two-tower)结构上。
核心思想是:
动作通常不变,状态每一步都在变。既然动作的 embedding 与当前状态无关,就提前算一次并缓存;运行时只重新编码当前状态。
具体来看。
第一步,系统预先把所有候选动作编码成向量:
z a i = E a ( a i ) z_{a_i}=E_a(a_i) zai=Ea(ai)
例如图里的:
- left → z a 1 z_{a1} za1
- jump → z a 2 z_{a2} za2
- right run → z a 3 z_{a3} za3
- right jump → z a 4 z_{a4} za4
这些action embedding一旦算好,就存进cache。只要动作定义没有变化,后续每一个时间步都可以重复使用,不需要重新经过Action Encoder。
第二步,运行时只对新状态做一次前向传播。比如在时间 t t t,Mario 看到一个新的画面:
z s ( t ) = E s ( s t ) z_s(t)=E_s(s_t) zs(t)=Es(st)
因为环境发生了变化,所以 state embedding 不能缓存,必须每一步重新计算。
接下来 CLM 直接计算当前状态与所有缓存动作的相似度:
s c o r e i = z s ( t ) ⊤ z a i score_i=z_s(t)^\top z_{a_i} scorei=zs(t)⊤zai
即:
z s ⋅ z a 1 , z s ⋅ z a 2 , z s ⋅ z a 3 , z s ⋅ z a 4 z_s\cdot z_{a1},\quad z_s\cdot z_{a2},\quad z_s\cdot z_{a3},\quad z_s\cdot z_{a4} zs⋅za1,zs⋅za2,zs⋅za3,zs⋅za4
取分数最高的动作:
a ∗ = arg max i z s ⊤ z a i a^*=\arg\max_i z_s^\top z_{a_i} a∗=argimaxzs⊤zai
图中 Step T 的结果是 jump。
Mario 跳起来以后,到了 t + 1 t+1 t+1,画面变化了。系统只重新算:
z s ( t + 1 ) = E s ( s t + 1 ) z_s(t+1)=E_s(s_{t+1}) zs(t+1)=Es(st+1)
然后再次与同一批缓存的 action embeddings 比较,这次可能得到:
right jump
所以整个在线循环实际上非常简单:
New State → State Encoder → 与 Cached Actions 做 Dot Product → Argmax → Execute → New State
最重要的机制其实是 State--Action 解耦。
CLM 学的是:
f ( s , a ) = E s ( s ) ⊤ E a ( a ) f(s,a)=E_s(s)^\top E_a(a) f(s,a)=Es(s)⊤Ea(a)
注意这里 State Encoder 和 Action Encoder 是分开的。
正因为:
E a ( a ) E_a(a) Ea(a)
不依赖当前的 s s s,它才能提前计算。
如果模型采用的是这种结构:
f ( s , a ) = T r a n s f o r m e r ( s ; a ) f(s,a)=Transformer(s;a) f(s,a)=Transformer(s;a)
也就是把 state 和 action 拼起来一起送进模型,那么每换一个 action 都必须重新做一次 forward:
text
(state, left)       → forward
(state, jump)       → forward
(state, right run)  → forward
(state, right jump) → forward
就无法有效缓存动作。
CLM 的 bi-encoder 则变成:
text
Offline:
left       → Action Encoder → za1 ┐
jump       → Action Encoder → za2 │
right run  → Action Encoder → za3 ├─ Cache
right jump → Action Encoder → za4 ┘

Online:
state → State Encoder → zs

zs × [za1, za2, za3, za4]
          ↓
       argmax
          ↓
        action
这就是这张图真正想强调的结构优势。
图最下面的 1 pass vs 5 passes 也来自这个机制。
如果有 4 个动作,没有缓存时,一个时间步可能需要:
- 1 次 State Encoder
- 4 次 Action Encoder
总共约:
1 + 4 = 5 1+4=5 1+4=5
次 encoder forward
有缓存以后,四个动作都已经提前编码,只剩:
1 1 1
次 State Encoder forward。
之后的四个 dot product 是非常便宜的向量运算,因此图里称为大约 4× faster。
当候选动作数量变成 100、1000 甚至更多时,这个思路的价值会更明显。其计算可以粗略写成:
没有 cache:
C state + N C action + O ( N d ) C_{\text{state}}+N C_{\text{action}}+O(Nd) Cstate+NCaction+O(Nd)
有 cache:
C state + O ( N d ) C_{\text{state}}+O(Nd) Cstate+O(Nd)
其中 N N N 是候选动作数量, d d d 是 embedding 维度。真正昂贵的 Transformer forward 从随 N N N 增长,变成基本固定的一次。
因此,这张图实际上体现了三个机理:
Dual Encoder / Representation Decoupling
State和Action独立编码到同一embedding space。Action Embedding Caching
静态动作提前编码,运行过程中反复复用。Similarity-based Decision
决策不依赖autoregressive generation,而是通过dot product / similarity + argmax完成。
可以把 CLM 的整个 inference 思路概括为:
把
Agent的在线决策从"每一步重新理解并生成一个动作",转化成"只编码变化的状态,再从预计算的动作向量库里检索最匹配的动作"。
这也是 CLM 能做低延迟 Agent 的关键:它优化的不只是模型大小,而是把计算从重复的 Transformer forward 转化成一次编码 + 大量廉价向量匹配。
当然这个机制有一个明确前提:候选动作需要相对稳定且可以预先定义。 如果每一步都会动态产生全新的工具或参数化动作,新动作仍然需要先经过 Action Encoder,缓存的收益就会下降。
CLM 三阶段训练路线
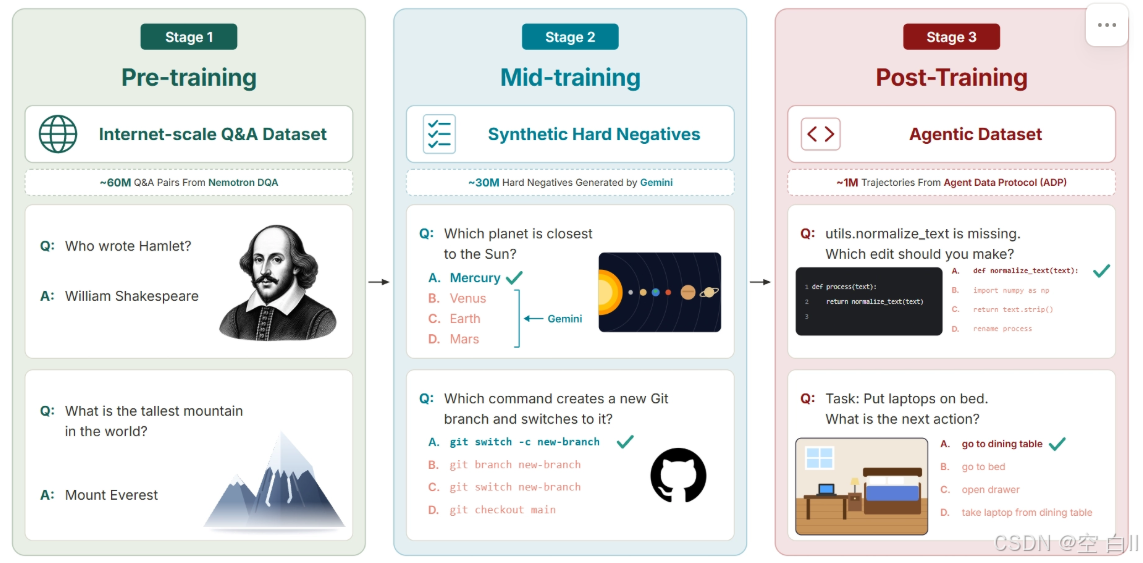
这张图讲的是 CLM 的三阶段训练路线,本质上是把模型从"学会一般语义匹配",逐步训练成"能区分相似动作",最后适配真实 Agent 决策。
第一阶段:Pre-training
用约 6000 万条互联网级 Q&A 数据做基础训练。
核心作用是:
先让模型学会"什么样的输入和答案在语义上是匹配的"。
也就是建立一个通用的 state/action 或 query/answer 表示空间。这个阶段主要学广泛语义,不强调 Agent 场景。
第二阶段:Mid-training
加入约 3000 万条 synthetic hard negatives。
所谓 hard negative,就是"看起来很像正确答案,但其实不对"的候选。比如:
- Mercury 是正确答案
- Venus / Earth / Mars 都是合理但错误的候选
这一步的核心机制是:
不只是把正样本拉近,还要学会把"很像但错误"的候选推远。
它主要提升 CLM 的决策边界,让模型在多个相似 action 中做更精细的区分。
第三阶段:Post-training
再用约 100 万条 Agent trajectory 做后训练。
这里数据不再是普通问答,而是真实 Agent 场景,例如:
- 代码编辑下一步做什么
- GUI / embodied task 下一步执行哪个动作
- 工具调用时该选哪个 action
这一阶段的目标是:
把通用的 contrastive matching 能力,适配到实际 Agent 的 action selection / verification 上。
所以整个训练逻辑可以概括成:
通用语义对齐 → 难负样本强化区分能力 → Agent 轨迹适配真实决策
三个阶段分别解决三个问题:
- Pre-training:"什么是相关的?"
- Mid-training:"几个很像的候选里,哪个才是真的对?"
- Post-training:"在真实 Agent 环境里,下一步到底该做什么?"
总结下来就是:
CLM 先用大规模 Q&A 学语义空间,再用 hard negatives 学判别边界,最后用 Agent trajectories 把这种判别能力转化成实际的动作选择能力。