这篇学习笔记,想记的不是"ArkTS 可以调一下 C++"这么一句话,而是我这次把 Native 模块真正接进 HarmonyOS 工程以后,关于桥接层、参数传递、CMake 构建和调用收口这一整套过程,重新走了一遍。
一、我一开始以为,这只是一个"导个 so"的小事
最早接这个练习题时,我脑子里的模型其实很简单:
- C++ 里写一个方法;
- 编译出 so;
- ArkTS 导入一下;
- 页面按钮点一下;
- 成功拿到结果。
看起来是个非常直线型的流程。
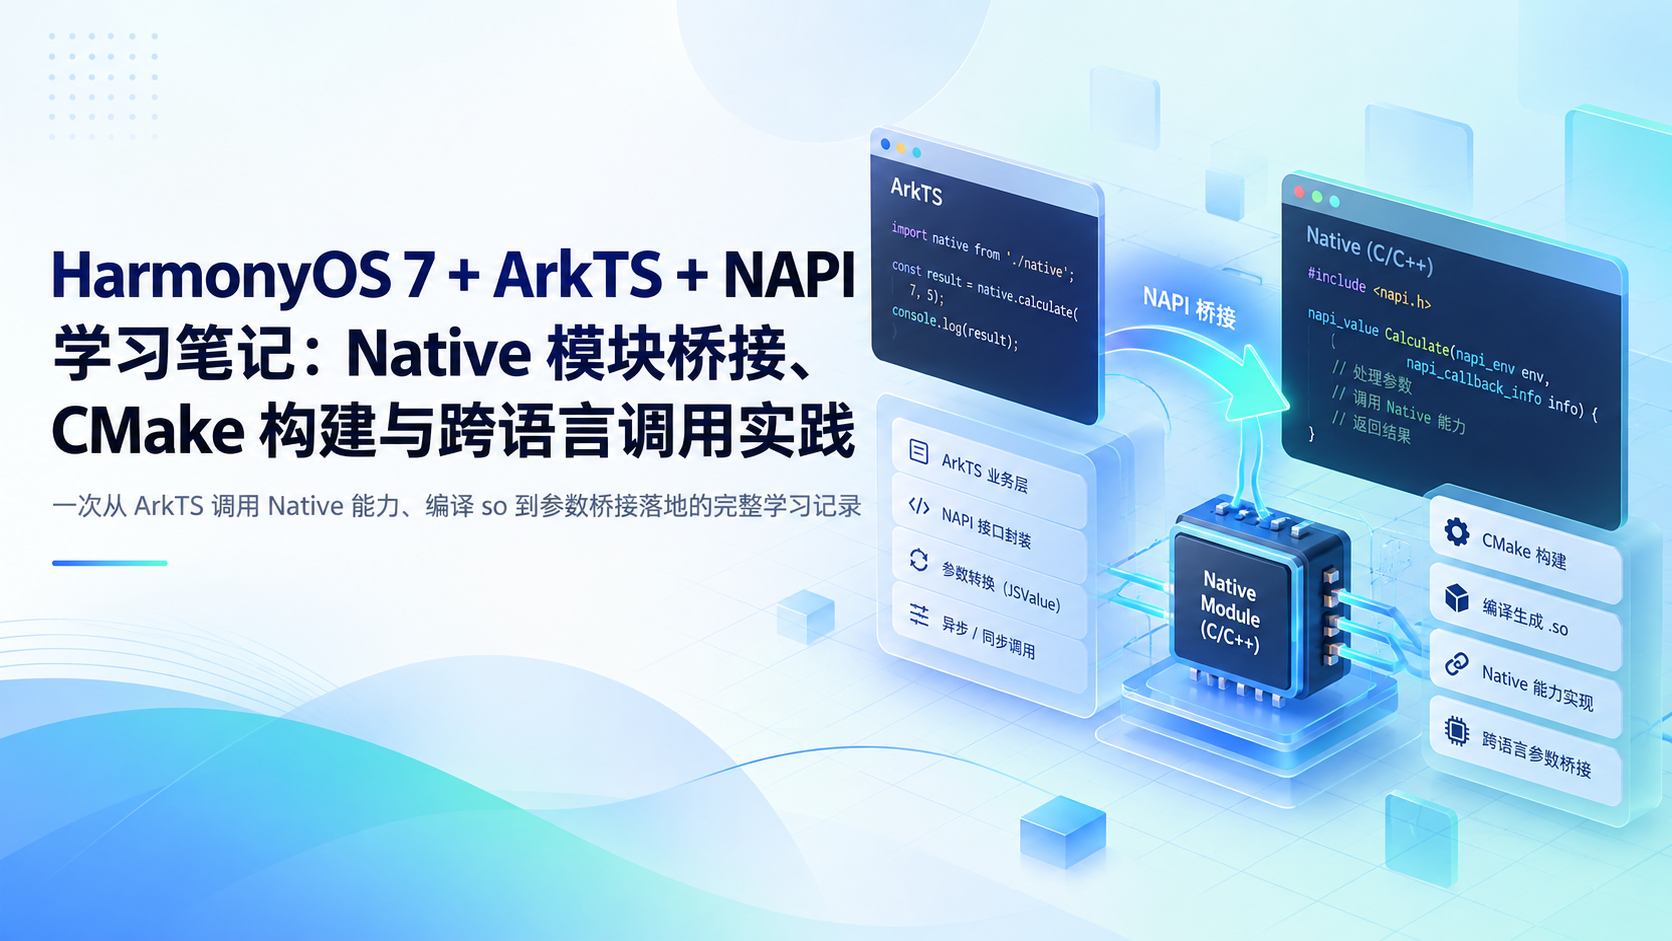
但真正做起来以后,我很快发现,Native 接入和普通业务开发不是一回事。它难的地方,不是某一个 API,而是它横跨了几层:
- ArkTS 业务层 要知道怎么发起调用;
- NAPI 封装层 要把参数从 JSValue 转成 Native 能理解的类型;
- C++ 实现层 要真正处理逻辑;
- 构建层 要保证 CMake、头文件、动态库导出和编译链接都能跑通;
- 回传层 还要把结果再完整送回 ArkTS。
也就是说,这类问题根本不是"能不能调起来",而是:这几层桥到底有没有搭稳。
我后来回头看,这也是为什么很多人第一次碰 NAPI,会觉得"明明只想调个 Native,最后却像在处理一条工程链"。
二、我先把需求缩到最小,只做两个最能说明问题的调用
做这类学习项目,我一般不喜欢一上来就接一大堆复杂能力。因为一旦 Native 还没跑通,就急着上文件读写、图像处理、系统信息、加密能力,出问题时根本不知道卡在哪一层。
所以这次我先给自己定了两个极小目标:
- 调用 Native 做一次整数加法;
- 调用 Native 读取一段设备基础信息。
为什么选这两个?
因为它们刚好能覆盖最核心的两条链:
- 一条是"传两个 number 进去,拿一个结果出来";
- 一条是"触发 Native 逻辑,返回一段字符串信息"。
如果这两条链能跑顺,后面再做更复杂的 Native 模块,思路就清楚很多了。
三、ArkTS 这边的关键,不是 import,而是把调用状态收拢
很多人第一次看 NAPI 示例,最容易注意到的是这一句:
arkts
import native from 'libnative.so'但真到工程里,import 只是开头。真正有价值的,是你怎么把调用状态组织起来。
我这次没有把 Native 调用写成零散按钮事件,而是先把页面状态定义清楚,比如:
- 加法结果;
- 设备信息;
- 调用日志;
- 模块是否已加载;
- 当前调用有没有失败。
最基础的一版调用代码,我最后是这么收的:
arkts
import native from 'libnative.so'
import { BusinessError } from '@kit.BasicServicesKit'

@State addResult: string = ''
@State deviceInfo: string = ''

async onAdd() {
  try {
    let result: number = await native.add(12, 30)
    this.addResult = `计算结果:${result}`
    console.info(`native add(12, 30) = ${result}`)
  } catch (error) {
    let e = error as BusinessError
    this.addResult = `调用失败:${e.message}`
    console.error(`native add error: ${e.message}`)
  }
}

async onGetDeviceInfo() {
  try {
    let info: string = await native.getDeviceInfo()
    this.deviceInfo = info
  } catch (error) {
    let e = error as BusinessError
    this.deviceInfo = `调用失败:${e.message}`
  }
}
这段代码不复杂,但它把我这次最想确认的事情都放到了明面上:
- ArkTS 到底能不能调起 Native;
- number 类型能不能顺利传下去;
- string 类型能不能顺利回上来;
- 异常是不是能回到业务层被看到。
真正把调用这样拆开以后,我对这件事的理解就比"引一个 so"清晰多了:ArkTS 不是在直接运行 C++,而是在消费一层桥接后的能力。
四、Native 层最核心的工作,不是业务逻辑,而是参数翻译
到了 C++ 这一层,我一开始也有点误判。
最早我总觉得,Native 难点应该在算法或者底层实现。结果真正开始写以后,我反而越来越觉得,最关键的不是"算得多复杂",而是参数能不能正确进出。
因为 NAPI 的现实工作,很多时候其实就是在做"翻译":
- JSValue 转 number;
- JSValue 转 string;
- C++ int / string 再转回 JS 层可识别的数据。
所以我先做了一个最基础的桥接函数:
cpp
#include <napi/native_api.h>

static napi_value Add(napi_env env, napi_callback_info info) {
    size_t argc = 2;
    napi_value args[2] = { nullptr };
    napi_get_cb_info(env, info, &argc, args, nullptr, nullptr);

    int32_t a = 0;
    int32_t b = 0;
    napi_get_value_int32(env, args[0], &a);
    napi_get_value_int32(env, args[1], &b);

    napi_value result;
    napi_create_int32(env, a + b, &result);
    return result;
}
这段代码看起来非常朴素,但它把桥接的本质暴露得很彻底:
- 从回调里拿参数;
- 把参数从 JS 语义转换成 C++ 语义;
- 执行业务逻辑;
- 再把结果转回 JS 世界。
写到这里以后,我对 NAPI 的感觉就变了。它不再是一个"黑盒能力",而是一层相当明确的边界层。
边界一旦理解清楚,后面很多事都没那么神秘了。
五、真正把我卡住的,反而是构建层
如果只看示例,Native 接入最容易让人忽略的一层,就是构建。
因为代码看起来都不长,页面也很快能写完,但最后能不能真正跑起来,很大程度取决于下面几件事:
CMakeLists.txt有没有配对;- 源文件有没有被正确加入;
- 导出的符号有没有注册;
- 目标名称和 ArkTS 侧导入名称是不是一致;
- 编译出的 so 有没有被工程真正加载到。
这一层我后来专门记了一个经验:Native 项目最容易出现"代码看着没问题,但工程就是不工作"的错觉。
为了解决这个问题,我最后把构建配置压成了最小闭环。比如 CMake 这一段,我会先保证目标单一、命名统一、依赖明确:
cmake
cmake_minimum_required(VERSION 3.5.0)
project(native_module)

add_library(native SHARED native_module.cpp)

find_library(log-lib hilog_ndk.z)

target_link_libraries(native ${log-lib})
写成这种最简配置以后,问题一下子变得好排查很多:
- 编不过,就是构建问题;
- 编过了调不到,就是桥接注册问题;
- 能调到但数据不对,就是参数转换问题。
也就是说,当层次清楚以后,问题就不再混成一团。
六、我调试时最常看的,反而是 DevEco 里的"加载成功没"
到了联调阶段,我最常盯的不是页面外观,而是模块有没有真正被加载、方法有没有真正被调到。
整个开发过程,我关注的基本就是三组信息:
- 左侧项目结构里,ArkTS 页面、cpp 文件、CMake 配置有没有对齐;
- 右侧页面里,加法调用和设备信息按钮按下去能不能返回;
- 底部日志里,模块加载、函数执行、返回结果这些节点有没有出来。
整个开发场景,大概就是下面这种感觉:
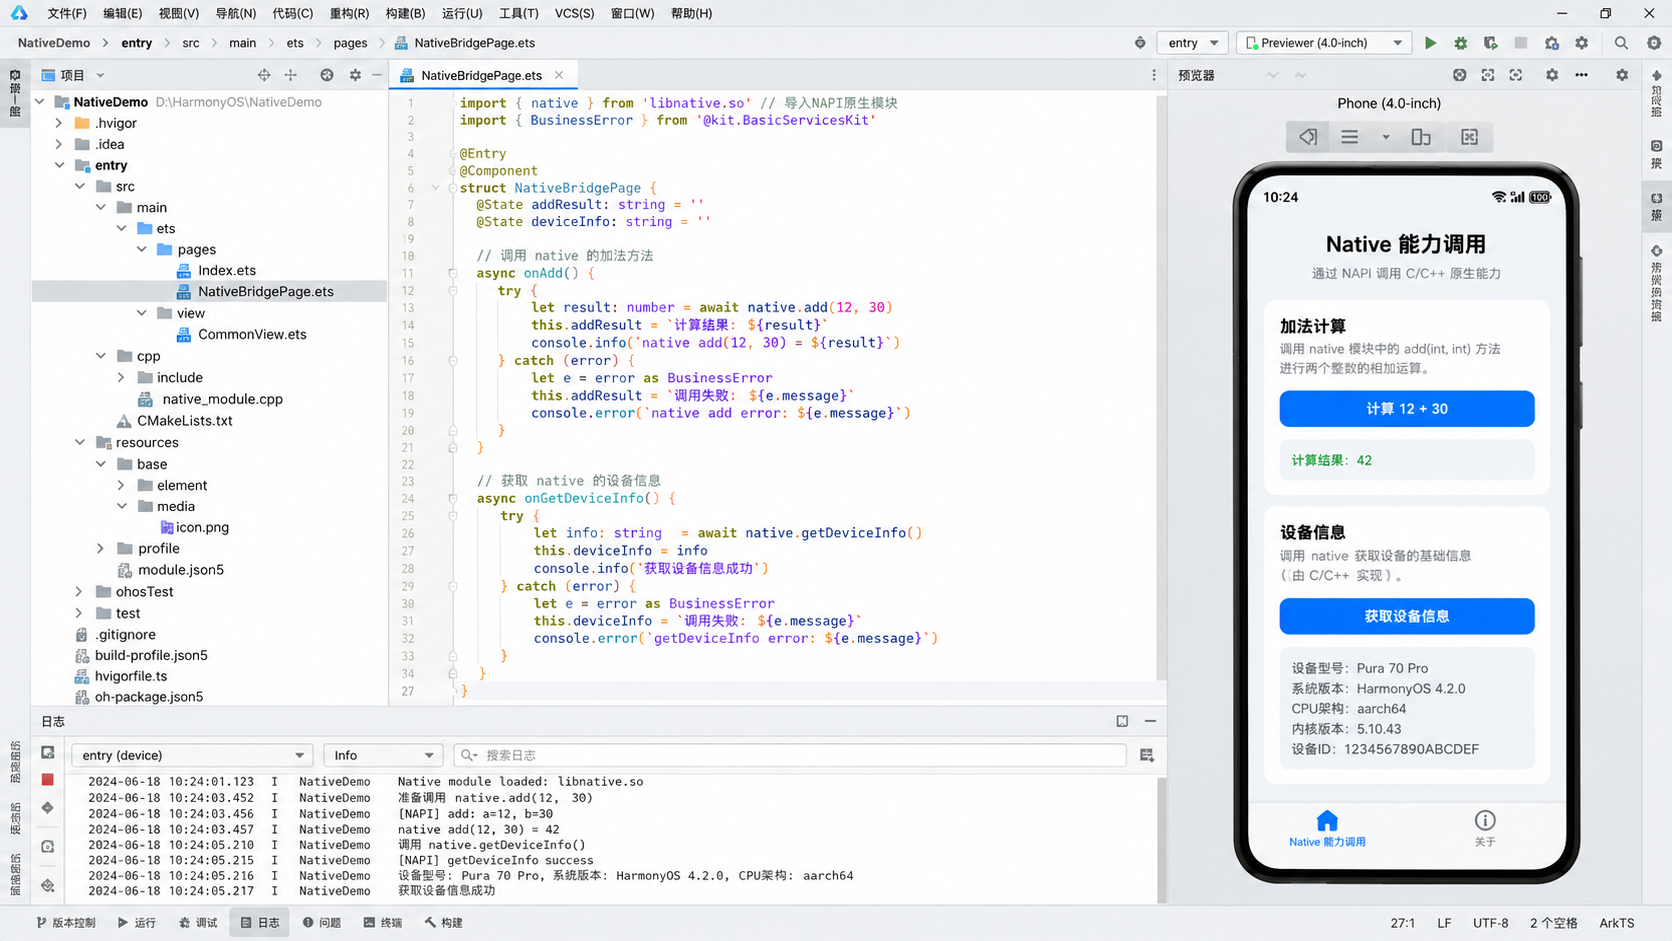
我后来越来越觉得,Native 模块调试最值钱的,不是某个花哨界面,而是你能不能看到这些"中间证据":
- Native module loaded;
- add(12, 30) 执行成功;
- getDeviceInfo success;
- 返回内容是不是符合预期。
因为一旦这些节点不完整,页面就算看起来还在动,你也很难确认问题到底在哪一层。
七、结果页如果只放一个按钮,其实不足以说明桥接是不是稳了
如果只是为了演示"ArkTS 能调 Native",其实放一个按钮、回一个数字就够了。
但我后来还是把页面补成了一个更完整的结构:
- 一块做加法计算;
- 一块做设备信息读取;
- 一块展示最近调用日志。
这样做的好处很直接:一次页面操作,就能把"参数传入、返回结果、模块状态、日志证据"全都放到一起。
页面最终我更希望呈现出的是这种层次:
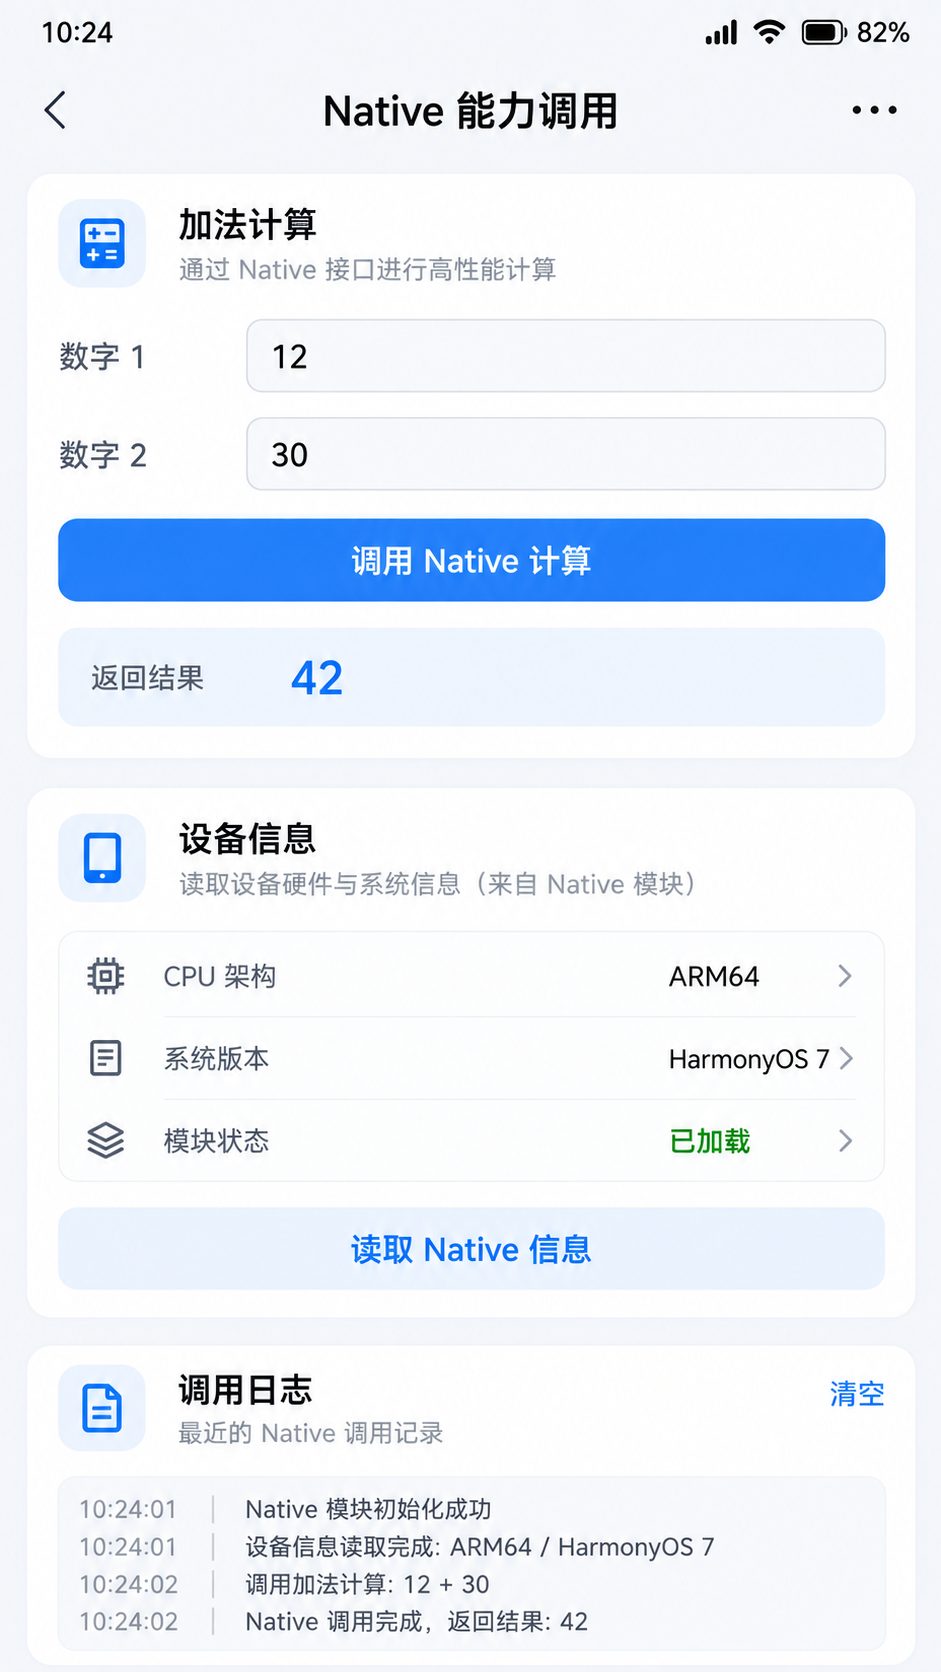
这里最有价值的不是视觉,而是它把桥接项目里几个容易散掉的东西收拢了:
- 调用入口;
- 返回值;
- 当前设备信息;
- 模块状态;
- 最近一次调用记录。
只有这些信息一起出现,页面才真的像一个"桥接验证页",而不是一个零散的 Demo 页面。
八、我后来又补了一页"桥接详情",专门确认这条桥是不是完整
做这种学习项目,有一个很现实的问题:页面跑通了,不等于桥就搭稳了。
所以我最后又补了一页更偏诊断型的详情页,把桥接状态拆开来看,比如:
- ArkTS 入参是什么类型;
- Native 出参是什么类型;
- CMake 构建是否通过;
- so 加载状态是不是正常;
- 最近几次执行记录返回了什么。
理想里,我希望它呈现的是这种"桥接诊断页"的感觉:
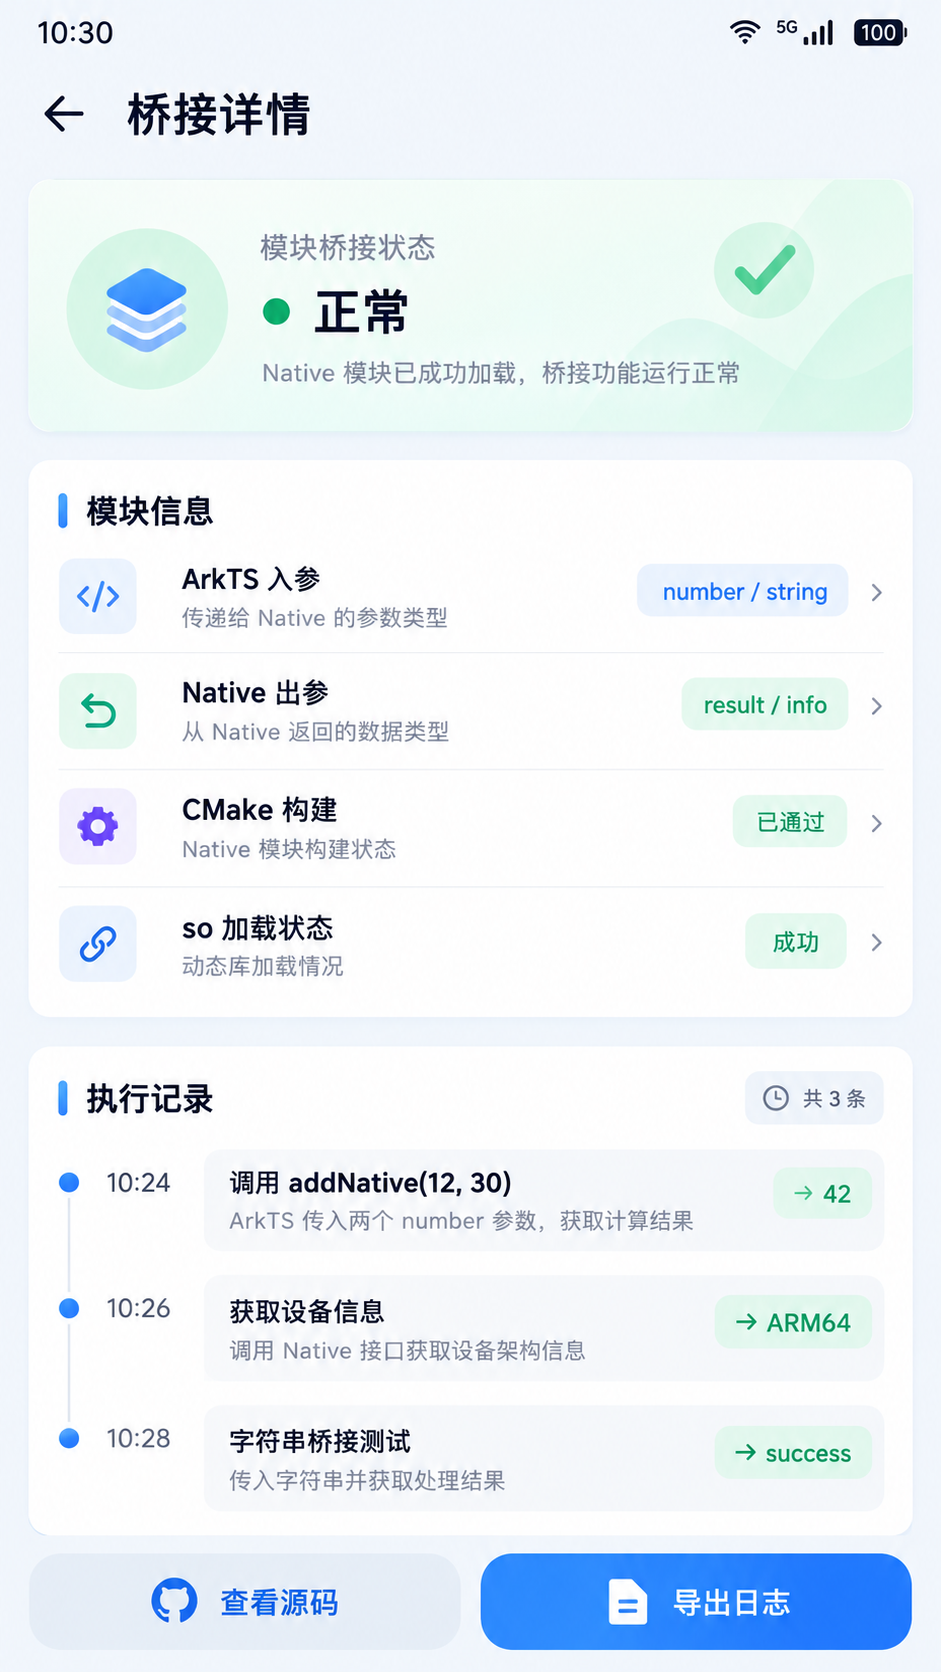
这种页面对学习笔记项目特别有价值,因为它把原本隐藏在代码和日志里的内容,翻到了界面层:
- 模块有没有正常加载;
- 哪些桥接调用成功了;
- 返回的结果值是不是符合预期;
- 当前这条桥是不是处于可继续扩展的状态。
如果后面我再继续加:
- 字符串处理;
- 数组传参;
- 二进制缓冲区;
- 异步任务或回调;
我都能沿着这套结构继续往上搭。
九、这次学习里,我真正记住的不是某个 API,而是这条桥的结构
回头看这次练习,我觉得最值得记下来的,不是 napi_get_value_int32 这种具体细节,而是整个桥接结构:
- ArkTS 负责发起调用和消费结果;
- NAPI 层负责做参数翻译;
- Native 层负责真正能力实现;
- CMake 负责把整个构建链拉通;
- 日志与诊断页负责把中间证据留出来。
以前我总会把 Native 接入理解成"为了用底层能力"。这次做完以后,我更愿意把它理解成:在 HarmonyOS 工程里,补了一层跨语言能力扩展机制。
这两种理解差别很大。
前者更像"为了完成某个点需求";后者更像"在搭工程能力底座"。
十、本文小记
如果用一句话总结这次学习,我会写成:NAPI 接入不是一次 import,而是一条跨语言桥接链。
这条链真正的难点,不在于业务逻辑有多复杂,而在于边界是不是清楚、参数是不是稳定、构建是不是顺畅、调用是不是可验证。
对我自己来说,这次练习至少让我把几个判断记牢了:
- ArkTS 调 Native,重点不是页面按钮,而是桥接层;
- Native 调得起来,不等于桥接结构已经稳定;
- CMake 构建层非常关键,很多问题都卡在这里;
- 日志和诊断页,对 Native 项目特别重要;
- 小闭环先跑顺,比一开始接复杂能力更值。
后面如果继续往下做,我最想补的两块是:
- 一块是复杂对象与数组的桥接封装;
- 一块是异步 Native 任务与回调结果回传。
这一篇先把第一阶段的学习过程记到这里。至少到这一步,我已经不再把 NAPI 看成"调一次底层函数",而是把它看成一条可以持续扩展的跨语言能力通道。