上一篇的结尾留了一个问题:数据放不进内存时,一个 KV 存储要重新面对哪些问题?这篇就从上一篇的那次 Put 说起。
在 .output/shorturl-demo 里,c:Ab3xK 已经写入了 000003.log 文件;目录下还没有任何 .ldb 文件。上一篇的实验进程退出时,MemTable 随析构一起消失,所以这条数据此刻只存在于磁盘日志里。这一篇文章我们暂时先不深入细节,我想先给读者一份完整的数据流视野,后面的文章会逐一深入数据流的每个节点。
数据放不进内存时,一个 KV 存储要重新面对哪些问题?LevelDB 为什么选了 LSM 这条路?
从一次 Put 说起
如果数据集小到能全部装进内存,一个 KV 存储可以简单到只有一个哈希表:Put 就是插入一个键值对,Get 就是查表,时间复杂度是 O(1),皆大欢喜。
可一旦数据比内存大,哈希表这个理想模型就不好用了。有三堵墙横在我们面前:
第一堵墙:掉电。 内存是易失的,进程一退、机器一断电,哈希表就没了。那我们就得想办法把数据先落入磁盘中。许多存储引擎都采用的是预写日志(WAL) ,LevelDB 也不例外。当然,"写"到什么程度才算安全也是有讲究的------默认 sync = false 只把数据交给操作系统页缓存,后面的文章中我会探讨这一话题。
第二堵墙:索引。 数据的主体必须放到磁盘上。可磁盘不像哈希表那样能 O(1) 定位一个 key,得为"在磁盘上找数据"准备一套索引结构------数据按什么组织、索引放在哪、一次查找要读几个地方。哈希表帮不上忙了,因为它本身也要占内存。
第三堵墙:随机写的代价。 顺着前人的思路,很容易可以想到在磁盘上实现一棵 B+ 树:所有数据按 key 排好,就地更新。但磁盘和内存不同------顺序写和随机写的成本差着数量级(机械盘是寻道,SSD 也有擦除块和写放大的问题)。如果每次 Put 都要"先找到对应的页,修改数据",甚至还可能面临"页分裂"的问题,那么写吞吐就会被磁盘的随机写性能掣肘。
LevelDB 的选择是:不就地改,只追加写------新的数据永远往文件末尾追加,已经写好的文件不再修改,旧数据和删除记录交给后台的归并逻辑去消化。
把这三堵墙的答案合在一起,就是 LevelDB 写入路径的四个主角:
- WAL :追加写的第一站,
Put返回前日志已经写完(是否刷到物理盘由sync决定); - MemTable:内存中的有序表,数据在这里等待积少成多;
- SSTable:磁盘上的不可变有序文件,MemTable 写满后整表倒出;
- Compaction:后台的归并整理,把一堆新旧混杂的文件慢慢收敛。
LSM
上面这种"追加写 + 后台归并"的结构有个名字:LSM-Tree(Log-Structured Merge-Tree,日志结构合并树)。
它和 B+ 树走的是两条完全不一样的路线。B+ 树,更新是就地的:找到 key 所在的页,在原处改掉它,页满了就分裂。数据在磁盘上的位置长期稳定,读路径也稳定------一次点查,顺着树往下走几次 IO 就到。
LSM 却反过来:更新不在原处,而是追加成一个新的版本;同一个 key 的历史版本可能散落在内存和好几层文件里,直到某次后台归并把它们合并、把废弃版本丢掉。写入变成了顺序追加,代价被挪到了读取和空间上------读一个 key 可能要翻好几层才能确定哪个版本最新,删除也不是马上消失,而是留下一个标记等归并清算。
这是一笔很朴素的技术交易:磁盘顺序写便宜、随机写贵,那就把随机写都攒起来,换成大块的顺序写;读多花的那点代价,再用缓存、Bloom Filter 之类的机制进行弥补。后面的文章会把这笔交易量化成"读放大、写放大、空间放大"三个模型,这里先留个印象。
顺带一提,这正是 Bigtable 论文 §5.3 里那个 tablet 的单机形态------第一篇里 doc/impl.md 的自述说的就是它。
一张全局数据流图
现在把四个主角摆到一次 Put 的完整旅程里:
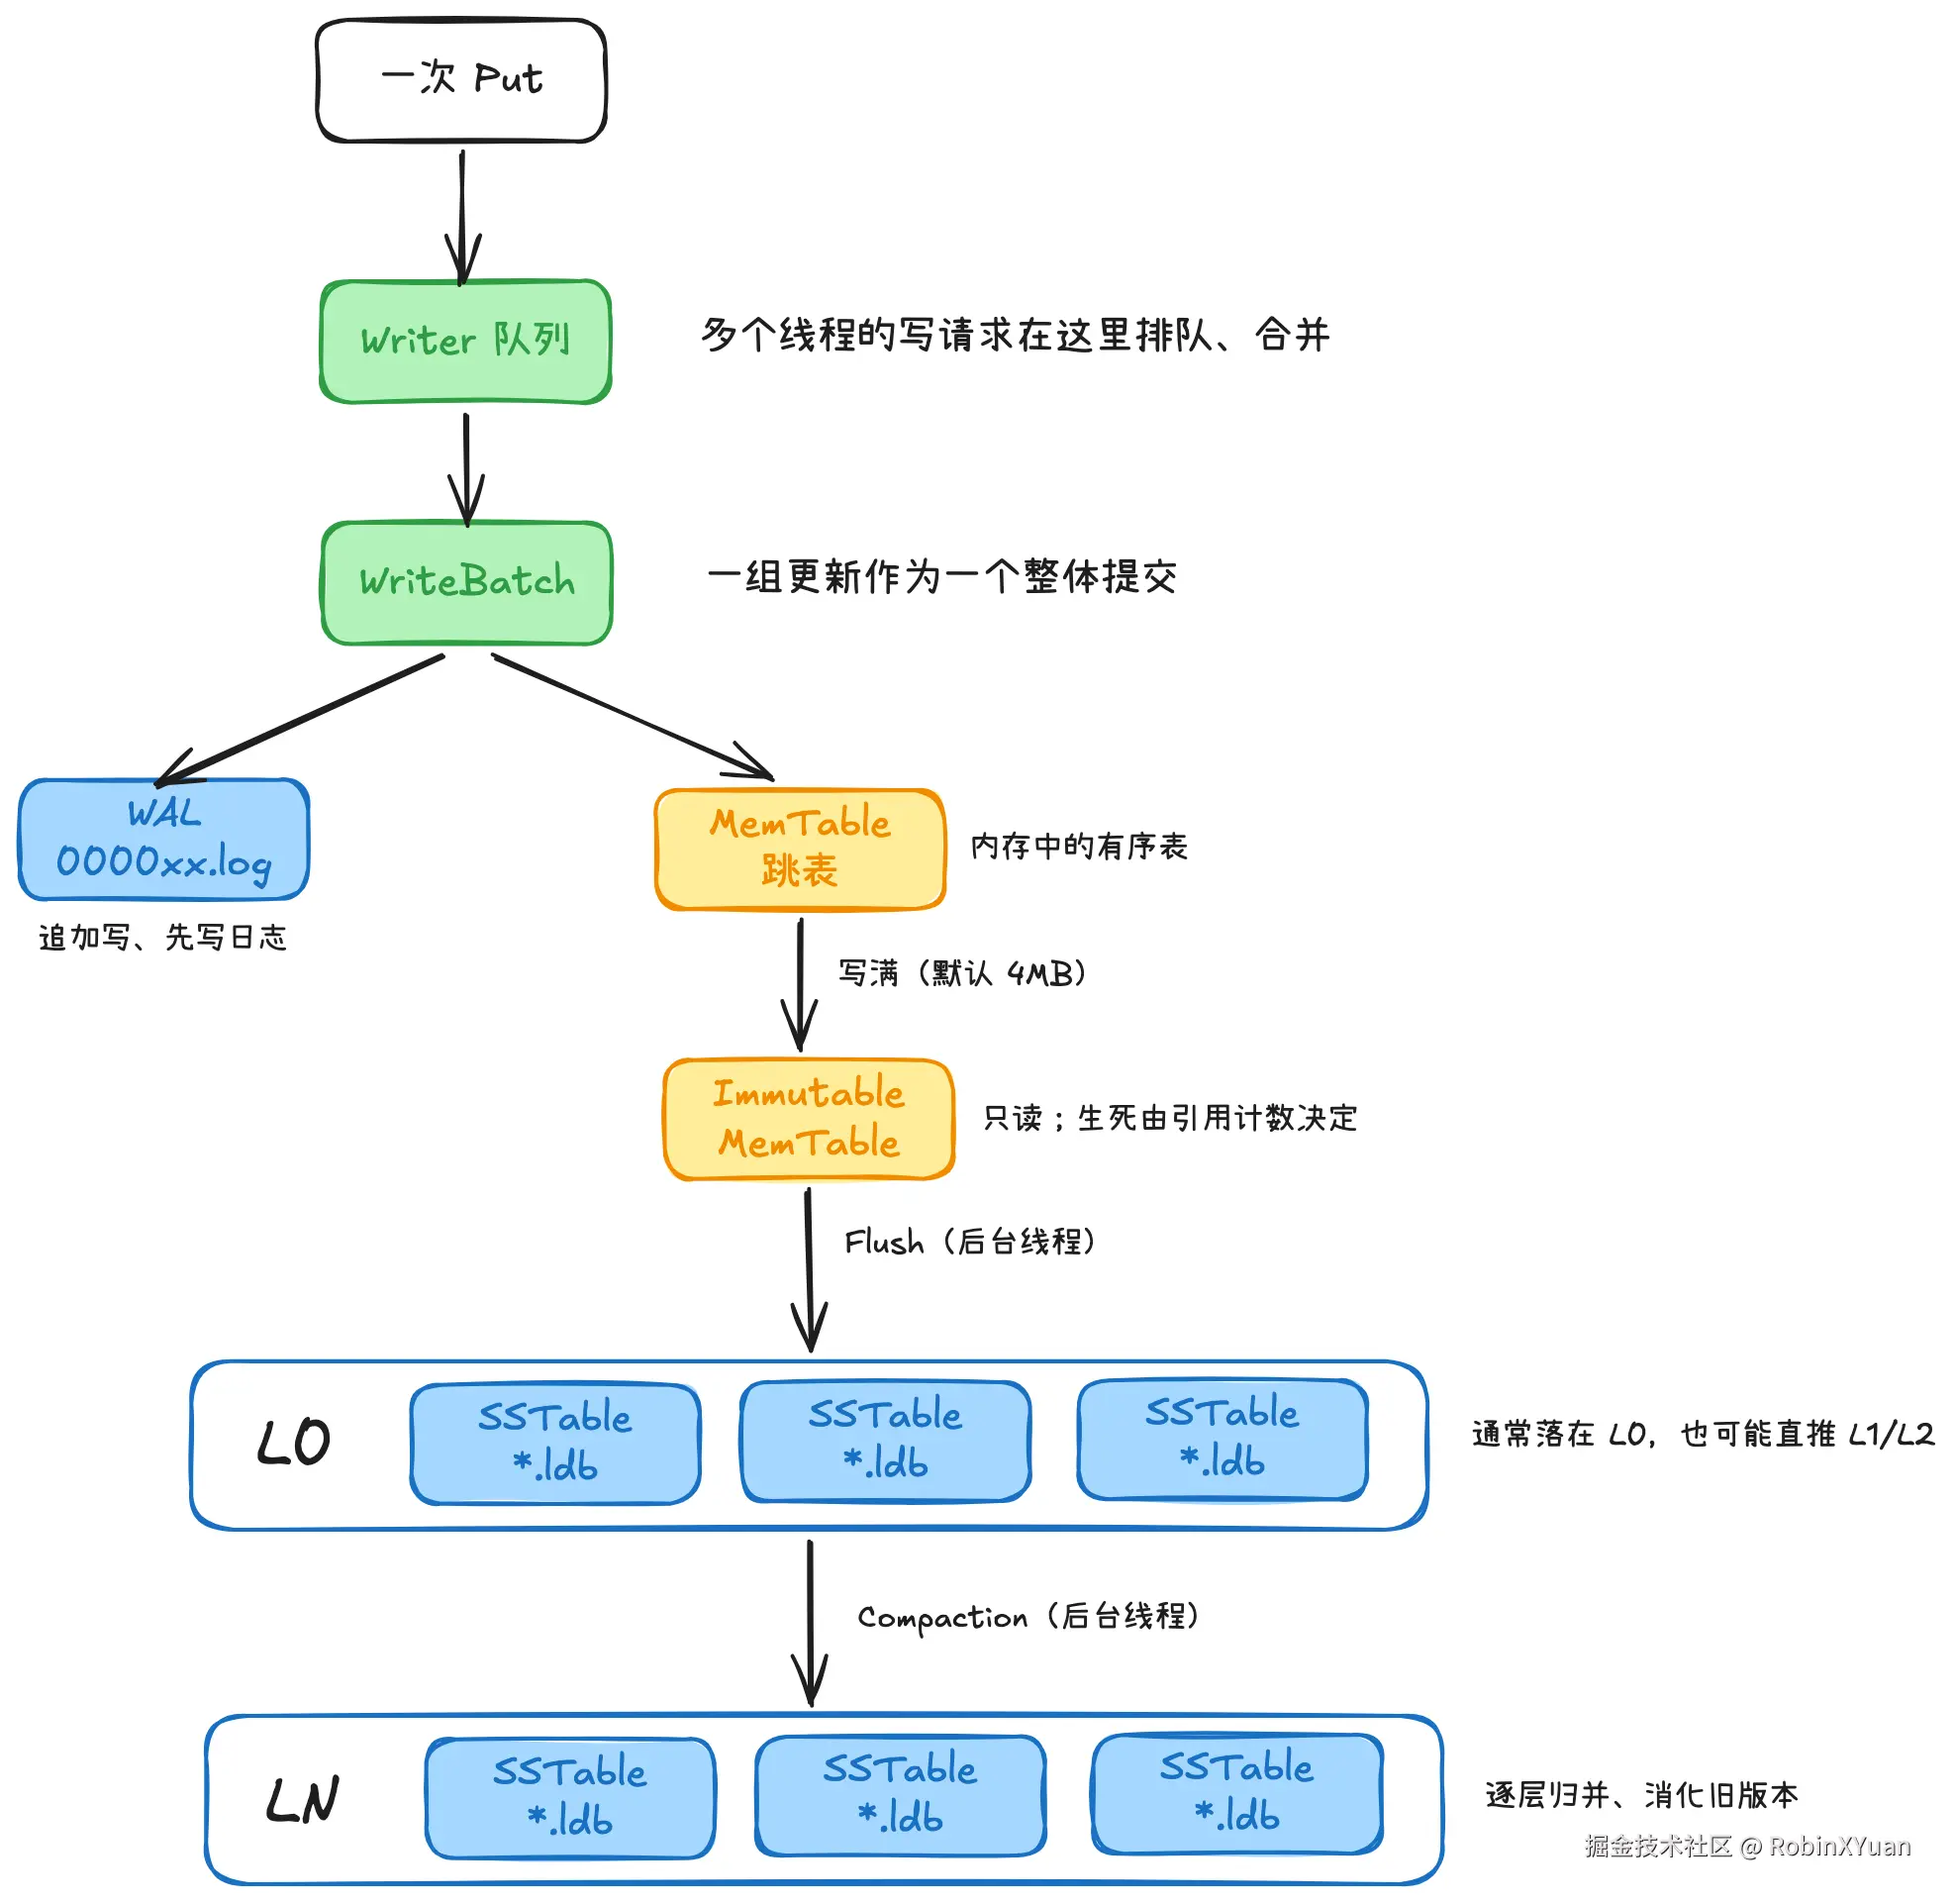
一次 Put 从图的顶端进入,先写 WAL 再进 MemTable(两笔数据内容相同,一份用于崩溃后恢复,一份用于读取);MemTable 写满后冻结成 Immutable MemTable,由后台线程整表倒成一个 SSTable------运行时通常落在 L0,如果与现有各层都不重叠,也可能被直接提到 L1、L2;更后面的工作------把各层文件层层归并------是持续的后台整理,平时与前台写入互不打扰,但后台忙不过来时,前台写入会让路。
读的方向要反过来看:一次 Get 从最新写入的地方开始找,MemTable → Immutable MemTable → L0 → L1 → ...... → L6,谁先给出这个 key 的最新版本就算谁赢。越靠前的数据越新,这是 LSM 里最重要的不变量之一。
每一层之间大约差 10 倍容量,最终撑起一个远远大于内存的数据集。
这里有两个默认值很重要:write_buffer_size = 4MB(options.h:82)是 MemTable 的换新阈值;max_file_size = 2MB(options.h:115)是 Compaction 输出单个文件的目标大小,和层级容量无关。各层的容量上限来自 db/version_set.cc 的 MaxBytesForLevel(version_set.cc:41)------从 L1 的 10MB 开始,每下一层乘 10:
plain
MemTable      约 4MB        内存写缓冲,写满就换新
Immutable     约 4MB        上一代内存表,等待落盘
──────────────────────────────────────────────────
L0            按文件数管理    每个文件由一次 Flush 整表倒出,文件之间 key 区间可能重叠
L1            10MB          主要由 Compaction 生成(少数来自 Flush 直推),层内 key 有序、文件之间不重叠
L2            100MB
L3            1GB           再往下每层 ×10
L4            10GB
L5            100GB
L6            1TB           最底下一层
注意 L0 和其它层不同:它不按容量、而是按文件数管理,文件之间还可能重叠------这正是后面要展开的"L0 为什么特殊"。
当然,图中的每个步骤都能够找到对应的源码:
| 过程 | 源码入口 |
|---|---|
Put → 队列 |
db/db_impl.cc DBImpl::Write(writers_ 在 db/db_impl.h:186,Writer 结构体在 db/db_impl.cc:43) |
| 队列 → WriteBatch | DBImpl::BuildBatchGroup |
| WriteBatch → WAL | db/log_writer.cc log::Writer::AddRecord |
| WriteBatch → MemTable | db/write_batch.cc WriteBatchInternal::InsertInto |
→ db/memtable.cc MemTable::Add |
|
| MemTable → Immutable | db/db_impl.cc MakeRoomForWrite(mem_ 与 imm_ 的交接) |
| Immutable → Flush | db/db_impl.cc CompactMemTable → db/builder.cc BuildTable |
| 层间 Compaction | 选择在 db/version_set.cc(PickCompaction),执行在 db/db_impl.cc(DoCompactionWork) |
Get 的查找 |
db/db_impl.cc DBImpl::Get → db/version_set.cc Version::Get |
短链实例:第一条数据现在在哪
回到 .output/shorturl-demo,用这张图给 c:Ab3xK 标个位置。
它已经走完了图的上半段:经过 Writer 队列(当时没有别的写请求,队列里只有它一个)、变成一个单条记录的 WriteBatch、以 64 字节写进 000003.log,然后进入 MemTable------DB::Put 在 db_impl.cc:1469 的源码其实只有三行:把一个键值对放进一个新建的 WriteBatch,然后调用 Write。所以"一次 Put 变成一次 batch"从接口层就注定了。
在 01 的实验里它一度停在 MemTable;数据库关闭后 MemTable 被释放,现在磁盘上只剩 WAL。目录里之所以还没有 .ldb,是因为那次写入离 4MB 的 Flush 门槛太远。后续每篇推进一步:先看短链服务重启时它怎么从 WAL 回到 MemTable;然后把 MemTable 写满,我们亲手迎来第一个 .ldb 文件的诞生;再往后,它会随着 Compaction 一层层往下走。
对比参照:持久化在内核,还是外挂
同样是"把数据持久化",三个系统把这件事放在了不同的位置。
InnoDB 的持久化在最底层。 它的主存储就是磁盘上的页,buffer pool 只是页的缓存;更新发生在 buffer pool 里,但落到磁盘是"就地"的------页就是数据结构本身。崩溃安全靠 redo log 补上:先写 redo,再慢慢把脏页刷回。也就是说,磁盘布局在写入前就已确定,日志保证"改到一半崩了"也能补齐。
Redis 的持久化在存储内核之外。 Redis 的主存储是内存,所有操作都在内存里完成;RDB 是把内存快照导出,AOF 是把写命令追加成日志。这两者是"导出、重放"性质的外挂机制,而不是数据本体的组织方式------所以内存预算就是它的容量上限,磁盘持久化只解决"重启后内存里还能重建出来"。
LevelDB 的持久化在写入路径正中间。 它没有"先把页改好再补日志"的次序问题:Put 先追加 WAL,再改内存中的 MemTable,磁盘上的数据文件是之后由 MemTable 整表倒出来的------每一步都是追加,没有就地修改。这也是 000003.log 只有 64 字节、而 .ldb 一个都还没有的原因:持久化的第一现场是日志,不是数据文件。
一句话概括:Redis 的家在内存,InnoDB 的家在磁盘的页里,LevelDB 的家在磁盘的有序文件里;每个系统都把"最贵的那次操作"放在了它认为最划算的位置。
工程启示
用好 LevelDB:顺序写是 LSM 的物理基础
理解了"追加写换随机写"这笔交易,很多 LevelDB 的行为就有了统一的解释:
- 写入吞吐通常很高,因为 Flush 和 Compaction 都是在做大块顺序写;代价是后台忙碌时写延迟会波动;
- 读性能更依赖缓存和 Bloom Filter------这是为写让路付出的读侧成本;
sync选项直接决定 WAL 是否真的落盘:sync = false(默认)时数据进了操作系统页缓存就算返回,进程崩溃不丢、机器掉电可能丢------这条边界后面会讲清楚。
选择 LevelDB 之前,先确认自己的读写比例能接受这笔交易:写多读少、或者写入吞吐是瓶颈的场景,它往往比 B+ 树系更合适;读极重、写很少的场景,LSM 的多层查找就未必划算了。
设计借鉴:追加式设计的价值
"只追加、不修改"不只是存储引擎的技巧,它是一套可以迁移的工程模式:
- 崩溃语义简单:不用考虑"原地写到一半"的补救,只需要判断"最后一条是否完整",恢复逻辑少了一大类分支;
- 顺序 IO 友好:对磁盘、文件系统、压缩算法都友好,SSTable 能按顺序生成,压缩率也高;
- 天然的历史记录:追加的文件本身就是一条时间线,需要回放、审计、重算时不用额外造轮子。
日志文件、事件流、只增不改的流水记录,本质上都在用同一套思想。
图已经画完,箭头也对应到了源码。但图的第一笔还有一个前提:数据库得先打开------CURRENT、MANIFEST、.log 这些文件,在 Open 时按什么顺序被读出来?如果上一次没关干净,现在发生了什么?下一篇,从打开一个数据库说起。