上篇我们详细看了 Acceptor 的工作流程,也对 Processor 有了一些简单了解,最后收在安全握手:listener 的身份在 Processor 构造时变成了 ChannelBuilder,握手在事件循环里逐 poll 推进,ready() 之前业务字节一个不读。这一篇接着往下走------连接就绪之后,Processor 的七步循环怎么流转、一条连接为什么同一时刻只能有一个在途请求、线上的字节怎么被切成一帧一帧的请求、双方又怎么对表版本,以及这整件事为什么没有交给 Netty 去做。
- 「一条连接同一时刻只有一个在途请求」是怎么用 NIO 实现的?为什么这么设计?
apiKey/apiVersion/correlationId各自干什么?版本协商谈不拢时怎么办?- Kafka 为什么放着 Netty 不用,要自己实现 NIO?
Processor:事件循环,与一条连接的「静音」
Processor 是网络层真正的主力:socket 读写、握手推进、成帧、入队、写响应,全在这一个线程的循环里。我们还是先看看 Processor 的全景图,图里标出了它与世界相连的全部通道------四个入口队列/事件源,一个出口。
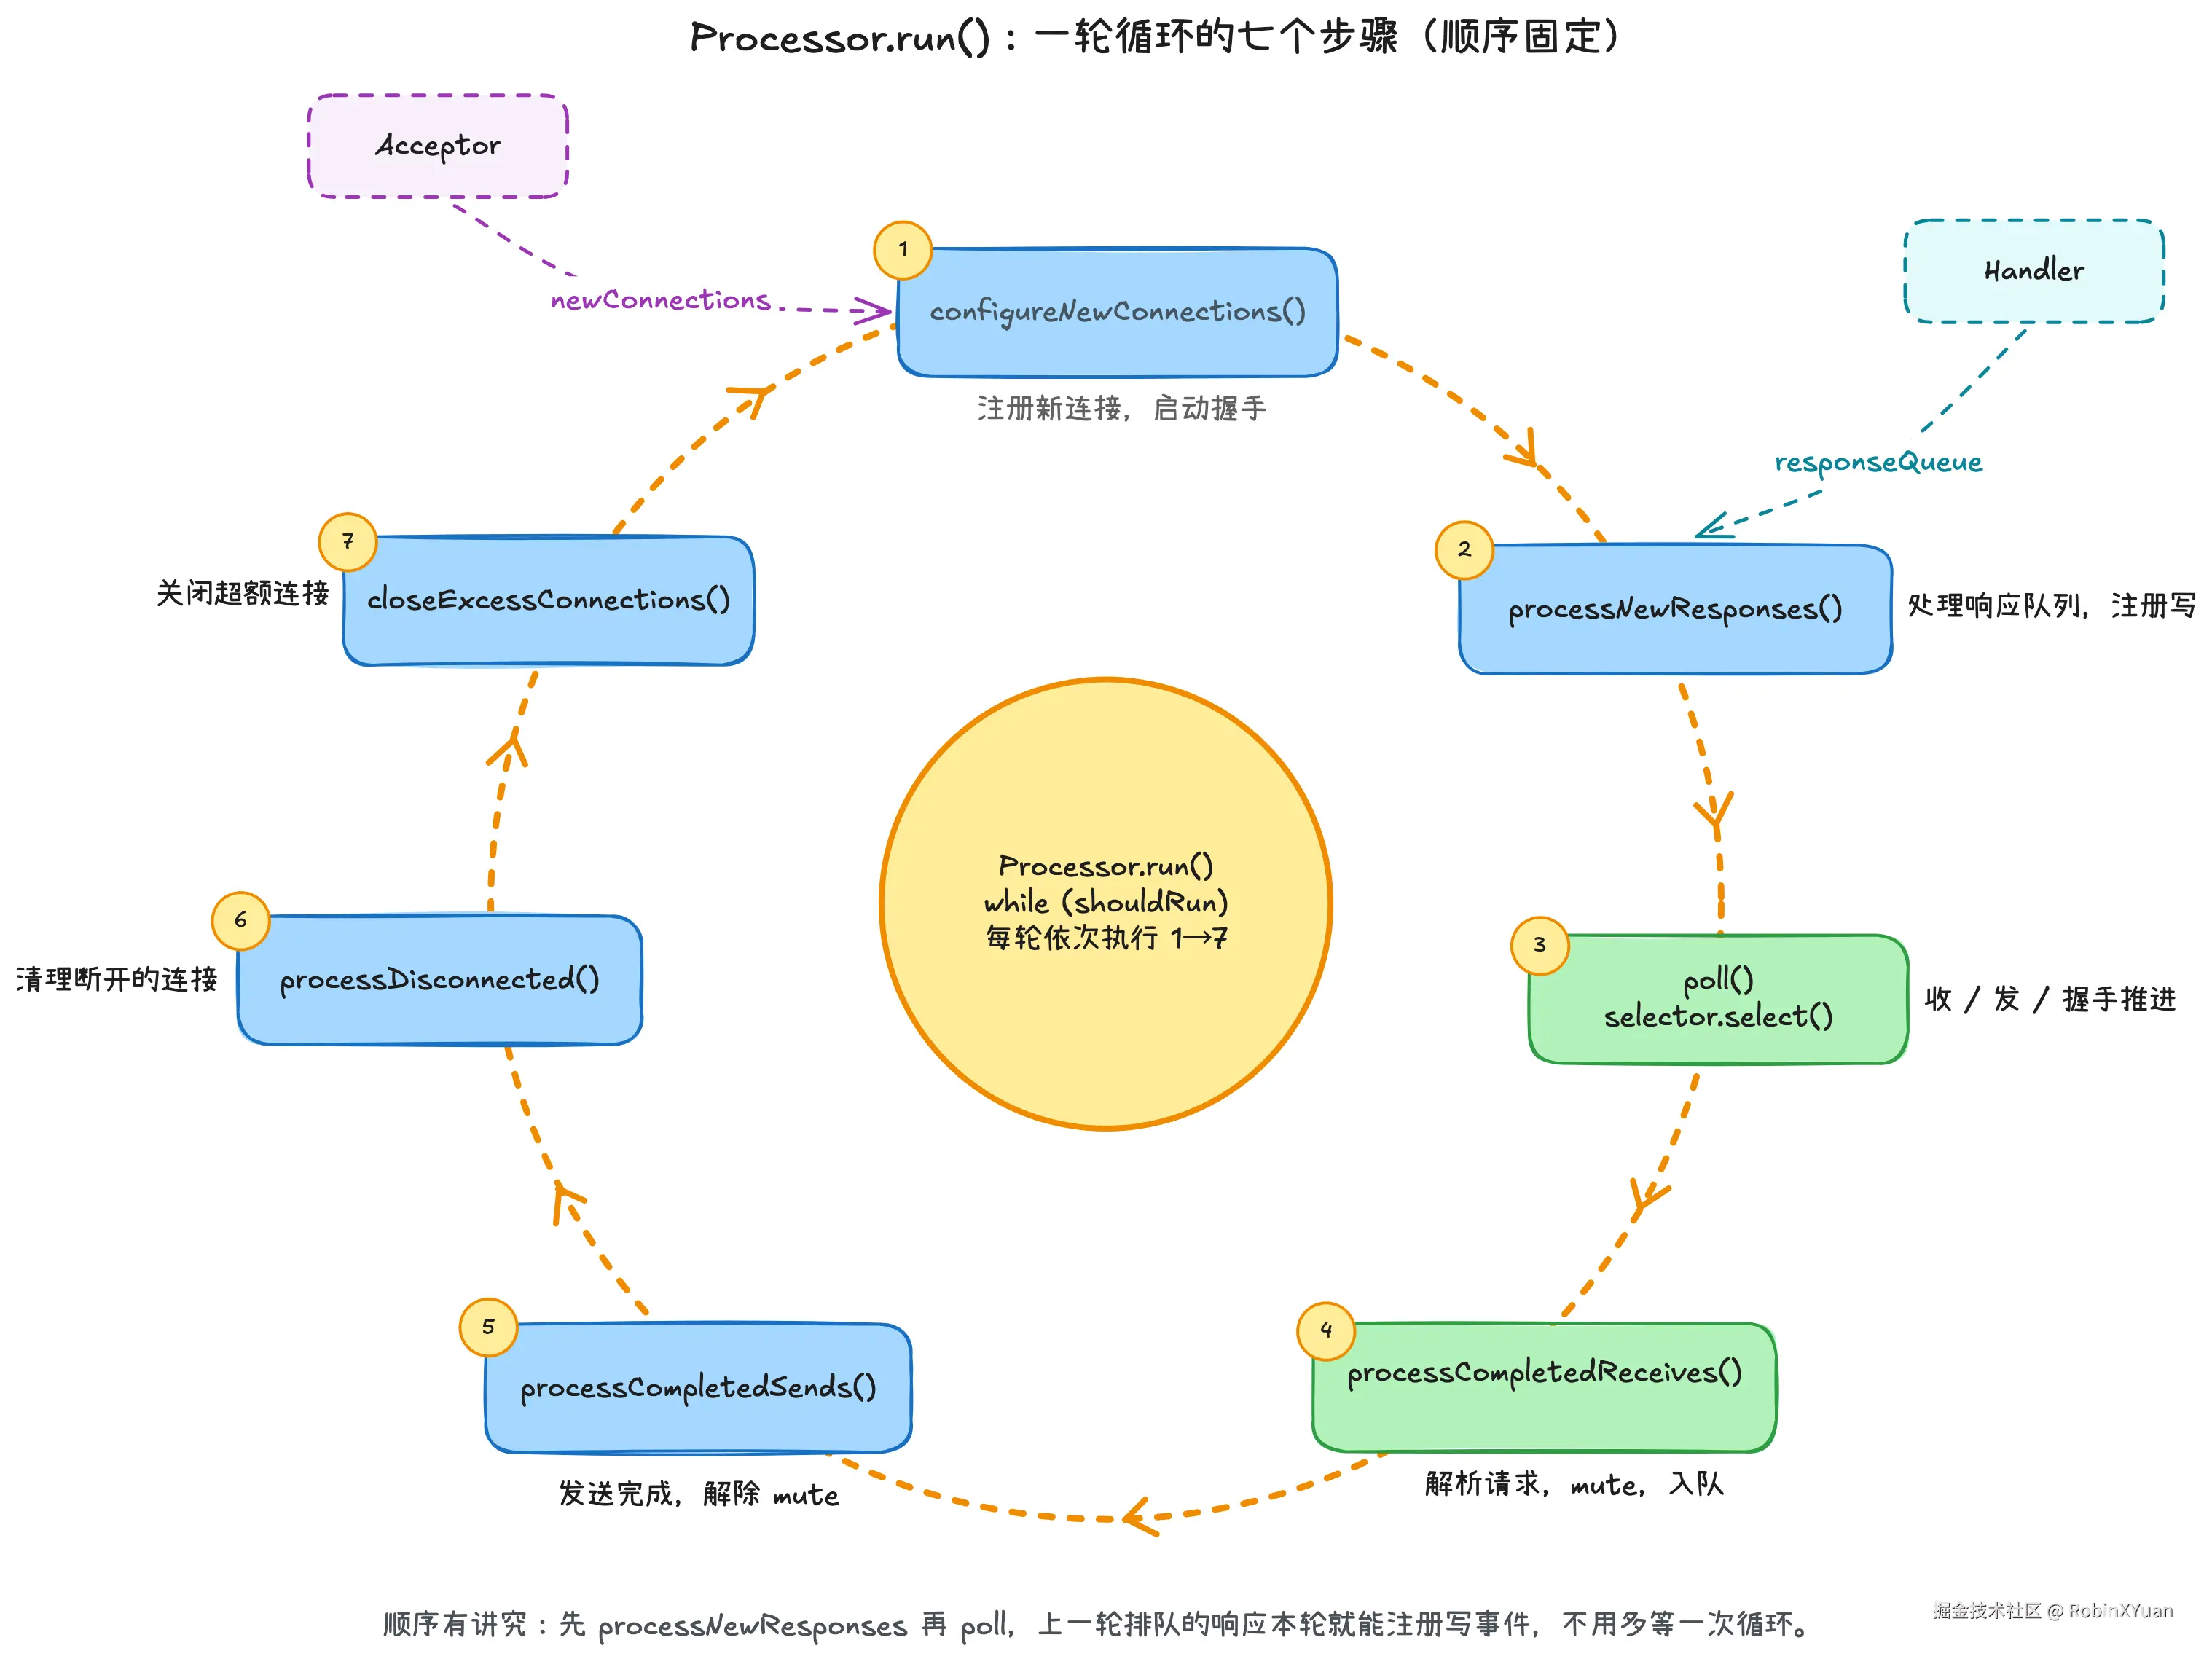
每个 listener 名下有 num.network.threads(默认 3)个 Processor,线程名 data-plane-kafka-network-thread-{nodeId}-{listener}-{secProto}-{id}(SocketServer.scala:746 )。主循环分七步(:889 的 run()):
scala
override def run(): Unit = {
  try {
    while (shouldRun.get()) {
      try {
        // setup any new connections that have been queued up
        configureNewConnections()      // ①
        // register any new responses for writing
        processNewResponses()          // ②
        poll()                         // ③
        processCompletedReceives()     // ④
        processCompletedSends()        // ⑤
        processDisconnected()          // ⑥
        closeExcessConnections()       // ⑦
      } catch {
        case e: Throwable => processException("Processor got uncaught exception.", e)
      }
    }
  } finally {
    // ...
    Utils.swallow(this.logger.underlying, Level.ERROR, () => closeAll())
  }
}| 步骤 | 方法 | 行号 | 功能 |
|---|---|---|---|
| ① | configureNewConnections |
SocketServer.scala:1168 | 把 Acceptor 塞进 newConnections 的通道注册到 selector |
| ② | processNewResponses |
:933 | 处理 handler 排进 responseQueue 的五种 Response(本节后半展开) |
| ③ | poll |
:991 | selector.select(空闲 300ms,有待办立刻返回,:992-993),读写就绪的通道在此推进(握手也在其中) |
| ④ | processCompletedReceives |
:1002 | 把完整收到的请求解析、包装、入 RequestChannel,并 mute 连接 |
| ⑤ | processCompletedSends |
:1062 | 响应发完的收尾:记账、回调、unmute |
| ⑥ | processDisconnected |
:1093 | 清理断连通道 |
| ⑦ | closeExcessConnections |
:1111 | 关掉超过配额的连接 |
上篇中我们用 Docker 起了一个 Kafka 集群,我们查看 Processor 线程栈,恰好落在 ③ 的 poll 上------Processor.run(SocketServer.scala:897 )调用 poll(:993 ),poll 里再调 clients 模块 Selector.poll(Selector.java:470 ),一路下钻到 epoll 的 select 等事件:
text
"data-plane-kafka-network-thread-1-PLAINTEXT-PLAINTEXT-0" #63 [1199] runnable
  at sun.nio.ch.EPoll.wait(...)
  at sun.nio.ch.EPollSelectorImpl.doSelect(...)
  at sun.nio.ch.SelectorImpl.lockAndDoSelect(...)
  at sun.nio.ch.SelectorImpl.select(...)
  at org.apache.kafka.common.network.Selector.select(Selector.java:880)
  at org.apache.kafka.common.network.Selector.poll(Selector.java:470)
  at kafka.network.Processor.poll(SocketServer.scala:993)
  at kafka.network.Processor.run(SocketServer.scala:897)
run 停在 :897 的 poll() 调用那一行,poll 自己停在 :993 的 selector.select 上------栈顶在等事件,这就是一个网络线程最常驻的状态。
对照图看:Acceptor 塞入 newConnections(① 消费),selector 事件驱动 ③,④ 的产物离开网络层去 RequestChannel,handler 侧的响应塞 responseQueue(② 消费),⑤ 完成回环。七步里 ③ 是发动机,其余都是它的前后处理。
先说成帧。「多少字节算一个请求」的知识属于网络层 :Processor 在 ④ 里从字节流解出请求头(SocketServer.scala:775 的 parseRequestHeader,object Processor 下的静态方法),检查 API 是否启用,甚至 KIP-511 之后连 ApiVersionsRequest 都在 Processor 层被截下来记录客户端软件名(:1032 )------这些工作根本轮不到 handler 线程。handler 拿到的已经是解析好的 Request 对象。分层的边界画在这里,而不是画在「读到字节」和「处理字节」之间。成帧的具体规则(4 字节长度前缀、请求头四字段)是下一节的主角。
再说本篇我认为的整个网络层的灵魂:一条连接同一时刻只允许一个在途请求 。看 ④ 的核心段落(SocketServer.scala:1021-1043):
scala
val connectionId = receive.source
val context = new RequestContext(header, connectionId, channel.socketAddress, ...)
req = new RequestChannel.Request(processor = id, context = context, ...)
// KIP-511: ApiVersionsRequest is intercepted here to catch the client software name
// and version. ...
if (header.apiKey == ApiKeys.API_VERSIONS) { /* ... */ }
requestChannel.sendRequest(req)
selector.mute(connectionId)
请求从连接上读出来、刚递给 RequestChannel,下一行就是 selector.mute(connectionId)。所谓 mute(静音) ,实现是去掉这条连接在 selector 上的「读兴趣」(clients/src/main/java/org/apache/kafka/common/network/KafkaChannel.java:252):
java
void mute() {
    if (muteState == ChannelMuteState.NOT_MUTED) {
        if (!disconnected) transportLayer.removeInterestOps(SelectionKey.OP_READ);
        muteState = ChannelMuteState.MUTED;
    }
}

boolean maybeUnmute() {
    if (muteState == ChannelMuteState.MUTED) {
        if (!disconnected) transportLayer.addInterestOps(SelectionKey.OP_READ);
        muteState = ChannelMuteState.NOT_MUTED;
    }
    return muteState == ChannelMuteState.NOT_MUTED;
}
NIO 里每个通道注册到 selector 时带一个 interest 集合,OP_READ 表示「这条通道可读时请唤醒我」;removeInterestOps(OP_READ) 之后,哪怕内核缓冲区里堆满字节,selector 也不会再为这条通道报告可读事件------注意不是「读到不处理」,是事件循环根本不被告知。mute 就是给连接戴上耳塞;unmute(maybeUnmute,注意没有无条件版本)把 OP_READ 加回来。从时序上看:
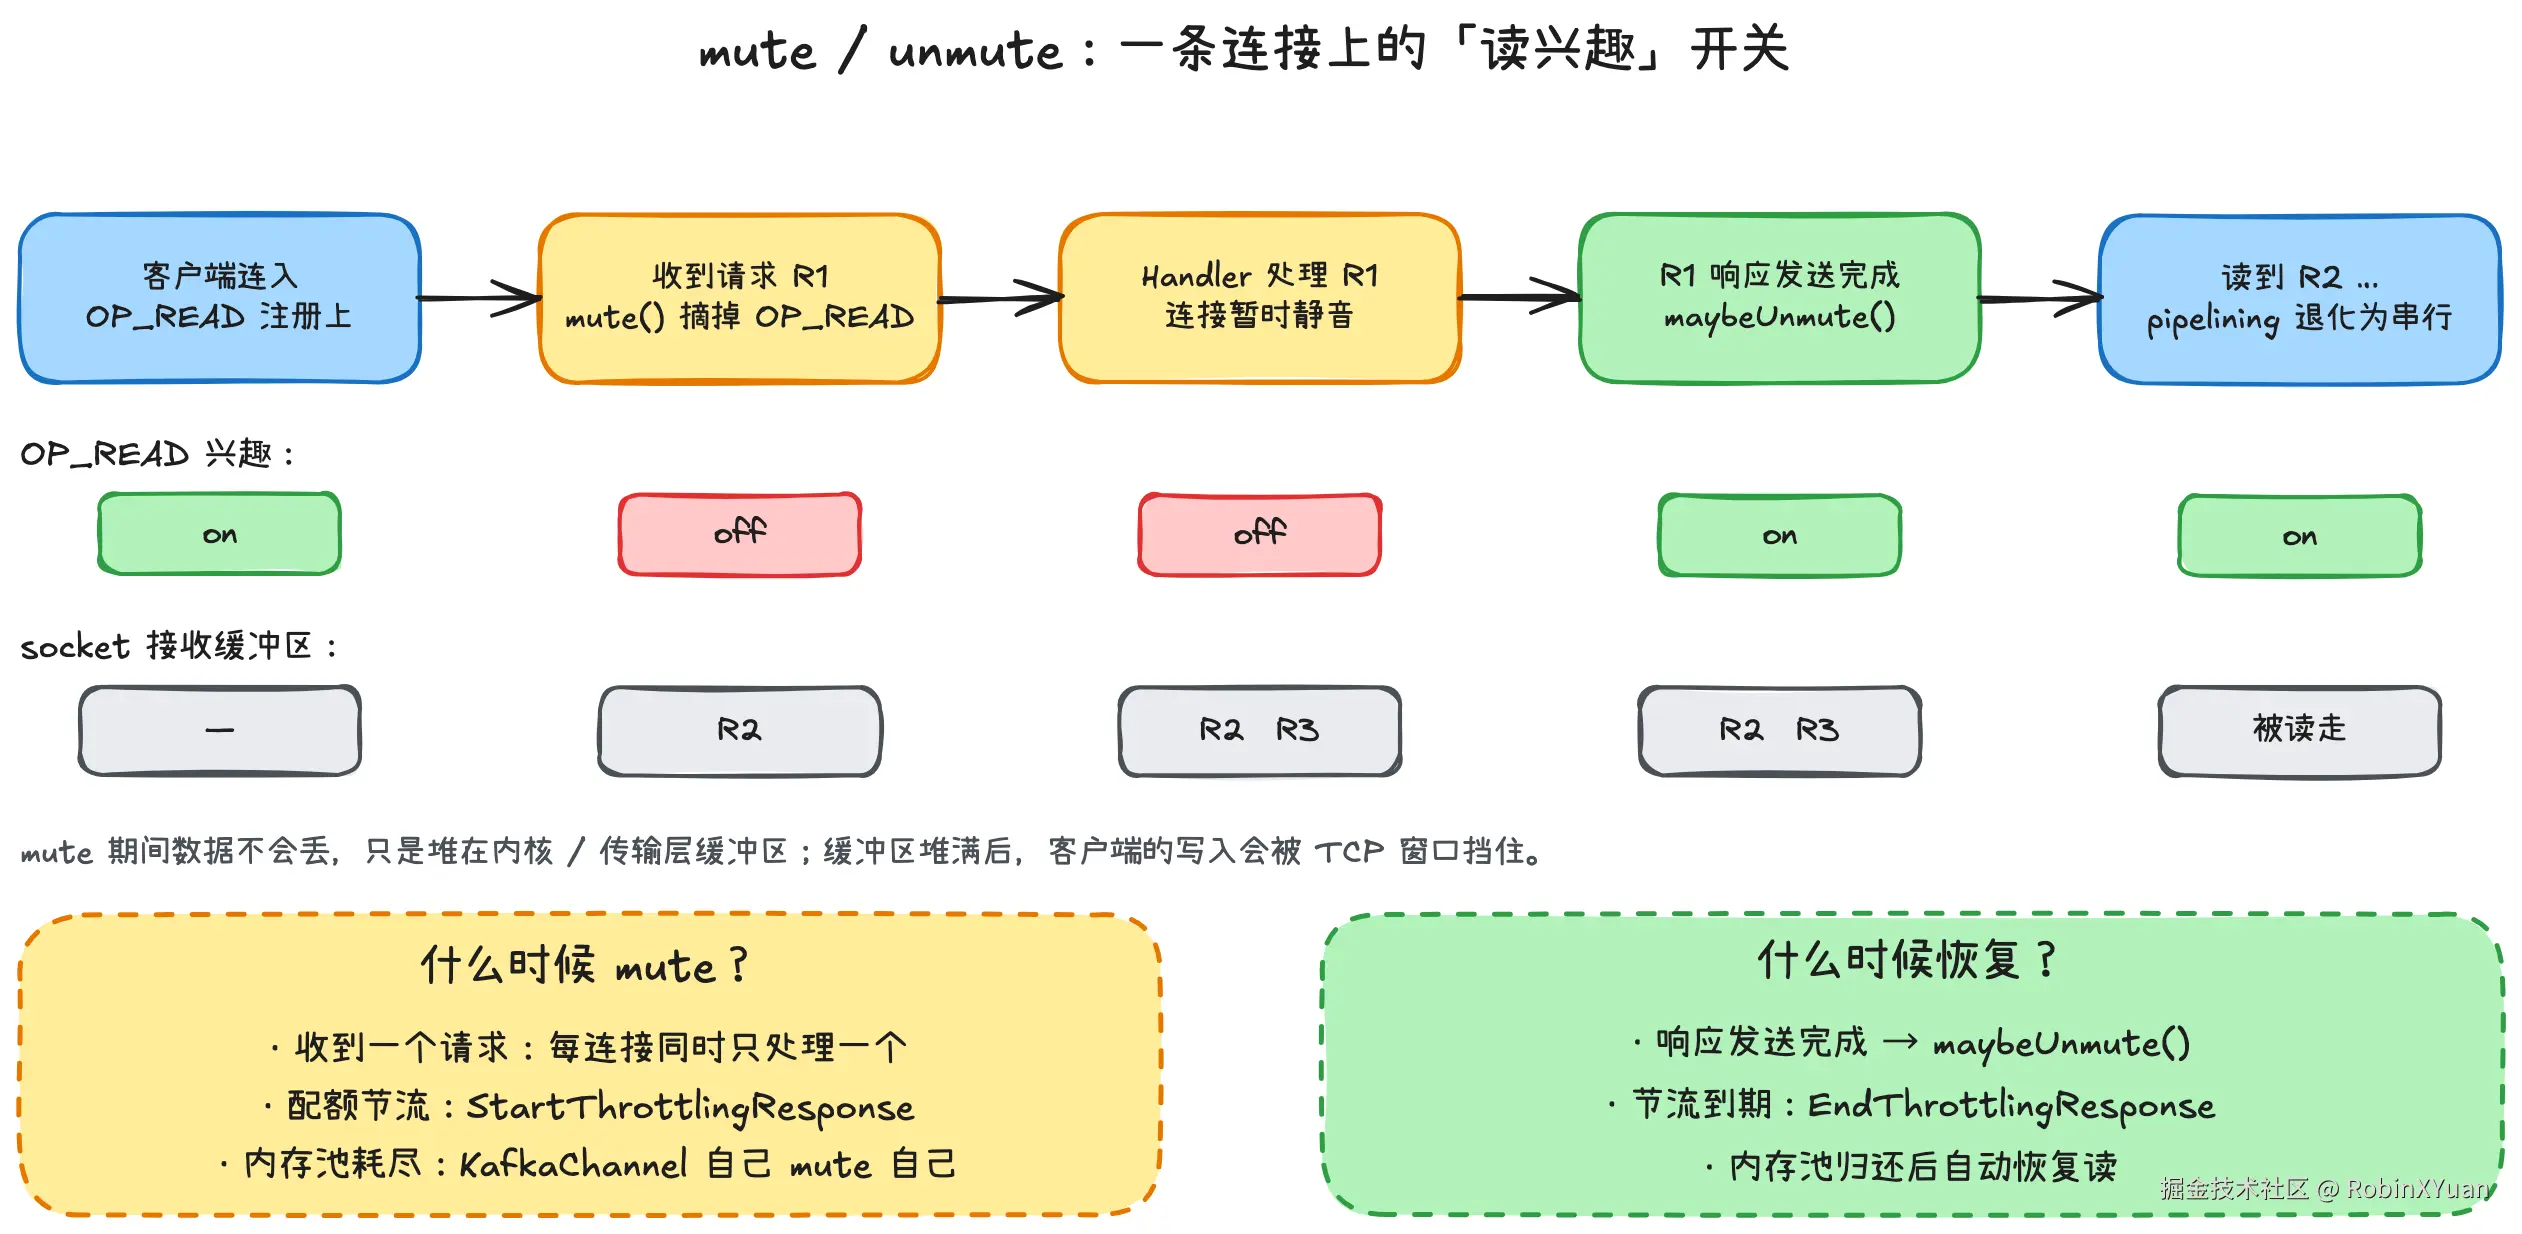
读出请求 → mute → 响应写完(⑤ 的 processCompletedSends,:1078 tryUnmuteChannel)→ unmute。请求与响应在一条连接上严格交替,服务端永远不会读到第二条请求,除非第一条的响应已经出门。
为什么要这么设计?看到这段代码时我的第一反应是「太保守了,HTTP 都有 pipelining」,这和我们平时接触的网络实现都不太一样。仔细一想又不无道理:Kafka 协议本来就是一问一答式的 RPC,客户端发出请求后本来就只能干等响应;既然如此,让 broker 在响应前继续从这条连接读请求,就等于允许客户端无节制地推送在途请求,broker 还得为每条连接维护请求表。mute 把这条路直接焊死------单连接的并发就是 1,想并行的客户端自己开多条连接(04 篇说的按 nodeId 建立连接,就是如此)。代价是单连接吞吐被 RTT 加处理时长限制,但 Kafka 的客户端从不指望单连接扛吞吐量,这个取舍就没有问题。
其实,mute 还被复用作了配额节流的执行机制 。handler 线程判定某连接超配额后,不能直接去改 Processor 的 selector------那是别人的线程状态------于是包装成一条 StartThrottlingResponse 排进响应队列,让 Processor 自己把连接静音,到期再排 EndThrottlingResponse 解除。这五种 Response 的分派就在七步循环的 ② processNewResponses(SocketServer.scala:933):
scala
private def processNewResponses(): Unit = {
  var currentResponse: RequestChannel.Response = null
  while ({currentResponse = dequeueResponse(); currentResponse != null}) {
    val channelId = currentResponse.request.context.connectionId
    try {
      currentResponse match {
        case response: NoOpResponse =>
          // There is no response to send to the client, we need to read more pipelined requests
          // that are sitting in the server's socket buffer
          updateRequestMetrics(response)
          // Try unmuting the channel. If there was no quota violation and the channel has not been throttled,
          // it will be unmuted immediately. ...
          handleChannelMuteEvent(channelId, ChannelMuteEvent.RESPONSE_SENT)
          tryUnmuteChannel(channelId)

        case response: SendResponse =>
          sendResponse(response, response.responseSend)
        case response: CloseConnectionResponse =>
          updateRequestMetrics(response)
          close(channelId)
        case _: StartThrottlingResponse =>
          handleChannelMuteEvent(channelId, ChannelMuteEvent.THROTTLE_STARTED)
        case _: EndThrottlingResponse =>
          // Try unmuting the channel. The channel will be unmuted only if the response has already been sent out to
          // the client.
          handleChannelMuteEvent(channelId, ChannelMuteEvent.THROTTLE_ENDED)
          tryUnmuteChannel(channelId)
        case _ =>
          throw new IllegalArgumentException(s"Unknown response type: ${currentResponse.getClass}")
      }
    } catch { /* ... */ }
  }
}| Response 类型 | 谁产生 | Processor 动作 |
|---|---|---|
SendResponse |
handler 正常应答 | 注册写事件,发回客户端 |
NoOpResponse |
acks=0 的 PRODUCE 等无需应答 |
记账 + 尝试 unmute,放行下一条读 |
CloseConnectionResponse |
handler 判定该断 | 记账 + 关连接 |
StartThrottlingResponse |
配额判定超限 | mute(静音一段时间) |
EndThrottlingResponse |
节流到期 | 尝试 unmute |
「谁拥有状态,谁来改」------连节流都要排队回到拥有者线程执行。
这里,我们又可以回到「上篇」中没解释的问题:Processor 创建 Selector 用的不是什么服务端专用类,而是 org.apache.kafka.common.network.Selector------客户端模块的原班代码(SocketServer.scala:864 的 createSelector,上篇安全握手一节看到的闸门就在这个类的 pollSelectionKeys 里)。客户端与服务端共用同一份传输层意味着什么,接着往下看。
线上的字节:请求头、ApiKeys 与版本协商
上一节反复说「成帧发生在网络层」,那成帧的规则是什么?我们慢慢来看:TCP 之上没有任何握手或分隔符,一条连接就是一串「4 字节长度 + 长度所指的请求」的循环。收帧的载体是 NetworkReceive(clients/src/main/java/org/apache/kafka/common/network/NetworkReceive.java ):先攒 4 字节的 size 缓冲区(:62 ,ByteBuffer.allocate(4)),读满后 rewind 取出整数 N,再攒 N 字节的 body:
java
public long readFrom(ScatteringByteChannel channel) throws IOException {
    int read = 0;
    if (size.hasRemaining()) {
        int bytesRead = channel.read(size);
        if (bytesRead < 0)
            throw new EOFException();
        read += bytesRead;
        if (!size.hasRemaining()) {
            size.rewind();
            int receiveSize = size.getInt();
            if (receiveSize < 0)
                throw new InvalidReceiveException("Invalid receive (size = " + receiveSize + ")");
            if (maxSize != UNLIMITED && receiveSize > maxSize)
                throw new InvalidReceiveException("Invalid receive (size = " + receiveSize + " larger than " + maxSize + ")");
            // ...
maxSize 的服务端取值是 socket.request.max.bytes(默认 100MB,server/src/main/java/org/apache/kafka/network/SocketServerConfigs.java:95-96)------网络层在这一步就把恶意或误配置的超大帧拦下。请求体内部不再套一层帧长度,字段怎么切由 schema 决定:字符串、数组各带自己的长度与计数前缀。「协议自描述」说的是边界知识长在 schema 里,不长在流上。
请求头:四个字段定身份
body 的开头是请求头。头从 v1 起只有四项,四个字段各有差事:
| 字段 | 类型 | 干什么 |
|---|---|---|
apiKey |
int16 | API 类型编号:PRODUCE=0、FETCH=1、ApiVersions=18...... |
apiVersion |
int16 | 这套 schema 的第几版;同一个 FETCH,v4 与 v18 的字段表完全不同 |
correlationId |
int32 | 客户端自增的编号,响应头里原样带回(clients/src/main/java/org/apache/kafka/common/requests/RequestHeader.java:119 的 toResponseHeader);它是防张冠李戴的校验凭证,不参与请求-响应的配对(原因见「版本协商」第 4 点) |
clientId |
nullable string | 写给服务端看:日志与指标拿它当键;配额分组 <user, client-id> 的一半 |
解析代码在 RequestHeader.java:123 的 parse(),顺序需要留意------先「偷」看 apiKey 与 apiVersion 两个 int16,推出这条请求该用哪个版本的头,再把 buffer 倒回去、按那个头版本正式解一遍:
java
public static RequestHeader parse(ByteBuffer buffer) {
    short apiKeyId = -1;
    try {
        // We derive the header version from the request api version, so we read that first.
        // The request api version is part of `RequestHeaderData`, so we reset the buffer position after the read.
        int bufferStartPositionForHeader = buffer.position();
        apiKeyId = buffer.getShort();
        short apiVersion = buffer.getShort();
        ApiKeys apiKey = ApiKeys.forId(apiKeyId);
        // ...

        short headerVersion = apiKey.requestHeaderVersion(apiVersion);
        buffer.position(bufferStartPositionForHeader);
        final RequestHeaderData headerData = new RequestHeaderData(new ByteBufferAccessor(buffer), headerVersion);
        // ...
头的版本不由协商决定,由请求自带的 apiVersion 推导(注释原话:"We derive the header version from the request api version ")。为什么能这么做?因为 int16 的 apiKey 和 apiVersion 在所有头版本里都在最前面、定长------先读它们再决定按哪版解,是自描述协议常用的「引导」技巧。
ApiKeys
apiKey 的全集是 clients/src/main/java/org/apache/kafka/common/protocol/ApiKeys.java 的枚举,4.3.1 里包括 93 项,从 PRODUCE 一路排到 share group 与 Raft voter 管理一族。编号一经发布永久不变,所以清单上留着空洞:对客户端稳定开放的列表里,3 之后直接是 8;枚举里那些 LEADER_AND_ISR、VOTE、ENVELOPE 是 broker 间与 Controller 内部的指令,不背对客户端的兼容承诺。全景图里那句「KafkaApis.handle() 按 apiKey 分发」,落到代码上是下篇会展开的巨型 match,分发表的键就是这个枚举。
读这个枚举的源码会遇到一个小小的迷宫:枚举项的构造参数是 ApiMessageType.PRODUCE 这样的引用,id、name、版本区间全部来自它------但如果没有编译一遍 Kafka 代码,ApiMessageType 这个类在源码树里是找不到的。这不是源码缺失,也不是引用了其它仓库中的内容,这些代码是编译期生成的。
生成器在 generator/src/main/java/org/apache/kafka/message/ApiMessageTypeGenerator.java (public enum ApiMessageType 的模板在 :144 ),驱动它的是根 build.gradle 里 project(':clients') 块注册的 processMessages 任务(:1988 起):
groovy
task processMessages(type:JavaExec) {
  mainClass = "org.apache.kafka.message.MessageGenerator"
  args = [ "-p", "org.apache.kafka.common.message",
           "-o", "${projectDir}/build/generated/main/java/org/apache/kafka/common/message",
           "-i", "src/main/resources/common/message",
           "-t", "ApiMessageTypeGenerator",
           "-m", "MessageDataGenerator", "JsonConverterGenerator" ]
}
输入是 clients/src/main/resources/common/message/ 下的 198 个消息定义 json(ProduceRequest.json 、FetchRequest.json ......每个 API 一对 request/response),输出写进 build/generated/,再经 sourceSets 并入编译。每个 json 里写着这个 API 的 validVersions、各个版本的字段表、是否 flexible------ApiKeys 里的版本区间、KafkaApis 分发用的 schema,源头都是这批 json。这套「单一事实来源 + 编译期生成」的机制使得改协议只需改 json,枚举与消息类自动再生,不存在两处手工同步的问题。
版本协商:从探测到定版
93 种 API 各自演进,而双向兼容(新客户端连老 broker、老客户端连新 broker)要成立,双方必须先对表。这套协商是连接建立后的第一件事;broker 侧跨着两个线程------网络层的 Processor 与 handler 侧的 KafkaApis,中间经 RequestChannel 交接。整套流程如下:
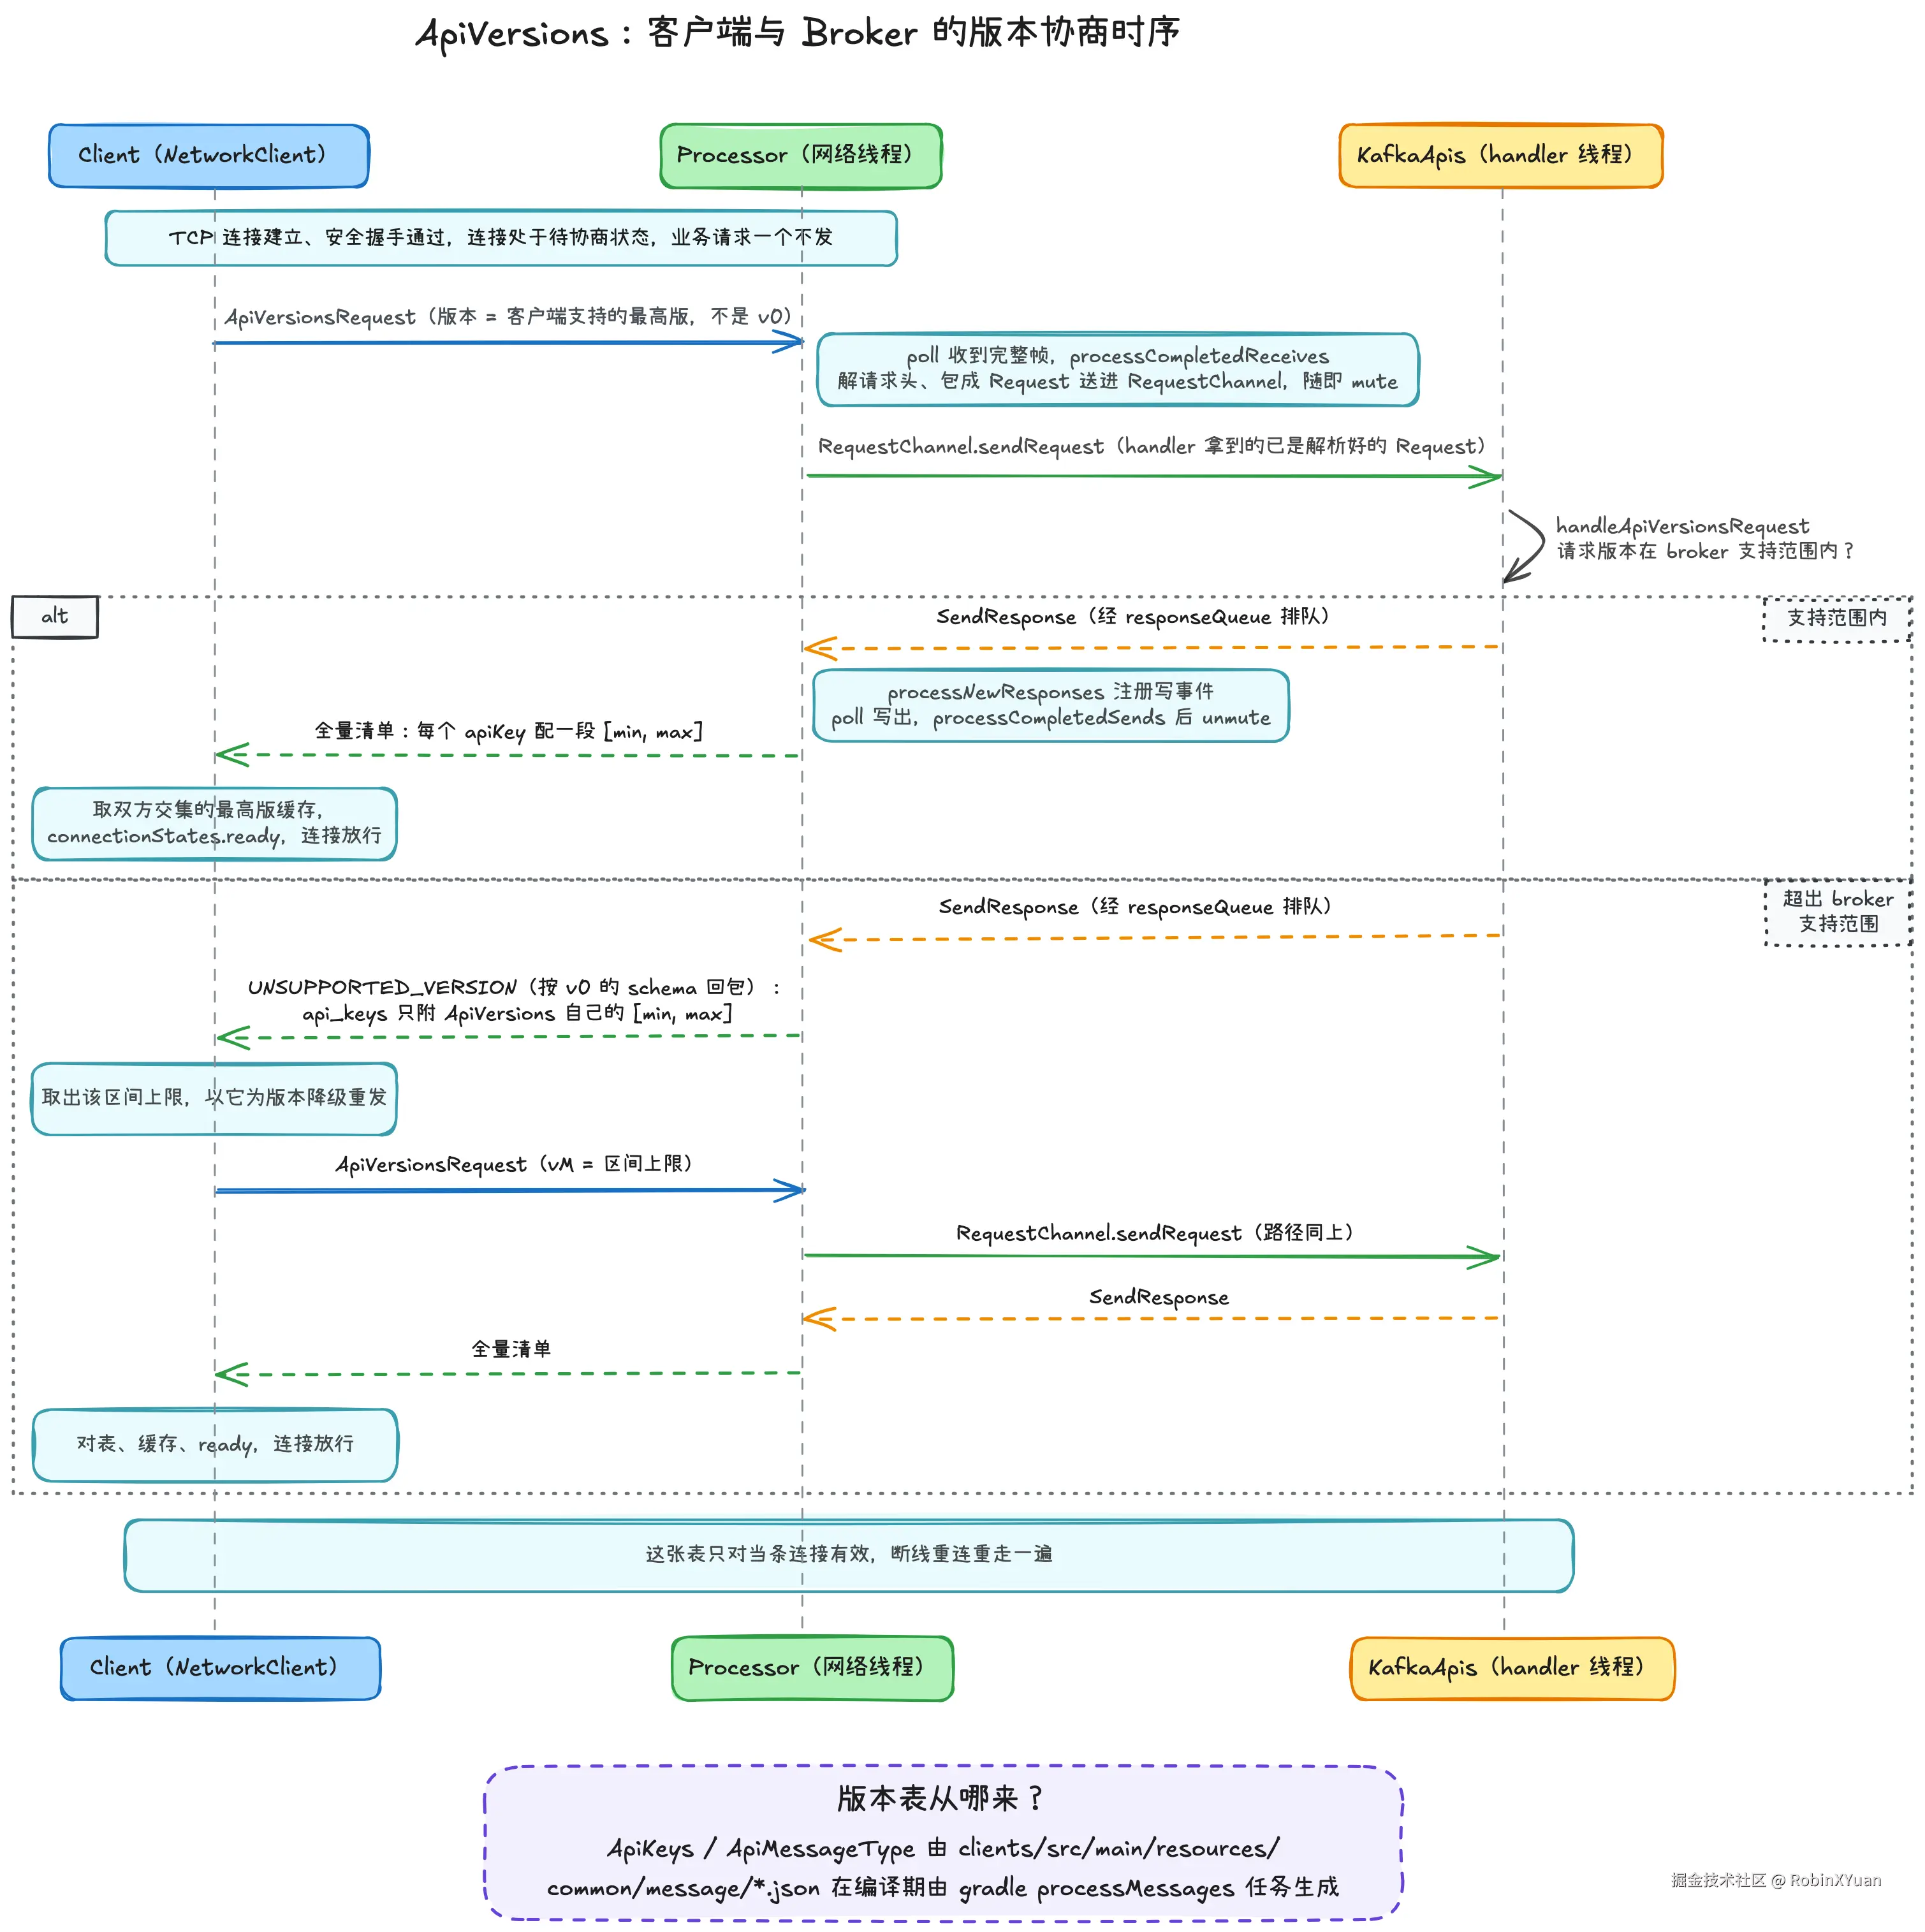
图中 broker 侧的两条竖线正是上一节的主角:Processor 管收发与 mute/unmute,KafkaApis 管判定与应答,一来一回正好走完七步循环的 ②③④⑤。时序的四个环节,逐一对应代码。
-
谁发起 :连接建立后,客户端在
handleConnections(clients/src/main/java/org/apache/kafka/clients/NetworkClient.java:1081 ,登记动作在 :1088 )里把节点放进待协商登记表nodesNeedingApiVersionsFetch,handleInitiateApiVersionRequests(:1097 )随后发出请求。有个细节需要留意:初始探测发的不是 v0,而是客户端自己支持的最高版本 。代码证据有两处:无参的new ApiVersionsRequest.Builder()给出的允许区间是[oldestVersion, latestVersion]全区间(clients/src/main/java/org/apache/kafka/common/requests/ApiVersionsRequest.java:40-44 );真正定版发生在doSend(NetworkClient.java:551 )------此刻还没有对表缓存,versionInfo为 null,走的是这段:javaNodeApiVersions versionInfo = apiVersions.get(nodeId); short version; // Note: if versionInfo is null, we have no server version information. This would be // the case when sending the initial ApiVersionRequest which fetches the version // information itself. ... if (versionInfo == null) { version = builder.latestAllowedVersion(); ... } else { version = versionInfo.latestUsableVersion(clientRequest.apiKey(), builder.oldestAllowedVersion(), builder.latestAllowedVersion()); }注释原话点破了场景:发初始 ApiVersions 时正是没有服务端版本信息的时刻,于是取 builder 的最高允许版;协商完成后再发请求,同一处代码走
else分支、按双方交集的最高可用版定版------「先按最高版发,拿不到再降」在doSend里一目了然。(这是NetworkClient的常规协商路径;上篇 SASL 认证里那一步的 ApiVersions 是另一回事,仍固定 v0,不要混为一谈。) -
broker 怎么回答 :core/src/main/scala/kafka/server/KafkaApis.scala:1518 的
handleApiVersionsRequest,三分支:
scala
def createResponseCallback(requestThrottleMs: Int): ApiVersionsResponse = {
  val apiVersionRequest = request.body[ApiVersionsRequest]
  if (apiVersionRequest.hasUnsupportedRequestVersion) {
    apiVersionRequest.getErrorResponse(requestThrottleMs, Errors.UNSUPPORTED_VERSION.exception)
  } else if (!apiVersionRequest.isValid) {
    apiVersionRequest.getErrorResponse(requestThrottleMs, Errors.INVALID_REQUEST.exception)
  } else {
    apiVersionManager.apiVersionResponse(requestThrottleMs, request.header.apiVersion() < 4)
  }
}
正常路径下 broker 回一张全量清单,每个 apiKey 配一段支持的 [min, max],客户端取交集的最高值使用;这张表只对当条连接有效,断线重连需要重拿。方法开头有一大段注释:broker 无论认证状态如何都答全表(SASL 握手前客户端就需要它,见上篇安全握手一节),代价是泄露 broker 版本信息,补救靠 SSL 双向认证提前把关。
- 谈不拢怎么办------这是协商体系自己的鸡生蛋问题 :
ApiVersions自己也是个 API,版本谈不拢时连「清单都拿不到」。解法分两端。
- broker 端,
ApiVersionsRequest的构造器注释(clients/src/main/java/org/apache/kafka/common/requests/ApiVersionsRequest.java:84-88 )写明了策略:收到比支持范围更新的版本,当作 v0 处理、按 v0 的 schema 回响应。于是getErrorResponse(:111 )在UNSUPPORTED_VERSION时会塞进一条特殊数据:
java
public ApiVersionsResponse getErrorResponse(int throttleTimeMs, Throwable e) {
    ApiVersionsResponseData data = new ApiVersionsResponseData()
        .setErrorCode(Errors.forException(e).code());
    // ...
    // Starting from Apache Kafka 2.4 (KIP-511), ApiKeys field is populated with the supported
    // versions of the ApiVersionsRequest when an UNSUPPORTED_VERSION error is returned.
    if (Errors.forException(e) == Errors.UNSUPPORTED_VERSION) {
        ApiVersionCollection apiKeys = new ApiVersionCollection();
        apiKeys.add(ApiVersionsResponse.toApiVersion(ApiKeys.API_VERSIONS));
        data.setApiKeys(apiKeys);
    }
    return new ApiVersionsResponse(data);
}
错误码是 UNSUPPORTED_VERSION,但 api_keys 列表里填上唯一一条------ApiVersions 自己支持的版本区间。
- client 端,NetworkClient.java:1023 的
handleApiVersionsResponse收到这个错误码后,从 v0 响应里取出那条区间,以区间上限为版本降级重发 (:1036-1043 );重发成功,apiVersions.update缓存对表、connectionStates.ready置连接就绪(:1052-1053)------协商完成之前,这条连接上别的请求一个也不许发。v0 由此成了这套握手的永久兜底,版本协商体系自己的引导程序。
- correlationId 为什么只是校验凭证 :表里把
correlationId的差事写成「校验」而非「配对」,原因两端各有一半。客户端侧真正的配对靠目的地:clients/src/main/java/org/apache/kafka/clients/InFlightRequests.java:34 用Map<节点, 在途请求队列>管理,响应到达时按来源节点从队列头取出(FIFO);correlationId只做一致性校验,对不上抛CorrelationIdMismatchException(clients/src/main/java/org/apache/kafka/common/requests/AbstractResponse.java:104-109 )。服务端侧更简单:mute 保证了单连接单在途,顺序本身就是配对。配对在两端都已有更强的机制兜底,correlationId剩下的差事就是在异步收发里抓住张冠李戴------这也是响应头把它原样带回的全部目的。
tagged fields:加字段而不升版本
版本区间再宽,schema 也不能每加一个字段就升一版。KIP-482(2.4.0 起)给出了另一条路:每个 API 从某个版本起成为「flexible」,请求头升到 v2、字符串与数组改用紧凑编码,消息末尾多出一个标签区------tagged fields。头版本的判定入口是 ApiKeys.requestHeaderVersion(clients/src/main/java/org/apache/kafka/common/protocol/ApiKeys.java:303 ),但方法体只有一行------委托给 messageType.requestHeaderVersion,又是前面 ApiKeys 一节那个编译期生成的 ApiMessageType。
它生成出来到底干什么,我们分两层来看。生成模板是 generator/src/main/java/org/apache/kafka/message/ApiMessageTypeGenerator.java:346 的 generateHeaderVersion(request 在 :178 调用、response 在 :180 ):对每个 API 生成一个 case,按 flexibleVersions 对请求版本做条件判断------落在 flexible 区间内,request 头返回 v2、response 头返回 v1,区间外则是 v1 与 v0;未知 apiKey 走 default 抛 UnsupportedVersionException(:387-391)。
模板里唯一的特例恰好呼应前面版本协商一节:ApiVersionsResponse(apiKey 18)无论版本多高,响应头固定 v0(:362-365 ,注释指名 KIP-511)------v0 兜底能成立,一半靠错误响应里附的那条版本区间,另一半靠这里把响应头也钉在最老版本,任何客户端都解析得了。而编译一遍之后,生成结果就落在 clients/build/generated/main/java/org/apache/kafka/common/message/ApiMessageType.java:755 的 requestHeaderVersion 里------case 18 的条件分支、:1194 处固定返回 0 的特例。
标签区的线上格式很朴素:一个 unsigned varint 写字段个数,随后每个字段三段------tag 编号(varint)、长度(varint)、内容字节。varint 的读写由 ByteUtils 提供(readUnsignedVarint,clients/src/main/java/org/apache/kafka/common/utils/ByteUtils.java:159 ;writeUnsignedVarint,:344)。
解析方拿到标签区怎么办?*Data 类是编译期生成的,但生成模板就在 generator/src/main/java/org/apache/kafka/message/MessageDataGenerator.java 里,读入模板(:476-530)产出的代码骨架是:
java
int _numTaggedFields = _readable.readUnsignedVarint();
for (int _i = 0; _i < _numTaggedFields; _i++) {
    int _tag = _readable.readUnsignedVarint();
    int _size = _readable.readUnsignedVarint();
    switch (_tag) {
        case 0: { /* 按 schema 解出对应字段 */ break; }
        // ...
        default:
            this._unknownTaggedFields = _readable.readUnknownTaggedField(this._unknownTaggedFields, _tag, _size);
            break;
    }
}
认识的 tag 按 schema 解;不认识的原样存进 _unknownTaggedFields,写出时由 RawTaggedFieldWriter.forFields(_unknownTaggedFields) 数进总数、逐段写回(写出模板 :707-882 ,未知字段的回收在 :783-784 )。也就是说,未知标签不是丢掉了事,而是原样穿过去------中间节点转发自己不理解的请求时,新加的字段不会在转发途中丢失。写出模板里还有个值得留意的细节:已知 tagged 字段先做非默认值检查(:763-766 ),值等于默认就整个不写------「不出现时一个字节都不花」落到代码上,就是 _numTaggedFields++ 之前的那道条件。
我们就以本节的主角为例。ApiVersionsResponse 的 v3 是第一个 flexible 版本,后来要加的四个字段没进主 schema、全部挂 tag(clients/src/main/resources/common/message/ApiVersionsResponse.json:48-77 ):SupportedFeatures(tag 0)、FinalizedFeaturesEpoch(tag 1)、FinalizedFeatures(tag 2)、ZkMigrationReady(tag 3)。不认识这些 tag 的客户端连上新 broker,跳过即可,响应照常解析------加字段时连版本号都没动。到 v4 才升了一版,修的还只是语义(KAFKA-17011:SupportedFeatures.MinVersion 为 0 时也要下发,ApiVersionsResponse.json:31 ),一个字段没加。v3 的版本注释里还有句要紧的话:tagged fields 只进 body 不进响应头,「头的长度不能变,以保证向后兼容」(:24-26 )------头是双方引导解析的起点,连 flexible 化都动它不得,这与前面 RequestHeader.parse 先「偷」看定长 apiKey/apiVersion 的逻辑是一体的两面。
FetchRequest 的 ClusterId(tag 0,12+,clients/src/main/resources/common/message/FetchRequest.json:64-66)则展示了另一半好处:consumer 通常不知道 clusterId,默认 null 就不带这个字段,需要时才写。
FetchResponse 的分区级还有一组:DivergingEpoch / CurrentLeader / SnapshotId(tag 0/1/2,12+,clients/src/main/resources/common/message/FetchResponse.json:79-101),leader 检测到 Follower 日志分叉、或需要指引快照时才在响应里附上,常态 fetch 一个都不带。
机制上就是把「以后可能要加的可选字段」从主 schema 挪进缓冲区:常用字段照旧定长定序、解析快,罕用字段挂标签、可忽略,加字段不必再动版本号。各 API 的 flexible 起点写在 schema json 的 flexibleVersions 字段里:Produce 9+、Fetch 12+、Metadata 9+、ApiVersions 3+。apiKey 定身份、apiVersion 定 schema、tagged fields 定「不破坏兼容的演进」、correlationId 做校验凭证------十五年协议的机制骨架就这么几句,后面讲 V2 消息格式时,会看到同一套思路在 RecordBatch 上的又一次落地。
为什么不用 Netty
看完了这一整篇文章,我们再回过头来看上篇开头留下的问题:为什么不用 Netty?
从事实上来看:
- 整个 4.3.1 的依赖树里没有 Netty------
clients模块的依赖清单(根 build.gradle 的project(':clients')块)只有 zstd、lz4、snappy、protobuf、opentelemetry proto、slf4j 这些,grep 全部构建文件无一处 netty。 - SocketServer.scala:864 显示
Processor直接实例化clients模块的org.apache.kafka.common.network.Selector,Broker 网络层不是「另一套 NIO」,而是与 Producer、Consumer 共用同一份传输层------成帧、TLS、SASL 的行为天然两端一致,修改一处两端受益。上篇安全握手一节里客户端与服务端代码同源同路径,就是这个事实的直接体现。
那么为什么呢?代码里没有注释直接回答,我的推断是:首先,clients 的定位是嵌进用户应用的轻量库,零传递依赖近乎硬约束,Netty 的体积和依赖面首先满足不了这一约束,而服务端没有理由为网络层单独维护一套与客户端割裂的实现;其次,历史时点也有影响------Kafka 起步于 2011 年前后,Netty 远未取得今天的事实标准地位;再加上 Kafka 协议自描述、成帧规则简单,不需要 Netty 编解码器生态解决的那类问题。
那么自己实现 NIO 的代价是什么呢?没有 ByteBuf 的池化与引用计数,没有现成的内存泄漏检测,传输层的性能优化全靠自己(Kafka 自己做了 MemoryPool,SocketServer.scala:97)。对一个把「客户端可嵌入」写进基因的系统,这笔交换大概率是划算的。这笔账值得算得更细,系列为此补了一条支线:06 篇讲 Java NIO 的原理,07 篇把 Kafka 的 KSelector 封装摊开,08 篇用 Netty 重写同一种成帧、逐点对照后回收本节的事实与推测。
为什么是划算的?Kafka 的 NIO 实现和 Netty 的实现有什么区别?NIO 的好处是什么?这一篇里我们没办法讲得更细,所以在讨论完 Acceptor、Processor 和 Handler 三者之后,我会再通过几篇文章继续深入 NIO 的内容。
小结
这篇文章的主角是 Processor,其网络层的主力是七步循环:configureNewConnections 收新连接、processNewResponses 处理响应、poll 推进事件,之后处理完成的读写与断连。一条连接同一时刻只有一个在途请求,靠的是 mute/unmute 对 OP_READ 的摘与戴------请求读出来就 mute,响应写出门才 unmute,配额节流复用的正是这套机制。线上的字节按「4 字节长度 + schema 自描述」成帧,请求头四字段定身份:apiKey 定 API、apiVersion 定 schema、correlationId 做校验凭证、clientId 供日志与配额分组;93 项 ApiKeys 背后是一套编译期生成的枚举,ApiVersions 先行对表、谈不拢有 v0 兜底,flexible 版本靠 tagged fields 演进。而这一切跑在与客户端同源的传输层代码上------KSelector 是带 Kafka 业务状态的 Selector,明确非线程安全,这是 mute 与节流必须在 Processor 线程执行的根。
请求进了 RequestChannel 之后呢?那条默认 500 容量的有界队列,满了会发生什么,handler 线程又怎么把每个请求的时间拆成七段可核对的账?下一篇接着看。
下一篇:Broker 网络层与请求处理(下):RequestChannel、handler 线程与七段账本。