第 2 章 函数:机器学习的积木
2.1 函数是什么:一台自动售货机
又从一个 debugging 故事说起。有位网友曾拿一段怎么调都不对的代码来找我:他写了 f(x) = 2*x + 1,然后在别处写了 fx 想表示"函数值",结果当然是 NameError。深挖下去才发现,他心里一直把 f(x) 当成 "f 乘以 x"------于是他以为函数值需要一个叫 fx 的变量存起来。这个误解小学就该修掉,但它安然活到了他学机器学习的那天。本章第一节就是冲着这类误解来的。
把硬币塞进售货机,饮料掉出来。投进什么,掉出什么,规则固定------这就是函数的全部本质。数学写法:
y=f(x)y = f(x)y=f(x)
读作:"y 等于 f 作用在 x 上"。xxx 叫自变量 (投进去的),yyy 叫因变量 (掉出来的),fff 是那台机器(规则)。
具体例子:f(x)=2x+1f(x) = 2x + 1f(x)=2x+1。投进 3,掉出 7:f(3)=2×3+1=7f(3) = 2 \times 3 + 1 = 7f(3)=2×3+1=7。
先破一个心理障碍 :f(x)f(x)f(x) 不是"f 乘 x",是"f 处理 x"。就像 sin(x)\sin(x)sin(x)、log(x)\log(x)log(x) 一样,它是"动作"不是"乘积"。很多初学者在这里默默犯错。
机器学习的本质视角 :一个模型就是一个函数 fff,数据 xxx 投进去,预测 y^=f(x)\hat{y} = f(x)y^=f(x) 掉出来;所谓"训练",就是自动调整这台机器内部的零件(参数),让它掉出来的东西越来越接近正确答案。
2.2 定义域与值域
- 定义域 :允许投进去的东西。f(x)=1xf(x) = \frac{1}{x}f(x)=x1 不许投 0(除以零);g(x)=lnxg(x) = \ln xg(x)=lnx 只许投正数。
- 值域 :可能掉出来的东西。h(x)=x2h(x) = x^2h(x)=x2 只会掉出非负数。
第 10 章讲交叉熵时会用到"概率的值域是 0 到 1"这句话;第 5 章 sigmoid 函数"值域是 (0,1)"是它能当概率用的原因。定义域值域不是形式主义,是函数的"使用说明书"。
2.3 函数的图像:把机器的说明书画出来
建立平面直角坐标系:横轴 x(投进),纵轴 y(掉出)。每个输入输出对 (x,y)(x, y)(x,y) 是平面上的一个点,把所有点连起来就是图像。
描点法 画 f(x)=2x+1f(x) = 2x + 1f(x)=2x+1:
| x | -1 | 0 | 1 | 2 |
|---|---|---|---|---|
| y | -1 | 1 | 3 | 5 |
描出 4 个点,连线------一条直线。看图能读出的信息比式子更直观:x 每增加 1,y 增加 2;直线向右上方爬。这就是下一节的主角。
2.4 一次函数:线性模型的原型
f(x)=wx+bf(x) = wx + bf(x)=wx+b
(很多书写 y=kx+by = kx + by=kx+b 或 y=mx+by = mx + by=mx+b,同一个东西,本书用机器学习记号 www、bbb。)
- www 是斜率 :x 每走 1 步,y 变化多少。w=2w=2w=2 时每步涨 2;w=−1w=-1w=−1 时每步降 1(直线向右下);w=0w=0w=0 时是水平线。
- bbb 是截距:x = 0 时 y 的值,即直线和 y 轴交点的高度。
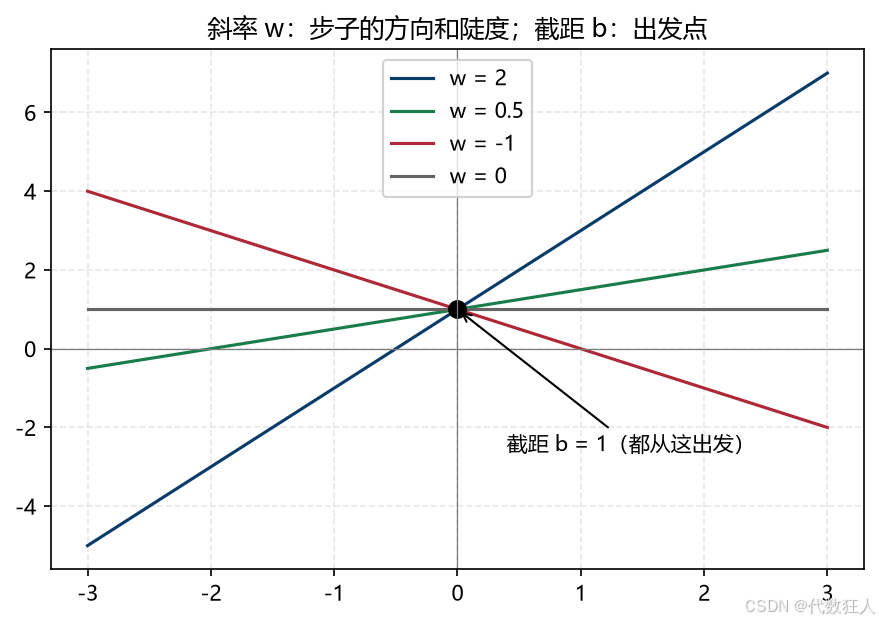
图 2-1:斜率 w 控制方向和陡度,截距 b 是共同的出发点
手算:f(x)=2x+1f(x) = 2x + 1f(x)=2x+1 中 w=2,b=1w=2, b=1w=2,b=1。f(0)=1f(0) = 1f(0)=1(截距),f(1)−f(0)=2f(1)-f(0) = 2f(1)−f(0)=2(斜率)。
现在就把这句话钉在墙上:
机器学习中最基础的模型"线性回归"就是一个一次函数 f(x)=wx+bf(x) = wx + bf(x)=wx+b,训练就是让机器自己找 w 和 b。
房价预测:面积 x(平米),价格 y(万)。真实数据不会完美落在一条线上,但"找一条最贴近所有点的直线"就是线性回归的全部------"最贴近怎么量化"需要第 5、6 章的导数和梯度(损失 = 直线和点的垂直距离平方和,找让它最小的 w、b)。
两个一次函数:www 相同则平行(斜着爬的步调一致),www 不同则相交。
2.5 二次函数:损失函数的形状
f(x)=x2f(x) = x^2f(x)=x2
图像是开口向上的抛物线(碗)。关键特征:最低点在 x = 0 ,离 0 越远函数值越大。机器学习里几乎所有的"损失函数"(衡量模型烂不烂的函数)都被刻意设计成碗状------为什么?因为碗有一个独一无二的最低点,机器可以顺着碗壁往下滑(第 6 章梯度下降)直到碗底,那是最优参数所在。
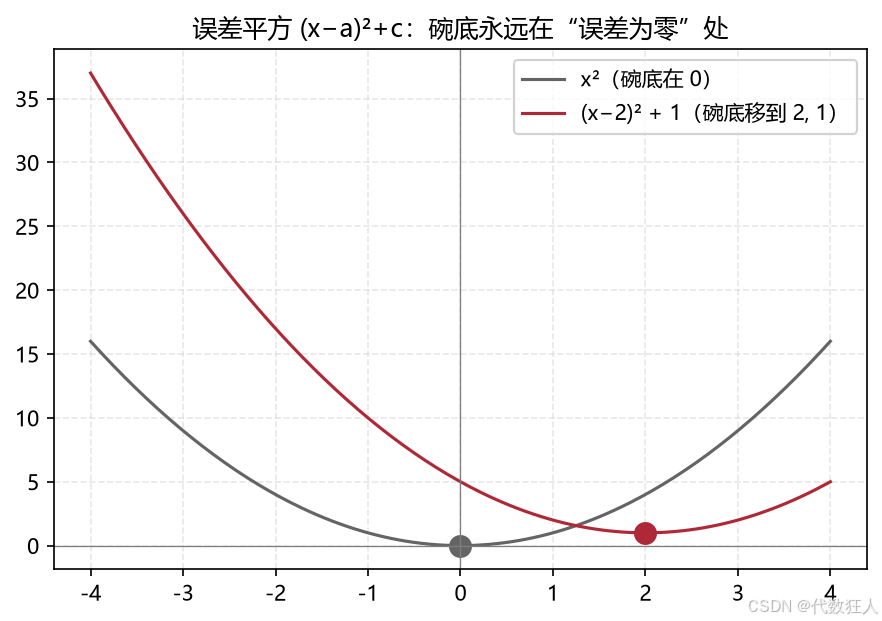
图 2-2:误差平方函数是一只碗,碗底永远在"误差为零"处
推而广之:
f(x)=(x−a)2+cf(x) = (x - a)^2 + cf(x)=(x−a)2+c
的碗底平移到了 x=ax = ax=a、高度 ccc。机器学习最爱出现的式子 (y^−y)2\left(\hat{y} - y\right)^2(y^−y)2(预测误差的平方)就是这种:预测和真实完全一致时取 0(碗底),偏得越远惩罚平方级增长。
顶点公式(配方法结论,过程了解即可):f(x)=x2−4x+5f(x) = x^2 - 4x + 5f(x)=x2−4x+5 配方成 (x−2)2+1(x-2)^2 + 1(x−2)2+1,碗底在 (2, 1)。平方展开(第 1 章的看家本领)在这里用第二次。
2.6 分段函数与 ReLU:神经网络的基础零件
分段函数 = 不同区间执行不同规则:
f(x)={0x<0xx≥0f(x) = \begin{cases} 0 & x < 0 \\ x & x \geq 0 \end{cases}f(x)={0xx<0x≥0
x 是负数时一律输出 0;是正数时原样输出。这就是 ReLU------当今神经网络里用得最多的激活函数(原书第 11 章)。它的图像:左半边贴着横轴睡觉,右半边是 45 度直线。
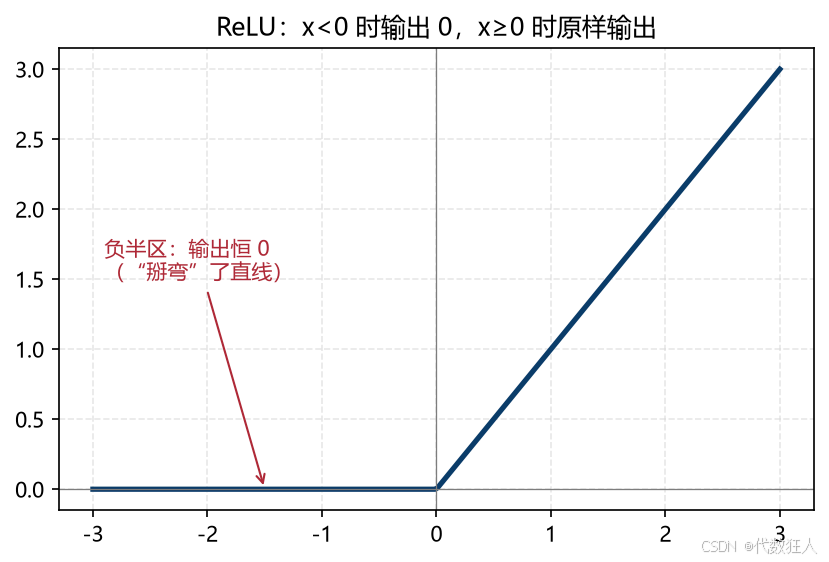
图 2-3:ReLU------左半边睡觉,右半边 45 度直线
为什么神经网络需要它?一句话直觉:如果网络里全是线性函数(一次函数),千层叠加复合出来还是一次函数(直线套直线还是直线!),永远表达不了弯曲的规律;ReLU 在负半区"掰弯"了直线,让网络能表达非线性关系。第 5 章会推导它的导数(一个更简洁到令人发笑的函数)。
2.7 指数函数: explosive 的增长
f(x)=2xf(x) = 2^xf(x)=2x
描点:2−2=0.252^{-2}=0.252−2=0.25,2−1=0.52^{-1}=0.52−1=0.5,20=12^0=120=1,21=22^1=221=2,22=42^2=422=4,23=82^3=823=8。图像:先贴地爬行,过 0 之后陡然起飞------翻倍增长。
直观感受:一张纸对折 1 次 2 层,对折 42 次的厚度超过地月距离。指数增长的可怕之处在于"起步毫不起眼,后期不可阻挡"。反过来 2−x2^{-x}2−x 是指数衰减:起步很高,迅速趴下,无限接近 0 但永远不等于 0。
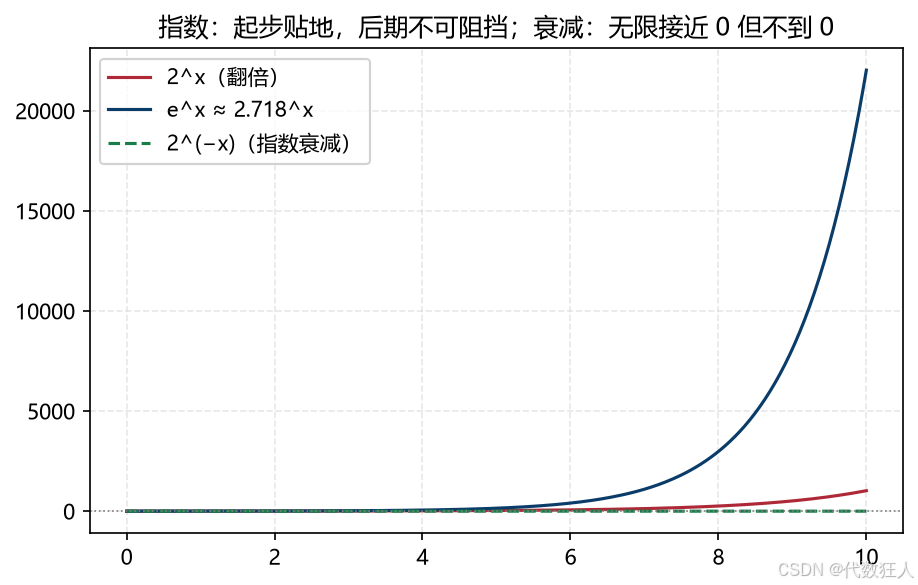
图 2-4:指数增长、自然指数与指数衰减
e 和自然指数
下面这个"银行结息"的故事是 e 的各种来历里我最喜欢的一个,因为它把一个抽象常数变成了一件你几乎能亲身参与的事。我第一次真正记住 e 就是靠它,此后再没忘过。
以 e≈2.71828...e \approx 2.71828\ldotse≈2.71828... 为底的指数 exe^xex 叫自然指数。e 从哪来?一个直觉故事:1 万元存银行,年利率 100%。一年结一次息,年底 2 万。如果一年结两次(每次 50%):1×(1.5)2=2.251 \times (1.5)^2 = 2.251×(1.5)2=2.25 万。结四次(每次 25%):(1.25)4≈2.44(1.25)^4 \approx 2.44(1.25)4≈2.44 万。结息越频繁,年底越多,但涨速有天花板 ------无限次复利的极限正是 e1≈2.718e^1 \approx 2.718e1≈2.718。
e=limn→∞(1+1n)n≈2.71828e = \lim_{n \to \infty} \left(1 + \frac{1}{n}\right)^n \approx 2.71828e=n→∞lim(1+n1)n≈2.71828
为什么机器学习偏爱 e?两大理由(数学的深刻原因在第 5、9 章揭晓):exe^xex 是唯一一个"导数等于自己"的函数 (求导不变,连乘链里最省心);连续复利的直觉天然匹配"连乘概率"的场合。第 5 章 sigmoid 里它第一次登场。
2.8 对数函数:把爆炸压回人间
f(x)=log2xf(x) = \log_2 xf(x)=log2x
描点:log20.5=−1\log_2 0.5 = -1log20.5=−1,log21=0\log_2 1 = 0log21=0,log22=1\log_2 2 = 1log22=1,log28=3\log_2 8 = 3log28=3,log21024=10\log_2 1024 = 10log21024=10。
看数值:x 从 2 涨到 1024(512 倍!),y 只从 1 涨到 10。对数是"压缩机" ------把天文数字压成 manageable 的数。它的图像和指数函数的图像关于直线 y=xy = xy=x 互为镜像(互为反函数的两个函数都这样,见 2.10 节)。
机器学习应用场景:数据里有一个特征范围 1~1000000(比如收入),其他特征范围 0~10------直接训练会被大特征支配。取 ln\lnln 后变成 0~13.8,和邻居们量级就齐了。这是特征工程里的"对数变换",你在《机器学习实战》第 2 章会遇到它。
2.9 复合函数:流水线(全书最重要的一节之一)
h(x)=f(g(x))h(x) = f(g(x))h(x)=f(g(x))
先过机器 g,出来的结果再投进机器 f------两道工序的流水线。数值例子:g(x)=x+1g(x) = x + 1g(x)=x+1,f(x)=x2f(x) = x^2f(x)=x2,则:
h(x)=f(g(x))=(x+1)2,h(2)=f(3)=9h(x) = f(g(x)) = (x+1)^2, \quad h(2) = f(3) = 9h(x)=f(g(x))=(x+1)2,h(2)=f(3)=9
顺序不能反:g(f(x))=x2+1g(f(x)) = x^2 + 1g(f(x))=x2+1,g(f(2))=5≠9g(f(2)) = 5 \neq 9g(f(2))=5=9。复合不满足交换律,就像先穿袜子再穿鞋 ≠ 先穿鞋再穿袜子。
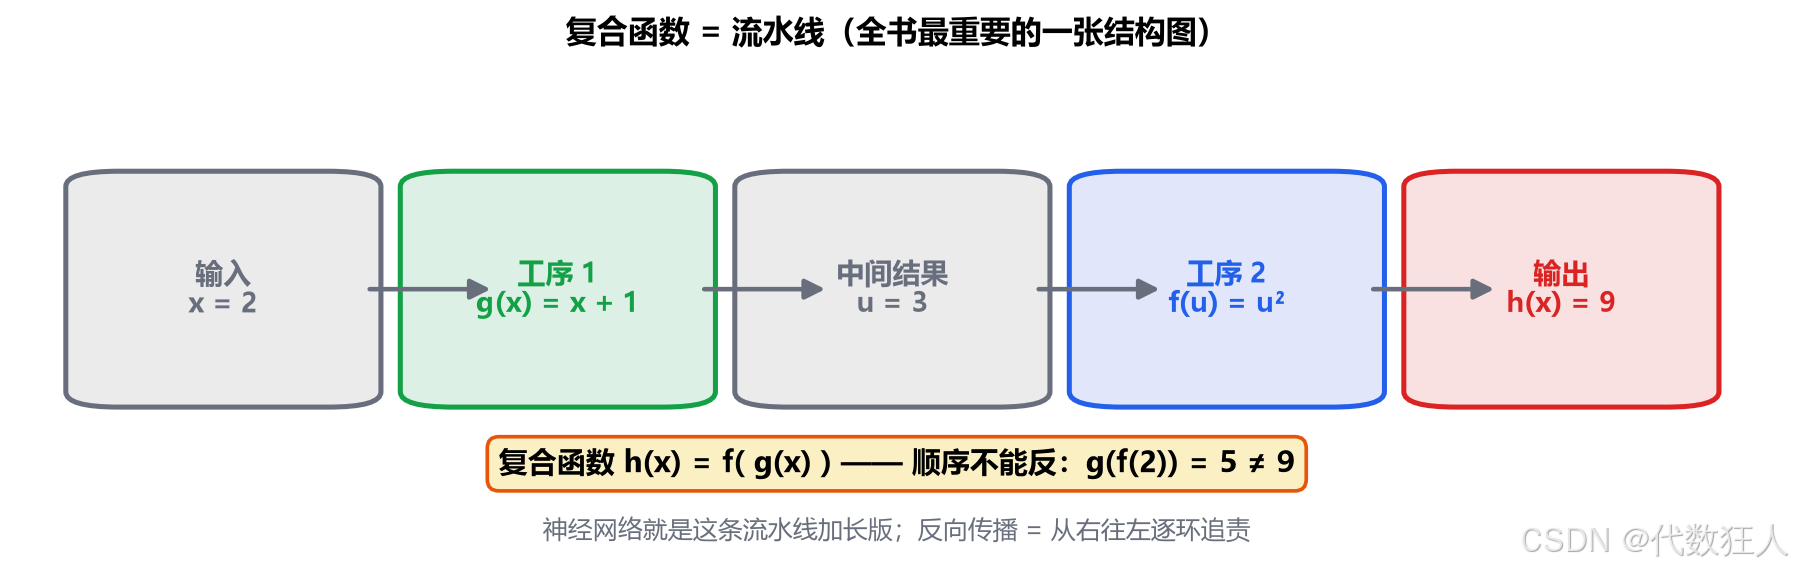
图 2-5:复合函数 = 流水线------两道工序,顺序不能反
(这个比喻是我上学时一位老师随口说的,好比喻就是这样,比定理还长寿。)
为什么这一节是全书最重要之一 :一个神经网络就是一条复合函数流水线。两层网络 = f(g(x))f(g(x))f(g(x)),八层网络 = 八道工序。而"反向传播"这个深度学习的核心机制,名字里的"传播"就是在问:流水线最后一道工序的输出错了,每道工序各自该负多少责任? 回答这个问题用的数学叫链式法则(第 5 章的重头戏)。你在第 11 章会亲手对一条三道工序的流水线做"责任分摊"。
2.10 反函数:拆开黑盒
f(x)=2xf(x) = 2xf(x)=2x 的反函数是 f−1(y)=y2f^{-1}(y) = \frac{y}{2}f−1(y)=2y:投 3 得 6,反机器投 6 得 3。反函数就是把"输出"还原回"输入"的机器 。判断方法:f(f−1(x))=xf(f^{-1}(x)) = xf(f−1(x))=x。
- exe^xex 与 lnx\ln xlnx 互为反函数(ln(e2)=2\ln(e^2) = 2ln(e2)=2);
- x2x^2x2(仅限 x≥0)与 x\sqrt{x}x 互为反函数。
记号警报 :f−1f^{-1}f−1 是反函数,不是 1f\frac{1}{f}f1 (负一次方)。上下文会区分------机器学习书里 σ−1\sigma^{-1}σ−1 指反函数。
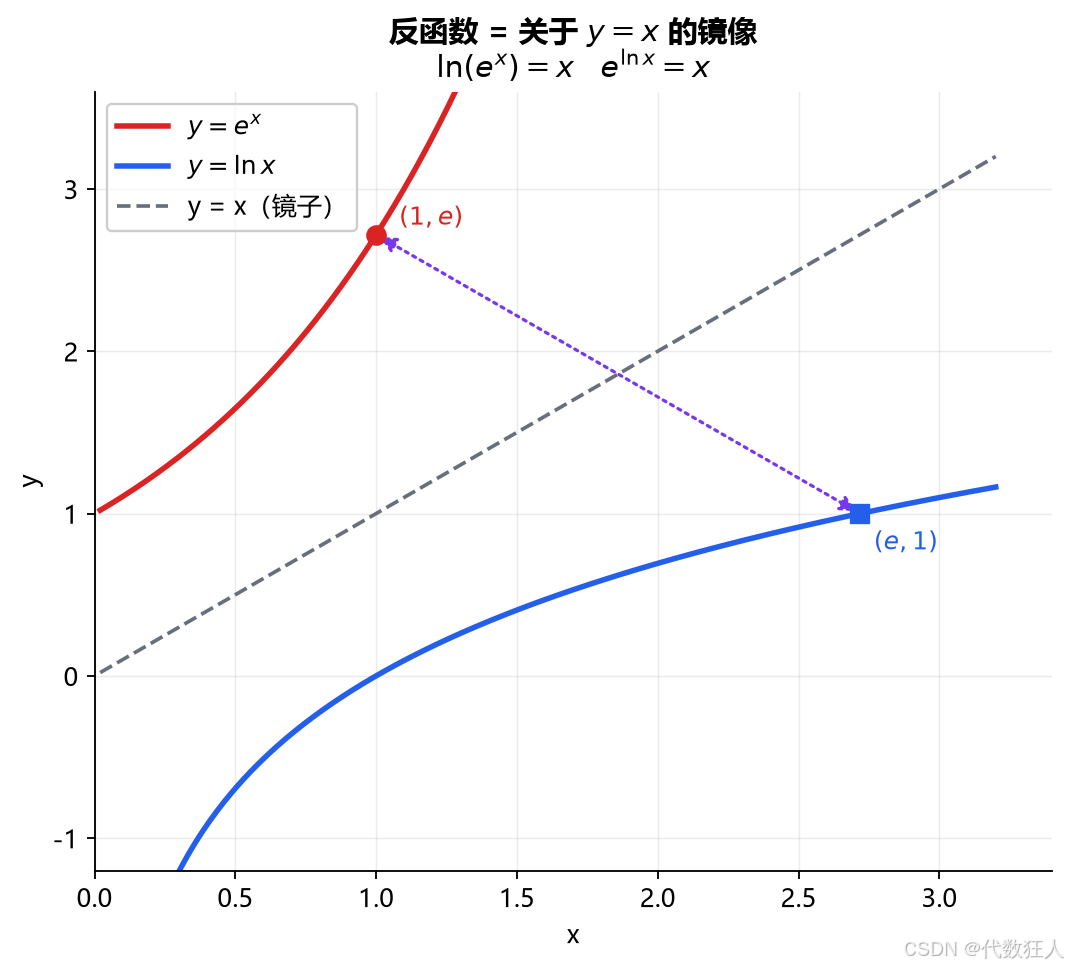
图 2-6:反函数关于 y = x 互为镜像------eˣ 与 ln x 互为反函数
一个机器学习冷知识:如果最后一道工序是 σ(x)\sigma(x)σ(x)(把任意数压成 0~1 的概率),而你手里有"已知的概率答案 p",想反推出这道工序该收到多少输入,就要用反函数 σ−1(p)\sigma^{-1}(p)σ−1(p)(这就是逻辑回归的"对数几率",原书第 4 章)。函数与反函数是同一个知识的两面。
2.11 用 Python 画出它们(10 分钟上手)
不需要任何深度学习库,NumPy + Matplotlib 就够。强烈建议亲手跑一遍------改改参数看图像变化,是建立函数直觉最快的方式:
python
import numpy as np
import matplotlib.pyplot as plt


plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei', 'Arial Unicode MS']
plt.rcParams['axes.unicode_minus'] = False


x = np.linspace(-3, 3, 400)
x_log = np.linspace(0.01, 3, 400)

plt.figure(figsize=(9, 6))


plt.plot(x, 2*x + 1, color='tab:blue', label="2x+1  (一次/匀速爬坡)")
plt.plot(x, x**2,      color='tab:red',  label=r"$x^2$      (二次/碗)")
plt.plot(x, 2**x,      color='tab:green',label=r"$2^x$      (指数/起飞)")
plt.plot(x_log, np.log2(x_log), color='tab:orange', label=r"$\log_2(x)$ (对数/慢慢爬升)")

plt.ylim(-4, 10)
plt.xlim(-3, 3)
plt.axhline(0, color="black", lw=0.8)
plt.axvline(0, color="black", lw=0.8)

plt.legend()
plt.grid(alpha=0.3)
plt.title("四种性格的函数:直线、碗、爆炸、压缩机")
print(plt.show())输出:四条曲线同框------直线匀速爬、抛物线成碗、指数函数右侧起飞、对数函数缓慢爬升。这张图值得存在脑子里:第 11 章讨论"损失为什么这么设计"时,四种形状就是四种候选性格。
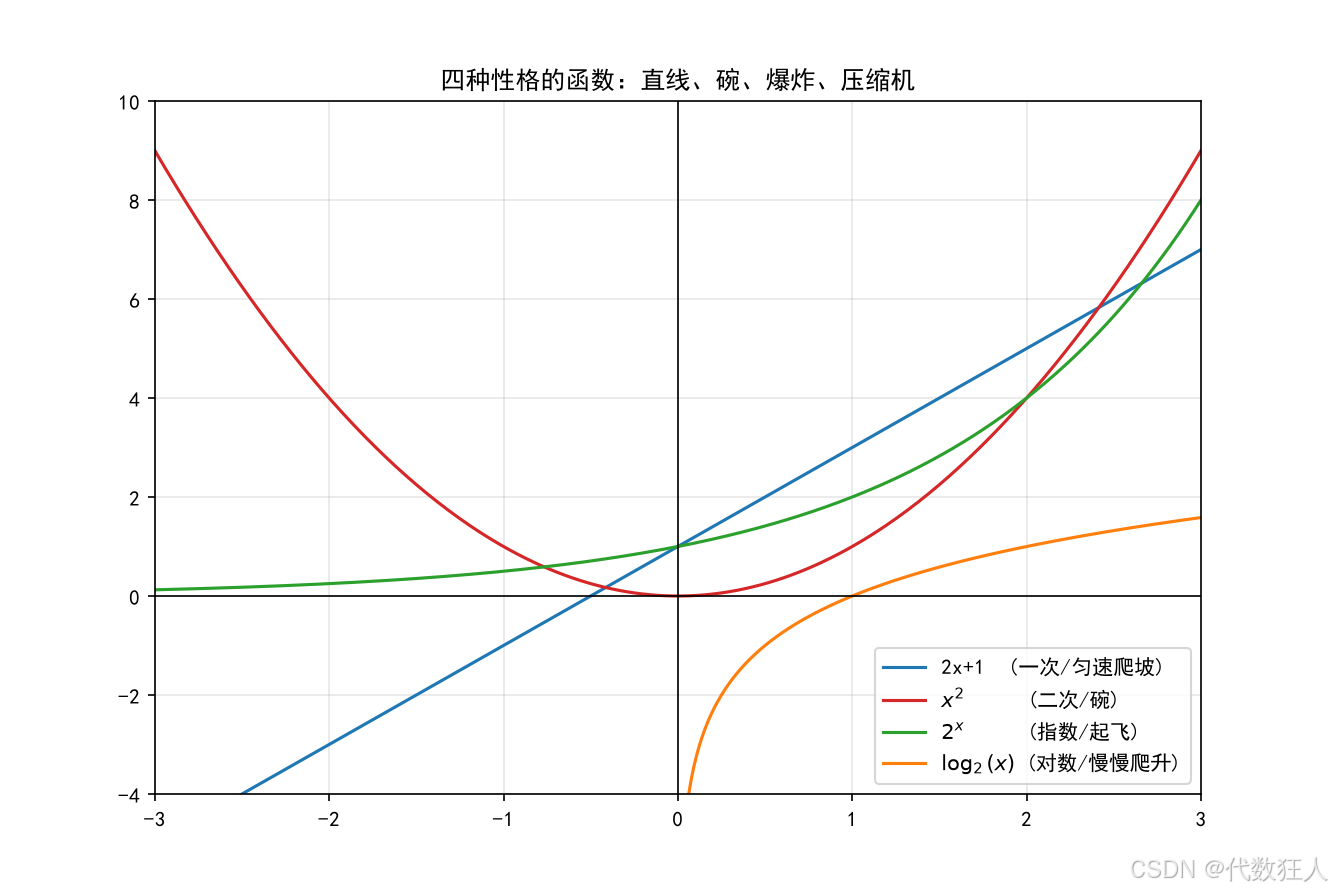
图 2-7:四种性格的函数全家福(对着它背:直线、碗、爆炸、压缩机)
2.12 本章小结
- 函数 = 规则固定的机器;f(x)f(x)f(x) 是"动作"不是乘法
- 一次函数 wx+bwx+bwx+b 就是线性回归;www 是步幅(斜率),bbb 是起点(截距)
- 误差平方 (y^−y)2(\hat{y}-y)^2(y^−y)2 是碗状函数------"唯一最低点"是所有优化故事的舞台
- ReLU 是分段函数;指数爆炸、对数压缩、二者互为镜像
- 复合函数 = 流水线 = 神经网络的结构;链式法则将拆解流水线的责任(第 5 章)
- 反函数拆黑盒;f−1f^{-1}f−1 不是倒数
2.13 练习(答案在本章末尾)
- f(x)=3x−2f(x) = 3x - 2f(x)=3x−2,求 f(4)f(4)f(4)、f(0)f(0)f(0),并说出斜率和截距。
- 画 f(x)=−2x+3f(x) = -2x + 3f(x)=−2x+3 的草图(x 从 -1 到 2 取 4 个点),直线向哪个方向倾斜?
- 把 x2+6x+10x^2 + 6x + 10x2+6x+10 配方成 (x+a)2+c(x+a)^2 + c(x+a)2+c 的形式,指出碗底坐标。
- g(x)=x−5g(x) = x - 5g(x)=x−5,f(x)=x2f(x) = x^2f(x)=x2。求 f(g(7))f(g(7))f(g(7)) 和 g(f(7))g(f(7))g(f(7)),两者相等吗?
- h(x)=11+e−xh(x) = \frac{1}{1+e^{-x}}h(x)=1+e−x1(sigmoid 预告)。计算 h(0)h(0)h(0)、h(10)h(10)h(10)、h(−10)h(-10)h(−10)(用计算器),观察它把大数小数压成什么范围。
- 说出 f(x)=ln(x)f(x) = \ln(x)f(x)=ln(x) 的定义域,以及 f(1)f(1)f(1) 等于多少。
- 设计一个分段函数,满足:x < 1 时输出 0,x ≥ 1 时输出 x。(它在第 11 章有个名字,猜猜是什么的亲戚?)
练习答案
- f(4)=10f(4) = 10f(4)=10,f(0)=−2f(0) = -2f(0)=−2;斜率 w=3w = 3w=3,截距 b=−2b = -2b=−2。
- 取点 (-1, 5), (0, 3), (1, 1), (2, -1)。直线向右下方倾斜(w=−2<0w = -2 < 0w=−2<0)。
- x2+6x+9+1=(x+3)2+1x^2 + 6x + 9 + 1 = (x+3)^2 + 1x2+6x+9+1=(x+3)2+1,碗底 (−3,1)(-3, 1)(−3,1)。
- f(g(7))=f(2)=4f(g(7)) = f(2) = 4f(g(7))=f(2)=4;g(f(7))=g(49)=44g(f(7)) = g(49) = 44g(f(7))=g(49)=44。不相等------复合不可交换。
- h(0)=11+1=0.5h(0) = \frac{1}{1+1} = 0.5h(0)=1+11=0.5;h(10)≈0.99995h(10) \approx 0.99995h(10)≈0.99995;h(−10)≈0.0000455h(-10) \approx 0.0000455h(−10)≈0.0000455。它把任意实数压进 (0, 1),且 0 输入恰好输出 0.5------这是它能在机器学习里当"概率发生器"的原因(第 5 章正式介绍)。
- 定义域 (0,+∞)(0, +\infty)(0,+∞)(正数);f(1)=0f(1) = 0f(1)=0。
- f(x)=0f(x) = 0f(x)=0(x<1);f(x)=xf(x) = xf(x)=x(x≥1)。它和 ReLU 是"表亲":ReLU 的拐点在 0,这个的拐点在 1------机器学习里管这叫 Leaky 变体家族。
必要工具
Python 解释器:可以从 Python 官网 下载,或通过 pyenv / conda 等版本管理工具安装。
JetBrains PyCharm(推荐)
跨平台支持一等公民(Windows, macOS, Linux 体验一致),社区版开源免费,专业版提供完整 Web/数据科学支持。https://www.jetbrains.com/pycharm/
选择 PyCharm 的理由
如果你主要在 macOS 或 Linux 上进行 Python 开发,请选择 PyCharm 集成开发环境。
如果你的项目涉及 Django / Flask / FastAPI 等 Web 框架,或 数据科学 / 机器学习(Jupyter、Pandas、NumPy),请选择 PyCharm Professional 集成开发环境。
你非常看重 IDE 对 大型 Python 项目的代码索引速度、智能补全和重构能力,尤其是在多模块/微服务架构下,请选择 PyCharm 集成开发环境。
你需要开箱即用的 虚拟环境管理、依赖解析、远程开发(Remote Dev)和数据库工具 深度集成,请选择 PyCharm 集成开发环境。
中型到大型项目流畅度 大型项目索引/重构/补全 PyCharm 的核心竞争力是对 Python 动态类型的静态分析能力,而非单纯的响应速度
提示:如果你的 Python 项目同时涉及前端(JS/TS)或容器化部署,PyCharm Professional 已内置相关支持,无需额外安装 WebStorm 或 Docker 插件。若仅做纯脚本/算法开发,免费的 Community Edition 已完全足够。