你 CREATE DATABASE 建完数据库,转头就 INSERT 用户数据,会吃一记报错:ERROR 1046 (3D000): No database selected。因为数据库一行数据都不存,它只是个"文件夹"。
这篇带你从零建一张 user_info 用户表:库、表、字段、记录、主键五个概念顺着一条线全串明白,每一步都能自己跑、自己验。
文章目录
-
- 一、数据到底存在哪儿?数据库(Database)只是个"文件夹"
- 二、谁真正装数据?数据表(Table)
- 三、空表的"形状"由谁定?字段(列,Column)
- 四、人怎么"进表"?记录(行,Row)
- [五、两行数据"撞号"了怎么办?主键(Primary Key)](#五、两行数据“撞号”了怎么办?主键(Primary Key))
- 六、回头串一遍:用户数据是怎么被安放好的
- 写在最后
一、数据到底存在哪儿?数据库(Database)只是个"文件夹"
很多新手以为数据是"放进数据库里"的。不是。
MySQL 的存储是一层套一层的结构:MySQL 服务实例 → 数据库 → 数据表 → 字段/列、记录/行 → 主键。
最外层的 MySQL 服务实例,就是你装好 MySQL 后启动的那个服务进程,库是它下面隔出来的房间。库里也不只有表,视图、索引、存储过程这些对象都归库管,但业务数据只落在表里。
我习惯用写字楼打比方,一次就能记牢:
- MySQL 服务是一栋写字楼;
- 数据库(Database)是楼里的独立办公室,一间办公室放一类业务数据;
- 数据表是办公室里的档案柜,一个柜子对应一类具体数据;
- 字段是每份档案上的固定栏目,姓名、年龄、手机号;
- 记录是一张填好的档案单据;
- 主键是单据上的唯一编号,保证不重复、能精准定位。
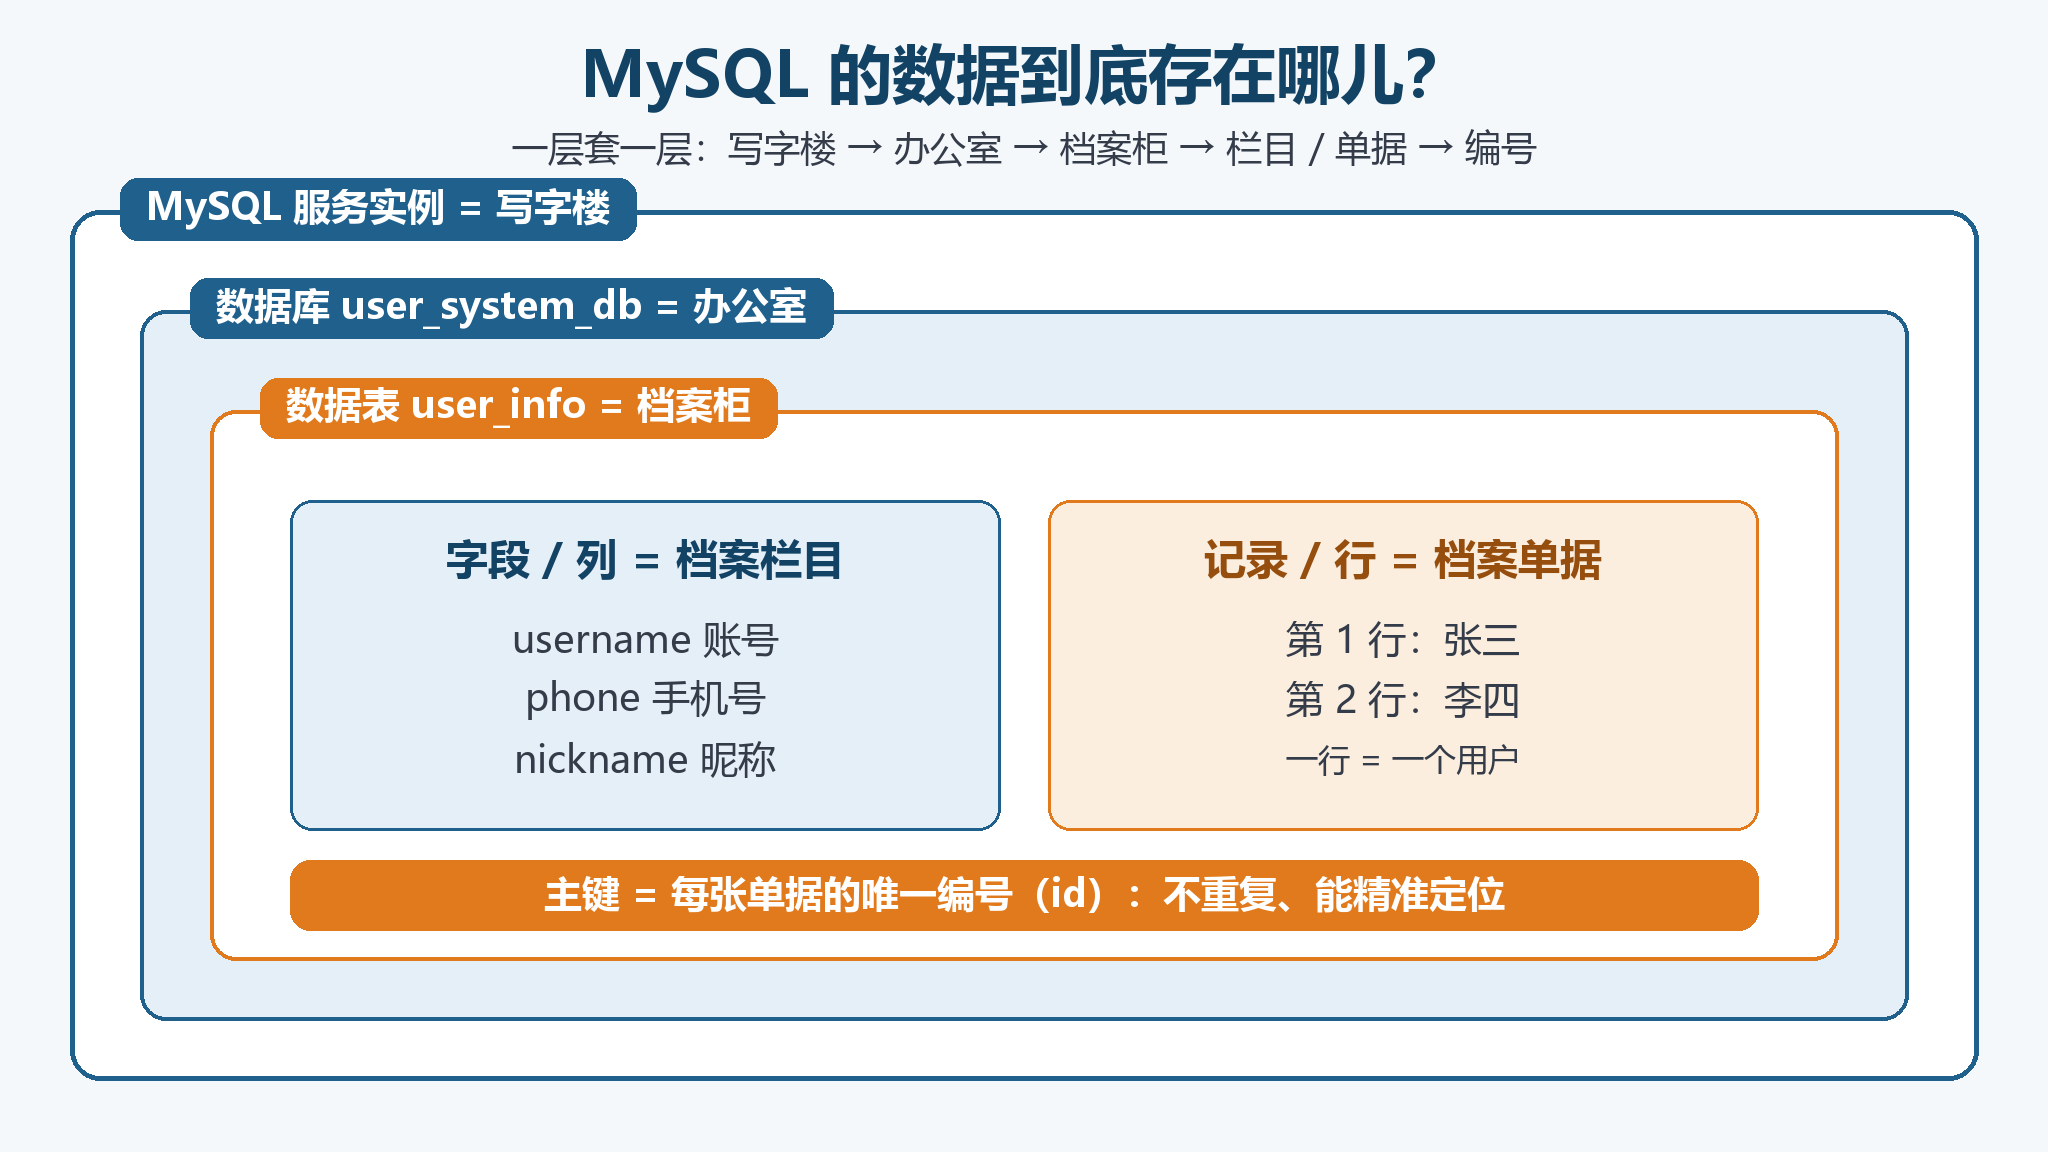
实际项目里就一条规矩:一项目一数据库 。用户表、订单表、商品表、评论表,同一个项目的表全放一个库里;商城用 shop_db、博客用 blog_db,两个库互相独立、权限能单独配,数据不会串。
反过来,一个库里混着好几个项目的表,备份时不知道该带谁、权限没法按项目分,迟早出事故。库名也按项目起,user_system_db 一看就是用户系统的库。
为什么要拆库?三个好处,都是踩出来的:各库相互独立、数据互不干扰,权限还能单独配------你可以让 A 项目的账号只碰得到 shop_db,连 blog_db 的门都摸不到;同一个业务的表、索引、触发器归在一个库里,备份、迁移都按项目整体走,不用一张张表操心。
库还能单独指定字符集和排序规则:字符集决定能存什么字,排序规则决定字怎么比、怎么排。中文乱码、排序异常,都在这一层解决。
来,亲手把"办公室"盖出来,命令适配 MySQL 8.0:
sql
SHOW DATABASES;
CREATE DATABASE IF NOT EXISTS user_system_db
  DEFAULT CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;
USE user_system_db;
SELECT DATABASE();
✅ 验证 :最后一条返回
user_system_db,说明你已经"走进这间办公室",后面的操作才会落在这个库里;不USE就插数据,就是开头的 1046 报错。
这里指定 utf8mb4:一个字符最多 4 字节,所有中文、表情符号都存得下。
⚠️ 坑 :
DROP DATABASE会连库带表带数据一起清空,且不可回滚。练手库随便删,生产库碰都别碰。
记住:数据库是"办公室",只做隔离和归类,本身不存一行业务数据。
办公室有了,可数据总不能摊在地上------得往屋里摆档案柜。柜子,就是数据表。
二、谁真正装数据?数据表(Table)
数据表(Table)才是真正存储业务数据的基本单元。库只管表,用户信息、订单信息、商品信息,全存在表里。
表是一张二维的行列表格,结构规整、好查好管。一个库里可以放几十上百张表,每张表负责一个维度的数据。
而且你往后写的绝大多数 SQL------增、删、改、查------操作对象都是表。库是后勤,表才是前线。
设计上遵循单一职责 :一张表只存一类核心业务数据。我们要建的 user_info 只存注册用户的基础信息------账号、密码、昵称、手机号、注册时间、状态;订单、权限这些维度另开表。表混着用,字段越堆越多,查询、维护一起受罪。
先把柜子打出来:
sql
CREATE TABLE IF NOT EXISTS user_info (
    id INT COMMENT '用户唯一ID(主键)',
    username VARCHAR(30) NOT NULL COMMENT '用户登录账号',
    password VARCHAR(64) NOT NULL COMMENT '用户登录密码',
    nickname VARCHAR(20) DEFAULT '' COMMENT '用户昵称',
    phone CHAR(11) DEFAULT '' COMMENT '用户手机号',
    create_time DATETIME DEFAULT CURRENT_TIMESTAMP COMMENT '注册时间',
    status TINYINT DEFAULT 1 COMMENT '账号状态:1正常 0禁用'
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='用户信息基础表';
注意看第一行 id 的注释写着"主键",但这张表其实没有主键------我故意的,先卖个关子。
💡 要点 :注释只是给人看的文字,
PRIMARY KEY约束才真正生效。现在执行SELECT * FROM user_info;,只回你Empty set:柜子和栏目都有了,里面一张单据都没有。
记住:表才是真正装数据的柜子,一张表只管一类业务。
柜子有了,那"姓名栏、手机号栏"这些格子,是怎么定下来的?
三、空表的"形状"由谁定?字段(列,Column)
表的栏目,就是字段 ,也叫列(Column) 。它是表中纵向的属性维度,说白了就是表头------规定这张表能存哪些维度、每个维度什么格式。
每个字段有五样东西:字段名、数据类型、约束条件、默认值、注释。字段名在一张表里不能重,就像一张档案上不能印两个"姓名"栏;数据类型和约束,则把每栏能填什么焊死。对照刚建的表:
| 字段 | 类型 | 约束 / 默认 | 含义 |
|---|---|---|---|
| id | INT | --- | 用户唯一 ID |
| username | VARCHAR(30) | NOT NULL | 登录账号 |
| password | VARCHAR(64) | NOT NULL | 登录密码 |
| nickname | VARCHAR(20) | DEFAULT '' | 用户昵称 |
| phone | CHAR(11) | DEFAULT '' | 手机号 |
| create_time | DATETIME | DEFAULT CURRENT_TIMESTAMP | 注册时间 |
| status | TINYINT | DEFAULT 1 | 1 正常 / 0 禁用 |
顺带看两个细节:每个字段都带 COMMENT 注释,表尾还有 COMMENT='用户信息基础表'------日后翻到这张表,一眼知道它存什么。
类型不是随便挑的,我说下我的判断:
- 手机号固定 11 位,用
CHAR(11)定长,不浪费、比较快; - 账号、昵称长短不一,用
VARCHAR,按实际长度占空间; - 注册时间用
DATETIME,默认值CURRENT_TIMESTAMP,插入时不用手填; - 状态只有 0 和 1,
TINYINT就够,没必要用大类型; NOT NULL表示这栏必须给值,DEFAULT表示没给就自动填默认值。
归纳一下,字段设计就三条:必要性,只留业务必需的字段,冗余字段一个都别加,白白占存储还容易写错;精准性,数据类型选得准,定长用 CHAR、变长用 VARCHAR、时间用 DATETIME,前面已经对照过;规范性,名字统一小写加下划线、见名知意,禁止中文和特殊符号,注释一定写------后人接手不骂人,这是团队协作的基本功。
💡 要点:字段定的是规则------能存什么、什么格式、能不能空,建表那一刻就锁死了。
记住:字段是表的"栏目"和规则,纵向固定,决定一张表长什么样。
栏目印好了,张三这个大活人,怎么才能变成表里的一行?
四、人怎么"进表"?记录(行,Row)
填进栏目里的真实内容,叫记录 ,也叫行(Row) 。字段是规则框架,记录就是按框架填好的真实数据------一行对应一个完整用户。
把张三、李四请进表:
sql
INSERT INTO user_info (id,username,password,nickname,phone,status)
VALUES
(1,'zhangsan','123456','张三','13800138000',1),
(2,'lisi','654321','李四','13900139000',1);
SELECT * FROM user_info;
latex
id=1  zhangsan  张三  13800138000  status=1
id=2  lisi      李四  13900139000  status=1
create_time 由 DEFAULT CURRENT_TIMESTAMP 自动填入,不用手写
注意我们没传 create_time,查出来它已经有值了------默认值就是干这个的:你不给,数据库替你填。
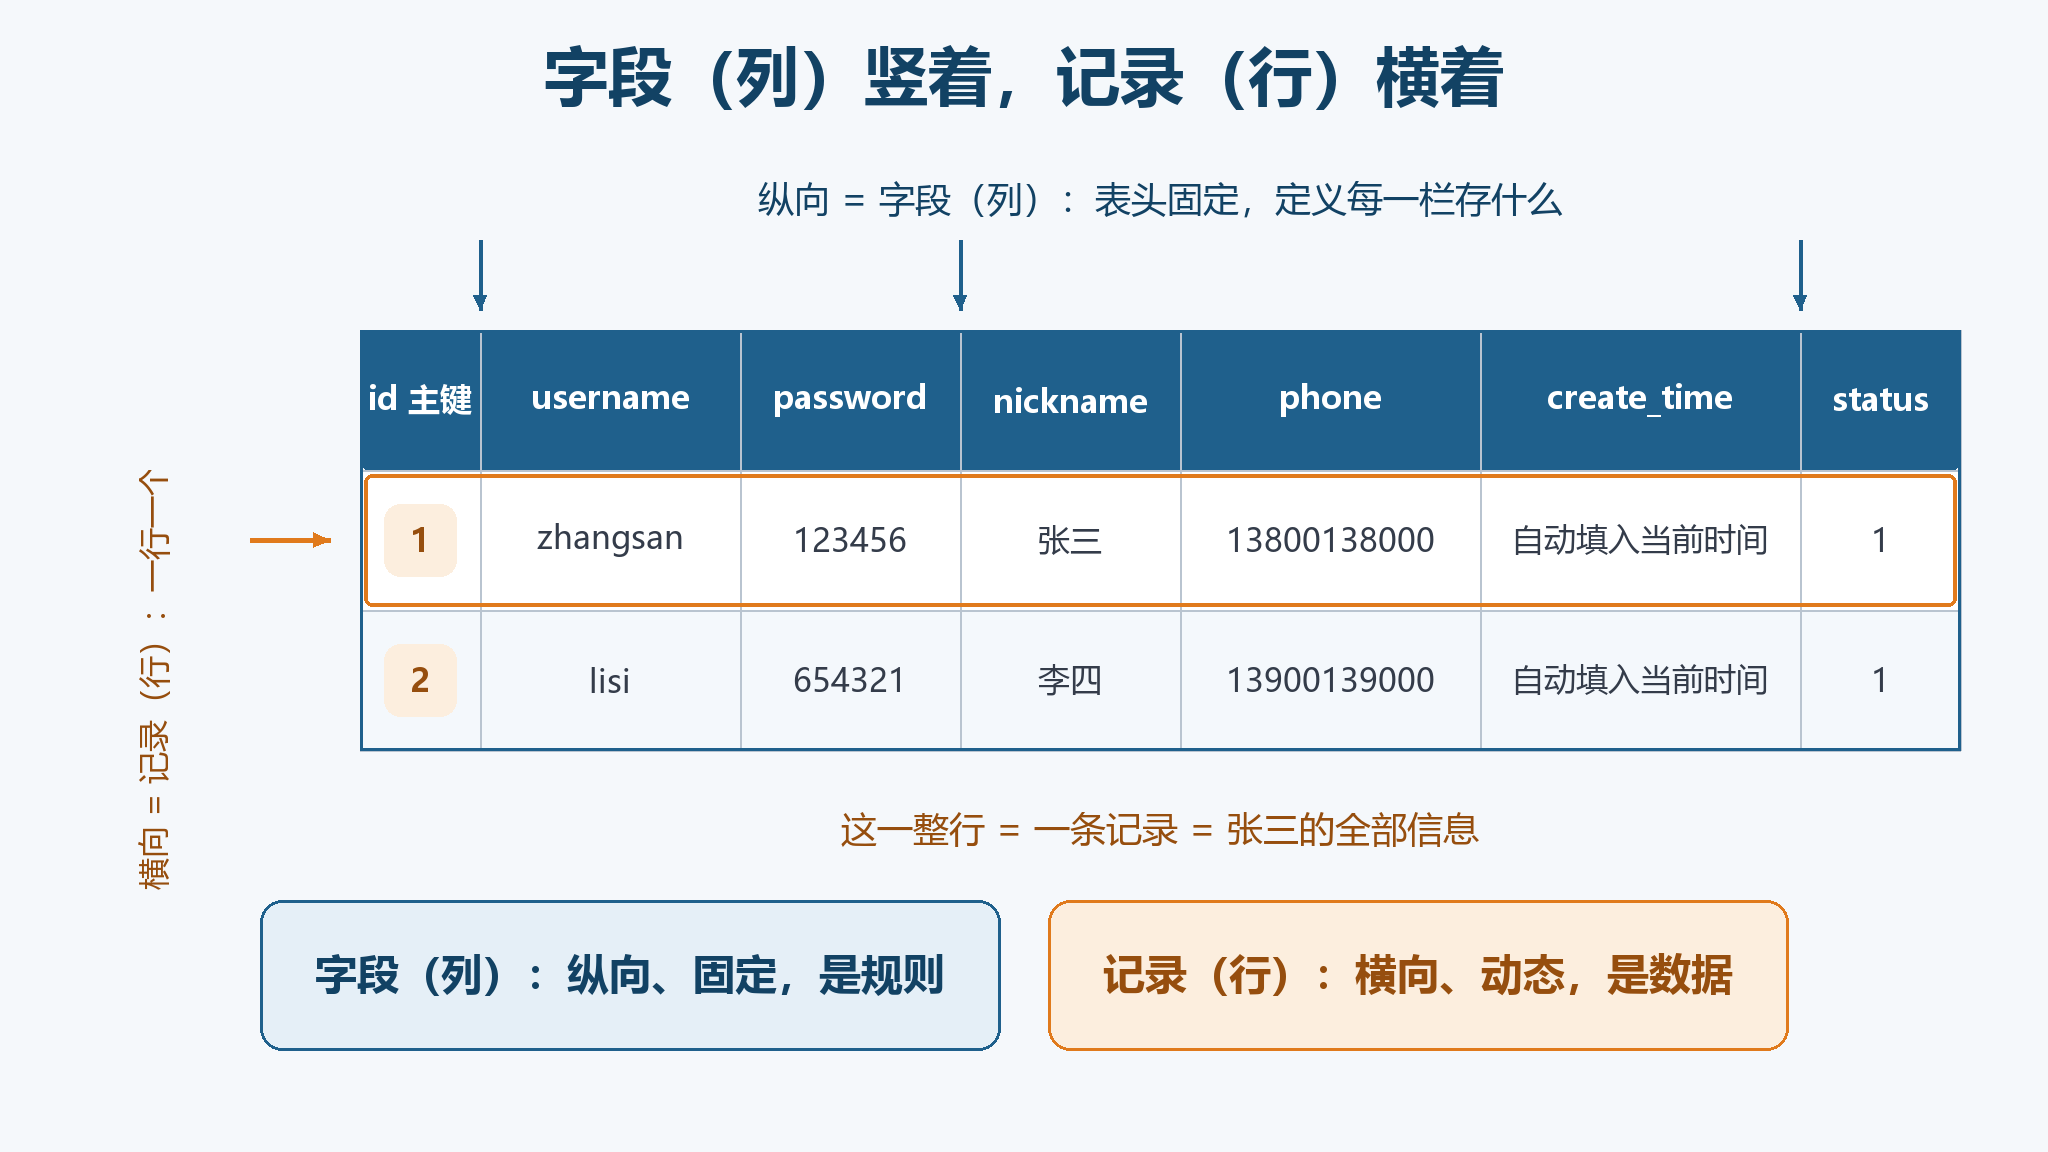
字段和记录谁也离不开谁:没有字段,表没有框架,数据不知道往哪填;没有记录,表就是个空框架,没有任何业务价值。字段定维度和规则,记录填内容和实例。
现在再看这张表,关系就清楚了:纵向是字段(列),固定不变,是结构;横向是记录(行),可以随时新增、修改、删除,是数据。 一张表能放无数条记录,但每条都得遵守同一套字段规则。
用户改昵称,就 UPDATE 对应那一行;用户注销,就 DELETE 那一行------动的永远是行,表头始终不动。
记住:一条记录就是字段规则下的一行真实数据,一行对应一个用户。
现在两个用户的 id 是 1 和 2。要是我手滑,再插一条 id=1 的,会怎样?按直觉,该报错吧?
五、两行数据"撞号"了怎么办?主键(Primary Key)
别猜,动手试:
sql
INSERT INTO user_info (id,username,password)
VALUES (1,'fake_zhangsan','123456');
SELECT id, username FROM user_info WHERE id = 1;
latex
+----+---------------+
| id | username      |
+----+---------------+
|  1 | zhangsan      |
|  1 | fake_zhangsan |
+----+---------------+
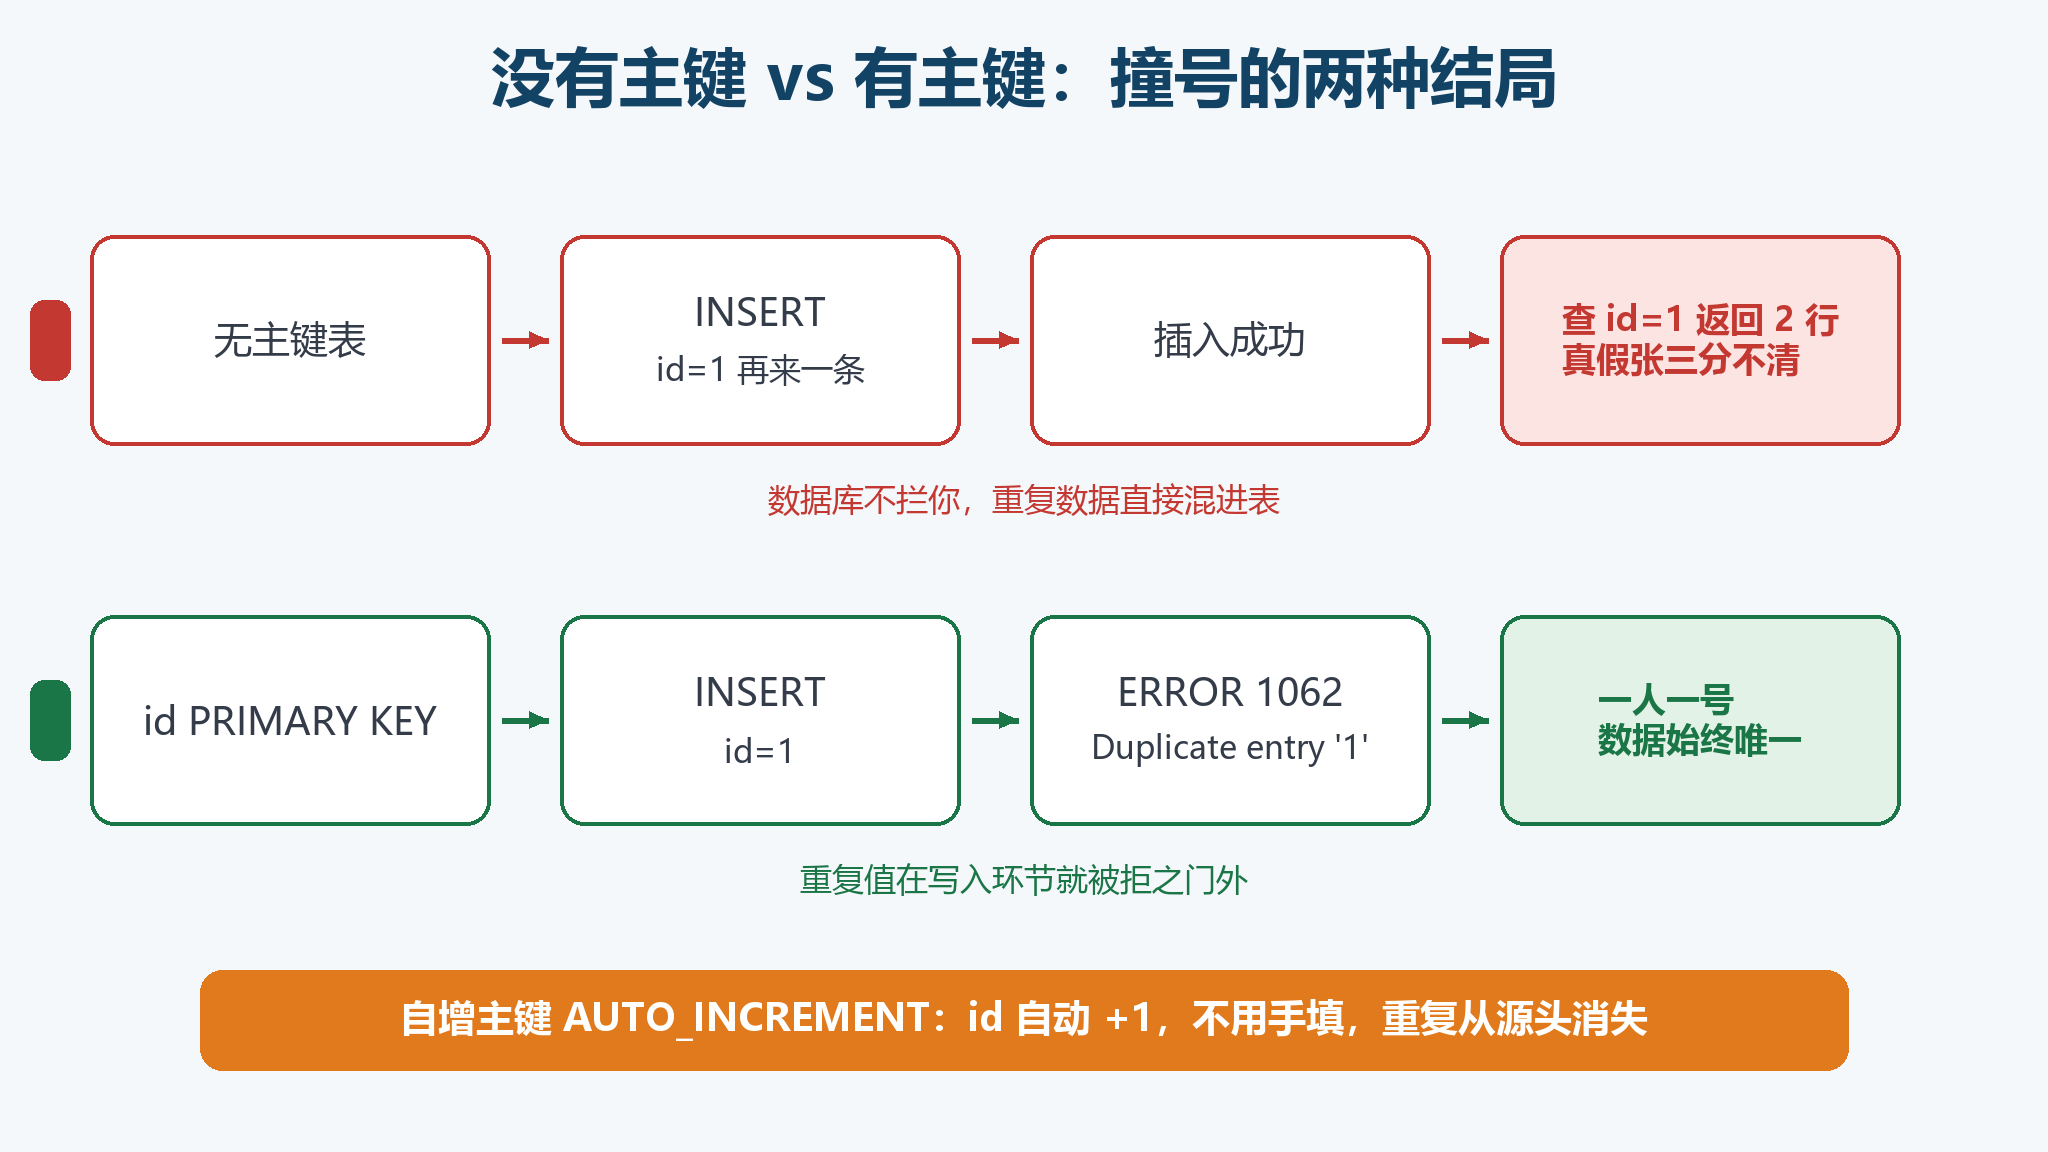
2 rows in set看到了吧?没有主键,数据库根本不拦你。一个 id=1 查出两个人,谁是真张三?数据从这一刻起再也分不清,后面的关联查询、按 id 定位全乱。
⚠️ 坑 :字段叫
id、注释写"主键",都不顶用。没有PRIMARY KEY约束,重复值就能大摇大摆混进表。
解决它,靠主键约束(Primary Key,简称 PK)------它是唯一标识每一行的特殊字段,相当于每条数据的身份证。四个特性,记牢:
- 唯一:id 值绝不重复,id=1 只对应张三;
- 非空:主键不能为 NULL,每条数据都必须有 id,想插一条没 id 的记录,直接被拒;
- 稳定:id 一旦生成,别乱改,它永久对应这条数据;订单表等其他表可能正用这个 id 做关联,一改,关联就断;
- 自带索引:主键会自动创建主键索引,按 id 查询是表里最快的。
一张表有且只有一个主键。把旧表删掉、重建,这次带上主键和自增:
sql
DROP TABLE IF EXISTS user_info;
CREATE TABLE IF NOT EXISTS user_info (
    id INT PRIMARY KEY AUTO_INCREMENT COMMENT '用户唯一ID(主键,自增)',
    username VARCHAR(30) NOT NULL COMMENT '用户登录账号',
    password VARCHAR(64) NOT NULL COMMENT '用户登录密码',
    nickname VARCHAR(20) DEFAULT '' COMMENT '用户昵称',
    phone CHAR(11) DEFAULT '' COMMENT '用户手机号',
    create_time DATETIME DEFAULT CURRENT_TIMESTAMP COMMENT '注册时间',
    status TINYINT DEFAULT 1 COMMENT '账号状态:1正常 0禁用'
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='用户信息基础表';
自增属性(AUTO_INCREMENT):新插入一行,id 自动 +1,不用手填,从根上杜绝重复和遗漏。
手动发号是什么下场?两个人同时注册,都查到当前最大 id 是 5,于是都插 id=6------又撞了。自增由数据库统一发号,天然没这个问题。
主键分两种。单字段主键由一个字段构成,是最标准的用法:通常用 INT,数据量特别大的场景用 BIGINT,搭配 AUTO_INCREMENT,新增数据自动发号,简洁高效、适配性极强,实际开发里 99% 的场景用的都是它。
复合主键由两个及以上字段组合成唯一主键,只用在特殊的关联表场景,普通业务表几乎不会出现,新手不用重点掌握。
重建会清空数据,把张三、李四的 INSERT 再跑一遍(这次不用写 id),然后验证:
sql
INSERT INTO user_info (username,password) VALUES ('wangwu','123456');
INSERT INTO user_info (id,username,password) VALUES (1,'dup','123456');
latex
第一行成功:id 自动取 3
第二行失败:ERROR 1062 (23000): Duplicate entry '1' for key 'user_info.PRIMARY'
✅ 验证:重复 id 在写入环节就被拒之门外,这就是主键"从根源避免数据重复"的含义。
再把数据查出来看:张三、李四的 id 还是 1、2,wangwu 是 3,号段连续、不重号。
❌ 错误 :手动给主键赋值。重复、遗漏都难免,让
AUTO_INCREMENT自己发号,或者用雪花算法,别手填。
记住:主键是每行数据的身份证,唯一、非空、还自带最快的索引;自增主键别手填。
六、回头串一遍:用户数据是怎么被安放好的
从盖办公室到发身份证,一条线走完。对着案例再看一遍层级:
| 层级 | 写字楼类比 | user 案例 | 一句话职责 |
|---|---|---|---|
| 数据库 | 办公室 | user_system_db | 隔离、归类一整个项目的数据 |
| 数据表 | 档案柜 | user_info | 真正存数据,一表一类业务 |
| 字段(列) | 档案栏目 | id、username、phone | 定属性、类型和约束 |
| 记录(行) | 档案单据 | 张三那一行 | 一个用户的完整数据 |
| 主键 | 单据唯一编号 | id(自增) | 唯一标识,精准定位 |
想确认主键真的生效,可以让 MySQL 把建表语句吐出来给你看:
查看表结构,确认主键生效
SHOW CREATE TABLE user_info;
结果里找得到 PRIMARY KEY (id) 和 AUTO_INCREMENT,就说明主键和自增都就位了。
这套规矩不分项目大小:个人博客也好,大厂的分布式系统也好,数据都按这套层级安放。
记住:从库到主键是"容器 → 柜子 → 栏目 → 单据 → 编号"的嵌套,少了哪一层,数据都安放不稳。
写在最后
总结:数据库管隔离,数据表管存储,字段定规则,记录填内容,主键保唯一------五个概念不是五个并列考点,是安放一条用户数据的五个环节。
术语速查表:
| 中文 | English | 一句话 |
|---|---|---|
| 数据库 | Database | 数据容器,一项目一库 |
| 数据表 | Table | 真正存数据的二维表格 |
| 字段(列) | Column | 纵向表头,定属性和规则 |
| 记录(行) | Row | 横向一行,一条业务数据 |
| 主键约束 | Primary Key(PK) | 唯一、非空,一表一个 |
| 自增 | AUTO_INCREMENT | 主键自动发号 |
| 字符集 | utf8mb4 | 中文、表情都能存 |
新手高频坑清单:
- 库和表搞混:库不存数据,表才存;不
USE就操作 → 1046; - 字段和记录搞混:纵向固定的是列,横向动态的是行;
- 表不设主键:重复数据混进来,查不准、联不上、还慢;
- 手填主键:重复、遗漏难免,交给
AUTO_INCREMENT; - 字符集偷懒:不用
utf8mb4,中文乱码、表情存不进。
下一步行动 :现在打开一个客户端,按顺序跑一遍------建库 → USE → 建带主键的表 → 插两个用户(不写 id)→ 故意插一条重复 id,亲眼看着 1062 报错把它拦下。
参考链接: