1. 这篇论文到底想解决什么问题
GROUNDHOG 想解决的是:让 MLLM 的语言能够精确对应到像素区域
以前很多 grounded MLLM,比如 Shikra、Kosmos-2,主要把语言和 bounding box 对齐:
但 box 很粗,尤其不适合:
- 不规则物体;
- 天空、草地这类背景区域;
- 物体局部,比如"狗的尾巴";
- 多个实例;
- 图像中的文字区域。
所以 GROUNDHOG 希望做到:
也就是把语言真正 grounding 到像素级。
2. 最核心的思想:不是直接生成 mask,而是"先分割,再选择"
这是整篇论文最重要的设计。
GROUNDHOG 不采用:语言 → 直接生成 mask
而是:Mask Proposal +Language-guided Mask Retrieval
首先给图像 :
,产生很多候选 mask。
然后 MLLM 根据语言判断:
用户说的这个东西,对应哪些候选 mask?
所以整个 grounding 被拆成:先找到可能存在的视觉区域 + 再判断语言对应哪个区域
论文把这两部分称为:Localization + Recognition
这种解耦设计也是 GROUNDHOG 和 LISA 一类方法非常明显的区别。
3. 第一步:生成尽可能全面的候选 mask
既然后面只能从已有 mask 中选择,那么前面的 mask proposals 就必须尽量全面。
GROUNDHOG 希望候选区域覆盖不同语义粒度:
完整物体 + 背景区域 + 物体部件 + 文字区域
例如:dog、grass、dog's tail、sign text
**proposal 覆盖能力决定后续 grounding 的上限,**因为如果"狗尾巴"从一开始就没有被切成候选区域,那么后面的 MLLM 即使知道用户说的是狗尾巴,也没有对应的 mask 可以选择。
4. 为什么作者要设计 Mask2Former+
普通 Mask2Former 主要在 COCO Panoptic 上训练,因此对于 COCO 常见类别很好,但对于:物体部件、视觉文字、开放世界中的其他实体 覆盖能力不足。
所以作者构建了 Mask2Former+。
他们整合了 COCO、LVIS、Entity-v2、Pascal、PACO、MHP-v2、TextOCR 等数据,并在原本的 200 个 entity queries 基础上增加:50个 part queries + 50个 text queries, 专门增强物体部件 和文字区域的候选 mask 生成能力。
Mask2Former+ 负责"尽可能把图里的有意义区域都切出来",它还没有负责语言理解。
5. 第二步:把每个候选 mask 变成 MLLM 能理解的视觉表示
现在假设已经得到:,为方便模型解耦,GROUNDHOG 只拿 Mask2Former 产生的 **binary mask,**并不直接使用 内部的 feature。
而是然后整张图分别经过 CLIP 和 DINOv2,得到两套 feature maps。
对于某个 mask ,分别做 mask pooling:
本质上就是利用 mask,只保留这个区域相关的视觉特征,再进行聚合。
然后分别经过 MLP 映射到 MLLM 的 embedding 空间,最后相加:
最终的 就是这个候选区域对应的:
也就是说:
一个 mask 对应一个视觉实体 token。
6. 这时 MLLM 实际上看到的图像是什么
经过上一步之后,GROUNDHOG 不再只是把图像理解成一堆普通 patch。
而是变成一组视觉实体:
Image → 一组视觉实体
如: = 第一只狗,
= 第二只狗,
= 草地,
= 某个文字区域
这些 Visual Entity Tokens 会进入 MLLM,后面语言 grounding 的本质就是:
当前语言描述到底和哪几个 visual entity tokens 最匹配?
7. 第三步:语言如何变成一个 grounding query
假设模型生成:
I see <GRD> two dogs </GRD> on <GRD> the beach </GRD><GRD> 和 </GRD> 表示:中间这段语言需要和图像区域对应。
对于:
<GRD> two dogs </GRD>MLLM 最后一层分别得到 和
,然后相加
得到:
可以直接把 q 记成:"two dogs" 这个需要被定位的语言短语的表示
8. 第四步:用 q 去选择前面的候选区域
现在已经有两类东西:
语言:q
视觉:
拼接,经过 MLP得到一个 score:,代表这个候选区域 Mi 和当前语言 phrase 的匹配度
如:对于 two dogs,可能得到:,
,
,模型就知道
对应 two dogs。
所以这里 GROUNDHOG 的 grounding,本质就是:
9. 为什么它天然支持多个目标
因为 GroundHog 不是只能选一个 mask。对于 two dogs,两个 dog mask 都可以获得高分。
最后模型把高分 mask 合并:
所以 可以一起组成最终结果。
因此它天然支持 和
,甚至
,本质上都统一成从候选 mask 中选择并组合
10. <PTR>:GROUNDHOG 还可以反过来让用户"指区域"
GROUNDHOG 不只是:
也支持:
例如用户指着某个位置:
What is that
<PTR>?
这里 <PTR> 代表用户提供的 point、box 等空间提示。
GROUNDHOG 可以先用 SAM:
然后同样经过前面的:
再用这个视觉实体 token 替换 <PTR>。
因此 MLLM 就能理解:
用户现在到底指的是哪一个区域。
这使得模型可以进行 Referential Dialogue,也就是基于空间指示进行交互。
11. M3G2 数据集:训练模型把各种任务统一成 grounded dialogue
作者构建了:
它把很多已有 grounding、segmentation、VQA 数据重新整理成统一的视觉对话形式。
主要包括四类任务:
(Grounded Image Captioning):
生成 caption,同时把里面的 phrase 和 mask 对应起来。
(Referring Expression Segmentation):
给一句语言,找到对应 mask。
(Grounded Visual Question Answering):
回答问题,同时给出支持这个答案的像素区域。
(Referential Dialogue):
用户通过 point、box、region 等方式和模型交互。
前文和表格描述:M3G2 大约 2.5M text-image pairs、36 个子任务、来源于 27 个数据集 。但结论部分又写成了 1.9M training text-image pairs
12. 这篇论文真正想证明的不是"某一个分割任务做到最好"
作者更强调:GROUNDHOG 是一个 generalist grounded MLLM
即同一套模型参数可以同时处理:
、
、
、
而不是一个模型只专门做一个 segmentation benchmark。
在这些任务上使用的是同一组模型权重,没有针对每个数据集单独 fine-tune。
在 RefCOCO、RefCOCO+、RefCOCOg、gRefCOCO、PhraseCut、ReasonSeg 等任务上,它整体表现也比较强。
13. 为什么作者强调"可解释"和"可诊断"
这种: 的解耦还有一个很重要的好处。
如果最后 grounding 错了,可以检查:
情况一
目标区域根本没有被 proposal model 切出来。
那么问题在:
情况二
目标区域其实已经存在,但 MLLM 给它的 score 很低。
那么问题在:
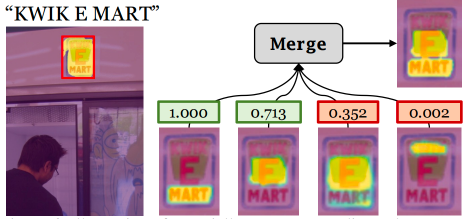 :
如图,对应区域其实已经被成功 proposal 出来了,但 MLLM 没有正确识别 "KWIK",所以没有把对应 mask 选中。
所以相比 LLM hidden state → 直接生成 mask,GROUNDHOG 更容易知道错在哪一步
14. 实验里还有两个比较重要的结论
1、 hallucination
在 M3G2 中加入 negative QA(问题里问到的目标在图像中不存在,正确答案应该否定) 数据,再加上模型要求语言和视觉区域建立明确对应,因此在 POPE 上 object hallucination 明显减少。
但不是 pixel grounding 彻底解决了 hallucination
更准确的是:
共同改善了 hallucination。
2、消融实验
作者发现: 整体优于单独使用其中一个;
同时 整体效果优于只使用其中一个 boundary token 的 hidden state。
15. 论文局限:本质上仍然是在"选已有的 mask"
它的流程是先 proposal → 再 retrieval,因此没有 proposal 出来的区域,MLLM 很难凭空生成
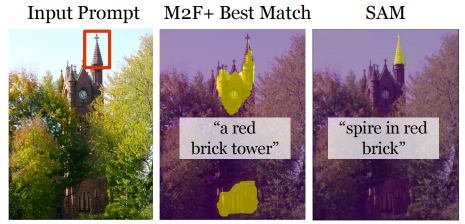
如用户问:
red brick spire
但 Mask2Former+ 只 proposal 出整个 tower,没有单独 proposal 出 spire,那么即使 MLLM 完全理解 "spire",也只能从已有 mask 中选择,很难得到精确的尖塔区域。
所以它的最大优点和最大局限来自同一个设计:把 segmentation 和 language grounding 解耦
优点是模块化、可替换、可解释;缺点是:最终 grounding 的上限受到 mask proposal 的限制
如果现在把整篇论文最后压缩成一条完整链路,你可以记成:
图像 → Mask2Former+ 产生候选 mask → CLIP/DINO 提取每个区域特征 → Visual Entity Tokens
然后语言这一边:
最后:q + {e 1, ..., eN} → 给候选区域打分 → 选择并合并 mask
所以整篇 GROUNDHOG 最核心的一句话:
它不是让 MLLM 学会"画 mask",而是让 MLLM 学会"理解并选择已有的像素级视觉实体"。