多机训练那头,最舒服的往往是写数据:几十个 worker 把权重和 checkpoint 写进去,落盘、返回 200,吞吐曲线漂亮得能当壁纸。真正卡住训练节奏的常常是读的这一头:同一个 4 GiB 的模型权重,八个 worker 各读各的段,回源次数不是按 worker 数算的,而是按「每个 worker 每碰一次冷页算一次」往上翻。单次延迟都不高,可尾延迟会被拉得不讲道理。
这篇文章记的是一条具体路径:把 Cachey 挂到 RustFS 前面,让重复 Range 读不再打到后端。Cachey 是个开源读穿透缓存,后端走标准 S3 接口。
作者 Shikhar 所在的 s2.dev 做流式日志存储,最近写的那些记录由指定的进程持有,读延迟几乎为零,代价是并发读者数和吞吐都被这个进程框住;真正持久化的一头又是 S3,而 S3 自己有请求速率上限,网关和持有进程还不总落在同一个可用区,跨区网络成本跟着来。缓存是那块还能再挤的地方:降操作成本、改善延迟分布、抬高扩展性上限。作者列这门心思的理由时也点过名,ClickHouse、Turbopuffer、WarpStream、RisingWave 都公开讲过自己在 S3 上做分布式缓存的路数,这不是某一家临时想到的。
自建后端的读路径,卡在哪
一个典型的对象存储,读路径大致是:客户端带 Range 头打过来,网关解析范围,到 EC 编解码层取数据块,拼好返回。单次 GET 的延迟本身不高,问题出在重复读和并发读。
- 第一个问题是尾延迟。多个 worker 同时读同一段冷数据,后端会同时处理好几条回源,队列一深,谁都不快。
- 第二个问题是回源放大。同一个页被八个请求经过,如果没有合并,后端就要做八次昂贵的取块,而这八次的结果完全一样。
- 第三个问题是小随机读。列举和单对象 GET 在「小范围随机读」上并不便宜,元数据检索的占比会突然变得很难看。
这三个问题都不是 RustFS 独有,是 POSIX 式语义摊到分布式对象存储上的通病。解法得在前面加一层「存储感知」的缓存:理解 Range、理解页对齐、能把同页并发请求合并。
Cachey 是一个用 Rust 写的对象存储读穿透缓存,MIT 协议。它的核心假设很克制:缓存的对象是不可变 blob,所以某段一旦被拉过,就可以放心复用,这一条也决定了它的适用面。
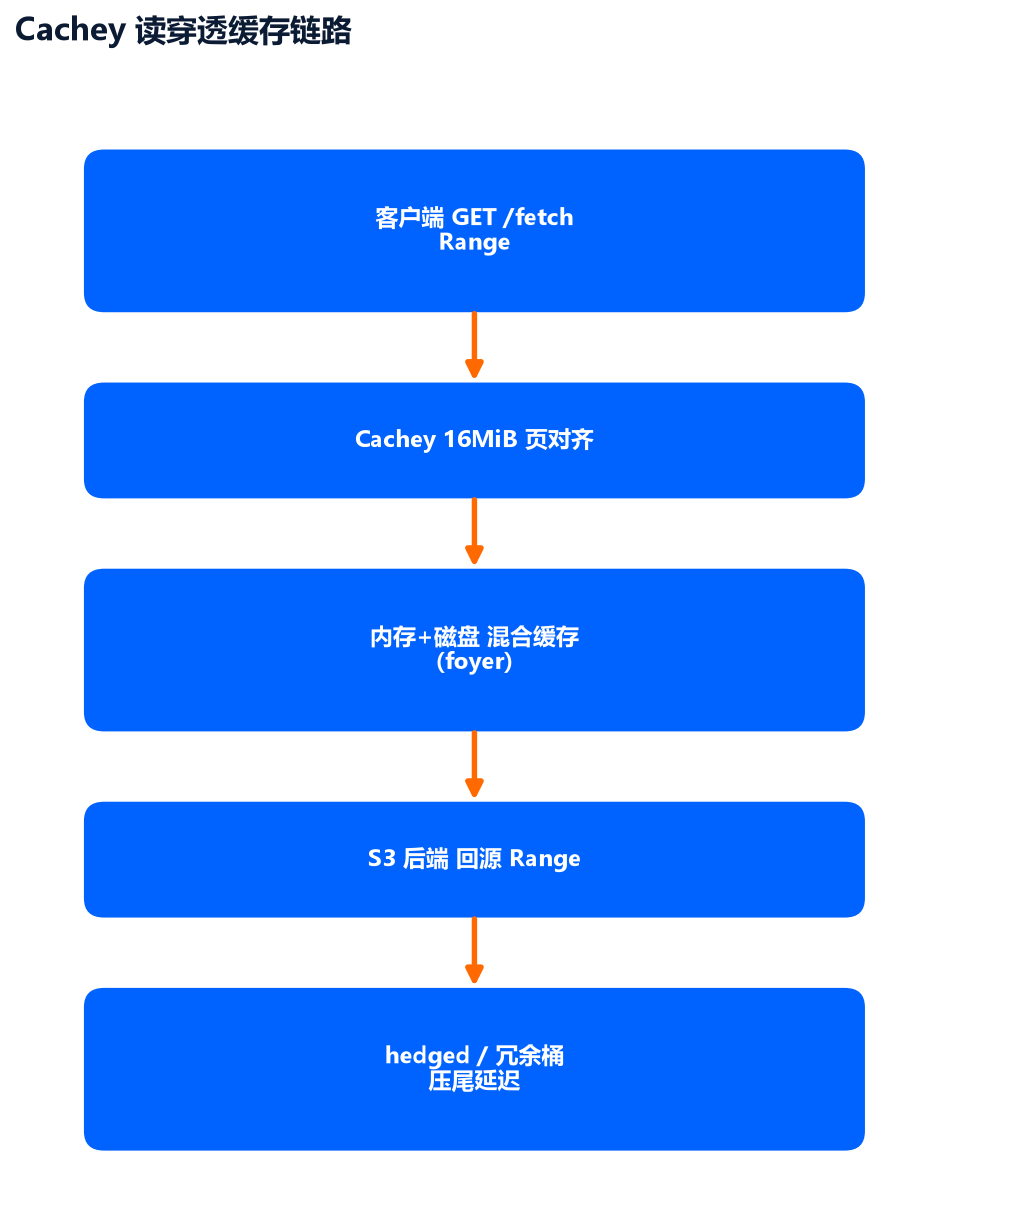
它的接口面极小。客户端打 GET /fetch/{kind}/{object},带上 Range: bytes=...;Cachey 把请求的字节范围对齐到固定的 16 MiB 页,先在混合缓存里找,miss 才回源到后端。同页的并发请求会被合并成一次回源,多个 bucket 之间还能做 hedged request 来压住尾延迟。
它连鉴权都不自己做,认证和签名都留在你的反向代理或网关上。「只做缓存、不做其他」是它能插到任何 S3 兼容后端前面的原因,接 RustFS 也不例外。
但「不做其他」有反作用的一面:既然没有鉴权,请求里由客户端填写的字段也就没人拦。C0-Bucket 让请求方自己指名桶,可以一次填多个当副本;C0-Config 让请求方逐页覆盖回源的连接超时、首字节时间、重试次数和路径风格。换句话说,打到 Cachey 的任何请求都能让它去后端任意有权限的桶上取数据,还能顺手把超时调紧、把重试次数调低,制造大量失败回源。所以前面那层反向代理要多做两件小事:剥离客户端传来的 C0-Bucket 与 C0-Config,改由代理注入可信的桶名。这步省不得,省了就等于是把后端桶列表交给了每个下游。
16 MiB 页对齐,和它划出的甜区
页大小是这套东西里最值得先想清楚的一个数。Cachey 固定按 16 MiB 切页,把任意 Range 请求映射到页对齐的查找,这个数是写死的,命令行里没有对应的参数可调。
这个思路是从操作系统的页缓存借来的,代价也一并跟过来:通常可以省掉的 Range 头,在这里变成了必填,而且必须给出精确的字节范围。页大小选 16 MiB,是因为它落在 S3 建议区间的上半段,越大越省回源次数,也越浪费。
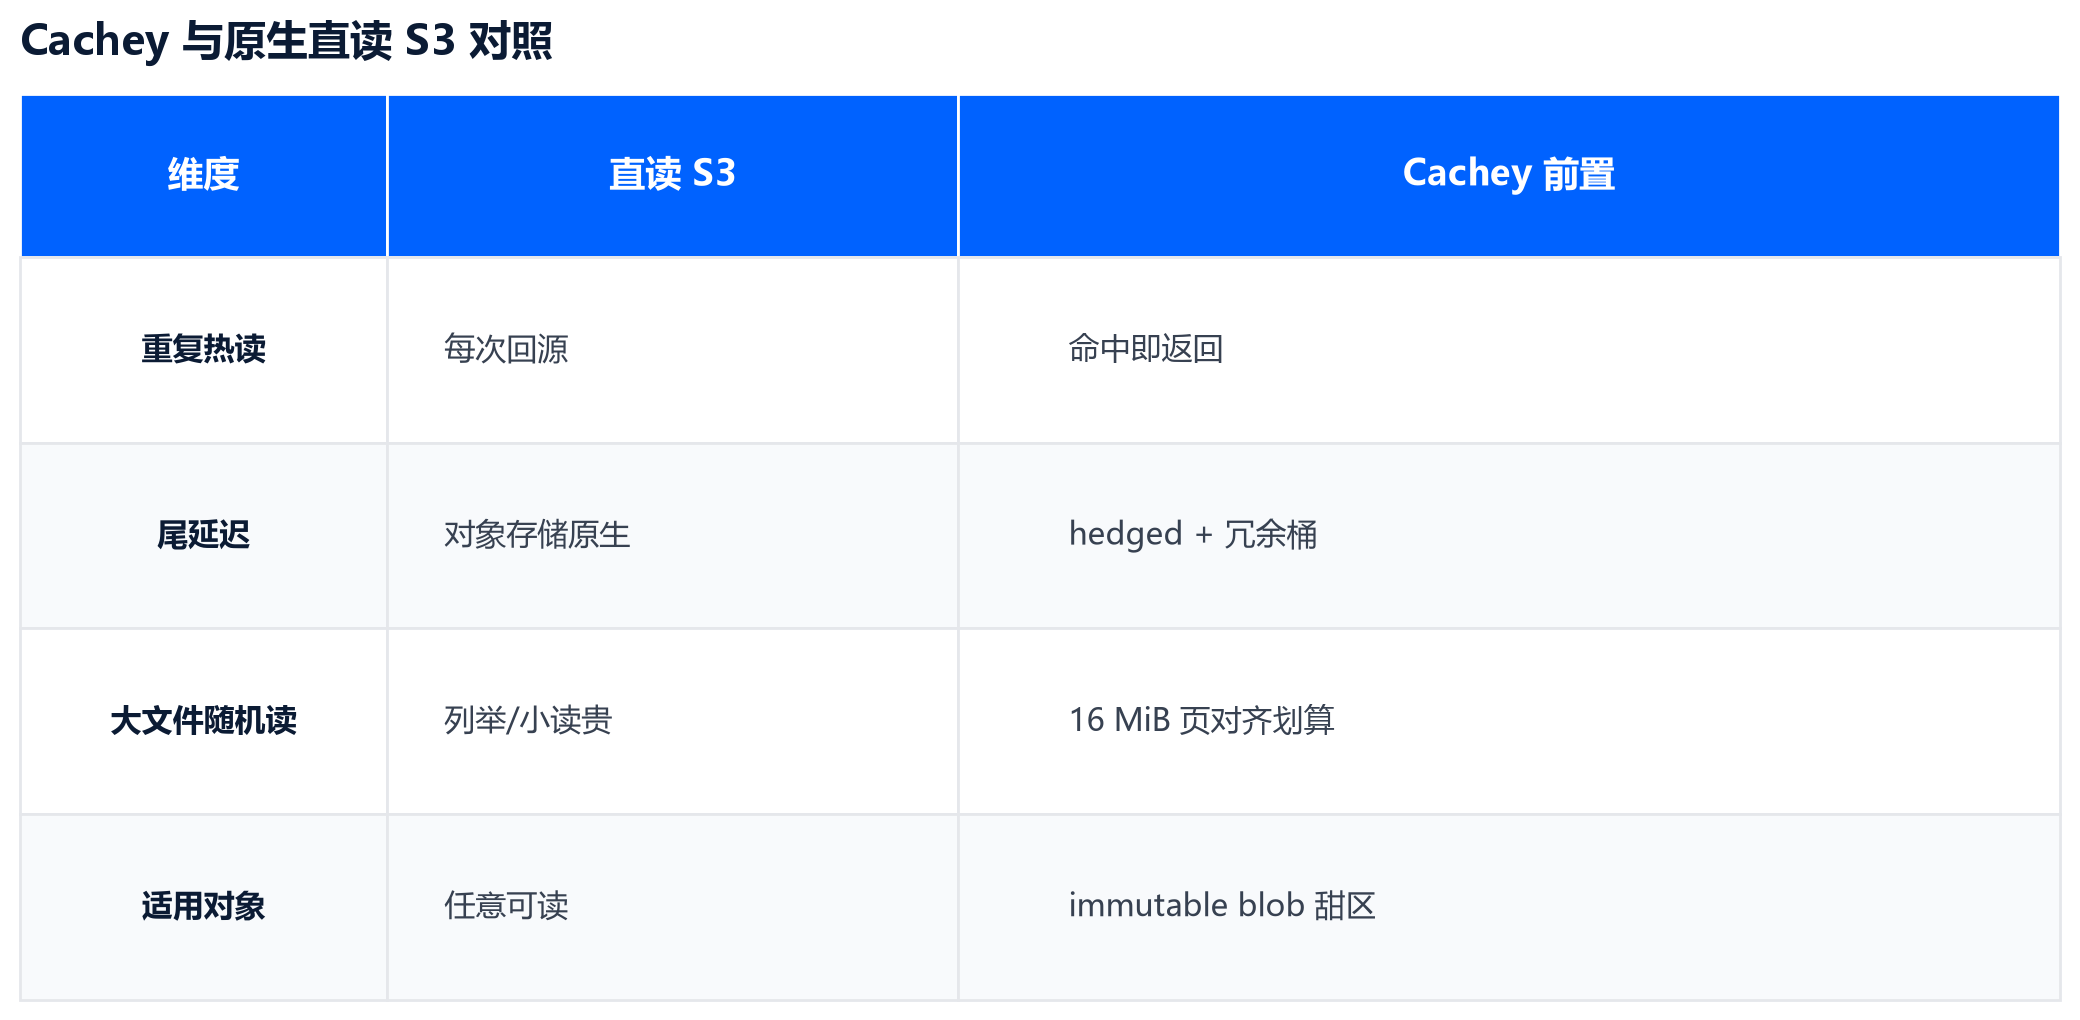
落到开篇那份 4 GiB 权重上,按 16 MiB 切正好是 256 个对齐页。八个 worker 各读各的段,只要落在同一页,第一跳回源、后续全命中:回源次数从「按请求数算」变成「按用到的页数算」。训练、权重分发、视频切片这类大文件配按段随机读的负载,命中率天然就高。
一次很小的 Range 也可能触发一整页的回源与缓存占用,小对象居多的负载并不划算。服务端对每次读都按整页预留缓冲,哪怕你只要最后 1 KiB 也照样占满 16 MiB,默认预算下并发副本数因此只有 64 个。你的文件大小分布离 16 MiB 越远,浪费掉的带宽和缓冲越多,这一层就越不划算。
更要紧的是另一头。缓存键由 kind 和 object 拼成,ETag 和版本号都不参与,所以它锁死在「对象不可变」这个假设上。后端对象一旦被覆盖、新版本传上去,旧页会被原样返回,业务读到的还是上一次的内容,而且不会有任何提示。想避开只能把 kind 当命名空间用:发新版就换一个 kind,等于新开一块缓存区,旧页只能等容量压力慢慢淘汰。频繁覆盖的对象,本来就不该放在这一层后面。
命令行的旋钮在 C0-Config 头里覆盖:ct 连接超时、rt 首字节时间、ot 操作超时、ma 每桶最大尝试数、ib/mb 退避上下限、fps 强制 path-style 寻址。rt 调小能让慢回源更快失败并转去冗余桶,ma 调大能在后端波动时多扛几次,ib/mb 决定重试之间退避多久,避免雪崩式回源。要看缓存有没有生效,把 /metrics 直接接进 Prometheus 就行。
接 RustFS 的最小步骤
接 RustFS 的完整动作只有三步,没有额外的适配层。
这件事在测试里已经发生过一次:PR #106 把集成测试中的 MinIO 容器换成了 rustfs/rustfs,当时拉的还是 1.0.0-alpha.98 那版。它说明在第三方项目的自动化测试这一层,RustFS 已经当 S3 后端跑起来了。
第一步,起服务。把 RustFS 的端点当成源配进去:
bash
cachey server \
  --memory 4GiB \
  --disk-path /data/cachey \
  --disk-capacity 100GiB \
  --iouring \
  --bucket-timeout-ms 5000 \
  --page-timeout-ms 10000 \
  --max-download-memory 1GiB \
  --hedge-budget-percent 5
这一串参数同时也是它的全部配置面:官方文档里只有 server [OPTIONS] 这一条路径,没有配置文件,也没有环境变量。所有旋钮都在命令行上,想改就得重启进程,所以参数一次给足比事后调划算。
第二步,告诉它从哪个桶回源。每次请求带 C0-Bucket: your-bucket 即可,想给 RustFS 开 path-style 寻址(比如端点后面带桶名、不走虚拟主机),在配置里加 fps。
第三步,把应用侧的上游从 RustFS 改到 Cachey。这一步之所以只是改一个地址,是因为 /fetch 就是标准 HTTP Range 读,客户端不需要引入任何 SDK。原直连 RustFS 的 Range 读,改成打到 Cachey 的 /fetch,迁移和回滚都不碰对象存储本身的数据。
比较省事的一种部署是 Cachey 与 RustFS 同机或同子网部署,前端由反向代理做 TLS 终止,缓存层不对外暴露签名校验。因为协议就是普通 HTTP,哪天要下线缓存,把上游指回 RustFS 即可,数据零迁移。
真要上线,还有四件事得先想明白。
一是上面提过的请求头。代理侧必须把客户端传来的 C0-Bucket 和 C0-Config 全部剥掉,换成自己注入的固定值,否则等于把后端的桶列表和超时旋钮交给了每个下游。
二是对象更新。缓存不认版本号,后端覆盖之后旧页照样命中,得靠换 kind 启新缓存区来切,不要指望它自己感知。
三是后端故障时的行为。Cachey 不会拿缓存里的旧数据兜底:副本读取失败回 503,超时回 504,响应已经开始流式传输之后再出错就直接中断连接。它是加速层,不是容灾层,缓存命中省下的是延迟,省不下后端的可用性。
四是多实例,命中率摊薄那部分放到部署形态那一节说。
三条路的差别不在「谁更快」,而在理解不理解对象存储。
CDN 擅长把内容推到离用户近的边缘做全局分发,但它不理解 Range 语义和页结构,热数据 miss 之后还是要回到源站,源站承受的还是那一份重复读。Varnish 这类通用 HTTP 缓存能缓存 HTTP 响应,但默认不按「大块对齐加并发合并」做优化,小随机读照样把回源打穿。Cachey 的差别在于它原生就是 object-storage-aware:16 MiB 页对齐、同页并发合并、hedged 回源,这些恰好对准对象存储的弱点。
如果你的瓶颈是边缘分发,CDN 更合适;如果是回源的存储被重复 Range 读打爆,就该考虑存储感知缓存。自建 RustFS 的场景里,第二种更常见,因为后端是自己运维的,资源有限,尤其不该为同一段冷数据做十几次重复取块。
缓存底座、命中边界与替代路线
Cachey 的命中层是 foyer,一个把内存和磁盘合在一起的混合缓存,热页留在内存、冷页落盘,按访问热度自动在两级边界上滑动。这意味着缓存容量可以远超物理内存,你给的 100 GiB 磁盘容量不是「二级缓存」,而是和内存一起参与同一套淘汰的存储面。对 RustFS 这种可能承几 TB 权重文件的后端来说,这一条决定了缓存层能不能真的挡住大部分回源,而不是只挡住头几百兆的热数据。
部署形态上还有一点容易被忽略。内存和磁盘缓存都长在单个进程上,作者在发布帖里也写得很直接:它就是一个自包含的单节点二进制,亲和与负载均衡指望客户端那侧的逻辑。所以后面多实例各自一份缓存不是配错了,是设计如此。C0-Bucket 那套「一次给多个桶当副本」的设置,也是同一套思路的延伸:服务端不做选主,把判断交给调用方。摊开有它的好处,单实例挂掉不影响整体,但代价同样直接:每个实例的缓存彼此独立,一份 4 GiB 权重在四个实例上会被各存一份,有效容量仍是单实例的那些,整体命中率跟着实例数摊薄;实例一重启,本地磁盘上那份也一起没。所以扩实例能扛住更多并发回源,但不等于命中率会一起涨上去。
少数大文件反复按段读,命中率会很快爬到很高;海量小对象每个只读一次,缓存全程 miss,不如不要。上线前先把 /stats 的命中率和回源延迟盯一段时间,确认你的负载真落在甜区里。
边界与判断
Cachey 仍是相当早期的项目:单仓库、MIT、文档还在长。它能解决的那部分尾部问题很明确,但它自己能撑到什么程度,得看一段时间才知道。前面讲过的还有一条后果,灾备切换的时候指望缓存层跟着一起扛,这层给不了。
RustFS 在 2026-09-16 走到 1.0.0,官方口径下 4 KiB 小对象 PUT 约 MinIO 的 2.3 倍,读路径同样走高性能实现,正好适合当这类缓存层的回源后端,尤其当热点 miss 需要快速回填时。缓存层与后端是各自独立的取舍:后端负责持久与一致性,缓存层负责把重复读挡在前面。搞清楚这个分工,这一层加不加、加多大,就不难判断了。
项目仓库见 https://github.com/rustfs/rustfs,Cachey 本身在 https://github.com/s2-streamstore/cachey。