目录
一、研发效能评估的"不可能三角":为什么单一指标会系统性失真
[二、软件研发与组织效能评估的 7 维分类体系](#二、软件研发与组织效能评估的 7 维分类体系)
[三、100 个典型应用场景全景图](#三、100 个典型应用场景全景图)
[第六类:CI/CD 与发布交付(51--60)](#第六类:CI/CD 与发布交付(51–60))
[第七类:运维、SRE 与可靠性(61--70)](#第七类:运维、SRE 与可靠性(61–70))
[第十类:AI 辅助研发与智能化效能(91--100)](#第十类:AI 辅助研发与智能化效能(91–100))
[四、场景 → 指标映射矩阵(精华)](#四、场景 → 指标映射矩阵(精华))
[5.1 主从结构:安全底线 × 效能加权](#5.1 主从结构:安全底线 × 效能加权)
[5.2 权重的动态性:不是一张表能解决的](#5.2 权重的动态性:不是一张表能解决的)
摘要 :软件研发与组织效能,不是"代码行数多不多、流水线绿不绿、Jira 燃尽图漂不漂亮"这么简单。一次需求从想法到上线,背后是需求流转、开发协同、代码质量、测试守护、持续交付、系统稳定性、开发者体验、成本与资源、AI 辅助研发、组织治理十条绳子绑在一起。本文系统梳理软件研发与组织效能领域的 100 个典型效能评估场景 ,按 10 大类组织,每个场景一句话点明"评估核心",并给出可落地的分类体系和指标映射。本文为 CTO、研发 VP、PMO、效能平台负责人、DevOps / 研发效能工程师提供一张系统性全景地图。
一、研发效能评估的"不可能三角":为什么单一指标会系统性失真
软件研发系统有一个天然的矛盾结构------交付速度、交付质量、组织可持续,三者很难同时最优。
这不是工具问题,是系统结构问题:
- 把 部署频率 拉到极致,变更失败率会上升,线上事故增多,运维开始习惯性回滚,真实业务价值反而被拖慢------速度与质量冲突
- 把 代码覆盖率 卡到 95%,团队开始写无意义的断言,开发体验恶化,骨干流失,长期交付能力反而下降------质量与可持续冲突
- 把 需求吞吐量 压到最高,需求拆分越来越碎,上下文切换加剧,返工率上升,交付物与业务目标脱节------效率与价值冲突
- 把 AI 代码生成采纳率 当成 KPI,开发者大量复制 AI 输出,Code Review 形同虚设,技术债以指数级累积------短期产出与长期健康冲突
这四个冲突的共同特征是:你在单一维度上优化得越狠,其他维度的隐性代价越大,而且这些代价往往不会立刻体现在仪表盘上,而是延迟 2--4 个迭代以线上故障、人员流失、架构腐化、业务投诉的形式爆发。
所以研发效能评估的本质不是"给每个团队打个分",而是回答三个问题:
- 边界在哪? 这个指标的优化已经逼近哪个维度的代价拐点?
- 代价去哪了? 被牺牲的维度有没有被量化、被监控、被补偿?
- 拐点之后怎么办? 当单一指标继续优化的边际收益小于跨维度损失时,系统是否具备自动回撤或重新分配权重的能力?
这也是为什么本文采用 7 维分类体系而不是单一"交付时长"或"Bug 数"指标------不是因为维度多显得专业,而是因为研发系统的失效几乎总是从"其他维度"开始的。
二、软件研发与组织效能评估的 7 维分类体系
| 维度 | 英文 | 看什么 |
|---|---|---|
| 交付效能 | Delivery | 需求前置时间、部署频率、变更失败率、MTTR、流动效率 |
| 工程质量 | Engineering Quality | 代码复杂度、重复率、测试覆盖率、缺陷逃逸率、技术债指数 |
| 系统韧性 | Resilience | 可用性 SLA、故障恢复、告警有效性、变更安全、回滚能力 |
| 开发者体验 | Developer Experience | 满意度、上下文切换、环境准备时间、工具链摩擦、倦怠风险 |
| 协作与流程 | Collaboration & Process | WIP 合理度、等待时间、跨团队依赖、会议负载、需求流转 |
| 经济与资源 | Economics & Resources | 人均产出、云成本效率、资源利用率、浪费识别、改进 ROI |
| 模型与数据可信 | AI & Data Trust | AI 采纳率、AI 缺陷率、数据完整度、模型漂移、可解释性 |
三、100 个典型应用场景全景图
第一类:需求与产品价值流(1--10)
核心问题:需求从想法到上线的端到端是否通畅,有没有在排队、返工、等待中悄悄腐烂。
| 编号 | 场景 | 评估核心 |
|---|---|---|
| 1 | 需求从想法到上线的端到端周期 | 全链路前置时间、各环节等待占比 |
| 2 | 需求排队与积压分析 | 队列深度、平均等待时长 |
| 3 | 需求变更率与返工率 | 开发启动后需求变更频率 |
| 4 | 需求价值假设验证率 | 上线后业务指标是否兑现 |
| 5 | 低价值需求识别与淘汰 | 被取消/搁置需求占比 |
| 6 | 用户反馈到需求转化效率 | 反馈→排期→上线的闭环时长 |
| 7 | 需求拆分粒度合理性 | 单需求交付周期分布 |
| 8 | 需求验收标准清晰度 | 返工率与澄清轮次 |
| 9 | 跨团队需求流转阻塞点 | 跨团队等待时间占比 |
| 10 | 需求价值流中的"伪忙碌"识别 | 活跃时间 vs 等待时间 |
第二类:敏捷与项目管理(11--20)
| 编号 | 场景 | 评估核心 |
|---|---|---|
| 11 | 迭代目标达成率 | 承诺 vs 交付的一致性 |
| 12 | Sprint 计划可信度 | 计划偏差趋势 |
| 13 | 故事点通胀检测 | 单点估算是否随时间膨胀 |
| 14 | 迭代间范围蔓延 | 开发中新增需求占比 |
| 15 | 看板 WIP 超限识别 | 在制品堆积与瓶颈位置 |
| 16 | 阻塞卡片根因分析 | 阻塞原因分类与持续时间 |
| 17 | 跨团队 Scrum of Scrums 协同 | 依赖等待与承诺兑现 |
| 18 | 发布火车延误预测 | 里程碑偏离预警 |
| 19 | 项目组合健康度 | 多项目资源冲突与优先级漂移 |
| 20 | 研发资源容量规划 | 产能 vs 需求匹配度 |
第三类:开发工程实践(21--30)
| 编号 | 场景 | 评估核心 |
|---|---|---|
| 21 | 分支策略与合并冲突率 | 分支寿命、冲突频率与解决成本 |
| 22 | PR/MR 打开到合并时长 | 评审等待与迭代轮次 |
| 23 | Code Review 覆盖率与有效性 | 评审是否覆盖关键路径、意见质量 |
| 24 | 提交粒度合理性 | 单次提交变更范围与可追溯性 |
| 25 | Trunk-Based Development 成熟度 | 主干开发比例、长分支数量 |
| 26 | 本地构建与远程构建耗时 | 开发反馈循环速度 |
| 27 | 开发环境准备时间 | 新成员/新项目上手成本 |
| 28 | 脚手架与模板复用率 | 重复搭建 vs 标准化程度 |
| 29 | 开发者上下文切换成本 | 日均任务切换次数、恢复时间 |
| 30 | 代码所有权与知识孤岛 | 单人修改集中度、Bus Factor |
第四类:代码质量与架构健康(31--40)
| 编号 | 场景 | 评估核心 |
|---|---|---|
| 31 | 代码重复率 | 复制粘贴代码占比 |
| 32 | 圈复杂度热点模块 | 高复杂度文件分布与趋势 |
| 33 | 死代码与废弃接口识别 | 不可达代码占比 |
| 34 | 单元测试缺失模块 | 无测试覆盖的核心路径 |
| 35 | 代码规范违规趋势 | 违规数/千行代码变化 |
| 36 | 安全漏洞密度 | 严重/高危漏洞数/千行 |
| 37 | 许可证合规风险 | 传染性许可证使用情况 |
| 38 | 服务耦合度 | 跨服务调用深度与扇出 |
| 39 | 架构边界侵蚀检测 | 模块间非法依赖增长 |
| 40 | 技术债指数 TDI | 修复技术债的预估人日 |
第五类:测试与质量保障(41--50)
| 编号 | 场景 | 评估核心 |
|---|---|---|
| 41 | 自动化测试覆盖率 | 单测/集成/E2E 分层覆盖 |
| 42 | 测试金字塔比例合理性 | 各层测试数量与维护成本 |
| 43 | Flaky Test 比例 | 非确定性失败占比 |
| 44 | 测试用例维护成本 | 每千行代码测试维护人时 |
| 45 | 缺陷逃逸率 | 生产缺陷 vs 测试缺陷 |
| 46 | 预发布环境缺陷密度 | staging 环境 Bug 数/功能点 |
| 47 | 回归测试耗时 | 全量回归执行时长 |
| 48 | 测试数据准备效率 | 数据构造与清理时间 |
| 49 | 质量门禁通过率 | 各阶段门禁拦截与放行比 |
| 50 | 缺陷修复周期 | 从发现到关闭的端到端时长 |
第六类:CI/CD 与发布交付(51--60)
| 编号 | 场景 | 评估核心 |
|---|---|---|
| 51 | 部署频率 DF | 单位时间部署次数 |
| 52 | 变更前置时间 | 提交到生产运行的时长 |
| 53 | 变更失败率 CFR | 导致降级/回滚的变更占比 |
| 54 | 平均恢复时间 MTTR | 故障到恢复的中位时长 |
| 55 | 发布回滚率 | 上线后回滚/热修比例 |
| 56 | 流水线排队时间 | 任务等待执行器空闲时长 |
| 57 | 构建缓存命中率 | 增量构建效率 |
| 58 | 多环境部署一致性 | 环境间配置漂移检测 |
| 59 | 灰度/金丝雀发布成功率 | 灰度阶段异常发现率 |
| 60 | 发布说明自动生成准确率 | 变更描述与代码关联度 |
第七类:运维、SRE 与可靠性(61--70)
| 编号 | 场景 | 评估核心 |
|---|---|---|
| 61 | SLA / SLO 达成率 | 可用性目标达标情况 |
| 62 | P0/P1 故障频次 | 高严重级事故趋势 |
| 63 | 故障平均检测时间 MTTD | 从发生到告警的时延 |
| 64 | 故障平均定位时间 | 从告警到根因确认 |
| 65 | 告警噪声率 | 无效告警占比、静音率 |
| 66 | 值班负载均衡度 | on-call 分配公平性 |
| 67 | 混沌工程演练覆盖率 | 核心链路故障注入覆盖 |
| 68 | 容量预测准确率 | 资源预估 vs 实际峰值 |
| 69 | 事故复盘闭环率 | 改进项完成率 |
| 70 | 运维变更导致故障占比 | 配置/扩缩容引发事故 |
第八类:开发者体验与团队健康(71--80)
| 编号 | 场景 | 评估核心 |
|---|---|---|
| 71 | 开发者满意度 | 定期调研净推荐值 |
| 72 | 研发倦怠风险 | 加班趋势、连续高强度周期 |
| 73 | 会议占用开发时间比 | 可用于编码的净时间 |
| 74 | 上下文切换次数 | 日均工具/任务切换频率 |
| 75 | 新人上手周期 | 首次合并到生产的时间 |
| 76 | 关键人单点风险 | 核心模块单人覆盖率 |
| 77 | 跨团队协作摩擦 | 跨团队 PR 等待与返工 |
| 78 | 工具链碎片化成本 | 工具切换与数据孤岛 |
| 79 | 内部平台 NPS | 开发者对内部工具评分 |
| 80 | 心理安全感水平 | 团队敢于暴露问题的程度 |
第九类:成本、资源与组织效能(81--90)
| 编号 | 场景 | 评估核心 |
|---|---|---|
| 81 | 研发人均产出 | 人均交付需求数/业务价值 |
| 82 | 云资源成本效率 | 每笔交易/请求的资源成本 |
| 83 | 资源利用率 | 计算/存储实际利用率 |
| 84 | 研发浪费识别 | 被取消项目的沉没成本 |
| 85 | 技术债偿还 ROI | 还债投入 vs 效率提升 |
| 86 | 效能改进专项 ROI | 效能投入 vs 交付改善 |
| 87 | 组织级交付风险热力图 | 多团队风险聚合与预警 |
| 88 | 跨 BU 协同效率 | 跨业务单元交付时延 |
| 89 | 研发预算执行偏差 | 预算 vs 实际投入 |
| 90 | 产品线研发投入产出比 | 投入成本 vs 业务营收贡献 |
第十类:AI 辅助研发与智能化效能(91--100)
| 编号 | 场景 | 评估核心 |
|---|---|---|
| 91 | AI 代码生成采纳率 | 接受建议数 vs 总建议数 |
| 92 | AI 生成代码缺陷率 | AI 代码引发的 Bug 占比 |
| 93 | AI 辅助 Code Review 覆盖率 | 自动评审参与比例 |
| 94 | AI 测试用例生成有效率 | 生成用例的可执行比例 |
| 95 | AI 排期/估点偏差 | 预测 vs 实际工时差异 |
| 96 | 人机协同交付周期变化 | 引入 AI 前后前置时间对比 |
| 97 | AI 工具使用渗透率 | 活跃用户占比、功能覆盖 |
| 98 | AI 生成代码后续维护成本 | AI 代码的重构/修复频率 |
| 99 | AI 效能改进 A/B 实验 | 对照组的量化差异 |
| 100 | 大模型辅助需求转设计准确率 | 需求到设计文档的可用度 |
四、场景 → 指标映射矩阵(精华)
| 业务域 | 第一指标 | 第二指标 | 红线指标 |
|---|---|---|---|
| 需求价值流 | 需求前置时间 | 流效率(活跃/总时长) | 高价值需求等待超阈值 |
| 持续交付 | 部署频率 / 变更前置时间 | 变更失败率 | 生产事故不可自动回滚 |
| 工程质量 | 缺陷逃逸率 | 技术债指数 | 核心模块零测试覆盖 |
| 系统韧性 | MTTR | SLO 达成率 | P0 故障无告警 |
| 开发者体验 | 满意度 NPS | 上下文切换次数 | 核心骨干连续加班超阈值 |
| 测试效能 | 自动化分层覆盖率 | Flaky Test 比例 | 回归测试全靠人工 |
| 运维可靠性 | 告警有效命中率 | 故障检测时延 | 数据丢失不可恢复 |
| 成本经济 | 云成本/交易量 | 资源利用率 | 预算穿底 |
| AI 辅助研发 | AI 采纳率 | AI 生成缺陷率 | 黑盒 AI 决策无审计 |
| 组织效能 | 交付吞吐量 | 浪费率 | 关键人单点无备份 |
五、软件研发效能的可落地公式
5.1 主从结构:安全底线 × 效能加权
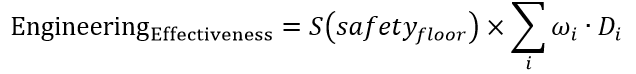
其中:
- S(safety_floor) :安全底线函数,前置门禁,不是维度之一
- 交付安全:近 30 天是否出现可避免的 P0/P1 生产事故
- 系统韧性:是否存在无备份的单点故障、数据不可恢复
- 人员安全:核心骨干是否出现批量流失或持续过劳
- 合规安全:是否发生数据泄露、合规违规
- 只要 S = 1(无红线事件),效能计算继续;一旦 S = 0,总分归零
- Σ wᵢ · Dᵢ:七个维度的加权线性组合,权重随组织类型、发展阶段、业务周期动态变化
这个结构的含义是:研发系统先过"安全关",过了之后才比"谁更高效、更可持续、更经济"。
5.2 权重的动态性:不是一张表能解决的
| 场景切换 | 权重迁移方向 | 例子 |
|---|---|---|
| 稳态业务 → 高速扩张 | 交付效能(↑↑) > 工程质量(↓) | 新市场抢占期:上线速度压倒一切 |
| 正常期 → 大范围故障后 | 系统韧性(↑↑) > 交付速度(↓↓) | 事故复盘后:稳定性权重飙升 |
| 传统研发 → AI 全面铺开 | AI 可信(↑↑) > 运营效率(↓) | AI 辅助上线前 3 个月:生成代码审计权重最高 |
| 人员充裕 → 核心骨干流失 | 开发者体验(↑↑) > 吞吐量(↓) | 关键人离职后:团队健康权重反超产出 |
| 成本宽松 → 预算紧缩 | 经济与资源(↑↑) > 协作(↓) | 降本周期:云成本/人均产出权重飙升 |
所以更诚实的做法是:不要给一个固定权重表,而是给出权重变化的触发条件和迁移方向。
六、常见误区
| ❌ 错误做法 | ✅ 正确认知 |
|---|---|
| 代码行数多 = 产出高 | 一天 3000 行代码,其中 2000 行是复制粘贴,技术债爆炸 |
| 流水线全绿 = 交付健康 | 测试全是断言 assert true,生产照样出 P0 |
| DORA 四指标全优 = 团队优秀 | 部署频繁但全是低价值配置变更,业务指标纹丝不动 |
| AI 采纳率 80% = 效能提升 | AI 生成代码缺陷率 30%,Code Review 成本翻倍 |
| 故事点完成多 = 迭代成功 | 交付的全是边角功能,核心业务需求排了三个月 |
| 缺陷数少 = 质量好 | 测试环境形同虚设,Bug 全留到生产才发现 |
| 会议少 = 协作高效 | 不沟通导致需求理解偏差,返工率 40% |
| 覆盖率 95% = 测试充分 | 全是 getter/setter 的测试,核心逻辑零覆盖 |
| 个人代码提交最多 = 最佳员工 | 单人修改 70% 核心模块,Bus Factor = 1,组织风险极高 |
| 模型上线 = 效能改进结束 | 不监控 PR-AUC 漂移,三个月后模型悄悄变质 |
七、结语
100 个场景,10 大领域,7 个维度------
这不是"研发效能指标清单",而是一张软件研发与组织效能系统评估地图。
无论你在做:
- 研发效能平台 / DevOps 工具链 / 效能度量中台
- 敏捷转型 / PMO / 组织效能改进
- 代码质量 / 架构治理 / 技术债管理
- CI/CD 优化 / 发布工程 / SRE
- 开发者体验 / 内部工具 / 工程文化
- AI 辅助研发 / 代码大模型 / 智能测试
- 云成本优化 / 资源调度 / 研发经济
都能从这张地图里找到自己的坐标。
度量的目的不是"谁差",而是"系统哪里可以更好"。
八、勘误及更新说明
本文如有疏漏或表述不当之处,欢迎各位读者在评论区指正,博主会持续关注反馈并及时修正优化,力求内容准确可靠。感谢大家的监督与陪伴。