一、首先确认一个结论
Linux 中的线程是用进程来模拟实现的,它在 Linux 中都叫做轻量级进程(LWP)。
- 每个进程在自己的用户空间中拥有资源;进程内部的线程只要有自己独立的 PCB 和资源划分,就拥有了对应的资源
- 本文的内容:缺点 → 线程出现异常的表现 → 用途 → 最后对比进程与线程
二、线程的优点
2.1 教材上的优点清单(7 条)
| # | 优点 | 一句话解释 |
|---|---|---|
| ① | 创建一个新线程的代价要比创建一个进程小得多 | 进程已存在 = 资源已分配,线程只要建 PCB + 划分资源 |
| ② | ★ 线程之间的切换,OS 要做的工作少很多 | 具体看下面的解释 |
| ③ | 线程占用的资源要比进程少 | 线程拿的资源本身就是进程的一部分 |
| ④ | 能充分利用多处理器的可并行数量 | 线程是调度的基本单位,多核才能跑满 |
| ⑤ | 等待慢速 I/O 的同时,程序可以执行其他计算任务 | 多进程同样能做到,不是线程专有优点 |
| ⑥ | 计算密集型应用,把计算分解到多线程 | 在多处理器上运行才划算 |
| ⑦ | I/O 密集型 应用,让 I/O 操作重叠 | 同时等待不同的 I/O,提高吞吐 |
✖ 别把 ⑤ 当成线程的独有优点------进程同样也有这个优点
💡 如果在找工作面试时不用死背 7 条:你只需要记住"线程更轻量化"就够了,剩下的到时候现场展开。
2.2 为什么线程创建代价小(②③①)
| 操作 | 创建进程 | 创建线程 |
|---|---|---|
| PCB / task_struct | 要创建 | 要创建 |
| 地址空间(mm_struct) | 要创建 | 不创建,共享 |
| 页表 | 要创建并构建映射 | 不创建,共享 |
| 运行时 | 还要不断处理缺页中断、调度、内存管理 | 直接参与调度即可 |
✔ 本质:创建线程时进程一定已经存在了------说人话就是资源已经分配了,线程只要"PCB + 资源划分",代价当然小。
2.3 两种应用类型:计算密集型 vs I/O 密集型
在 Linux 里 一切皆进程(你在系统中跑的所有任务全以进程身份运行),而计算任务可以分成两类:
| 类型 | 典型场景 | 特征 | 多线程策略 |
|---|---|---|---|
| 计算密集型 | 加密解密、压缩解压、各种算法、游戏画面、大模型训练 | 大部分时间消耗 CPU 资源 | 线程数 ≈ CPU 核数,不要多 |
| I/O 密集型 | 写磁盘、网络下载/上传、访问数据库 | 大部分时间在等 | 线程可以多创建一点,让 I/O 重叠 |
计算密集型的例子(学校和 AI 都能套上)
- 大文件排序 :1TB 数据切成 4 份(每份 256G 甚至 1G),创建 4 个线程各排各的,局部有序后再归并成一个更大的有序序列
- 游戏画面 :显示器本质是一个 XY 二维平面 ,上面有无数像素点,每个像素点由 RGB 三元素 构成;画面刷新 = 高频更新每个坐标的 RGB 数值(等价于三个二维矩阵,也就是一个三维矩阵),所以它是典型的矩阵式计算
- 大模型 :数据矩阵化 + 前向传播 / 反向传播也是矩阵更新 → 和游戏画面的矩阵计算非常像
- 所以大模型训练更爱用 GPU :GPU 本来就能把大型游戏的计算扛住,矩阵计算面前 CPU 就是个小学生
I/O 密集型的例子(多线程下载)
单线程下载:带宽很宽,但远端不一定准备好 → 大部分时间在白等
多线程下载:线程①下载第 1GB、线程②下载第 2~3GB、线程③......各下同一文件的不同区域
           → 把带宽压力拉满;万一卡住了,四个线程同时在等,总有人先读到数据
2.4 线程不是越多越好(重要结论)
✖ 误区:听说多线程好,那就开十个八个线程。
| 场景 | 合理线程数 | 为什么 |
|---|---|---|
| 计算密集型 | = CPU 核数(正相关) | 2 个 CPU 开 8~10 个线程,每个核平均分到 4~5 个线程,它除了算还得切换------本来用于计算的算力被切换吃掉了,反而更慢 |
| 单核上的计算密集型 | 单线程最快 | CPU 上永远只有你一个人在算,没人打扰,没有切换成本 |
| I/O 密集型 | 可以多一些 | 大部分时间在等,线程多了,概率上总有那么几个线程能读到数据,提升上传/下载效率 |
💡 下次有人问"线程数怎么定",答这句:看任务是吃 CPU 还是在等 I/O。
三、★ 重点:线程切换为什么比进程切换更便宜
3.1 先看清:进程切换到底在切什么
进程切换的核心就三件事:
- 切换 PCB / task_struct(背后就是一大堆数据结构:地址空间、信号、文件......全跟着换)
- 切换 CR3 寄存器 ------CR3 里放的是页目录起始地址 ,所以 CR3 一换,页表和整套虚拟↔物理映射关系就全换了
- 保存并恢复 CPU 寄存器上下文(保存到 PCB 里,再把下一个进程的上下文装上)
💡 OS 怎么知道"当前是谁在跑"?内核里有一个当前进程指针 current (更准确说是 per-CPU 的),它永远指向当前正在运行的 task_struct;调度器按(大 O(1) 调度算法)优先级从 active 队列里选中一个进程后,current 就指向它。
- 内核源码里
current的定义前面加了register关键字------这是个建议型关键字,意思是"建议编译器把这个指针放到寄存器里",因为取当前进程这个操作太频繁了 - 所以:PCB 也好、CR3 页目录也好,本质上都是 CPU 内部的寄存器 → 进程切换 = 把 CPU 的硬件上下文 换一遍,完事
3.2 线程切换:省掉了什么(但还不够)
判定规则很简单:
OS 判断"下一个线程还在不在当前进程里"------看两者指向的地址空间是不是同一个。
c
if (next->mm == current->mm)   // 地址空间相同 = 同一个进程内的线程
    /* 不用换 CR3、不用换页表 */;
else                            // 换到别的进程的线程 → 这已经是进程切换了
    switch_mm();                // 换 CR3 + 页表
线程切换时:
- ✔ task_struct 要切(每个线程有自己独立的 PCB)
- ✔ CPU 寄存器上下文要保存/恢复(运行时有自己的临时数据)
- ✖ 页表不用换、地址空间不用换、CR3 不用保存 ------ 因为所有 PCB 都指向同一个
mm_struct,映射关系天然不变
⚠️ 但这并不是降低成本的根本原因:
"好像能低那么一点点,但总有点杯水车薪------一个寄存器的值而已,保存一下也无伤大雅。单看这个,根本看不出来谁的成本明显更低。"
所以 3.2 不是主要原因,真正的原因在下面。
3.3 真正的元凶:Cache 和 TLB 失效
CPU 内部针对当前进程 ,其实维护着两大缓存:
| 缓存 | 缓存的东西 | 位置 |
|---|---|---|
| Cache(硬件高速缓存) | 用户数据本身(内存里的代码/数据) | CPU 内部,一般还分 L1/L2/L3 多级 |
| TLB(快表 / 转译后备缓冲器) | 虚拟地址 → 物理地址 的映射关系 | CPU 内部,与 MMU 协同 |
① Cache:对用户数据做缓存(对用户透明,你感知不到)
你写代码:int a=10, b=20, c=30, d=100;
读 a 时,CPU 不会只把 a 读进来 ------ 它依据【局部性原理 / 预加载策略】,
会把 a 周边的一整块数据都搬进 CPU 内部的 Cache。
→ 第一次访问:穿透到内存
→ 第二次访问:命中 Cache,直接从 CPU 内部拿,不用再跑内存
→ 没命中:仍然要做内存块与 Cache 之间的置换
② TLB:缓存虚拟到物理的映射关系(复习上一节)
- 多级页表省了空间,代价是查询要多次访存;于是 CPU 里加了一层 TLB:MMU 先查 TLB,命中就直接拿到物理地址,未命中才走多级页表这个"保底武器",查完顺手写回 TLB
③ 关键结论
| 场景 | Cache | TLB | 后果 |
|---|---|---|---|
| 进程切换 | 直接失效 | 直接失效 | 下次回来还要做热加载 ,把数据、映射项重新"热"起来------这才是最大的成本 |
| 线程切换 | 不会大面积失效 | 永远都不会大面积失效 | 不需要重新热起来 → 成本极低 |
✔ 为什么线程切换不会失效?因为它压根不换页表。 映射关系的条目是稳定的、不变的,TLB 里缓存的虚拟→物理映射自然不用动。
一句话:进程切换会让 TLB 和 Cache 全部失效,下次运行需要重新缓存;线程切换不会导致缓存失效 ------ 这才是线程切换成本低的根本原因。
💡 这跟软件没关系,是硬件层面的事;但它和"你到底选多进程还是多线程"密切相关。
四、线程的缺点
| 缺点 | 说的是什么 | 注脚 |
|---|---|---|
| 性能损失 | 线程创建得过多 → 切换成本变高 → 反而变慢 | 严格说是"创建太多"的缺点,多进程也一样 |
| 健壮性降低 | 一个线程出错,会连累整个进程被干掉 | 因为共享地址空间 |
| 缺乏访问控制 | 线程之间没有天然隔离,一个线程可以直接改掉另一个线程的数据 | 进程则有天然独立性 |
| 编程难度提高 | 要处理共享数据的并发访问 | 后续线程同步互斥要解决的核心问题 |
4.1 我对这份"缺点清单"的态度
✖ 不要死记这些缺点,它们描述的其实是**"用不好"的后果**:
- 什么性能损失?------ 你别创建那么多不就完了
- 什么健壮性降低、缺乏访问控制?------ 你别去访问别人的东西不就完了
- 什么编程难度高?------ 你把代码写好一点就没问题
✔ 真正想表达的差异只有一句:进程天然具有独立性 (你爱怎么写怎么写,不会影响别的进程);线程一旦出问题,就会影响同进程内的其他线程。
4.2 辩证的一面:缺乏访问控制也是优点
💡 在这个世界上,所有的事情都只有特点;优缺点是人为强加的,任何一件事都有两面性。
回想进程间通信那一段:折腾半天(管道、共享内存、消息队列......),研究的本质都是"怎么让不同进程看到同一份资源"。
- 而线程天然就能看到 同一份资源 → 在线程里做资源共享,是特别容易的事情
- 所以"缺乏访问控制"既是缺点,也正是多线程的最大优点
五、线程出现异常的表现
5.1 结论
线程是进程的执行分支,线程出异常 = 进程出异常。
一旦某个线程出现 除零、野指针(越界访问非法地址) 等错误:
- 该线程崩溃
- OS 依据信号机制给整个进程 发信号,终止进程
- 进程没了,它赖以生存的所有资源------地址空间、页表------全部被释放
- 进程内的所有线程自然也就没有存在下去的必要了
💡 成语总结:覆巢之下,安有完卵(皮之不存,毛将焉附)。
5.2 线程的用途(加餐)
- 合理使用多线程,可以提高 CPU 密集型程序的执行效率(多核算力跑满)
- 可以提高 I/O 密集型程序的用户体验(等待 I/O 的同时还能响应交互)
六、进程 vs 线程:到底哪些共享、哪些私有
6.1 一句话定位
| 定位 | 资源 | |
|---|---|---|
| 进程 | 资源分配的基本单位 | 大部分资源独占,少量共享(如进程间通信) |
| 线程 | 调度的基本单位 | 大部分资源共享 ,少量私有 |
6.2 ★ 私有(面试必答的两条,答对就 80 分)
面试官问"线程相比进程,哪些资源是私有/独占的",必须答出这两条:
| 私有资源 | 说明 | 它证明的事 |
|---|---|---|
| ① 一组寄存器(线程的上下文数据) | 运行时有各种临时数据,CPU 内绝大部分寄存器的值都是线程私有的,要做上下文保存/恢复 | ✔ 线程是可以被独立调度的 |
| ② 独立的栈结构 | 函数调用要形成栈帧,栈里保存的是临时变量 | ✔ 线程是一个动态的概念(有生命周期,压栈/出栈完成临时数据保存) |
为什么栈必须独立?------ 如果多个线程共用一个栈:A 线程入栈,B 线程说我要出栈,栈结构直接就烂完了。
6.3 共享(除了上面那些,剩下的全共享)
| 共享资源 | 说明 |
|---|---|
| 代码区、数据区 | 共享地址空间 → 一个全局变量被两个线程访问时,访问的是同一个变量;A 线程能调的函数,B 线程也能调 |
| 文件描述符表 | 每个进程有自己的 fd 表(讲管道时强调过),线程各自的 PCB 都指向同一张进程 fd 表 |
| 每种信号的处理方式 | 进程里设置了忽略/捕捉,之后创建的线程对信号的处理动作是一致的 |
| 当前工作目录(cwd / pwd) | 进程在哪个目录,线程就在哪个目录 |
| 用户 ID 和组 ID | 进程"是谁在跑"的身份 |
| 堆、共享库、3-4GB 内核区、页表 | 本质都是同一份地址空间 |
6.4 四种组合形态
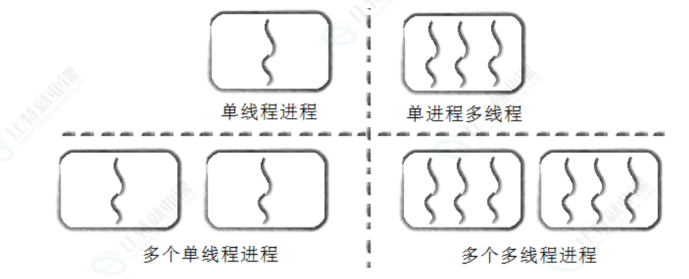
| 形态 | 描述 |
|---|---|
| 单线程进程 | 以前学 C/C++、数据结构时写的全是这种 |
| 多进程(每个进程单线程) | 之前讲的多进程阶段 |
| 单进程多线程 | 一个进程内可以有多个线程 |
| 多进程 + 多线程 | 更复杂的情况,需要时出现 |
✔ 所以换个角度看待从前学过的进程:以前的单进程,就是一个只具有一个线程执行流的进程。
七、总结
7.1 核心结论串
- Linux 线程 = 用进程模拟的轻量级进程(LWP) ,共享同一份
mm_struct和页表 - 线程优点记得一句就够:线程更轻量化;展开则是创建代价小、资源占用少、吃满多核、I/O 可重叠
- 线程数不是越多越好:计算密集型 ≈ CPU 核数,I/O 密集型可多开
- ★ 线程切换更便宜的根本原因:不换页表 ⇒ TLB 和 Cache 不会大面积失效;而"少保存一个 CR3"只是表象,杯水车薪
- 线程缺点(性能损失/健壮性降低/缺乏访问控制/编程难度高)本质是"用不好"的后果;而"缺乏访问控制"的另一面正是线程共享资源极其容易
- 线程异常 = 进程异常 → 信号终止进程 → 线程陪葬(覆巢之下安有完卵)
- 进程 = 资源分配基本单位,线程 = 调度基本单位;线程共享代码/数据/fd 表/信号处理/cwd/uid,私有只有上下文寄存器 + 独立栈(外加 tid/errno/信号屏蔽字/优先级)
7.2 进程 vs 线程 速查表
| 对比项 | 进程 | 线程 |
|---|---|---|
| 定位 | 资源分配的基本单位 | CPU 调度的基本单位 |
| 地址空间 | 独立 mm_struct + 独立页表 | 共享 |
| 资源 | 大部分独占 | 大部分共享,少量私有(寄存器上下文 + 独立栈) |
| 创建代价 | 大(PCB + 地址空间 + 页表 + 映射 + 缺页中断) | 小(PCB + 资源划分) |
| 切换代价 | 大(换 CR3/页表,TLB 与 Cache 全部失效,需要重新热加载) | 小(不换页表,缓存不失效) |
| 健壮性 | 天然独立,互不影响 | 一个线程崩溃 → 整个进程被终止 |
| 共享资源的难度 | 难(IPC:管道/共享内存/消息队列...) | 极易(天然看到同一份资源) |
| Linux 实现 | task_struct + 独立地址空间 | task_struct + 共享地址空间(LWP) |