以前圈子里信奉一句话:Talk is cheap, show me the code。
最近风向变了,流行起 Code is cheap。AI 降低了编码门槛,让不少圈外人形成一种认知:会不会写代码没关系,写得烂也没关系。真的吗?
我听着总觉得不对劲------AI 对烂代码的容忍度远比人类更低。人依靠长期记忆,可以绕开历史遗留的坑;但 AI 新建会话时,很容易被代码库里的烂模式持续带偏。
下面四条思考,来自百亿级 Token 的实战验证,我拆解过多套业界 SDD(Spec-Driven Development,规范驱动开发)工作流,也和大量落地团队交流过踩坑经历。
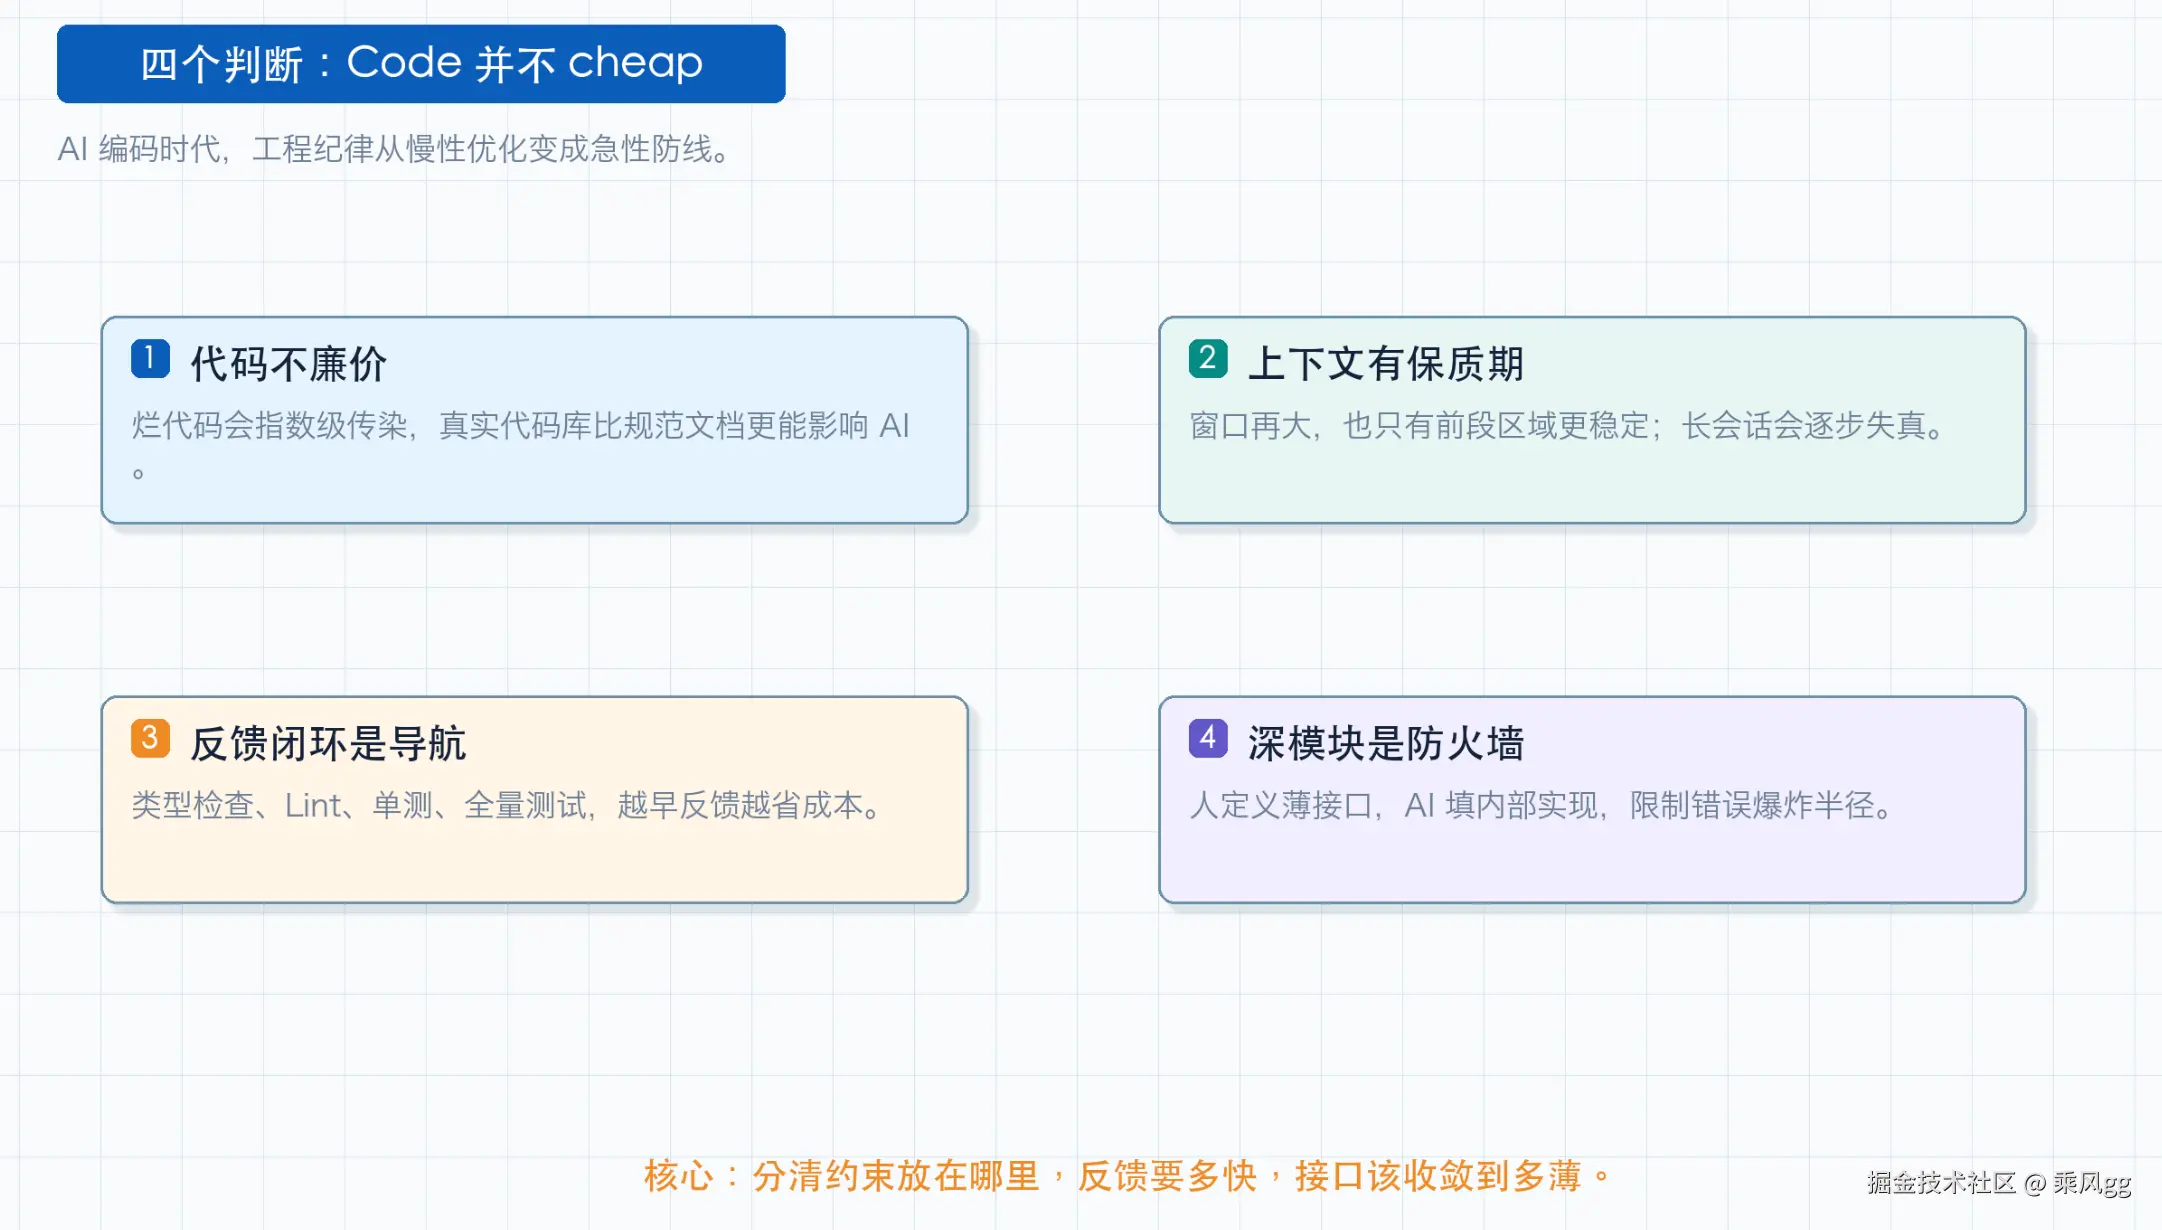
烂代码会指数级传染
代码库天然倾向持续腐化。每一次思考不充分的提交,都在推高「乱码指数」。AI 让提交频次暴增,但梳理架构、编写测试、评判代码优劣,它并不擅长。
更危险的一点:烂代码会指数级传染。 乱码指数 30% 时,AI 尚能找到干净模块作为参考;一旦攀升至 60%,高质量样本被淹没,AI 只能从大量劣质代码里归纳模式,持续产出更糟糕的实现,进一步抬高乱码指数,陷入无法挣脱的死亡螺旋。
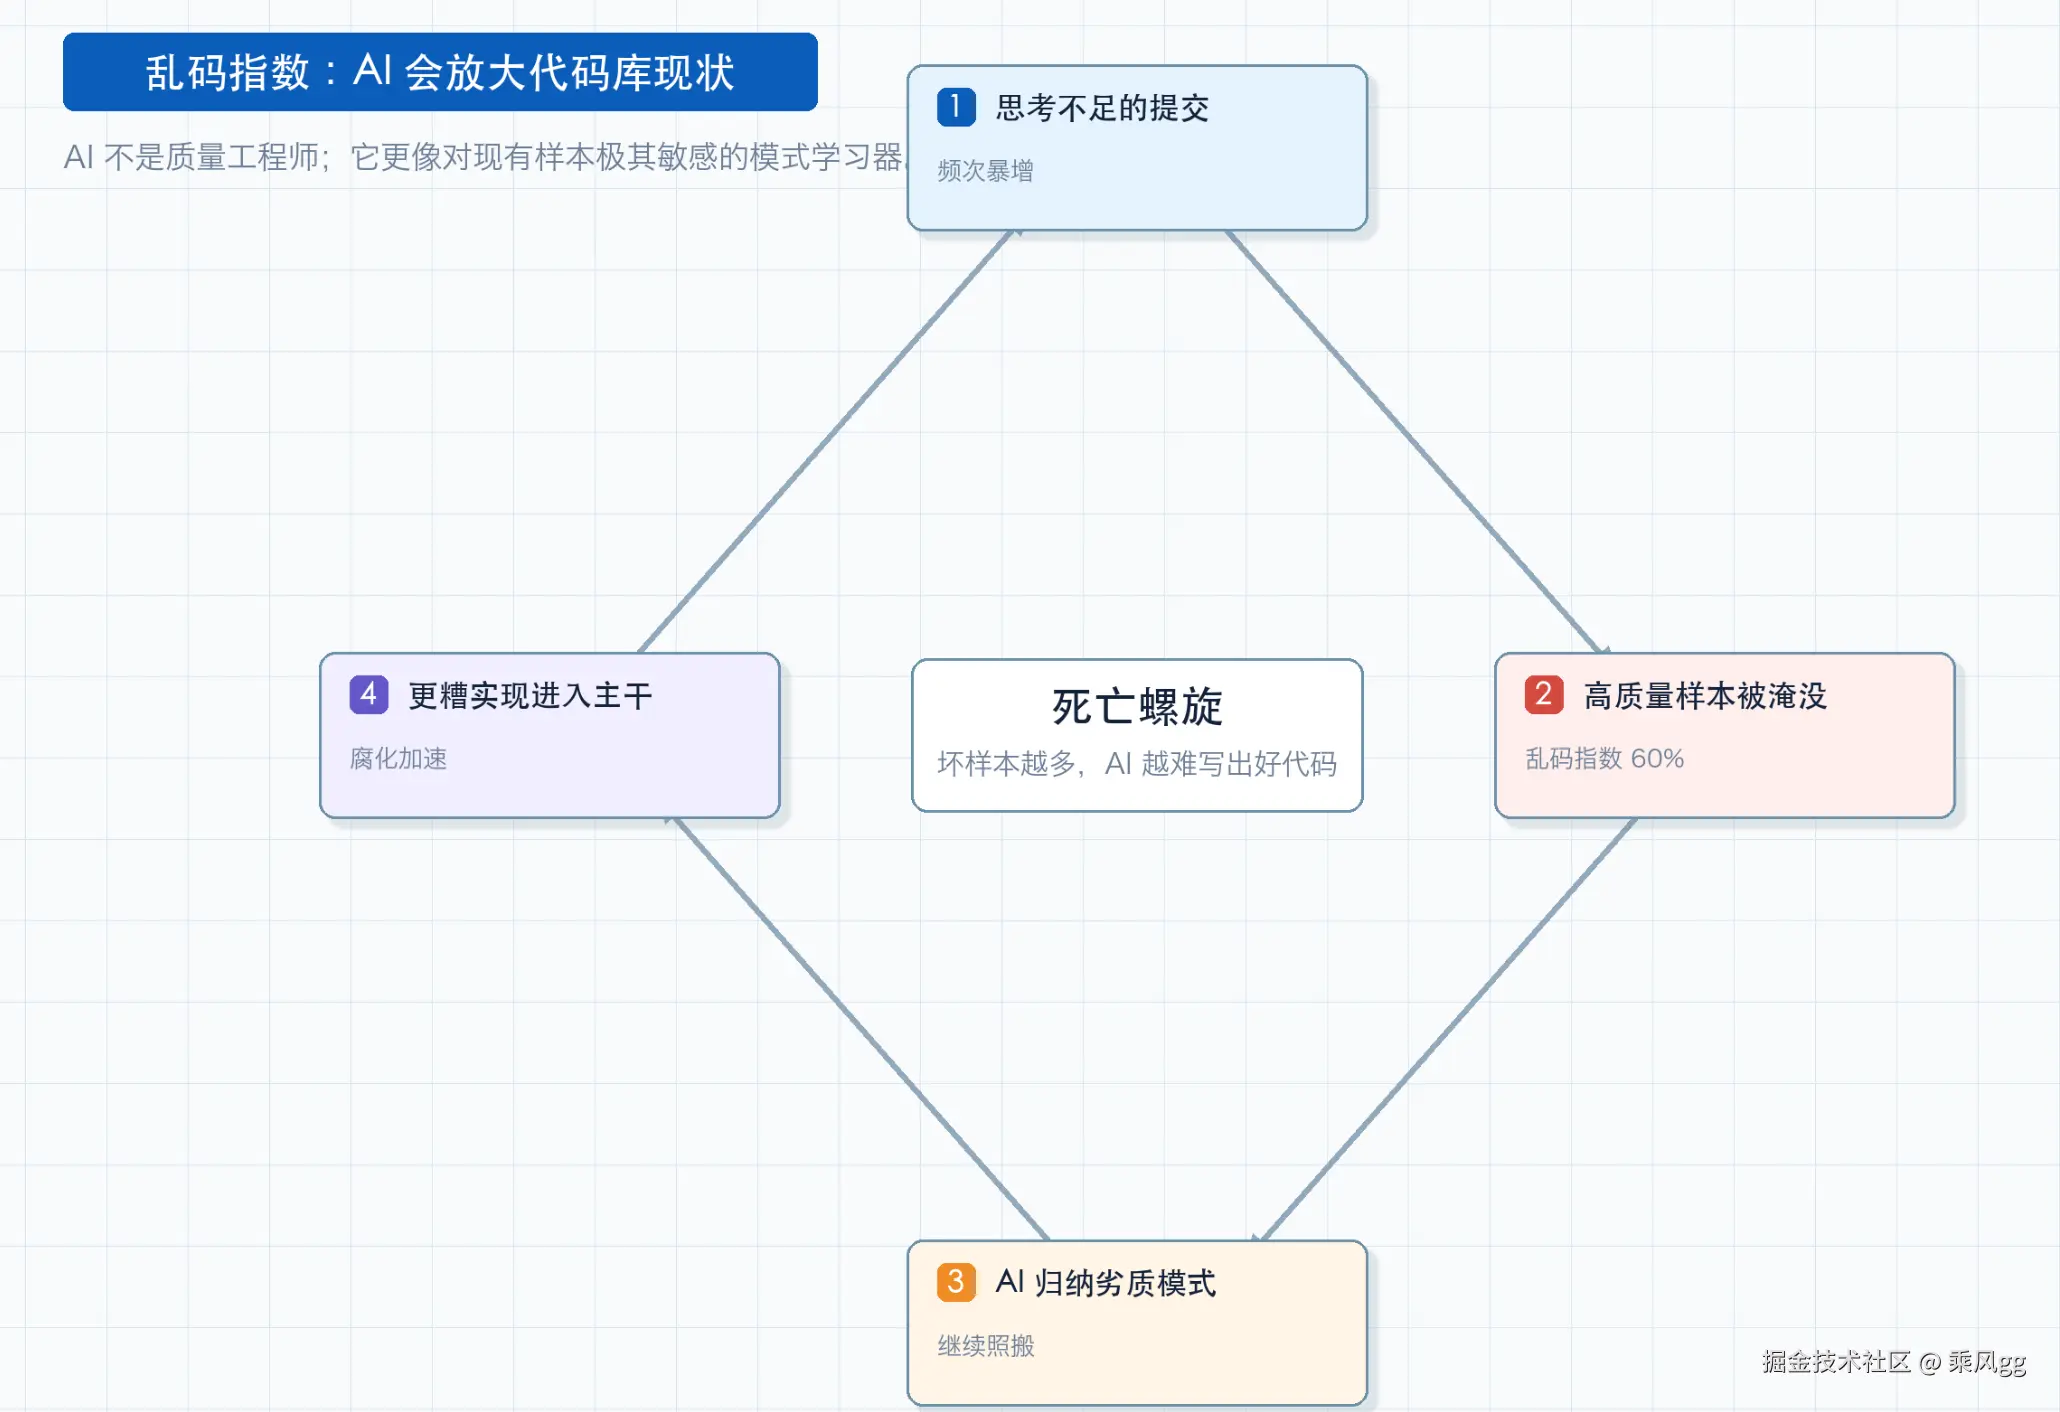
举个例子:你在团队文档写满代码规范,但代码库里五十个现存接口全都没有遵守规范。AI 接入项目后,它会参考群内规范文档,还是直接模仿库里现成接口?它优先照搬现有代码。 代码库真实的现状,远比你写在 CLAUDE.md 里的约束影响力更大。
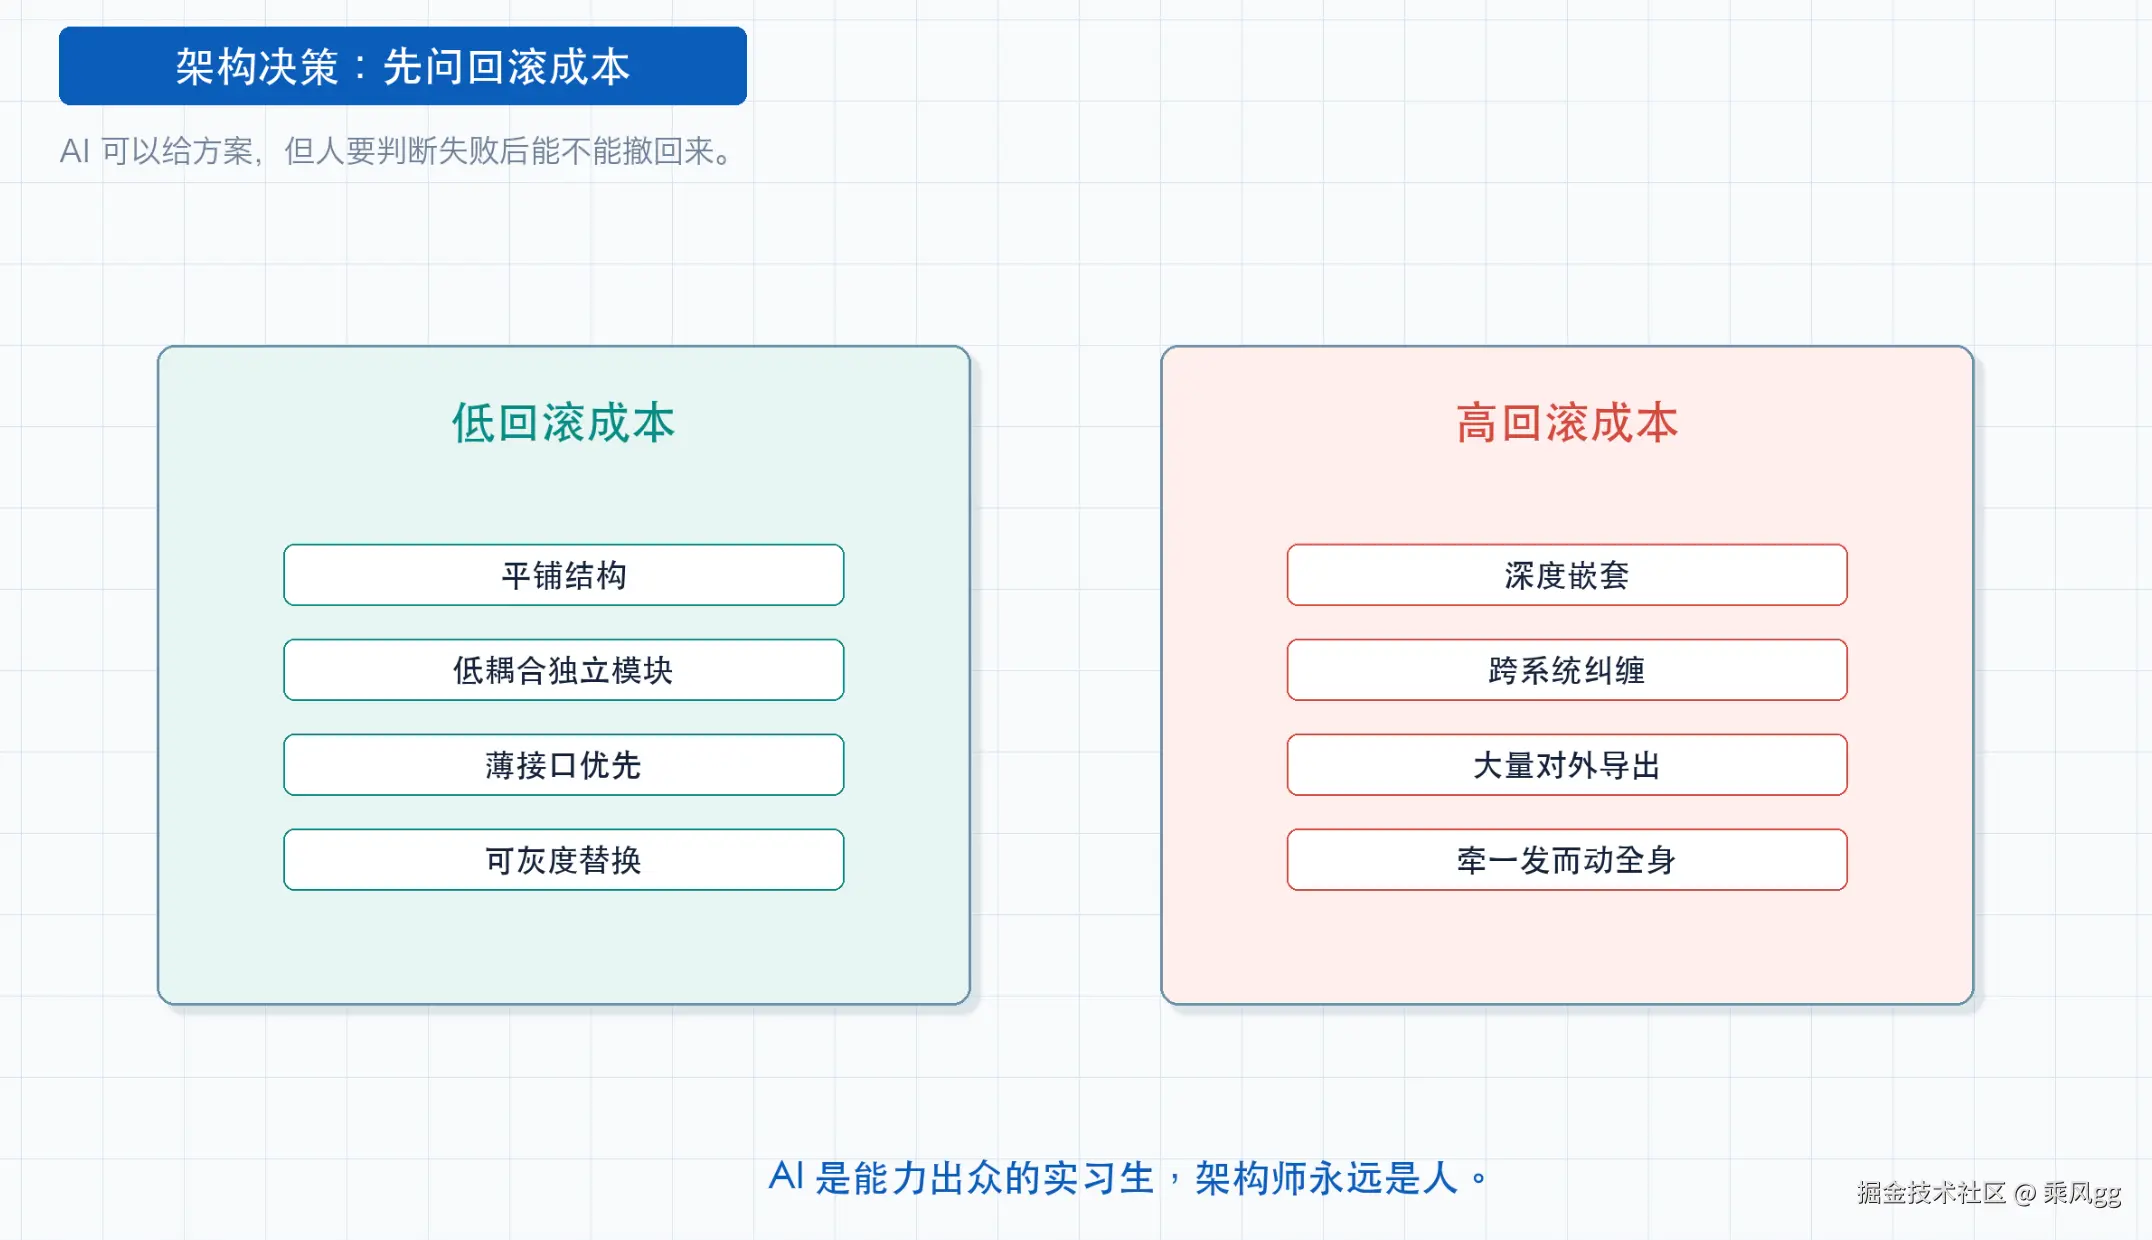
还有一个容易被忽视的风险:AI 给出的架构缺陷,往往要数月之后才暴露。单一会话内,模型看不到系统全局,更无法预判业务三年后的演进方向。所以每次委托 AI 做架构决策时,多追问一句:这个方案一旦失败,回滚成本有多高? 优先选择便于回撤的路径:平铺结构优于深度嵌套,低耦合独立模块优于互相缠绕的代码。AI 只是能力出众的实习生,架构师永远是人。
上下文不是越大越好
如今大模型上下文窗口动辄百万 Token,看起来足以容纳全部项目信息。但有两个客观约束始终没有改变。
第一,上下文容量再大,有效信息保质期有限。 百万 Token 窗口中,靠前大约 60% 的内容推理稳定、判断可靠;越过这条分界线,模型表现明显下滑:幻觉增多、遗忘前置约束、判断力持续衰减。
第二,LLM 具备非确定性。 同样的提示词,不同时段运行,输出结果存在差异。上周全部通过的测试功能,下周可能直接失效。不能依靠"上次运行正常"保障质量,必须依靠持续重跑形成反馈闭环。
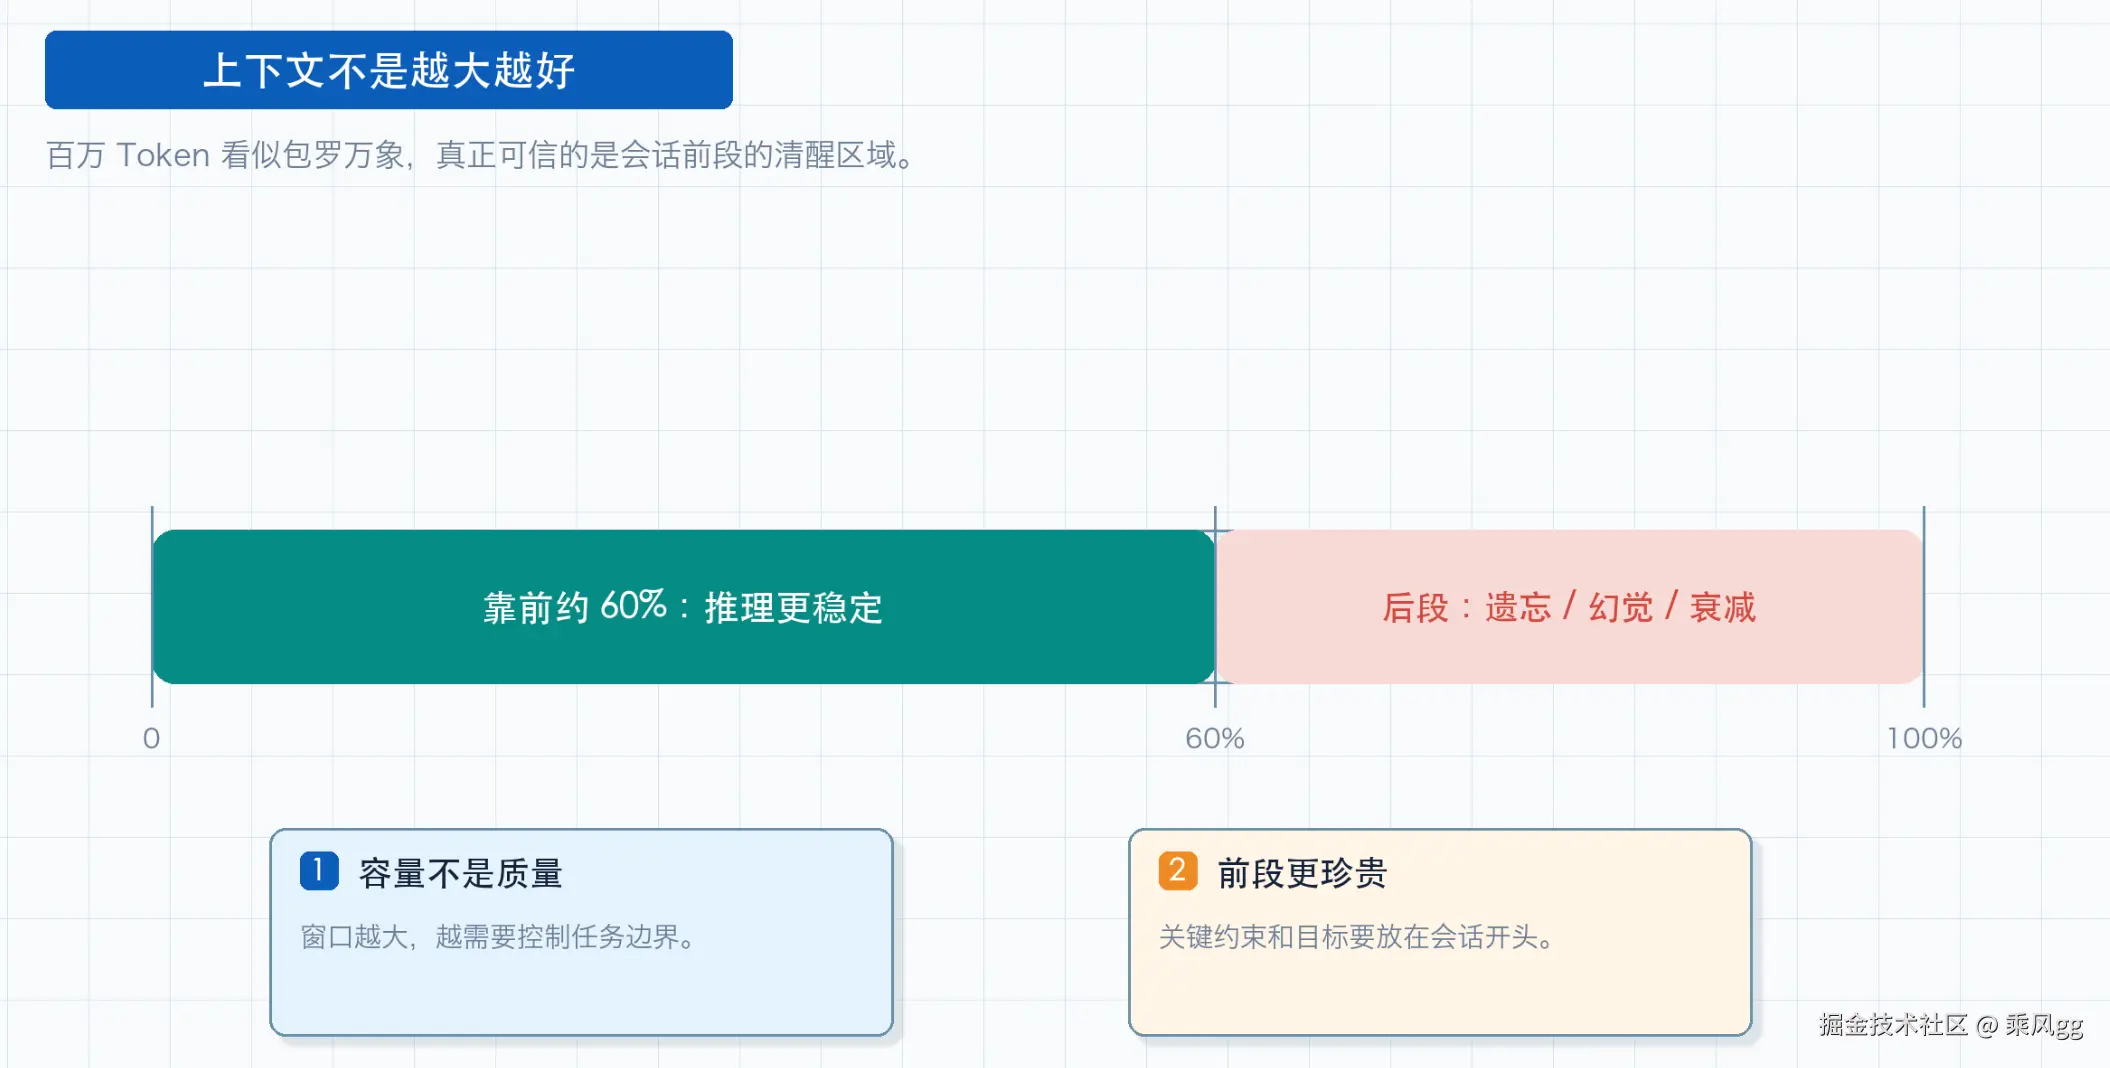
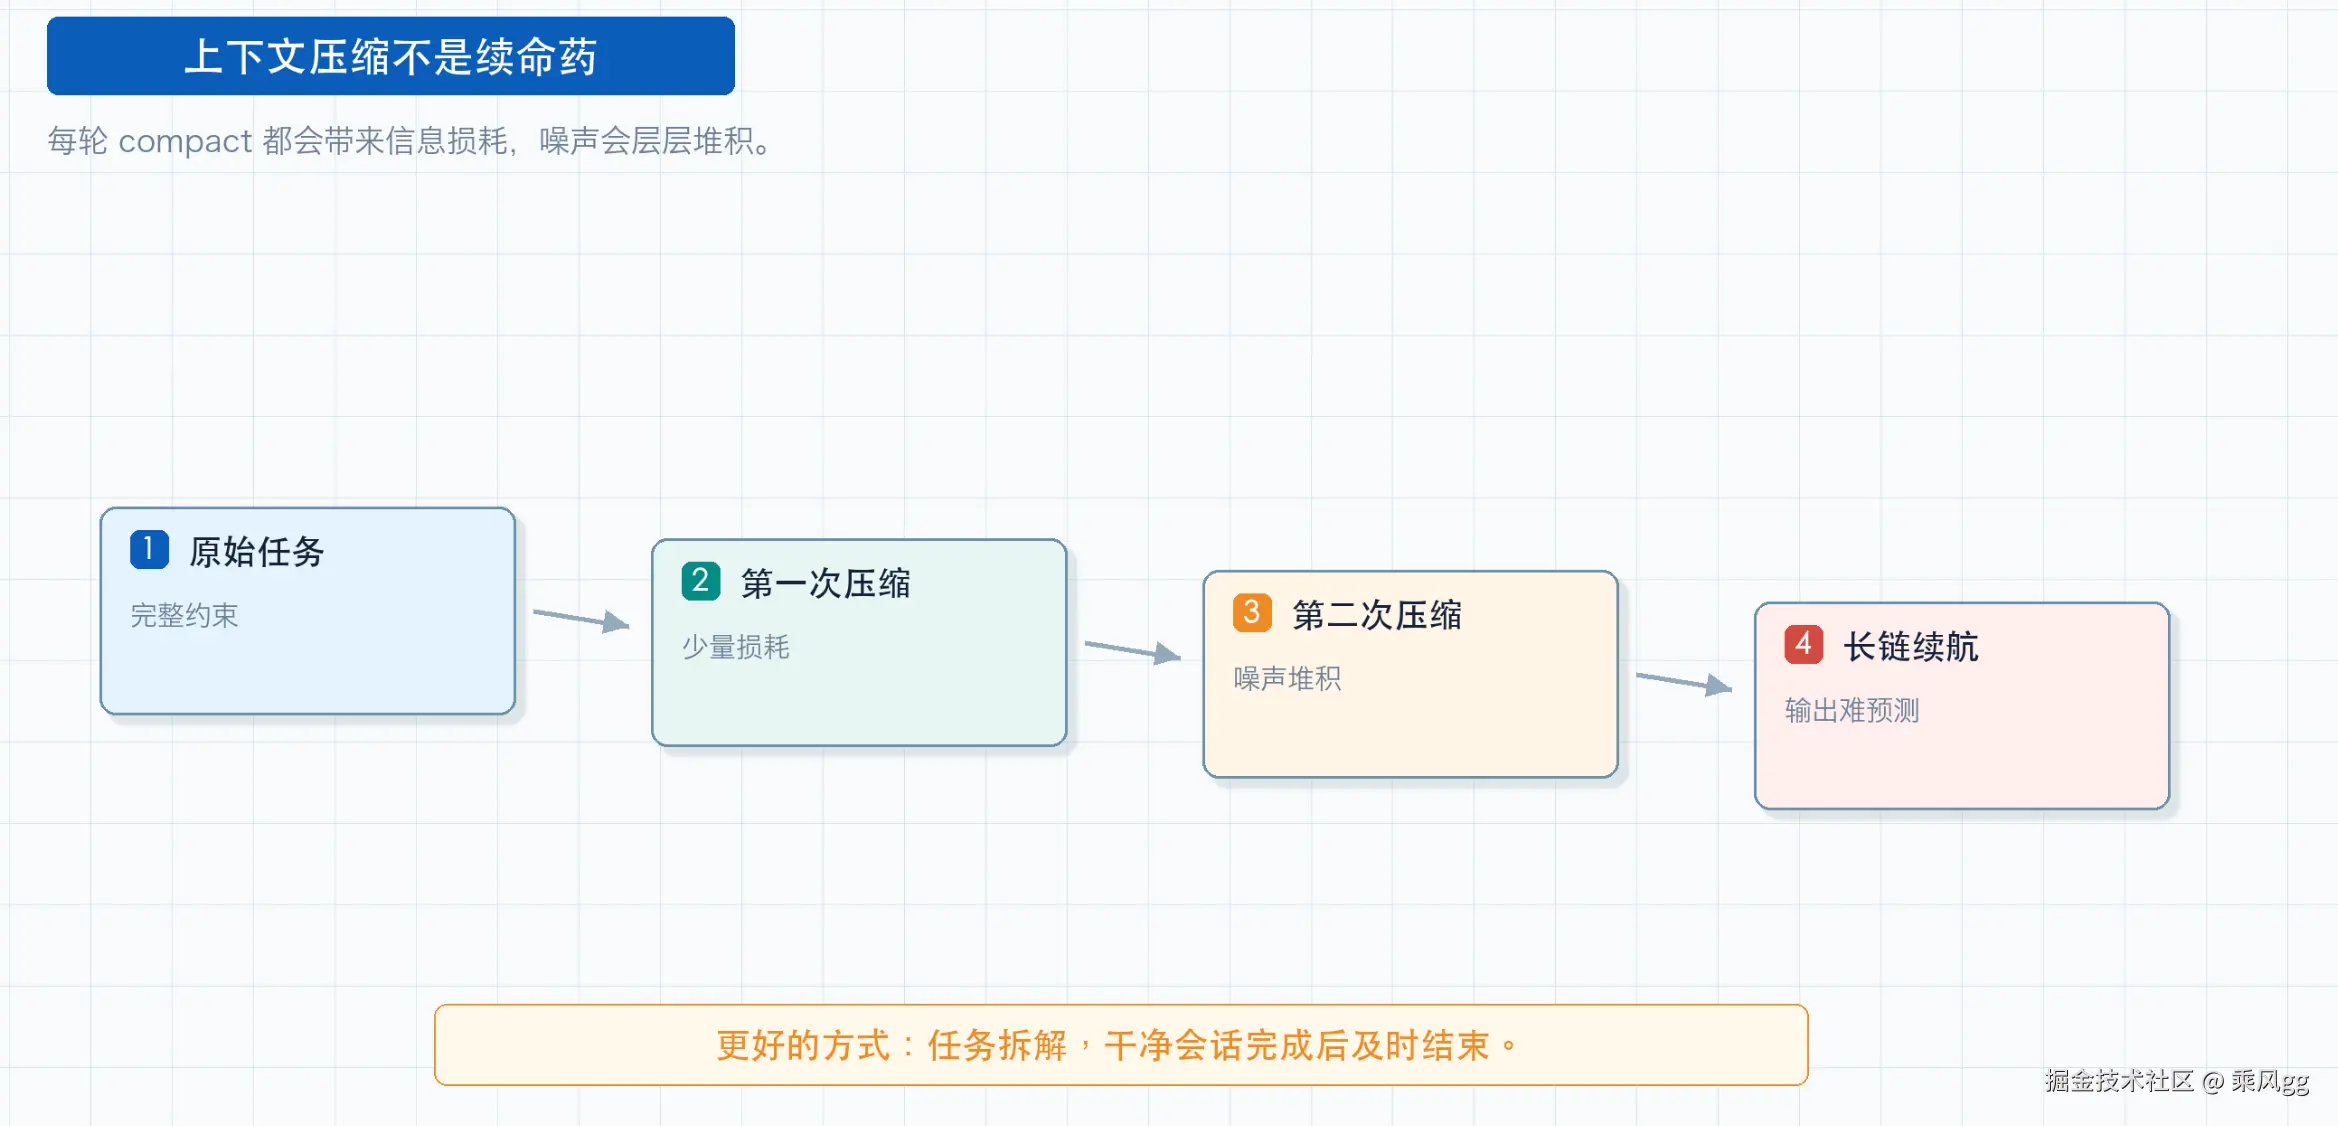
也不要寄希望依靠上下文压缩(compact)续命:每一轮压缩都会产生信息损耗,层层堆积噪声,最终输出结果难以预测。更好的方式是任务拆解,独立干净会话完成任务后及时结束。百万 Token 看似包罗万象,但真正可信的,永远是会话前段的清醒区域。
AI 需要反馈系统
人类编码时,可以连续编写一小时不执行测试,大体方向不会跑偏------脑海里拥有完整业务地图。AI 没有这份全局认知,每生成一行代码都是基于概率重新采样,无法感知自身偏离目标有多远。
因此反馈闭环对 AI 而言,不只是加分项,而是导航系统。缺少闭环,AI 等同于闭着眼开车。
这套导航系统能否发挥作用,核心看两点。
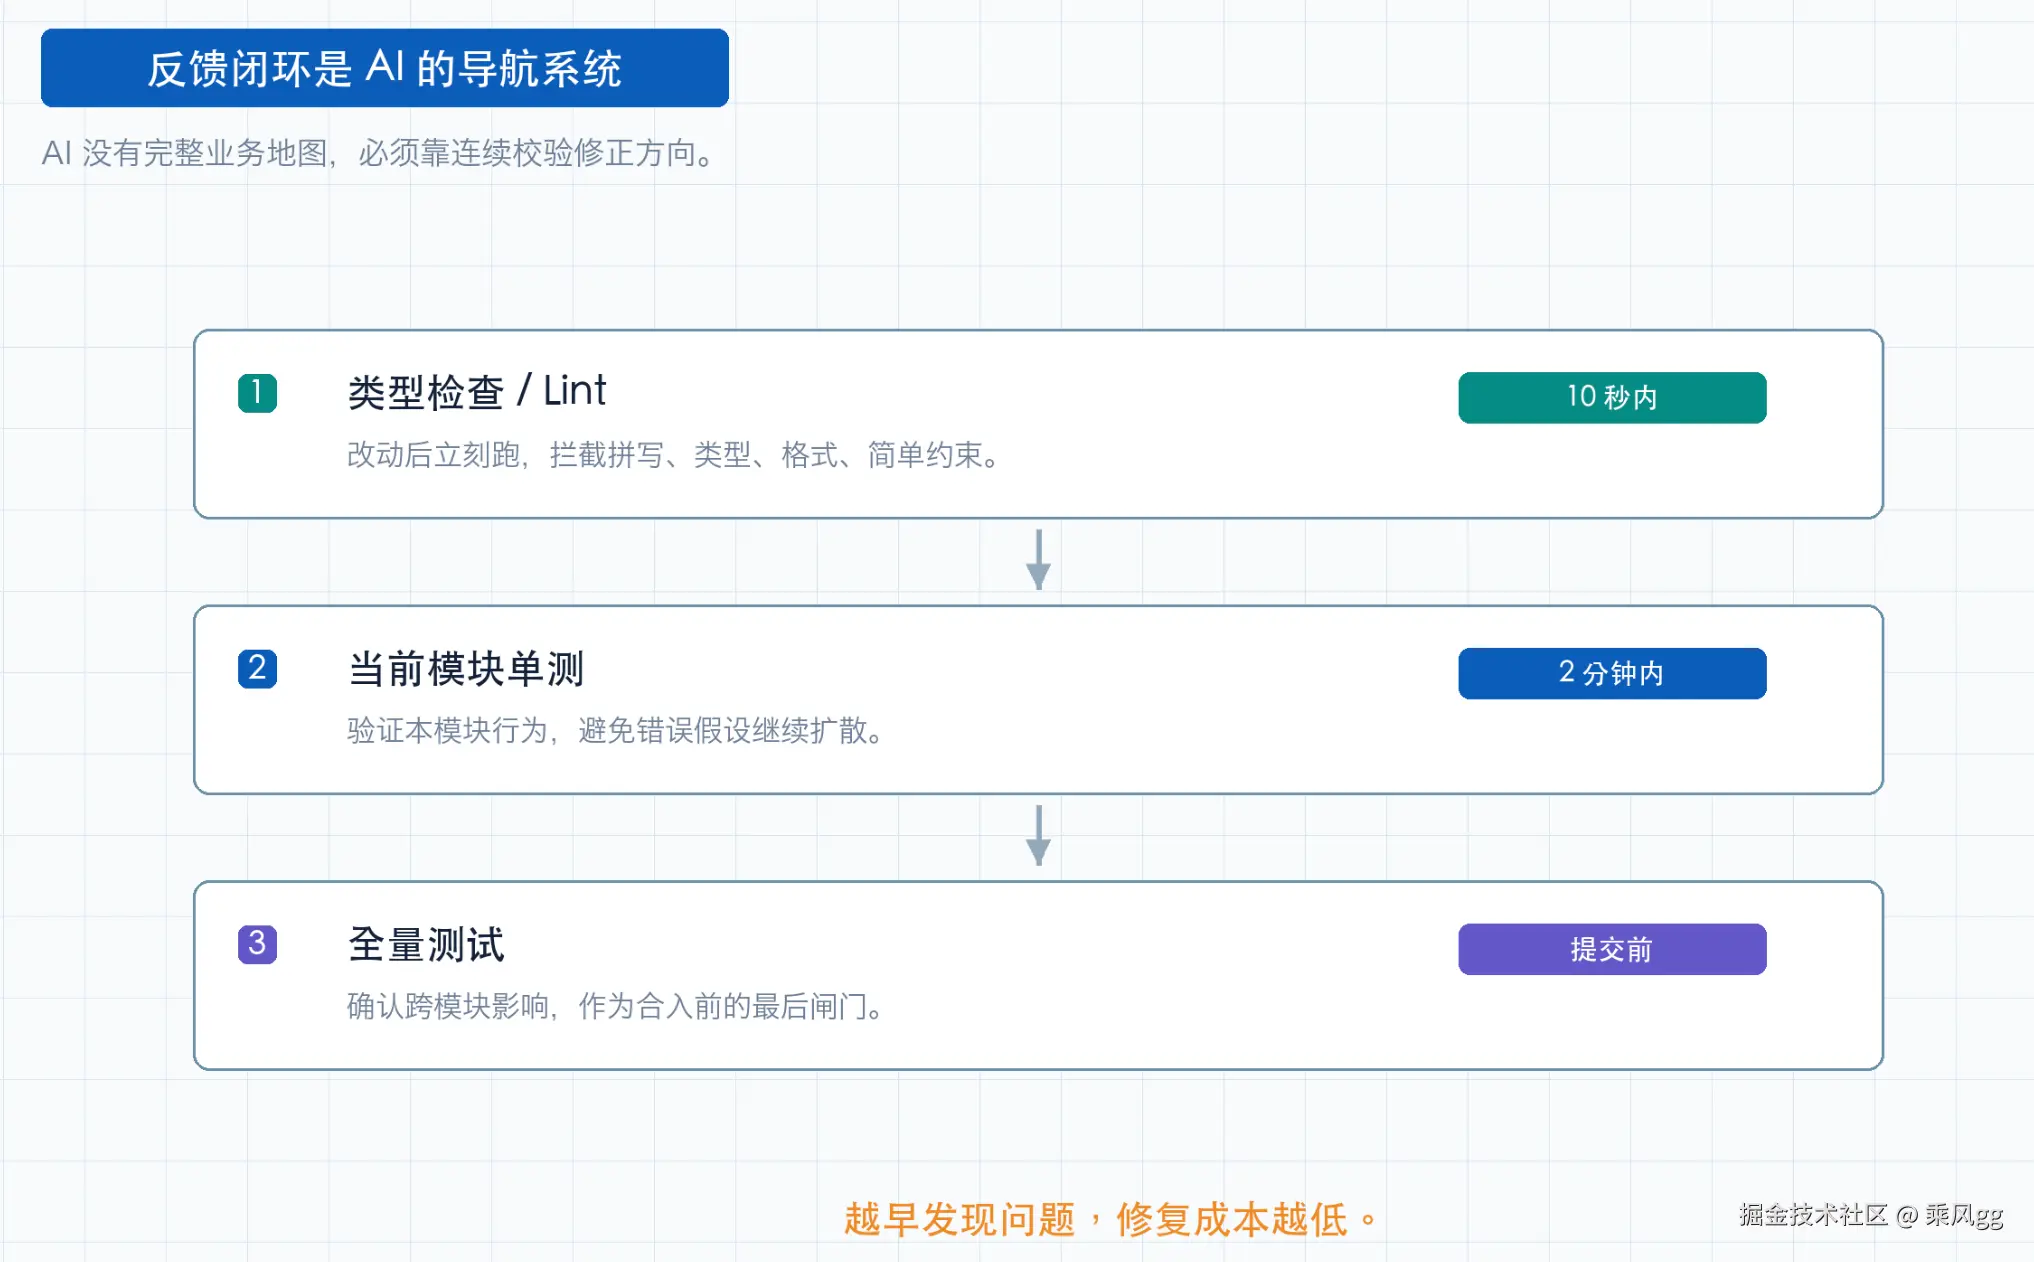
第一,反馈分层,越早发现问题,修复成本越低。 第一层:类型检查与 Lint,文件修改后立刻执行,10 秒内输出结果。第二层:当前模块单元测试,两分钟内完成校验。第三层:全量测试,放在提交代码之前执行。层级之间本质是修复成本的差距:在第一层拦截的错误,调整只需数秒;如果一路漏到第三层,AI 可能已经基于错误假设写了大量代码,需要整体推翻。人具备自我感知,中途能察觉异常;AI 不会,上一行的错误,会直接成为下一行代码的输入。
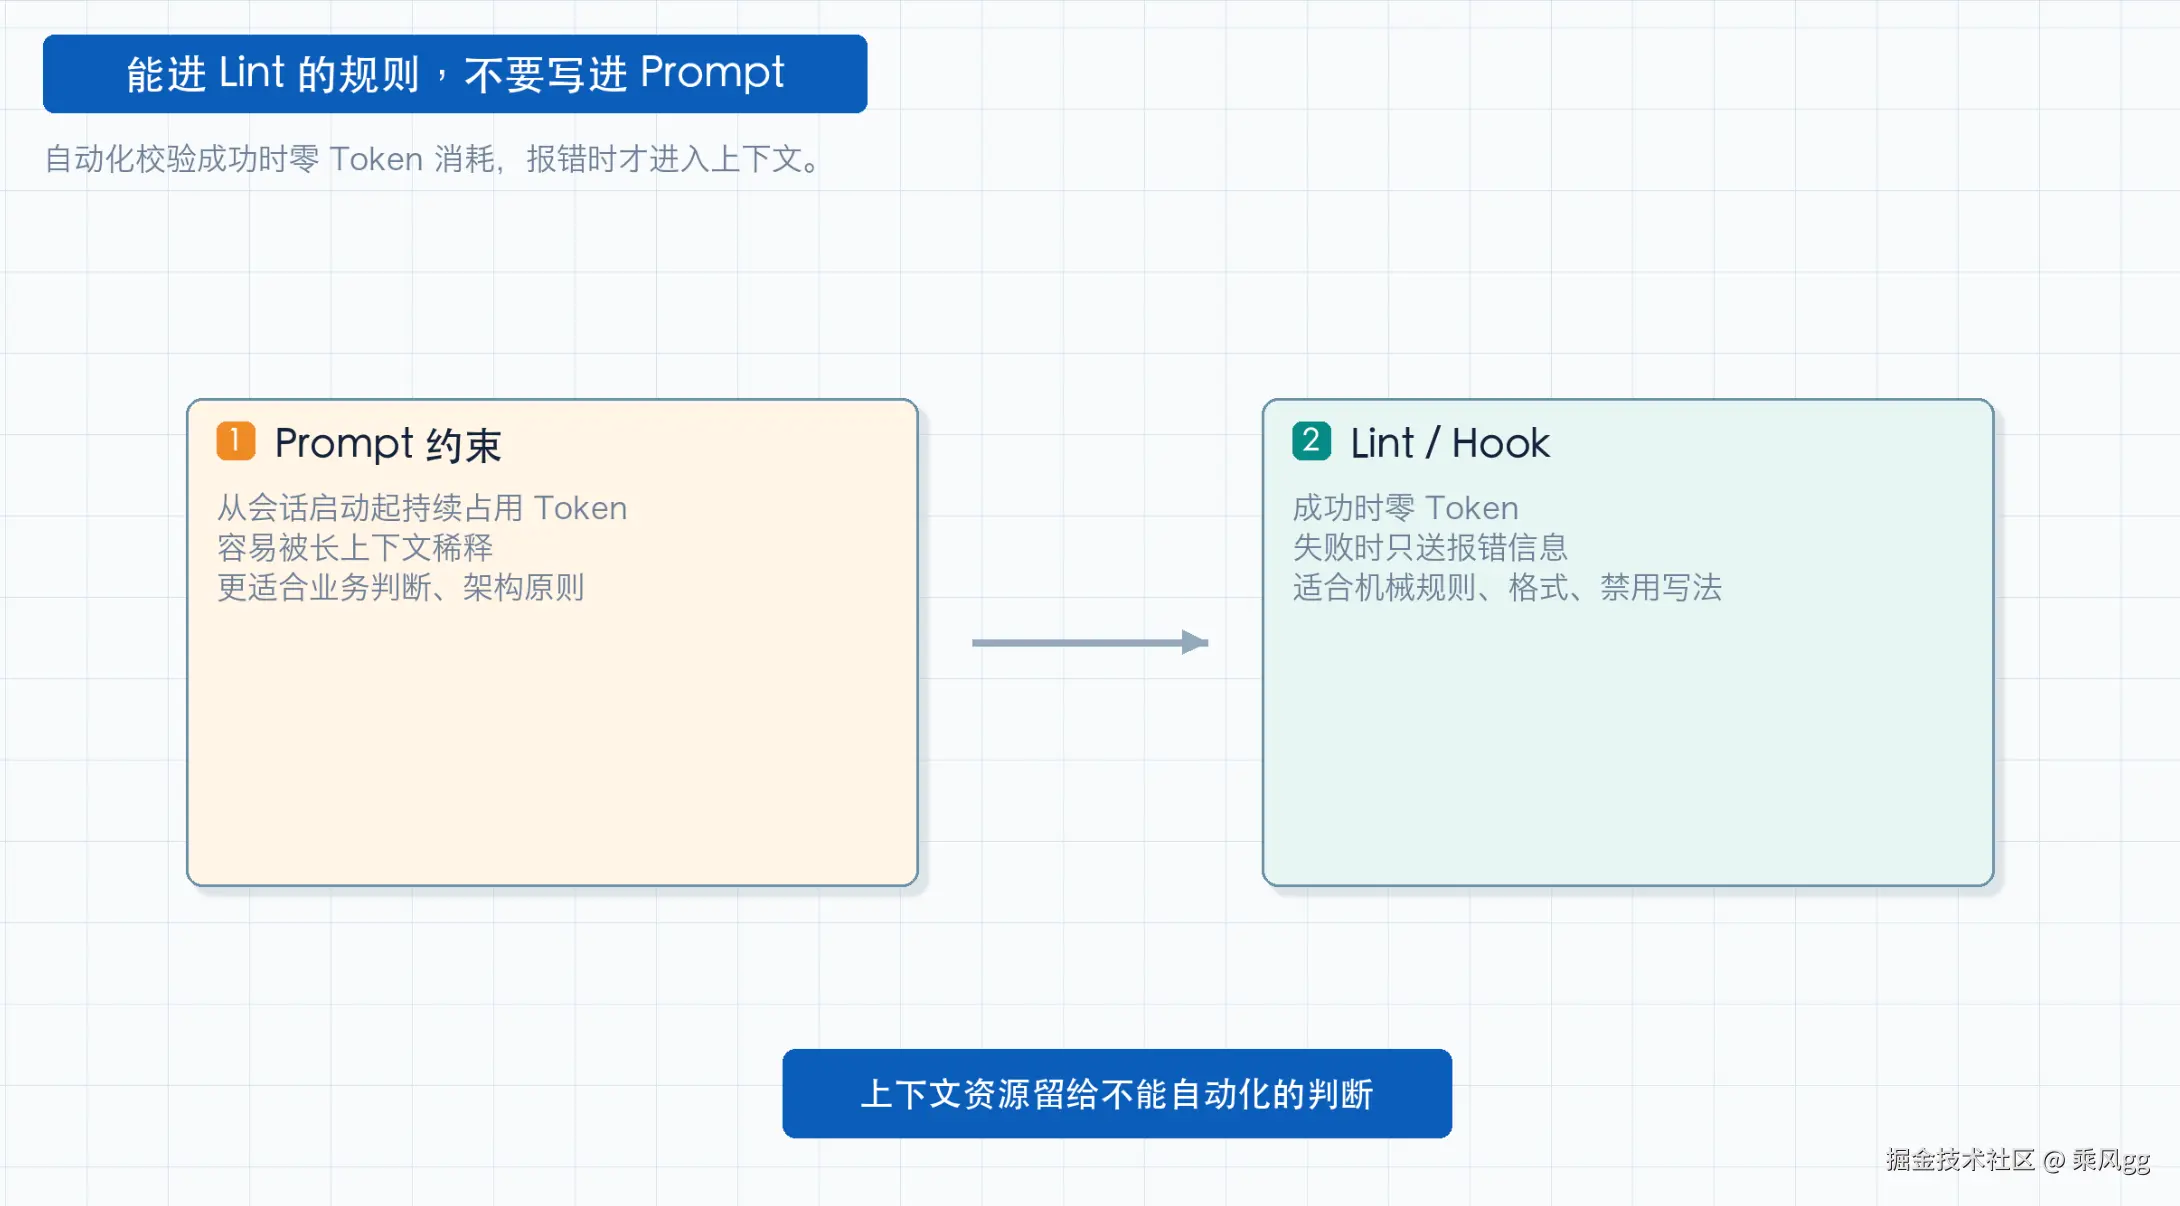
第二,尽可能让自动化反馈不消耗上下文配额。 Lint 规则、pre-commit 钩子有一个巨大优势:校验成功时零 Token 消耗,只有报错信息才会送入上下文。而写在 Prompt 里的约束,从会话启动起持续占用 Token。由此得出一条铁律:能够放进 Lint 校验的规则,不要写进 Prompt。 节省下来的上下文资源,留给架构约束、业务逻辑这类无法自动化校验的判断。
搭建分层反馈体系,可以配套三种实践手段:
Red-Green-Refactor,先编写失败测试,再实现逻辑,测试不通过是客观事实,AI 无法主观规避。
类型系统,TypeScript 提供近乎零延迟的实时纠偏,弱类型环境下 AI 很难察觉代码隐患,直到运行时崩溃。
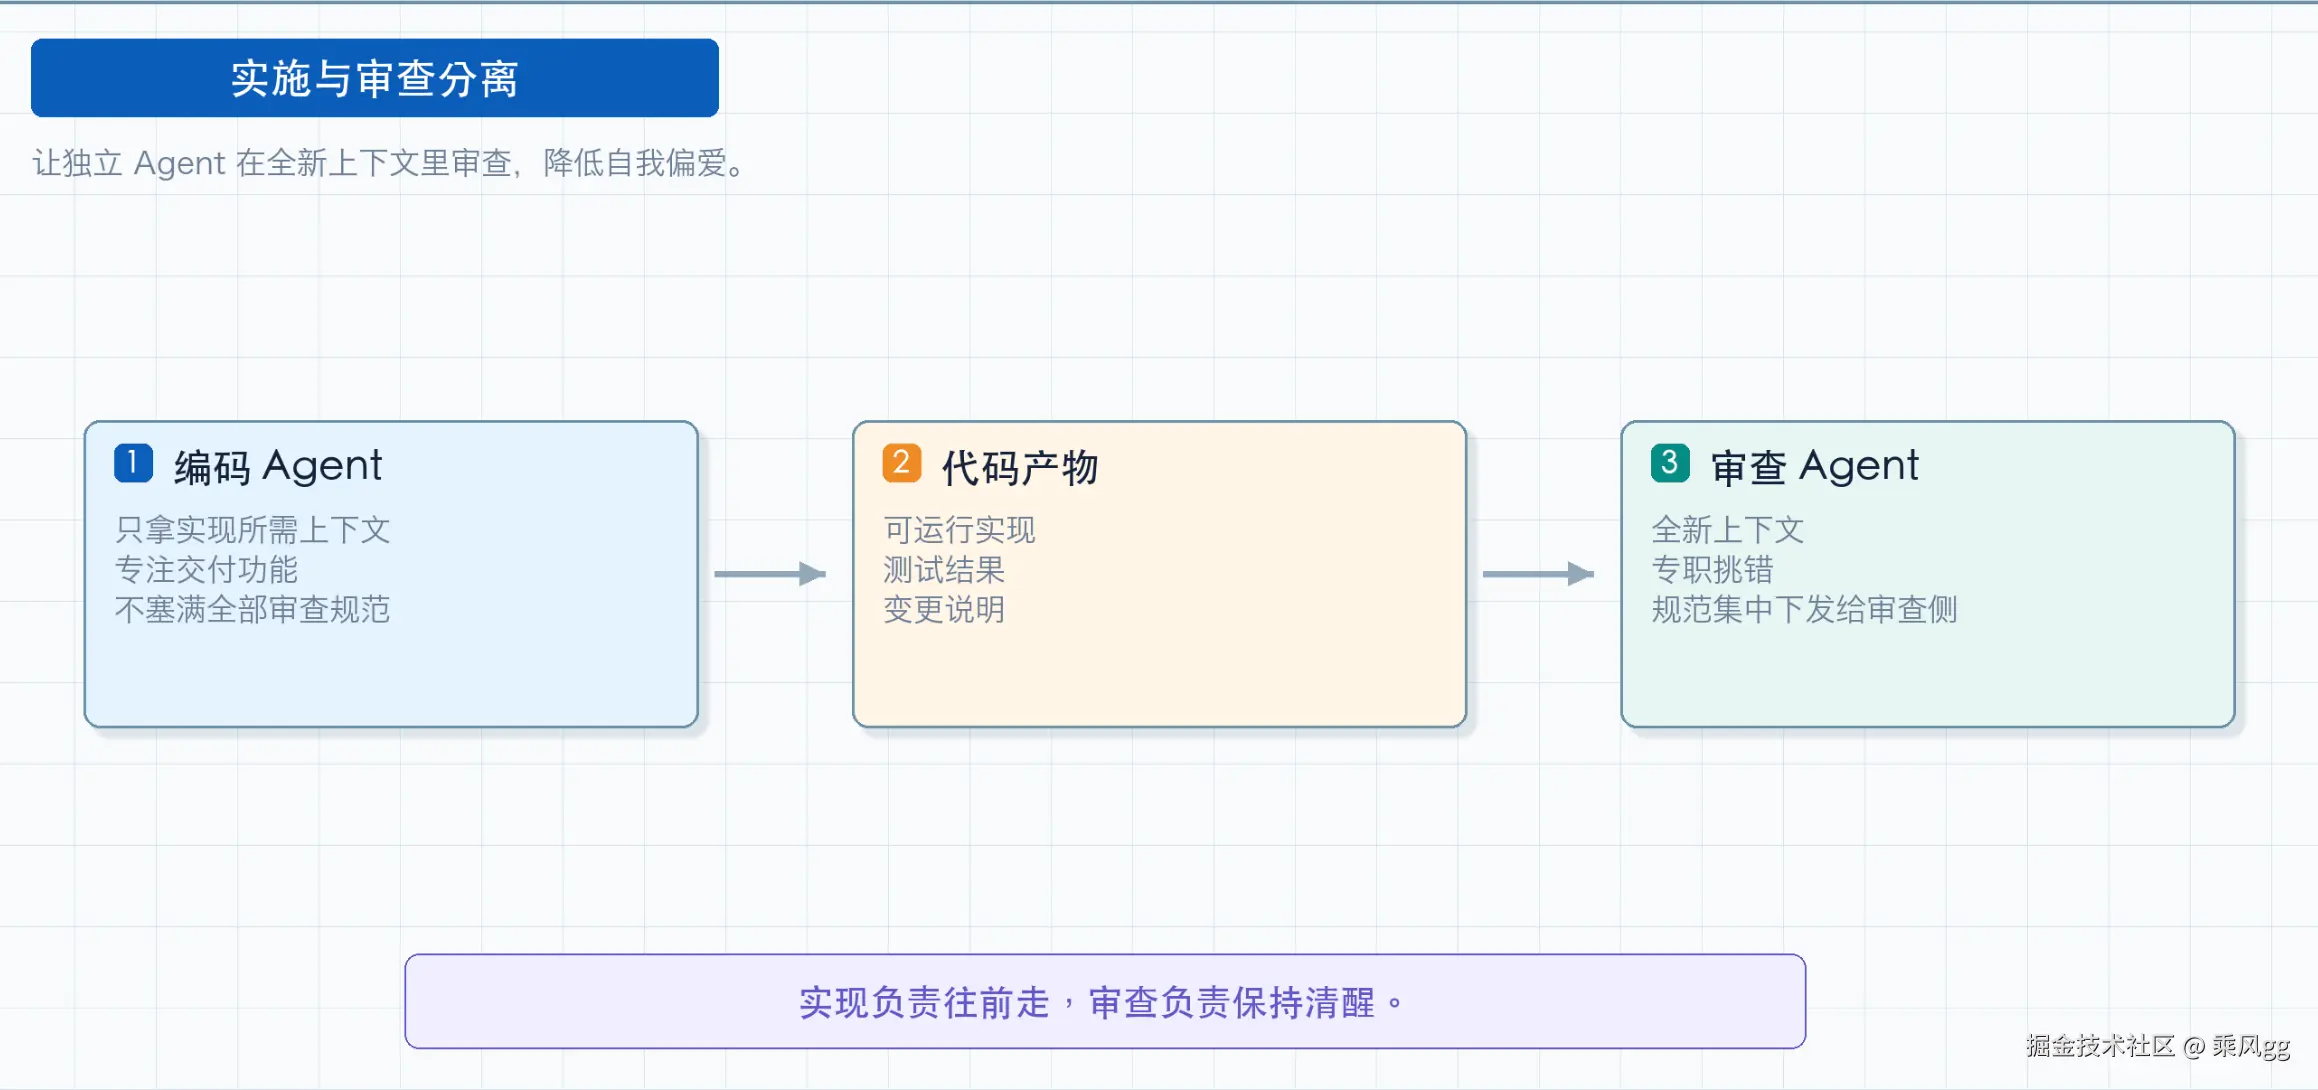
实施与审查分离,AI 普遍偏爱自己生成的代码,不会主动重构,安排独立 Agent 在全新上下文内专职审查,规范只下发给审查 Agent,不交给编码实现 Agent。
深模块为 AI 构筑错误防火墙
我在项目里踩过一个典型陷阱:后台编辑器模块,前端状态、后端接口、CLI、本地存储二十多个文件相互纠缠。出现 Bug 时,需要跨四个子系统来回排查。
后来我把这一组文件封装为深模块(Deep Module,出自 John Ousterhout《A Philosophy of Software Design》,核心思想是薄接口、厚实现),对外仅暴露两层薄接口:前端调用 SDK、后端处理 API Handler,所有复杂实现全部向内隐藏。故障定位效率立刻提升,端到端集成测试就能快速锁定问题。
但这件事最重要的启示不在于提效,而是:识别"应当封装深模块"这件事,现阶段 AI 做不到。 它需要跨多层抽象、理解子系统交互、权衡复杂度收敛的边界。AI 可以在已有接口之下填充实现,却无法主动告诉你:当前接口暴露粒度太粗,应当向内隐藏复杂度。
由此形成一套「人管接口,AI 管实现」的协作范式,我称之为灰盒模型。
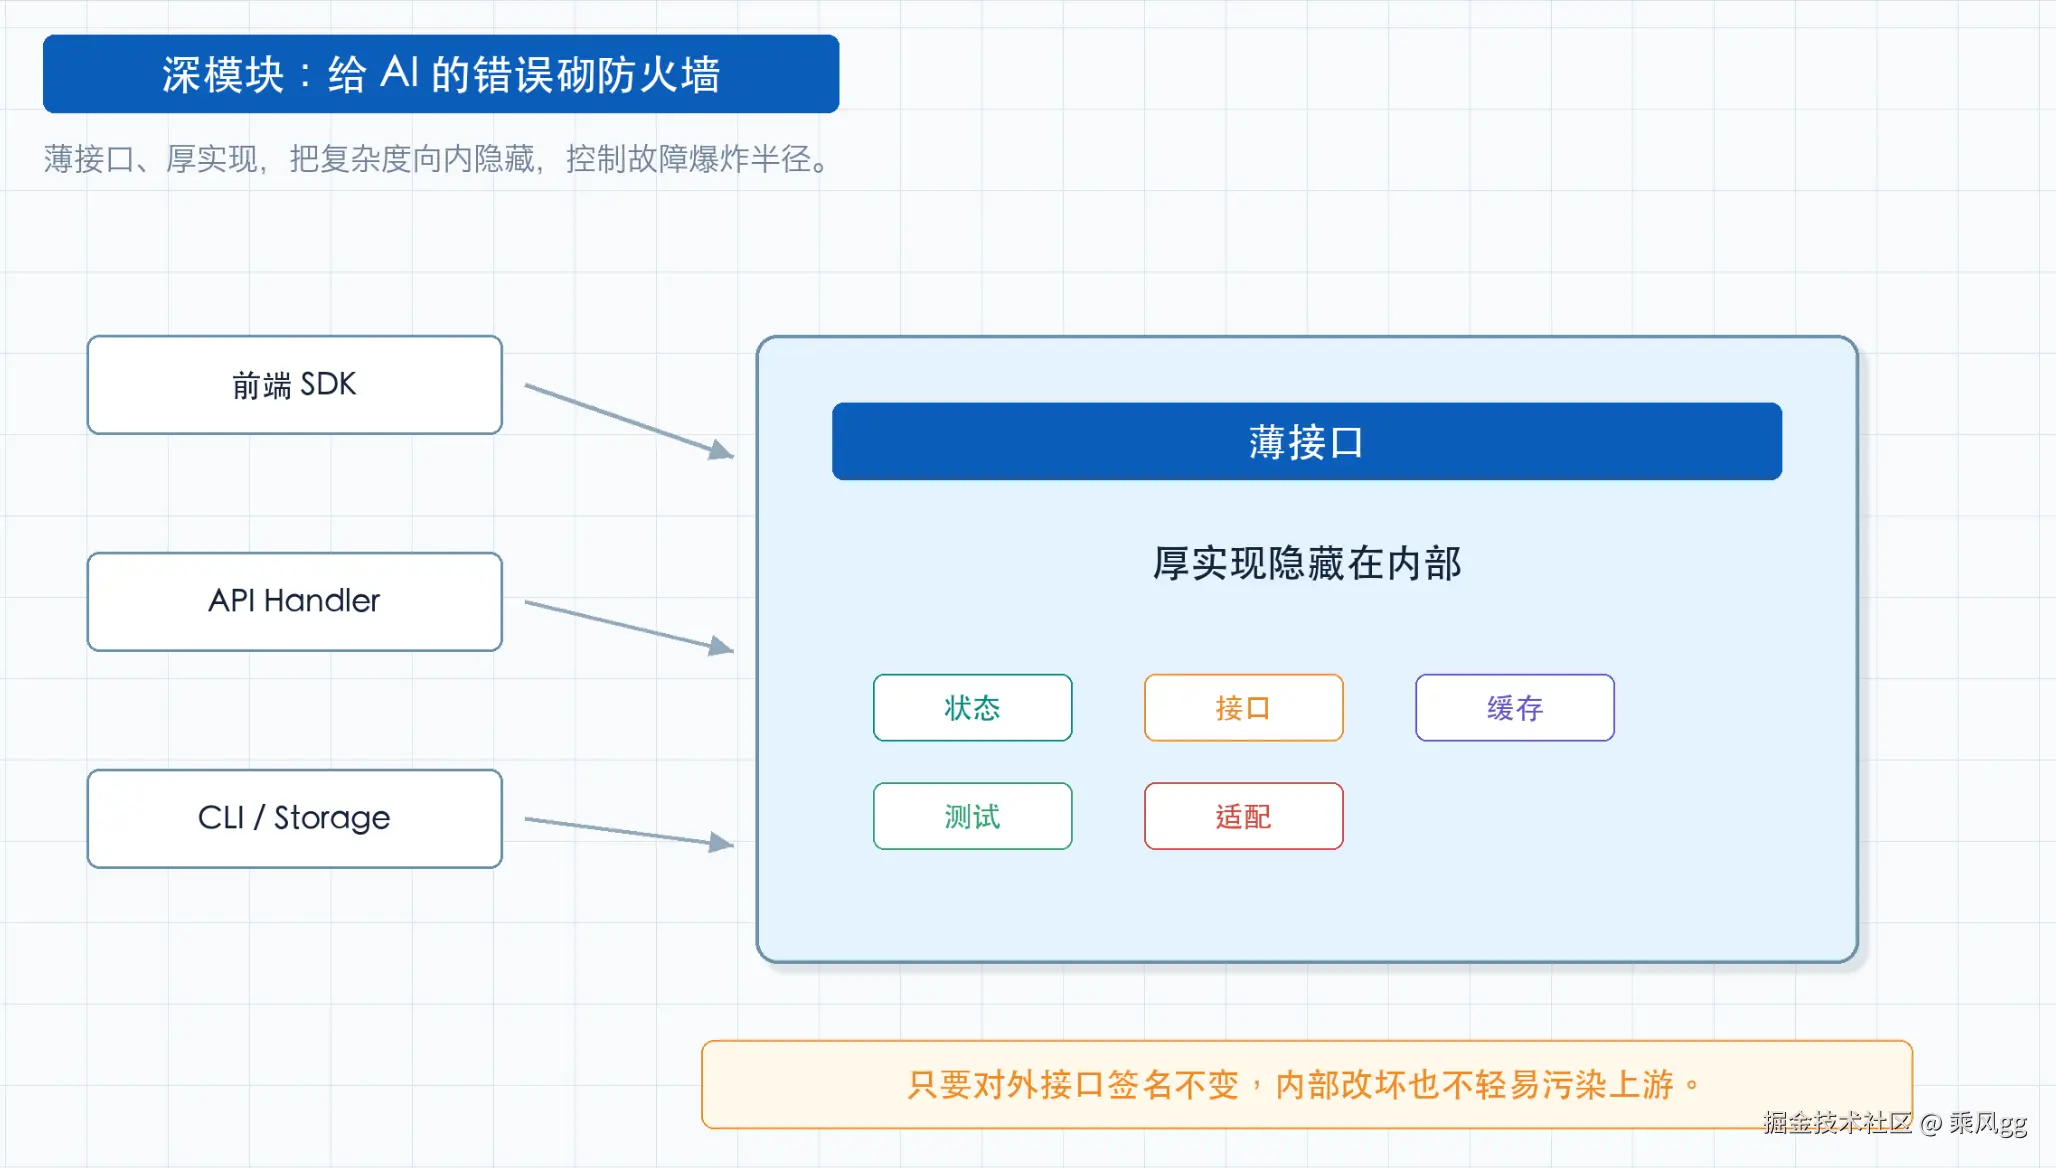
这套模型容易被低估的价值:控制 AI 写坏代码时的故障爆炸半径。 浅度模块的接口和实现高度重合,对外暴露数十个导出函数,模块内部自由调用,AI 写错一个返回值,错误顺着依赖链快速污染大量文件。深模块内同样的缺陷,会被薄层接口阻断------只要对外接口签名不变,内部实现改动不会影响上游调用方。对外接口越精简,错误防火墙的漏洞越少。
总结
代码腐化、深模块、反馈闭环、信息渐进披露,全部都是软件工程老生常谈的概念。但叠加 AI 编码这个新变量后,所有实践的优先级都发生改变:慢性风险演变为急性隐患,传统设计原则变成风险防火墙,质量校验升级为实时纠偏机制。
代码并不廉价------烂代码会指数级传染。 提前清理代码库基准样本;委托 AI 做设计时,评估方案失败后的回滚成本。
上下文窗口越大,越要守住会话开头的有效信息。 不要依赖上下文压缩解决长会话质量下滑问题。
反馈闭环是 AI 的导航系统。 自动化校验优先放入 Lint,不要堆砌在提示词;将编码实施与代码审查拆分为独立任务。
深模块为 AI 构筑错误防火墙。 人定义对外接口边界,AI 负责内部实现。
分清约束应该放置在哪里、自动化检查需要多快响应、接口需要收敛到多薄,这份架构判断力,永远不会过时。
欢迎大家关注我的公众号:深入浅出AI